
Руководство по использованию
Руководство по началу работы с gemini-4-hydrogen: границы возможностей, ключевые параметры и практика интеграции
Справочник по интеграции и выбору текстовой модели для инженерных команд
На этой странице
Позиционирование и границы возможностей gemini-4-hydrogen
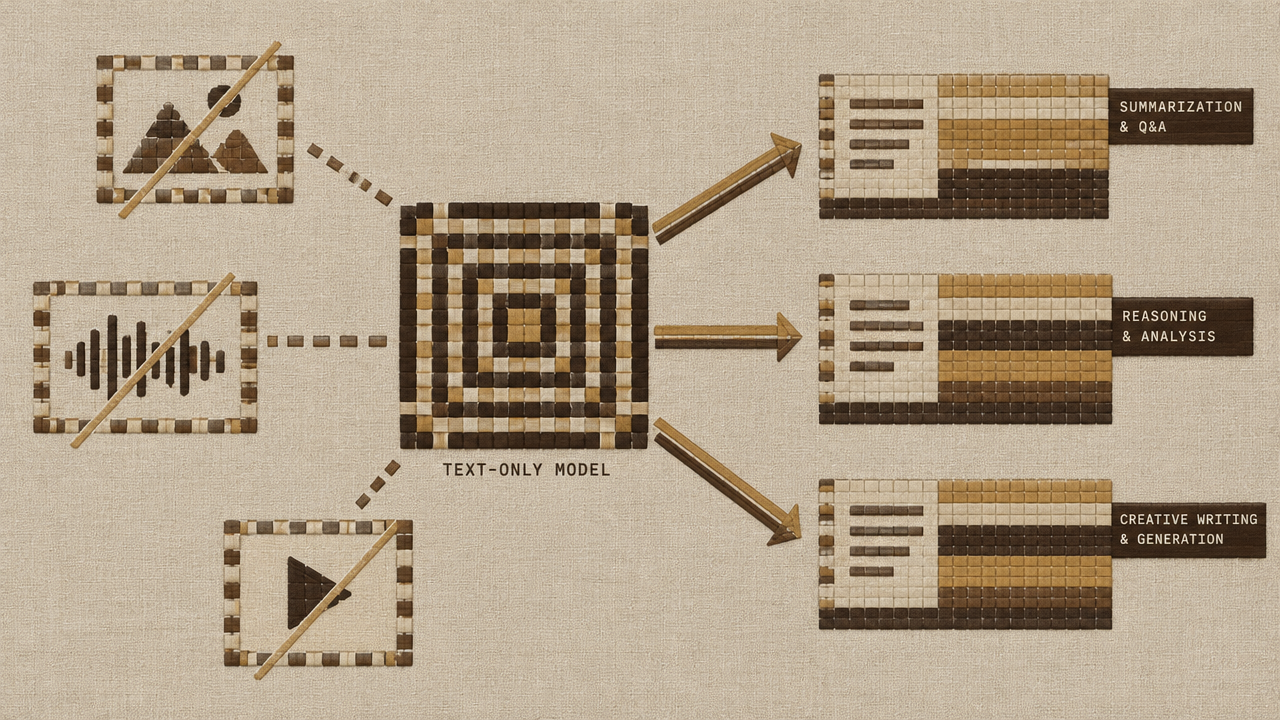
gemini-4-hydrogen — текстовая модель от Google. Тип её вывода — обычный текст, и это определяет, куда её следует поместить в архитектуре: в звено «текст на входе — текст на выходе», а не в мультимодальный конвейер.
Что она делает хорошо
С инженерной точки зрения типичные места применения модели с текстовым выводом — задачи, где «промежуточный продукт и есть фрагмент текста»:
- Структурированное извлечение и преобразование: превращение неструктурированного текста в JSON, строки таблиц, списки полей и другие согласованные форматы;
- Суммаризация и перефразирование: сжатие длинных документов, корректировка тона, унификация формулировок на разных языках;
- Классификация и принятие решений: распознавание намерений, классификация контента, маршрутизация тикетов — короткий вывод ради низкой задержки;
- Вспомогательная генерация: написание черновиков, дополнение комментариев к коду, расширение промптов — этап перед ручной проверкой;
- Диалог и ответы на вопросы: организация ответа при наличии контекста из поиска.
Общая черта этих задач: вход можно сериализовать в текст, выход можно разобрать нижестоящей программой, а результат — проверить выборочно.
Для чего она не подходит
Это тоже инженерное суждение, и границы нужно очертить заранее:
- Не рассчитывайте, что она напрямую создаст изображения, аудио или видео. Форма вывода — текст, и цепочки с мультимодальной генерацией нужно собирать в другом месте;
- Не используйте её как строго детерминированный калькулятор. Точную арифметику и строгую проверку по правилам следует поручать коду, а не модели;
- Не позволяйте ей делать фактические утверждения без контекста. Там, где нужны внешние знания, сначала поместите материалы в вход через поиск, а затем поручите ей организовать ответ;
- Не считайте её единственным источником информации о событиях в реальном времени. Внутренние знания модели имеют границу отсечения, и данные с высокими требованиями к актуальности должен подавать ваша система.
Записать эти пункты в проектной документации команды намного дешевле, чем потом латать дыры на нижестоящем уровне.
Что нужно уточнить перед интеграцией
Прежде чем написать первую строку кода вызова, стоит прояснить несколько вещей, иначе на этапе отладки появится много бесполезных проверок.
Определите форму задачи и контракт вывода
Сначала ответьте на три вопроса: вход однораундовый или многораундовый? Вывод свободный текст или он должен соответствовать определённой структуре? Может ли нижестоящая система допустить повторную попытку при ошибке? Эти три ответа напрямую определят, как писать промпт, как задать верхний предел длины вывода и как делать проверку.
Учётные данные и точка входа вызова
Независимо от итогового способа интеграции вам нужен набор управляемых и сменяемых учётных данных API, и не встраивайте учётные данные во фронтенд-код и не коммитьте их в репозиторий. Рекомендуемый подход: хранить учётные данные в переменных окружения сервера или в сервисе управления секретами, вызывать модель через единый выход на бэкенде, а фронтенд общается только с вашим бэкендом. Так вы избегаете утечки и упрощаете последующее квотирование и аудит по бизнес-направлениям.
Сеть и бюджет таймаута
Время одного запроса к текстовой модели меняется в зависимости от длины входа и выхода. Перед запуском в продакшен определите: какое максимальное время ответа приемлемо для вашего бизнеса? От этого обратным счётом задайте таймаут запроса, число повторов и стратегию деградации. Многие отзывы о «нестабильности модели» на деле оказываются несоответствием настроек таймаута ожиданиям бизнеса.
Наблюдаемость важнее функциональности
До написания бизнес-логики зафиксируйте поля логов: ID запроса, количество входных токенов, количество выходных токенов, затраченное время, код ошибки. Эти пункты почти необходимы при последующем расчёте стоимости и локализации проблем, а добавлять их задним числом обычно означает переписывать целый пласт кода.
Комплаенс и границы данных
Убедитесь, содержит ли отправляемый контент конфиденциальные сведения — персональные данные пользователей, ключи, внутренние документы, — и определите, какие поля должны быть обезличены до передачи в модель.
Параметры вызова и организация запроса
Типичный вызов состоит из трёх частей: входное содержимое, управляющие параметры, возвращаемый результат. На качество результата и стоимость обычно влияет лишь несколько параметров.
Как организовать входное содержимое
Рассматривайте вход как три уровня: «инструкция + контекст + обрабатываемые данные»:
- инструкция идёт первой и описывает роль и цель задачи;
- контекст (найденные материалы, история диалога) идёт в середине и чётко отделяется;
- обрабатываемые данные идут последними, вплотную к объекту, к которому относится инструкция.
В многораундовом диалоге сохраняйте последние несколько раундов, а не бесконечно накапливайте историю: чем длиннее история, тем больше расход на входе, а шум размывает ключевую информацию. Содержимое, требующее долговременной памяти, лучше передавать в виде суммаризации, а не в полном объёме оригинала.
Ключевые параметры
- Верхний предел длины вывода: это параметр, который чаще всего упускают, но он влияет и на стоимость, и на опыт пользователя. Слишком маленькое значение обрезает ответ, слишком большое оставляет модели пространство для «болтливости». Рекомендуется задавать уровни по типу задачи: для классификации — очень маленький предел,放开 большой — только для генерации длинных текстов.
- Параметры сэмплирования вроде temperature/top-p: для извлечения, классификации и преобразования формата, где нужен стабильный вывод, снижайте случайность; для генерации текстов можно适度放开. В рамках одного бизнес-сценария держите значения согласованными для удобства регрессионного сравнения.
- Условия остановки: если нижестоящей системе нужно, чтобы вывод закончился в определённом месте (например, взять только первый фрагмент JSON), ограничение через стоп-последовательность надёжнее, чем последующая обрезка регулярным выражением.
- Ограничения структурированного вывода: если результат должен разбирать программный код, укажите в инструкции имена полей, типы и примеры, а также явно потребуйте «выводить только JSON без пояснений».
Несколько практик организации запроса
- Отделите промпты от бизнес-кода и сделайте их версионируемыми шаблонами для удобства A/B-сравнения;
- Сделайте резервную обработку разбора вывода: при ошибке разбора логируйте исходный ответ, а не сразу отдавайте ошибку пользователю;
- Задайте идемпотентный ключ для одного и того же запроса, чтобы избежать повторного списания средств и повторных побочных эффектов из-за повторов;
- Для длинного входа сначала делайте разбиение и отбор, отсекая нерелевантные абзацы до попадания в модель, — это самый прямой способ сэкономить.
Как оценивать и контролировать стоимость при оплате по токенам
gemini-4-hydrogen оплачивается по токенам. Это означает, что ваша стоимость почти полностью определяется двумя вещами: сколько токенов вы отправляете в каждом запросе и сколько токенов выдаёт модель. Конкретные цифры цен смотрите на панели цен сайта, здесь речь только о методике.
Выработайте привычку оценивать
Не оценивайте на глаз. Подход такой: сначала прогоните партию реальных образцов, запишите количество входных и выходных токенов каждого запроса и сгруппируйте по бизнес-сценариям, рассчитав средние значения и квантили. По «среднему числу токенов × суточному числу вызовов» получите оценку порядка величины, а по P95 посмотрите худший случай. Вы обнаружите, что распределения по разным сценариям сильно различаются, и оценка по единому среднему часто даёт серьёзные отклонения.
Конкретные рычаги контроля стоимости
- Сжатие входа: уберите повторяющиеся системные подсказки, обрежьте нерелевантный контекст, для длинных документов сначала делайте суммаризацию, а затем передавайте. Вход обычно составляет основную долю затрат, и выгода здесь наиболее прямая;
- Ограничение вывода: через верхний предел длины вывода и инструкции вроде «отвечай кратко» напрямую убирайте избыточный вывод;
- Многоуровневые вызовы: простую классификацию и проверку формата решайте малыми запросами, а полный вызов используйте только там, где действительно нужна генеративная способность;
- Кеширование и дедупликация: кешируйте результаты одинаковых или очень похожих запросов, особенно для пакетных офлайн-задач;
- Пакетность и асинхронность: задачи, не требующие реального времени, обрабатывайте пакетами, чтобы сократить повторяющиеся фиксированные накладные расходы.
Превратите стоимость в наблюдаемый показатель
В логах фиксируйте расход токенов по бизнес-линиям и стройте дашборды дневных и недельных трендов. Когда в какой-то день расход аномально растёт, обычно есть три причины: рост числа вызовов, удлинение входа (например, изменилась логика сборки контекста), удлинение выхода (например, изменили промпт). Сделайте эти три пункта объектами мониторинга — это избавит от массы последующих разбирательств.
И последнее напоминание: оптимизация стоимости не должна идти за счёт качества вывода. Сначала создайте оценочный набор, а потом говорите о сжатии.
Интеграция на платформе агрегации API и сравнение нескольких моделей
Для большинства команд на этапе выбора модели наибольшая стоимость — не написание кода, а «смена модели требует переделки слоя интеграции». Единая точка входа сводит эту стоимость к минимуму.
Преимущества единого интерфейса
На платформе агрегации API способ вызова моделей унифицирован в одну и ту же структуру запроса: та же аутентификация, тот же формат сообщений, та же логика разбора ответа. При смене модели обычно достаточно изменить идентификатор модели, а бизнес-код почти не меняется. Прямые выгоды:
- слой интеграции пишется один раз и используется несколькими моделями;
- на этапе оценки можно с низкими затратами сравнивать модели горизонтально;
- в продакшене можно делать канареечные выкатки и быстрый откат — при проблеме с одной моделью переключение на резервную требует лишь изменения конфигурации.
Информацию о подключении и доступности модели можно получить на странице модели: /models/gemini-4-hydrogen.
Проведите сравнение на одинаковых задачах
Не смотрите только на рейтинги. Подготовьте собственный оценочный набор из 20–50 образцов, покрывающих реальное распределение бизнеса, включая простые случаи, граничные случаи и случаи с длинным входом, а затем:
- прогоните несколько моделей-кандидатов на одном и том же шаблоне промпта;
- запишите качество вывода (ручная или规则 оценка), затраченное время, расход токенов;
- смотрите в первую очередь на долю успешных прохождений и характер ошибок, а не на средний балл;
- по образцам с заметными различиями проведите анализ причин: это проблема следования инструкциям, проблема формата или обрезка длинного контекста.
Стратегия переключения и сосуществования
Вывод по результатам оценки часто звучит не как «используем одну модель», а как «распределяем роли по сценариям». Например: для классификации и извлечения — модель с низкой задержкой, для генерации длинных текстов — модель с лучшим качеством вывода. Единая точка входа позволяет выразить такое распределение на уровне конфигурации без поддержки нескольких SDK. Также рекомендуется оставить в слое интеграции конфигурационный переключатель идентификатора модели и сочетать его с постепенным увеличением доли трафика при канареечном релизе.
Чек-лист проверок перед запуском и диагностика типовых проблем
Чек-лист проверок перед запуском
Пройдите эти шаги по порядку, прежде чем думать о масштабировании трафика:
- Дымовой тест: возвращается ли нормально самый короткий запрос, проходят ли аутентификация и сеть;
- Проверка формата: в сценариях структурированного вывода какова доля успешного разбора на пакете образцов и как выглядит ответ при неудачном разборе;
- Граничные входы: как ведут себя сверхдлинный вход, пустой вход, вход со специальными символами и несколькими языками;
- Длина вывода: обрезается ли вывод в худшем случае и может ли нижестоящая система распознать обрезку;
- Параллелизм и таймауты: при ожидаемом пиковом параллелизме приемлемы ли доля таймаутов и доля ошибок;
- Путь деградации: действительно ли работает цепочка переключения на резервную модель или возврата резервного результата при недоступности основной модели;
- Базовая стоимость: зафиксируйте расход токенов на типичном трафике как ориентир для последующего мониторинга.
Типовые проблемы и порядок диагностики
Таймаут запроса: сначала проверьте, не слишком ли велик вход (особенно не вставили ли вы туда весь документ), затем — не задан ли слишком большим верхний предел вывода, и наконец убедитесь, что таймауты клиента и стратегия повторов разумны. Повторы должны сопровождаться задержкой с экспоненциальным ростом, чтобы избежать лавины.
Вывод обрезан: проверьте верхний предел длины вывода и не требует ли промпт слишком длинного содержимого; иногда преждевременное завершение вызвано неправильно заданной стоп-последовательностью.
Вывод нестабилен, формат то хороший, то плохой: в первую очередь снизьте случайность сэмплирования; затем проверьте, достаточно ли точны инструкции (полны ли имена полей, типы, примеры); потом проверьте, не попали ли во вход противоречивые примеры.
Содержимое отклоняется от инструкций: частая причина — слишком длинный контекст, из-за которого ключевые инструкции размываются. Обычно помогает повторить инструкцию в конце входа или сжать контекст.
Аномальный рост стоимости: разберите по трём упомянутым выше причинам — число вызовов, длина входа, длина выхода — и сопоставьте каждую с трендами в логах.
Результат не воспроизводится: записывайте параметры запроса и версию шаблона; вывод модели сам по себе случаен, не ожидайте дословного воспроизведения, а проверку стройте на правилах или ручной оценке.
Закрепить этот чек-лист в процессе релиза гораздо надёжнее, чем каждый раз действовать импровизированно при запуске. Конкретные детали выбора и интеграции можно начать уточнять на странице модели /models/gemini-4-hydrogen.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по генерации изображений из текста в базовой версии Nano Banana: формат кадра, свободное пространство и использование промптов
Используйте поля aspect_ratio и prompt интерфейса задач для генерации изображений с чёткой композицией для баннеров и социальных карточек
-

Руководство по использованию
Практика обработки ответов Kimi K3: полный JSON, прерывание потока и границы повторных попыток
-

Руководство по использованию
Практика структурированного извлечения данных с GLM 5.3: каждое поле JSON должно иметь основание в исходном тексте
Извлечение полей в режиме JSON-объекта: отсутствующие значения, цитаты и бизнес-валидация не дают ошибкам попасть в хранилище