ByteDance
OmniHuman 2.0
omnihuman-2.0
Цифровая модель человека второго поколения от ByteDance: достаточно одного изображения человека или персонажа и аудиозаписи речи или пения, чтобы создать видео с исполнением, в котором движение губ, мимика и жесты синхронизированы со звуком; длительность одного непрерывного кадра — до 5 минут, а с помощью промпта можно управлять движениями и движением камеры
Попробовать omnihuman-2.0
Ввод
Работы
Все работыВывод
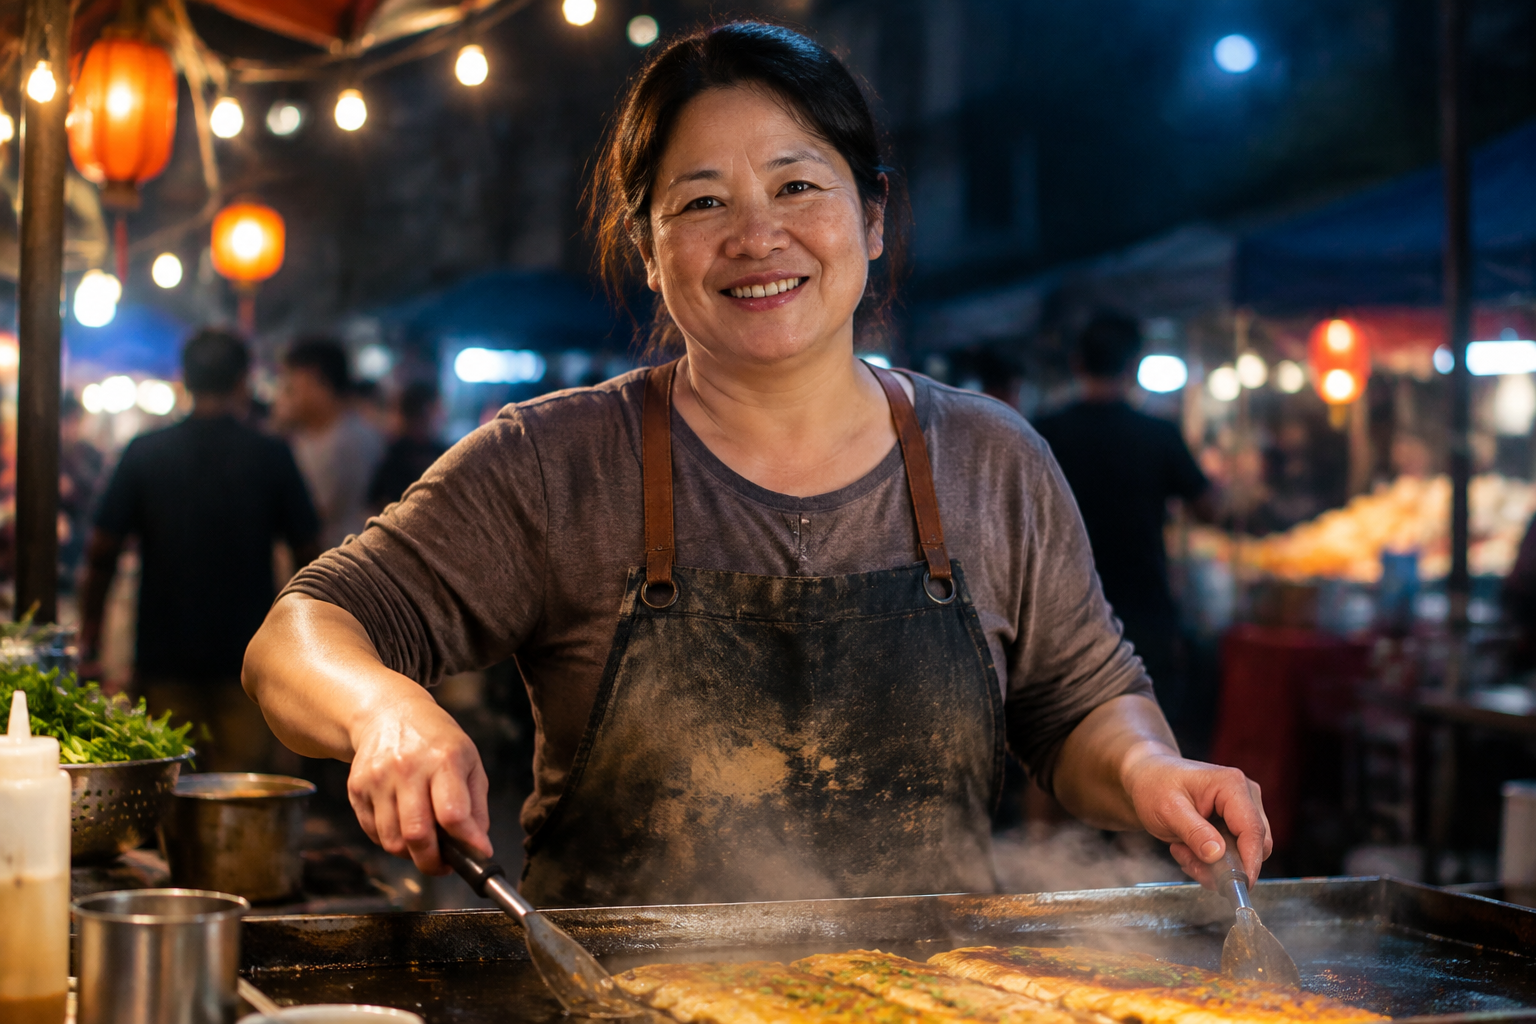
videoМонолог уличного торговца на ночном рынке
Стиль портрет-аватар · Уличная еда · синхронизация губ
Референсные входы
Аудиодрайвер
Изображение персонажа
Промпт
На ночном рынке уличный торговец едой в фартуке, испачканном мукой, стоит за раскалённой плитой, от которой поднимается пар, обращается к камере с тёплой, естественной и приветливой улыбкой, делает небольшой жест, подчёркивающий интонацию; позади него висят гирлянды огней, пар медленно плывёт; камера медленно и мягко приближается.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
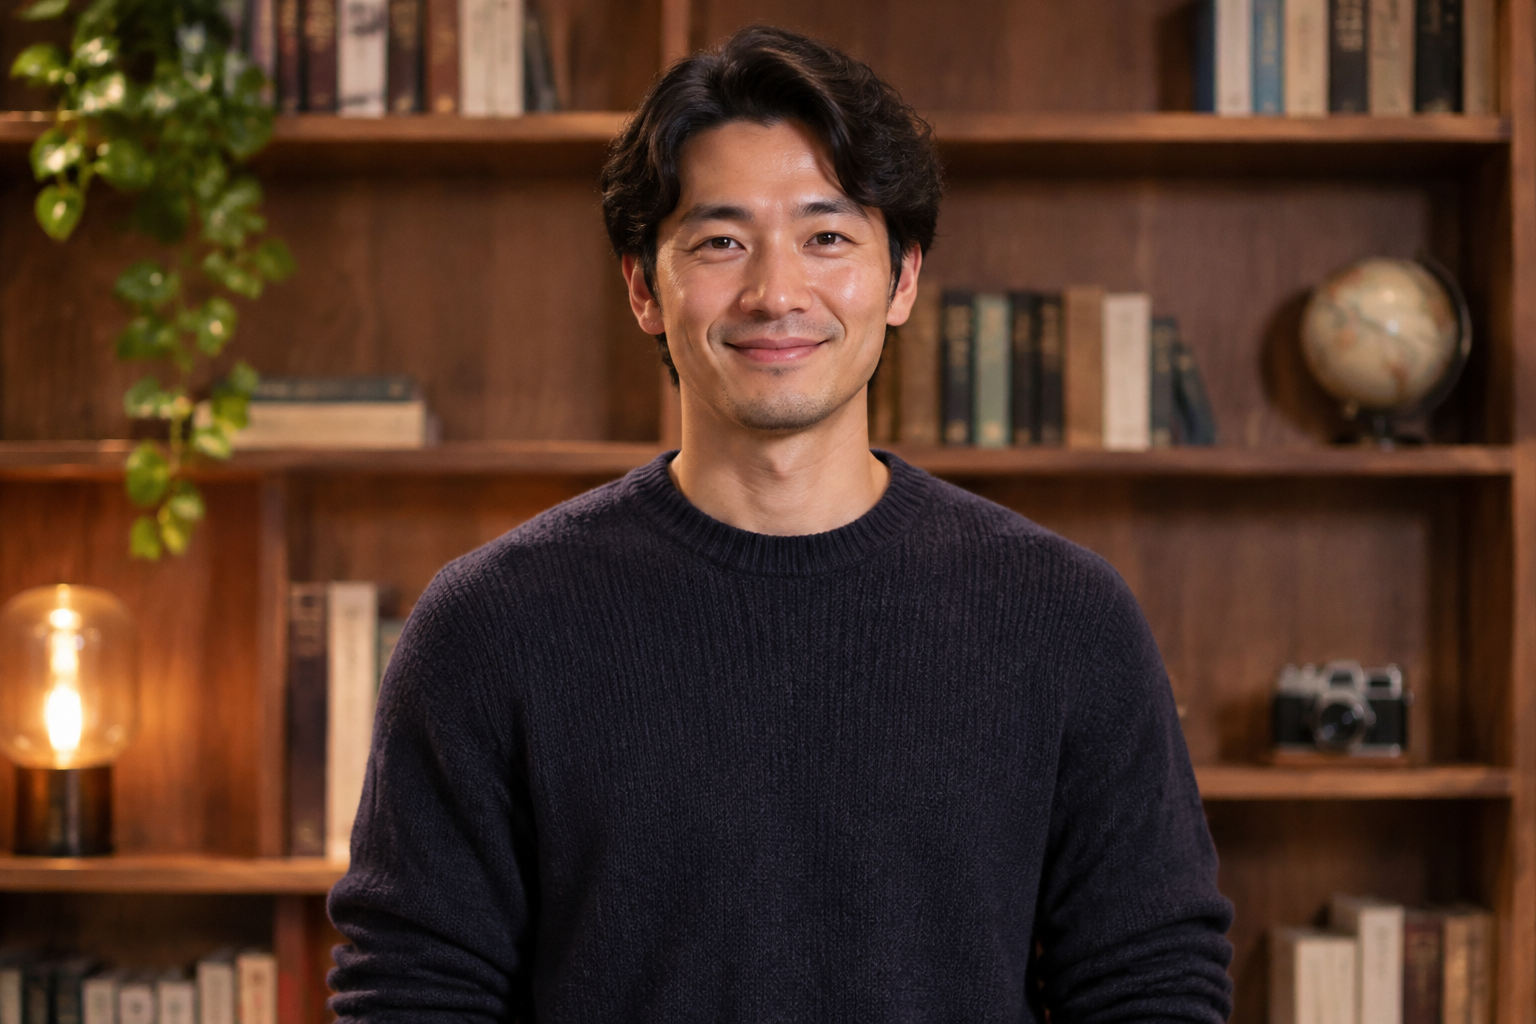
Объяснение знаний у книжной полки · цифровой ведущий
Стиль Голосовое озвучивание · Образование · Студийный портрет
Референсные входы
Аудиодрайвер
Изображение персонажа
Промпт
Ведущий в тёмном вязаном свитере со спокойным выражением лица стоит перед тёплой деревянной книжной полкой и говорит в камеру; губы двигаются естественно, жесты сдержанные, камера медленно приближается со среднего плана к более крупному, мягкий тёплый основной свет.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
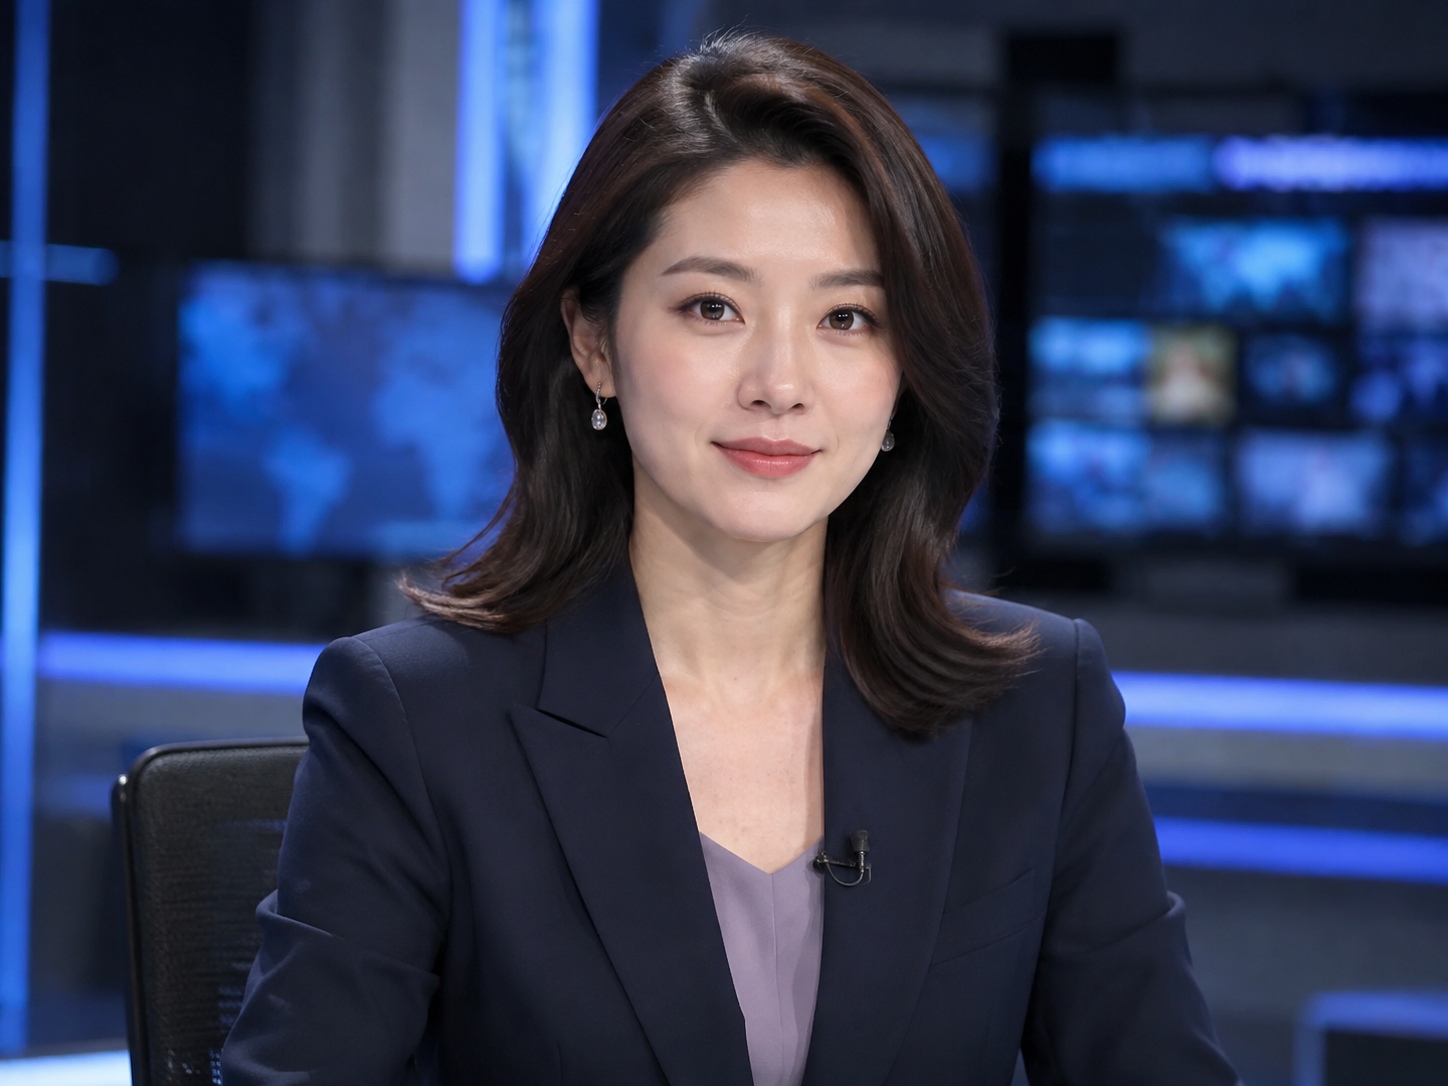
Ночная студия · Цифровой ведущий в кадре
Стиль Трансляция · Голосовое озвучивание · Кинематографичный
Референсные входы
Аудиодрайвер
Изображение персонажа
Промпт
Камера медленно приближается к сдержанной женщине-ведущей, которая говорит, сидя за столом в полумрачной студии; когда её тон становится задумчивым, она слегка кивает, и выражение её лица смягчается; холодный синий и янтарный студийный свет, чёткая эфирная фактура.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
omnihuman-2.0 per second
| Цена за единицу | $0.100 |
|---|
Краткое описание
Это модель генерации видео с цифровым человеком на основе аудио: она принимает изображение реального человека или иллюстрированного персонажа и фрагмент речи или пения, а на выходе создаёт видео с исполнением, синхронизированным с аудио. Длительность видео соответствует аудио, а кадр сохраняет соотношение сторон исходного изображения; дополнительно можно использовать промпт для описания сцены, мимики, жестов и движения камеры. Модель подходит разработчикам и создателям контента, которым нужны кадры с говорящим, поющим или ведущим диалог персонажем: для коротких видео в соцсетях, рекламных роликов с лицом бренда и материалов с участием персонажа в приложениях цифровых людей.
Ключевые особенности
- Синхронизация губ и мимики под аудио — артикуляция, мимика и движения тела генерируются в соответствии с ритмом и интонацией речи и пения, а длительность видео совпадает с длительностью аудио.
- Изображение в видео с сохранением пропорций — достаточно загрузить изображение персонажа, чтобы получить видео с его исполнением; готовый ролик сохраняет соотношение сторон изображения, что упрощает встраивание в существующий макет.
- Управление исполнением и движением камеры через промпт — необязательный промпт описывает сцену, мимику, жесты и эффекты камеры, например медленное приближение.
- Один аудиофрагмент покрывает несколько минут исполнения — управляющее аудио поддерживается длительностью от 4 до 300 секунд, и готовое видео может следовать за аудио, что подходит для连续ных отрезков речи или пения.
Описание возможностей
Генерация видео с персонажем из изображения и аудио: при наличии изображения персонажа и управляющего аудио создаётся видео с исполнением этого персонажа; изображение может быть фотографией реального человека или иллюстрацией, а кадр готового видео сохраняет соотношение сторон исходного изображения.
Исполнение с синхронизацией губ: видео генерирует соответствующую артикуляцию и мимику в ритме управляющей речи или пения, что подходит для материалов с закадровым голосом, диалогами и пением; длина видео совпадает с длиной аудио.
Управление исполнением и камерой через промпт: необязательный промпт длиной до 300 символов описывает сцену, мимику, жесты и движение камеры.
Диапазон длины аудио: управляющее аудио должно быть в формате mp3 или wav, длительностью от 4 до 300 секунд и размером не более 15 МБ; длительность готового видео соответствует ему, что удобно для планирования длинных непрерывных исполнений.
Диапазон параметров изображения: изображение персонажа поддерживается в форматах jpeg, png или webp, размером не более 10 МБ, с соотношением сторон от 0.4 до 2.5 и сторонами от 300 до 6000 пикселей.
Сценарии применения
- Создатели видео с говорящим ведущим для соцсетей — загрузите портрет ведущего и аудиозапись объяснения, чтобы получить видео с говорящим персонажем и сразу использовать его для публикации коротких видео на социальных платформах и регулярного обновления аккаунта.
- Виртуальное пение и музыкальные выступления — используйте изображение певца или виртуального образа вместе с аудио песни, чтобы получить кадры исполнения персонажа в качестве материала для музыкального контента.
- Короткие ролики с лицом бренда — сочетайте изображение фирменного образа с озвучкой рекламного текста, чтобы создать короткий ролик с лицом бренда или ведущим для рекламы и страниц мероприятий.
- Разработчики приложений с цифровыми людьми — подключайтесь к API и пакетно отправляйте изображения персонажей и аудио, чтобы предоставлять приложениям для создания видео фрагменты с цифровыми людьми для досъёмки или генерации диалоговых кадров.
Ограничения и рекомендации по выбору
Управляющее аудио обязательно: содержимое видео определяется аудио, и при этом необходимо также предоставить изображение персонажа; длительность входного аудио должна быть от 4 до 300 секунд, задачи короче 4 секунд завершаются ошибкой с полным возвратом средств. Изображение персонажа должно соответствовать требованиям к формату и размеру: соотношение сторон от 0.4 до 2.5, стороны от 300 до 6000 пикселей. Промпт необязателен и может содержать до 300 символов.
Новости
Смотреть changelog →- Новая модель Запуск OmniHuman 2.0: один портрет и один аудиофайл — говорящее видео длительностью до 5 минут
Частые вопросы
Все частые вопросы →-
Можно ли получить видео, имея только одно изображение и одну аудиодорожку?
Да, на вход этой модели подаётся одно изображение человека и одна управляющая аудиодорожка; обязательны только параметры image_url и audio_url. Поддерживаются изображения в форматах jpeg, png, webp, размером не более 10MB каждое, с соотношением сторон от 0.4 до 2.5 и длиной каждой стороны от 300 до 6000 пикселей; аудио — mp3, wav, длительностью от 4 до 300 секунд и не более 15MB. Содержимое видео управляется аудио, его длина совпадает с длиной аудио, а готовый ролик сохраняет соотношение сторон изображения.
-
Какой длины видео с цифровым человеком можно сгенерировать?
Максимальная длина одного непрерывного ролика — 5 минут, что соответствует аудио до 300 секунд, без необходимости сегментировать и склеивать. Минимальная длина аудио — 4 секунды; задачи с аудио короче 4 секунд завершаются ошибкой с полным возвратом средств. Если нужна длинная непрерывная игра, отправляйте весь закадровый текст или диалог одним аудиофайлом — это проще, чем генерировать по частям и потом склеивать, и меньше риск скачков артикуляции и мимики на стыках.
-
Какое выходное разрешение, можно ли получить 1080p?
У этой модели нет параметра разрешения, указать 1080p нельзя. Формат кадра и разрешение итогового видео соответствуют входному изображению с портретом: например, из портрета 960×960 получится видео 960×960; вертикальные и горизонтальные материалы можно использовать напрямую. Чтобы итоговое видео было чётче, используйте чёткое изображение с портретом и чистотой композицией и чистый звук.
-
Нужно ли использовать разные модели отдельно для закадрового голоса, пения и диалога?
Нет, одна и та же модель охватывает три типа аудио: закадровый голос, пение и диалог — отдельного режима пения нет. Артикуляция губ, мимика лица и движения тела синхронно меняются вслед за интонацией, ритмом, эмоциями и семантикой аудио, а для смены типа аудио достаточно заменить само аудио. Именно в этом заключается основное отличие по выразительности от ранних инструментов, которые выполняли только синхронизацию губ.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: omnihuman-2.0
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для omnihuman-2.0 и маршрута default — см. таблицу параметров ниже.
promptstringНеобязательноmaxLength 300Необязательный параметр для описания сцены, мимики, жестов и движения камеры, например, кивок с улыбкой или медленный наезд камеры.
audio_urlstringОбязательноАдрес аудио с голосом или пением для синхронизации губ; длительность видео равна длительности аудио, аудио должно быть длительностью от 4 до 300 секунд, в формате mp3 или wav, размером не более 15 МБ.
image_urlstringОбязательноАдрес портретного изображения человека для анимации, может быть реальным человеком или иллюстрированным персонажем; поддерживаются форматы jpeg, png, webp, размер не более 10 МБ, соотношение сторон должно быть от 0.4 до 2.5, длина стороны в пикселях от 300 до 6000; выходное видео сохраняет соотношение сторон и разрешение этого изображения.
callbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-2.0",
  "input": {
    "audio_url": "…",
    "image_url": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "omnihuman-2.0",
input: {
"audio_url": "…",
"image_url": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "omnihuman-2.0",
"input": {
"audio_url": "…",
"image_url": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →
Похожие модели
Все модели →Тот же тип
-
 Kling 4.0 Kuaishou $0.204 /секунду
-
 Kling 2.5 Kuaishou $0.090 /секунду
-
 FLUX 3 Max Black Forest Labs $0.121 /секунду
-
 Vidu Q4 Preview Vidu $0.051 /секунду
-
 Wan 2.7 Video Alibaba $0.100 /секунду
-
 Seedance 2.5 ByteDance $0.121 /секунду
-
 PixVerse V6 Max PixVerse $0.030 /секунду
-
 P-Video 2 Pro Avatar Pruna AI $0.029 /секунду
-
 Veo 3.1 Google $0.290 /секунду
-
 LTX 2.5 Fast Lightricks $0.086 /секунду
-
 Gemini Omni 1.2 Google $0.023 /секунду
-
 Kling 3.0 Turbo Kuaishou $0.144 /секунду