ByteDance
OmniHuman 2.0
omnihuman-2.0
ByteDanceの第2世代デジタルヒューマン動画モデル。人物またはキャラクターの画像1枚と音声または歌声を組み合わせるだけで、口元・表情・身体動作が音声に同期したパフォーマンス動画を生成可能。1回の連続ショットは最長5分で、プロンプトにより動作やカメラワークを制御できる
omnihuman-2.0 を試す
入力
作品ギャラリー
すべての作品を見る出力
video夜市の屋台店主の語りモノローグ
スタイル portrait-avatar · 屋台グルメ · リップシンク
参照入力
音声ドライブ
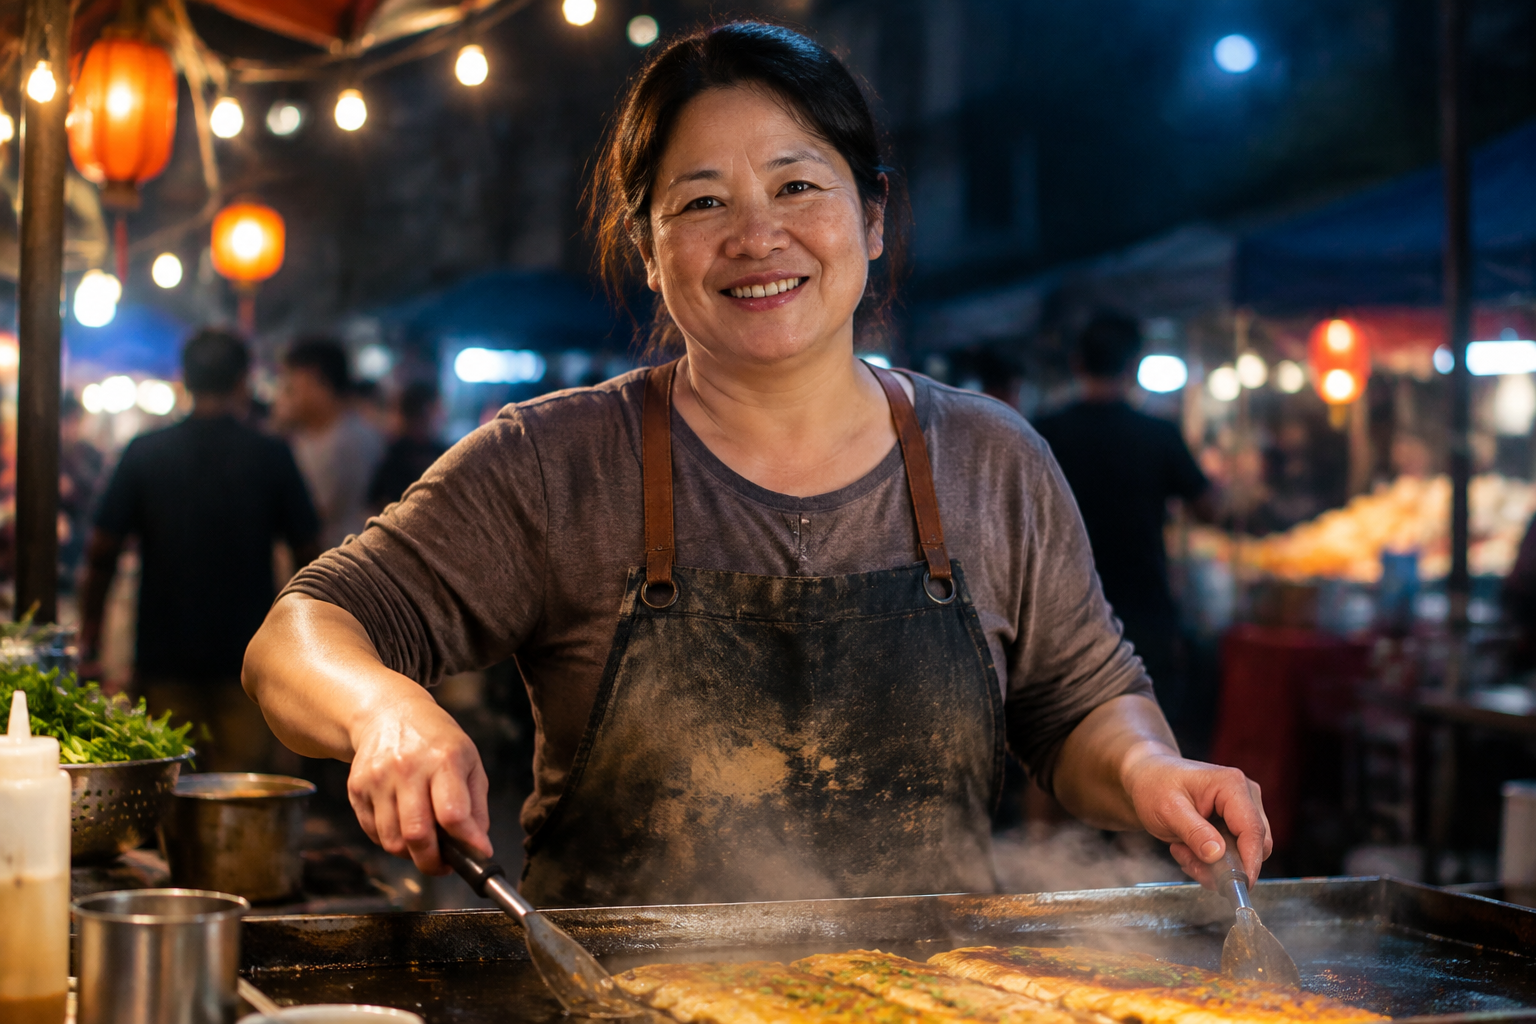
人物画像
プロンプト
夜市で、エプロンに小麦粉をいっぱいつけた屋台の店主が湯気の立つ鉄板の後ろに立ち、カメラに向かって話しかけ、温かく自然で親しみやすい笑顔を見せ、語気を強調するために小さなジェスチャーをし、背後にはストリングライトが吊るされ、蒸気がゆっくりと漂っている。カメラはゆっくりと柔らかく前方へ寄っていく。
完全なプロンプトをコピーして、自分の生成用にアレンジしてください。
タグ
本棚前の知識解説・デジタルヒューマンボイスオーバー
スタイル ナレーション · 教育 · スタジオポートレート
参照入力
音声ドライブ
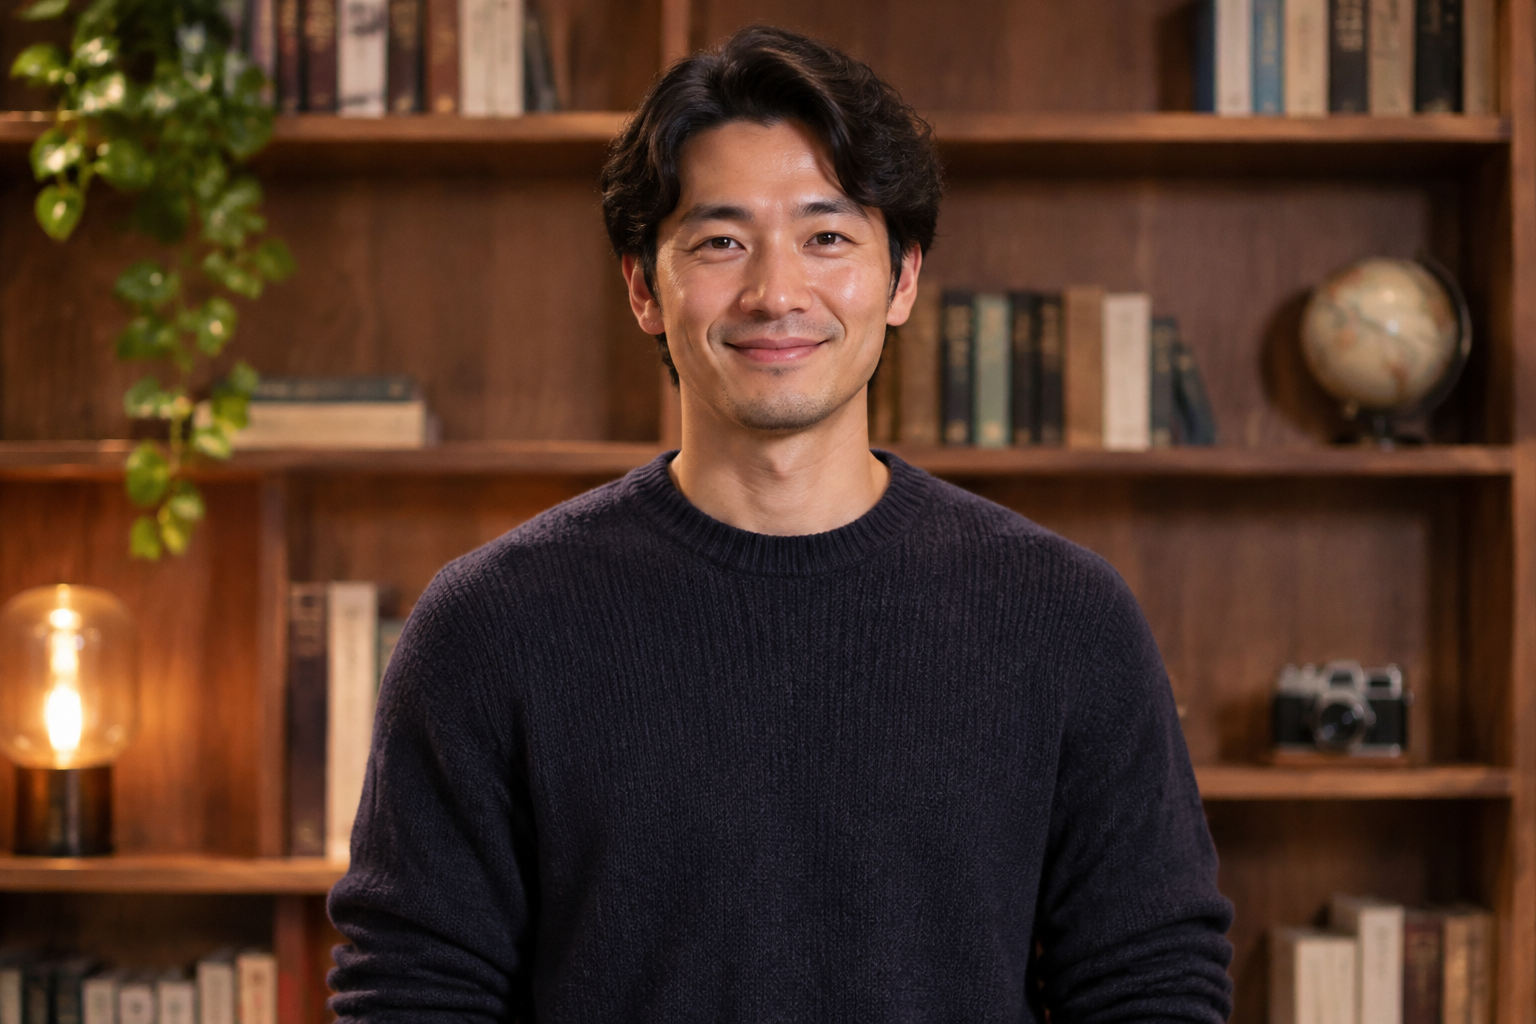
人物画像
プロンプト
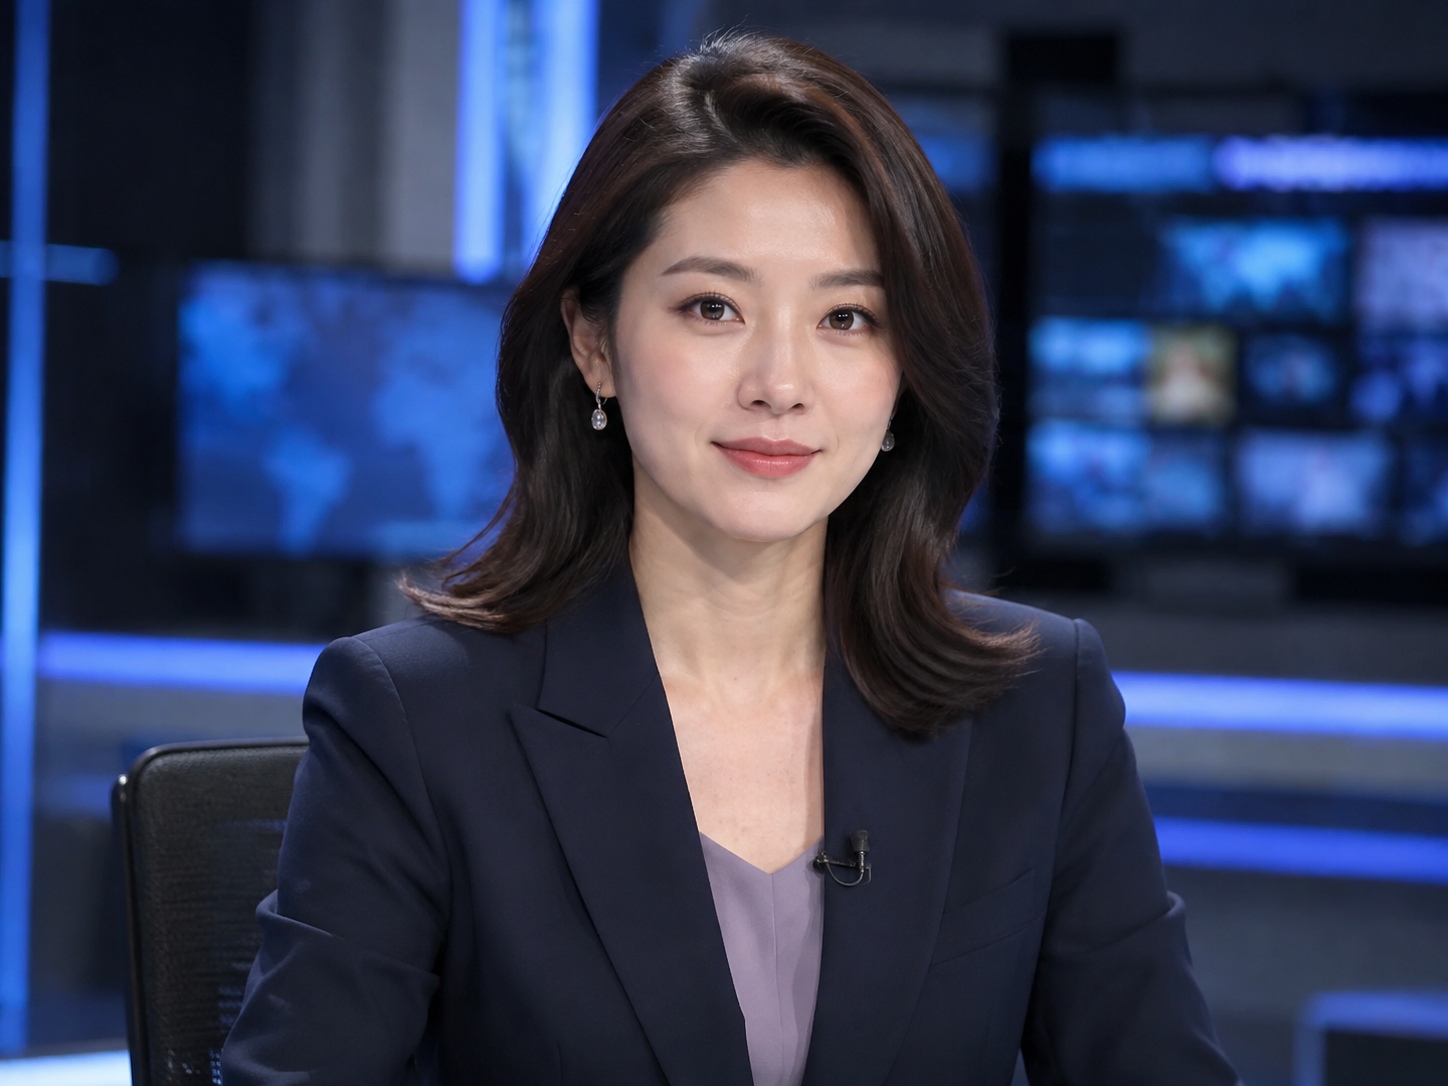
深色のニットセーターを着た落ち着いた表情の司会者が、暖かみのある木製の本棚の前に立ち、カメラに向かって語りかける。唇の動きは自然で、ジェスチャーは小さめ。カメラはミディアムショットからゆっくりと寄りのフレーミングへと進み、柔らかく温かなキーライトが照らす。
完全なプロンプトをコピーして、自分の生成用にアレンジしてください。
タグ
料金
omnihuman-2.0 per second
| 単価 | $0.100 |
|---|
位置づけの概要
これは音声駆動型のデジタルヒューマン動画生成モデルです。実写またはイラストキャラクターの画像と、音声または歌声を受け取り、音声と同期したパフォーマンス動画を出力します。動画の長さは音声に従い、映像は元画像のアスペクト比を維持します。任意でプロンプトを用いてシーン、表情、ジェスチャー、カメラワークを記述できます。キャラクターのナレーション、歌唱、対話のカットを必要とする開発者やコンテンツクリエイターに適しており、SNS向けショート動画、マーケティングの代言、デジタルヒューマンアプリにおけるキャラクター出演素材などに活用できます。
主なハイライト
- 音声駆動によるリップシンクと表情の同期——音声や歌声のリズムと語調に合わせて、口の動き、表情、身体の動きを生成し、動画の長さは音声と一致します。
- 画像から動画へ、元の比率を維持——キャラクター画像をアップロードするだけでパフォーマンス動画を生成でき、完成映像は画像のアスペクト比を引き継ぐため、既存のレイアウトにそのまま組み込めます。
- プロンプトによる演技とカメラワークの制御——任意のプロンプトでシーン、表情、ジェスチャー、ゆっくりとしたズームインなどのカメラ効果を記述できます。
- 1本の音声で数分間のパフォーマンスをカバー——駆動音声は4〜300秒に対応し、完成映像は音声に合わせて延長できるため、連続したナレーションや歌唱パートに適しています。
機能説明
画像と音声からキャラクター動画を生成:キャラクター画像と駆動音声を提供するだけで、そのキャラクターのパフォーマンス動画を生成できます。画像は実写またはイラストキャラクターに対応し、出力映像は元画像のアスペクト比を引き継ぎます。
リップシンクパフォーマンス:動画は駆動する音声や歌声をリズムとして、対応する口の動きと表情を生成します。ナレーション、台詞、歌唱系の素材に適しており、動画の長さは音声と一致します。
プロンプトによる演技とカメラの制御:任意のプロンプトは最大300文字までで、シーン、表情、ジェスチャー、カメラワークの記述に使用できます。
音声の長さ範囲:駆動音声はmp3またはwavで、長さ4〜300秒かつ15MB以下である必要があり、完成映像の長さはそれに対応するため、長い連続パフォーマンスの計画が容易です。
画像仕様の範囲:キャラクター画像はjpeg、png、webpに対応し、10MB以下、アスペクト比0.4〜2.5、各辺300〜6000ピクセルである必要があります。
適用シーン
- SNSナレーション動画クリエイター——配信者の人物画像と解説音声をアップロードし、キャラクターのナレーション動画を生成して、ソーシャルプラットフォームでのショート動画投稿やアカウントの日常更新にそのまま活用できます。
- バーチャル歌唱と音楽パフォーマンス——歌手やバーチャル形象の画像に楽曲音声を組み合わせ、キャラクターの歌唱映像を制作し、音楽系コンテンツのパフォーマンス素材として利用できます。
- マーケティング代言者ショートフィルム——ブランドイメージ画像に宣伝コピーの吹き替えを組み合わせ、代言者や司会者が出演するショートフィルムを生成し、広告やイベントページの表示に使用できます。
- デジタルヒューマンアプリ開発者——APIに接続してキャラクター画像と音声を一括送信し、動画制作アプリにデジタルヒューマンの出演カットを提供して、追加撮影や台詞カットの生成に活用できます。
制限と選定のアドバイス
駆動音声は必須入力であり、動画内容は音声によって駆動され、キャラクター画像も同時に提供する必要があります。入力音声の長さは4〜300秒の範囲である必要があり、4秒未満のタスクは失敗し全額返金されます。キャラクター画像は形式とサイズの要件を満たす必要があり、アスペクト比は0.4〜2.5、各辺300〜6000ピクセルです。プロンプトは任意項目で、最大300文字です。
最新情報
更新履歴を見る →- 新しいモデル OmniHuman 2.0 リリース:1枚のポートレートと1本の音声から、最長5分のトーキング動画を生成
よくある質問
よくある質問を見る →-
画像1枚と音声1本だけで動画が作れますか?
はい、このモデルの入力は人物画像1枚と駆動用音声1本で、必須項目は image_url と audio_url のみです。画像は jpeg、png、webp に対応し、1枚あたり10MB以下、アスペクト比は0.4から2.5の範囲、各辺300から6000ピクセルです。音声は mp3、wav に対応し、長さは4から300秒、15MB以下です。動画の内容は音声によって駆動され、長さは音声と同じで、完成した動画は画像のアスペクト比を維持します。
-
どのくらいの長さのデジタルヒューマン動画を生成できますか?
1回の連続ショットは最長5分、対応する音声の上限は300秒で、分割してつなぎ合わせる必要はありません。音声の最短は4秒で、4秒未満のタスクは失敗し全額返金されます。長い連続した演技を得たい場合は、完全なナレーションやセリフを1つの音声にまとめて提出する方が、分割生成してからつなぎ合わせるよりも手間がかからず、つなぎ目での口パクや表情の跳びも起きにくくなります。
-
出力解像度はいくつですか?1080p は出力できますか?
このモデルには解像度パラメータがなく、1080p を指定することはできません。出力される映像のアスペクト比と解像度は入力された人物画像に従い、例えば 960×960 の人物画像からは 960×960 の動画が生成され、縦向き・横向きの素材もそのまま使用できます。出力をより鮮明にしたい場合は、クリアで構図のすっきりした人物画像とクリーンな音声を使用してください。
-
ナレーション、歌唱、会話は別々のモデルを使い分ける必要がありますか?
いいえ、同じモデルでナレーション、歌唱、会話という3種類の音声をカバーでき、歌唱専用モードはありません。リップシンク、表情、体の動きは音声のイントネーション、リズム、感情、意味に合わせて同期的に変化し、音声の種類を変える場合は音声自体を差し替えるだけで済みます。これは、リップシンクの同期だけを行う初期のツールと比べた際の表現力における主な違いでもあります。
生成タスクの作成
https://api.hiapi.ai/v1/tasks ヘッダー
Authorizationstring必須アカウントの API キー。すべてのリクエストで必須です。例:Bearer YOUR_HIAPI_API_KEY。API キーを取得
Content-Typestring任意リクエストボディは常に JSON として解析されます。送信する場合は application/json(charset 付き可)のみ受け付け、他の値は 415 を返します。例:application/json。
Idempotency-Keystring任意冪等キー。最大 255 バイト。同じアカウントで同じキーの再試行はタスクを 1 つだけ作成し、リプレイは最初の taskId を返します。
ネットワークタイムアウトやクライアントの自動再試行時、同じキーではタスクを 1 回だけ作成し、二重課金は発生しません(適用範囲 = API キーのアカウント)。業務側の一意識別子(例:"order-42")をキーに使うことを推奨します。同じキーのリプレイは最初の taskId を返し、キーは初回送信から 24 時間で失効します。詳細なシナリオ表は統一非同期 API の紹介ページをご覧ください。
ボディ
modelstring必須現在の固定値:omnihuman-2.0
routestring任意現在の固定値:default
inputobject必須
omnihuman-2.0 とルート default の業務パラメータオブジェクト。下のパラメータ表を参照してください。
promptstring任意maxLength 300オプションのパラメータで、シーン、表情、ジェスチャー、カメラワークなどの画面演出を記述するために使用します。例えば、微笑みながらうなずく、ゆっくりとズームインするなどです。
audio_urlstring必須リップシンクを駆動するための音声または歌声のオーディオアドレス。動画の長さは音声と同じで、音声の長さは4~300秒、形式はmp3またはwav、サイズは15MB以下である必要があります。
image_urlstring必須駆動対象となる人物の肖像画像のアドレス。実在の人物またはイラストキャラクターが可能です。jpeg、png、webp形式に対応し、サイズは10MB以下、アスペクト比は0.4~2.5の範囲内、一辺のピクセル数は300~6000である必要があります。出力動画はこの画像のアスペクト比と解像度を引き継ぎます。
callbackobject任意
終了状態の通知設定。省略した場合はコールバックされず、呼び出し側でポーリングします。
作成時に callback.url を指定すると、タスク終了時に HiAPI があなたのサービスへ POST し、ポーリングが不要になります。コールバックのリクエストボディはタスク詳細と同構造です。署名検証・再送・冪等の詳細は統一非同期 API 紹介ページのコールバック説明を参照してください。
urlstring必須callback を指定する場合は必須。タスク終了後にこの URL へ POST します。有効な http(s) URL である必要があります。
whenstring任意デフォルト: "final"現在は final のみ対応(success / fail の両方で通知)。
finalstoragestring任意デフォルト: "temp"成果物の保存期間:temp(デフォルト・約 7 日)または persistent(長期保存・サイズ課金)。残高不足や保存上限超過の場合は temp に自動降格します。実際に適用された段階はタスク詳細レスポンスで確認できます。
temppersistentリクエスト例
# 非同期タスクを送信。成功すると即座に taskId を返します(生成完了は待ちません)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-2.0",
  "input": {
    "audio_url": "…",
    "image_url": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "omnihuman-2.0",
input: {
"audio_url": "…",
"image_url": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "omnihuman-2.0",
"input": {
"audio_url": "…",
"image_url": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
タスク詳細の取得
https://api.hiapi.ai/v1/tasks/:id レスポンスフィールド
taskIdstring必須タスク ID。先頭は固定で tk-hiapi-。
modelstring必須解決済みのモデル完全名。route パラメータで送信したタスクは base@route(例:gpt-image-2/text-to-image@ext)を返し、それ以外は送信時のモデル名と同一です。
routestring任意route パラメータを明示して送信したタスクでのみ出現し、送信時の値をエコーします。
statusstring必須タスク状態。
queued キュー投入済み、未開始。
handling 処理中。
archiving 処理完了、成果物準備中。
success 終端:完了。成果物利用可能(output を返却)。
fail 終端:失敗(error を返却)。
送信後は status で判断します:success と fail が終端、それ以外は非終端です。1〜3 秒間隔で終端までポーリングすることを推奨します。成功したら output[].url から成果物をダウンロードし、expireAt までに保存先へ転送してください。長期保存が必要な場合は作成時に storage: "persistent" を指定します。
creatednumber必須タスク作成時刻(Unix 秒)。
completednumber必須終了状態になった Unix 秒。非終端では 0 固定。
outputarray任意
status == success のときのみ出現。成果物リスト — 常に配列で、1 タスクで複数の type を同時に返すことがあります(例:video + first_frame)。
Array [ object ]
配列要素
urlstring必須成果物の URL。直接ダウンロードできます。
typestring必須現在の候補値:video、image、audio、first_frame、last_frame、thumbnail。今後拡張される可能性があります。
expireAtnumber必須成果物にアクセスできる期限(Unix 秒)。期限までにダウンロードまたは転送してください。
errorobject任意
status == fail のときのみ出現。
codestring必須業務エラーコード。
messagestring必須エラーの説明。
レスポンス例
成功
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
処理中(非終端)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
失敗
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}関連記事
すべての記事を見る →
関連モデル
すべてのモデルを見る →同タイプ
-
 Kling 3.0 Kuaishou $0.100 /秒
-
 Veo 3.1 Fast Google $0.170 /秒
-
 Kandinsky 6.0 Pro $1.93 /動画
-
 Hailuo 2.3 MiniMax $0.270 /動画
-
 HappyHorse 1.1 Alibaba $0.160 /秒
-
 Wan 2.6 Flash Alibaba $0.043 /秒
-
 P-Video 2 Pro Replace Pruna AI $0.036 /秒
-
 PixVerse V6 Max PixVerse $0.030 /秒
-
 Grok Imagine 1.5 Lite xAI $0.029 /秒
-
 Wan 3.0 Video Alibaba $0.040 /秒
-
 HappyHorse 1.0 Alibaba $0.168 /秒
-
 Kling 2.5 Kuaishou $0.090 /秒