ByteDance
OmniHuman 2.0
omnihuman-2.0
Modello video di digital human di seconda generazione di ByteDance: basta un'immagine di una persona o di un personaggio con una traccia vocale o un canto per generare un video performativo in cui labiale, espressioni e movimenti del corpo si sincronizzano con l'audio; una singola ripresa continua può durare fino a 5 minuti e si possono aggiungere prompt per controllare azioni e movimenti di camera
Prova omnihuman-2.0
Input
Creazioni
Vedi tutte le creazioniOutput
videoIl monologo di un venditore ambulante del mercato notturno
Stile portrait-avatar · Street food · sincronizzazione labiale
Input di riferimento
Audio di guida
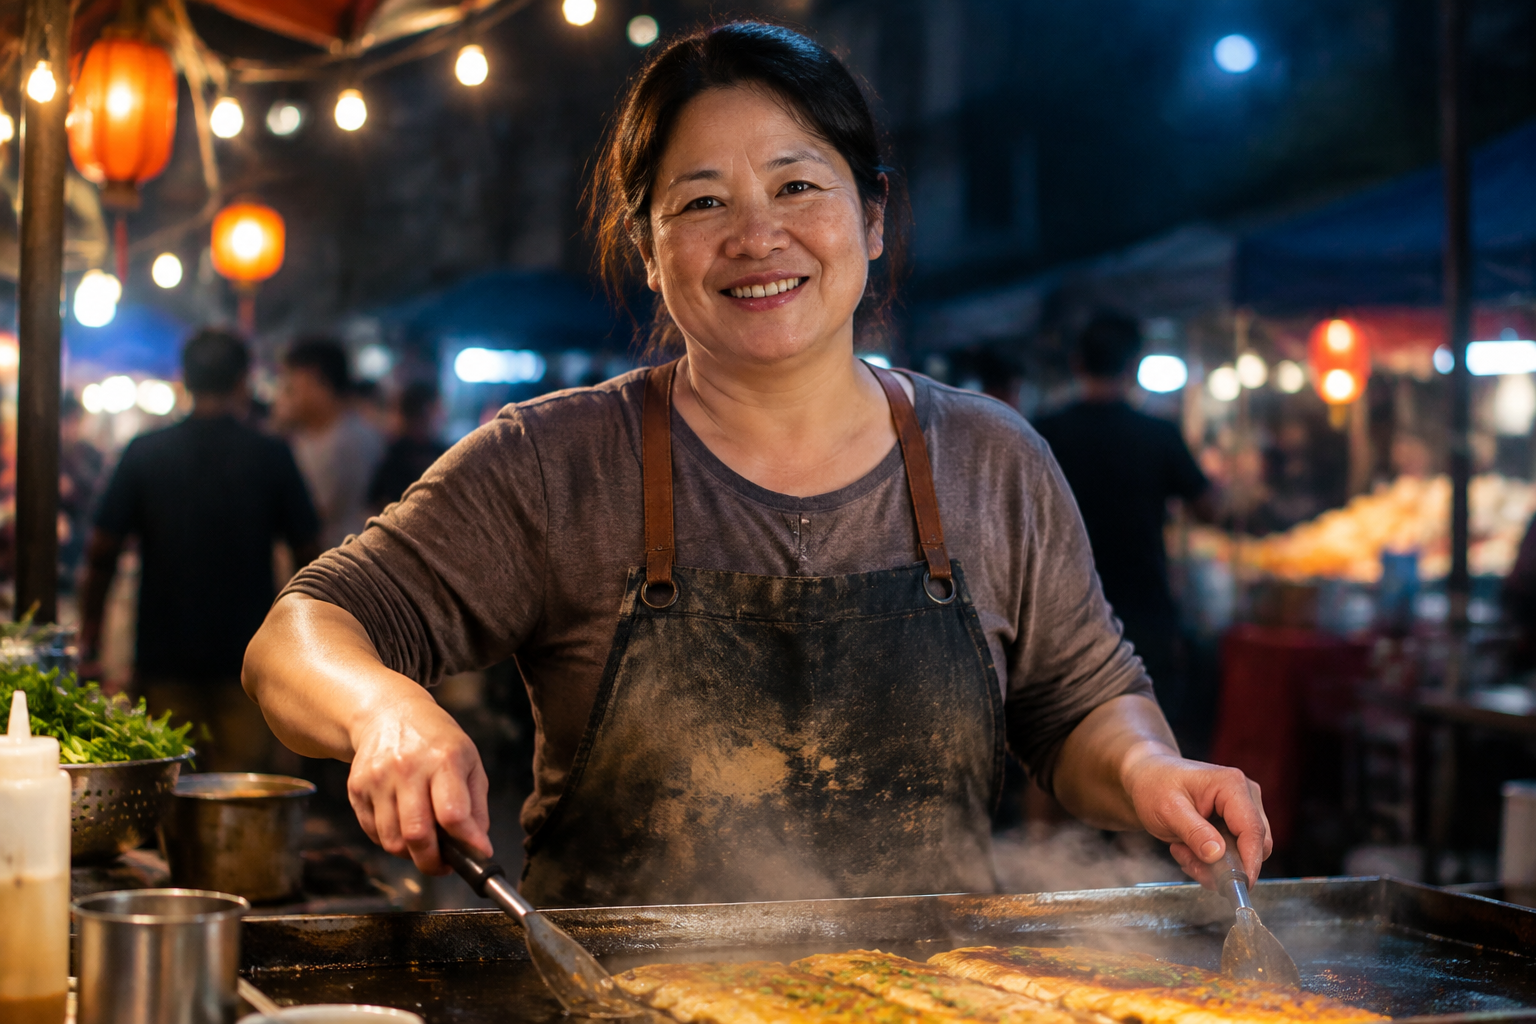
Immagine della persona
Prompt
In un mercato notturno, il gestore di uno street food con il grembiule sporco di farina sta dietro a una piastra fumante, parla verso la telecamera con un sorriso caldo, naturale e cordiale, fa un piccolo gesto per sottolineare il tono, dietro di lui sono appese catene di luci, il vapore si muove lentamente; la telecamera avanza lentamente e dolcemente.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Spiegazione davanti alla libreria · Presentatore digitale
Stile Voce fuori campo · Istruzione · Ritratto in studio
Input di riferimento
Audio di guida
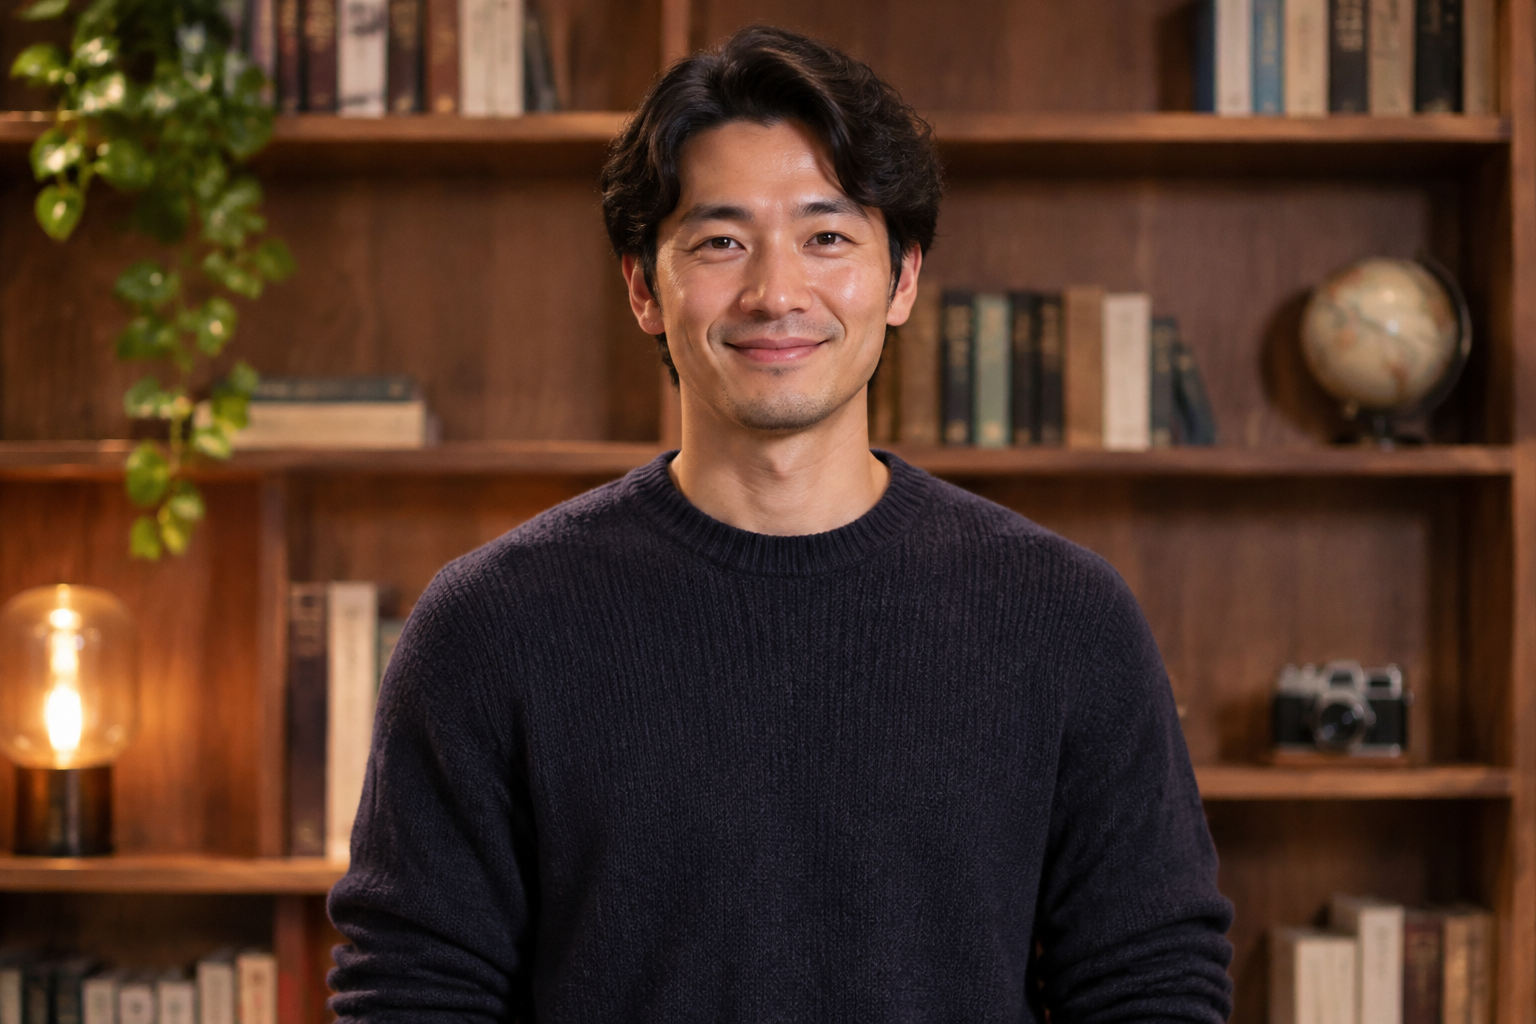
Immagine della persona
Prompt
Un presentatore dall'atteggiamento disinvolto, con un maglione in maglia scuro, sta davanti a una calda libreria in legno e parla alla telecamera; i movimenti delle labbra sono naturali, i gesti contenuti, la fotocamera si avvicina lentamente da un'inquadratura media a una più stretta, con una luce principale morbida e calda.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Studio notturno · Anchor digitale in voce
Stile Trasmissione · Voce fuori campo · Cinematografico
Input di riferimento
Audio di guida
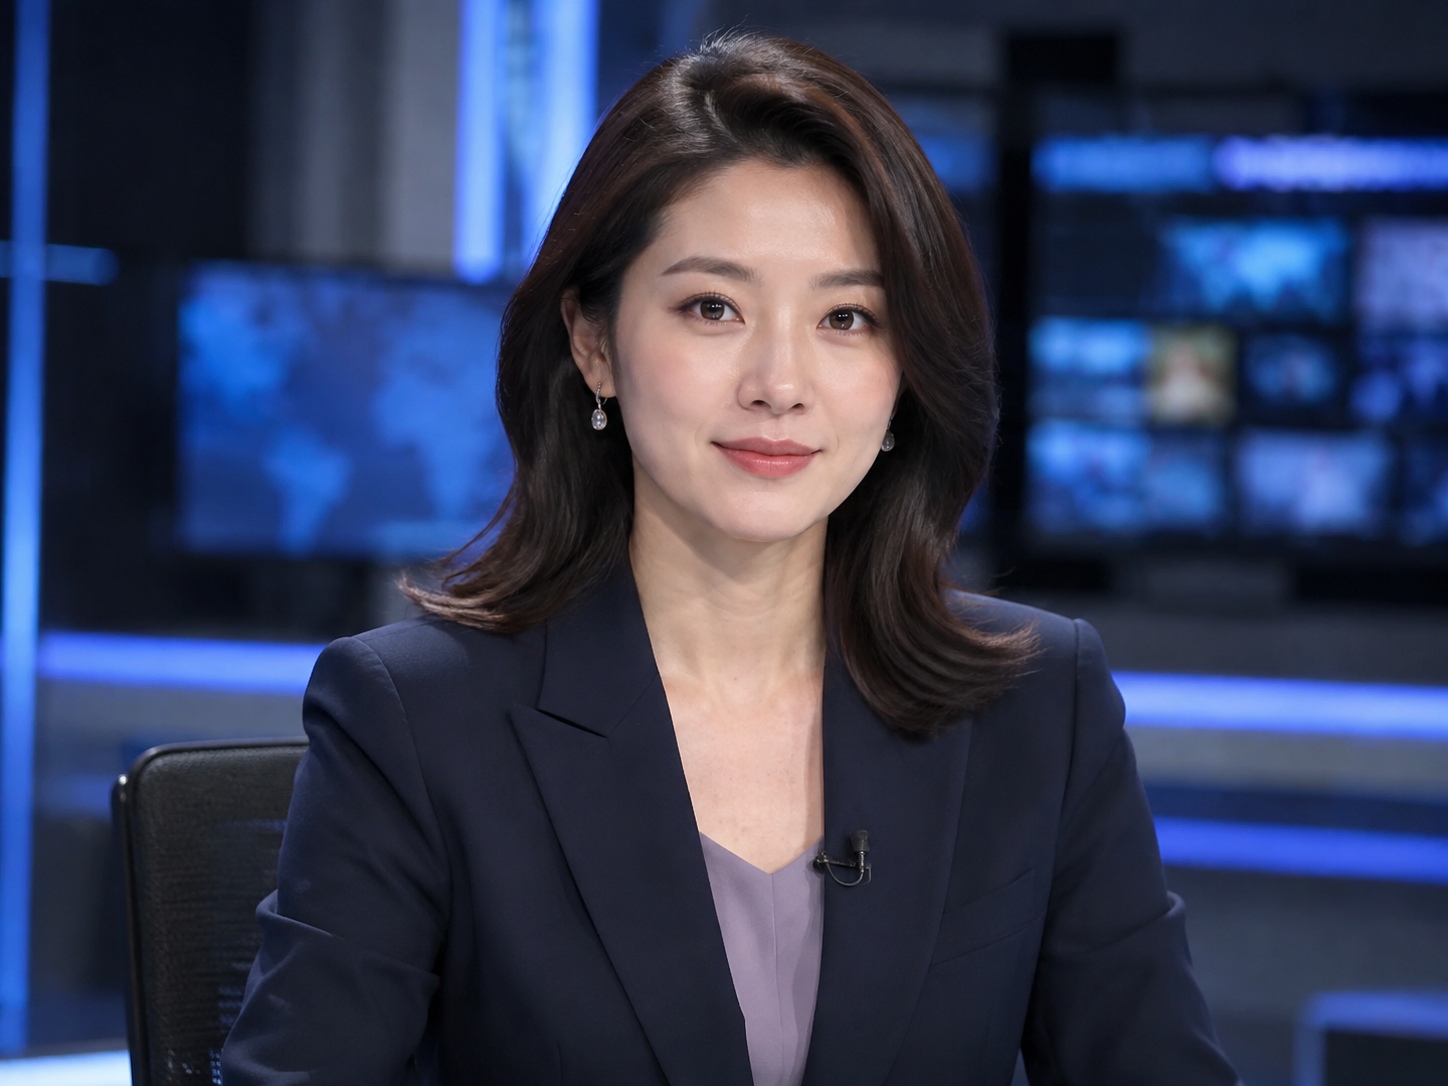
Immagine della persona
Prompt
La camera si avvicina lentamente a una conduttrice compassata che parla seduta al tavolo di uno studio in penombra; mentre il suo tono si fa malinconico, annuisce lievemente e la sua espressione si addolcisce; luci da studio blu freddo e ambra, una nitida qualità broadcast.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
omnihuman-2.0 per second
| Prezzo unitario | $0.100 |
|---|
Panoramica della posizione
Questo è un modello di generazione video di personaggi digitali guidato dall'audio: riceve un'immagine di una persona reale o di un personaggio illustrato e un file audio di parlato o canto, e restituisce un video di performance sincronizzato con l'audio. La durata del video segue quella dell'audio e l'immagine mantiene le proporzioni originali; è possibile usare un prompt opzionale per descrivere scena, espressioni, gesti e movimento di camera. È adatto a sviluppatori e creatori di contenuti che necessitano di inquadrature di personaggi che parlano, cantano o dialogano, per video brevi sui social, testimonial pubblicitari e materiali di recitazione di personaggi in applicazioni di digital human.
Punti di forza principali
- Sincronizzazione di labiale ed espressioni guidata dall'audio: genera labiale, espressioni e movimenti del corpo coerenti con il ritmo e il tono di parlato e canto; la durata del video coincide con quella dell'audio.
- Da immagine a video mantenendo le proporzioni originali: basta caricare l'immagine del personaggio per generare un video di performance; il risultato conserva le proporzioni dell'immagine, così da poter essere inserito direttamente nel layout esistente.
- Controllo della performance e del movimento di camera tramite prompt: un prompt opzionale descrive scena, espressioni, gesti ed effetti di camera come un lento avvicinamento.
- Una sola traccia audio per performance di più minuti: l'audio guida supporta da 4 a 300 secondi e il video può proseguire seguendo l'audio, adatto a segmenti continui di parlato o canto.
Descrizione delle capacità
Generazione di video di personaggi da immagine e audio: fornendo l'immagine del personaggio e l'audio guida si genera un video in cui il personaggio si esibisce; l'immagine può raffigurare una persona reale o un personaggio illustrato e il video in output mantiene le proporzioni dell'immagine originale.
Performance con labiale sincronizzato: il video genera labiale ed espressioni facciali corrispondenti al ritmo del parlato o del canto guida, adatto a materiali di narrazione, dialogo e canto; la durata del video coincide con quella dell'audio.
Controllo di performance e camera tramite prompt: il prompt opzionale può contenere fino a 300 caratteri ed è usato per descrivere scena, espressioni, gesti e movimento di camera.
Intervallo di durata dell'audio: l'audio guida deve essere in formato mp3 o wav, con durata da 4 a 300 secondi e non superiore a 15MB; la durata del video corrisponde a quella dell'audio, facilitando la pianificazione di lunghe performance continue.
Specifiche dell'immagine: l'immagine del personaggio supporta jpeg, png o webp, non supera 10MB, ha un rapporto d'aspetto compreso tra 0.4 e 2.5 e lati da 300 a 6000 pixel.
Scenari di utilizzo
- Creatori di video parlati per i social: caricando il ritratto di un conduttore e un audio esplicativo si genera un video con il personaggio che parla, da usare direttamente per la pubblicazione di video brevi sulle piattaforme social e per gli aggiornamenti quotidiani dell'account.
- Esibizioni vocali virtuali e performance musicali: con l'immagine di un cantante o di un avatar e l'audio di una canzone si producono scene di canto del personaggio, come materiale di performance per contenuti musicali.
- Clip con testimonial pubblicitari: abbinando l'immagine di un brand a una voce fuori campo con testo promozionale si generano clip con testimonial o conduttore in video, per annunci pubblicitari e pagine di eventi.
- Sviluppatori di applicazioni di digital human: tramite l'integrazione dell'API si inviano in batch immagini di personaggi e audio per fornire alle applicazioni di creazione video clip di digital human in scena, utili per riprese aggiuntive o per la generazione di inquadrature di dialogo.
Limiti e consigli per la scelta
L'audio guida è un input obbligatorio; il contenuto del video è guidato dall'audio ed è necessario fornire anche l'immagine del personaggio. La durata dell'audio in input deve essere compresa tra 4 e 300 secondi; le richieste inferiori a 4 secondi falliscono con rimborso totale. L'immagine del personaggio deve rispettare i requisiti di formato e dimensioni, con rapporto d'aspetto tra 0.4 e 2.5 e lati da 300 a 6000 pixel. Il prompt è opzionale e può contenere al massimo 300 caratteri.
Novità
Vedi il changelog →- Nuovo modello OmniHuman 2.0 è online: un ritratto e una traccia audio per generare video parlanti fino a 5 minuti
Domande frequenti
Vedi tutte le domande →-
È possibile generare un video fornendo solo un'immagine e una traccia audio?
Sì, l'input di questo modello è semplicemente un'immagine di una persona più una traccia audio di guida; i campi obbligatori sono solo image_url e audio_url. Le immagini supportano jpeg, png e webp, con una dimensione massima di 10MB per file, un rapporto d'aspetto compreso tra 0,4 e 2,5 e lati da 300 a 6000 pixel; l'audio supporta mp3 e wav, con una durata da 4 a 300 secondi e una dimensione massima di 15MB. Il contenuto del video è guidato dall'audio, la durata coincide con quella dell'audio e il video finale mantiene il rapporto d'aspetto dell'immagine.
-
Quanto può durare un video con avatar digitale?
La durata massima di un singolo piano sequenza è di 5 minuti, che corrisponde a un limite audio di 300 secondi, senza necessità di suddividere e ricomporre. L'audio deve durare almeno 4 secondi; le attività con audio inferiore a 4 secondi falliscono con rimborso completo. Per ottenere lunghe performance continue, è più semplice inviare l'intera narrazione o il dialogo in un unico file audio anziché generare segmenti separati e assemblarli, e si riduce il rischio di salti improvvisi nel labiale e nelle espressioni nei punti di giunzione.
-
Qual è la risoluzione di output? È possibile ottenere 1080p?
Questo modello non ha un parametro di risoluzione, quindi non è possibile specificare 1080p. Il formato e la risoluzione del video finale seguono l'immagine del ritratto in input: ad esempio, un ritratto da 960×960 produrrà un video da 960×960, e i materiali sia verticali che orizzontali possono essere usati direttamente. Per ottenere un video più nitido, usa un'immagine del ritratto nitida e con una composizione pulita e un audio pulito.
-
La narrazione, il canto e il dialogo richiedono modelli diversi separati?
No, lo stesso modello copre tre tipi di audio: narrazione, canto e dialogo; non esiste una modalità di canto separata. Il movimento delle labbra, le espressioni facciali e i movimenti del corpo cambiano in sincronia con l'intonazione, il ritmo, l'emozione e la semantica dell'audio; per cambiare il tipo di audio basta cambiare l'audio stesso. Questa è anche la principale differenza in termini di espressività rispetto ai primi strumenti che si limitavano ad allineare il movimento delle labbra.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: omnihuman-2.0
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per omnihuman-2.0 e la route default — vedi la tabella dei parametri sotto.
promptstringOpzionalemaxLength 300Parametro opzionale, utilizzato per descrivere la scena, le espressioni, i gesti e i movimenti di camera, ad esempio annuire sorridendo o un lento avvicinamento.
audio_urlstringObbligatorioIndirizzo audio vocale o canoro utilizzato per guidare la sincronizzazione labiale; la durata del video è uguale a quella dell'audio, che deve essere compresa tra 4 e 300 secondi, in formato mp3 o wav, con dimensione non superiore a 15MB.
image_urlstringObbligatorioIndirizzo del ritratto della persona da animare, che può essere una persona reale o un personaggio illustrato; supporta i formati jpeg, png, webp, con dimensione non superiore a 10MB, rapporto larghezza-altezza compreso tra 0.4 e 2.5, pixel per lato da 300 a 6000; il video di output mantiene il rapporto larghezza-altezza e la risoluzione dell'immagine.
callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-2.0",
  "input": {
    "audio_url": "…",
    "image_url": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "omnihuman-2.0",
input: {
"audio_url": "…",
"image_url": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "omnihuman-2.0",
"input": {
"audio_url": "…",
"image_url": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Vidu Q3 Vidu $0.149 /secondo
-
 Wan 2.7 Video Alibaba $0.100 /secondo
-
 P-Video 2 Pro Avatar Pruna AI $0.029 /secondo
-
 Kling 3.0 Kuaishou $0.100 /secondo
-
 MiniMax H3 MiniMax $0.072 /secondo
-
 PixVerse V6 PixVerse $0.036 /secondo
-
 FLUX 3 Video Black Forest Labs $0.090 /secondo
-
 HappyHorse 1.1 Alibaba $0.160 /secondo
-
 Kandinsky 6.0 Pro $1.93 /video
-
 Ray 3.2 Luma $0.214 /video
-
 Vidu Q4 Preview Vidu $0.051 /secondo
-
 Kling 4.0 Kuaishou $0.204 /secondo