ByteDance
OmniHuman 2.0
omnihuman-2.0
Die Digitalhuman-Videomodell der zweiten Generation von ByteDance: Mit einem Bild einer Person oder Figur und einer Sprach- oder Gesangsaufnahme lässt sich ein Performance-Video erzeugen, in dem Lippenbewegungen, Mimik und Körperbewegungen synchron zum Audio ablaufen. Eine durchgehende Einstellung kann bis zu 5 Minuten lang sein, und Aktionen sowie Kameraführung lassen sich über Prompts steuern.
omnihuman-2.0 ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
videoDas gesprochene Monolog eines Nachtmarktstand-Betreibers
Stil Porträt-Avatar · Streetfood · Lip-Sync
Referenz-Eingaben
Audiospur
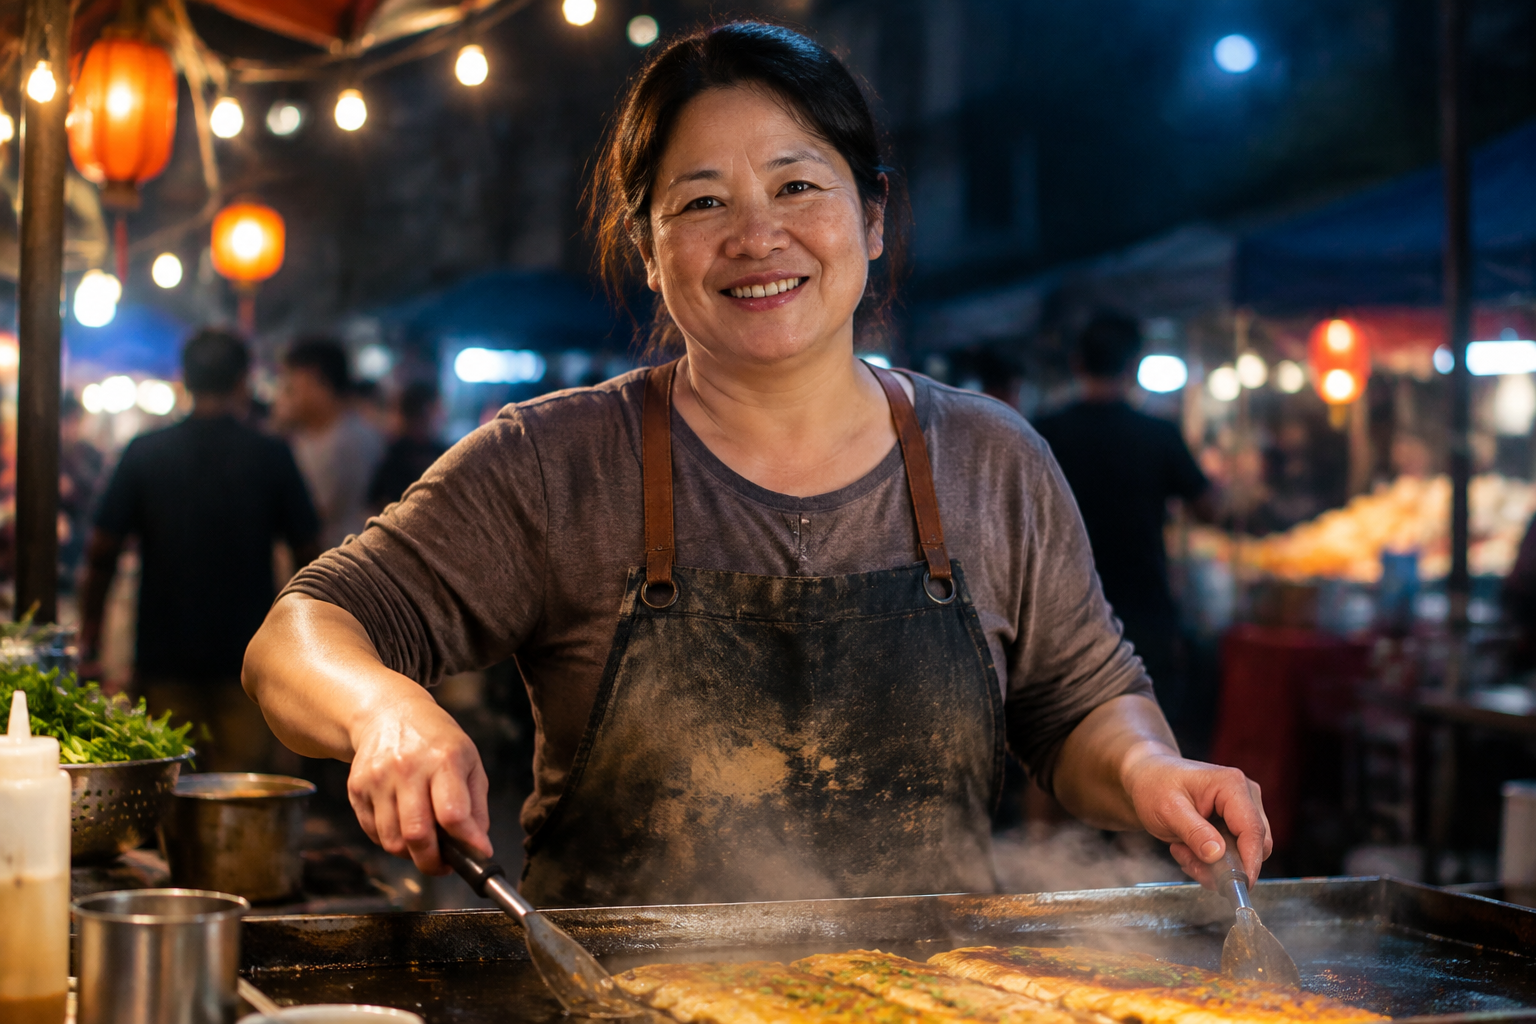
Personenbild
Prompt
Auf einem Nachtmarkt steht ein Straßenimbiss-Standbetreiber mit mehlbestäubter Schürze hinter einer dampfenden Eisenplatte, blickt in die Kamera und spricht, zeigt ein warmes, natürliches und freundliches Lächeln und macht eine kleine Handbewegung, um seine Betonung zu unterstreichen; hinter ihm hängen Lichterketten, Dampf zieht langsam dahin; die Kamera fährt langsam und sanft nach vorn heran.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Wissensvermittlung vor dem Bücherregal · Digitaler Avatar-Sprecher
Stil Sprechtext · Bildung · Studioporträt
Referenz-Eingaben
Audiospur
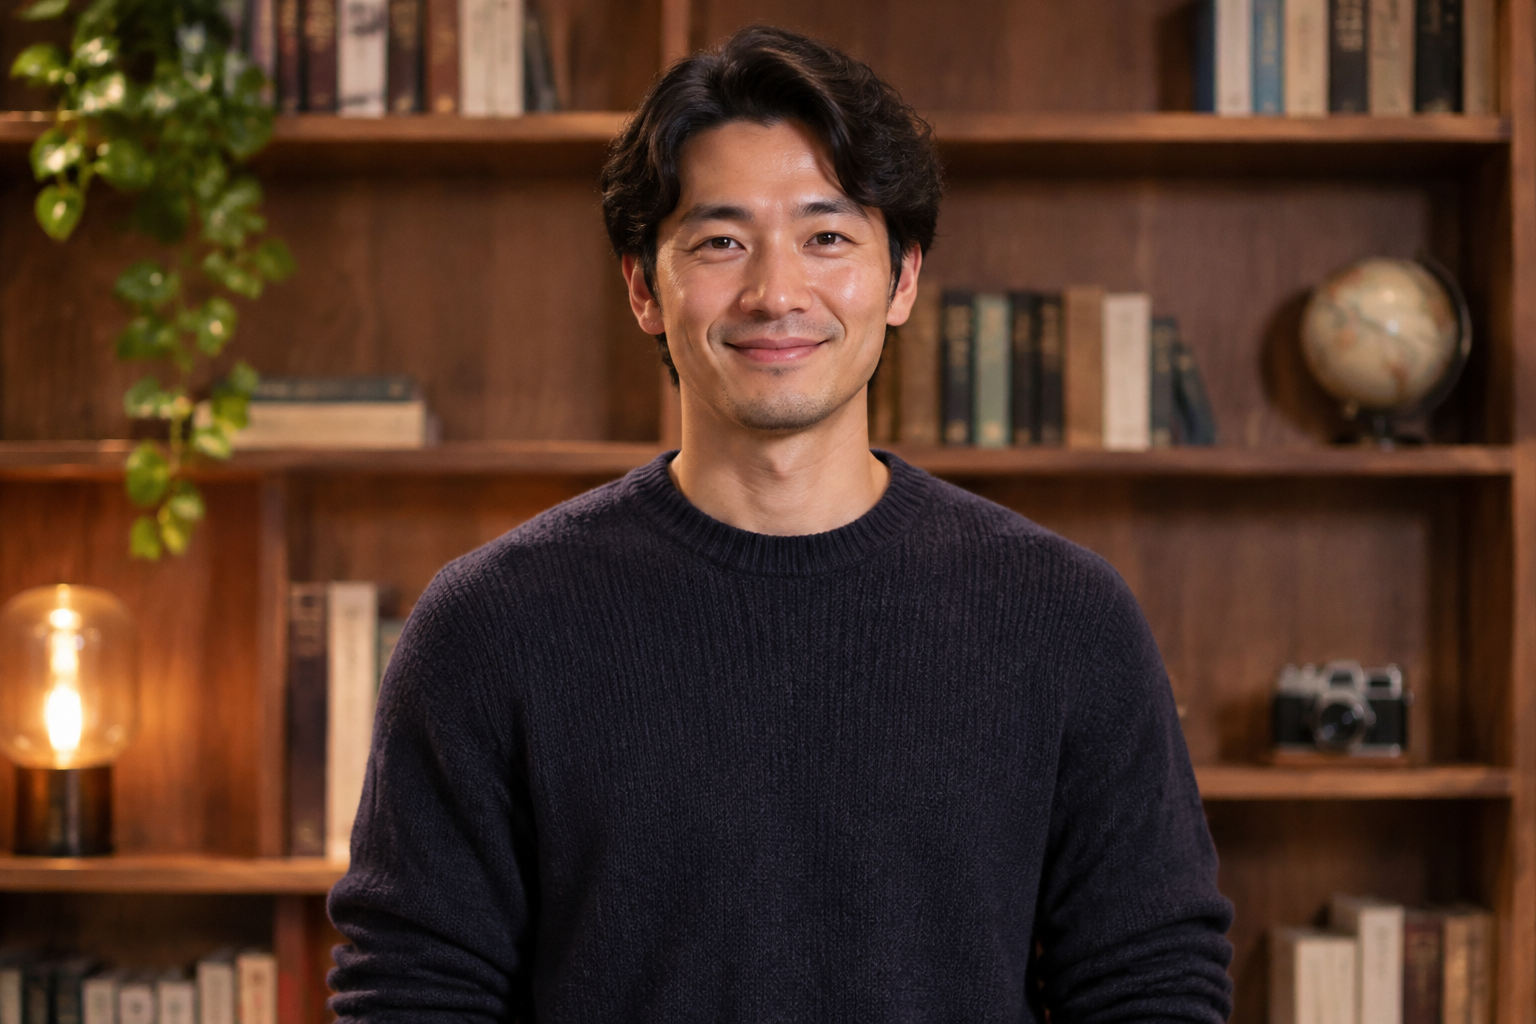
Personenbild
Prompt
Eine gelassene Moderatorin in einem dunklen Strickpullover steht vor einem warmen Holzregal und spricht in die Kamera; natürliche Lippenbewegungen, kleine Gesten, die Kamera fährt langsam von einer mittleren Einstellung auf eine nähere Bildkomposition zu, weiches und warmes Hauptlicht.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Spätes Studio · Digitaler Nachrichtensprecher mit Sprecher-Over
Stil Rundfunk · Sprechtext · Filmisch
Referenz-Eingaben
Audiospur
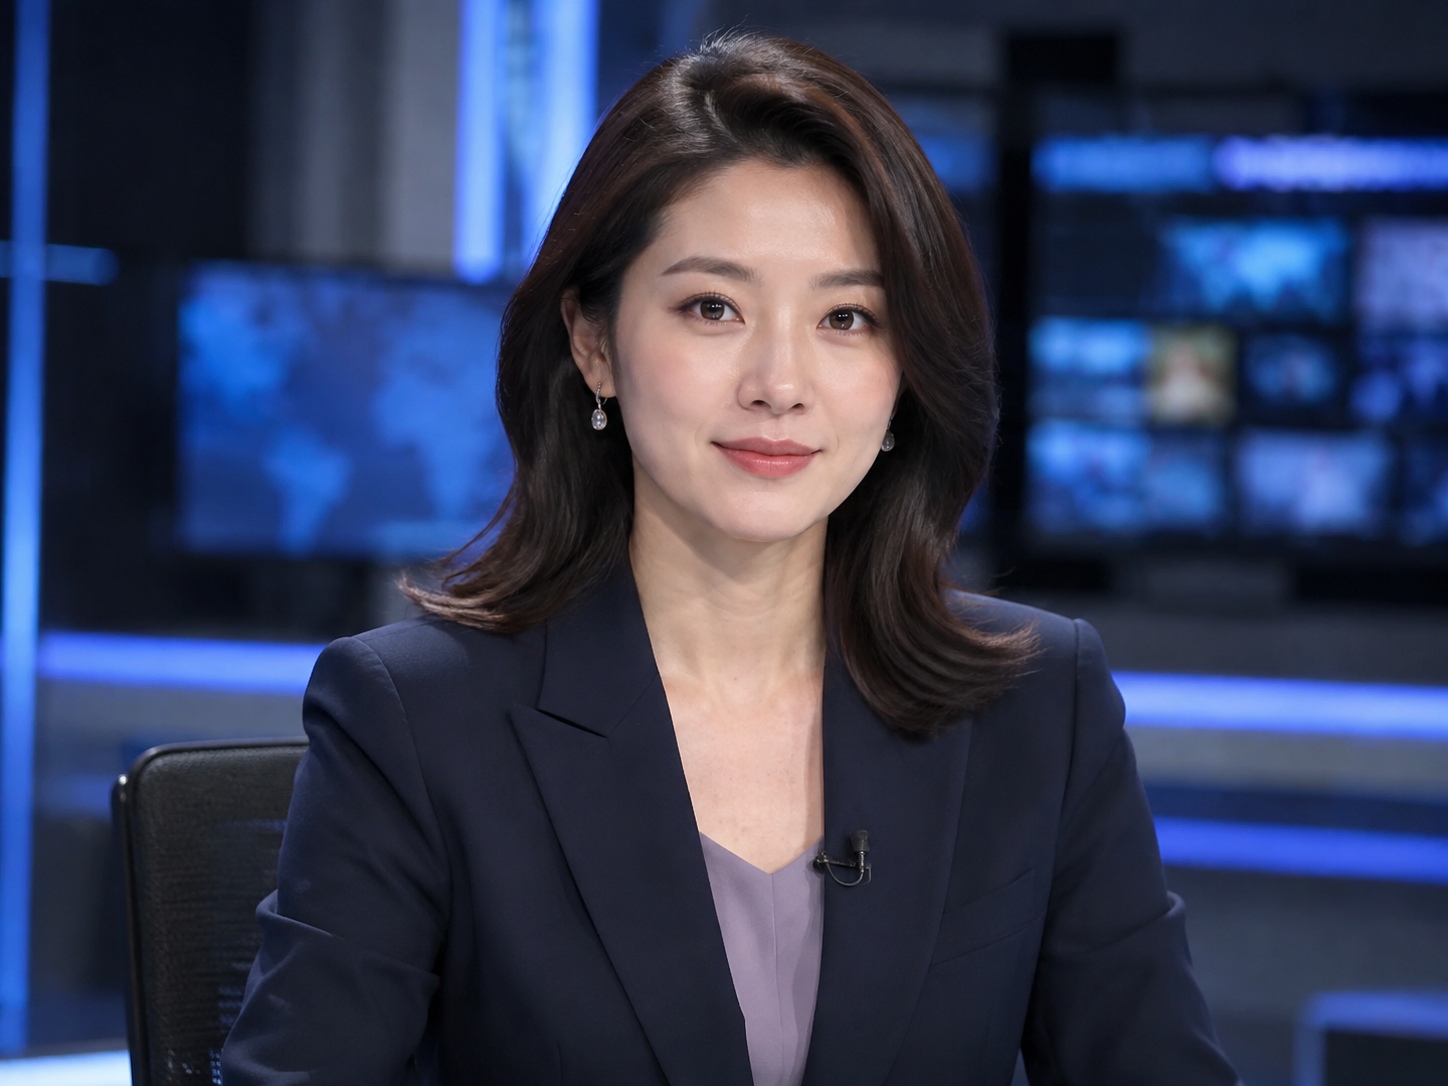
Personenbild
Prompt
Die Kamera fährt langsam auf eine besonnene Nachrichtensprecherin zu, die an einem Tisch in einem schwach beleuchteten Studio sitzt und spricht; als ihr Ton nachdenklich wird, nickt sie leicht und ihr Gesichtsausdruck wird sanft; kaltblaues und bernsteinfarbenes Studiolicht, klare Broadcast-Anmutung.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
omnihuman-2.0 per second
| Einzelpreis | $0.100 |
|---|
Positionierung und Kurzprofil
Dies ist ein audiogesteuertes Modell zur Erzeugung von Digital-Human-Videos. Es erhält ein Bild einer realen Person oder einer illustrierten Figur sowie eine Sprach- oder Gesangsaufnahme und gibt ein zur Audiospur synchrones Performance-Video aus. Die Videolänge richtet sich nach der Audiodauer, und das Bild behält das Seitenverhältnis des Ausgangsbildes bei. Optional kann ein Prompt zur Beschreibung von Szene, Mimik, Gestik und Kamerabewegung angegeben werden. Geeignet für Entwickler und Content-Creator, die Sprecher-, Gesangs- oder Dialogaufnahmen mit Charakteren benötigen – etwa für kurze Social-Media-Videos, Marketing-Botschafter oder Charakterauftritte in Digital-Human-Anwendungen.
Kernhighlights
- Audiogesteuerte Synchronisation von Lippenbewegungen und Mimik – passend zu Rhythmus und Tonfall von Sprache und Gesang werden Lippenbewegungen, Mimik und Körperbewegungen erzeugt; die Videolänge entspricht der Audiodauer.
- Bild-zu-Video unter Beibehaltung des Seitenverhältnisses – laden Sie ein Charakterbild hoch, um ein Performance-Video zu erzeugen; das fertige Video übernimmt das Seitenverhältnis des Bildes und lässt sich direkt in bestehende Layouts einbetten.
- Steuerung von Performance und Kameraführung per Prompt – ein optionaler Prompt beschreibt Szene, Mimik, Gestik und Kameraeffekte wie langsames Heranfahren.
- Mehrere Minuten Performance mit einer einzigen Audiospur – das treibende Audio kann 4 bis 300 Sekunden lang sein, und das fertige Video kann der Audiospur folgen; ideal für zusammenhängende Sprech- oder Gesangsabschnitte.
Funktionsbeschreibung
Charaktervideo aus Bild und Audio: Mit einem Charakterbild und treibendem Audio lässt sich ein Video der Performance dieses Charakters erzeugen. Das Bild kann eine reale Person oder eine illustrierte Figur zeigen; die Ausgabe übernimmt das Seitenverhältnis des Ausgangsbildes.
Performance mit Lippensynchronisation: Das Video erzeugt passend zum Rhythmus der treibenden Sprache oder des Gesangs entsprechende Lippenbewegungen und Gesichtsausdrücke. Geeignet für Off-Kommentare, Dialoge und Gesangsaufnahmen; die Videolänge entspricht der Audiodauer.
Steuerung von Performance und Kamera per Prompt: Ein optionaler Prompt von bis zu 300 Zeichen beschreibt Szene, Mimik, Gestik und Kamerabewegung.
Bereich der Audiolänge: Das treibende Audio muss im Format mp3 oder wav vorliegen, 4 bis 300 Sekunden lang sein und darf 15 MB nicht überschreiten. Die Länge des fertigen Videos entspricht dem Audio, was die Planung längerer zusammenhängender Performances erleichtert.
Bereich der Bildspezifikationen: Das Charakterbild kann im Format jpeg, png oder webp vorliegen, darf 10 MB nicht überschreiten, muss ein Seitenverhältnis zwischen 0,4 und 2,5 aufweisen und pro Seite 300 bis 6000 Pixel groß sein.
Anwendungsszenarien
- Creator von Social-Media-Sprechvideos – laden Sie ein Porträt der moderierenden Person und ein Erklär-Audio hoch, um ein Sprechvideo des Charakters zu erzeugen, das direkt für die Veröffentlichung von Kurzvideos auf sozialen Plattformen und die regelmäßige Aktualisierung von Konten genutzt werden kann.
- Virtueller Gesang und Musikauftritte – kombinieren Sie ein Bild einer Sängerin oder eines Sängers bzw. einer virtuellen Figur mit einem Song-Audio, um Gesangsaufnahmen des Charakters als Performance-Material für Musikinhalte zu erzeugen.
- Kurzfilme mit Marketing-Botschaftern – kombinieren Sie ein Markenbild mit einer Vertonung des Werbetexts, um einen Kurzfilm mit Botschafter oder Moderator zu erzeugen, der in Anzeigen und auf Aktionsseiten präsentiert wird.
- Entwickler von Digital-Human-Anwendungen – binden Sie die Schnittstelle an, um Charakterbilder und Audios im Batch zu übermitteln und Anwendungen zur Videogenerierung mit Digital-Human-Auftritten zu versorgen, etwa für Nachdrehs oder Dialogaufnahmen.
Einschränkungen und Auswahlhinweise
Das treibende Audio ist eine erforderliche Eingabe, und der Videoinhalt wird durch das Audio gesteuert; zusätzlich muss ein Charakterbild bereitgestellt werden. Die Dauer des eingegebenen Audios muss zwischen 4 und 300 Sekunden liegen; Aufgaben unter 4 Sekunden schlagen fehl und werden vollständig erstattet. Das Charakterbild muss die Format- und Größenanforderungen erfüllen: Seitenverhältnis zwischen 0,4 und 2,5 sowie 300 bis 6000 Pixel pro Seite. Der Prompt ist optional und darf höchstens 300 Zeichen lang sein.
Neuigkeiten
Changelog ansehen →- Neues Modell OmniHuman 2.0 ist online: Ein Porträt plus eine Audiodatei erzeugen ein sprechendes Video mit bis zu 5 Minuten Länge
Häufige Fragen
Alle Fragen ansehen →-
Reicht ein einziges Bild plus eine Audiodatei, um ein Video zu erzeugen?
Ja, die Eingabe für dieses Modell besteht aus einem Personenbild und einer Antriebsaudiodatei; Pflichtfelder sind nur image_url und audio_url. Bilder werden in jpeg, png und webp unterstützt, jeweils maximal 10MB, mit einem Seitenverhältnis zwischen 0.4 und 2.5 und 300 bis 6000 Pixeln pro Seite; Audio wird in mp3 und wav unterstützt, mit einer Dauer von 4 bis 300 Sekunden und maximal 15MB. Der Videoinhalt wird durch das Audio gesteuert, die Länge entspricht der des Audios, und das fertige Video behält das Seitenverhältnis des Bildes bei.
-
Wie lange können digitale Humanvideos erzeugt werden?
Ein einzelner durchgehender Clip kann bis zu 5 Minuten lang sein, entsprechend einem Audio-Maximum von 300 Sekunden, ohne dass eine segmentierte Aneinanderreihung nötig ist. Das Audio muss mindestens 4 Sekunden lang sein; Aufgaben mit weniger als 4 Sekunden schlagen fehl und werden vollständig erstattet. Wenn Sie eine lange durchgehende Performance wünschen, reichen Sie die vollständige Erzählung oder den Dialog in einer einzigen Audiodatei ein – das ist einfacher als die segmentierte Generierung mit anschließendem Zusammensetzen und es treten seltener Sprünge bei Mundbewegungen und Mimik an den Übergängen auf.
-
Welche Ausgabeauflösung gibt es, ist 1080p möglich?
Dieses Modell hat keinen Auflösungsparameter, 1080p lässt sich nicht vorgeben. Bildformat und Auflösung des fertigen Videos richten sich nach dem eingegebenen Porträtbild – ein Porträt mit 960×960 ergibt beispielsweise ein Video mit 960×960; Hochformat- und Querformatmaterial lassen sich beide direkt verwenden. Für ein schärferes Ergebnis verwenden Sie ein klares Porträtbild mit sauberer Bildkomposition und eine saubere Audiospur.
-
Müssen für Off-Kommentar, Gesang und Dialog unterschiedliche Modelle verwendet werden?
Nein, dasselbe Modell deckt alle drei Audioarten ab – Off-Kommentar, Gesang und Dialog –, es gibt keinen separaten Gesangsmodus. Lippenbewegungen, Gesichtsausdruck und Körperbewegungen passen sich synchron an Intonation, Rhythmus, Emotion und Semantik des Audios an; um die Audioart zu wechseln, muss nur die Audiodatei selbst ausgetauscht werden. Darin liegt auch der wesentliche Unterschied in der Ausdrucksstärke gegenüber früheren Werkzeugen, die nur eine Lippen-Synchronisation durchführten.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: omnihuman-2.0
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für omnihuman-2.0 und Route default — siehe Parametertabelle unten.
promptstringOptionalmaxLength 300Optionaler Parameter zur Beschreibung der Bilddarstellung, z. B. von Szene, Mimik, Gestik und Kamerabewegung – etwa lächelnd nicken oder langsam heranfahren.
audio_urlstringPflichtAdresse der Sprach- oder Gesangs-Audiodatei zur Steuerung der Lippen synchronisation; die Videolänge entspricht der Audiolänge, die Audiodauer muss zwischen 4 und 300 Sekunden liegen, das Format ist mp3 oder wav, die Dateigröße darf 15MB nicht überschreiten.
image_urlstringPflichtAdresse des Porträtbildes der zu animierenden Person, das eine echte Person oder eine illustrierte Figur sein kann; unterstützt werden die Formate jpeg, png und webp, die Dateigröße darf 10MB nicht überschreiten, das Seitenverhältnis muss zwischen 0,4 und 2,5 liegen, die Kantenlänge beträgt 300 bis 6000 Pixel, und das Ausgabevideo übernimmt Seitenverhältnis und Auflösung dieses Bildes.
callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-2.0",
  "input": {
    "audio_url": "…",
    "image_url": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "omnihuman-2.0",
input: {
"audio_url": "…",
"image_url": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "omnihuman-2.0",
"input": {
"audio_url": "…",
"image_url": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Veo 3.1 Fast Google $0.170 /Sekunde
-
 Vidu Q3 Vidu $0.149 /Sekunde
-
 Seedance 2.0 ByteDance $0.017 /Sekunde
-
 Ray 3.2 Luma $0.214 /Video
-
 Gemini Omni 1.2 Google $0.023 /Sekunde
-
 Creatify Boreal Creatify $0.015 /Sekunde
-
 P-Video 2 Pro Avatar Pruna AI $0.029 /Sekunde
-
 Runway Gen 4.5 Runway $0.172 /Sekunde
-
 HeyGen Avatar IV HeyGen $0.150 /Sekunde
-
 Wan 2.6 Flash Alibaba $0.043 /Sekunde
-
 Kandinsky 6.0 Pro $1.93 /Video
-
 Kling 4.0 Flash Kuaishou $0.122 /Sekunde