ByteDance
OmniHuman 2.0
omnihuman-2.0
Modèle de vidéo d’avatar numérique de deuxième génération de ByteDance : à partir d’une seule image de personne ou de personnage accompagnée d’un enregistrement vocal ou d’un chant, il génère une vidéo de performance où la synchronisation labiale, les expressions et les mouvements du corps suivent l’audio, avec un plan continu allant jusqu’à 5 minutes et la possibilité d’ajouter des prompts pour contrôler les actions et les mouvements de caméra.
Essayer omnihuman-2.0
Entrée
Créations
Voir toutes les créationsSortie
videoMonologue face caméra d'un vendeur de marché nocturne
Style portrait-avatar · Cuisine de rue · synchronisation labiale
Entrées de référence
Audio pilote
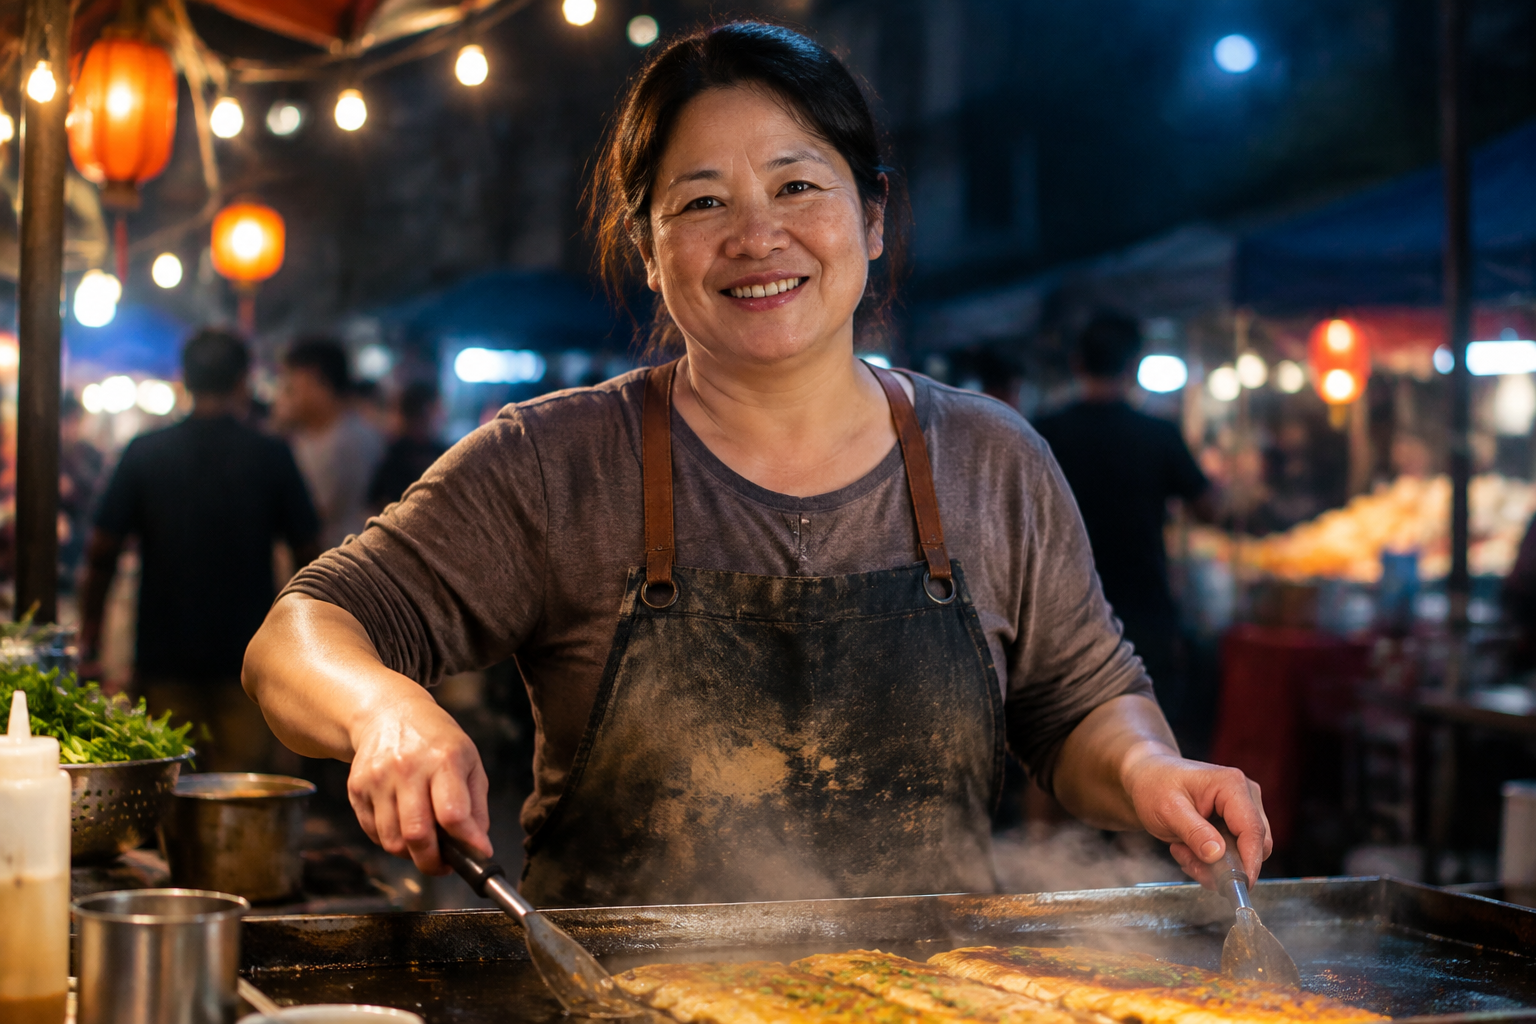
Image de personnage
Prompt
Dans un marché nocturne, un vendeur de street food, tablier couvert de farine, se tient derrière une plaque chauffante fumante, face à la caméra, arborant un sourire chaleureux, naturel et avenant, et esquisse un petit geste pour souligner son propos ; derrière lui sont suspendues des guirlandes lumineuses et la vapeur flotte lentement ; la caméra avance lentement et doucement vers lui.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Explication devant la bibliothèque · présentation par avatar numérique
Style Voix off · Éducation · Portrait de studio
Entrées de référence
Audio pilote
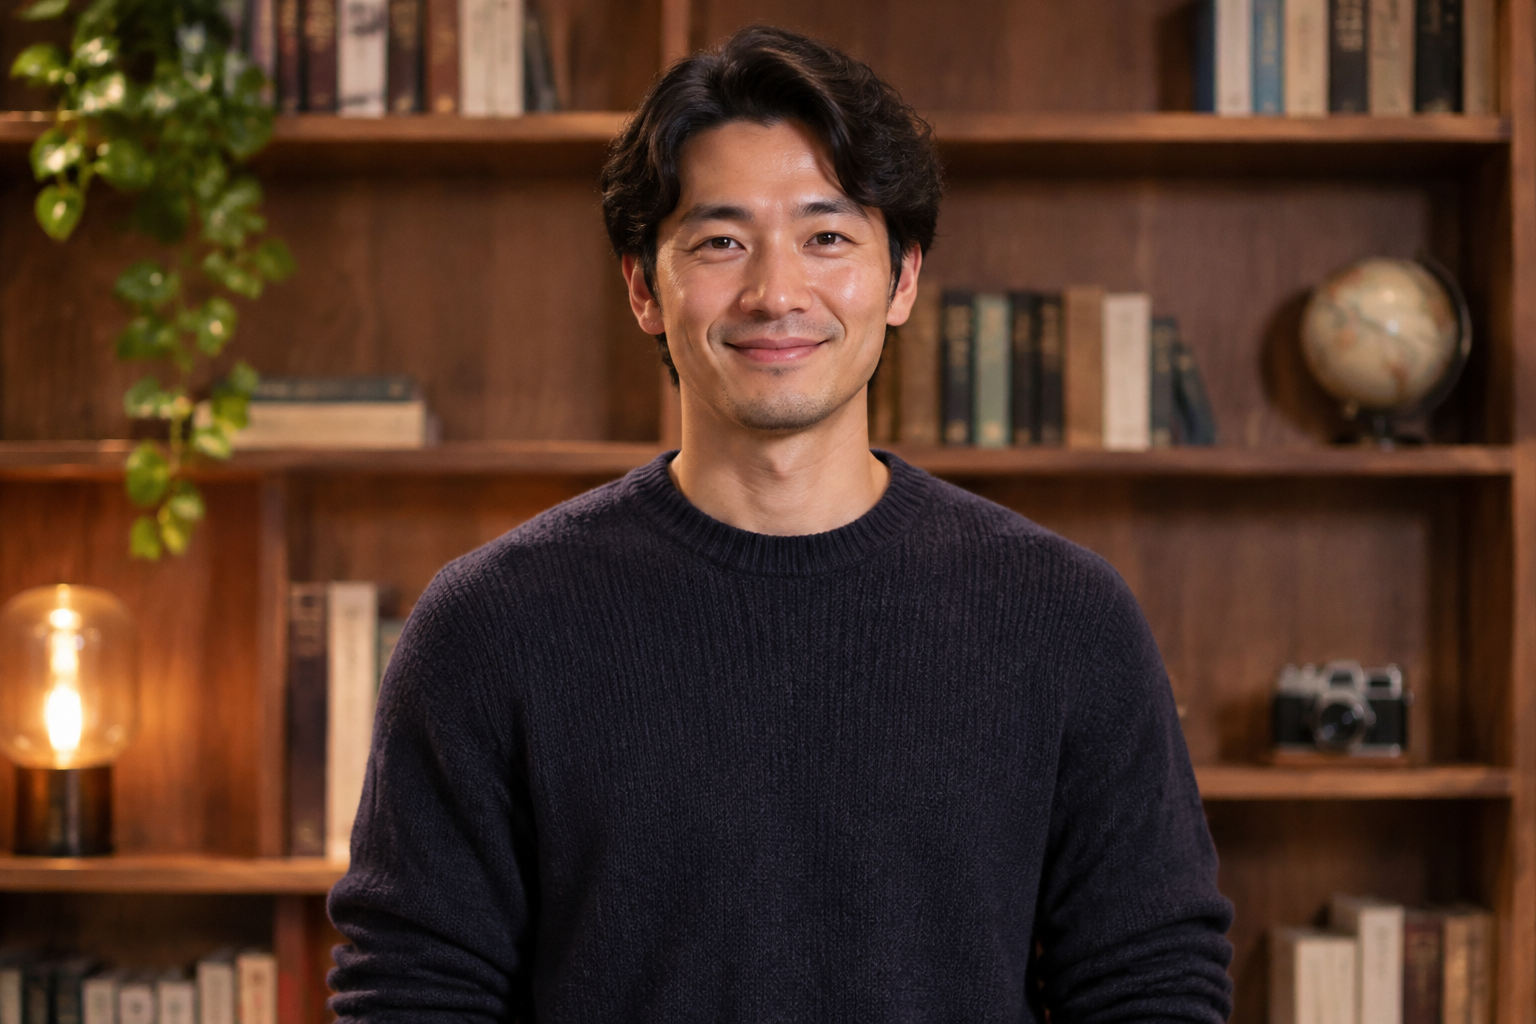
Image de personnage
Prompt
Un présentateur vêtu d'un pull en maille foncé, à l'allure posée, se tient devant une bibliothèque en bois chaleureuse et s'adresse à la caméra ; les mouvements des lèvres sont naturels, les gestes discrets, la caméra avance lentement d'un plan moyen vers un cadrage plus rapproché, avec une lumière principale douce et chaleureuse.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Studio de nuit · Présentation d'une présentatrice numérique
Style Diffusion · Voix off · Cinématographique
Entrées de référence
Audio pilote
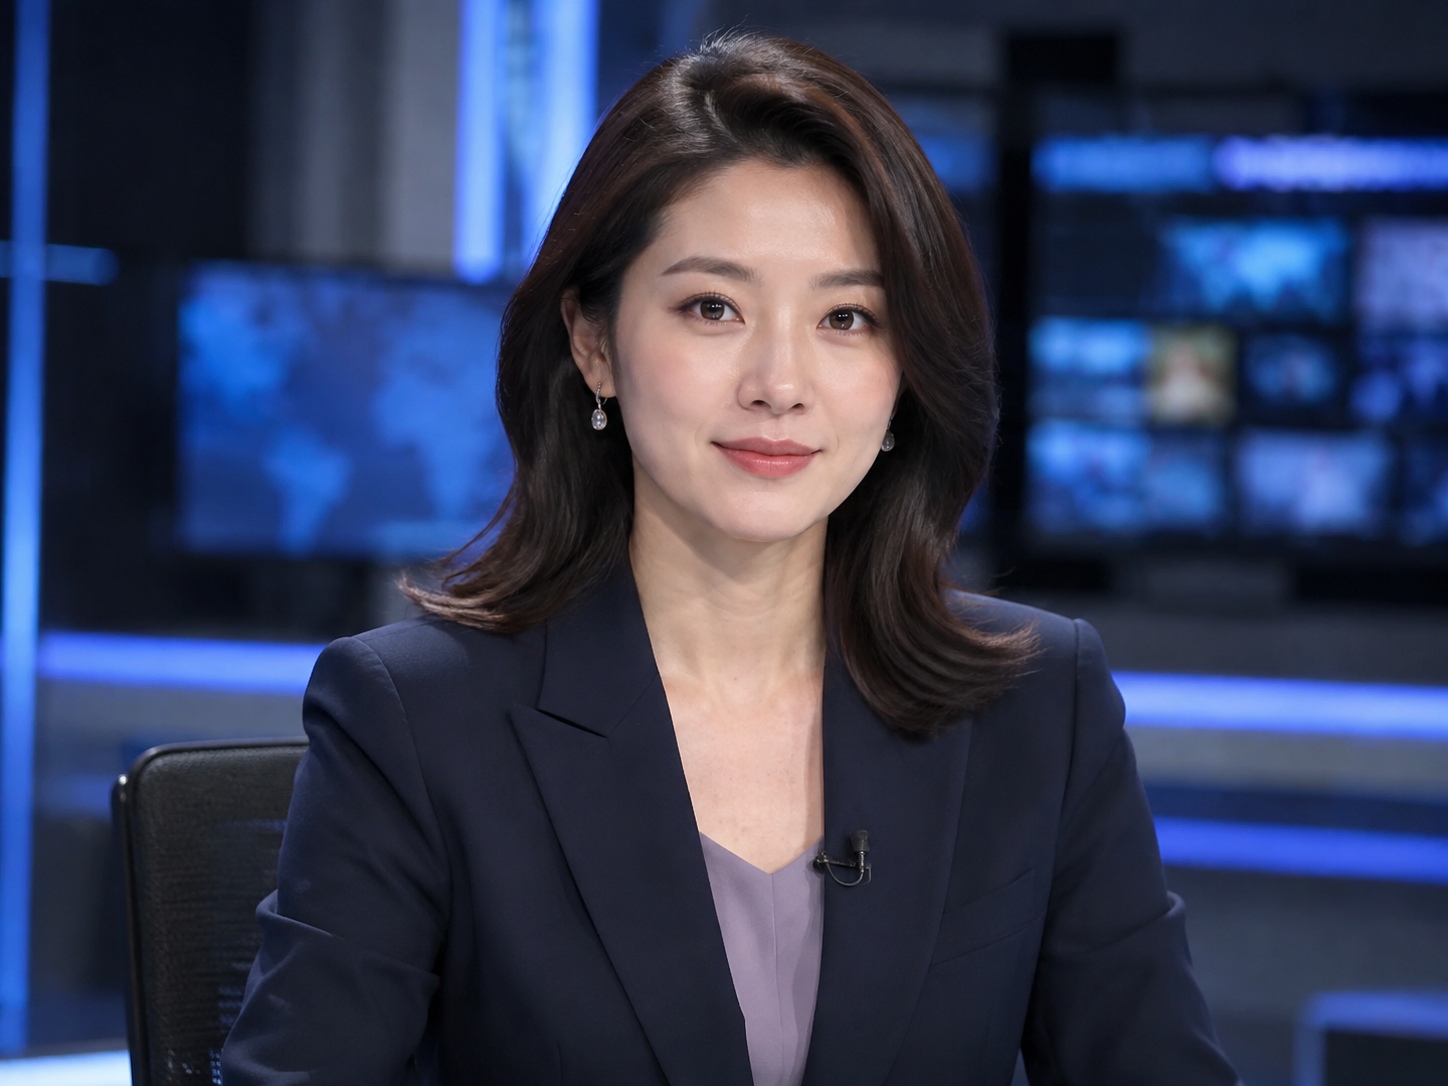
Image de personnage
Prompt
La caméra s'approche lentement d'une présentatrice posée, assise à une table de studio plongé dans la pénombre ; à mesure que son ton se fait mélancolique, elle hoche doucement la tête et son expression s'adoucit ; éclairage de studio bleu froid et ambré, texture radiophonique nette.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
omnihuman-2.0 per second
| Prix unitaire | $0.100 |
|---|
Présentation
Il s'agit d'un modèle de génération de vidéos de personnages numériques piloté par l'audio : il reçoit une image de personne réelle ou de personnage illustré ainsi qu'un enregistrement vocal ou chanté, et produit une vidéo de performance synchronisée avec l'audio. La durée de la vidéo suit celle de l'audio et l'image conserve le rapport largeur-hauteur de l'image d'origine ; un prompt peut éventuellement décrire la scène, les expressions, les gestes et les mouvements de caméra. Il convient aux développeurs et créateurs de contenu qui ont besoin de plans de personnage parlant face caméra, chantant ou dialoguant, pour des vidéos courtes destinées aux réseaux sociaux, des apparitions publicitaires et des séquences de jeu d'acteur dans des applications de personnages numériques.
Points clés
- Synchronisation labiale et expressive pilotée par l'audio — les mouvements de bouche, les expressions et les gestes corporels sont générés en fonction du rythme et du ton de la voix ou du chant, et la durée de la vidéo correspond à celle de l'audio.
- De l'image à la vidéo en conservant le ratio d'origine — il suffit de téléverser une image de personnage pour générer une vidéo de performance ; la vidéo finale reprend le rapport largeur-hauteur de l'image, ce qui facilite son intégration directe dans une mise en page existante.
- Contrôle de la performance et de la caméra par prompt — un prompt facultatif permet de décrire la scène, les expressions, les gestes et des effets de caméra comme un lent travelling avant.
- Un seul audio pour plusieurs minutes de performance — l'audio de pilotage accepte de 4 à 300 secondes, et la vidéo finale peut se prolonger au rythme de l'audio, ce qui convient aux séquences continues de discours face caméra ou de chant.
Description des capacités
Génération de vidéo de personnage à partir d'une image et d'un audio : il suffit de fournir une image de personnage et un audio de pilotage pour générer une vidéo où ce personnage se produit ; l'image peut représenter une personne réelle ou un personnage illustré, et la vidéo produite reprend le rapport largeur-hauteur de l'image d'origine.
Performance avec synchronisation labiale : la vidéo génère les mouvements de bouche et les expressions faciales correspondant au rythme de la voix ou du chant de pilotage ; elle convient aux contenus de narration, de dialogue et de chant, et sa durée correspond à celle de l'audio.
Contrôle de la performance et de la caméra par prompt : le prompt facultatif peut atteindre 300 caractères et sert à décrire la scène, les expressions, les gestes et les mouvements de caméra.
Plage de durée de l'audio : l'audio de pilotage doit être au format mp3 ou wav, durer de 4 à 300 secondes et ne pas dépasser 15 Mo ; la durée de la vidéo finale y correspond, ce qui facilite la planification de longues performances continues.
Plage de spécifications de l'image : l'image de personnage accepte les formats jpeg, png ou webp, ne doit pas dépasser 10 Mo, son rapport largeur-hauteur doit être compris entre 0,4 et 2,5 et chaque côté doit mesurer entre 300 et 6000 pixels.
Cas d'usage
- Créateurs de vidéos de discours face caméra pour les réseaux sociaux — téléversez le portrait d'un présentateur et un audio d'explication pour générer une vidéo où le personnage parle face caméra, directement utilisable pour publier des vidéos courtes sur les plateformes sociales et alimenter la mise à jour quotidienne d'un compte.
- Chant virtuel et performances musicales — associez l'image d'un chanteur ou d'un avatar virtuel à l'audio d'une chanson pour produire des images de chant du personnage, utilisables comme séquences de performance pour des contenus musicaux.
- Courts métrages d'ambassadeurs de marque — combinez l'image d'une marque avec la voix off d'un texte promotionnel pour générer un court métrage mettant en scène un ambassadeur ou un présentateur, destiné à l'affichage sur des publicités et des pages d'événements.
- Développeurs d'applications de personnages numériques — intégrez l'interface pour soumettre en lot des images de personnages et des audios, afin de fournir aux applications de création vidéo des séquences de personnages numériques à l'écran, pour des reprises de tournage ou la génération de plans de dialogue.
Limites et conseils de choix
L'audio de pilotage est une entrée obligatoire : le contenu de la vidéo est piloté par l'audio et une image de personnage doit également être fournie. La durée de l'audio d'entrée doit être comprise entre 4 et 300 secondes ; une tâche de moins de 4 secondes échouera et sera intégralement remboursée. L'image de personnage doit respecter les exigences de format et de dimensions : un rapport largeur-hauteur compris entre 0,4 et 2,5 et chaque côté entre 300 et 6000 pixels. Le prompt est facultatif et limité à 300 caractères.
Nouveautés
Voir le journal des modifications →- Nouveau modèle OmniHuman 2.0 est disponible : un portrait et un fichier audio suffisent pour générer une vidéo parlante de 5 minutes maximum
Questions fréquentes
Voir toutes les questions →-
Une seule image et un seul fichier audio suffisent-ils pour générer une vidéo ?
Oui, ce modèle prend en entrée une image de personne et une piste audio de pilotage ; les seuls champs obligatoires sont image_url et audio_url. L'image doit être au format jpeg, png ou webp, ne pas dépasser 10 Mo, avec un rapport largeur/hauteur compris entre 0,4 et 2,5 et des côtés de 300 à 6000 pixels ; l'audio doit être au format mp3 ou wav, d'une durée de 4 à 300 secondes et ne pas dépasser 15 Mo. Le contenu de la vidéo est piloté par l'audio, sa durée est identique à celle de l'audio et la vidéo finale conserve le rapport largeur/hauteur de l'image.
-
Quelle est la durée maximale d'une vidéo de présentateur numérique ?
Un plan continu unique peut durer jusqu'à 5 minutes, avec une limite audio correspondante de 300 secondes, sans nécessité de segmentation ni de raccord. L'audio doit durer au minimum 4 secondes ; une tâche dont l'audio est inférieur à 4 secondes échouera et sera intégralement remboursée. Pour obtenir une longue performance continue, il est plus simple de soumettre l'intégralité de la narration ou du dialogue dans un seul fichier audio que de générer par segments puis de les assembler, et cela réduit aussi le risque de sauts de synchronisation labiale et d'expressions aux points de raccord.
-
Quelle est la résolution de sortie, peut-on obtenir du 1080p ?
Ce modèle n'a pas de paramètre de résolution, il n'est donc pas possible de spécifier du 1080p. Le format et la résolution de la vidéo finale suivent l'image de portrait en entrée : par exemple, un portrait en 960×960 donnera une vidéo en 960×960, et les sources verticales comme horizontales sont utilisables directement. Pour obtenir une vidéo finale plus nette, utilisez une image de portrait nette avec une composition épurée ainsi qu'un audio propre.
-
Faut-il utiliser des modèles différents pour la narration, le chant et le dialogue ?
Non, un même modèle couvre les trois types d'audio : narration, chant et dialogue, il n'existe pas de mode chant séparé. La synchronisation labiale, les expressions faciales et les mouvements corporels s'adaptent en même temps à l'intonation, au rythme, à l'émotion et au sens de l'audio ; pour changer de type d'audio, il suffit de remplacer l'audio lui-même. C'est d'ailleurs la principale différence d'expressivité avec les outils antérieurs qui ne faisaient que l'alignement labial.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : omnihuman-2.0
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour omnihuman-2.0 et la route default — voir le tableau des paramètres ci-dessous.
promptstringOptionnelmaxLength 300Paramètre facultatif servant à décrire la mise en scène, les expressions, les gestes et les mouvements de caméra, par exemple hocher la tête en souriant ou effectuer un lent travelling avant.
audio_urlstringRequisAdresse de l'audio vocal ou chanté utilisé pour la synchronisation labiale ; la durée de la vidéo est égale à celle de l'audio, laquelle doit être comprise entre 4 et 300 secondes, au format mp3 ou wav, pour une taille maximale de 15 Mo.
image_urlstringRequisAdresse du portrait à animer, qu'il s'agisse d'une personne réelle ou d'un personnage illustré ; formats jpeg, png et webp pris en charge, taille maximale de 10 Mo, rapport largeur-hauteur compris entre 0,4 et 2,5, côté entre 300 et 6000 pixels ; la vidéo générée conserve le rapport largeur-hauteur et la résolution de cette image.
callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-2.0",
  "input": {
    "audio_url": "…",
    "image_url": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "omnihuman-2.0",
input: {
"audio_url": "…",
"image_url": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "omnihuman-2.0",
"input": {
"audio_url": "…",
"image_url": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →
Modèles associés
Voir tous les modèles →Même type
-
 FLUX 3 Video Black Forest Labs $0.090 /seconde
-
 HeyGen Avatar IV HeyGen $0.150 /seconde
-
 Creatify Boreal Creatify $0.015 /seconde
-
 Gemini Omni 1.1 Google $0.450 /vidéo
-
 Runway Gen 4.5 Runway $0.172 /seconde
-
 Kling 3.0 Kuaishou $0.100 /seconde
-
 Veo 3.1 Google $0.290 /seconde
-
 Muse Video 1.0 Meta $0.034 /vidéo
-
 Seedance 2.0 ByteDance $0.017 /seconde
-
 P-Video 2 Pro Replace Pruna AI $0.036 /seconde
-
 Ray 3.2 Luma $0.214 /vidéo
-
 FLUX 3 Max Black Forest Labs $0.121 /seconde