ByteDance
OmniHuman 2.0
omnihuman-2.0
Modelo de vídeo de avatar digital de segunda geração da ByteDance: basta uma imagem de pessoa ou personagem acompanhada de um trecho de fala ou canto para gerar um vídeo de performance em que lábios, expressões faciais e movimentos corporais sincronizam com o áudio, com plano contínuo de até 5 minutos por geração e possibilidade de adicionar prompts para controlar ações e movimento de câmera
Experimentar omnihuman-2.0
Entrada
Criações
Ver todas as criaçõesSaída
videoO monólogo de um vendedor de comida de rua noturno
Estilo portrait-avatar · Comida de rua · sincronização labial
Entradas de referência
Áudio de condução
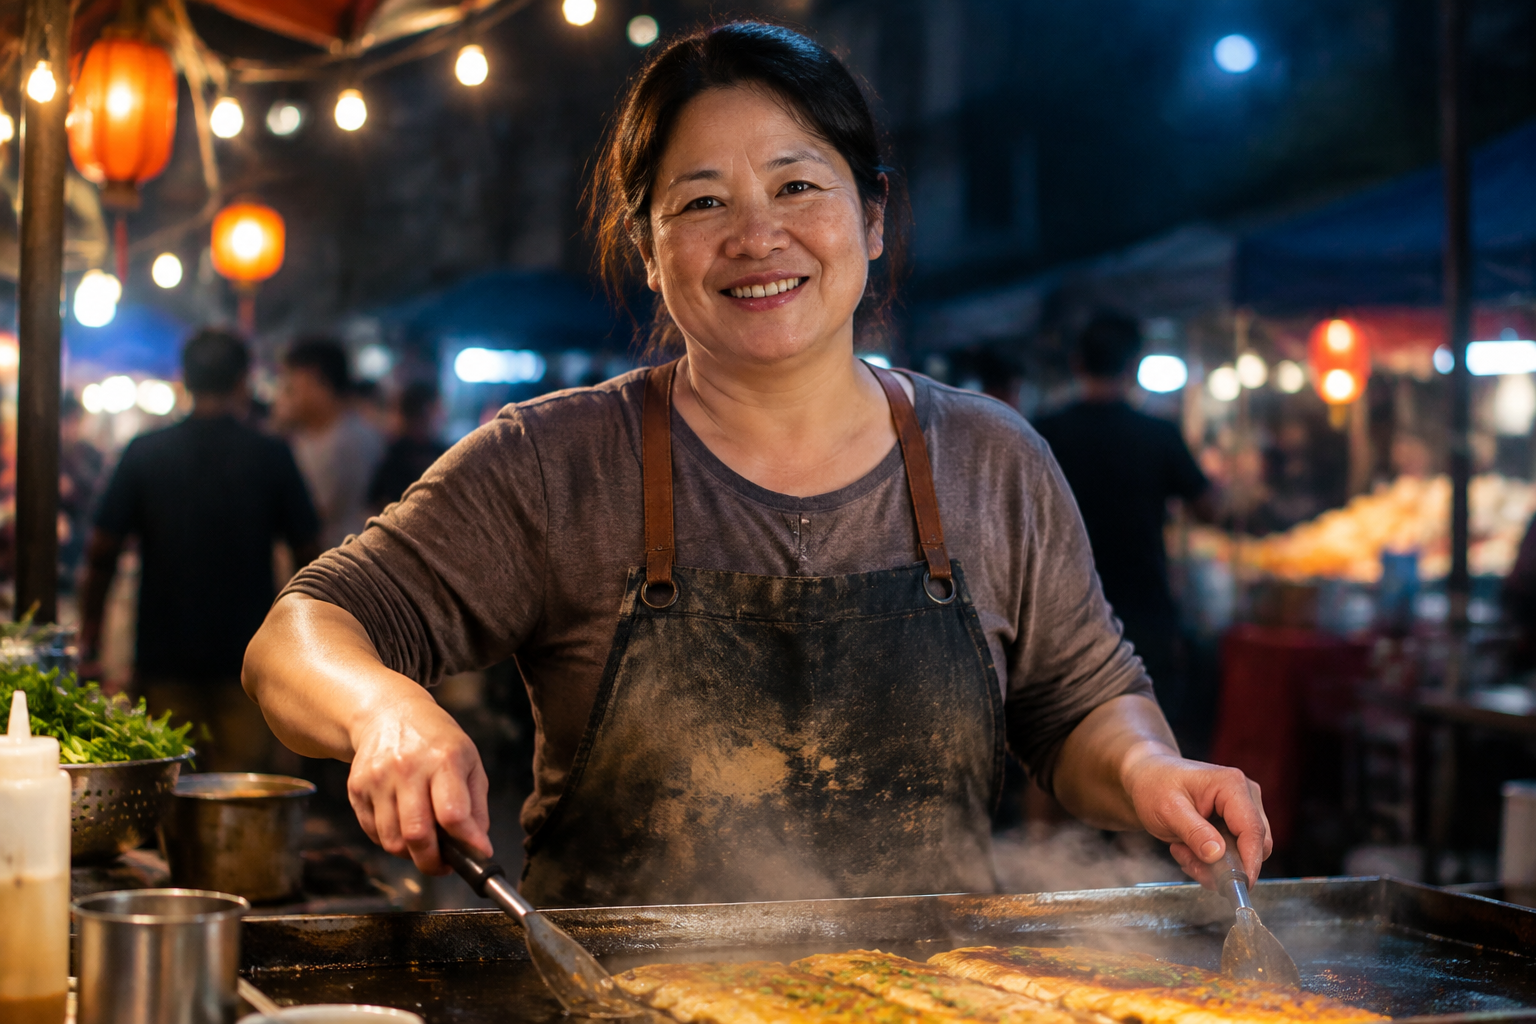
Imagem de personagem
Prompt
Em um mercado noturno, um vendedor ambulante de comida com o avental coberto de farinha está atrás de uma chapa quente soltando vapor, falando para a câmera com um sorriso caloroso, natural e acolhedor, fazendo um pequeno gesto para enfatizar o tom, com luzes pendentes ao fundo e o vapor flutuando lentamente; a câmera avança lenta e suavemente em direção ao rosto.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Explicação de conhecimento diante da estante · apresentador digital
Estilo Locução · Educação · Retrato de estúdio
Entradas de referência
Áudio de condução
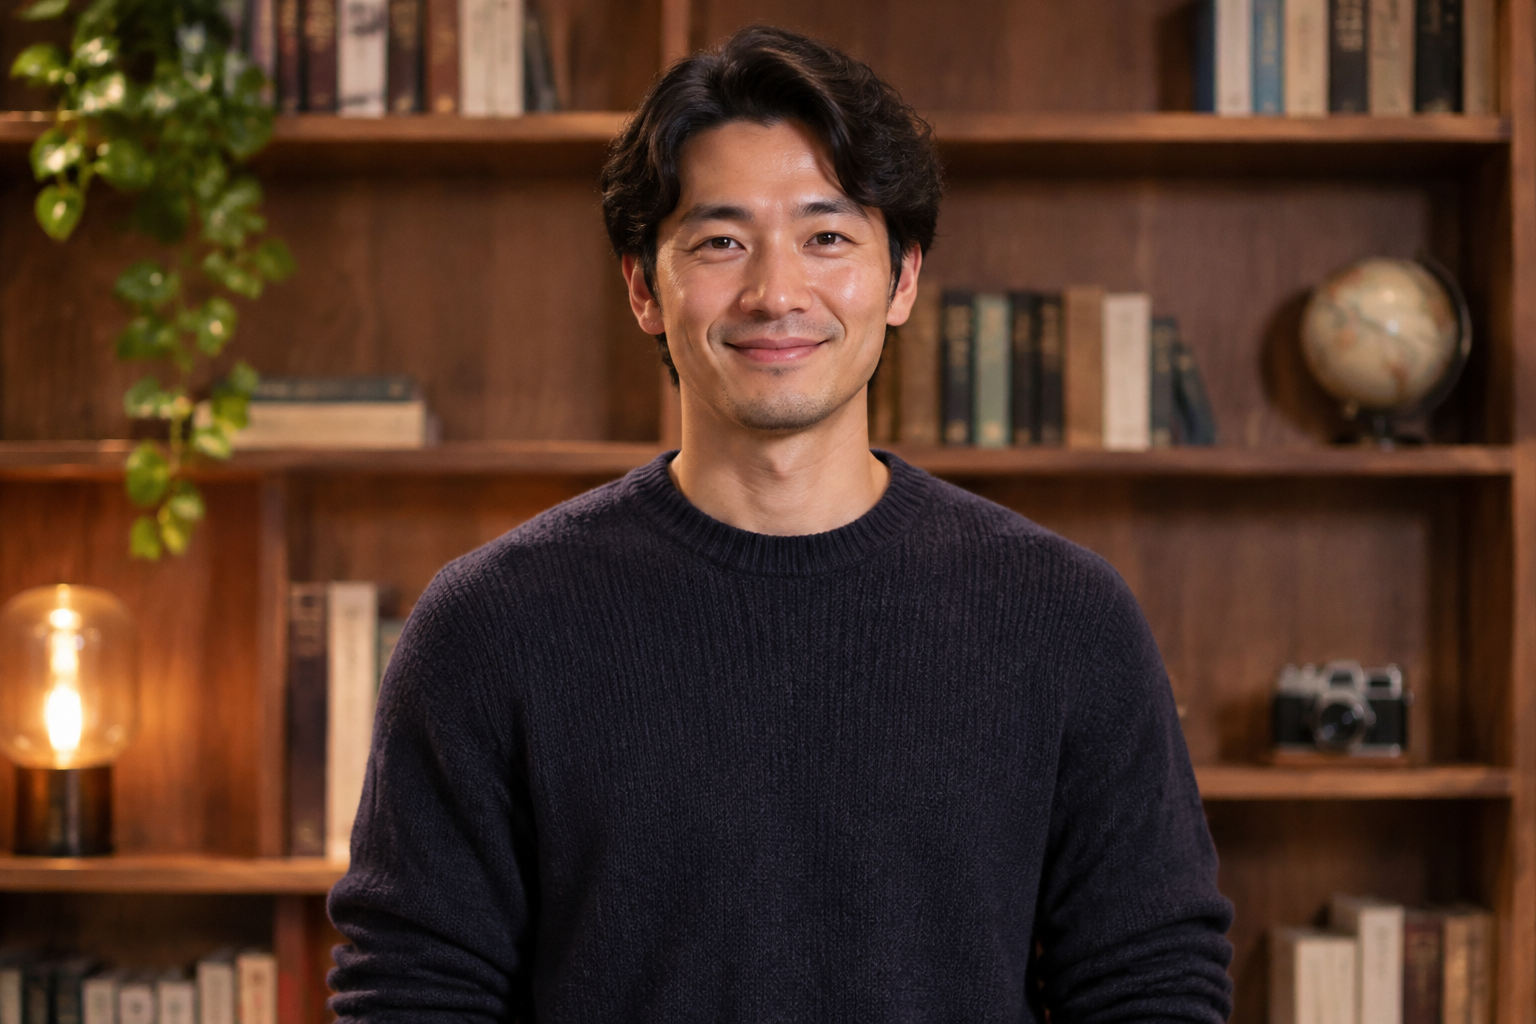
Imagem de personagem
Prompt
Um apresentador vestindo um suéter de tricô escuro, com postura tranquila, está diante de uma estante de madeira quente falando para a câmera; os movimentos dos lábios são naturais, os gestos são discretos, a câmera avança lentamente de um plano médio para um enquadramento mais próximo, com luz principal suave e quente.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Estúdio noturno · Locução de âncora digital
Estilo Transmissão · Locução · Cinematográfico
Entradas de referência
Áudio de condução
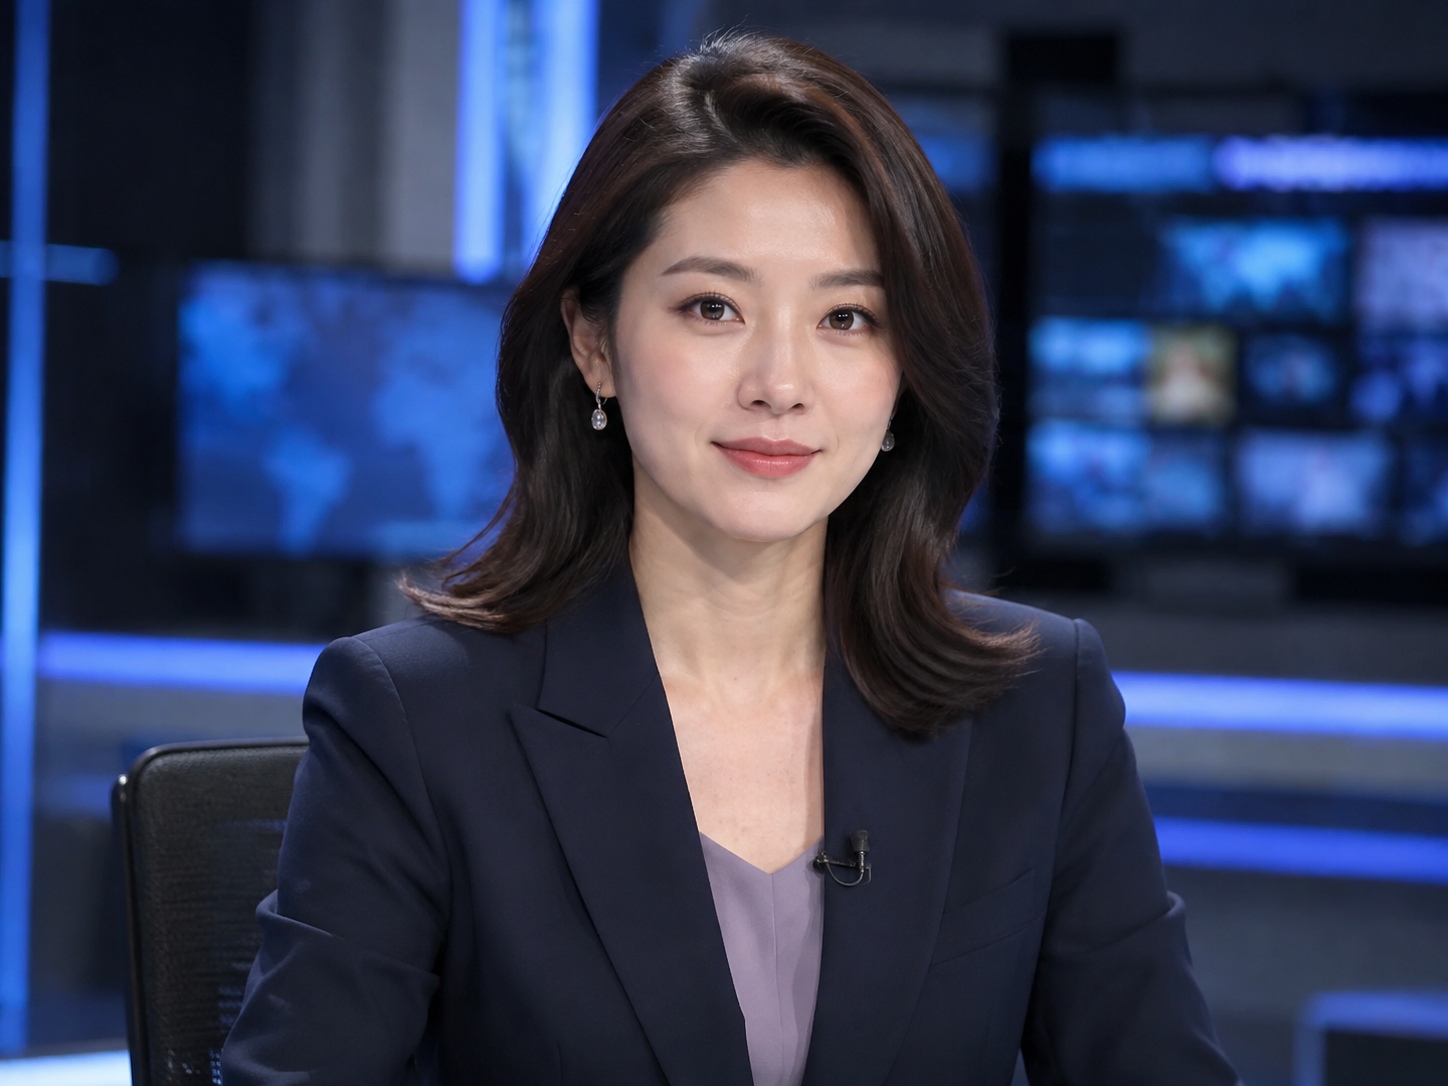
Imagem de personagem
Prompt
A câmera se aproxima lentamente de uma âncora serena, que fala sentada à mesa de um estúdio mal iluminado; conforme seu tom se torna melancólico, ela acena levemente com a cabeça e sua expressão se suaviza; iluminação de estúdio em azul frio e âmbar, com textura nítida de transmissão.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
omnihuman-2.0 per second
| Preço unitário | $0.100 |
|---|
Visão geral do posicionamento
Este é um modelo de geração de vídeo de avatar digital baseado em áudio: recebe uma imagem de uma pessoa real ou de um personagem ilustrado e um trecho de fala ou canto, e produz um vídeo de performance sincronizado com o áudio. A duração do vídeo acompanha o áudio e a imagem mantém a proporção de largura e altura da imagem original; opcionalmente, é possível usar um prompt para descrever a cena, as expressões, os gestos e o movimento de câmera. Indicado para desenvolvedores e criadores de conteúdo que precisam de planos de personagem falando em câmera, cantando ou em diálogo, para uso em vídeos curtos para redes sociais, endorsements de marketing e materiais de atuação de personagens em aplicações de avatar digital.
Destaques principais
- Sincronização labial e de expressões guiada por áudio — gera movimentos labiais, expressões e gestos corporais compatíveis com o ritmo e o tom da fala e do canto, com duração do vídeo igual à do áudio.
- Imagem para vídeo mantendo a proporção original — basta enviar a imagem do personagem para gerar o vídeo de performance; o resultado mantém a proporção de largura e altura da imagem, facilitando a incorporação direta em layouts existentes.
- Controle de performance e movimento de câmera por prompt — o prompt opcional descreve a cena, as expressões, os gestos e efeitos de câmera como um avanço lento.
- Um único trecho de áudio cobre vários minutos de performance — o áudio de condução suporta de 4 a 300 segundos, e o vídeo pode acompanhar o áudio, sendo adequado para trechos contínuos de fala em câmera ou canto.
Descrição das capacidades
Geração de vídeo de personagem a partir de imagem e áudio: basta fornecer a imagem do personagem e o áudio de condução para gerar um vídeo com a performance desse personagem; a imagem pode ser de uma pessoa real ou de um personagem ilustrado, e o vídeo de saída mantém a proporção de largura e altura da imagem original.
Performance com sincronização labial: o vídeo gera movimentos labiais e expressões faciais correspondentes ao ritmo da fala ou do canto de condução, sendo adequado para narração, diálogo e material de canto, com duração do vídeo igual à do áudio.
Controle de performance e câmera por prompt: o prompt opcional tem no máximo 300 caracteres e serve para descrever a cena, as expressões, os gestos e o movimento de câmera.
Faixa de duração do áudio: o áudio de condução deve estar em mp3 ou wav, com duração de 4 a 300 segundos e no máximo 15MB; a duração do vídeo corresponde a ele, facilitando o planejamento de trechos longos e contínuos de performance.
Faixa de especificações da imagem: a imagem do personagem suporta jpeg, png ou webp, com no máximo 10MB, proporção de largura e altura entre 0,4 e 2,5 e de 300 a 6000 pixels por lado.
Cenários de aplicação
- Criadores de vídeos de fala em câmera para redes sociais — envie o retrato do apresentador e um áudio de explicação para gerar um vídeo do personagem falando em câmera, pronto para publicação de vídeos curtos em plataformas sociais e atualização diária da conta.
- Performances vocais virtuais e musicais — use a imagem de um cantor ou de um avatar virtual junto com o áudio da música para produzir cenas do personagem cantando, como material de performance para conteúdo musical.
- Filmes curtos de garoto-propaganda — combine a imagem da marca com a narração de textos publicitários para gerar filmes curtos com porta-voz ou apresentador em cena, para exibição em anúncios e páginas de campanha.
- Desenvolvedores de aplicações de avatar digital — integre à interface para enviar em lote imagens de personagens e áudios, fornecendo trechos de avatar digital em cena para aplicações de criação de vídeo, usados em regravações ou na geração de planos de diálogo.
Limitações e recomendações de escolha
O áudio de condução é uma entrada obrigatória; o conteúdo do vídeo é guiado pelo áudio e é necessário fornecer também a imagem do personagem. A duração do áudio de entrada deve estar entre 4 e 300 segundos; tarefas com menos de 4 segundos falham e são reembolsadas integralmente. A imagem do personagem deve atender aos requisitos de formato e dimensões, com proporção de largura e altura entre 0,4 e 2,5 e de 300 a 6000 pixels por lado. O prompt é opcional e tem no máximo 300 caracteres.
Novidades
Ver o changelog →- Novo modelo OmniHuman 2.0 já disponível: um retrato e um áudio geram um vídeo falante de até 5 minutos
Perguntas frequentes
Ver todas as perguntas →-
É possível gerar um vídeo apenas com uma imagem e um áudio?
Sim, a entrada deste modelo é apenas uma imagem de pessoa mais um áudio de condução; os únicos campos obrigatórios são image_url e audio_url. A imagem aceita jpeg, png e webp, com no máximo 10MB por arquivo, proporção entre 0,4 e 2,5 e de 300 a 6000 pixels por lado; o áudio aceita mp3 e wav, com duração de 4 a 300 segundos e no máximo 15MB. O conteúdo do vídeo é conduzido pelo áudio, a duração é igual à do áudio e o vídeo final mantém a proporção da imagem.
-
Qual é a duração máxima de um vídeo de humano digital que pode ser gerado?
Um único plano contínuo tem no máximo 5 minutos, correspondendo a um limite de áudio de 300 segundos, sem necessidade de segmentar e emendar. O áudio tem duração mínima de 4 segundos; tarefas com menos de 4 segundos falham e são reembolsadas integralmente. Para obter uma performance contínua mais longa, envie a narração ou o diálogo completo em um único áudio: é mais prático do que gerar em segmentos e depois emendá-los, e também reduz o risco de saltos na sincronia labial e nas expressões faciais nas junções.
-
Qual é a resolução de saída? É possível gerar em 1080p?
Este modelo não tem parâmetro de resolução e não permite especificar 1080p. O enquadramento e a resolução do vídeo final seguem a imagem de retrato de entrada; por exemplo, um retrato de 960×960 gera um vídeo de 960×960, e materiais em formato vertical ou horizontal podem ser usados diretamente. Para deixar o vídeo final mais nítido, use uma imagem de retrato nítida e com composição limpa, além de um áudio limpo.
-
É preciso usar modelos diferentes para narração, canto e diálogo?
Não é necessário; o mesmo modelo cobre as três categorias de áudio — narração, canto e diálogo —, sem um modo de canto separado. A sincronia labial, as expressões faciais e os movimentos corporais acompanham o tom, o ritmo, a emoção e a semântica do áudio, mudando em conjunto; para trocar o tipo de áudio, basta trocar o próprio áudio. É justamente essa a principal diferença de expressividade em relação às ferramentas antigas que só faziam alinhamento labial.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: omnihuman-2.0
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para omnihuman-2.0 e a rota default — veja a tabela de parâmetros abaixo.
promptstringOpcionalmaxLength 300Parâmetro opcional, usado para descrever a cena, expressões faciais, gestos e movimentos de câmera, como sorrir e acenar com a cabeça ou um zoom in lento.
audio_urlstringObrigatórioEndereço do áudio de fala ou canto usado para sincronização labial; a duração do vídeo é igual à do áudio, que deve ter entre 4 e 300 segundos, formato mp3 ou wav e tamanho máximo de 15MB.
image_urlstringObrigatórioEndereço da imagem de retrato da personagem a ser animada, podendo ser uma pessoa real ou um personagem ilustrado; suporta formatos jpeg, png e webp, tamanho máximo de 10MB, proporção entre 0.4 e 2.5 e pixels por lado entre 300 e 6000; o vídeo de saída mantém a proporção e a resolução da imagem.
callbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-2.0",
  "input": {
    "audio_url": "…",
    "image_url": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "omnihuman-2.0",
input: {
"audio_url": "…",
"image_url": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "omnihuman-2.0",
"input": {
"audio_url": "…",
"image_url": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 PixVerse V6 Max PixVerse $0.030 /segundo
-
 Vidu Q4 Preview Vidu $0.051 /segundo
-
 MiniMax H3 MiniMax $0.072 /segundo
-
 Kling 4.0 Flash Kuaishou $0.122 /segundo
-
 Veo 3.1 Lite Google $0.060 /segundo
-
 Muse Video 1.0 Meta $0.034 /vídeo
-
 Grok Imagine 1.5 xAI $0.011 /segundo
-
 Wan 2.7 Video Alibaba $0.100 /segundo
-
 Seedance 2.0 ByteDance $0.017 /segundo
-
 Veo 3.1 Fast Google $0.170 /segundo
-
 Kling 3.0 Turbo Kuaishou $0.144 /segundo
-
 Kling 4.0 Kuaishou $0.204 /segundo