
Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Modelo de vídeo falante com rosto de retrato da Pruna AI, que a partir de uma única foto de retrato gera clipes de locução com sincronização labial e mudanças de expressão, podendo ser acionado por áudio enviado ou ler o roteiro diretamente com a síntese de voz integrada, ideal para explicações de cursos, dublagem multilíngue e produção em lote de vídeos curtos com avatares digitais
Experimentar p-video-2-pro-avatar
Entrada
Criações
Ver todas as criaçõesSaída
videoNotas visuais de linguagem de câmera · apresentação em vídeo por avatar digital
Estilo Locução · linguagem-de-câmera · estúdio
Entradas de referência
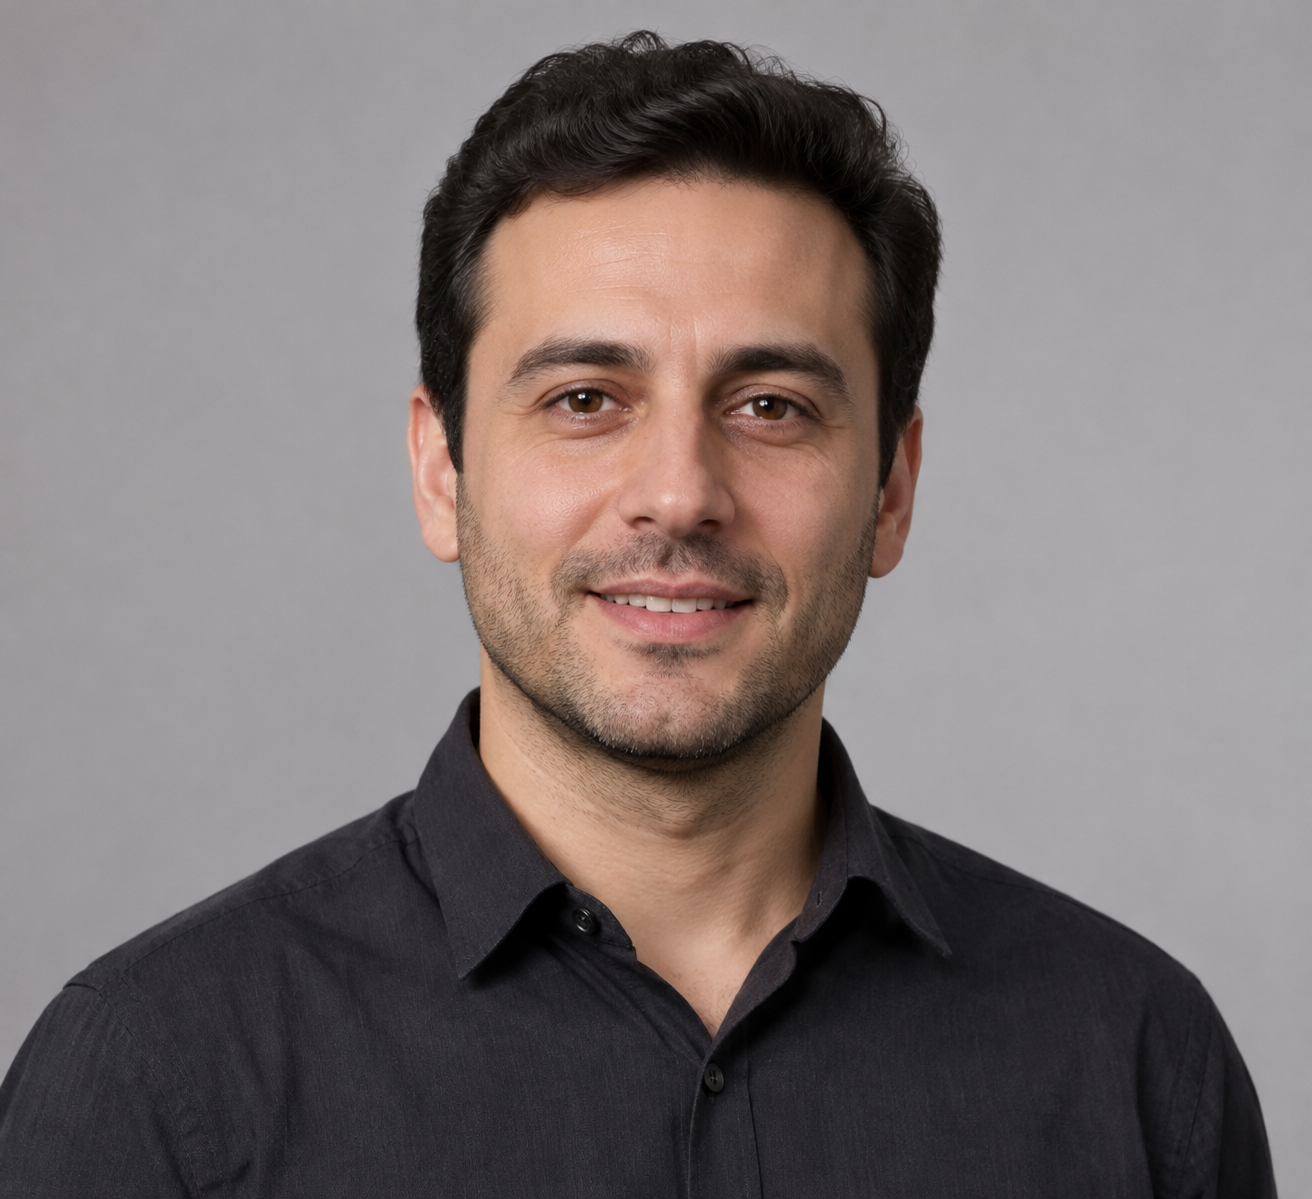
Imagem de retrato
Prompt
Um instrutor de camisa escura, de postura serena, está diante de um fundo de estúdio cinza-claro suave e explica à câmera, um a um, os termos de movimento de câmera. Os ombros e a cabeça se movem levemente no ritmo da fala, a expressão é focada e contida, e o olhar se dirige de forma estável para a câmera. Uma luz principal neutra e suave incide frontalmente pela lateral, complementada por um leve preenchimento refletido, criando uma atmosfera tranquila de sala de aula; a textura da pele é realista, e ele pisca naturalmente e acena levemente com a cabeça ao final das frases.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Depoimento da curadora após o fechamento do museu
Estilo Retrato falante · Museu · Cultura
Entradas de referência
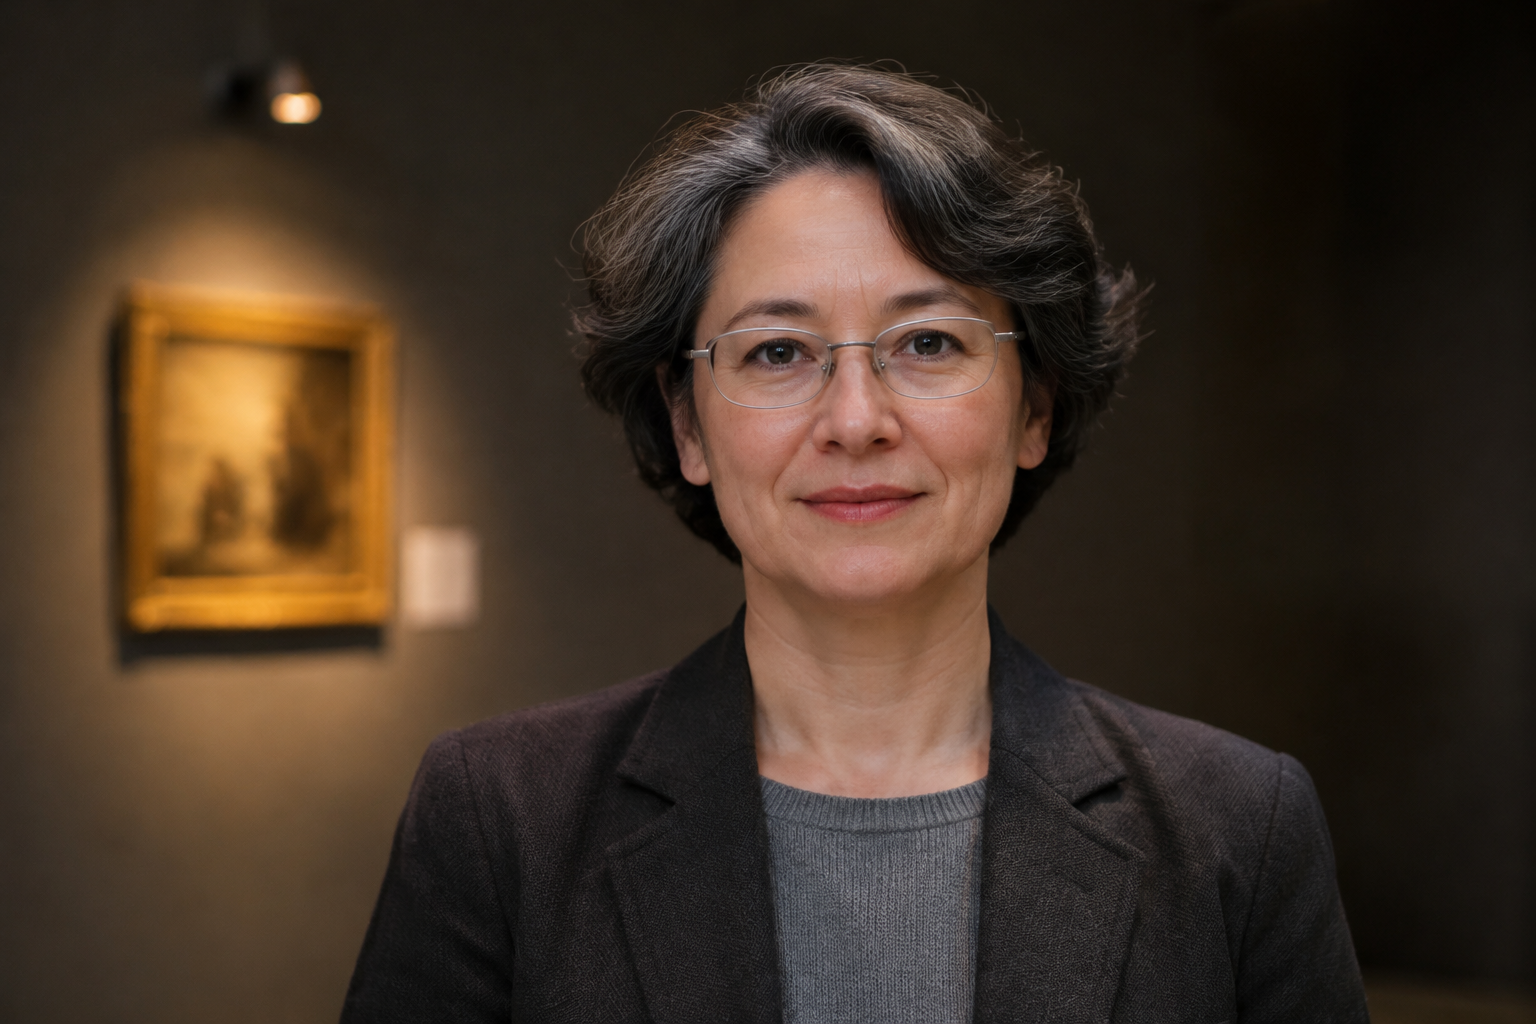
Imagem de retrato
Prompt
Uma curadora de meia-idade sentada na borda de um banco de galeria, com uma parede de exposição suavemente iluminada atrás de seus ombros, falando calmamente para a câmera sobre uma peça da exposição; ela acena levemente com a cabeça, pisca naturalmente, com uma expressão serena e gentil; profundidade de campo rasa, iluminação quente de tungstênio da galeria com queda suave, atmosfera tranquila de museu, apenas movimentos sutis no rosto e nos ombros.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
p-video-2-pro-avatar per second
| Especificações | Preço unitário |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
Visão geral do posicionamento
Modelo de geração de vídeo voltado para cenários de apresentação com avatares digitais: basta enviar um retrato de uma pessoa como primeiro quadro e, em seguida, fornecer um áudio de voz ou inserir um texto de roteiro para gerar um vídeo da pessoa falando. O roteiro é narrado pela voz integrada, com opção de várias timbres e idiomas, e prompts descrevem os movimentos e a expressão da pessoa enquanto fala. Indicado para criadores de conteúdo que precisam de uma figura humana real em cena, como aulas expositivas, peças de marketing com narração falada e vídeos curtos para redes sociais, eliminando as etapas de filmagem e de sincronização labial.
Destaques principais
- Um único retrato já impulsiona o vídeo de fala — é necessário apenas um retrato da pessoa como primeiro quadro, sem precisar de material de vídeo existente, para gerar a cena da pessoa falando.
- Duas formas de condução: áudio e roteiro — é possível enviar um áudio de voz de até 3 minutos ou inserir um roteiro para ser narrado pela voz integrada, com a duração do vídeo acompanhando a do áudio.
- Controle de expressão e movimento por prompts — use prompts para descrever a aparência, os movimentos e a expressão da pessoa ao falar, e defina uma semente aleatória para reproduzir o resultado.
- Várias resoluções para atender às necessidades de produção — há cinco opções de resolução: 480p, 768p, 1080p, 2k e 4k, facilitando a escolha da qualidade conforme a plataforma de publicação.
Descrição das capacidades
Vídeo de fala guiado por retrato: forneça, por meio de um link HTTPS, um retrato da pessoa nos formatos jpg, jpeg, png ou webp como primeiro quadro para gerar um vídeo da pessoa falando, com o conteúdo da cena descrito pelo prompt quanto à aparência, aos movimentos e à expressão.
Sincronização labial por áudio enviado: forneça um link HTTPS de áudio de voz; a duração do vídeo será igual à do áudio, com no máximo 3 minutos; ao usar a especificação 4k, o áudio pode ter no máximo 125 segundos. Nesse caso, as configurações de roteiro, timbre, idioma e estilo de voz deixam de ter efeito.
Sincronização labial por conversão de roteiro em fala: quando nenhum áudio é fornecido, insira um roteiro de até 5000 caracteres, que será narrado pela voz integrada para gerar o vídeo; o idioma do roteiro deve ser escolhido entre os dez idiomas disponíveis, e é possível usar até 1000 caracteres de descrição de estilo de voz para definir o tom e o ritmo.
Escolha de timbre e parâmetros de imagem: é possível selecionar um entre 30 timbres integrados para narrar o roteiro, descrever a imagem com um prompt de até 2000 caracteres e definir uma semente aleatória entre 0 e 2147483647; a resolução é escolhida entre 480p, 768p, 1080p, 2k e 4k, com padrão de 768p.
Cenários de aplicação
- Vídeos de narração em lote para instrutores de cursos — o instrutor fornece o retrato e o roteiro da explicação para gerar em lote vídeos de apresentação com a pessoa em cena, destinados à publicação em cursos online ou colunas de conhecimento.
- Narração com imagem real para materiais de marketing — a equipe de operações usa o retrato do porta-voz do produto junto com o texto promocional para gerar trechos narrados e veiculá-los em feeds ou contas sociais da marca.
- Produção final a partir de gravações já existentes — o criador envia a própria gravação de voz e o retrato, fazendo a sincronização labial da imagem acompanhar o áudio para produzir diretamente vídeos curtos para redes sociais.
- Conversão de retrato estático em vídeo de fala — use uma foto existente da pessoa com um roteiro ou áudio para gerar uma cena de fala com expressões e sincronização labial, destinada a colunas de avatar digital ou páginas de apresentação.
Limitações e recomendações de seleção
O roteiro e o prompt têm limites de comprimento: o prompt tem no máximo 2000 caracteres, o roteiro no máximo 5000 caracteres e a descrição de estilo de voz no máximo 1000 caracteres. A voz integrada não oferece suporte ao chinês; o idioma do roteiro deve ser escolhido entre inglês, espanhol, francês, alemão, italiano, português (Brasil), japonês, coreano e hindi. A duração do vídeo é determinada pelo áudio, com no máximo 3 minutos; ao usar a especificação 4k, o áudio pode ter no máximo 125 segundos.
Novidades
Ver o changelog →- Novo modelo P-Video 2 Pro Avatar disponível: um retrato mais áudio ou roteiro para gerar vídeos de fala de até 3 minutos
Perguntas frequentes
Ver todas as perguntas →-
Que áudio usar para dar vida ao avatar digital?
Use audio_url para passar um link de áudio HTTPS; a duração do vídeo é igual à duração do áudio, com no máximo 3 minutos (4k no máximo 125 segundos). Depois de passar o áudio, script, voice, voice_language e voice_prompt não terão efeito; se ambos forem passados, o áudio prevalecerá.
-
Qual é o comprimento máximo de texto do script que posso inserir?
O campo script aceita no máximo 5000 caracteres, mas a duração final do vídeo é determinada pela duração da fala do script lido pelo TTS integrado, com limite de 3 minutos; quando estiver próximo do limite, recomenda-se primeiro encurtar o texto ou gerar em segmentos.
-
Como escrever melhores prompts para vídeos de locução?
O prompt descreve a aparência, os movimentos e a expressão da pessoa enquanto fala, sem escrever falas. Recomenda-se seguir a ordem «aparência da pessoa → amplitude dos movimentos → expressão e direção do olhar → sensação de câmera», por exemplo «um homem de terno escuro, sentado naturalmente, assentindo ocasionalmente, sorrindo e olhando para a câmera, plano médio fixo», mantendo-se dentro de 2000 caracteres; o valor padrão é apenas «The person is talking.».
-
Quais idiomas e vozes são suportados?
voice_language tem 10 idiomas: inglês americano, inglês britânico, espanhol, francês, alemão, italiano, português brasileiro, japonês, coreano e hindi; chinês ainda não está incluído. voice tem 30 vozes predefinidas, com o gênero indicado no nome, e o padrão é Zephyr (Female). O texto de script deve corresponder ao idioma selecionado.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: p-video-2-pro-avatar
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para p-video-2-pro-avatar e a rota default — veja a tabela de parâmetros abaixo.
seedintegerOpcionalmin 0max 2147483647Semente aleatória, use um número inteiro de 0 a 2147483647; fornecer a mesma semente e manter as outras entradas inalteradas ajuda a reproduzir o resultado; se não for fornecida, será aleatória.
voicestringOpcionalPadrão: "Zephyr (Female)"A voz usada pela síntese de fala integrada, padrão Zephyr (Female). Este parâmetro é ignorado quando audio_url é fornecido.
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)Mostrar tudo (22)Mostrar menos
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstringOpcionalPadrão: "The person is talking."maxLength 2000Descrição do conteúdo do vídeo, explicando a aparência, os movimentos e o comportamento da pessoa enquanto fala; padrão 「The person is talking.」.
scriptstringOpcionalmaxLength 5000O texto exato que o avatar digital irá ler, escrito no voice_language selecionado (não suporta chinês). Obrigatório quando audio_url não é fornecido; a duração da leitura determina a duração do vídeo, com máximo de 3 minutos.
audio_urlstringOpcionalpattern ^https://URL HTTPS do áudio de voz, com máximo de 3 minutos (máximo de 125 segundos na resolução 4k); a duração do vídeo corresponde à do áudio. Quando fornecido, script, voice, voice_language e voice_prompt são ignorados.
image_urlstringObrigatóriopattern ^https://URL HTTPS da imagem de retrato da pessoa que fala, usada como primeiro quadro do vídeo; suporta os formatos jpg, jpeg, png e webp.
resolutionstringOpcionalPadrão: "768p"Resolução de saída, opções 480p, 768p, 1080p, 2k, 4k, padrão 768p; quanto maior a resolução, maior o custo.
480p768p1080p2k4kvoice_promptstringOpcionalPadrão: "Say the following."maxLength 1000Instrução de estilo de voz, usada para descrever tom, ritmo, sotaque ou emoção e outras formas de expressão; não será lida em voz alta; padrão 「Say the following.」. É ignorado quando audio_url é fornecido.
voice_languagestringOpcionalPadrão: "English (US)"O idioma usado no texto de script, padrão English (US). É ignorado quando audio_url é fornecido.
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)JapaneseMostrar tudo (2)Mostrar menos
KoreanHindicallbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 P-Video 2 Pro Replace Pruna AI $0.036 /segundo
-
 PixVerse V6 PixVerse $0.036 /segundo
-
 Wan 2.7 Video Alibaba $0.100 /segundo
-
 Veo 3.1 Lite Google $0.060 /segundo
-
 HappyHorse 1.0 Alibaba $0.168 /segundo
-
 HeyGen Avatar V HeyGen $0.150 /segundo
-
 LTX 2.5 Fast Lightricks $0.086 /segundo
-
 Hailuo 2.3 MiniMax $0.270 /vídeo
-
 Seedance 2.0 ByteDance $0.017 /segundo
-
 Kling 4.0 Kuaishou $0.204 /segundo
-
 Grok Imagine 1.5 xAI $0.011 /segundo
-
 Kling 4.0 Flash Kuaishou $0.122 /segundo