
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
Basta enviar uma única foto e um roteiro para gerar um vídeo de avatar falante com sincronização labial, expressões faciais e gestos, com suporte a saída em 1280p ou superior, ideal para apresentadores digitais e conteúdo de narração em vídeo
Experimentar heygen-avatar-iv
Entrada
Criações
Ver todas as criaçõesSaída
videoGuia visual das capacidades de geração de vídeo a partir de texto do HeyGen Avatar IV
Estilo Locução · Explicação · Vídeo de Avatar
Entradas de referência
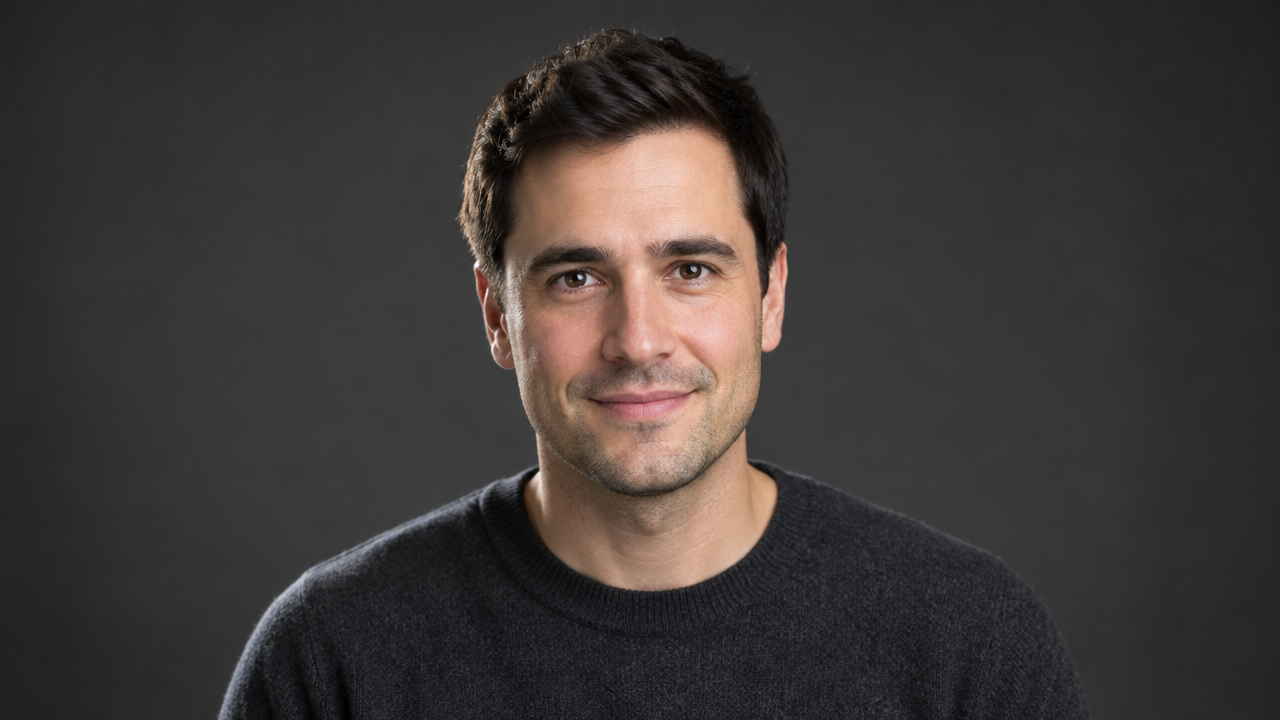
image_url
Prompt
Um apresentador fala diretamente para a câmera em um cenário de estúdio clean: enquadramento de cabeça e ombros, voltado de frente, contato visual estável com a lente, leves movimentos de cabeça e gestos naturais acompanhando o ritmo da fala; luz principal suave à frente à esquerda com preenchimento delicado, fundo sem emendas em cinza-escuro neutro, profundidade de campo rasa, composição widescreen 1080p 16:9, estilo realista de apresentação corporativa, ritmo firme e confiante.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Cartão de fórmula de prompt do HeyGen Avatar IV: guia visual de escrita estruturada
Estilo Explicação · Engenharia de Prompt · avatar falante
Entradas de referência
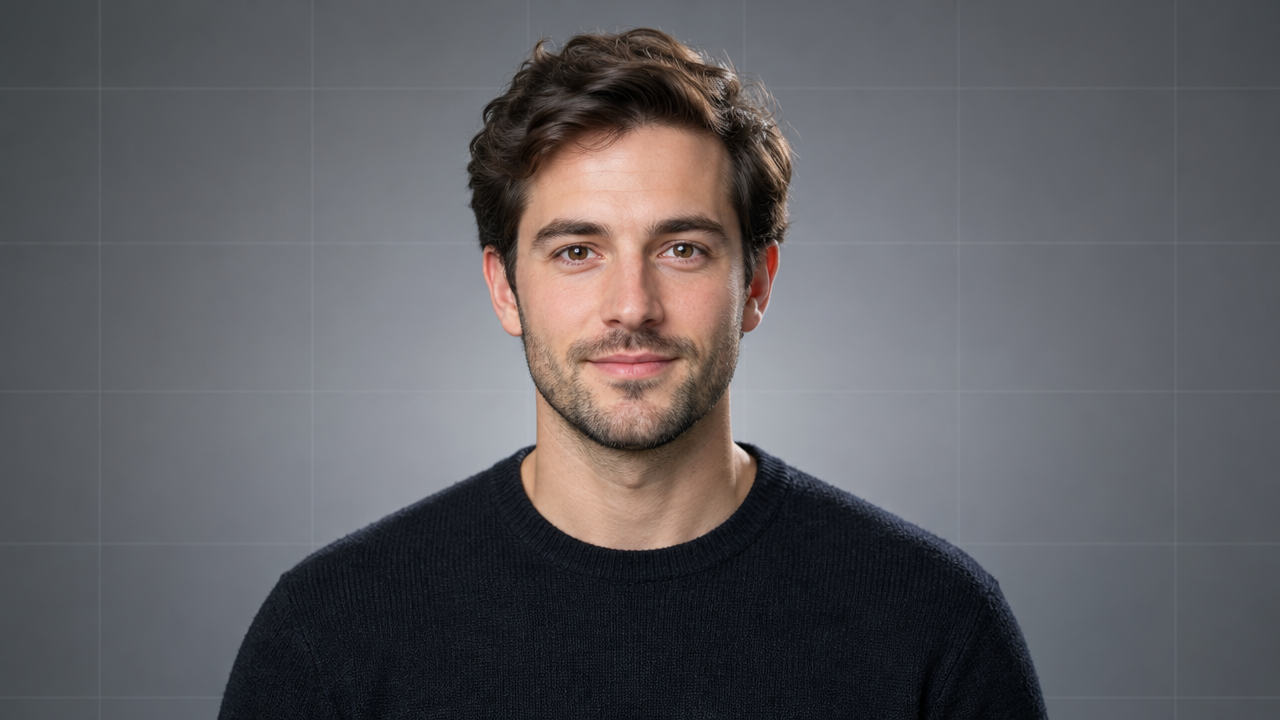
image_url
Prompt
Um apresentador de frente para a câmera fala diretamente para ela em um cenário de estúdio limpo, erguendo um cartão de índice de fórmula de prompt impresso; plano médio-próximo, movimento lento e sutil de aproximação com leve deriva de câmera na mão, luz principal suave com luz de contorno para separação, profundidade de campo rasa mantendo as bordas do cartão nítidas e legíveis e o rosto ainda afiado; ritmo estável com senso didático, com pequenos gestos naturais apontando para o cartão em cada parágrafo, fundo em gradiente neutro suave com linhas de grade tênues sugerindo o layout de diagramação de documento; imagem nítida, com alto nível de detalhe, qualidade 1080p.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Notas visuais sobre a linguagem de movimento de câmera: demonstração de apresentação com Avatar IV
Estilo linguagem-de-câmera · avatar falante · Explicação
Entradas de referência
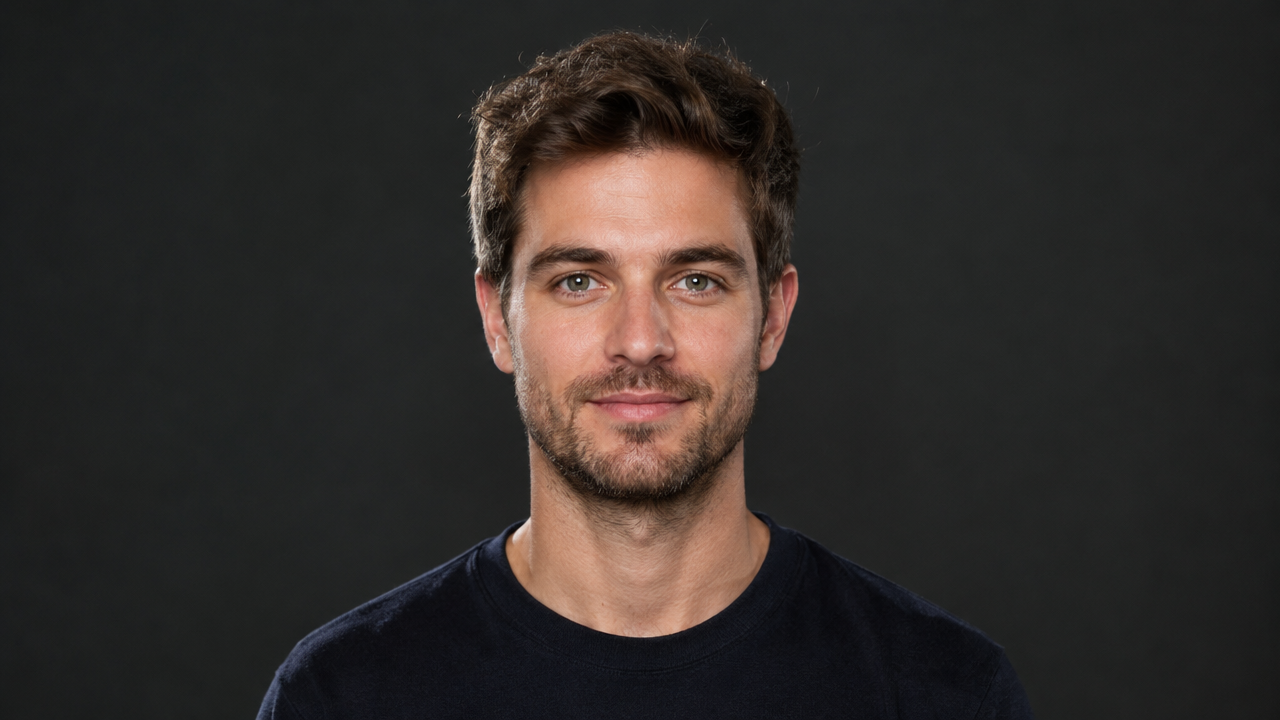
image_url
Prompt
Uma pessoa em cena, de frente para a câmera, fala diretamente para a lente com um tom calmo e explicativo, como se estivesse comentando diante da câmera uma nota visual sobre movimento de câmera. O olhar se mantém firme na lente, com leves movimentos naturais de cabeça e gestos explicativos ocasionais, indicando pan horizontal, aproximação e inclinação vertical. Composição de estúdio neutra com iluminação uniforme, fundo escuro e de baixa saturação, com uma atmosfera geral de gravação de tela, ritmo sereno e breves pausas entre cada termo de movimento de câmera.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Conceito de storyboard do HeyGen Avatar IV: do texto à imagem falante
Estilo avatar falante · Storyboard · Narrativa
Entradas de referência
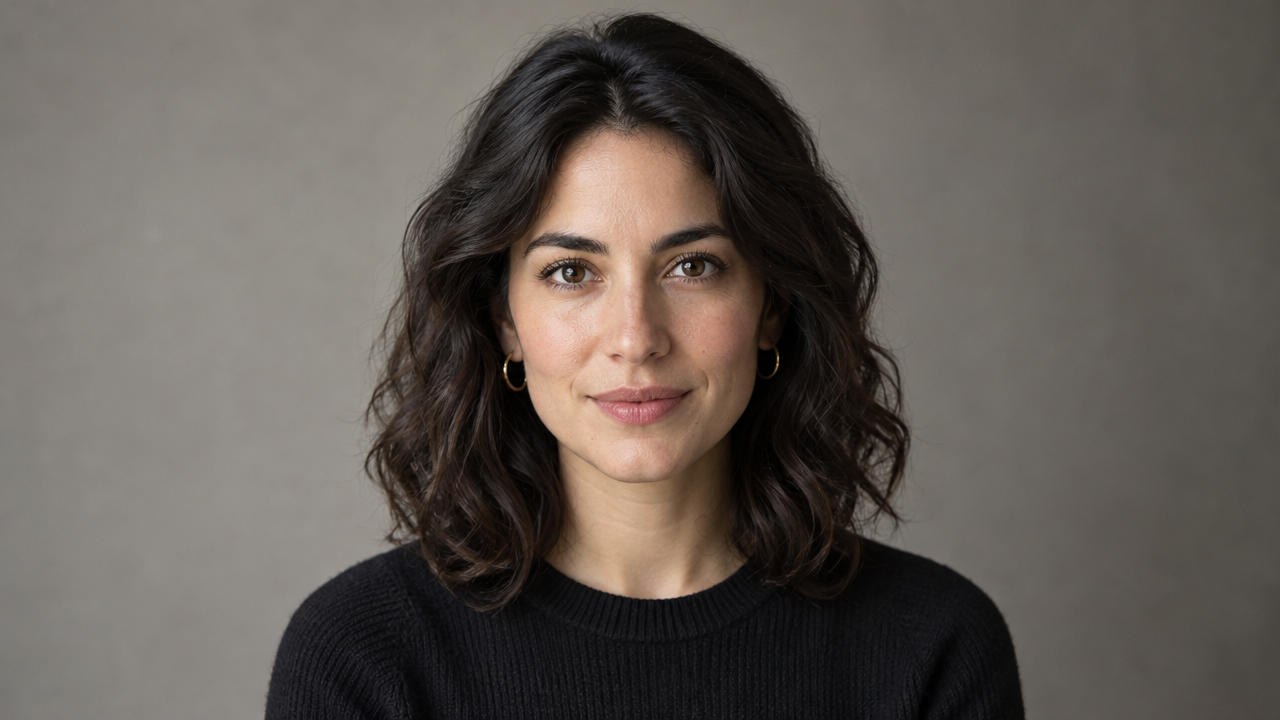
image_url
Prompt
Um retrato frontal de uma única pessoa é transformado num vídeo falante: a figura narra um breve texto de storyboard com sincronia labial natural, acompanhada de leves movimentos de cabeça e gestos expressivos, em formato 16:9 com fundo neutro e limpo, plano médio-próximo estável, luz principal suave, ritmo sereno e confiante.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
heygen-avatar-iv per second
| Preço unitário | $0.150 |
|---|
Visão geral do posicionamento
heygen-avatar-iv é um modelo de vídeo de avatar falante oferecido pela HeyGen, acessível por meio da interface unificada do HiAPI.ai. O desenvolvedor envia uma foto frontal de rosto e fornece um roteiro de texto ou um áudio para gerar um vídeo falante com sincronização labial, expressões faciais e gestos. Suporta saída em 720p e 1080p e várias proporções de tela, sendo adequado para desenvolvedores e equipes de conteúdo que precisam produzir rapidamente porta-vozes digitais ou material de locução de personagens.
Destaques principais
- Uma única foto gera todo o vídeo falante — basta uma foto frontal junto com um roteiro ou áudio, sem necessidade de gravação ou criação de ativos 3D para obter o vídeo final.
- Expressões e gestos acompanham a fala — a saída vai além da sincronização labial: expressões faciais e movimentos de cabeça variam naturalmente com a fala, aproximando-se da aparência de uma locução real.
- Entrada dupla: roteiro de texto e áudio — é possível preencher diretamente o roteiro e escolher a voz, ou enviar um áudio HTTPS para sincronização labial, adaptando-se a fluxos de dublagem existentes.
- Proporção e fundo configuráveis — oferece proporções como 16:9, 9:16 e 1:1, além de permitir preencher o quadro com fundo de cor sólida ou imagem.
Descrição das capacidades
Gerar vídeo falante a partir de foto: envie uma foto frontal de rosto para gerar um vídeo falante; a saída é um arquivo de vídeo, utilizável diretamente como peça final ou em edição posterior.
Converter roteiro em fala e conduzir a boca: preencha o texto do roteiro e especifique uma voz integrada; o modelo sintetiza a fala e conduz o avatar, com roteiro de até 5000 caracteres por segmento.
Sincronização labial com áudio: envie um link de áudio HTTPS para que a foto fale conforme a boca do áudio, com até 600 segundos por segmento de áudio; nesse caso, os parâmetros de roteiro e voz não têm efeito.
Controle de especificação de saída: escolha resolução de 720p ou 1080p e defina proporção 16:9, 9:16, 4:5, 5:4, 1:1 ou seguir a imagem original, adaptando-se a posições de publicação horizontais, verticais e quadradas.
Preenchimento de fundo do quadro: quando a proporção de saída difere da proporção da foto, é possível preencher as áreas vazias com cor sólida ou imagem de fundo, evitando bordas vazias na imagem.
Cenários de aplicação
- Equipes de marketing produzindo vídeos de porta-voz digital — usar roteiros de produto com fotos de personagens da marca para gerar vídeos de locução, destinados ao site, espaços publicitários e mídias sociais, sem necessidade de agendar presença real.
- Departamentos de treinamento gerando materiais de cursos explicativos — transformar apostilas de curso em roteiros e gerar em lote vídeos explicativos com imagem uniforme, incorporando-os a plataformas de aprendizagem ou materiais didáticos.
- Criadores de vídeos curtos produzindo locuções verticais — escolher proporção 9:16 e voz selecionada para gerar material de locução vertical, usado diretamente na atualização de conteúdo de plataformas de vídeos curtos.
- Adaptação multilíngue de conteúdo com dublagem existente — enviar áudios de dublagem já existentes para sincronização labial e gerar, com fotos, imagens de locução no idioma correspondente, para localização de conteúdo.
Limitações e recomendações de escolha
A foto de entrada deve ser um rosto claro e frontal; perfis, obstruções ou fotos de grupo afetam significativamente o resultado, e a qualidade da geração depende bastante da imagem de origem. A saída é um vídeo, não um texto finalizado, sendo necessário preparar previamente o roteiro ou o áudio. O limite é de 600 segundos por segmento de áudio e 5000 caracteres por roteiro; conteúdos mais longos precisam ser gerados em partes. Se for necessário apenas um avatar predefinido ou um gêmeo digital de pessoa real, deve-se escolher a linha de outro modelo correspondente.
Novidades
Ver o changelog →- Novo modelo Novo modelo: heygen-avatar-iv, envie uma foto de retrato e gere um vídeo de fala com sincronização labial usando um roteiro e uma voz predefinida ou áudio de condução; oferece…
Perguntas frequentes
Ver todas as perguntas →-
Quais entradas o HeyGen Avatar IV requer?
Uma foto de retrato e a escolha de um modo de condução: inserir o texto do roteiro e selecionar uma voz, ou enviar um arquivo de áudio. Ao usar o roteiro sem selecionar uma voz, será usada a voz padrão Warm Pro Narrator.
-
Que tipo de foto tem o melhor resultado?
Fotos individuais de rosto frontal, com traços faciais nítidos e sem obstruções, iluminação uniforme e boca naturalmente fechada têm o resultado mais confiável. Fotos de perfil, com máscara, em grupo ou com o rosto muito pequeno não são adequadas.
-
Qual é a duração do vídeo gerado?
Não é necessário informar a duração. Ao dublar falas, a duração é determinada pelo texto e pela velocidade da fala; no modo de áudio, a duração corresponde à do áudio enviado, com limite máximo de 600 segundos.
-
Quais proporções e resoluções são suportadas?
As proporções suportadas são 16:9, 9:16, 4:5, 5:4, 1:1 e auto (mantém a proporção da foto); as resoluções suportadas são 720p e 1080p.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: heygen-avatar-iv
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para heygen-avatar-iv e a rota default — veja a tabela de parâmetros abaixo.
voicestringOpcionalPadrão: "Warm Pro Narrator"minLength 1Especifica o timbre de voz usado para a locução do script do avatar digital; o padrão é Warm Pro Narrator. Quando audio_url é fornecido, este parâmetro é ignorado.
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer BrittneyMostrar tudo (94)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstringOpcionalminLength 1maxLength 5000O texto do script que o avatar digital irá ler; obrigatório quando audio_url não é fornecido.
audio_urlstringOpcionalpattern ^https://Endereço HTTPS do áudio usado para sincronização labial, com duração máxima de 600 segundos; quando fornecido, prompt e voice são ignorados.
image_urlstringObrigatóriopattern ^https://Endereço HTTPS da foto a ser animada, que deve conter um único rosto nítido e frontal, nos formatos jpg, jpeg, png, webp, gif, avif, heic e heif.
backgroundobjectOpcional
Configuração de fundo usada para preencher as áreas da imagem não cobertas pelo retrato quando a proporção de tela da saída difere da foto original; pode ser especificada por cor ou imagem, com padrão branco.
typestringObrigatórioO modo de preenchimento do fundo, que determina se o campo value é interpretado como cor ou como URL de imagem.
colorimagevaluestringObrigatóriominLength 1O valor concreto do fundo: quando type é cor, informe um valor hexadecimal #RRGGBB; quando type é imagem, informe um endereço HTTPS de imagem.
resolutionstringOpcionalPadrão: "720p"A resolução do vídeo de saída; o padrão é 720p.
720p1080paspect_ratiostringOpcionalPadrão: "16:9"A proporção de tela do vídeo de saída; o padrão é 16:9; quando definido como auto, prioriza-se manter a proporção da foto de origem e, se não for possível lê-la, recorre-se a 16:9.
16:99:164:55:41:1autocallbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →-

Tutorial
Como chamar kling-4.0/image-to-video na HiAPI: curl, Python e polling
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado
-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Avaliação comparativa
hailuo-2.3-fast/image-to-video comparação lado a lado: como escolher modelos de imagem para vídeo e pontos de migração
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video na HiAPI: curl + Python
Faça uma requisição de imagem para vídeo funcional na HiAPI: do upload do primeiro quadro ao polling assíncrono e ao download final
-

Avaliação comparativa
Comparação lado a lado do Recraft v4.1 Flash em text-to-image: guia de seleção e migração para desenvolvedores
Com um custo de $0.01 por imagem e capacidade de text-to-image pura, avalie se ele é adequado para seu pipeline de geração de imagens
-

Tutorial
recraft-v4.1-flash geração de imagens por texto na prática: 5 cenários de negócio de alto valor e pontos de integração
Partindo de um custo de US$ 0,01 por imagem, planeje como aplicar a geração de imagens em negócios reais
-

Tutorial
Como usar kling-4.0/text-to-video através da API HiAPI: curl, Python e um exemplo de requisição executável
Guia prático para desenvolvedores: prompts cinematográficos, áudio sincronizado, polling assíncrono e download da saída
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 Veo 3.1 Lite Google $0.060 /segundo
-
 Gemini Omni Google --
-
 Vidu Q3 Vidu $0.149 /segundo
-
 Ray 3.2 Luma $0.214 /vídeo
-
 Kling 3.0 Kuaishou $0.100 /segundo
-
 Kling 4.0 Kuaishou $0.330 /segundo
-
 FLUX 3 Max Black Forest Labs $0.061 /segundo
-
 Gemini Omni 1.1 Flash Google $0.450 /vídeo
-
 Veo 3.1 Fast Google $0.170 /segundo
-
 Wan 3.0 Video Alibaba $0.040 /segundo
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 LTX 2.5 Fast Lightricks $0.086 /segundo
