Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Modèle de vidéo parlante piloté par portrait de Pruna AI, capable de générer, à partir d'un seul portrait, un clip de présentation avec synchronisation labiale et variations d'expressions, pilotable par un fichier audio importé ou par la synthèse vocale intégrée qui lit directement le script ; adapté à l'explication de cours, au doublage multilingue et à la production en série de vidéos courtes de type avatar numérique
Essayer p-video-2-pro-avatar
Entrée
Créations
Voir toutes les créationsSortie
videoNotes visuelles sur le langage cinématographique · présentation orale par un présentateur numérique
Style Voix off · langage-cinématographique · studio
Entrées de référence
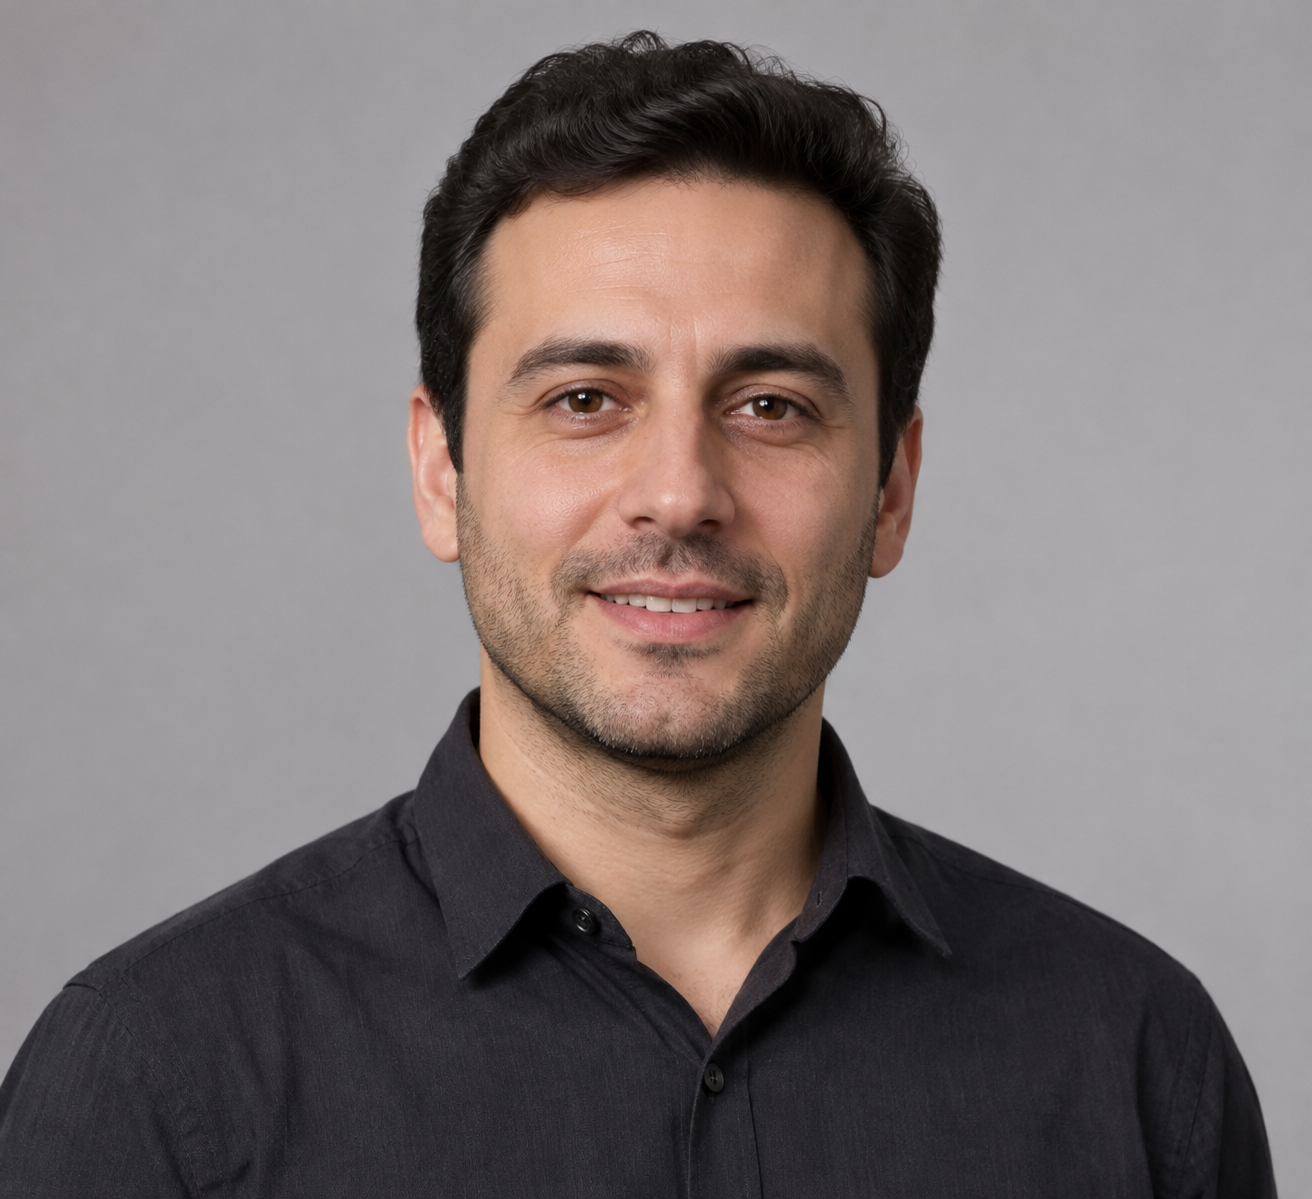
Image de portrait
Prompt
Un formateur au maintien posé, vêtu d'une chemise sombre, se tient devant un fond de studio photographique gris clair et doux, face à la caméra, et explique un à un les termes de mouvement de caméra. Les épaules et la tête bougent légèrement au rythme de la parole, l'expression est concentrée et mesurée, le regard stable dirigé vers l'objectif. Une lumière principale neutre et douce arrive de face sur le côté, complétée par un léger éclairage de remplissage réfléchi, créant une atmosphère calme de salle de cours ; la texture de la peau est réaliste, et le sujet cligne naturellement des yeux et hoche légèrement la tête au fil des phrases.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Confession d'une commissaire d'exposition après la fermeture du musée
Style Portrait parlant · Musée · Culture
Entrées de référence
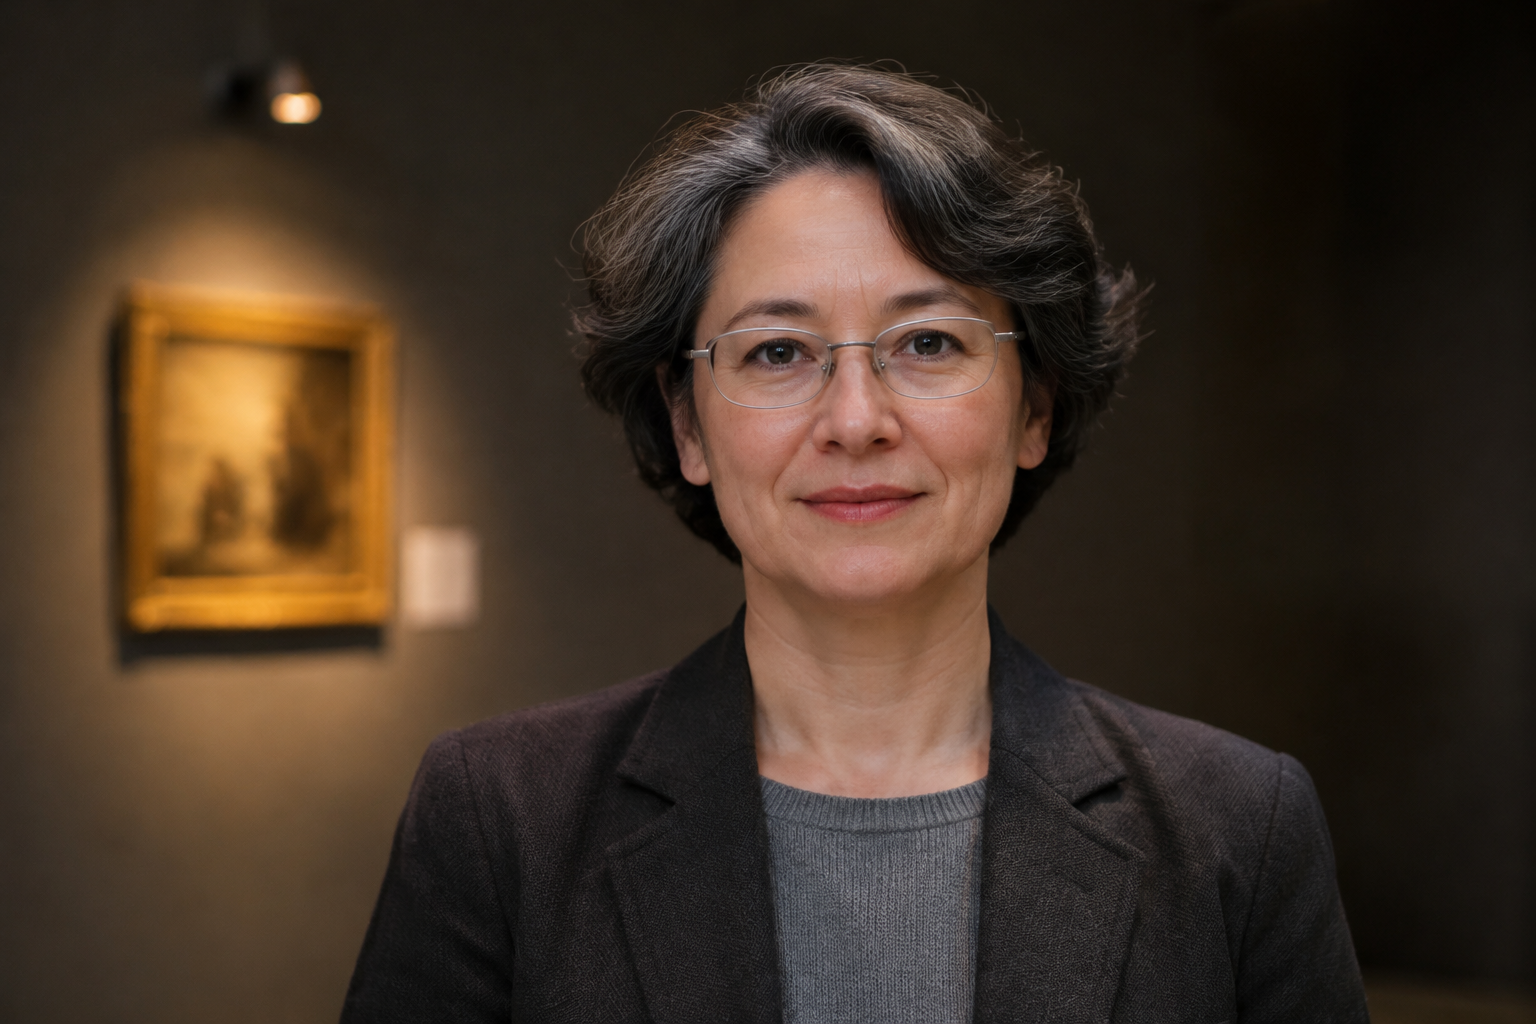
Image de portrait
Prompt
Une commissaire d'exposition d'âge mûr est assise au bord d'un banc de galerie, un mur d'exposition doucement éclairé se trouve derrière elle, en arrière-plan au-dessus de son épaule ; elle parle calmement face à la caméra d'une œuvre exposée ; elle hoche légèrement la tête, cligne naturellement des yeux, l'expression posée et douce ; faible profondeur de champ, éclairage chaleureux de galerie à filament de tungstène avec une douce décroissance, atmosphère paisible de musée, seuls de menus mouvements du visage et des épaules.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
p-video-2-pro-avatar per second
| Spécifications | Prix unitaire |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
Présentation
Modèle de génération vidéo destiné aux présentations par avatar numérique : importez un portrait de personne comme image de première frame, puis fournissez un fichier audio de voix ou saisissez un texte de script pour générer une vidéo où la personne parle. Le script est lu par la synthèse vocale intégrée, avec un choix parmi plusieurs timbres et langues, et un prompt décrit les gestes et l'expression de la personne pendant qu'elle parle. Idéal pour les créateurs de contenus nécessitant une présence humaine à l'écran, comme les cours explicatifs, les présentations marketing ou les vidéos courtes pour les réseaux sociaux, en supprimant l'étape de tournage et de synchronisation labiale.
Points clés
- Un seul portrait suffit pour animer une vidéo parlante — une seule image de portrait comme première frame suffit, sans séquence vidéo existante, pour générer une scène où la personne parle.
- Deux modes de pilotage : audio ou script — vous pouvez importer un fichier audio de voix de 3 minutes maximum, ou saisir un script lu par la synthèse vocale intégrée ; la durée de la vidéo suit celle de la voix.
- Le prompt contrôle l'expression et les gestes — un prompt décrit l'apparence, les gestes et l'expression de la personne pendant qu'elle parle, avec la possibilité de définir une graine aléatoire pour reproduire le résultat.
- Plusieurs niveaux de résolution pour tous les besoins de diffusion — cinq résolutions au choix : 480p, 768p, 1080p, 2k et 4k, pour adapter la qualité à la plateforme de publication.
Description des capacités
Vidéo parlante pilotée par un portrait : fournissez un portrait de personne au format jpg, jpeg, png ou webp via un lien HTTPS comme première frame pour générer une vidéo où la personne parle ; le contenu visuel est décrit dans le prompt (apparence, gestes et expression).
Pilotage de la synchronisation labiale par un audio importé : fournissez un lien HTTPS vers un fichier audio de voix ; la durée de la vidéo correspond à celle de l'audio, soit 3 minutes maximum ; en résolution 4k, l'audio est limité à 125 secondes. Dans ce cas, les paramètres de script, de timbre, de langue et de style vocal ne s'appliquent plus.
Pilotage par conversion texte-parole du script : si aucun audio n'est fourni, saisissez un script de 5000 caractères maximum, lu par la synthèse vocale intégrée pour générer la vidéo ; la langue du script doit être choisie parmi les dix langues proposées, et une description de style vocal de 1000 caractères maximum permet de préciser le ton et le rythme.
Choix du timbre et des paramètres visuels : sélectionnez l'un des 30 timbres intégrés pour lire le script, décrivez l'image avec un prompt de 2000 caractères maximum et définissez une graine aléatoire entre 0 et 2147483647 ; la résolution est au choix parmi 480p, 768p, 1080p, 2k et 4k, avec 768p par défaut.
Scénarios d'utilisation
- Vidéos de présentation en série pour formateurs — le formateur fournit son portrait et le script de son cours pour générer en série des vidéos de présentation à l'écran, destinées à des cours en ligne ou à des rubriques de vulgarisation.
- Présentations marketing avec un visage réel — les équipes marketing associent le portrait d'un porte-parole produit à un texte promotionnel pour générer des clips de présentation diffusés dans les fils d'actualité ou sur les comptes sociaux de la marque.
- Montage final à partir d'un enregistrement existant — le créateur importe son propre enregistrement audio et son portrait pour synchroniser la bouche de l'image sur l'enregistrement et produire directement une vidéo courte pour les réseaux sociaux.
- Transformer un portrait statique en vidéo parlante — à partir d'une photo de personne existante, avec un script ou un audio, générez une scène parlante avec expressions et synchronisation labiale, pour une rubrique d'avatar numérique ou une page de présentation.
Limites et conseils de choix
Le script et le prompt ont des limites de longueur : 2000 caractères maximum pour le prompt, 5000 caractères maximum pour le script et 1000 caractères maximum pour la description du style vocal. La synthèse vocale intégrée ne prend pas en charge le chinois ; la langue du script doit être choisie parmi l'anglais, l'espagnol, le français, l'allemand, l'italien, le portugais (Brésil), le japonais, le coréen et l'hindi. La durée de la vidéo est déterminée par la voix, avec un maximum de 3 minutes ; en résolution 4k, l'audio est limité à 125 secondes.
Nouveautés
Voir le journal des modifications →- Nouveau modèle P-Video 2 Pro Avatar disponible : un portrait et un fichier audio ou un script suffisent pour générer une vidéo de présentation parlée de 3 minutes maximum
Questions fréquentes
Voir toutes les questions →-
Quel audio utiliser pour animer l'avatar numérique ?
Utilisez audio_url pour transmettre un lien audio HTTPS ; la durée de la vidéo est égale à celle de l'audio, jusqu'à 3 minutes maximum (125 secondes maximum en 4k). Une fois l'audio transmis, script, voice, voice_language et voice_prompt ne prennent plus effet ; si les deux sont fournis, l'audio prévaut.
-
Quelle est la longueur maximale du texte du script que l'on peut saisir ?
Le champ script est limité à 5000 caractères, mais la durée de la vidéo est finalement déterminée par la durée de lecture vocale du script par le TTS intégré, avec une limite de 3 minutes ; à l'approche de cette limite, il est recommandé de condenser le texte ou de générer par segments.
-
Comment mieux rédiger le prompt d'une vidéo de prise de parole face caméra ?
La description du prompt précise l'apparence, les gestes et l'expression du personnage lorsqu'il parle, sans écrire de répliques. Il est recommandé de suivre l'ordre « apparence du personnage → amplitude des gestes → expression et regard → sensation de caméra », par exemple « un homme en costume sombre, en position assise naturelle, hochant parfois la tête, souriant face à la caméra, plan moyen fixe », en restant sous 2000 caractères ; la valeur par défaut n'est que « The person is talking. ».
-
Quelles langues et quelles voix sont prises en charge ?
voice_language propose 10 langues : anglais américain, anglais britannique, espagnol, français, allemand, italien, portugais brésilien, japonais, coréen et hindi ; le chinois n'est pas encore pris en charge. voice propose 30 voix prédéfinies, dont le nom indique le genre ; par défaut, il s'agit de Zephyr (Female). Le texte de script doit correspondre à la langue sélectionnée.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : p-video-2-pro-avatar
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour p-video-2-pro-avatar et la route default — voir le tableau des paramètres ci-dessous.
seedintegerOptionnelmin 0max 2147483647Graine aléatoire, entier compris entre 0 et 2147483647 ; fournir la même graine en gardant les autres entrées inchangées aide à reproduire le résultat, sinon elle est aléatoire.
voicestringOptionnelDéfaut: "Zephyr (Female)"Voix utilisée par la synthèse vocale intégrée, par défaut Zephyr (Female). Ce paramètre est ignoré lorsqu'audio_url est fourni.
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)Tout afficher (22)Afficher moins
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstringOptionnelDéfaut: "The person is talking."maxLength 2000Description du contenu de la vidéo, précisant l'apparence, les mouvements et le comportement de la personne pendant qu'elle parle ; par défaut « The person is talking. ».
scriptstringOptionnelmaxLength 5000Texte exact que le présentateur numérique lira, rédigé dans la langue voice_language choisie (le chinois n'est pas pris en charge). Obligatoire lorsqu'audio_url n'est pas fourni ; la durée de lecture détermine la longueur de la vidéo, jusqu'à 3 minutes.
audio_urlstringOptionnelpattern ^https://URL HTTPS de l'audio vocal, jusqu'à 3 minutes (125 secondes maximum en résolution 4k) ; la durée de la vidéo est identique à celle de l'audio. Une fois fourni, script, voice, voice_language et voice_prompt sont ignorés.
image_urlstringRequispattern ^https://URL HTTPS de l'image du portrait de la personne qui parle, utilisée comme première image de la vidéo ; formats jpg, jpeg, png et webp pris en charge.
resolutionstringOptionnelDéfaut: "768p"Résolution de sortie, au choix 480p, 768p, 1080p, 2k ou 4k, par défaut 768p ; plus la résolution est élevée, plus le coût augmente.
480p768p1080p2k4kvoice_promptstringOptionnelDéfaut: "Say the following."maxLength 1000Instruction de style vocal décrivant le ton, le rythme, l'accent ou l'émotion, etc. ; elle n'est pas lue à voix haute ; par défaut « Say the following. ». Ignorée lorsqu'audio_url est fourni.
voice_languagestringOptionnelDéfaut: "English (US)"Langue utilisée par le texte script, par défaut English (US). Ignorée lorsqu'audio_url est fourni.
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)JapaneseTout afficher (2)Afficher moins
KoreanHindicallbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →
Modèles associés
Voir tous les modèles →Même type
-
 FLUX 3 Max Black Forest Labs $0.121 /seconde
-
 Kling 4.0 Flash Kuaishou $0.122 /seconde
-
 Kling 3.0 Turbo Kuaishou $0.144 /seconde
-
 PixVerse V6 PixVerse $0.036 /seconde
-
 Vidu Q4 Preview Vidu $0.051 /seconde
-
 Kling 2.5 Kuaishou $0.090 /seconde
-
 Veo 3.1 Lite Google $0.060 /seconde
-
 Grok Imagine 1.5 xAI $0.011 /seconde
-
 Seedance 2.5 ByteDance $0.121 /seconde
-
 Gemini Omni 1.1 Google $0.450 /vidéo
-
 FLUX 3 Video Black Forest Labs $0.090 /seconde
-
 Runway Gen 4.5 Runway $0.172 /seconde