Pruna AI
P-Video 2 Pro Avatar
p-video-2-pro-avatar
Von Pruna AI stammendes Modell für portraitsgesteuerte Sprechvideos, das aus einem einzigen Porträtfoto Talking-Head-Clips mit Lippensynchronisation und wechselnden Gesichtsausdrücken erzeugt; es kann entweder durch hochgeladenes Audio angesteuert werden oder das Skript direkt per integrierter Text-to-Speech vorlesen – ideal für Kurserklärungen, mehrsprachige Vertonung und die serienweise Produktion von Kurzvideos mit digitalen Menschen
p-video-2-pro-avatar ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
videoVisuelle Notizen zur Bildsprache · erklärender digitaler Avatar mit Sprechauftritt
Stil Sprechtext · Kamerasprache · Studio
Referenz-Eingaben
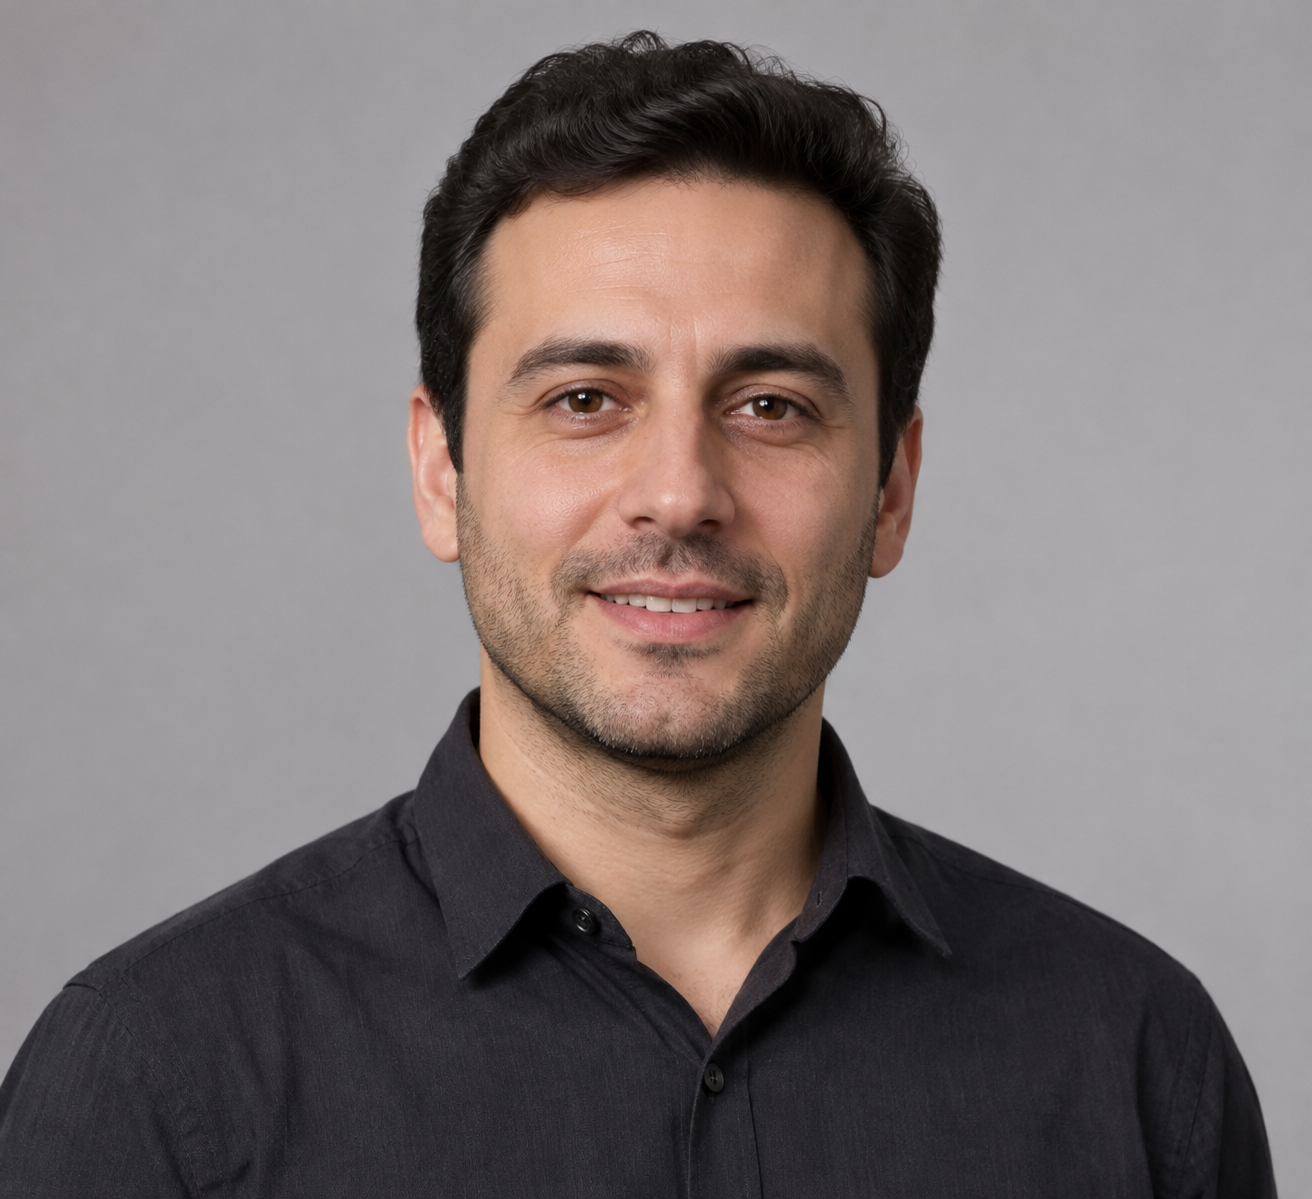
Porträtbild
Prompt
Ein Dozent in dunklem Hemd mit ruhiger Ausstrahlung steht vor einem weichen, hellgrauen Studiohintergrund und erklärt der Kamera gegenüber nacheinander die Begriffe der Kameraführung. Schultern und Kopf bewegen sich leicht im Rhythmus des Sprechens, der Ausdruck ist konzentriert und zurückhaltend, der Blick ruhig auf die Kamera gerichtet. Von vorne seitlich kommt ein neutrales, weiches Hauptlicht, ergänzt durch dezentes Reflexionsfülllicht, das eine ruhige Unterrichtsatmosphäre schafft; die Hautstruktur wirkt realistisch, beim Sprechen blinzelt die Person natürlich und nickt leicht.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Selbstaussage einer Kuratorin nach Schließung des Museums
Stil Sprechendes Porträt · Museum · Kultur
Referenz-Eingaben
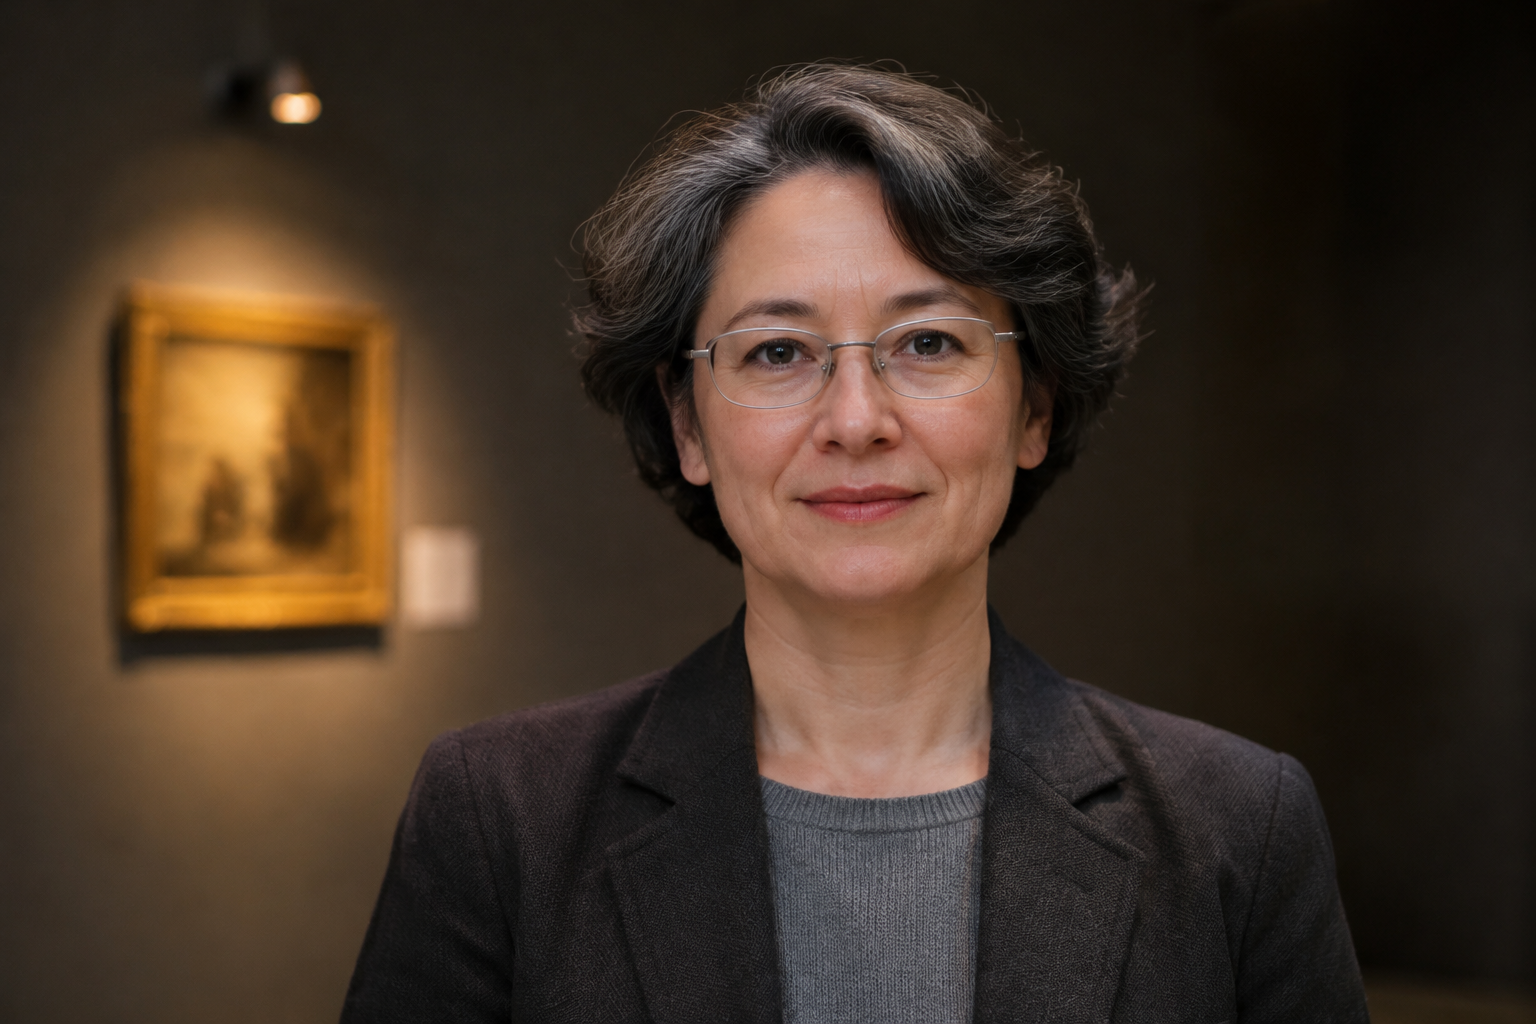
Porträtbild
Prompt
Eine Kuratorin mittleren Alters sitzt am Rand einer Galeriebank, hinter ihrer Schulter eine sanft beleuchtete Ausstellungswand; sie spricht ruhig in die Kamera über ein Exponat, nickt leicht, blinzelt natürlich, ihr Ausdruck ist gefasst und freundlich; geringe Schärfentiefe, warmes Wolfram-Galerielicht mit weichem Abfall, stille Museumsatmosphäre, nur feine Bewegungen in Gesicht und Schultern.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
p-video-2-pro-avatar per second
| Spezifikationen | Einzelpreis |
|---|---|
| 480P | $0.0286 |
| 768P | $0.0572 |
| 1080P | $0.0858 |
| 2K | $0.1143 |
| 4K | $0.1715 |
Einordnung und Kurzprofil
Ein Videogenerierungsmodell für digitale Sprecher-Szenen: Laden Sie ein Portrait einer Person als erstes Frame hoch und stellen Sie dann Sprach-Audio bereit oder geben Sie einen Skripttext ein, um ein Video zu erzeugen, in dem die Person spricht. Das Skript wird von der integrierten Sprachausgabe vorgelesen; verschiedene Stimmen und Sprachen stehen zur Auswahl, und mit einem Prompt lassen sich Bewegungen und Mimik der sprechenden Person beschreiben. Geeignet für Ersteller von Inhalten wie Kurserklärungen, Marketing-Sprechervideos und kurzen Social-Media-Videos, die eine reale Person vor der Kamera zeigen möchten, ohne Dreh und Lippensynchronisation.
Kernhighlights
- Ein einziges Portrait genügt für ein Sprechvideo – nur ein Portrait einer Person als erstes Frame ist nötig, kein vorhandenes Videomaterial, um eine sprechende Person zu erzeugen.
- Zwei Steuerungswege: Audio und Skript – Laden Sie Sprach-Audio mit bis zu 3 Minuten hoch, oder geben Sie ein Skript ein, das von der integrierten Sprachausgabe vorgelesen wird; die Videolänge folgt der Sprachaufnahme.
- Prompts steuern Mimik und Bewegung – Beschreiben Sie mit einem Prompt Aussehen, Bewegungen und Gesichtsausdruck der sprechenden Person; mit einem zufälligen Seed lassen sich Ergebnisse reproduzieren.
- Mehrere Auflösungsstufen für unterschiedliche Anforderungen – Wählbar sind 480p, 768p, 1080p, 2k und 4k, sodass die Bildqualität passend zur Veröffentlichungsplattform gewählt werden kann.
Funktionsbeschreibung
Portraitgesteuertes Sprechvideo: Stellen Sie ein Portrait einer Person im Format jpg, jpeg, png oder webp über einen HTTPS-Link als erstes Frame bereit, um ein Video der sprechenden Person zu erzeugen; der Prompt beschreibt Aussehen, Bewegungen und Mimik im Bild.
Lippensynchronisation über hochgeladenes Audio: Stellen Sie einen HTTPS-Link zu Sprach-Audio bereit; die Videolänge entspricht dem Audio und beträgt maximal 3 Minuten; bei 4k-Auflösung darf das Audio maximal 125 Sekunden lang sein. In diesem Fall sind die Einstellungen für Skript, Stimme, Sprache und Sprachstil nicht mehr wirksam.
Skript-zu-Sprache-Steuerung: Wenn kein Audio bereitgestellt wird, geben Sie ein Skript mit bis zu 5000 Zeichen ein, das von der integrierten Sprachausgabe vorgelesen und zum Generieren des Videos verwendet wird. Die Sprache des Skripts muss aus zehn vorgegebenen Sprachen gewählt werden; mit einer bis zu 1000 Zeichen langen Beschreibung des Sprachstils lassen sich Tonfall und Rhythmus festlegen.
Auswahl von Stimme und Bildparametern: Aus 30 integrierten Stimmen kann eine zum Vorlesen des Skripts gewählt werden. Mit einem Prompt von bis zu 2000 Zeichen lässt sich das Bild beschreiben, und ein zufälliger Seed zwischen 0 und 2147483647 kann festgelegt werden; die Auflösung ist unter 480p, 768p, 1080p, 2k und 4k wählbar, Standard ist 768p.
Anwendungsszenarien
- Massenproduktion von Sprechervideos für Kursdozenten – Dozenten stellen Portrait und Erklärungsskript bereit und erzeugen in großer Zahl Erklärvideos mit der Person vor der Kamera für Online-Kurse oder Wissensformate.
- Marketingmaterial mit realer Sprecherfigur – Marketingmitarbeiter erzeugen mit dem Portrait eines Produktbotschafters und Werbetexten Sprecherclips für Feed-Werbung oder Marken-Social-Media-Kanäle.
- Vorhandene Tonaufnahmen als fertiges Video – Ersteller laden ihre eigene Sprachaufnahme und ihr Portrait hoch, sodass die Lippenbewegungen im Bild zur Aufnahme passen, und erzeugen direkt Kurzvideos für Social-Media-Plattformen.
- Statisches Portrait in ein Sprechvideo verwandeln – Mit einem vorhandenen Foto einer Person und einem Skript oder Audio wird ein sprechendes Bild mit Mimik und Lippenbewegungen erzeugt, etwa für Formate mit digitalen Menschen oder Präsentationsseiten.
Einschränkungen und Auswahlhinweise
Für Skript und Prompt gelten Längenbegrenzungen: Der Prompt darf maximal 2000 Zeichen, das Skript maximal 5000 Zeichen und die Beschreibung des Sprachstils maximal 1000 Zeichen lang sein. Die integrierten Stimmen unterstützen kein Chinesisch; die Skriptsprache muss aus Englisch, Spanisch, Französisch, Deutsch, Italienisch, Portugiesisch (Brasilien), Japanisch, Koreanisch und Hindi gewählt werden. Die Videolänge wird durch die Sprachaufnahme bestimmt und beträgt maximal 3 Minuten; bei 4k-Auflösung darf das Audio maximal 125 Sekunden lang sein.
Neuigkeiten
Changelog ansehen →- Neues Modell P-Video 2 Pro Avatar ist online: Aus einem Porträt plus Audio oder Textskript entsteht ein Sprechervideo mit bis zu 3 Minuten Länge
Häufige Fragen
Alle Fragen ansehen →-
Mit welchem Audio wird der digitale Mensch gesteuert?
Übergeben Sie mit audio_url einen HTTPS-Audiolink. Die Videolänge entspricht der Audiodauer, maximal 3 Minuten (bei 4k maximal 125 Sekunden). Nach dem Übergeben von Audio werden script, voice, voice_language und voice_prompt unwirksam; werden beide übergeben, ist das Audio maßgeblich.
-
Wie lang darf der eingegebene Skripttext sein?
Das Feld script darf maximal 5000 Zeichen enthalten, aber die Videolänge wird letztlich durch die Dauer der Sprachausgabe bestimmt, mit der das integrierte TTS das Skript vorliest, wobei die Obergrenze bei 3 Minuten liegt; wenn du dich dieser Grenze näherst, empfiehlt es sich, den Text zuerst zu kürzen oder die Generierung in Abschnitten durchzuführen.
-
Wie schreibt man den Prompt für ein Sprechvideo am besten?
Die Prompt beschreibt das Aussehen, die Bewegungen und die Mimik einer Person beim Sprechen, ohne Dialogtext zu schreiben. Empfohlen wird die Reihenfolge „Aussehen der Person → Ausmaß der Bewegung → Gesichtsausdruck und Blickrichtung → Kamerawirkung“, zum Beispiel „Ein Herr im dunklen Anzug, natürliche Sitzhaltung, nickt gelegentlich, lächelt in die Kamera, feste Halbtotale“, begrenzt auf 2000 Zeichen; der Standardwert ist lediglich „The person is talking.“.
-
Welche Sprachen und Stimmen werden unterstützt?
voice_language unterstützt 10 Sprachen: Amerikanisches Englisch, Britisches Englisch, Spanisch, Französisch, Deutsch, Italienisch, Brasilianisches Portugiesisch, Japanisch, Koreanisch und Hindi; Chinesisch ist derzeit nicht enthalten. voice bietet 30 voreingestellte Stimmen, deren Namen das Geschlecht angeben; standardmäßig ist es Zephyr (Female). Der Text von script muss mit der ausgewählten Sprache übereinstimmen.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: p-video-2-pro-avatar
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für p-video-2-pro-avatar und Route default — siehe Parametertabelle unten.
seedintegerOptionalmin 0max 2147483647Zufälliger Startwert, ganzzahlig von 0–2147483647; die Übergabe desselben Startwerts bei sonst unveränderten Eingaben hilft, Ergebnisse zu reproduzieren; wird er nicht übergeben, ist er zufällig.
voicestringOptionalStandard: "Zephyr (Female)"Stimme für die integrierte Text-zu-Sprache, Standard ist Zephyr (Female). Wird dieser Parameter ignoriert, wenn audio_url bereitgestellt wird.
Zephyr (Female)Puck (Male)Charon (Male)Kore (Female)Fenrir (Male)Leda (Female)Orus (Male)Aoede (Female)Alle anzeigen (22)Weniger anzeigen
Callirrhoe (Female)Autonoe (Female)Enceladus (Male)Iapetus (Male)Umbriel (Male)Algenib (Male)Despina (Female)Erinome (Female)Laomedeia (Female)Achernar (Female)Algieba (Male)Schedar (Male)Gacrux (Female)Pulcherrima (Female)Achird (Male)Zubenelgenubi (Male)Vindemiatrix (Female)Sadachbia (Male)Sadaltager (Male)Sulafat (Female)Alnilam (Male)Rasalgethi (Male)promptstringOptionalStandard: "The person is talking."maxLength 2000Beschreibung des Videoinhalts: Aussehen, Bewegungen und Verhalten der Person beim Sprechen; Standard ist „The person is talking.“.
scriptstringOptionalmaxLength 5000Der exakte Text, den der digitale Mensch vorlesen soll, verfasst in der gewählten voice_language (Chinesisch wird nicht unterstützt). Erforderlich, wenn audio_url nicht bereitgestellt wird; die Vorlesedauer bestimmt die Videolänge, maximal 3 Minuten.
audio_urlstringOptionalpattern ^https://HTTPS-URL der Sprach-Audiodatei, maximal 3 Minuten (bei 4k-Auflösung maximal 125 Sekunden); die Videolänge entspricht der Audiolänge. Nach Bereitstellung werden script, voice, voice_language und voice_prompt ignoriert.
image_urlstringPflichtpattern ^https://HTTPS-URL eines Porträtbilds der sprechenden Person, das als erstes Frame des Videos verwendet wird; unterstützt die Formate jpg, jpeg, png, webp.
resolutionstringOptionalStandard: "768p"Ausgabeauflösung, wählbar sind 480p, 768p, 1080p, 2k, 4k, Standard ist 768p; je höher die Auflösung, desto höher die Kosten.
480p768p1080p2k4kvoice_promptstringOptionalStandard: "Say the following."maxLength 1000Anweisung zum Sprachstil, die Tonfall, Tempo, Akzent oder Emotion und andere Ausdrucksweisen beschreibt und nicht vorgelesen wird; Standard ist „Say the following.“. Wird ignoriert, wenn audio_url bereitgestellt wird.
voice_languagestringOptionalStandard: "English (US)"Sprache des script-Textes, Standard ist English (US). Wird ignoriert, wenn audio_url bereitgestellt wird.
English (US)English (UK)SpanishFrenchGermanItalianPortuguese (Brazil)JapaneseAlle anzeigen (2)Weniger anzeigen
KoreanHindicallbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "p-video-2-pro-avatar",
  "input": {
    "voice": "Zephyr (Female)",
    "prompt": "The person is talking.",
    "image_url": "…",
    "resolution": "768p",
    "voice_prompt": "Say the following.",
    "voice_language": "English (US)"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "p-video-2-pro-avatar",
input: {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "p-video-2-pro-avatar",
"input": {
"voice": "Zephyr (Female)",
"prompt": "The person is talking.",
"image_url": "…",
"resolution": "768p",
"voice_prompt": "Say the following.",
"voice_language": "English (US)"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Kling 3.0 Turbo Kuaishou $0.144 /Sekunde
-
 LTX 2.5 Fast Lightricks $0.086 /Sekunde
-
 PixVerse V6 Max PixVerse $0.030 /Sekunde
-
 FLUX 3 Max Black Forest Labs $0.121 /Sekunde
-
 Kling 2.5 Kuaishou $0.090 /Sekunde
-
 MiniMax H3 MiniMax $0.072 /Sekunde
-
 Kandinsky 6.0 Pro $1.93 /Video
-
 Ray 3.2 Luma $0.214 /Video
-
 Grok Imagine 1.5 xAI $0.011 /Sekunde
-
 FLUX 3 Video Black Forest Labs $0.090 /Sekunde
-
 Seedance 2.0 ByteDance $0.017 /Sekunde
-
 HeyGen Avatar IV HeyGen $0.150 /Sekunde