
Black Forest Labs
FLUX 3 Image
flux-3-image
Ein bildorientiertes Modell aus der multimodalen Familie von Black Forest Labs, das eine gemeinsame Trainingsarchitektur und das Self-Flow-Framework mit Video und Audio teilt und sich für Upgrades von Bildgenerierungs-Pipelines auf Basis des FLUX-Systems eignet
flux-3-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image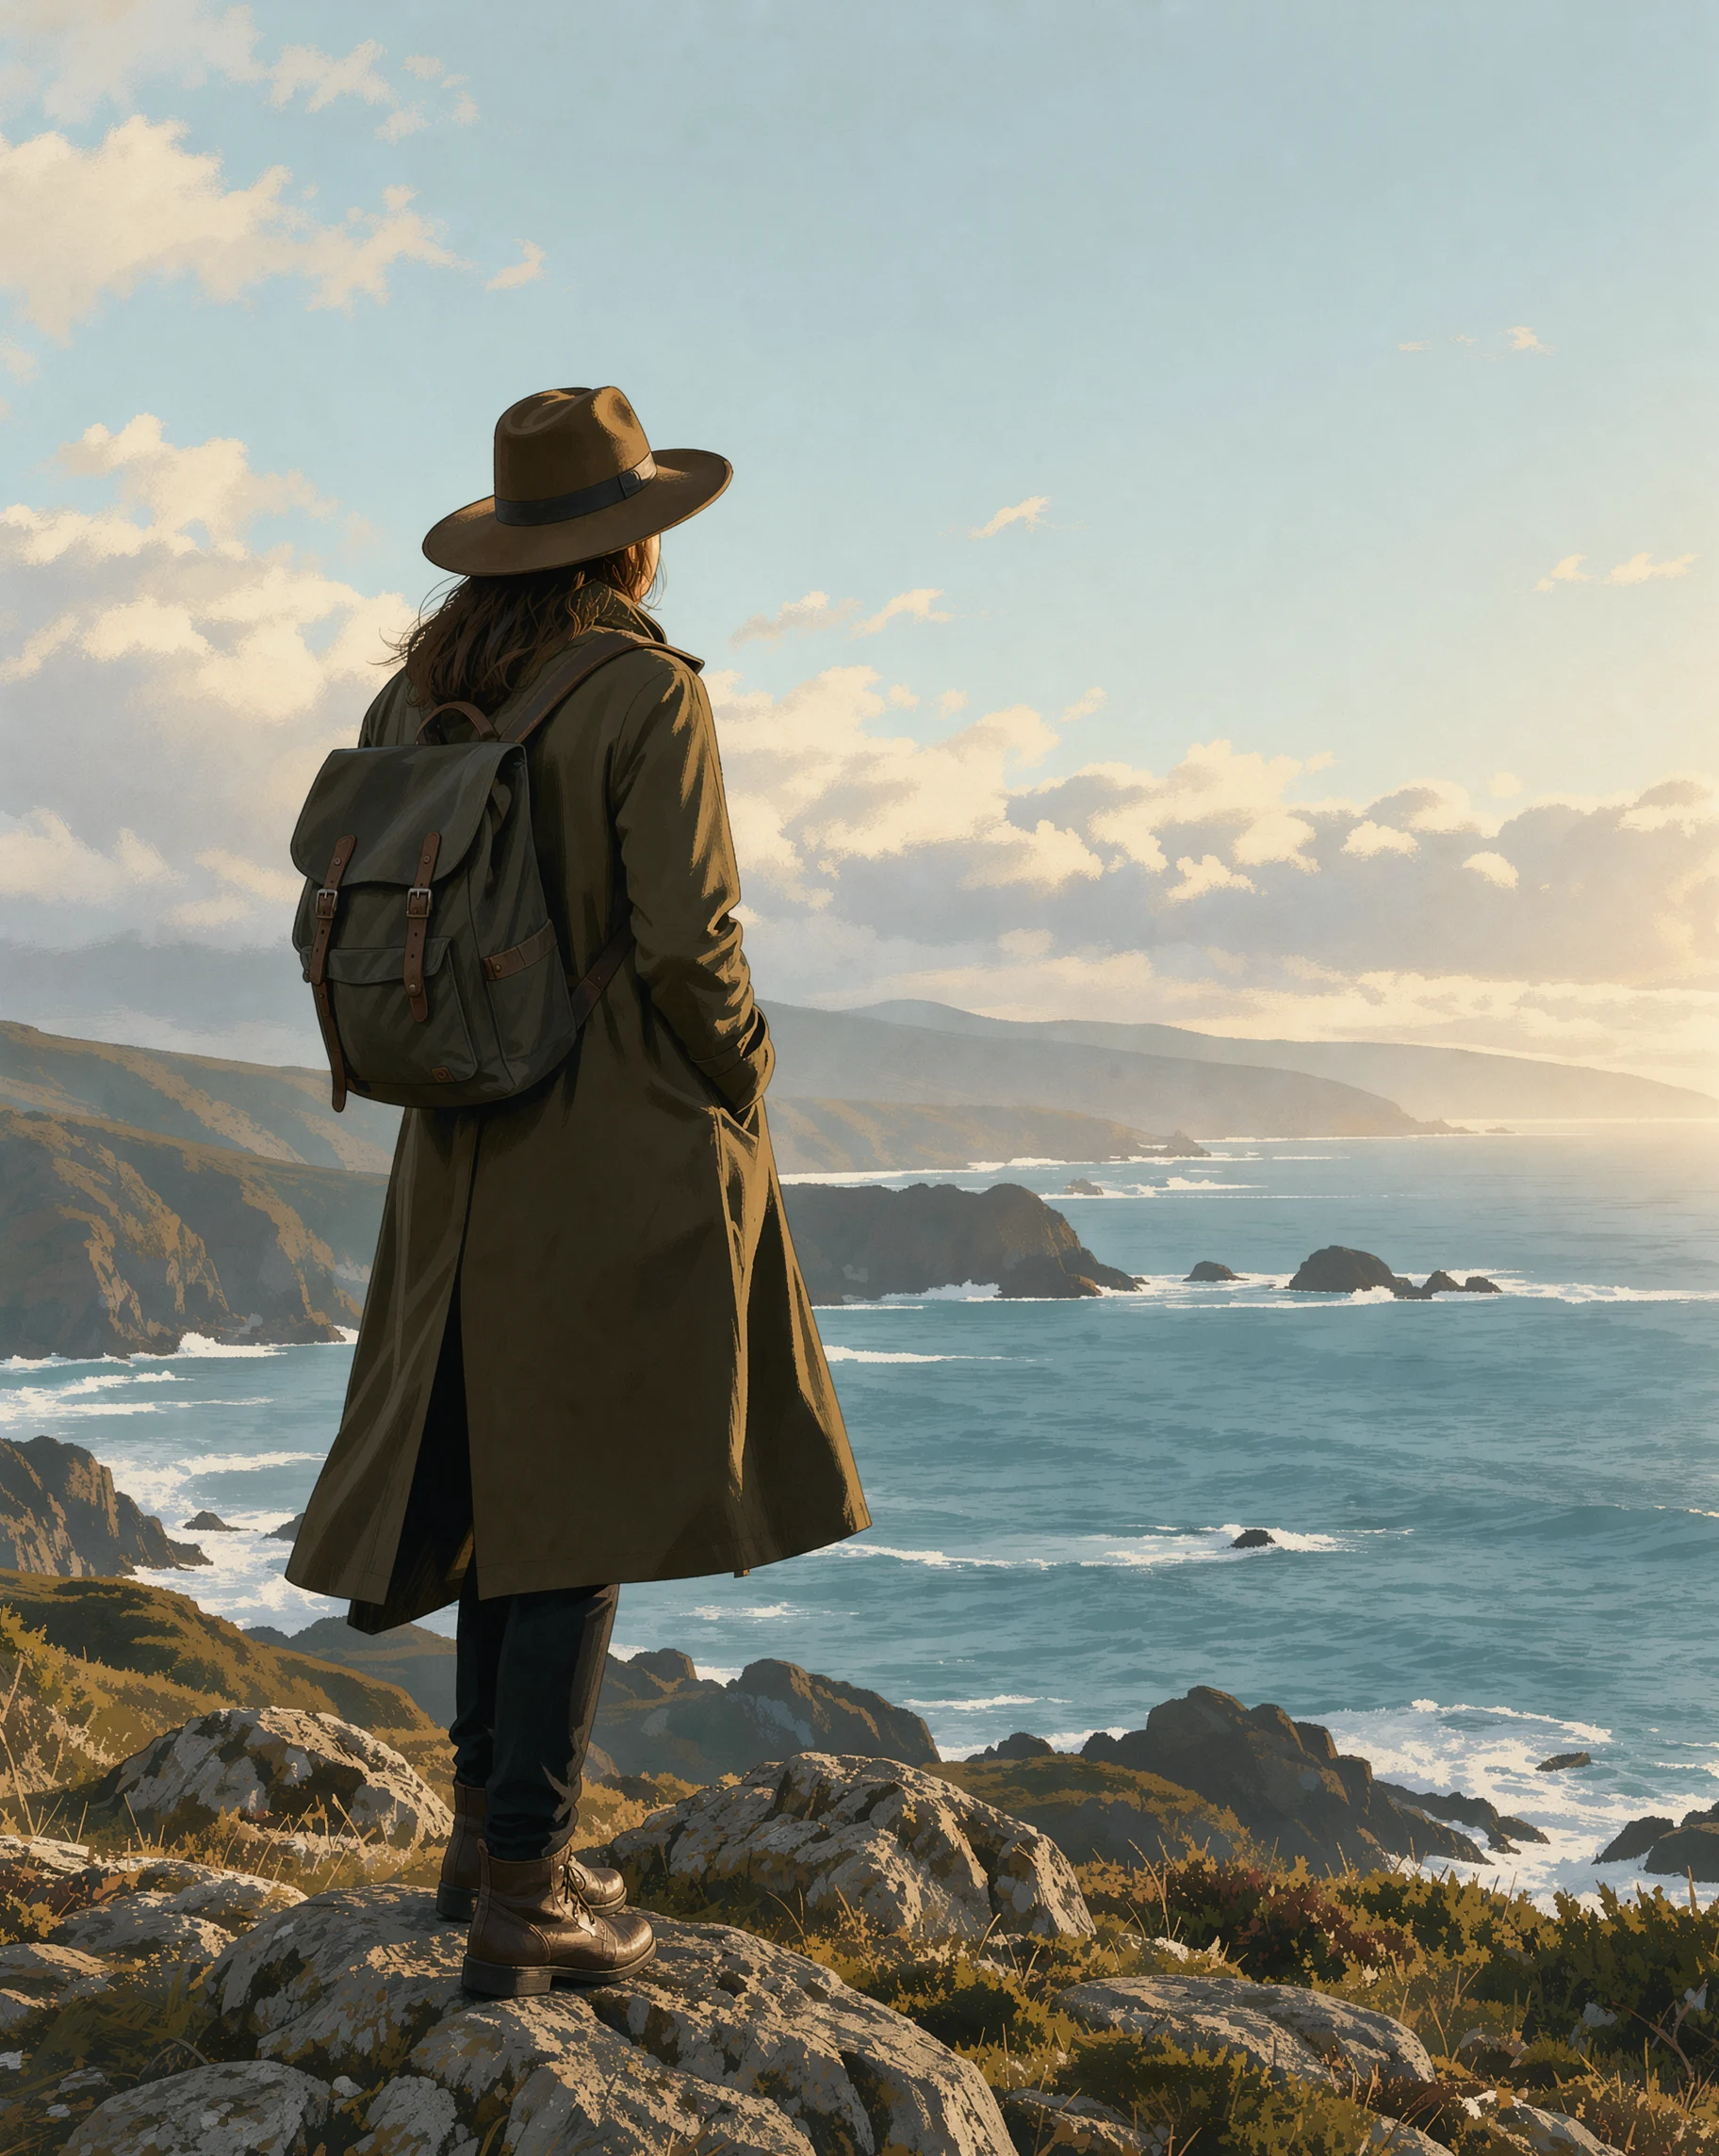
Stilspektrum: vom Realismus zur flachen Grafik am selben Motiv
Stil Stilspektrum · redaktionelle-illustration · Flächige Grafik
Referenz-Eingaben
image_urls
image_urls
Prompt
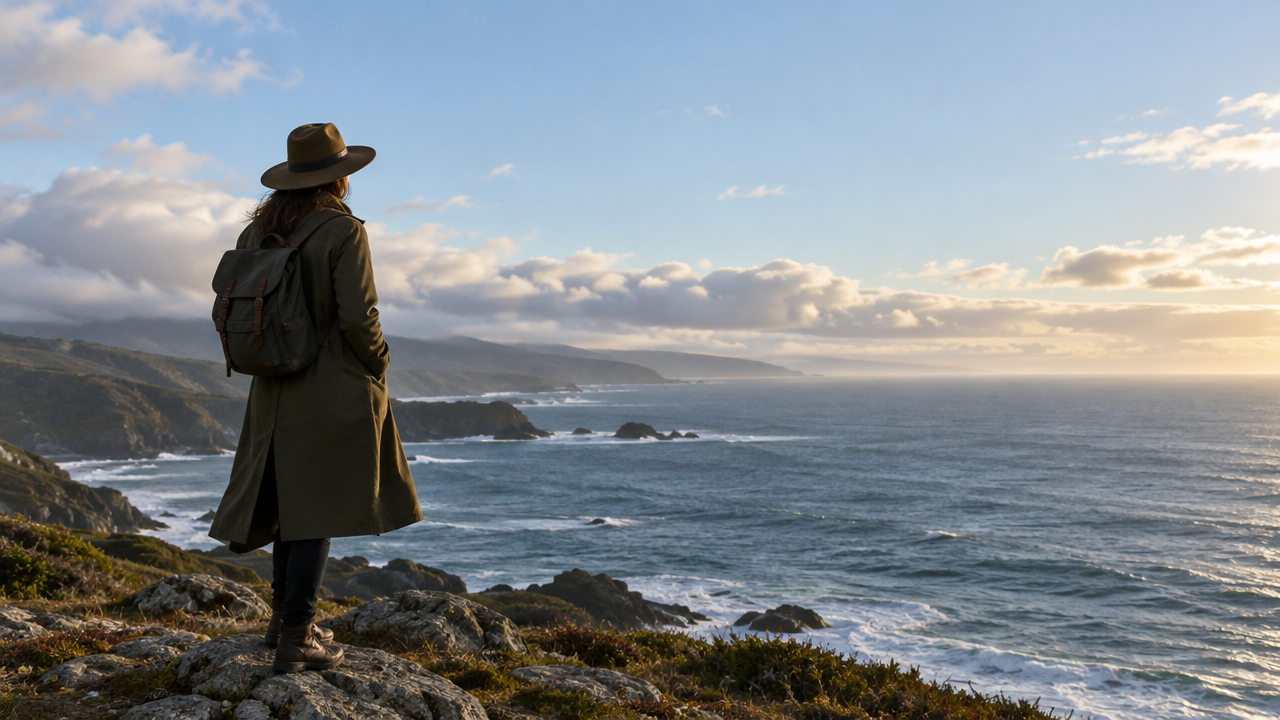
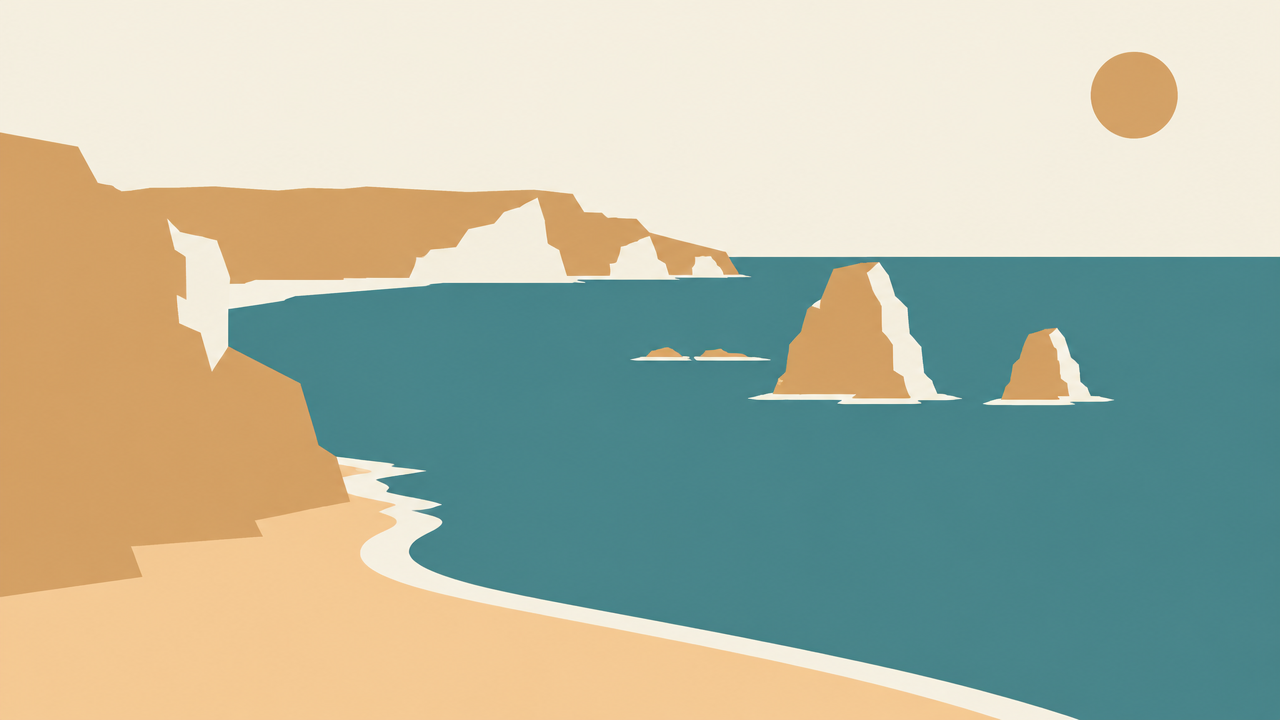
Redaktionelle Stilillustration: Eine einsame Reisende mit breitkrempigem Hut steht an einem Aussichtspunkt auf einer felsigen Küste, in Dreiviertel-Rückenansicht dargestellt, hinter ihr das Meer und tiefhängende Wolken. Referenzbild 1 definiert die Identität des Motivs und die Komposition; Referenzbild 2 definiert Farbflächen und Pinselstrichsprache. Stilziel: ein Spektrum zwischen malerischem Realismus und flacher grafischer Illustration – halbrealistische Renderings, mit sichtbarer Volumenwirkung, weichem Kantenlicht der tief stehenden Sonne, zurückhaltender, aber satter Farbpalette, zu klaren Formen vereinfachten Rändern, ohne schwere Textur und ohne Verläufe außer atmosphärischem Dunst. 4:3-Komposition, Motiv links der Mitte, rechts offener Himmel, großzügiger Freiraum. Farbpalette aus sanftem Türkisgrün, warmem Sandton und cremeweiß, eine ruhige, nachdenkliche Atmosphäre erzeugend, in der Qualität einer hochwertigen Magazin-Doppelseite.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
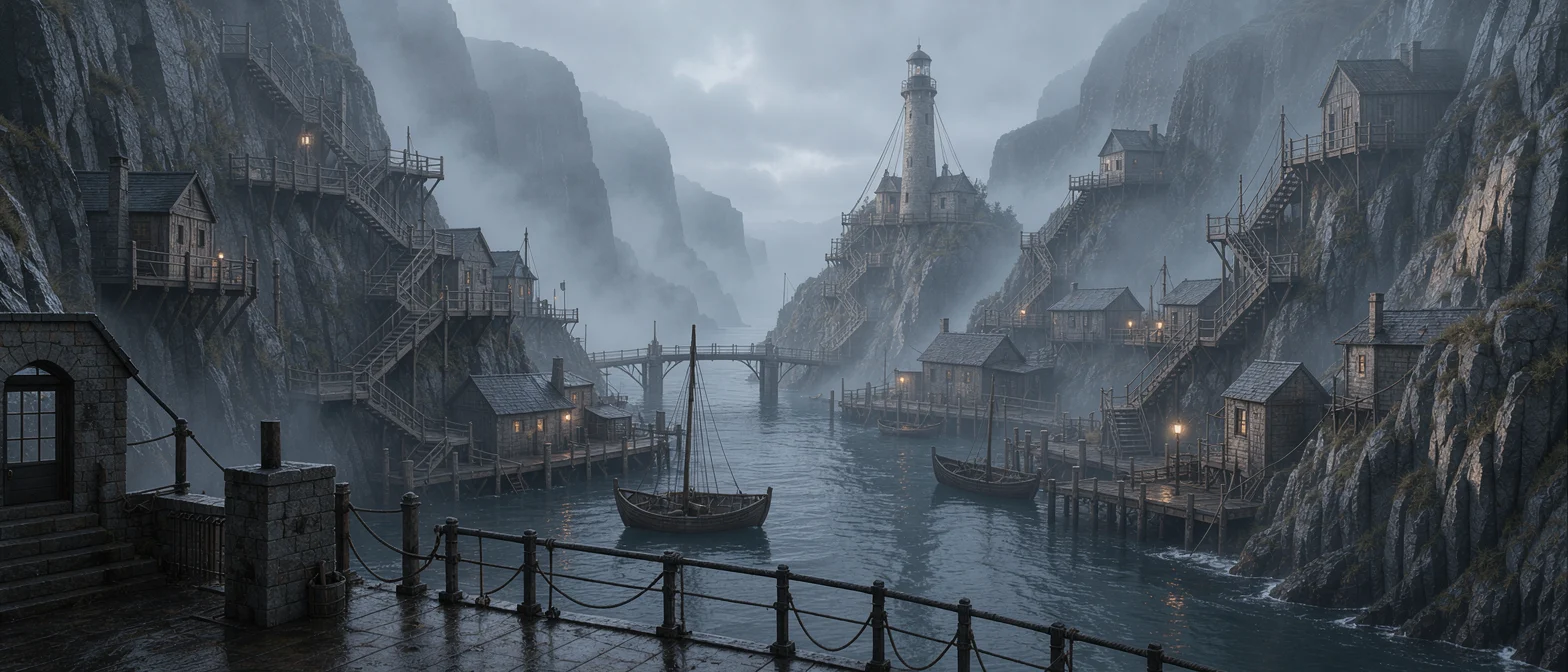
FLUX 3 Weltbild-Szenenkonzept: Morgenlicht im Nebelhafen
Stil Konzeptkunst · Weltbau · Atmosphäre
Referenz-Eingaben
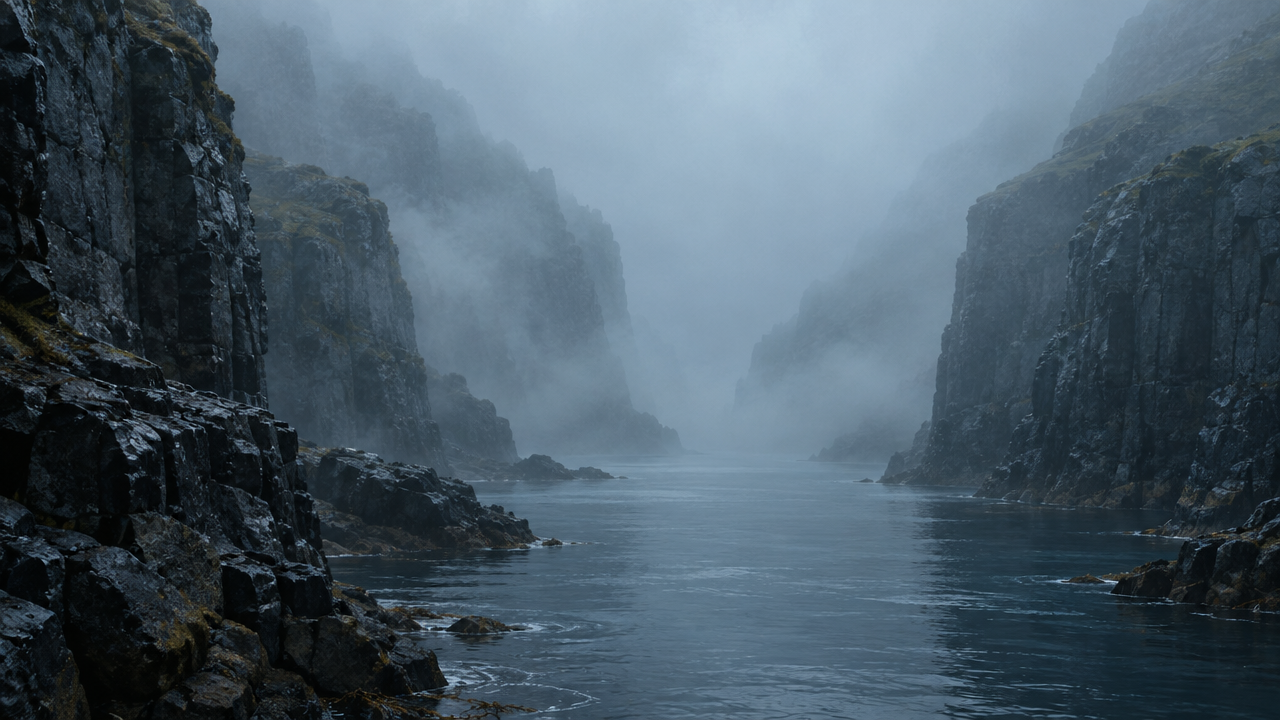
image_urls
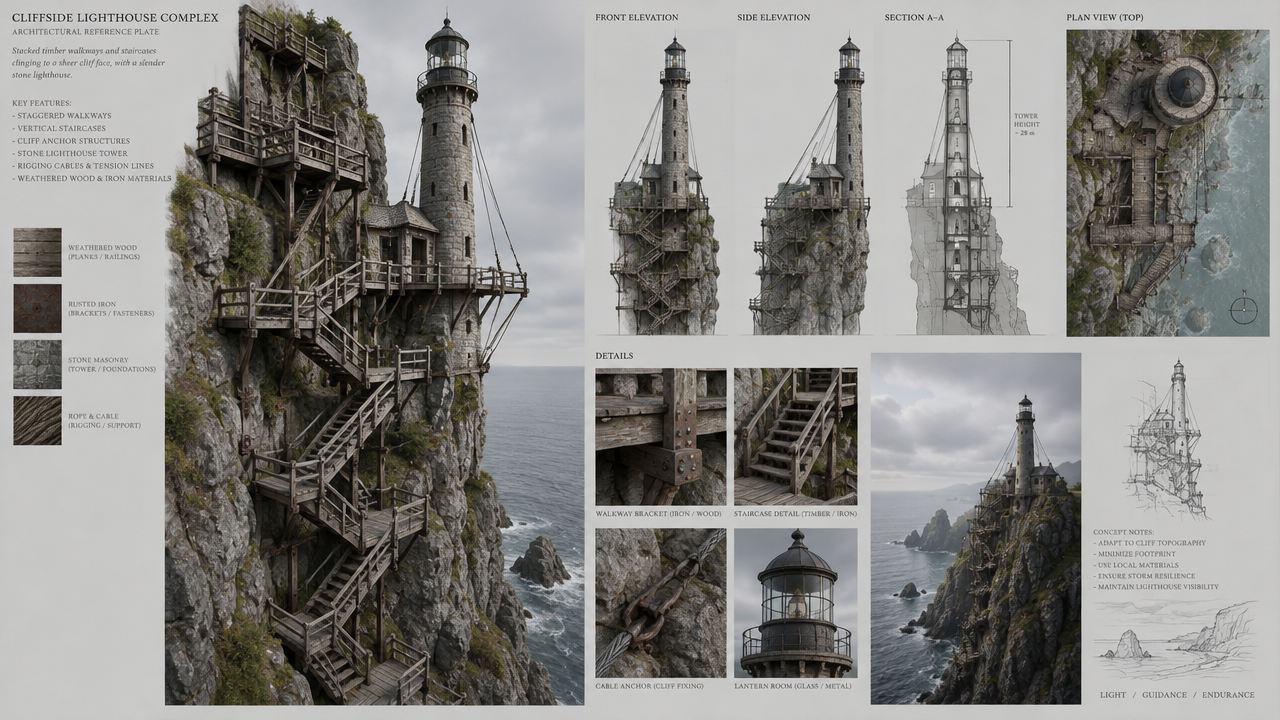
image_urls
Prompt
Filmische Weltbild-Konzeptkunst einer Hafen-Canyon-Stadt, die am frühen Morgen in dichtem Nebel liegt. Referenzbild 1 definiert Atmosphäre, Farbtöne und Volumennebel; Referenzbild 2 definiert die architektonische Sprache aus gestapelten Holzstegen, schlankem Leuchtturm und Takelwerk-Seilen. Beides wird zu einer zusammenhängenden Siedlung verschmolzen: Terrassen steigen in Schichten an feuchten Basaltklippen empor, enge Treppen, vertäute kleine Boote, warmes Laternenlicht dringt durch kaltblauen Nebel. Breite 16:9-Einstellungs-Komposition mit starker Tiefenstaffelung, im Vordergrund eine silhouettenhafte Balustrade, im Mittelgrund eine Brückenspannweite, in der Ferne der Leuchtturm als visueller Fokus. Malerisches digitales Matte Painting, zurückhaltende entsättigte Farbpalette mit selektiven warmen Akzenten, weiches Kantenlicht, feine Luftperspektive. Kein Text, kein Wasserzeichen.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
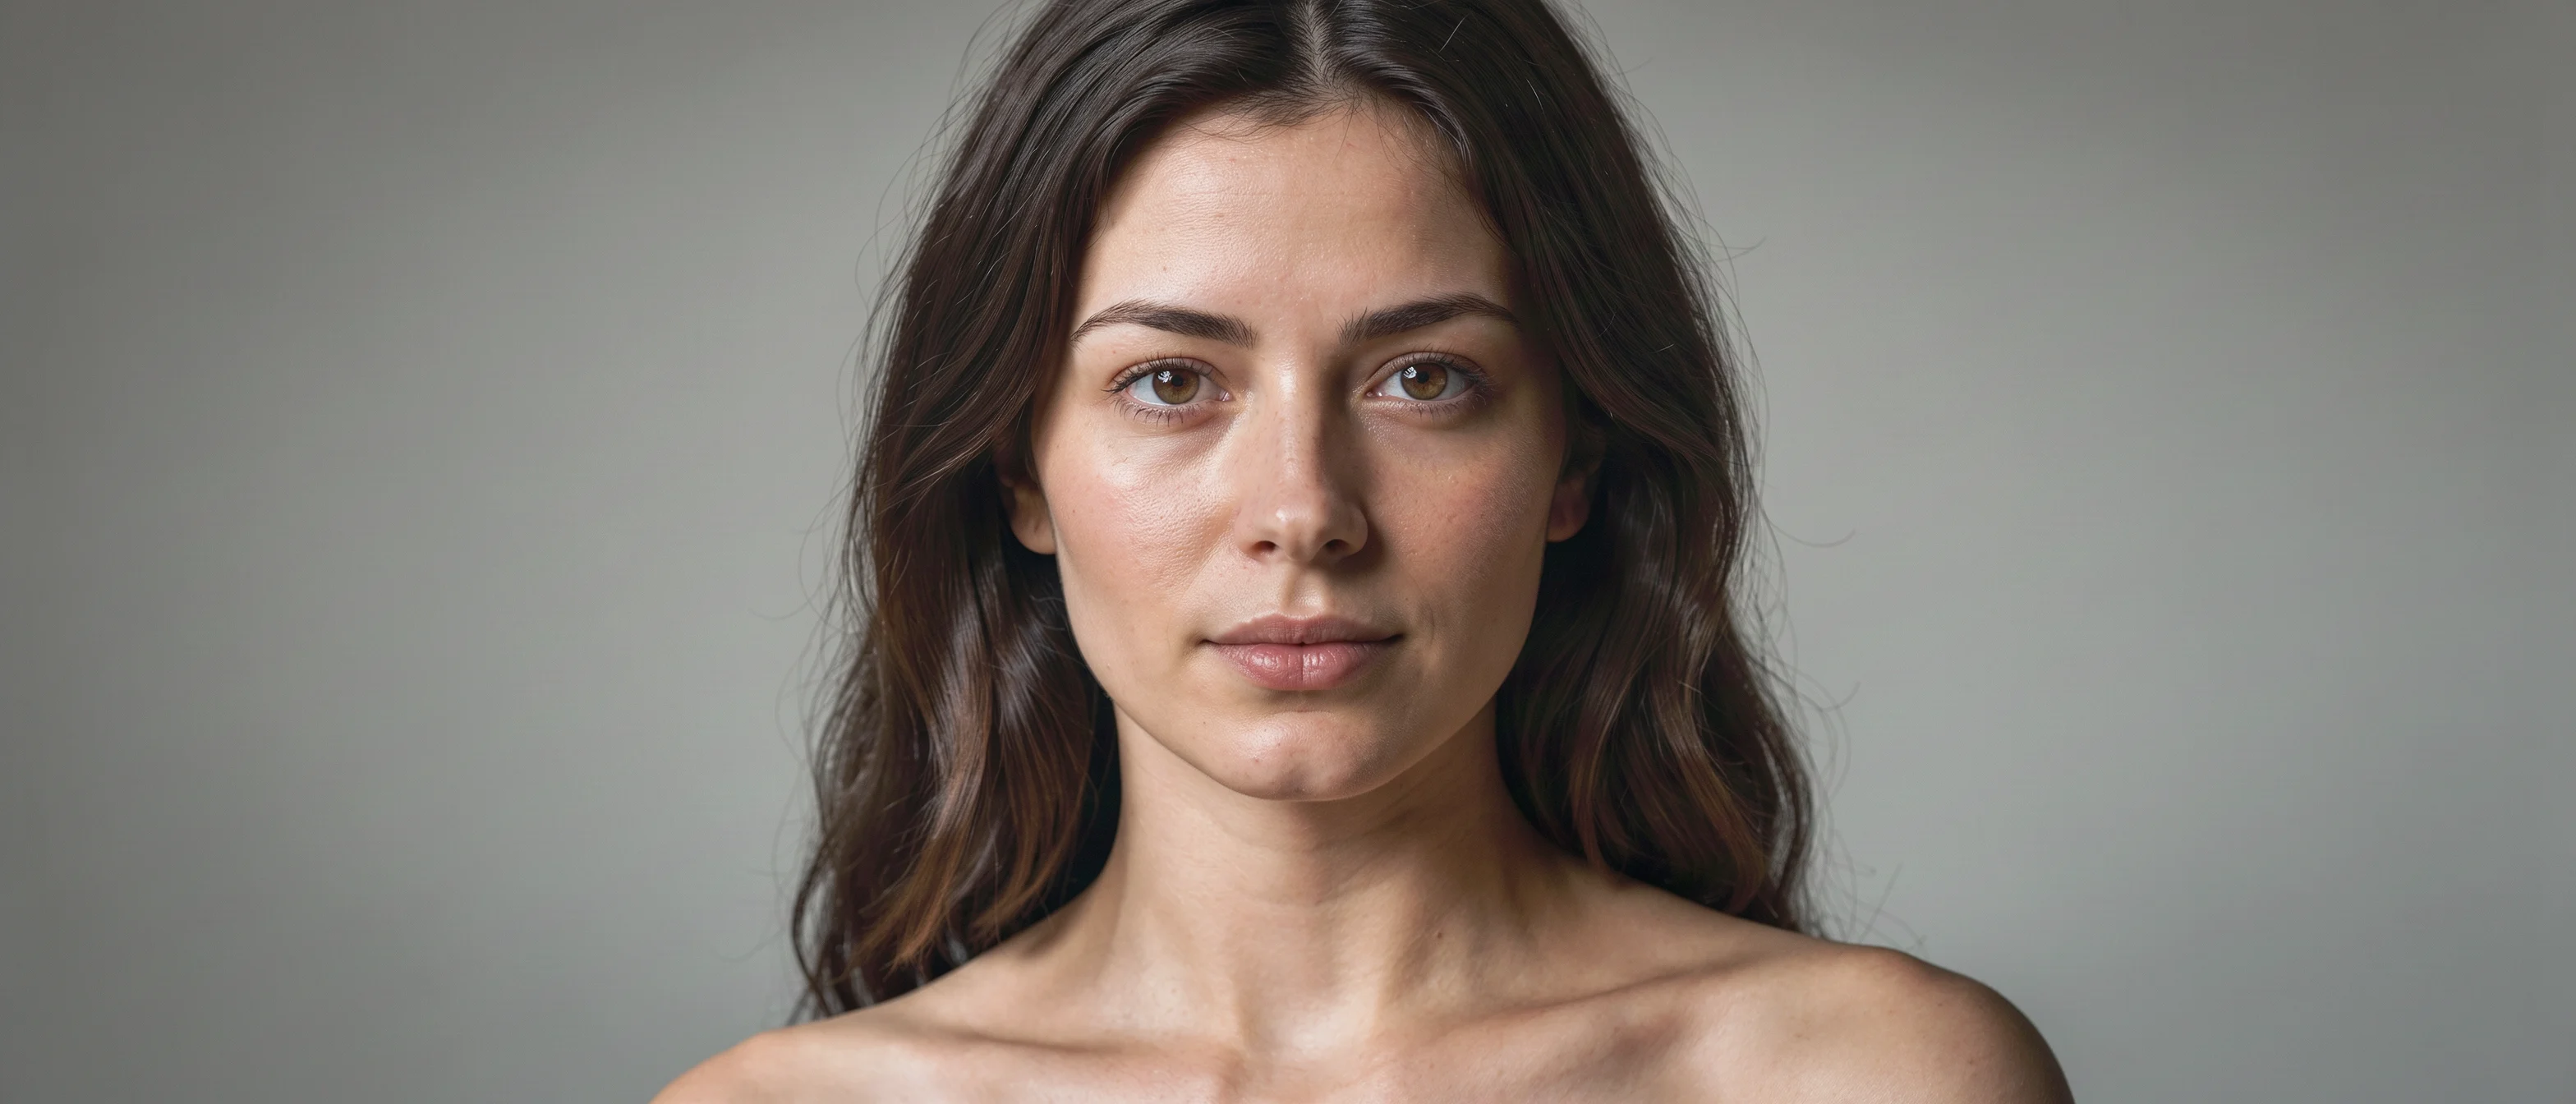
FLUX 3 Porträt-Demo: Referenz für realistische und künstlerische Stilvarianten
Stil Porträt und Fotografie · Fotorealistisch · Bearbeitung
Referenz-Eingaben
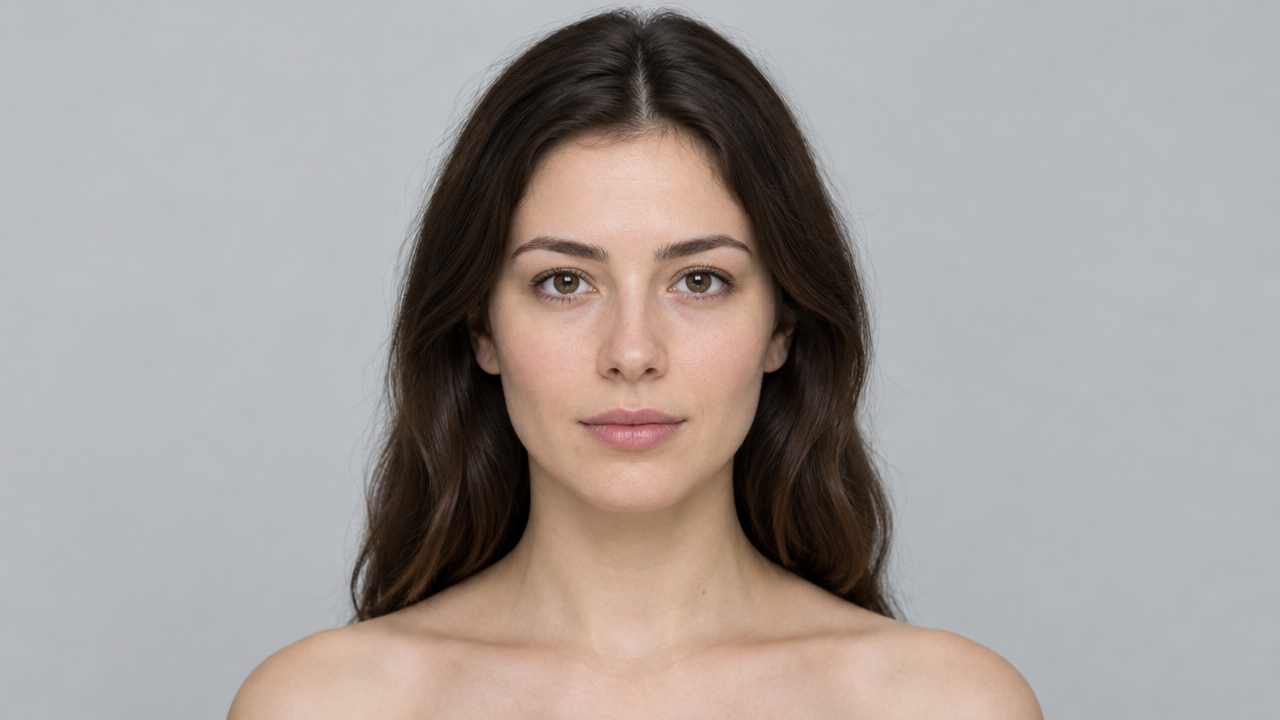
image_urls
Prompt
Editoriales Porträt einer jungen Frau, Kopf- und Schulterkomposition, vertikales 4:5-Format. Weiches, gerichtetes Fensterlicht von links vor der Kamera, das sanft in einen weichen warmgrauen Hintergrund übergeht. Natürliche Hauttextur, sichtbare Poren und feine Härchen, subtile Lichtreflexe in den Augen, geringe Schärfentiefe bei f/2.0. Ruhiger, neutraler Ausdruck, Blick leicht an der Kamera vorbei. Zurückhaltende Farbpalette, hoher Dynamikumfang, keine starke Retusche. Realistische fotografische Anmutung, Mittelformat-Detail.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
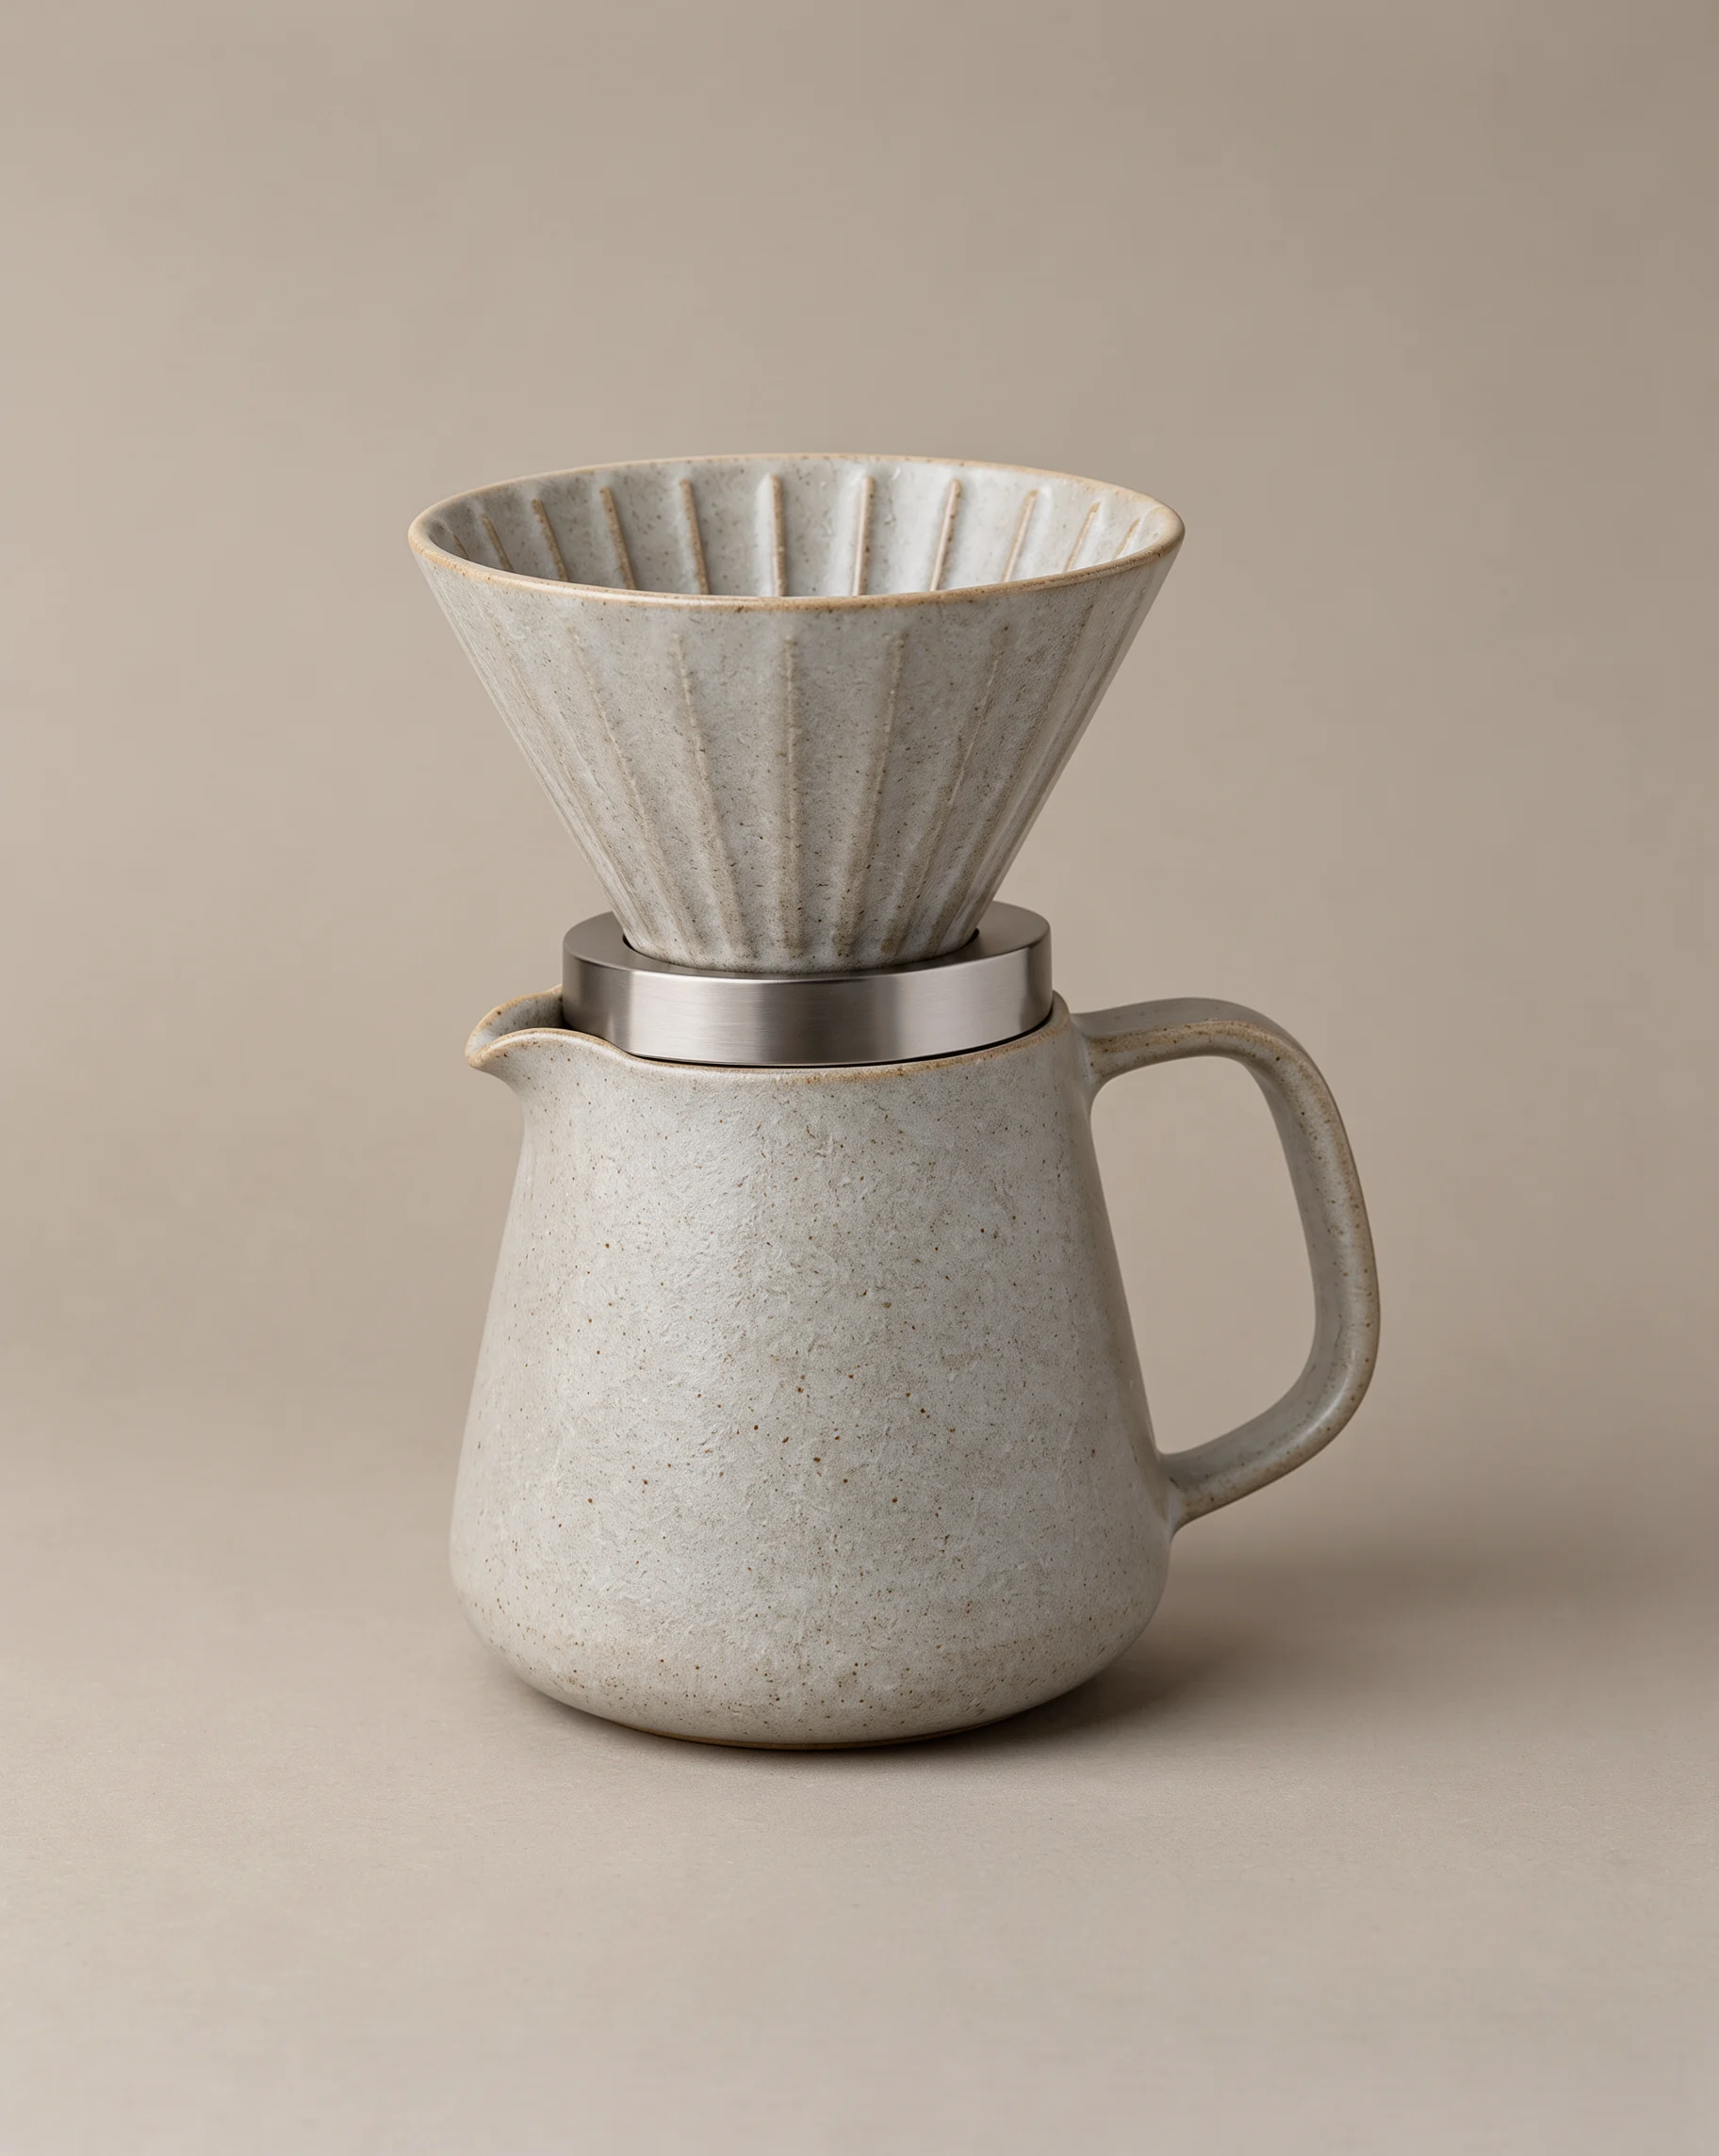
flux-3-image E-Commerce-Produktfotografie-Optik
Stil Produktbild · ecommerce · Studiobeleuchtung
Referenz-Eingaben
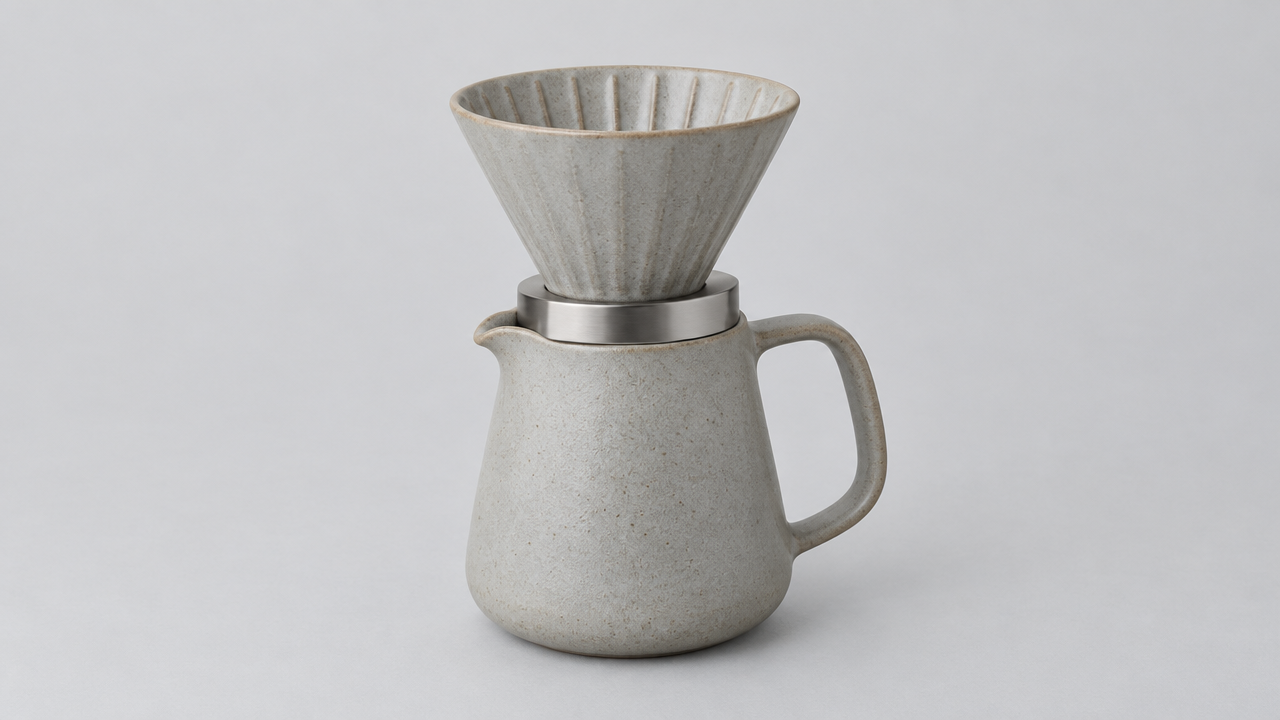
image_urls
Prompt
Studio-Produktfotografie: mattes Keramik-Handfilterkaffee-Set, Motiv zentriert und leicht von der Achse versetzt, auf einem nahtlosen Hintergrund in warmem Sandgrau. Oben links eine große weiche Softbox mit feinem Verlaufsabfall, am rechten Rand ein schmaler Konturlichtstreifen, der den Korpus vom Hintergrund trennt, unten ein weicher Bodenschatten, der den Stand stabilisiert. Aufgenommen mit einem 85-mm-Äquivalentobjektiv bei Blende f/8 für scharfe Bildqualität von der Mitte bis zum Rand, mit geringer Schärfentiefe, die den Hintergrund sanft verschwimmen lässt. An den Keramikrändern sind feine Glasurtexturen und Glanzreflexionen sichtbar, die Details der Metallringe klar. Neutrale Farbabstimmung, realistische Weißabgleich, keine störenden Requisiten, rechts großzügiger Negativraum für Text. Kommerzielle E-Commerce-Katalog-Ästhetik, sauber, hochauflösend, 3:2-Querformat.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
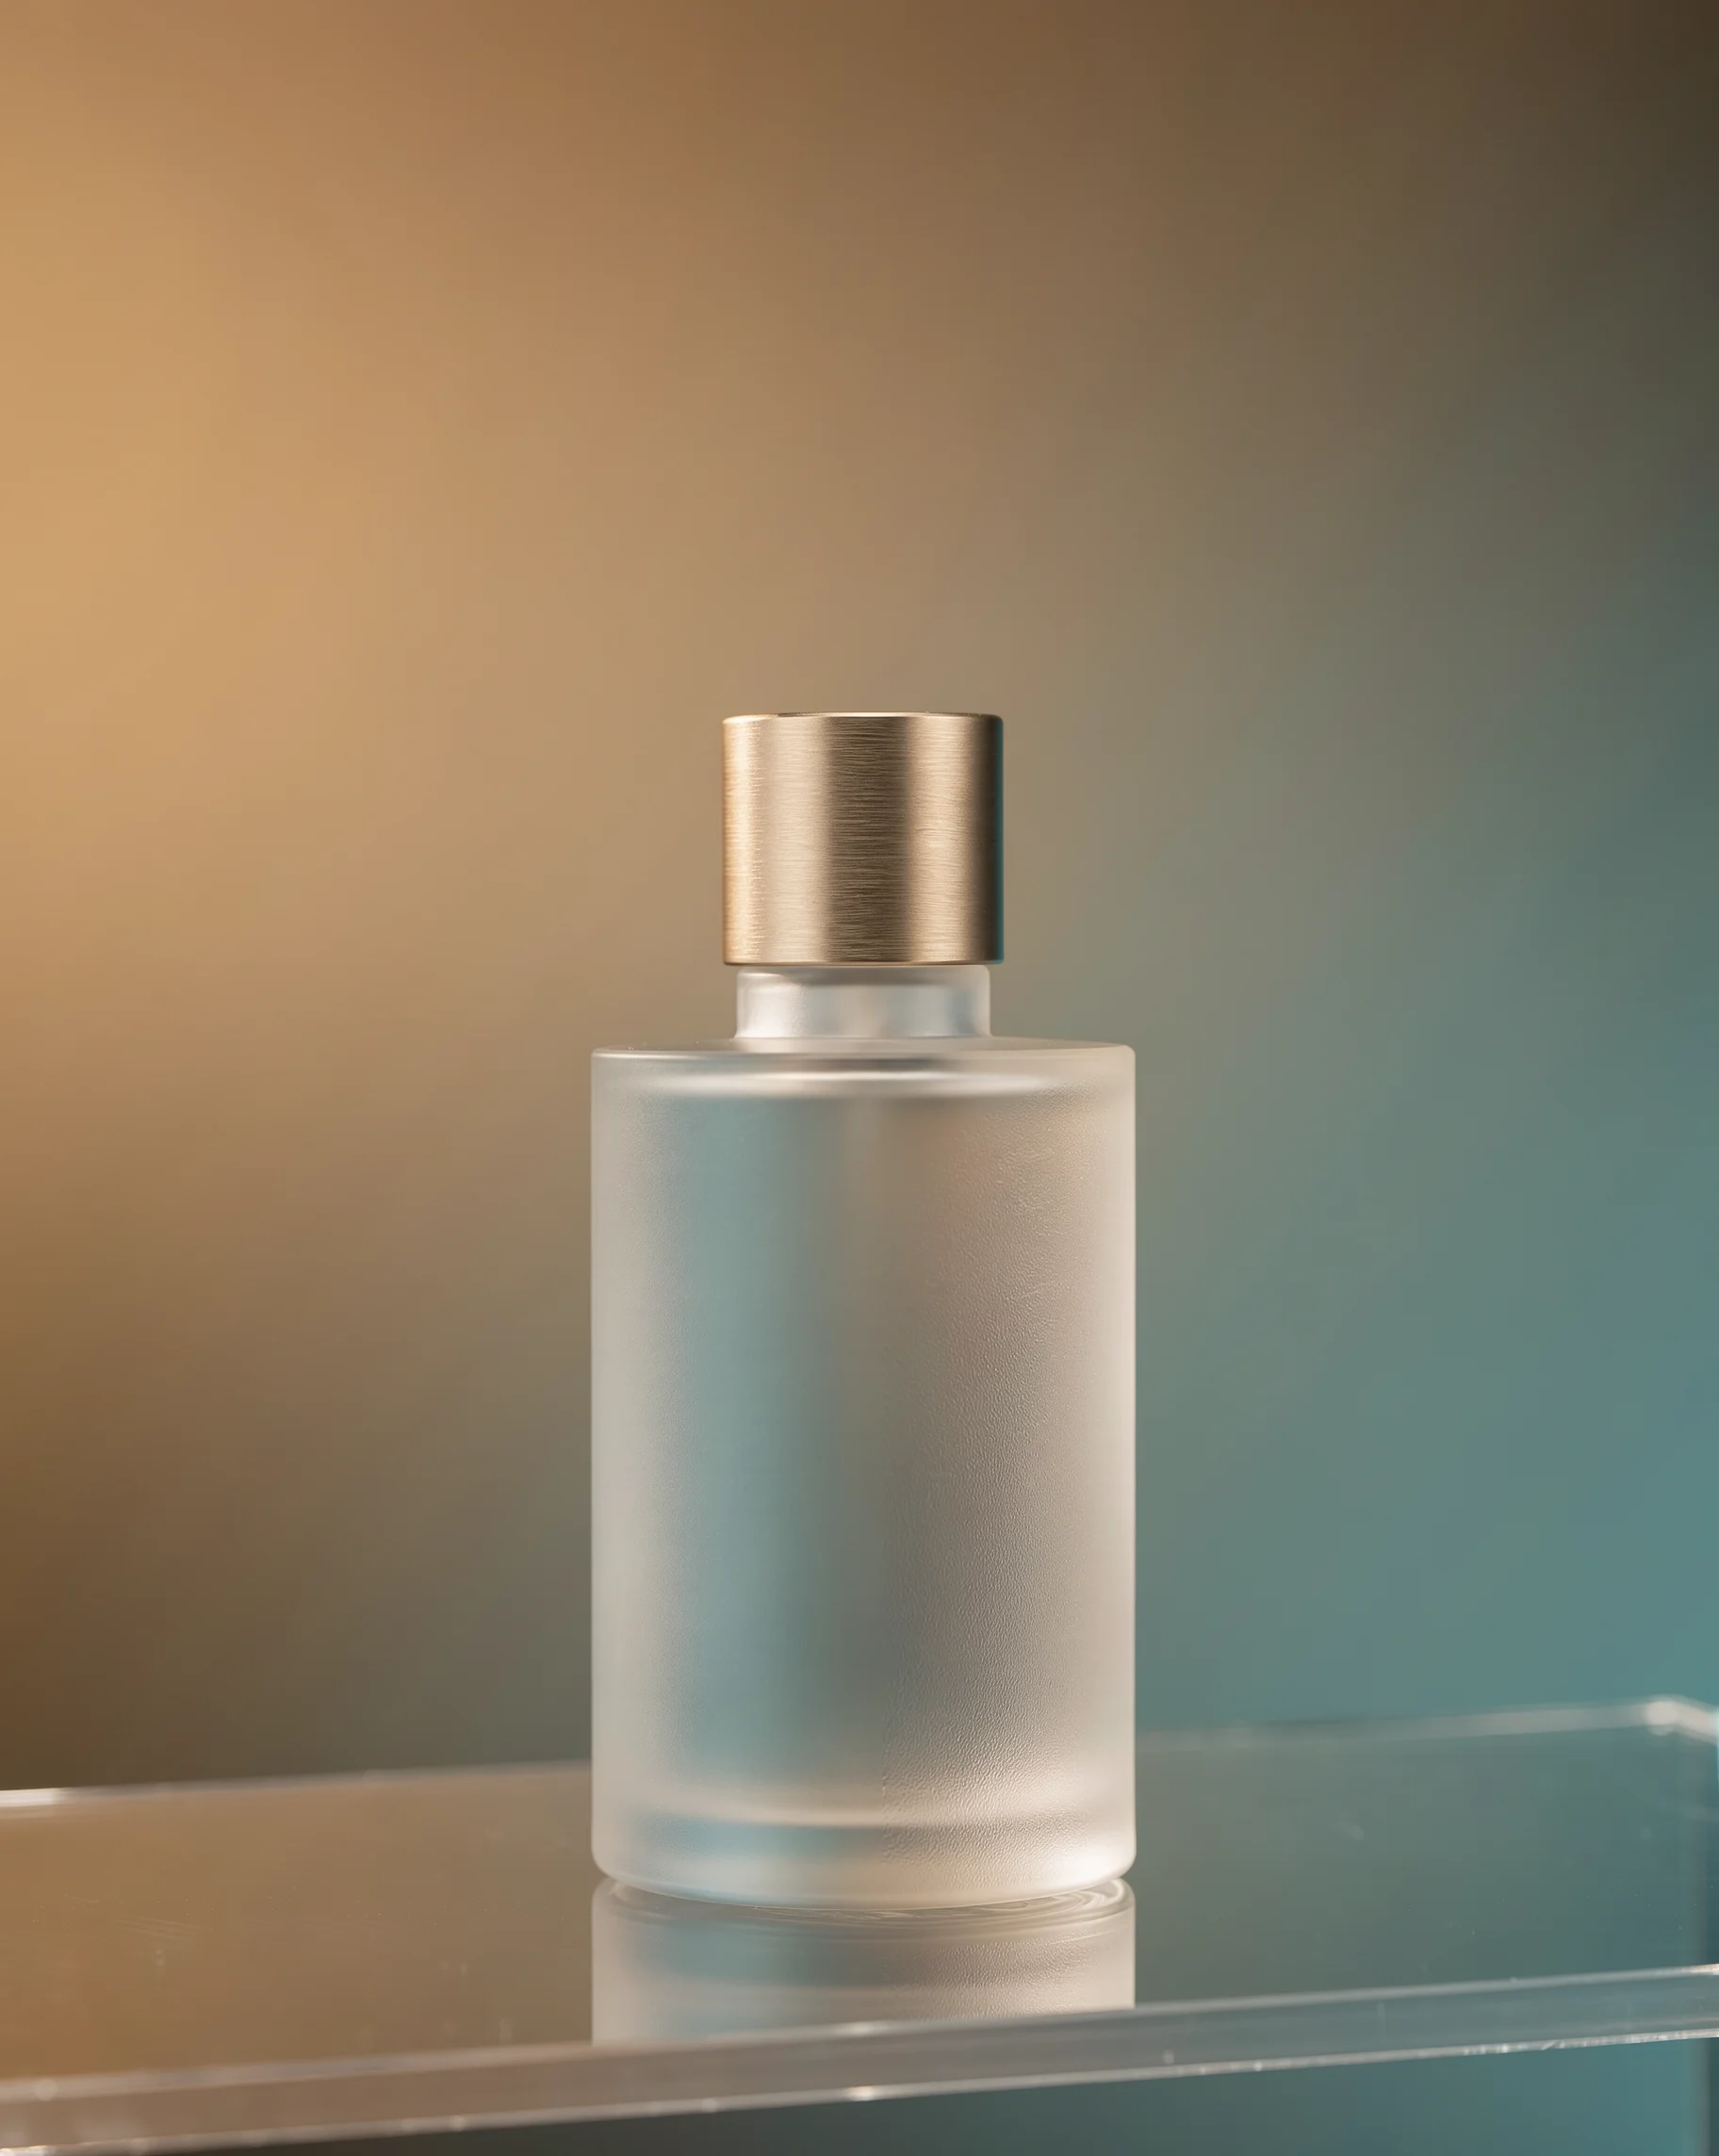
flux-3-image Produktstillleben auf E-Commerce-Niveau: Parfüm-Motiv mit warm-kaltem Kontrast
Stil Produktbild · ecommerce · Studiobeleuchtung
Referenz-Eingaben
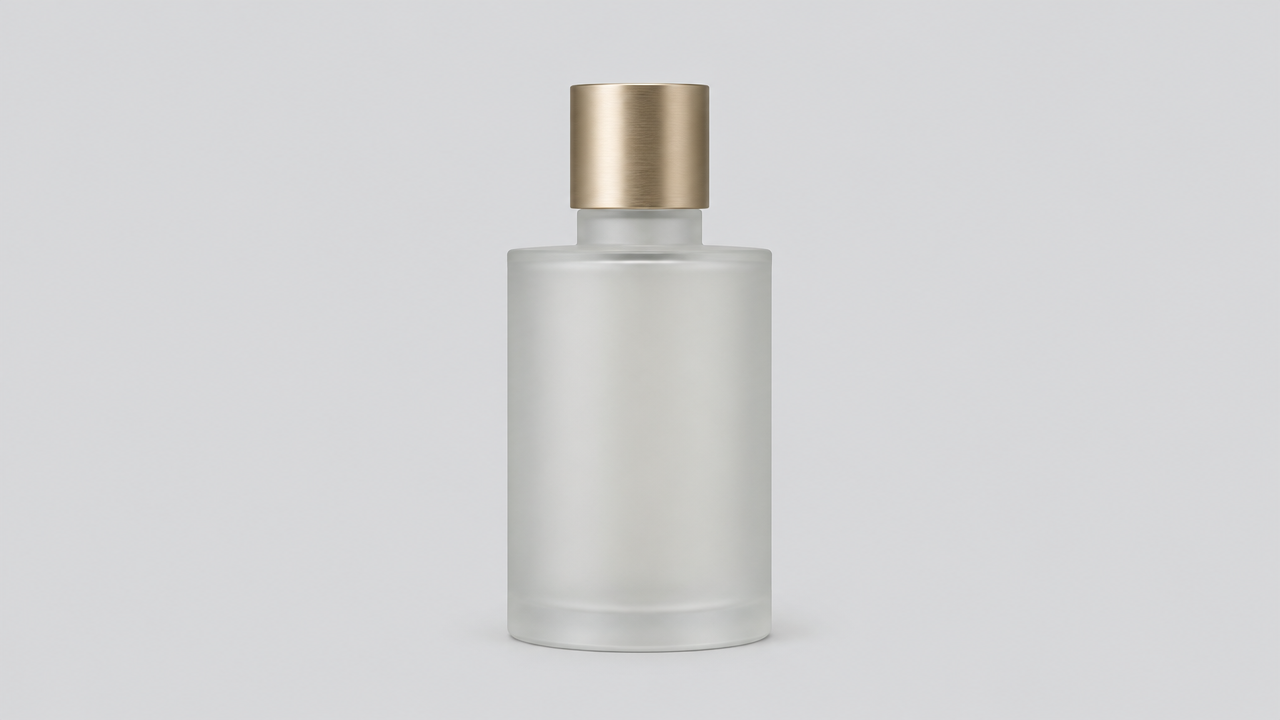
image_urls
Prompt
High-End-Produktfotografie für den E-Commerce, ein Parfümflakon aus mattiertem Glas mit einem Deckel aus gebürstetem Champagnergold, leicht außermittig auf einem transparenten Acrylpodest stehend, von rechts oben fällt hartes Hauptlicht ein und erzeugt an der Flakonflanke eine klar definierte, scharfe Glanzreflexion, links hellt eine große Softbox die Schattenseite auf, der Hintergrund geht von warmem Amberton zu einem kühlen Türkis auf der rechten Seite über, unter dem Flakon zeigt die glänzende Oberfläche eine feine Spiegelung, auf dem Glas liegt eine leichte Kondensationsschicht aus feinem Dunst, geringe Schärfentiefe, das Etikett scharf und klar, der Hintergrund weich unscharf, 4:5-Hochformat, oben ausreichend negativer Raum für Textplatzierung, klare kommerzielle Retusche-Ästhetik, kein Text, kein Logo, äußerst feine Glasbrechung und metallische Mikrostruktur
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
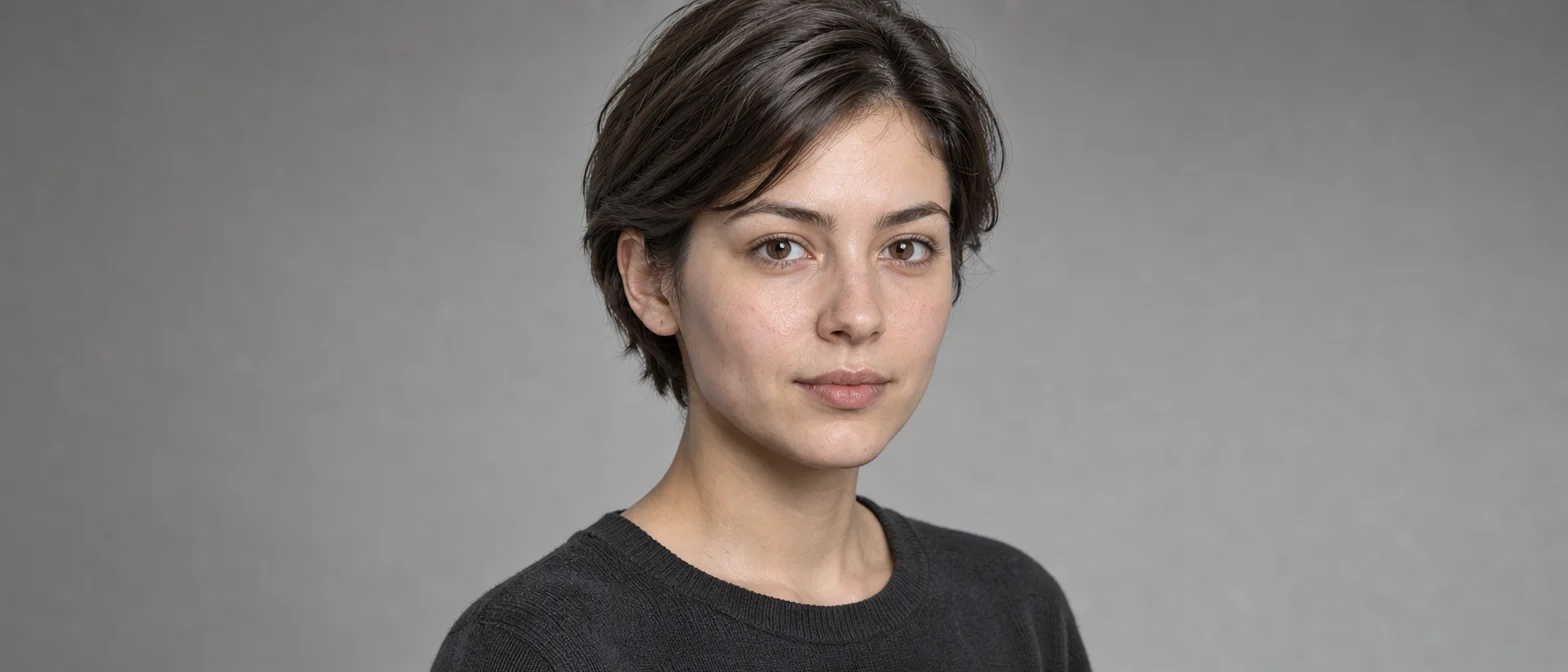
FLUX 3 Image Porträt-Doppelstil-Demo: Realismus und künstlerische Gestaltung
Stil Porträt und Fotografie · Fotorealistisch · Malstil
Referenz-Eingaben
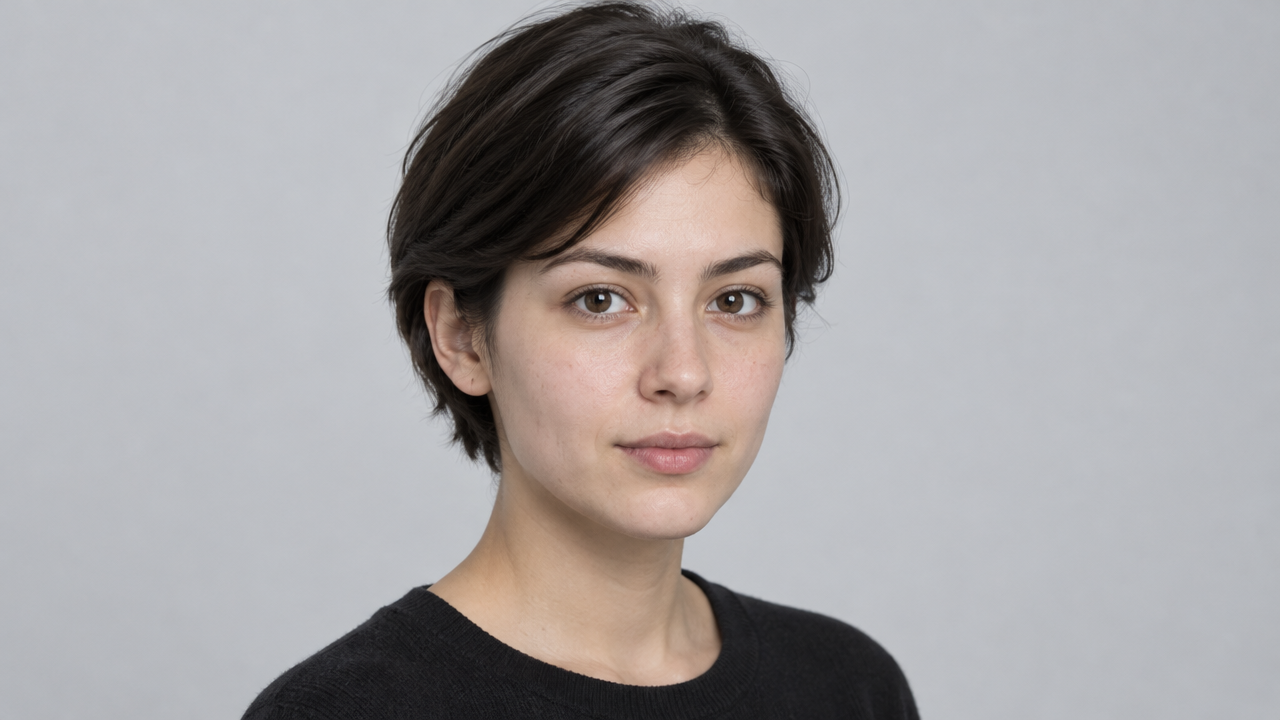
image_urls
Prompt
Fotorealistisches Studio-Porträt einer jungen Frau mit kurzem dunklem Haar, Dreiviertelprofil, weiches Fensterlicht von links einfallend, natürliche Hauttextur mit sichtbaren Poren und feinen Härchen, schwacher Glanzpunkt in den Augen, neutraler grauer nahtloser Hintergrund, geringe Schärfentiefe, 85-mm-Objektiv-Charakteristik, entsättigte Farbabstimmung, einfarbig dunkelgrauer Strickpullover mit detailreicher Stoffstruktur, ruhiger neutraler Gesichtsausdruck, Ästhetik der redaktionellen Magazinfotografie, vertikale 4:5-Komposition, Freiraum oben
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
flux-3-image per image
| Spezifikationen | Einzelpreis |
|---|---|
| 768S | $0.041 |
| 1K | $0.048 |
| 1.5K | $0.070 |
| 2K | $0.100 |
| 4K | $0.607 |
Positionierung
flux-3-image ist das Bildmodell aus der multimodalen FLUX-3-Familie von Black Forest Labs und wird über die einheitliche Schnittstelle von HiAPI.ai aufgerufen. Es akzeptiert sowohl reine Text-Prompts zur direkten Bilderzeugung als auch bis zu 10 Referenzbilder für die Generierung und partielle Bearbeitung; Ausgabeformat, Auflösungsstufe und Toleranz gegenüber Inhaltssicherheit sind einstellbar. Geeignet für Entwickler, die eine Pipeline zur Generierung visueller Inhalte aufbauen, sowie für Teams, die eine neue Modellgeneration in bestehende FLUX-Bild-Workflows integrieren möchten.
Zentrale Highlights
- Gemeinsame Steuerung über Referenzbilder und Prompts – bis zu 10 Referenzbilder können übergeben und im Prompt jeweils ihre Rolle als Motiv, Stil oder Komposition zugewiesen werden.
- Optionale Web-Recherche zur Ergänzung visueller Informationen – Grounding ist standardmäßig aktiviert; vor der Generierung werden Webseiten und Bilder durchsucht, um das Prompt um Entitäts- und Szenendetails zu ergänzen.
- Fein wählbare Auflösung und Bildformate – die Ausgabe umfasst fünf Pixelstufen von 768 bis 4K sowie 16 Seitenverhältnisse; im Auto-Modus wird das Bildformat anhand von Prompt und Referenzbildern automatisch festgelegt.
Funktionsbeschreibung
Text-zu-Bild und referenzbildgestützte Generierung: Mit einer einzigen Anfrage lässt sich aus einem Prompt ein Bild erzeugen; werden Referenzbilder bereitgestellt, genügt es, im Prompt die zu ändernden und beizubehaltenden Inhalte zu benennen, um gezielte Anpassungen ohne schrittweisen Ablauf vorzunehmen.
Kombination mehrerer Referenzbilder: Pro Anfrage sind bis zu 10 Referenzbilder verfügbar, die jeweils die Rolle von Motiv, Stil oder Komposition übernehmen – ideal, um mehrere visuelle Materialien in einem Bild zusammenzuführen.
Steuerung von Bildformat und Auflösung: aspect_ratio bietet 16 Seitenverhältnisse von 21:9 (Querformat) bis 9:21 (Hochformat) sowie eine automatische Auswahl; resolution reicht von 768 bis 4K, was die Batch-Erzeugung entsprechend Ausspielkanal und Schärfeanforderungen erleichtert.
Einstellbare Toleranz gegenüber Inhaltssicherheit: safety_tolerance ist von 0 bis 4 einstellbar, Standard ist 2; Teams können die Filterstärke gemäß ihren eigenen Compliance-Anforderungen verschärfen oder lockern.
Anwendungsszenarien
- Stilisierte Bilderzeugung für Kreativteams – Designvorgaben und Stilreferenzbilder eingeben und visuelle Entwürfe erzeugen, die der vorgegebenen Komposition und dem Bildformat entsprechen, für Werbematerial und Konzeptpräsentationen.
- Modell-Upgrade bestehender FLUX-Pipelines – bestehende Aufrufe zur Bilderzeugung durch Text-Prompts ersetzen; die Ausgabe behält die bisherige Schnittstellenform bei, sodass das Modell ohne Änderung der übergeordneten Abläufe aktualisiert werden kann.
- Erzeugung von Szenenbildern mit Faktenbezug – nach Aktivierung von Grounding das Motiv mit einem kurzen Prompt beschreiben und Bilder erzeugen, die durch Rechercheinformationen ergänzt sind, für Inhaltsbebilderung und Szenendarstellungen.
- Zusammenführung mehrerer Materialien und Bildüberarbeitung – mehrere Referenzbilder hochladen und deren jeweilige Rolle kennzeichnen, um einheitlich stilisierte Kompositionen oder Überarbeitungen zu erhalten, für E-Commerce-Bilder und die Wiederverwendung von Materialien.
Einschränkungen und Auswahlhinweise
Öffentlich verfügbare Informationen konzentrieren sich überwiegend auf die gesamte FLUX-3-Familie und die Videosparte; die konkreten Spezifikationen dieser Bildversion sind nur begrenzt offengelegt. Beschreibungen von gemeinsamem Training und Videofähigkeiten auf Familienebene lassen sich nicht unmittelbar mit dem vollständigen Funktionsumfang dieses Modells gleichsetzen. Grounding durchsucht zunächst und generiert anschließend, was die Dauer einer einzelnen Anfrage erhöhen kann. Für Generierungsgeschwindigkeit, Stabilität und das Verhalten bei extrem schwierigen Prompts empfiehlt es sich, zunächst mit eigenen Beispielen zu validieren, bevor das Modell in die Produktion übernommen wird. Falls Video- oder Audiogenerierung benötigt wird, sollte ein Modell der entsprechenden Sparte derselben Familie gewählt werden.
Häufige Fragen
Alle Fragen ansehen →-
Kann man mit einem einzigen Einstieg sowohl generieren als auch bearbeiten?
Ja. Ohne Referenzbild wird aus Text generiert; mit 1–10 Referenzbildern wird rund um vorhandenes Material bearbeitet. Bereite einfach je nach Ziel Text oder Bilder vor.
-
Wie sollte man die fünf Auflösungsstufen auswählen?
Verwenden Sie zunächst 768 oder 1K, um die Richtung zu besprechen; wenn mehr Details benötigt werden, ziehen Sie 1.5K oder 2K in Betracht, und wenn größere Bilder und Spielraum zum Zuschneiden benötigt werden, ziehen Sie 4K in Betracht. Die Stufen sind keine festen Seitenlängen; bitte überprüfen Sie die Breite und Höhe der zurückgegebenen Bilder.
-
Wie werden die Referenzbilder aufgeteilt?
Erkläre der Reihe nach, welches Bild das Motiv, welches die Umgebung und welches nur die Farbgebung oder den Stil liefert, und benenne zugleich die Elemente, die nicht übernommen werden sollen.
-
Wie viele Bilder werden pro Vorgang generiert?
Jede Aufgabe liefert ein Bild. Wenn eine andere Ausrichtung benötigt wird, passen Sie die Beschreibung an und reichen Sie eine separate Aufgabe ein.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: flux-3-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für flux-3-image und Route default — siehe Parametertabelle unten.
promptstringPflichtminLength 1maxLength 5000Beschreibe den gewünschten Bildinhalt; wenn Referenzbilder bereitgestellt werden, kannst du hier auch angeben, welche Teile des Bildes geändert und welche beibehalten werden sollen.
groundingbooleanOptionalStandard: trueBoolescher Wert, der steuert, ob vor der Generierung eine Websuche nach Webseiten und Bildern durchgeführt wird, um die visuellen Informationen im Prompt zu ergänzen; Standardwert ist true.
image_urlsarrayOptionalminItems 1maxItems 10Array von Referenzbild-URLs, die als visuelle Referenz für die Generierung dienen; das Motiv, der Stil oder die kompositorische Rolle jedes Bildes muss im Prompt angegeben werden.
Array [ string ]
resolutionstringOptionalStandard: "1K"Auflösungsstufe der Ausgabe; die genauen Breiten- und Höhenwerte variieren je nach Seitenverhältnis; Standardwert ist 1K.
7681K1.5K2K4Kaspect_ratiostringOptionalStandard: "auto"Seitenverhältnis der Ausgabe, wahlweise Querformat, Hochformat oder Quadrat; auto bedeutet, dass das Format automatisch anhand von Prompt und Referenzbildern bestimmt wird; Standardwert ist auto.
21:92:116:93:27:54:35:41:1Alle anzeigen (8)
4:53:45:72:39:161:29:21autosafety_toleranceintegerOptionalStandard: 2min 0max 4Ganzzahl für die Toleranz gegenüber Inhaltssicherheit; der Wert 0 ist am strengsten; Standardwert ist 2.
callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "flux-3-image",
  "input": {
    "prompt": "…",
    "grounding": true,
    "resolution": "1K",
    "aspect_ratio": "auto",
    "safety_tolerance": 2
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "flux-3-image",
input: {
"prompt": "…",
"grounding": true,
"resolution": "1K",
"aspect_ratio": "auto",
"safety_tolerance": 2
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "flux-3-image",
"input": {
"prompt": "…",
"grounding": True,
"resolution": "1K",
"aspect_ratio": "auto",
"safety_tolerance": 2
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Grok Imagine Quality xAI $0.070 /Bild
-
 FIBO 1.5 Bria $0.058 /Bild
-
 Krea 3 Krea $0.036 /Bild
-
 Wan 2.7 Image Alibaba $0.035 /Bild
-
 BRIA Eraser Bria $0.058 /Bild
-
 Qwen Image 2.0 Alibaba $0.042 /Bild
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /Bild
-
 FLUX.1 Schnell Black Forest Labs $0.005 /Bild
-
 Nano Banana Google $0.021 /Bild
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /Bild
-
 Seedream 5.0 ByteDance $0.025 /Bild
-
 Ideogram V4.5 Ideogram $0.011 /Bild
Gleicher Anbieter
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /Bild
-
 FLUX.2 Black Forest Labs $0.035 /Bild
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /Bild
-
 FLUX 3 Max Black Forest Labs $0.061 /Sekunde
- FLUX.1 Schnell Black Forest Labs $0.005 /Bild
- FLUX.2 Klein 9B Black Forest Labs $0.0086 /Bild
- FLUX.1 Kontext Max Black Forest Labs $0.071 /Bild
-
 FLUX 3 Video Black Forest Labs $0.090 /Sekunde
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /Bild