
Kuaishou
Kling 3.0
kling-3.0-omni/image-to-video
Einheitliche multimodale Videogenerierungs-Serie mit Unterstützung für Text-zu-Video, Bild-zu-Video, Referenz-zu-Video und Bearbeitung innerhalb von Videos, native Lippensynchronisation und mehrsprachiges Audio
kling-3.0-omni/image-to-video ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
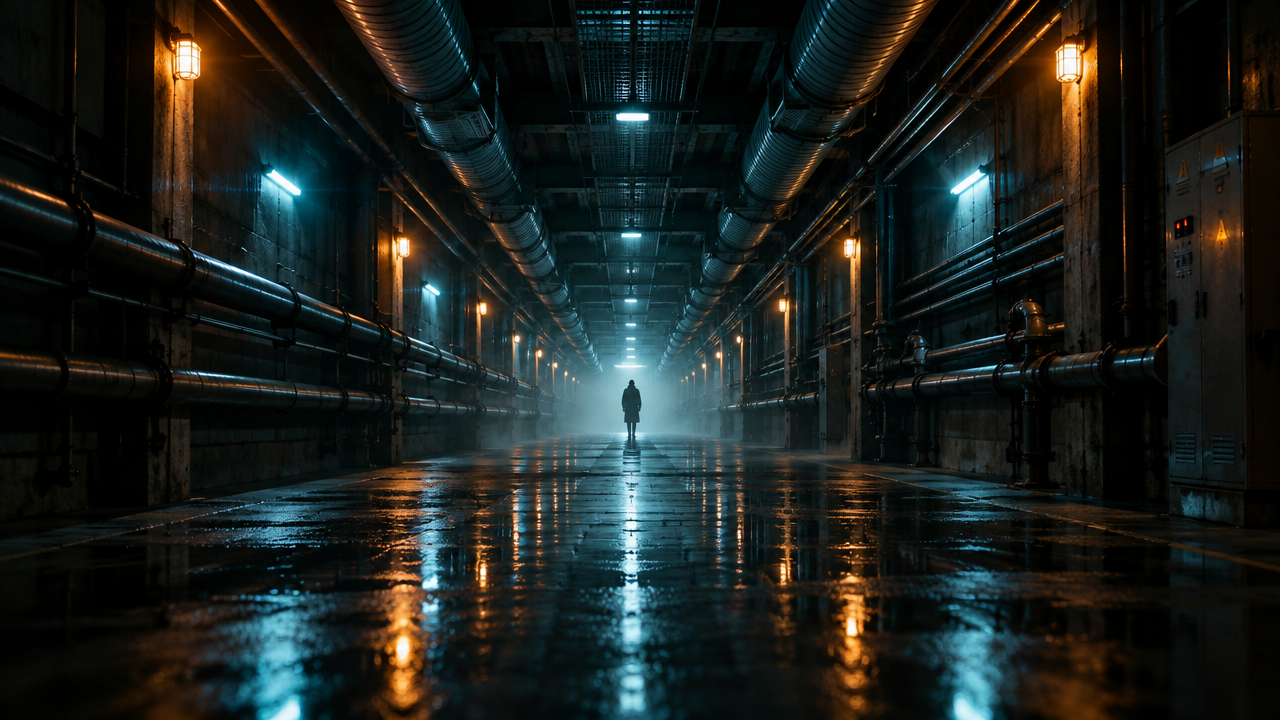
videoKamerabewegung – visuelle Notiz: Bild-zu-Video-Sprache der Kameraführung
Stil Kamerabewegung · Storyboard · Filmsprache
Referenz-Eingaben
image_urls
Prompt
Langsamer, filmischer Push-in, die Kamera auf eine einsame Gestalt am Ende eines regennassen Industriekorridors gerichtet, die Kamera gleitet mit konstanter Geschwindigkeit vorwärts, mit feinem, handgehaltenem Mikrozittern, geringe Schärfentiefe, die von den Rohren im Vordergrund allmählich auf das Motiv scharfstellt, kalt cyanfarbene und bernsteinfarbene praktische Lichtquellen flackern entlang der Wände, volumetrischer Nebel driftet durch das Bild, anamorphes Breitbild-Objektiv-Lens-Flare, filmische Bewegungsunschärfe bei 24 fps, stabile lange Einstellung, ohne Schnitt, zurückhaltende, beobachtende Grundstimmung
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
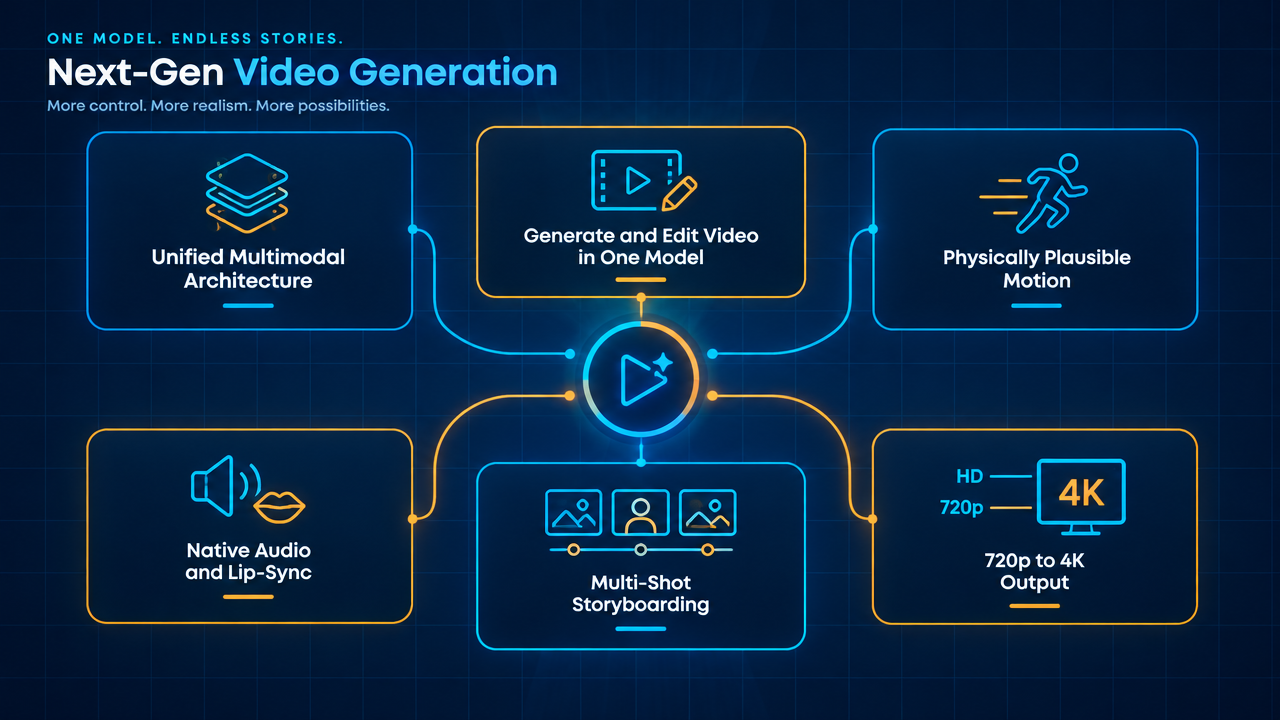
Kling 3.0 Omni Bild-zu-Video: Kerngrafik der Kernparameter und Anwendungsszenarien
Stil Erläuterung · i2v · Produktdemo
Referenz-Eingaben
image_urls
Prompt
Erstelle aus einer übersichtlichen 16:9-Technikfähigkeitsgrafik einen kurzen erklärenden Clip. Das Eröffnungsbild zeigt bereits ein Layout mit tief dunkelblauem Raster und sechs beschrifteten Parameterkarten: einheitliche multimodale Architektur, Text-zu-Video / Bild-zu-Video / Referenz-zu-Video sowie Bearbeitung innerhalb des Videos, dreidimensionale raumzeitliche gemeinsame Aufmerksamkeit für physikalisch plausible Bewegung, natives Audio und mehrsprachige Lippensynchronisation, Multishot-Storyboarding mit bis zu 15 Sekunden sowie Ausgabe von 720p bis 4K. Die Kamera fährt langsam und gleichmäßig vorwärts mit leichtem Parallaxendrift; die Karten werden nacheinander mit einem sanften Wischübergang von links nach rechts hervorgehoben und erhalten einen dezenten Leuchtschein, während die Verbindungslinien zwischen den Karten als feine Lichtlinien schrittweise gezeichnet werden. Halte sämtlichen Text scharf, gut lesbar und unverändert – keine Textneurenderung und keine fehlerhaften Glyphen. Zurückhaltende Unternehmens-Technologie-Ästhetik, tief dunkelblauer Hintergrund, cyanfarbene und warm bernsteinfarbene Akzentlichter, sanfter Volumennebel, geringe Schärfentiefe der Hintergrundebene, kontrastreiche Studiobeleuchtung, stabile Komposition, unverformte Beschriftungen, keine hinzugefügten Personen oder Objekte.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
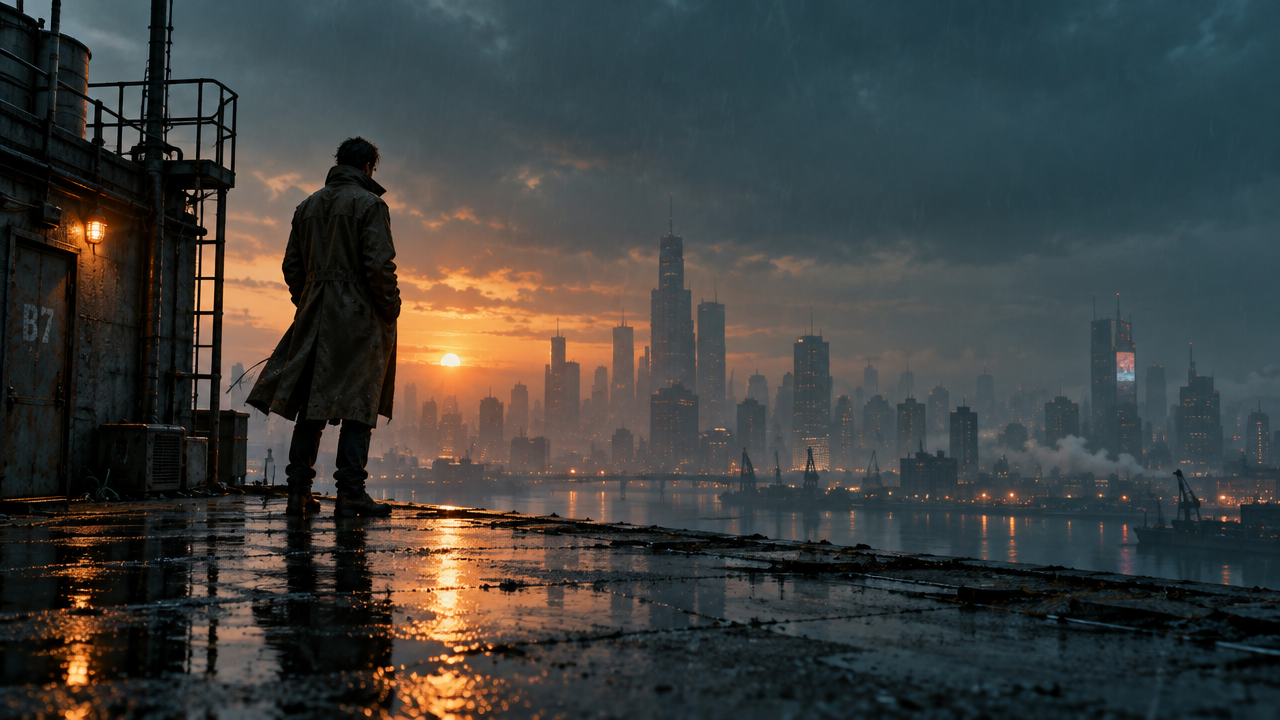
Storyboard-Konzept: Die Verwandlung vom Text zum Bild als filmische Kameraführung
Stil Storyboard · Konzeptkunst · Filmisch
Referenz-Eingaben
image_urls
Prompt
Kinoreife Konzeptaufnahme: In der Abenddämmerung steht eine einsame Gestalt in einer abgetragenen Jacke am Rand eines regennassen Industriedachs, während die Lichter der Stadt in der Ferne im Dunst weich erscheinen. Aus einer weiten Einstellungsgröße langsam heranfahrend, am Ende ein leichtes Anheben des Kamerakrans, geringe Schärfentiefe, Lens Flares eines anamorphen Breitbildobjektivs, kühle cyanfarbene Schatten und warmes Gegenlicht von Natriumdampflampen, feine Regentropfen, die im Licht aufblitzen, ein leichtes Atmen der Handkamera, kinoreife Bewegung mit 24 fps, die das Konzept-Art-Storyboard in einen Realfilm-Rhythmus überführt.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
kling-3.0-omni/image-to-video per second
Einordnung und Kurzprofil
kling-3.0-omni/image-to-video ist die Omni-Version der kling-3.0-Serie für die Bild-zu-Video-Generierung und wird über die einheitliche Schnittstelle von HiAPI.ai aufgerufen. Entwickler geben ein oder mehrere Frame-Bilder zusammen mit einem Text-Prompt ein und erzeugen so Videos mit 3–15 Sekunden Länge in 720p bis 4k; optional lassen sich natives Audio, intelligente Multi-Shot-Planung und wiederverwendbare Subjekte aktivieren. Geeignet ist das Modell für Entwickler, die in Szenarien wie E-Commerce-Präsentationen, Social-Media-Clips oder Storyboard-Previews statische Bilder schnell in dynamische Videos umwandeln wollen und dabei Elementkonsistenz sowie kontrollierbare Dauer und Bildqualität benötigen.
Wesentliche Highlights
- Steuerung über erstes und letztes Frame – Unterstützt 1 Bild als erstes Frame oder 2 Bilder, die erstes und letztes Frame getrennt festlegen, sodass der Generierungsprozess einen klaren Start- und Endpunkt hat.
- Wiederverwendbare Subjekte für Konsistenz – Bis zu 3 Subjekte definierbar, jedes beschrieben mit 2–4 Bildern und im Prompt über @Name referenziert, wodurch Subjekt-Drift über mehrere Shots hinweg reduziert wird.
- Optionales natives Audio – Bei aktiviertem audio werden Video und synchroner Ton gemeinsam erzeugt, was den separaten Schritt der Nachvertonung und Bild-Ton-Ausrichtung erspart.
- Einstellbare Dauer und Auflösung – Die Ausgabedauer reicht von 3–15 Sekunden, die Auflösung ist wahlweise 720p, 1080p oder 4k und passt sich damit verschiedenen Phasen von der Vorschau bis zum fertigen Clip an.
Funktionsbeschreibung
Steuerung über erstes Frame bzw. erstes und letztes Frame: Bei Eingabe von 1 Bild entsteht ein Video mit diesem Bild als Ausgangspunkt, oder bei Eingabe von 2 Bildern werden erstes und letztes Frame gesteuert; das Ausgabeseitenverhältnis folgt dem ersten Frame, was die Abstimmung auf die Bildkomposition vorhandener Materialien erleichtert.
Subjektreferenz und Konsistenz: Über elements lassen sich bis zu 3 benannte Subjekte definieren, jedes mit 2–4 Referenzbildern und einer kurzen Beschreibung; werden sie im Prompt mit @Name erwähnt, bleibt das Erscheinungsbild der Subjekte über mehrere Shots hinweg stabiler.
Native Audioerzeugung: Nach Aktivierung des audio-Parameters erzeugt die Videogenerierung gleichzeitig synchronen Ton, was für fertige Clips mit Dialogen oder Umgebungsgeräuschen geeignet ist und die Ton-Bild-Synthese vereinfacht.
Intelligente Multi-Shot-Planung: Bei aktiviertem prefer_multi_shots zerlegt das Modell den Prompt automatisch in mehrere Shots, sodass ein Aufruf einen Kurzfilm mit Shotschnitten statt einer einzigen durchgehenden Einstellung liefert.
Anwendungsfälle
- Produktbilder aus dem E-Commerce in Präsentationsvideos umwandeln – Mit dem Hauptproduktbild als erstem Frame entsteht ein kurzes Video mit Kamerabewegung für Produktdetailseiten oder Feed-Anzeigenmaterial.
- Statische Social-Media-Poster in dynamische Kurzclips verwandeln – Erstes und letztes Frame des Designentwurfs werden eingegeben und ein dynamisches Hoch- oder Querformat-Video erzeugt, das direkt auf Social-Plattformen veröffentlicht werden kann.
- Previews von Storyboard-Erst- und -Letztframes – Für Schlüsselframes von Film- oder Animations-Storyboards werden Erst- und Letztframe gepaart und Übergangsshots generiert, um Rhythmus und Kameraführung in der Vorproduktionsphase zu prüfen.
- Multi-Shot-Charakterclips – Mit elements wird das Charakterbild fixiert, Multi-Shot aktiviert und so in Serie konsistente kurze Erzählvideos für Werbung oder fortlaufende Inhalte erzeugt.
Einschränkungen und Auswahlhinweise
Die maximale Länge einer einzelnen Generierung beträgt 15 Sekunden; längere Erzählungen müssen in Segmenten erzeugt und anschließend zusammengefügt werden. Das Ausgabeseitenverhältnis wird durch das erste Frame bestimmt, daher müssen die Seitenverhältnisse der Materialien vorab vereinheitlicht werden. Es sind höchstens 3 Subjektreferenzen möglich, und jedes Subjekt benötigt 2–4 Bilder desselben Subjekts, was einen höheren Vorbereitungsaufwand für die Eingaben bedeutet. Natives Audio und intelligente Multi-Shot-Planung sind optionale Schalter; nach dem Aktivieren hängt die Qualität stärker von der Prompt-Beschreibung ab. Wenn ausschließlich textgesteuerte Generierung benötigt wird, sollte die Text-zu-Video-Route derselben Serie gewählt werden; wenn lokale Ersetzungen auf Basis eines vorhandenen Videos erforderlich sind, fällt dies nicht in den Bereich der Bild-zu-Video-Funktion dieser Route.
Neuigkeiten
Changelog ansehen →- Neues Modell Neues Modell: Kling 3.0 Omni (可灵 O3), aufrufbar über POST /v1/tasks. kling-3.0-omn…
Häufige Fragen
Alle Fragen ansehen →-
Muss ich bei Kling 3.0 Image-to-Video ein Bild hochladen?
Ja. Der aktuelle kling-3.0/image-to-video ist eine Image-to-Video-Route; das Eingabebild bestimmt das Motiv und die Ausgangskomposition, der Prompt steuert Bewegung, Kamera und Umgebungsveränderungen.
-
Welche Dauern und Auflösungen unterstützt Kling 3.0 Image-to-Video?
Der aktuelle HiAPI-Anfragevertrag unterstützt 3–15s, die Ausgabeauflösungen sind 720p, 1080p, 4K. Die verfügbaren Werte richten sich nach dem Parameterfeld der Seite und der API-Dokumentation.
-
Wie wird Kling 3.0 Image-to-Video abgerechnet?
Aufgaben werden nach der Ausgabedauer und der gewählten Stufe abgerechnet. Die Seite zeigt den Live-Preis in der globalen Währungseinheit an; die endgültige Abrechnung richtet sich nach dem Datensatz der erfolgreichen Aufgabe.
-
Wie lässt sich die Stabilität des Hauptmotivs bei der Bild-zu-Video-Generierung verbessern?
Verwenden Sie ein Eingabebild mit klarem Hauptmotiv, wenigen Verdeckungen und vollständiger Komposition; beschreiben Sie im Prompt zuerst die Hauptaktion und die Kameraführung und listen Sie anschließend die beizubehaltenden Merkmale von Aussehen, Material und Hintergrundbeziehungen auf. Für den ersten Test wird eine kürzere Dauer empfohlen.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: kling-3.0-omni/image-to-video
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für kling-3.0-omni/image-to-video und Route default — siehe Parametertabelle unten.
audiobooleanOptionalStandard: falseBoolescher Schalter, der steuert, ob beim Generieren des Videos gleichzeitig synchroner Ton erzeugt wird; Standardwert false, d. h. es wird kein Audio generiert.
promptstringPflichtminLength 1maxLength 3072Beschreibt den gewünschten Videoinhalt; um auf ein Subjekt aus subjects zu verweisen, kann der Name des Subjekts im Prompt in der Form @name erwähnt werden.
durationintegerOptionalStandard: 5min 3max 15Dauer des Ausgabevideos in Sekunden, Wertebereich 3-15; Standardwert 5.
elementsarrayOptionalmaxItems 3
Liste wiederverwendbarer Subjekte, maximal 3; jedes Element enthält einen Namen, eine kurze Beschreibung und 2-4 Bilder und wird im Prompt über @name referenziert.
Array [ object ]
Array-Elemente
namestringPflichtminLength 1Name des Subjekts, muss eindeutig sein und darf keine Leerzeichen enthalten; im Prompt wird das Subjekt in der Form @name referenziert.
descriptionstringPflichtminLength 1Kurzer Beschreibungstext zu diesem Subjekt, der dem Modell hilft, die Merkmale des Subjekts zu erkennen.
element_input_urlsarrayPflichtminItems 2maxItems 4Array mit 2-4 Bild-URLs desselben Subjekts, Formate JPG/PNG werden unterstützt.
Array [ string ]
image_urlsarrayPflichtminItems 1maxItems 2Array mit URLs für Start- und Endbild: 1 Bild ist das Startbild, 2 Bilder sind der Reihe nach Startbild und Endbild; JPG/PNG, pro Bild maximal 50 MB, mindestens 300 Pixel, Seitenverhältnis 0,4-2,5; das Seitenverhältnis der Ausgabe folgt dem Startbild.
Array [ string ]
resolutionstringOptionalStandard: "720p"Auflösung des Ausgabevideos; Standardwert 720p.
720p1080p4kprefer_multi_shotsbooleanOptionalStandard: falseBoolescher Schalter, der steuert, ob das Modell anhand des Prompts automatisch mehrere Kameraeinstellungen plant; Standardwert false.
callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "kling-3.0-omni/image-to-video",
  "input": {
    "audio": false,
    "prompt": "…",
    "duration": 5,
    "image_urls": "…",
    "resolution": "720p",
    "prefer_multi_shots": false
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "kling-3.0-omni/image-to-video",
input: {
"audio": false,
"prompt": "…",
"duration": 5,
"image_urls": "…",
"resolution": "720p",
"prefer_multi_shots": false
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "kling-3.0-omni/image-to-video",
"input": {
"audio": False,
"prompt": "…",
"duration": 5,
"image_urls": "…",
"resolution": "720p",
"prefer_multi_shots": False
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 LTX 2.5 Fast Lightricks $0.086 /Sekunde
-
 Gemini Omni 1.1 Flash Google $0.450 /Video
-
 Vidu Q4 Preview Vidu $0.051 /Sekunde
-
 Wan 2.7 Video Alibaba $0.100 /Sekunde
-
 MiniMax H3 MiniMax $0.072 /Sekunde
-
 Gemini Omni Google --
-
 Runway Gen 4.5 Runway $0.172 /Sekunde
-
 Vidu Q3 Vidu $0.149 /Sekunde
-
 Kling 2.5 Kuaishou $0.060 /Sekunde
-
 HeyGen Avatar IV HeyGen $0.150 /Sekunde
-
 HappyHorse 1.0 Alibaba $0.168 /Sekunde
-
 Veo 3.1 Fast Google $0.170 /Sekunde


