
MiniMax
MiniMax H3
minimax-h3
Einheitliches multimodales Videomodell, das Text, Bilder, Videos und Audio in einem einzigen Kontext gleichzeitig verarbeitet, Text-zu-Video, Bild-zu-Video, referenzbasiertes Video und instruktionsgestützte Bearbeitung unterstützt und synchrones Audio erzeugen kann
minimax-h3 ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
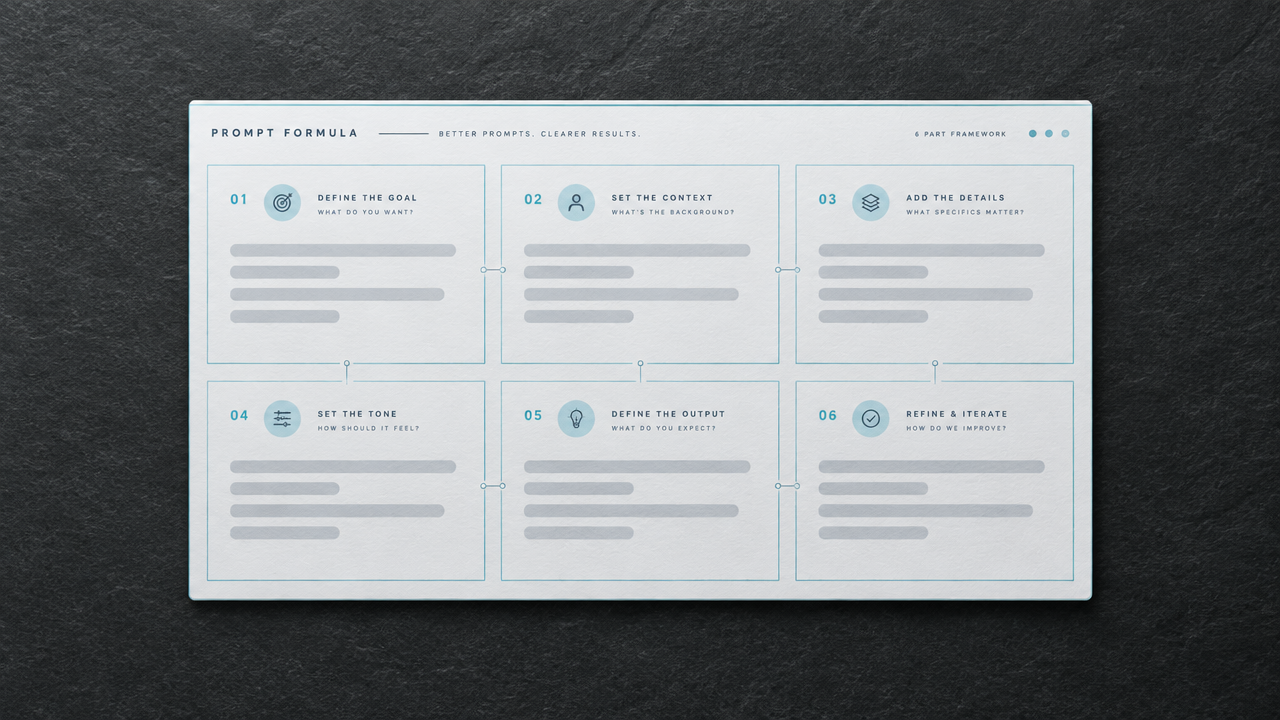
videoMiniMax H3 Prompt-Formel-Karte: Ein visueller Leitfaden für strukturiertes Schreiben
Stil Erläuterung · Bewegte Grafik · Typografie
Referenz-Eingaben
Referenzbild
Prompt
Eine saubere, präzise Motion-Graphics-Erklär-Einstellung: eine dunkel schieferfarbene Arbeitsfläche, weiches Deckenlicht, eine weiße Karte mit strukturierten Prompts schwebt in der Mitte. Sechs beschriftete Module setzen sich in stetigem Rhythmus nacheinander auf der Karte zusammen – Motiv, Aktion, Umgebung, Kamerasprache, Licht und Stimmung, Audio-Hinweis –, jedes Modul gleitet an seine feste Rasterposition, begleitet von feinen Verbindungslinien und kleinen nummerierten Indexmarkierungen. Die Kamera fährt langsam und gleichmäßig heran, mit einer leichten Parallaxen-Drift, sodass die Karte im oberen Zwei-Drittel-Bereich des 16:9-Bildformats bleibt. Die Typografie ist präzise und technisch, mit entsättigtem Cyan und warmem Weiß als Akzente auf anthrazitfarbenem Hintergrund, weicher Tiefenschärfe und feiner Filmkörnung. Kein Text wird zu unleserlichem Wirrwarr gerendert; jedes Modul erscheint als ruhiger, geordneter Block. Ton: ein tiefes ambientes Summen, begleitet von einem sanften Ticken, sobald jedes Modul seinen Platz einnimmt.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
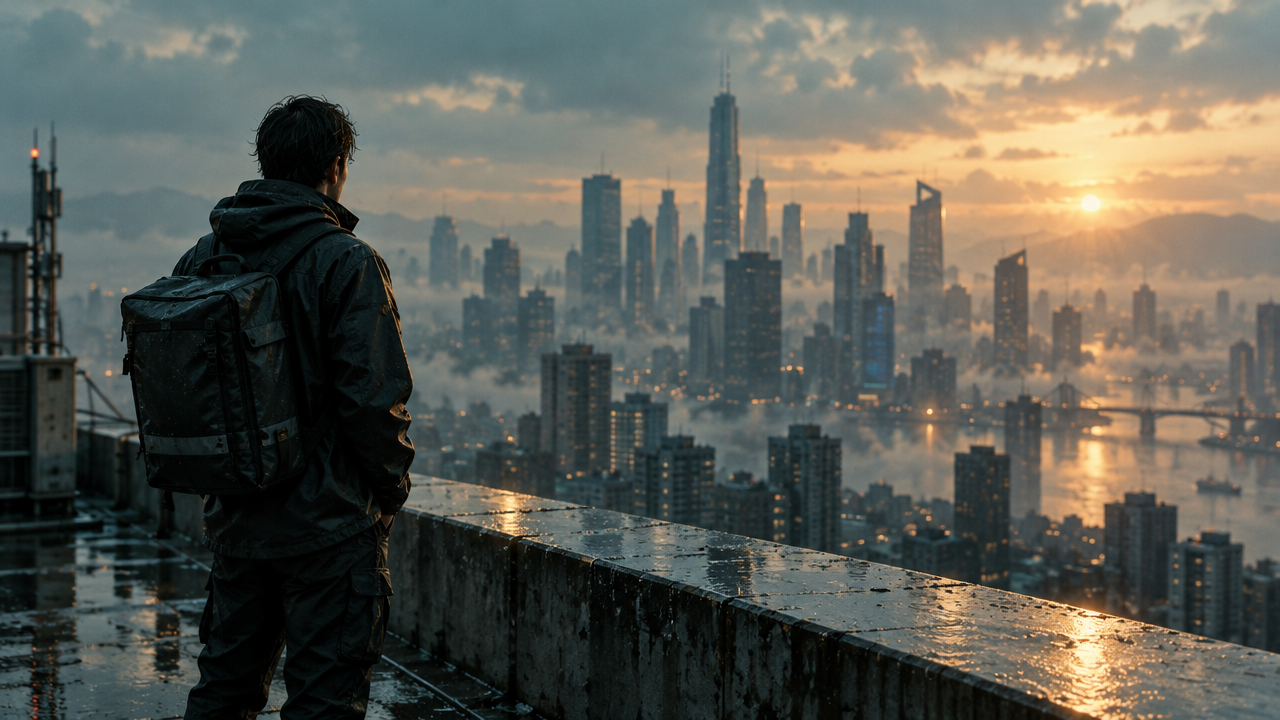
MiniMax H3 Szenen-Storyboard: Beispiel für die Umwandlung von Text zu Bild
Stil Szenen-Storyboard · Referenz-zu-Video · Filmisch
Referenz-Eingaben
Referenzbild
Prompt
Eine 6-sekündige filmische Szene, adaptiert nach dem Referenzkonzeptbild: Morgenlicht streift schräg über regennasse Stadtdächer, ein einsamer Kurier hält am Geländer an, sein Mantel weht im Wind. Die Kamera beginnt mit einer langsamen Annäherung als Weitwinkel-Totale und geht dann, während sich die Person zur Skyline wendet, fließend in eine sanfte laterale Kamerafahrt über; eine geringe Schärfentiefe hält die Silhouette vor weich verschwommenen Hochhäusern und ziehenden Wolken scharf. Konsistent mit den zarten blaugrünen und bernsteinfarbenen Tönen, dem sanften volumetrischen Nebel und der feinen Filmkörnung des Referenzbildes. Natürliche Bewegung mit 24 fps, leichtes handgeführtes Wanken, kein Schnitt, keine Texteinblendungen.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
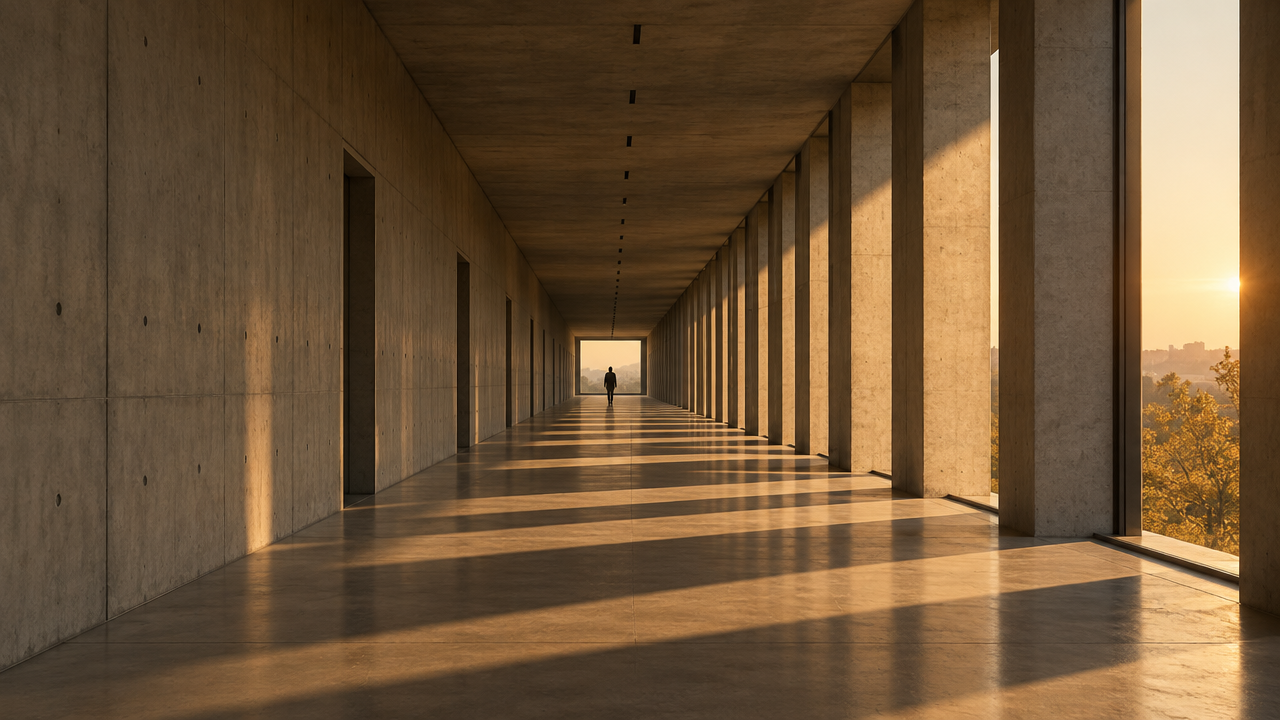
H3 Kamerasprache Visuelle Notizen: Vier Bewegungsbeispiele
Stil Kamerabewegung · Storyboard · Filmisch
Referenz-Eingaben
first_frame_image
Prompt
Langsame und stetige Kamerafahrt in einen minimalistischen Betonkorridor hinein; die Kamera folgt auf Augenhöhe nach vorn, mit einem leichten atmenden Handkamera-Gefühl, warmes Nachmittagslicht streift schräg über die Wände und wirft lange geometrische Schatten. Filmische 16:9-Komposition, geringe Schärfentiefe, Farbkorrektur mit Filmkorn-Charakter, natürlicher Lichtabfall, kein Schnitt, durchgehende Einstellung, ruhiges und beobachtendes Tempo.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
minimax-h3 per second
| Einzelpreis | $0.1189 |
|---|
Positionierung im Überblick
MiniMax H3 ist ein von MiniMax entwickeltes universelles Videogenerierungsmodell, das Text, Bilder, Videos und Audio in einem einheitlichen Kontext gemeinsam verarbeitet. Es unterstützt Text-zu-Video, Bild-zu-Video, Steuerung über Anfangs- und Endbild, multimodale Referenz-Videogenerierung und kann natives 2K-Bildmaterial ausgeben. Über die einheitliche Schnittstelle von HiAPI.ai aufgerufen, eignet es sich für Entwickler, die Storyboard-Prototyping, die Animation von Material und Kurzfilme mit konsistentem Charakterstil mit einem einzigen Modell umsetzen möchten – insbesondere für Teams, die in einem einheitlichen Workflow mehrere Generierungsmodi abdecken wollen.
Zentrale Highlights
- Einheitlicher Kontext für multimodale Eingaben – Text-, Bild-, Video- und Audioreferenzen lassen sich innerhalb desselben Modells kombinieren, wodurch die Kosten für den Wechsel zwischen spezialisierten Modellen je nach Aufgabe sinken.
- Native 2K-Ausgabe – Derzeit wird ausschließlich in nativer 2K-Auflösung generiert; die Bildformate reichen von 21:9 bis 9:16 sowie adaptiv und decken den Bedarf für Quer- und Hochformat-Ausspielungen ab.
- Kameratransitionen über Anfangs- und Endbild steuern – Mit einem Anfangs- und einem Endbild lassen sich die Übergänge zwischen beiden Bildern steuern, was die Produktion von Übergängen und Vorher-Nachher-Einstellungen erleichtert.
- Konsistenz durch multimodale Referenzen – Unterstützt bis zu 5 Referenzbilder, 3 Referenzvideos und 3 Referenzaudios, um Charaktere, Stil und Rhythmus fortzuführen.
Funktionsbeschreibung
Text-zu-Video: Allein durch Eingabe einer Textaufforderung lassen sich Videos mit einer ganzzahligen Dauer von 4–15 Sekunden erzeugen; als Bildformat stehen 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 oder adaptiv zur Wahl, Standard ist 16:9.
Bild-zu-Video und Steuerung über Anfangs- und Endbild: Ein öffentlich zugängliches Bild dient als erstes Einzelbild zur Videogenerierung, oder es werden zugleich Anfangs- und Endbild zur Steuerung des Übergangs angegeben; die Bildsteuerung und die Referenzmedienfelder schließen sich gegenseitig aus, die Route muss daher vorab festgelegt werden.
Multimodale Referenz-Videogenerierung: Akzeptiert bis zu 5 Referenzbilder, 3 Referenzvideos mit 2–15 Sekunden sowie bis zu 3 Referenzaudios mit einer Gesamtlänge von höchstens 15 Sekunden; Audio kann nicht allein verwendet werden, sondern muss mit mindestens einem Bild oder einem Video kombiniert werden.
Optionales AIGC-Wasserzeichen: Über den Parameter watermark wird festgelegt, ob das Ausgabevideo ein AIGC-Wasserzeichen trägt; standardmäßig wird keines hinzugefügt, sodass sich dies je nach Compliance-Anforderung des Veröffentlichungskanals umschalten lässt.
Anwendungsszenarien
- Werbeagenturen erstellen mit Textaufforderungen schnell Storyboard-Prototypen – Mit Multi-Shot-Aufforderungen werden 4–15-sekündige Ausschnitte als Storyboard-Preview-Assets für Kreativ-Reviews und Kundenpräsentationen erzeugt.
- E-Commerce-Design animiert Produktbilder zu Kurzfilmen – Mit einem Produktbild oder einer Illustration als erstem Einzelbild wird ein 2K-Video erzeugt, das direkt für Produktdetailseiten und Feed-Werbematerial verwendet wird.
- Content-Creator erstellen Übergänge mit Anfangs- und Endbild – Durch zwei vorgegebene Bilder vor und nach dem Übergang werden Übergangseinstellungen für den Kurzvideo-Schnitt oder Vorher-Nachher-Demonstrationen erzeugt.
- Multimodale Referenzgenerierung für Kurzfilme mit konsistenten Charakteren – Durch Kombination von Charakterbildern, Stilvideos und Referenzaudio werden stilistisch einheitliche Ausschnitte für die Serienproduktion von Inhalten erzeugt.
Einschränkungen und Auswahlhinweise
Die maximale Dauer einer einzelnen Generierung beträgt 15 Sekunden; längere Inhalte müssen in Abschnitten generiert und anschließend zusammengesetzt werden. Die Steuerung über Anfangs- und Endbild sowie die Referenzmedienfelder dürfen nicht gemischt werden; im Referenzmodus müssen Bild-, Video- und Audioeingaben nach festen Regeln organisiert werden, was eine gewisse Einarbeitung bei der Formulierung der Aufforderungen erfordert; Referenzaudio kann nicht allein verwendet werden. Wenn eine Aufgabe durchgehende lange Einstellungen von mehr als 15 Sekunden, Auflösungsstufen unterhalb von 2K oder einen einfacheren reinen Textgenerierungsablauf erfordert, sollten andere Routen oder Modelle geprüft werden.
Neuigkeiten
Changelog ansehen →- Neues Modell Neues Modell: minimax-h3 —— native 2K-Videos über POST /v1/tasks generieren, Unterstützung für 4-15 Sekunden Text-zu-Video…
Häufige Fragen
Alle Fragen ansehen →-
Was für ein Videomodell ist MiniMax H3?
Es stellt den Prompt in den Mittelpunkt; optional können Start- und Endbilder oder Referenzbilder, -videos und -audios hinzugefügt werden; die verschiedenen Steuerungsarten sollten gemäß dem aktuellen Parametervertrag kombiniert werden.
-
Welche Ausgabespezifikationen unterstützt MiniMax H3?
Unterstützt 4-15 Sekunden, Auflösungen einschließlich 2K, Seitenverhältnisse einschließlich 21:9, 16:9, 4:3, 1:1, 3:4, 9:16, adaptive.
-
Können Audiodaten generiert oder Audio-Referenzen verwendet werden?
Optional Bild-, Video- und Audio-Referenzen; Audiogenerierung wird unterstützt
-
Wie wird MiniMax H3 abgerechnet?
Die Abrechnung erfolgt nach Ausgabedauer und Echtzeit-Stufe; Abweichungen durch Auflösung, Modus oder Tonoptionen richten sich nach dem Seitenpreis und den Aufgabenaufzeichnungen.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: minimax-h3
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für minimax-h3 und Route default — siehe Parametertabelle unten.
promptstringPflichtminLength 1maxLength 7000Prompt für den Videoinhalt, in allen Generierungsmodi erforderlich, maximale Länge 7000 Zeichen.
durationintegerOptionalStandard: 5min 4max 15Dauer des generierten Videos in ganzzahligen Sekunden, Standard 5 Sekunden.
watermarkbooleanOptionalStandard: falseOb dem generierten Video ein AIGC-Wasserzeichen hinzugefügt wird, boolescher Wert, Standard false.
audio_urlsarrayOptionalmaxItems 3Array von Referenz-Audio-URLs, maximal drei Segmente mit einer Gesamtdauer von höchstens 15 Sekunden; Audio kann nicht allein verwendet werden, es muss mindestens ein Referenzbild oder ein Referenzvideo begleiten.
Array [ string ]
image_urlsarrayOptionalmaxItems 5Array von Referenzbild-URLs für die multimodale referenzbasierte Videogenerierung, HiAPI akzeptiert maximal fünf Bilder; nicht gleichzeitig mit der Erst-/Letztbild-Steuerung verwendbar.
Array [ string ]
resolutionstringOptionalStandard: "2K"Ausgabeauflösung, MiniMax H3 unterstützt derzeit nur native 2K-Generierung, Standard 2K.
2Kvideo_urlsarrayOptionalmaxItems 3Array von Referenzvideo-URLs für die multimodale referenzbasierte Videogenerierung, maximal drei Segmente, jeweils 2–15 Sekunden und insgesamt höchstens 15 Sekunden.
Array [ string ]
aspect_ratiostringOptionalStandard: "16:9"Seitenverhältnis der Ausgabe, Standard 16:9; Text-zu-Video verwendet standardmäßig 16:9, die Erst-/Letztbild-führte Videogenerierung folgt dem Eingabebild, der Referenzmodus kann adaptiv sein.
21:916:94:31:13:49:16adaptivelast_frame_imagestringOptionalÖffentliche Bild-URL für das Endbild; first_frame_image muss ebenfalls angegeben werden.
first_frame_imagestringOptionalÖffentliche Bild-URL für das Startbild; die Erst-/Letztbild-Steuerung darf nicht gleichzeitig mit Referenzmedienfeldern verwendet werden, erforderlich, wenn last_frame_image angegeben wird.
callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "minimax-h3",
  "input": {
    "prompt": "…",
    "duration": 5,
    "watermark": false,
    "resolution": "2K",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "minimax-h3",
input: {
"prompt": "…",
"duration": 5,
"watermark": false,
"resolution": "2K",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "minimax-h3",
"input": {
"prompt": "…",
"duration": 5,
"watermark": False,
"resolution": "2K",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Kling 3.0 Kuaishou $0.100 /Sekunde
-
 HeyGen Avatar IV HeyGen $0.150 /Sekunde
-
 Vidu Q4 Preview Vidu $0.051 /Sekunde
-
 Vidu Q3 Vidu $0.149 /Sekunde
-
 HappyHorse 1.0 Alibaba $0.168 /Sekunde
-
 Wan 2.6 Flash Alibaba $0.043 /Sekunde
-
 Veo 3.1 Lite Google $0.060 /Sekunde
-
 HappyHorse 1.1 Alibaba $0.160 /Sekunde
-
 Seedance 2.5 ByteDance $0.121 /Sekunde
-
 Hailuo 2.3 MiniMax $0.270 /Video
-
 Grok Imagine 1.5 Lite xAI $0.029 /Sekunde
-
 Wan 3.0 Video Alibaba $0.040 /Sekunde


