
Alibaba
Wan 2.7 Image
wan2.7-image/text-to-image
Ein von Alibaba entwickeltes Bildgenerierungs- und -bearbeitungsmodell, das Text-zu-Bild-Generierung, die Kombination mehrerer Referenzbilder und instruktionsbasierte Bearbeitung in einem einzigen Workflow vereint und Langtext-Rendering sowie Markenfarben-Steuerung unterstützt
wan2.7-image/text-to-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image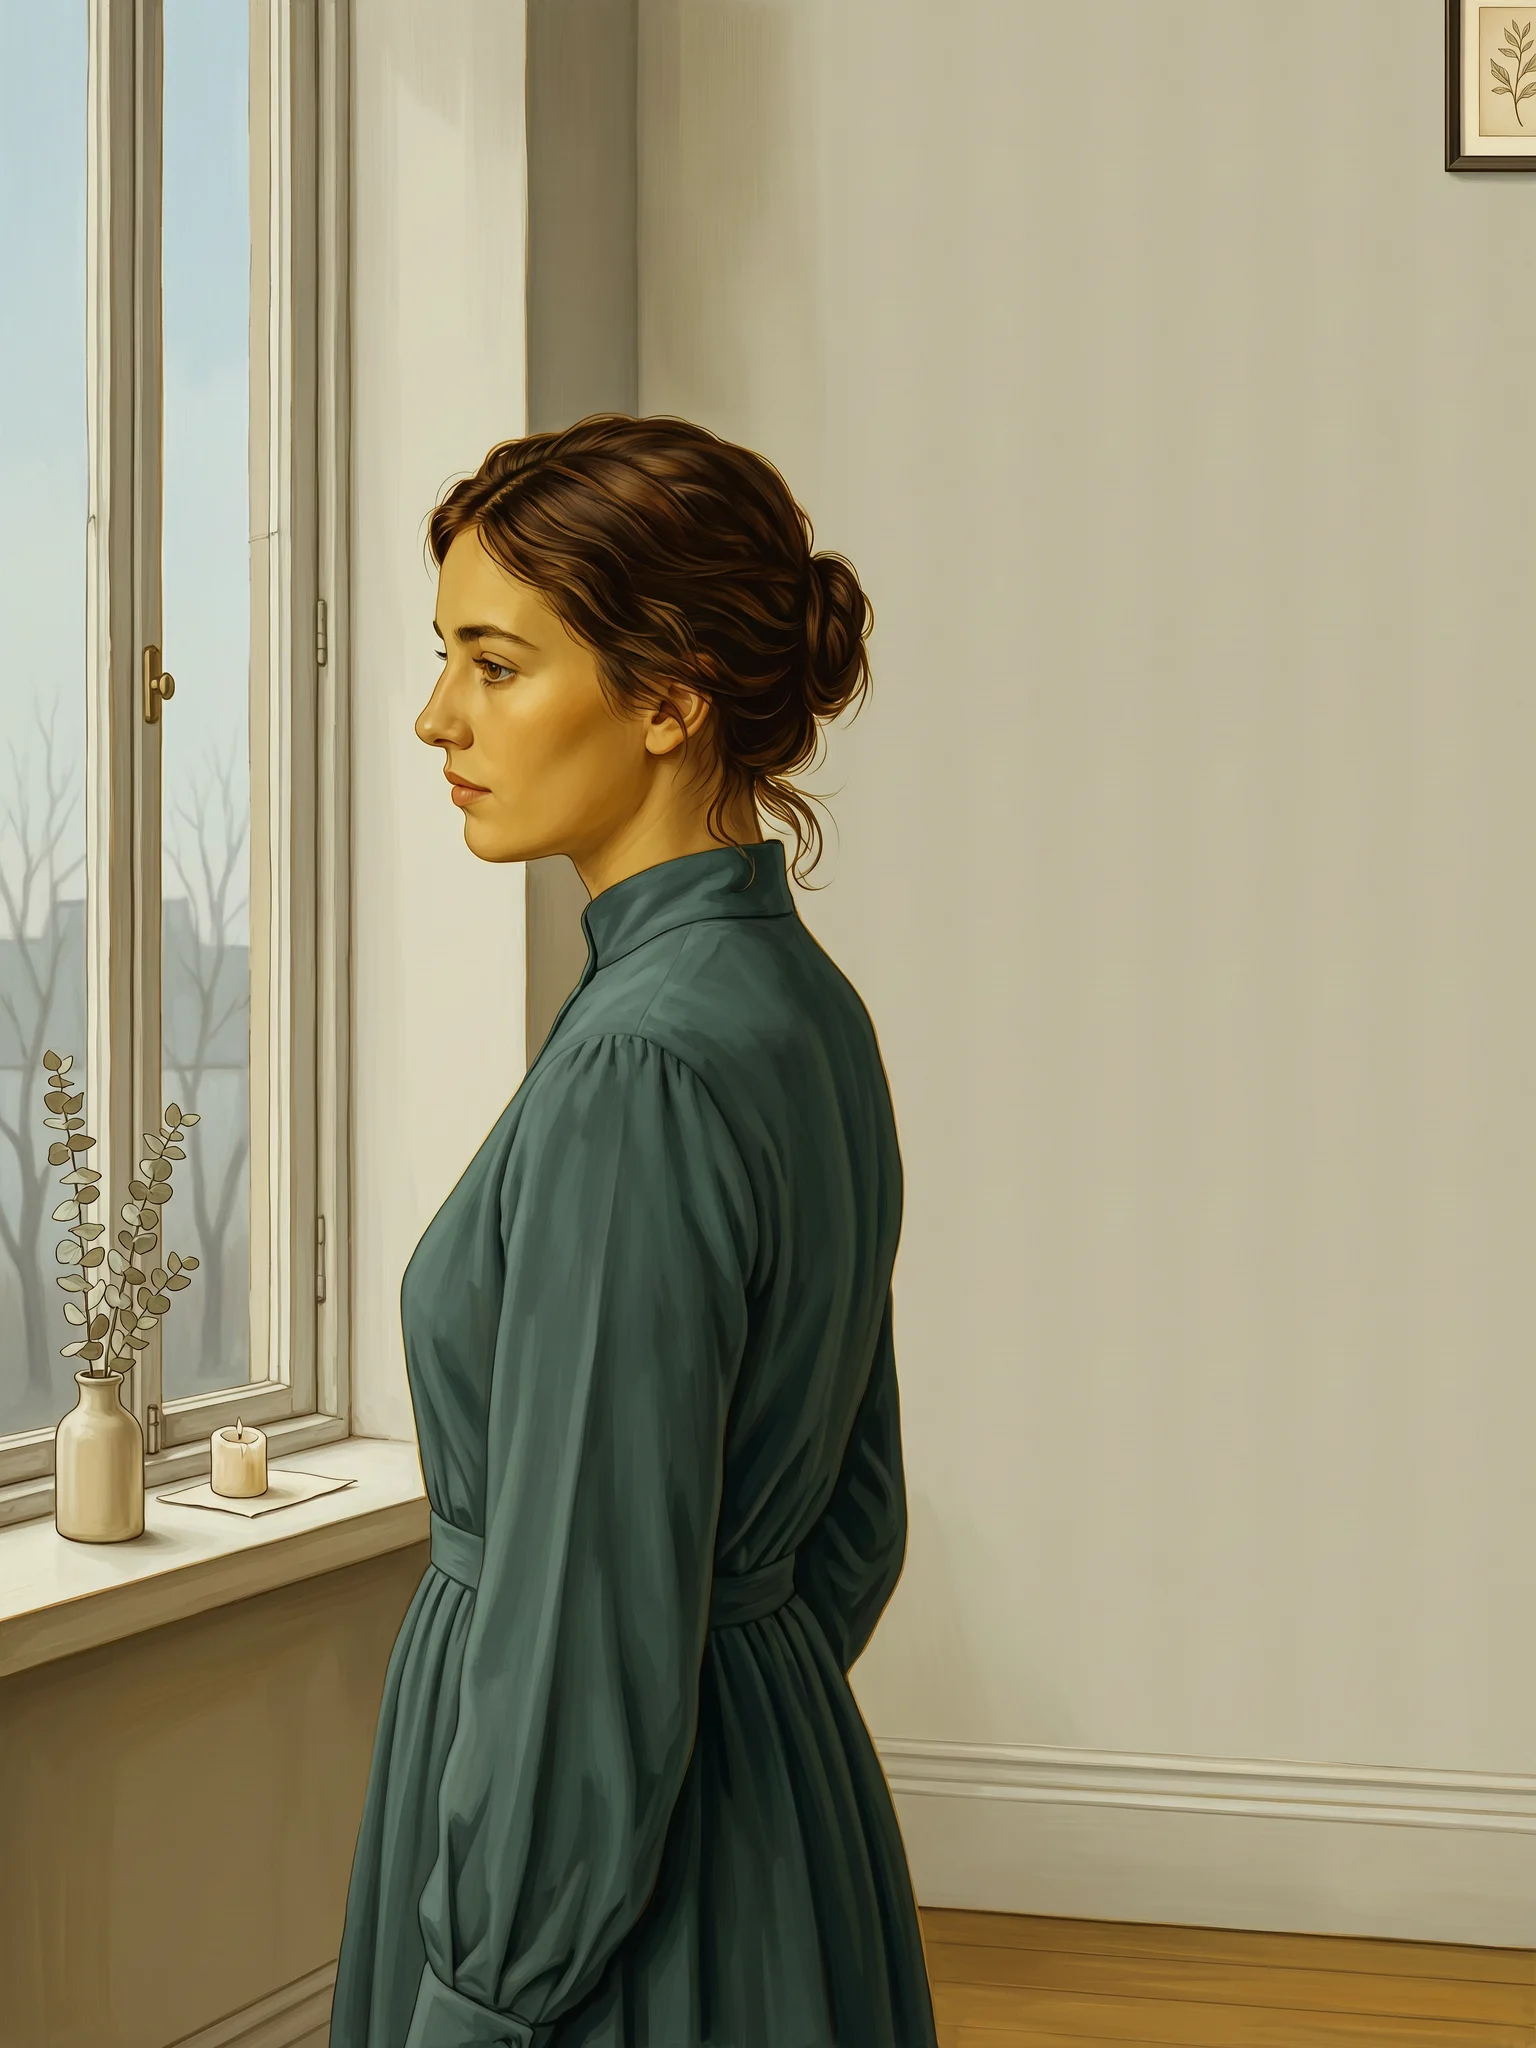
Von realistisch bis flach: Eine Prompt-Reise durch das Spektrum der Illustrationsstile
Stil Illustration · Stilspektrum · Charakterdesign
Prompt
Ein Halbporträt einer jungen Frau im Profil, die vor einem hohen Fenster steht und den Kopf leicht zurück zum Betrachter dreht, weiches Tageslicht fällt von links ein, der Hintergrund ist ein schlichter, neutraler Innenraum. Einheitliche klassische Illustrationskomposition, klare Konturen, mittlere Bildweite, auf der rechten Seite ausgewogener Negativraum für die Platzierung von Text. Malerische Umsetzung, sichtbare Pinselstrichstruktur, warme Ockertöne und entsättigte Blaugrüntöne, stimmige Körperproportionen, sanftes Konturlicht auf Wangen und Schultern, subtile atmosphärische Tiefe im Innenraum, 16:9-Querformat, detailreiche Stofffalten und Haarsträhnen.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
wan2.7-image/text-to-image per image
| Einzelpreis | $0.080 |
|---|
Positionierung im Überblick
wan2.7-image/text-to-image ist die Text-zu-Bild-Route der Wan-Serie von Alibaba und wird auf HiAPI.ai über eine einheitliche Schnittstelle aufgerufen. Sie nimmt chinesische und englische Prompts entgegen und erzeugt daraus Bilder, wobei wahlweise die Auflösungsstufen 1K und 2K sowie acht Seitenverhältnisse verfügbar sind und ein fester Zufalls-Seed die Reproduktion desselben Ergebnisses ermöglicht. Nach Aktivierung des erweiterten Inferenzmodus folgert das Modell zunächst und erzeugt erst danach das Bild, wodurch längere Generierungszeiten gegen eine höhere Bildqualität eingetauscht werden. Geeignet ist die Route für Entwickler, die visuelle Materialien in Serie produzieren und dabei Anforderungen an Bildspezifikationen und Reproduzierbarkeit der Ergebnisse stellen, etwa für Produktionsabläufe wie Posterbebilderungen, E-Commerce-Szenenbilder und Storyboard-Skizzen.
Kernhighlights
- Schalter für erweiterte Inferenz – Qualität und Zeitaufwand wählbar – thinking_mode ist standardmäßig deaktiviert; nach Aktivierung folgert das Modell zunächst und erzeugt erst danach das Bild, sodass je nach geschäftlichen Anforderungen an Bildqualität und Wartezeit flexibel umgeschaltet werden kann.
- Fester Seed, reproduzierbare Ergebnisse – Die Übergabe eines seed reproduziert dasselbe Bild, was beim Debuggen von Prompts oder bei der seriellen Bilderzeugung die Kontrolle der Variablen und eine stabile Ausgabe erleichtert.
- Seitenverhältnisse von Hochformat bis zu ultrabreitem Querformat – Neben gängigen Verhältnissen wie 1:1, 16:9 und 9:16 stehen auch 21:9, 8:1 und 1:8 zur Verfügung, die sich direkt für Banner, Hochformat-Materialien und ultrabreite Layouts eignen.
Funktionsbeschreibung
Text-zu-Bild auf Chinesisch und Englisch: Prompts werden auf Chinesisch und Englisch mit einer Länge von bis zu 5000 Zeichen unterstützt; Entwickler können die Bildbeschreibung direkt auf Chinesisch verfassen oder englische Prompts weiterverwenden, was den Aufwand für sprachübergreifende Umschreibungen reduziert.
Steuerung von Auflösung und Bildformat: Für die Ausgabe sind die Stufen 1K und 2K in Kombination mit acht Seitenverhältnissen wählbar, sodass ein einziger Aufruf ein fertiges Bild gemäß den Formatvorgaben liefert und spätere Zuschnitte und Skalierungen entfallen.
Bilderzeugung mit erweiterter Inferenz: Nach Aktivierung von thinking_mode steigt die Bildqualität, jedoch erhöht sich auch der Zeitaufwand; so lässt sich je nach Wichtigkeit des Materials abstufen, etwa deaktiviert in der Entwurfsphase und aktiviert in der Finalisierungsphase.
Reproduzierbare Ergebnisse: Durch einen festen seed wird die Zufälligkeit fixiert, sodass derselbe Prompt mit denselben Parametern wiederholt dasselbe Ergebnis liefert, was Regressionsvergleiche und Ergebnisprüfungen bei der Serienproduktion erleichtert.
Anwendungsszenarien
- Serielle Erzeugung von Kampagnenbebilderungen für Marketing-Entwickler – Kampagnenthema und Bildbeschreibung eingeben, im Format 16:9 oder 1:1 ausgeben und Bebilderungen erhalten, die direkt in Landingpages und Werbematerialien eingesetzt werden können.
- Erstellung von Produktszenenbildern für E-Commerce-Systeme – Mit den Verkaufsargumenten des Produkts als Prompt Szenenbilder erzeugen, die als Anzeigematerial für Produktdetailseiten und Listenseiten dienen.
- Storyboard- und Szenenskizzen für Content-Teams – Entlang des Drehbuchs Szene für Szene Prompts verfassen und den seed fixieren, um reproduzierbare Storyboard-Referenzbilder für die kreative Vorprüfung zu erhalten.
- Anpassung an verschiedene Platzierungsformate – Dieselbe Beschreibung jeweils in Formaten wie 21:9, 3:4 und 1:8 erzeugen und so komplette Materialsätze für Banner-, Hochformat- und ultrabreite Platzierungen erhalten.
Einschränkungen und Auswahlhinweise
Diese Route ist reine Text-zu-Bild-Generierung, akzeptiert keine Referenzbildeingaben und bietet keine Bildbearbeitung oder partielle Neuzeichnung; die maximale Ausgabeauflösung beträgt 2K, und wenn 4K-Bilder benötigt werden, sollte auf die Pro-Route derselben Serie ausgewichen werden. Wenn die Aufgabe auf Konsistenz über mehrere Bilder, instruktionsbasierte Bildänderungen oder Klick-Bearbeitung angewiesen ist, kann die aktuelle Route dies nicht abdecken. Die Textdarstellung in Prompts ist nicht garantiert; fertige Bilder mit präzisen Layout- und Markenfarbanforderungen müssen weiterhin manuell geprüft werden. Die Generierungsergebnisse hängen stark von der Formulierung des Prompts ab; es empfiehlt sich, zunächst mit einer niedrigeren Stufe und festem seed Testversionen zu erstellen und erst dann seriell auszugeben.
Neuigkeiten
Changelog ansehen →- Neues Modell Das Bildgenerierungsmodell wan2.7-image-standard ist jetzt verfügbar
Häufige Fragen
Alle Fragen ansehen →-
Welche besonderen Bildformate unterstützt Wan 2.7 Image?
Neben den gängigen Quer- und Hochformaten werden auch ultrabreite oder ultrahohe Formate wie 21:9, 8:1 und 1:8 unterstützt.
-
Welche Funktion hat der Thinking Mode?
Wenn er aktiviert ist, verlängert sich die Generierungszeit, um die推理 und Bildkomposition bei komplexen Prompts zu verbessern; für schnelle Entwürfe kann er deaktiviert bleiben.
-
Wie wählt man zwischen 1K, 2K und 4K?
Verwenden Sie zunächst 1K oder 2K, um die Richtung zu validieren, und wählen Sie erst dann 4K, wenn Sie letztendlich eine größere Ausgabe benötigen. Der auf dieser Seite angegebene Preis ist ein Festpreis pro Einzelbild.
-
Werden Referenzbilder unterstützt?
Das aktuelle Modell verwendet eine reine Text-zu-Bild-Pipeline und akzeptiert keine Referenzbilder.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: wan2.7-image/text-to-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für wan2.7-image/text-to-image und Route default — siehe Parametertabelle unten.
seedintegerOptionalmin 0max 2147483647Zufälliger Seed zur Reproduktion der Generierungsergebnisse; bei gleichem Seed erhält man konsistente Ausgaben.
promptstringPflichtminLength 1maxLength 5000Text-Prompt für die Bilderzeugung, unterstützt Eingaben auf Chinesisch und Englisch und bestimmt den Inhalt des erzeugten Bildes.
resolutionstringOptionalStandard: "2K"Ausgabauflösungsstufe; Pro unterstützt bis zu 4K; Standard ist 2K.
1K2K4Kaspect_ratiostringOptionalStandard: "1:1"Seitenverhältnis des Ausgabebildes; Standard ist 1:1.
1:116:94:321:93:49:168:11:8thinking_modebooleanOptionalStandard: falseOb erweitertes Reasoning zur Verbesserung der Bildqualität aktiviert wird; bei Aktivierung erhöht sich die Generierungsdauer; standardmäßig deaktiviert (false).
callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "wan2.7-image/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "thinking_mode": false
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "wan2.7-image/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": false
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "wan2.7-image/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": False
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 BRIA Eraser Bria $0.058 /Bild
-
 Recraft V4.1 Recraft $0.010 /Bild
-
 Ideogram V3 Character Ideogram $0.090 /Bild
-
 FASHN Tryon v1.6 FASHN $0.107 /Bild
-
 Recraft Creative Upscale Recraft $0.357 /Bild
-
 FLUX.1 Schnell Black Forest Labs $0.005 /Bild
-
 FLUX.2 Black Forest Labs $0.035 /Bild
-
 FIBO 1.5 Bria $0.058 /Bild
-
 Grok Imagine Quality xAI $0.070 /Bild
-
 Ideogram V4 Ideogram $0.050 /Bild
-
 BRIA Product Shot Bria $0.058 /Bild
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /Bild
Gleicher Anbieter
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 Zeichen
-
 Qwen Image 2.0 Alibaba $0.042 /Bild
-
 HappyHorse 1.1 Alibaba $0.160 /Sekunde
-
 Z-Image Alibaba $0.008 /Bild
-
 Wan 3.0 Video Alibaba $0.040 /Sekunde
-
 Qwen Image 3.0 Alibaba $0.036 /Bild
-
 Wan 2.6 Flash Alibaba $0.043 /Sekunde
-
 HappyHorse 1.0 Alibaba $0.168 /Sekunde
-
 Qwen Image 2.1 Alibaba $0.020 /Bild
-
 Wan 2.7 Video Alibaba $0.100 /Sekunde