Bria
FIBO 2.0
fibo-2.0/image-to-image
Ein einheitliches Bildmodell von Bria, das Text-zu-Bild-Generierung und instruktionsbasierte Bildbearbeitung in einem einzigen Modell vereint; bei der Bearbeitung können bis zu vier Bilder eingegeben werden; trainiert ausschließlich mit lizenzierten Daten, geeignet für Concept Art, Marketing-Standbilder und E-Commerce-Produktbilder
fibo-2.0/image-to-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image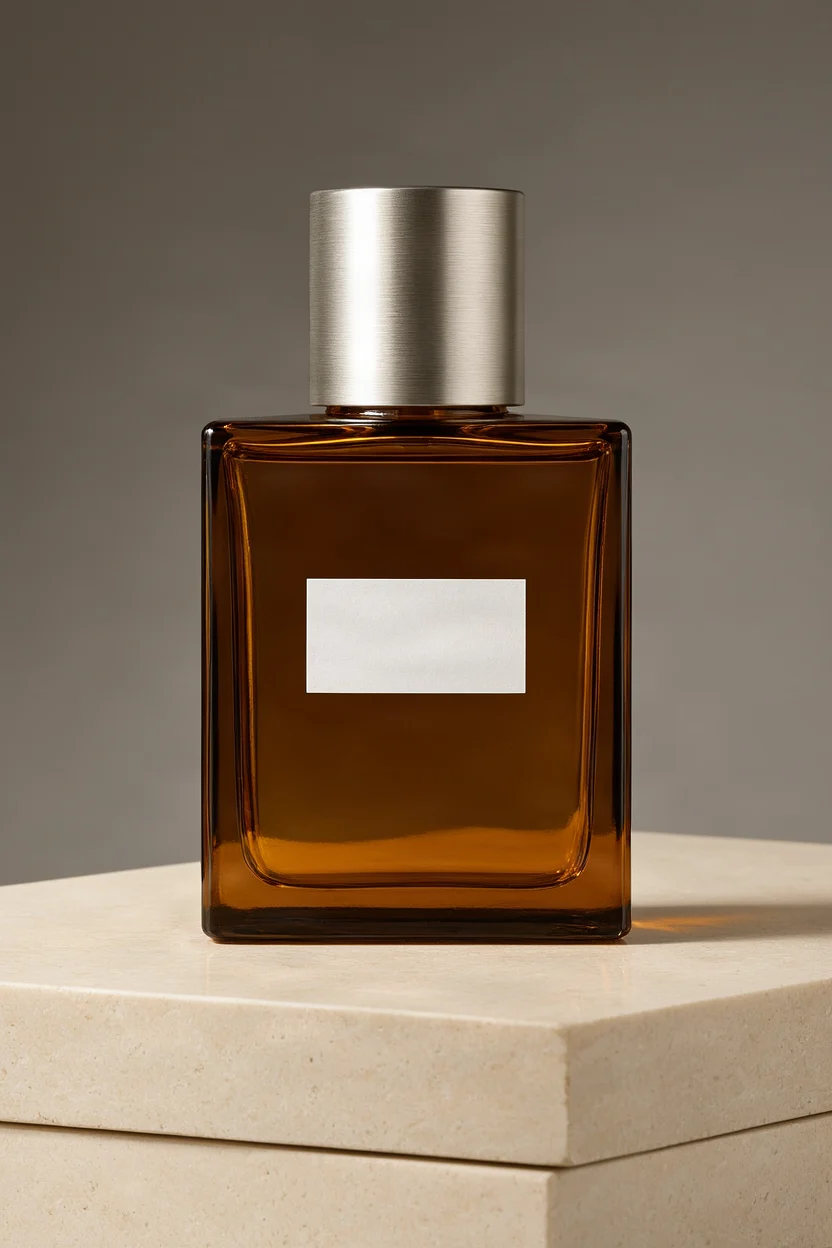
Bernstein-Parfümflakon · E-Commerce-Stillleben in Studioqualität
Stil Produktbild · Studiobeleuchtung · Stillleben
Referenz-Eingaben
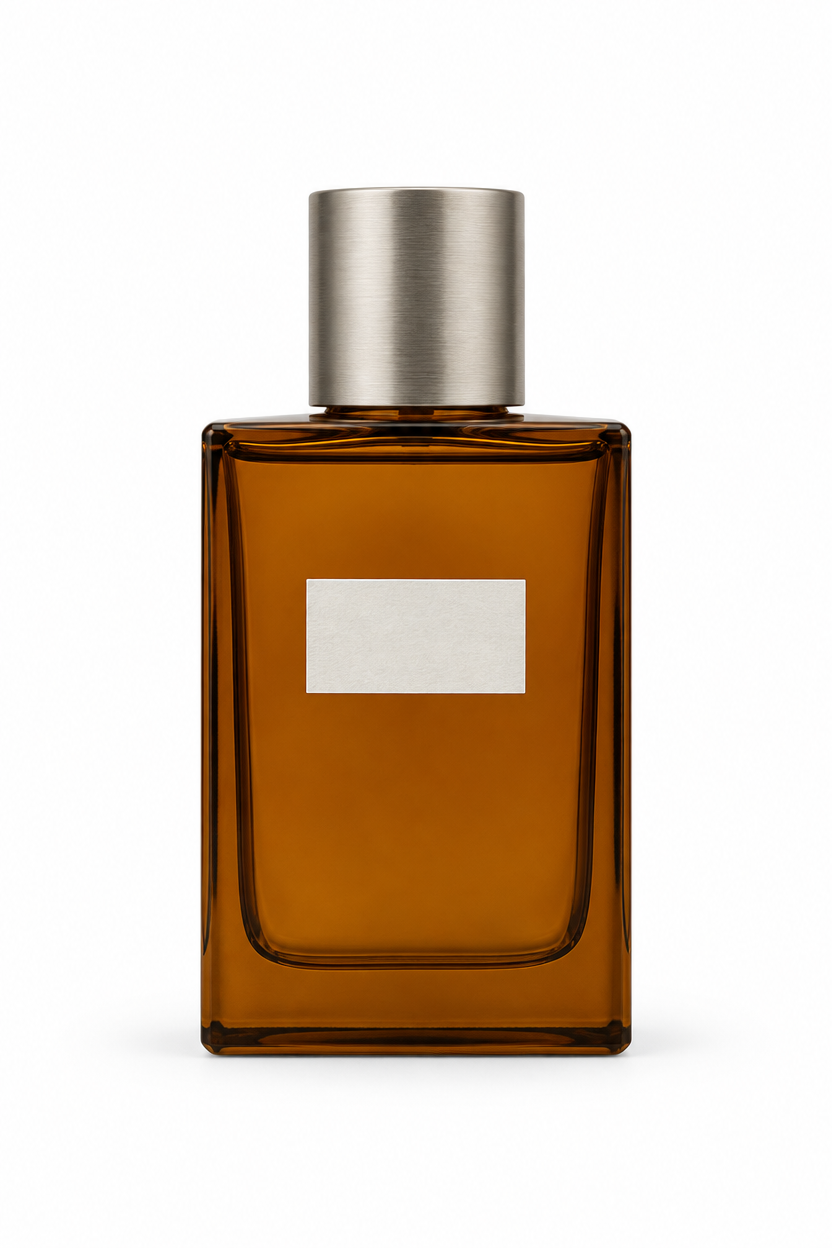
Eingabebild
Prompt
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
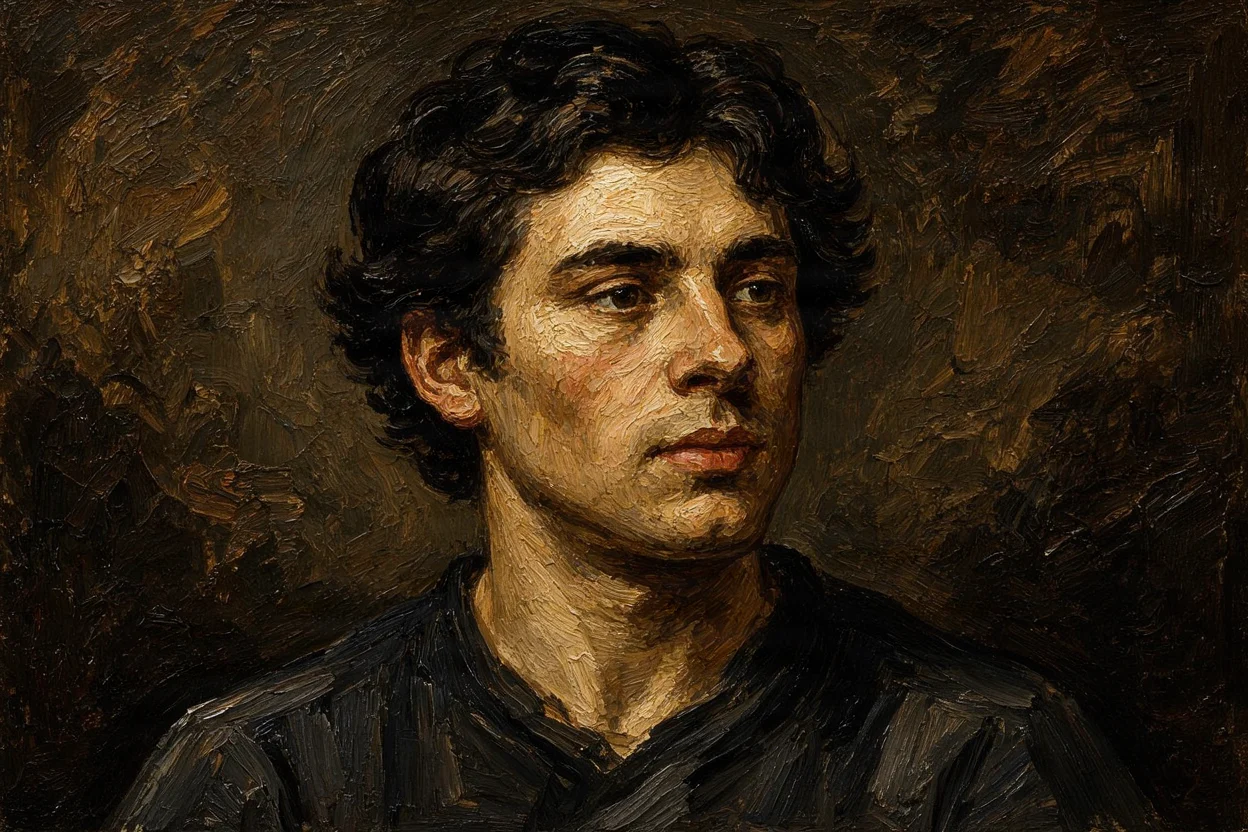
Rembrandt-Seitenlicht · Porträt im Ölgemälde-Stil neu gestaltet
Stil Impressionistisches Porträt · Studiobeleuchtung · Alter Meister
Referenz-Eingaben
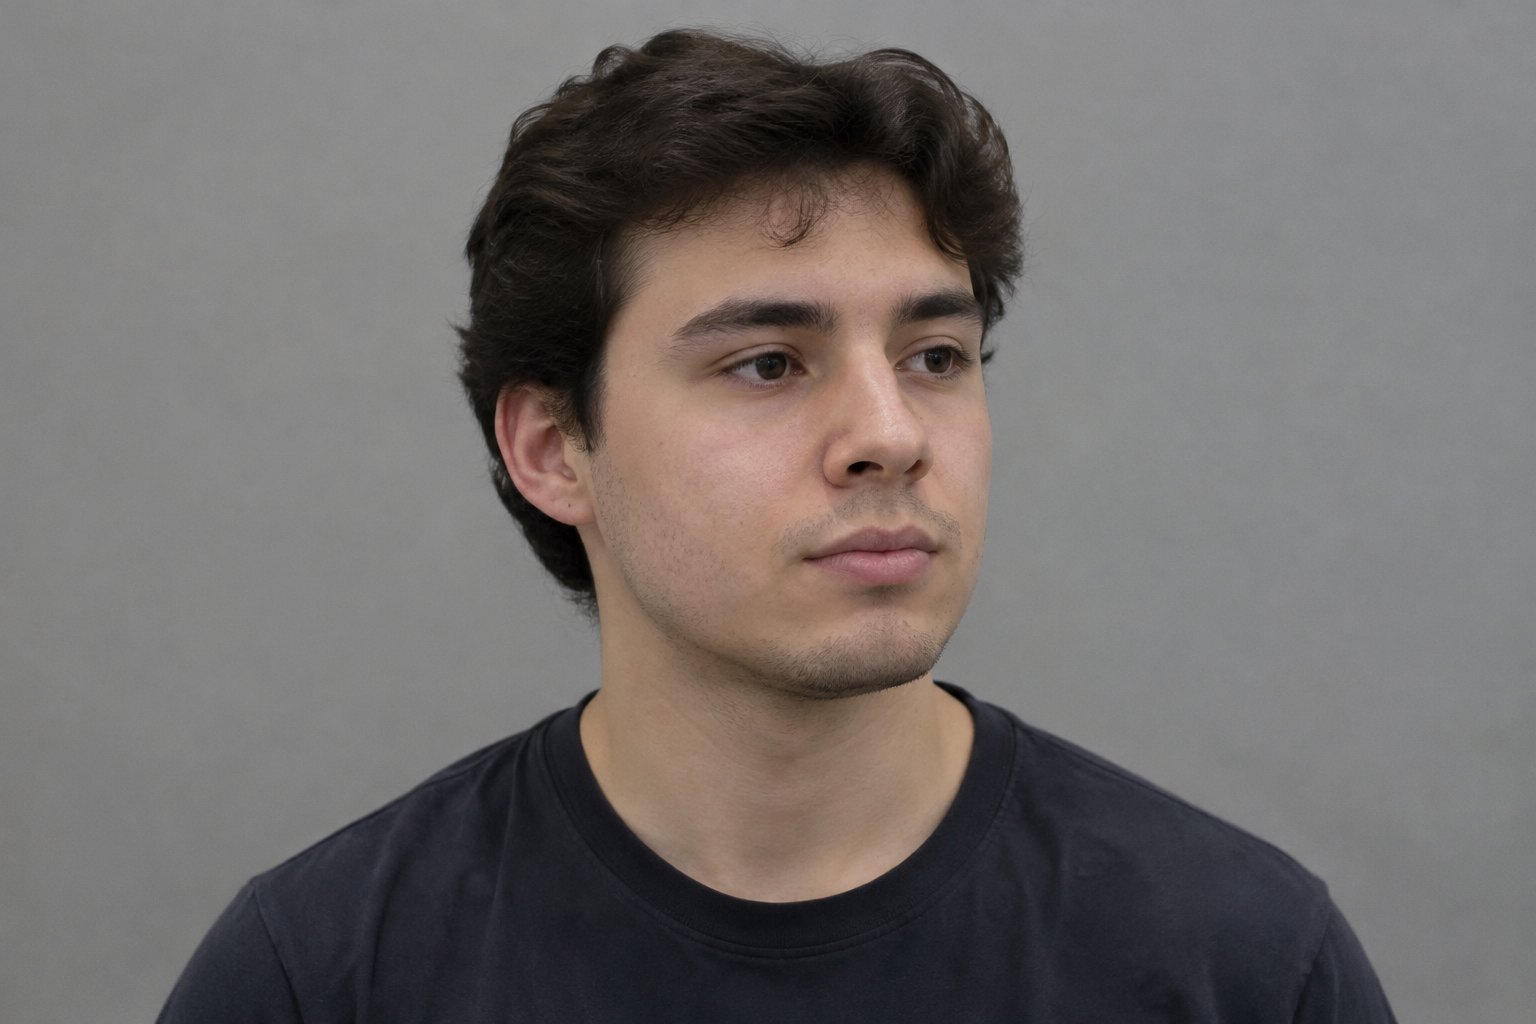
Eingabebild
Prompt
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
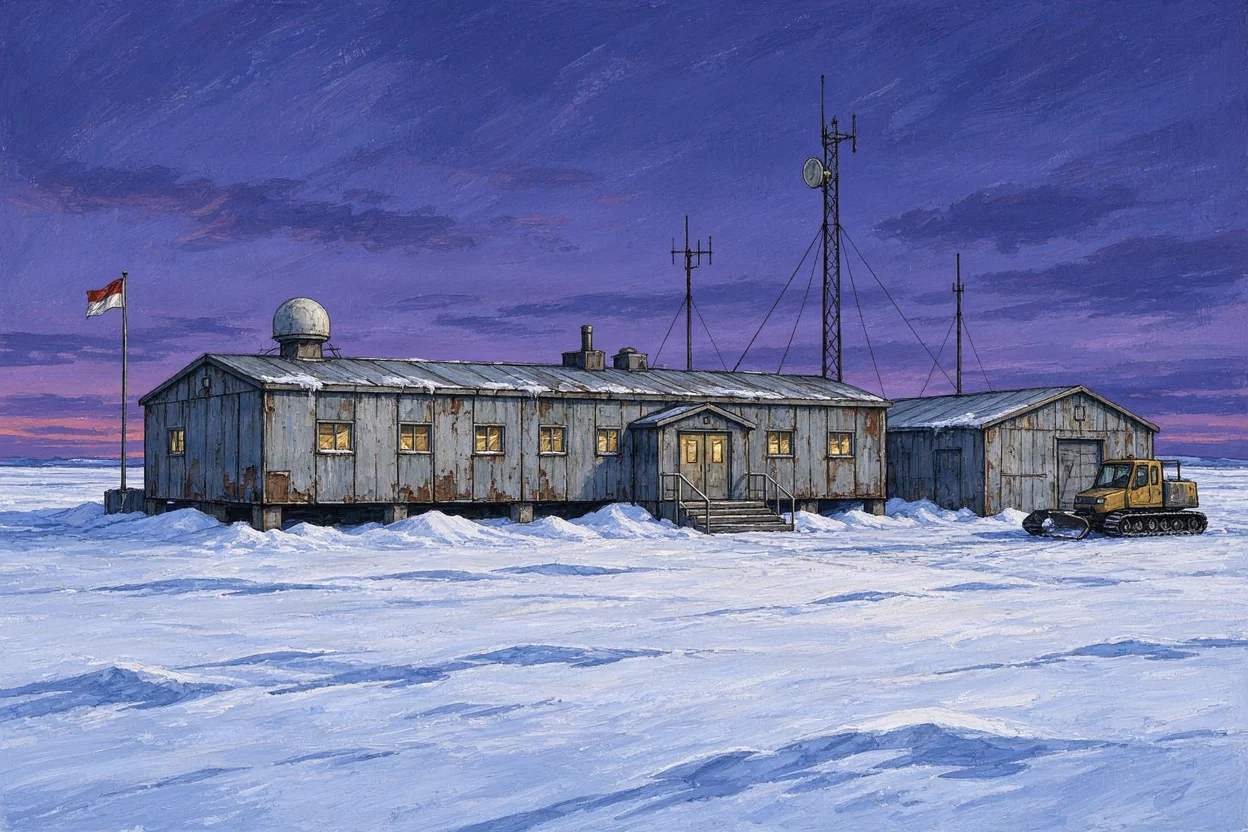
Polarforschungsstation · Konzeptbild der Eiswüsten-Welt
Stil Science-Fiction · Umgebungskonzept · Atmosphäre
Referenz-Eingaben
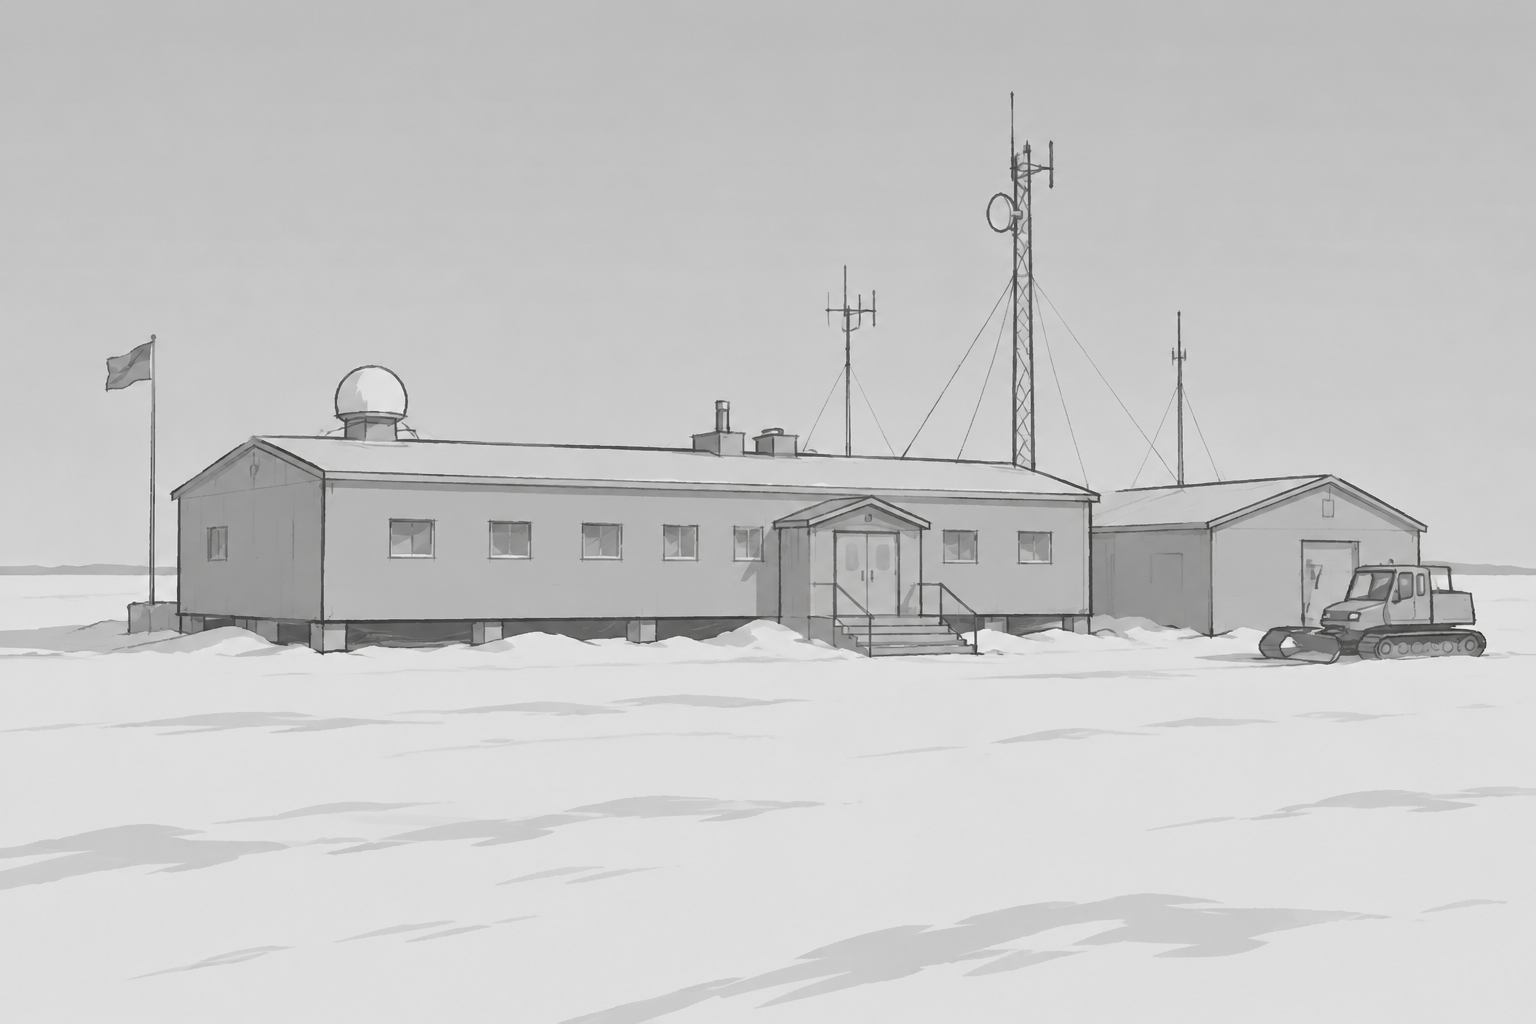
Eingabebild
Prompt
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
fibo-2.0/image-to-image per image
| Einzelpreis | $0.0572 |
|---|
Positionierung und Kurzprofil
Dieses Bild-zu-Bild-Modell unterstützt die Bearbeitung oder Komposition eines Bildes auf Basis eines zu bearbeitenden Bildes zusammen mit bis zu drei Referenzbildern und natürlichsprachlichen Anweisungen. Der Prompt umfasst maximal 10000 Zeichen; mit Platzhaltern wie <image_1> lassen sich die Eingabebilder referenzieren. Die Ausgabe hat etwa eine Million Pixel, und das Seitenverhältnis kann aus einundzwanzig Voreinstellungen gewählt werden. Geeignet ist es für Designer und Entwickler, die Bilder anweisungsgemäß gezielt anpassen, mehrere Materialien fusionieren und das Kompositionsverhältnis steuern möchten – etwa für Konzeptiterationen oder die Erstellung von Marketingmaterial.
Kernhighlights
- Anweisungsgesteuerte Bearbeitung und Komposition mehrerer Bilder – Ein zu bearbeitendes Bild bildet die Grundlage, bis zu drei Referenzbilder können ergänzt und per Platzhalter in der Anweisung referenziert werden, um lokale Änderungen oder die Fusion mehrerer Bilder zu erreichen.
- Flexibel wählbare Ausgabeverhältnisse – Es stehen einundzwanzig Seitenverhältnis-Voreinstellungen bereit; bei mehreren Eingabebildern kann das Ausgabeverhältnis nach Bedarf festgelegt werden, bei der Bearbeitung eines einzelnen Bildes bleibt das Originalverhältnis erhalten.
- Reproduzierbare Ergebnisse durch Seed-Steuerung – Wird ein zufälliger Seed zwischen 0 und 2147483647 übergeben, führen gleicher Seed und gleiche Eingaben zu identischen Ergebnissen, was A/B-Vergleiche erleichtert.
- Masken begrenzen den lokalen Bearbeitungsbereich – Optional kann ein Maskenbild den Bearbeitungsbereich festlegen: Weiße Bereiche werden geändert, schwarze Bereiche bleiben erhalten; dies gilt nur für die Bearbeitung eines einzelnen Bildes, und die Maske muss dieselbe Größe wie das Originalbild haben.
Fähigkeiten
Anweisungsgesteuerte Bearbeitung und Komposition mehrerer Bilder: Es werden 1 bis 4 öffentliche Bild-URLs eingegeben; das erste Bild ist das zu bearbeitende Bild, die übrigen bis zu drei Bilder sind Referenzbilder. In der Anweisung lassen sich die Bilder der Reihenfolge nach mit <image_1>, <image_2> usw. referenzieren, um lokale Änderungen oder die Fusion von Elementen über Bilder hinweg umzusetzen.
Lokale Änderungen mit Maskenvorgabe: Wird ein Maskenbild bereitgestellt, ist nur die Bearbeitung eines einzelnen Bildes zulässig (image_urls darf nur 1 Bild enthalten); weiße Bereiche sind zu ändernde Bereiche, schwarze Bereiche bleiben erhalten. Die Maskengröße muss mit dem Originalbild übereinstimmen; geeignet für präzises lokales Ersetzen.
Ausgabeverhältnis nach Bedarf festlegen: Bei mehreren Eingabebildern kann das Ausgabeseitenverhältnis aus 1:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 16:10, 10:16, 2:1, 1:2, 21:9, 9:21, 3:1, 1:3, 4:1, 1:4, 5:1, 1:5 gewählt werden; bei der Bearbeitung eines einzelnen Bildes bleibt stets das Originalverhältnis erhalten.
Ausreichende Zeichenkapazität für Anweisungen: Der Prompt umfasst maximal 10000 Zeichen, sodass Änderungswünsche ausführlich beschrieben und mehrere Eingabematerialien über Bildplatzhalter referenziert werden können – ideal für komplexe Bearbeitungsanweisungen.
Reproduzierbare Bearbeitungsergebnisse durch Seed: Über den seed-Parameter wird ein zufälliger Seed fixiert; gleicher Seed und gleiche Eingaben reproduzieren dasselbe Ergebnis, was Parametervergleiche oder Versionsrückverfolgung bei derselben Bearbeitungsaufgabe erleichtert.
Anwendungsszenarien
- Gezielte Anpassung von Konzeptbildern durch Designer – Ein Konzeptdesign wird eingegeben und mit einer Änderungsanweisung versehen, die zu ändernde lokale Bereiche oder Eigenschaften benennt; das geänderte Bild dient der Iteration von Entwürfen und der Präsentation im Review.
- Komposition mehrerer Bilder im E-Commerce – Ein Produktbild dient als Hauptbild, ergänzt um bis zu drei Szenen- oder Stilreferenzbilder; per Anweisung werden Lifestyle-Szenenbilder für Produktdetailseiten oder Werbematerial fusioniert.
- Anpassung des Formats für Marketingmaterial – Bei mehreren Eingabebildern werden Ausgabeverhältnisse wie 1:1, 16:9 oder 9:16 festgelegt, um schnell Marketing-Standbilder für verschiedene Platzierungen zu erzeugen und Nachbearbeitung durch Zuschneiden zu reduzieren.
- Präzises lokales Ersetzen per Maske – Für ein einzelnes Bild wird eine Maske bereitgestellt, sodass nur die weiß markierten Bereiche geändert und die übrigen Bildinhalte erhalten bleiben; geeignet zum Ersetzen von Produktdetails oder zum Entfernen unerwünschter Elemente.
Einschränkungen und Auswahlhinweise
Pro Anfrage können maximal 4 Bilder eingegeben werden; bei der Bearbeitung eines einzelnen Bildes mit Maske wird nur 1 Bild unterstützt, und die Maskengröße muss mit dem Originalbild übereinstimmen. Der Prompt umfasst höchstens 10000 Zeichen; bei Überschreitung kann nicht abgesendet werden. Das Ausgabeseitenverhältnis kann nur aus den 21 voreingestellten Verhältnissen gewählt werden; bei der Bearbeitung eines einzelnen Bildes wird fest das Originalverhältnis übernommen und kann nicht anderweitig festgelegt werden. Der Seed garantiert lediglich die Reproduzierbarkeit bei gleichen Eingaben, nicht die Ergebnisgleichheit über verschiedene Parameterkombinationen hinweg.
Neuigkeiten
Changelog ansehen →- Neues Modell FIBO 2.0 Bildbearbeitung veröffentlicht
- Neues Modell FIBO 2.0 Text-zu-Bild ist live
Häufige Fragen
Alle Fragen ansehen →-
Wie stelle ich es ein, um eine feste Komposition und dasselbe Bild zu reproduzieren?
Mit festem Seed und unverändertem Prompt lässt sich dasselbe Ergebnis reproduzieren. Der Seed ist standardmäßig 5555 und reicht von 0 bis 2147483647; solange Seed und Prompt identisch sind, ist auch die Ausgabe identisch – ein anderer Seed ergibt beim selben Motiv eine andere Bildkomposition.
-
Welche Seitenverhältnisse sind wählbar? Wie hoch ist die Auflösung?
Wähle je nach Bildkomposition ein Seitenverhältnis aus den Presets; die Ausgabe beträgt etwa 1 Megapixel. Verfügbare Werte sind unter anderem 1:1, 2:3, 3:2, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 16:10, 10:16, 2:1, 1:2, 21:9, 9:21 sowie Langformate wie 3:1, 1:3, 4:1, 1:4, 5:1, 1:5; ohne Angabe gilt standardmäßig 1:1.
-
Können bei der Text-zu-Bild-Generierung Referenzbild und Stilvorgabe zusammen verwendet werden?
Beides kann nicht gleichzeitig verwendet werden, es ist nur eines von beiden möglich. Wenn bei der Text-zu-Bild-Generierung style übergeben wird, darf image_url nicht mehr übergeben werden und umgekehrt; wer ein Referenzbild zur Festlegung der Szene möchte, verzichtet auf die Stilvorgabe, und wer Film-, Hartblitz-, Dunst- oder grobkörnige Echtheitswirkung möchte, verwendet nur Text-Prompts. Bei der Bild-zu-Bild-Bearbeitung gibt es keinen Parameter für Stilvorgaben; die Bildstimmung wird direkt in instruction geschrieben.
-
Welche fotografischen Stilvoreinstellungen sind bei der Text-zu-Bild-Generierung verfügbar?
Bei der Text-zu-Bild-Generierung stehen vier fotografische Anmutungen zur Verfügung: Kodak Film, Hard Flash, Hazy Dreamy und Rough Realism. Sie dienen lediglich als optionaler Gesamtton der Fotografie und schließen sich gegenseitig mit dem Referenzbild aus; wenn Lichtführung und Kameraposition präzise gesteuert werden sollen, sollten diese weiterhin im Prompt ausdrücklich angegeben werden, statt sich nur auf die Voreinstellung zu verlassen. Bei der Bild-zu-Bild-Bearbeitung gibt es keine Stilvoreinstellungen.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: fibo-2.0/image-to-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für fibo-2.0/image-to-image und Route default — siehe Parametertabelle unten.
seedintegerOptionalStandard: 5555min 0max 2147483647Zufälliger Seed, Standardwert 5555. Gleicher Seed und gleiche Eingabe erzeugen reproduzierbar identische Ergebnisse.
mask_urlstringOptionalminLength 1pattern ^https?://Optionale Maskenbild-URL, nur Einzelbildbearbeitung wird unterstützt, d. h. image_urls muss genau 1 Bild enthalten; weiße Bereiche sind die zu bearbeitenden Teile, schwarze Bereiche bleiben unverändert, und die Maskengröße muss mit dem Bild übereinstimmen.
image_urlsarrayPflichtminItems 1maxItems 4Array von Bild-URLs mit 1–4 öffentlichen Bildadressen: Das erste Bild ist das zu bearbeitende Bild, bis zu 3 weitere dienen als Referenzbilder; in der Anweisung kann in dieser Reihenfolge mit <image_1>, <image_2> usw. darauf verwiesen werden.
Array [ string ]
instructionstringPflichtminLength 1maxLength 10000Textanweisung für die am Bild vorzunehmenden inhaltlichen Änderungen.
aspect_ratiostringOptionalAusgabe-Seitenverhältnis, ca. eine Million Pixel; wenn weggelassen, wird das erste Bild übernommen, bei der Einzelbildbearbeitung bleibt stets das Seitenverhältnis dieses Bildes erhalten.
1:12:33:23:44:34:55:49:16Alle anzeigen (13)Weniger anzeigen
16:916:1010:162:11:221:99:213:11:34:11:45:11:5callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "fibo-2.0/image-to-image",
  "input": {
    "seed": 5555,
    "image_urls": "…",
    "instruction": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "fibo-2.0/image-to-image",
input: {
"seed": 5555,
"image_urls": "…",
"instruction": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "fibo-2.0/image-to-image",
"input": {
"seed": 5555,
"image_urls": "…",
"instruction": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Imagen 4 Google $0.030 /Bild
-
 Krea 3 Krea $0.036 /Bild
-
 Qwen Image 3.0 Alibaba $0.036 /Bild
-
 Ideogram V3 Character Ideogram $0.090 /Bild
-
 Nano Banana Pro Google $0.029 /Bild
-
 Qwen Image 2.1 Alibaba $0.020 /Bild
-
 FLUX.2 Black Forest Labs $0.035 /Bild
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /Bild
-
 Nano Banana Google $0.011 /Bild
-
 Grok Imagine Quality xAI $0.070 /Bild
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /Bild
-
 Seedream 5.5 ByteDance $0.019 /Bild