ByteDance
OmniHuman 2.0
omnihuman-2.0
Modelo de video de avatar digital de segunda generación de ByteDance: con una sola imagen de una persona o personaje y una pista de voz o canto, genera un video de actuación en el que la sincronización labial, las expresiones faciales y los movimientos corporales acompañan al audio; el plano continuo más largo por generación es de 5 minutos y se pueden añadir prompts para controlar las acciones y el movimiento de cámara
Probar omnihuman-2.0
Entrada
Creaciones
Ver todas las creacionesSalida
videoMonólogo a cámara de un vendedor de mercadillo nocturno
Estilo retrato-avatar · Comida callejera · sincronización labial
Entradas de referencia
Audio de entrada
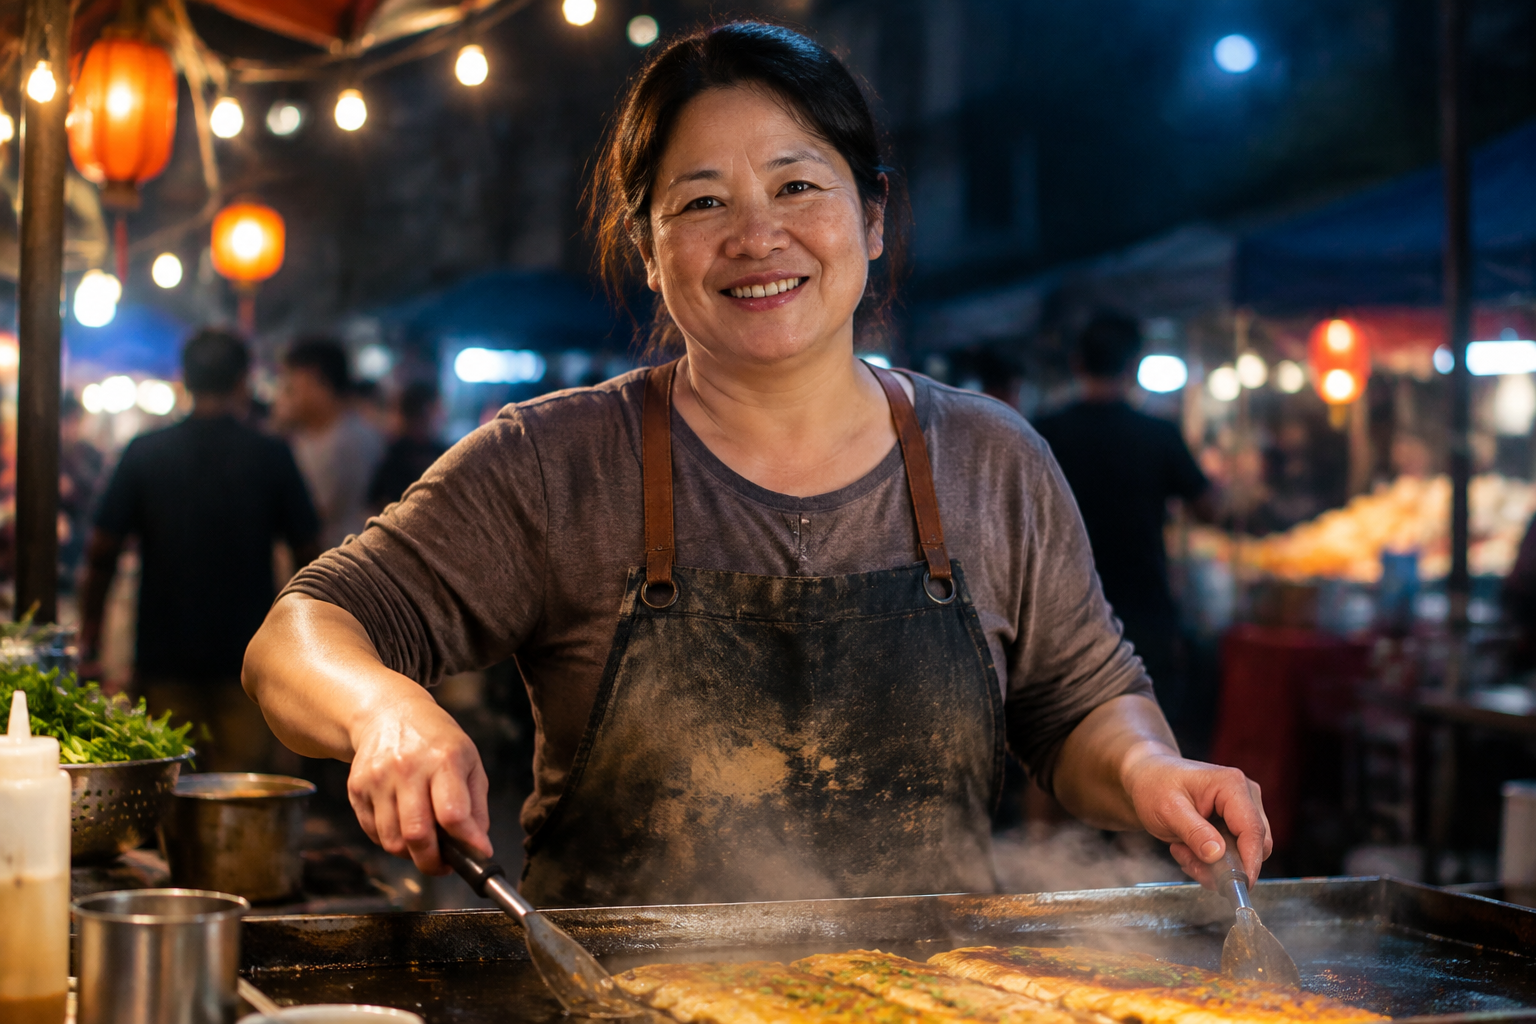
Imagen de personaje
Prompt
En un mercadillo nocturno, un vendedor ambulante de comida con el delantal manchado de harina está de pie detrás de una plancha humeante, hablando hacia la cámara con una sonrisa cálida, natural y cercana, y hace un pequeño gesto para enfatizar sus palabras; detrás de él cuelgan luces de guirnalda y el vapor se desplaza lentamente; la cámara se acerca lenta y suavemente.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Explicación de conocimientos frente a la estantería · Presentación digital
Estilo Locución · Educación · Retrato de estudio
Entradas de referencia
Audio de entrada
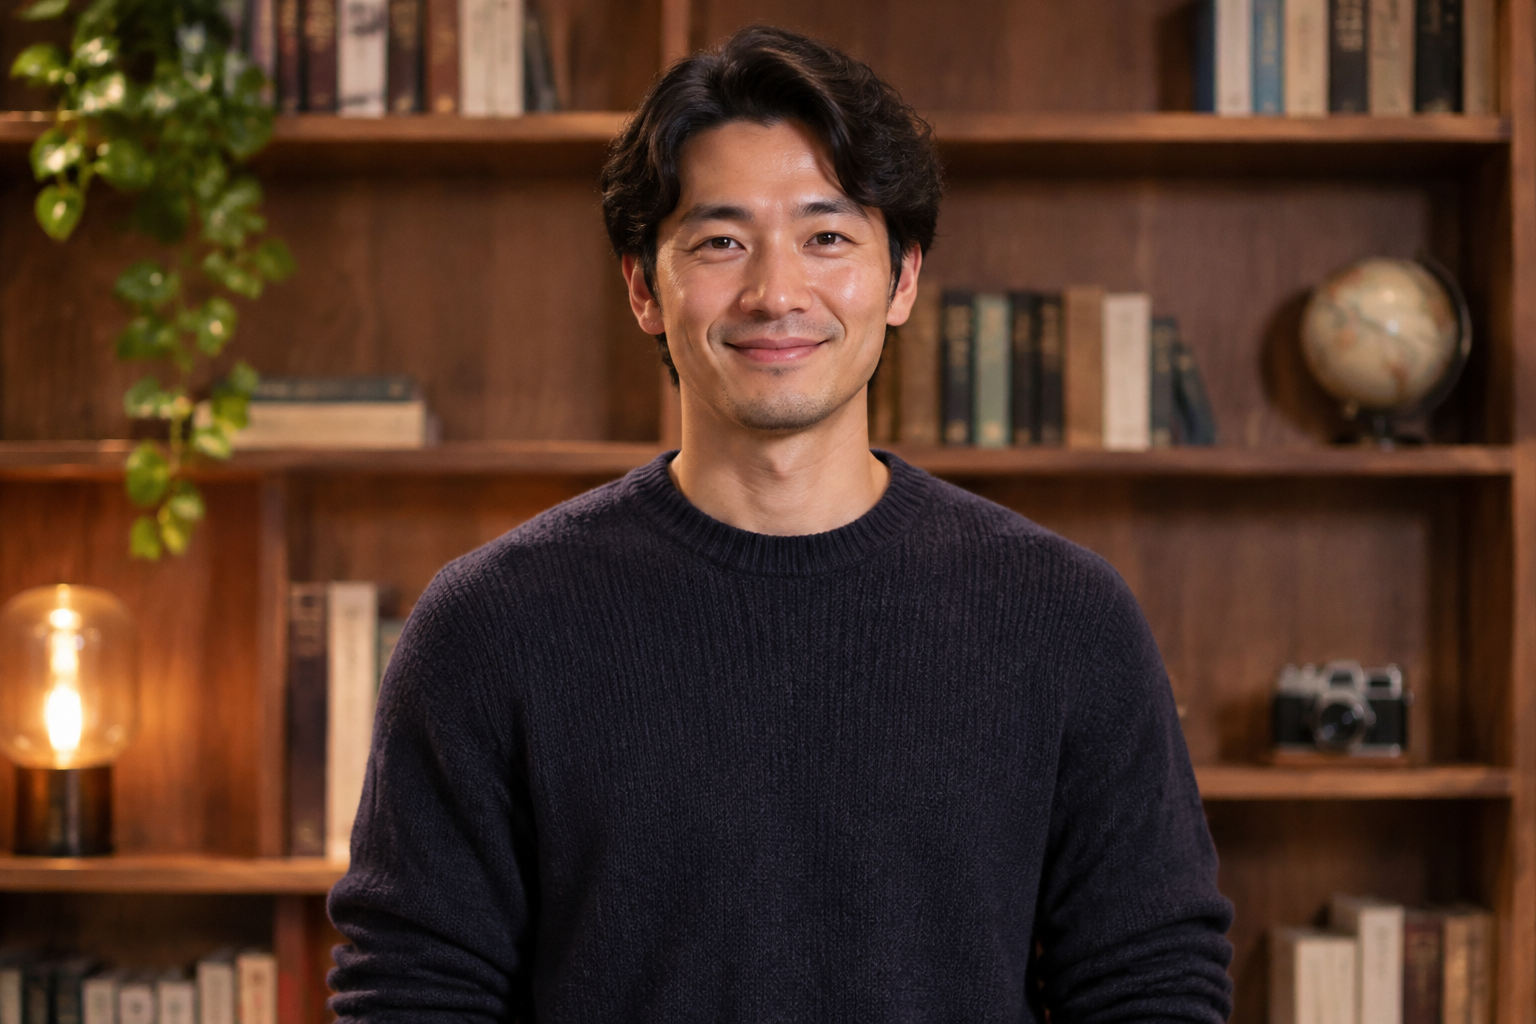
Imagen de personaje
Prompt
Una presentadora de aspecto sereno, vestida con un suéter de punto oscuro, está de pie frente a una cálida estantería de madera hablando a cámara; el movimiento de sus labios es natural, sus gestos son discretos, la cámara avanza lentamente desde un plano medio hacia un encuadre más cercano, con una luz principal suave y cálida.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Estudio nocturno · Presentadora digital en locución
Estilo Difusión · Locución · Cinematográfico
Entradas de referencia
Audio de entrada
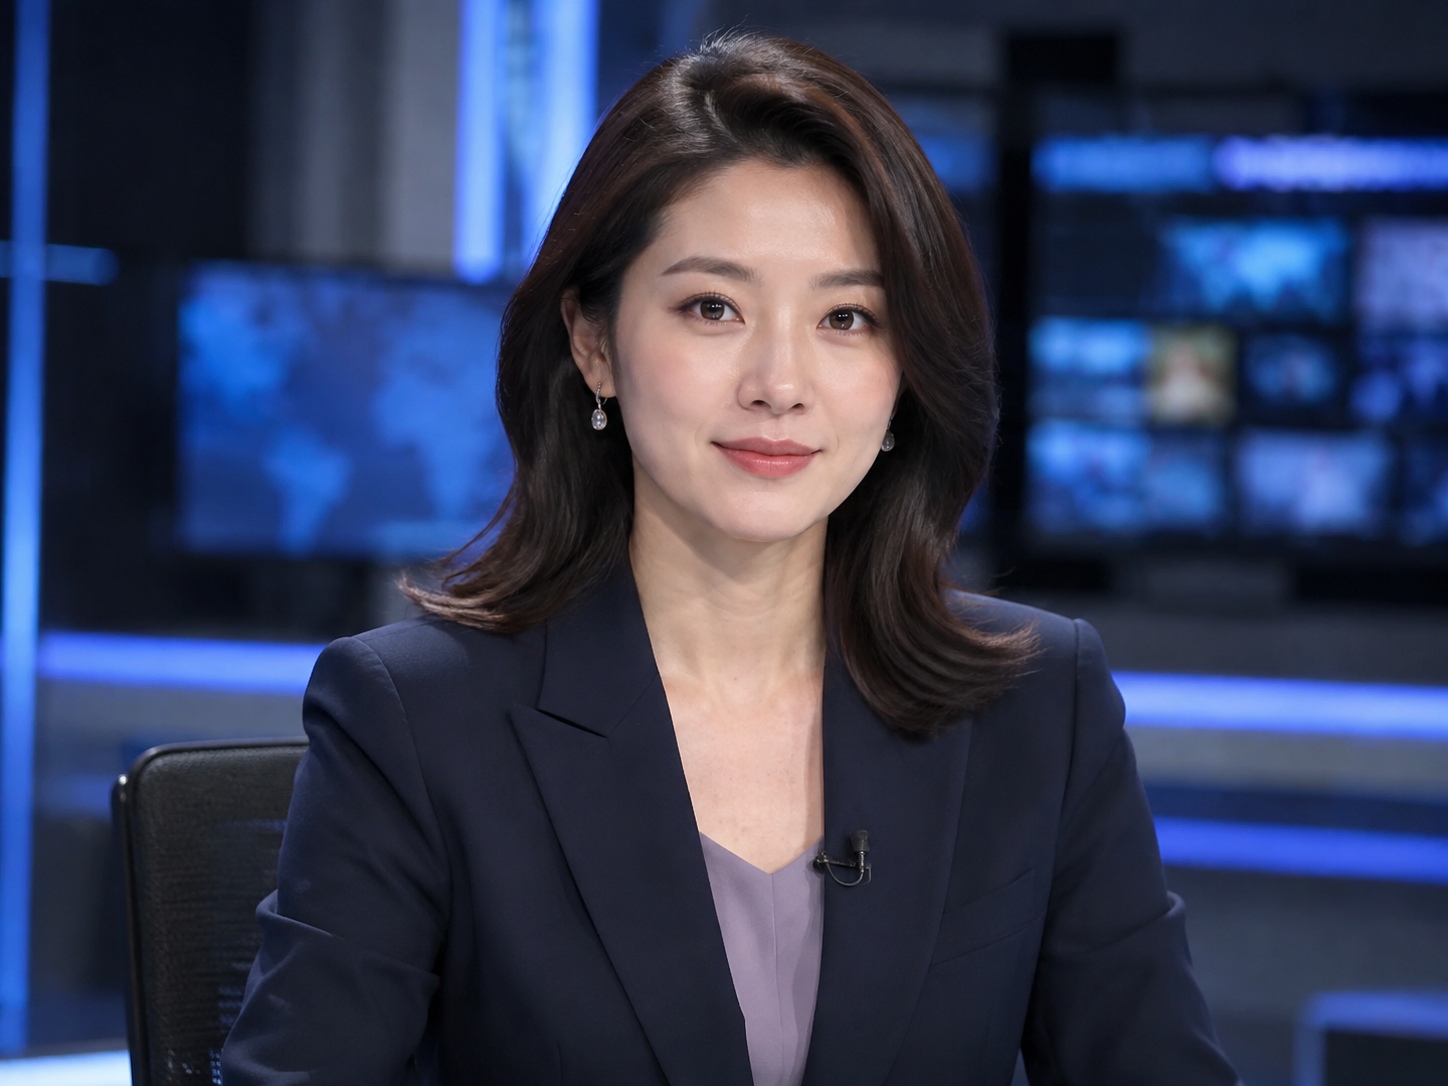
Imagen de personaje
Prompt
La cámara se acerca lentamente a una presentadora serena que habla sentada junto a la mesa de un estudio tenue; a medida que su tono se vuelve melancólico, asiente suavemente y su expresión se dulcifica; iluminación de estudio en azul frío y ámbar, con una nítida calidad de difusión.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
omnihuman-2.0 per second
| Precio unitario | $0.100 |
|---|
Descripción general
Este es un modelo de generación de vídeo de personajes digitales impulsado por audio: recibe una imagen de una persona real o de un personaje ilustrado y una pista de voz o canto, y produce un vídeo de actuación sincronizado con el audio. La duración del vídeo sigue al audio y la imagen mantiene la relación de aspecto de la imagen original; opcionalmente se puede usar un prompt para describir la escena, las expresiones, los gestos y el movimiento de cámara. Está pensado para desarrolladores y creadores de contenido que necesitan tomas de personajes hablando a cámara, cantando o dialogando, y se emplea en vídeos cortos para redes sociales, en la imagen de marca publicitaria y en material de actuación de personajes para aplicaciones de humanos digitales.
Aspectos destacados
- Sincronización de labios y expresiones impulsada por audio: genera labios, expresiones y movimientos corporales acordes con el ritmo y el tono de la voz y del canto, y la duración del vídeo coincide con la del audio.
- De imagen a vídeo manteniendo la proporción original: basta con subir una imagen del personaje para generar un vídeo de actuación; el resultado conserva la relación de aspecto de la imagen, lo que facilita insertarlo directamente en maquetas existentes.
- Control de la actuación y del movimiento de cámara mediante prompt: un prompt opcional permite describir la escena, las expresiones, los gestos y efectos de cámara como un lento acercamiento.
- Un solo audio cubre varios minutos de actuación: el audio de entrada admite de 4 a 300 segundos, y el vídeo puede prolongarse según el audio, lo que resulta idóneo para fragmentos continuos de locución o canto.
Capacidades
Generación de vídeo de personaje a partir de imagen y audio: con una imagen del personaje y un audio de entrada se genera un vídeo en el que ese personaje actúa; la imagen puede ser de una persona real o de un personaje ilustrado, y la salida conserva la relación de aspecto de la imagen original.
Actuación con sincronización labial: el vídeo genera los labios y las expresiones faciales correspondientes al ritmo de la voz o del canto de entrada, adecuado para material de narración, diálogo y canto, y la duración del vídeo coincide con la del audio.
Control de la actuación y de la cámara mediante prompt: el prompt opcional admite hasta 300 caracteres y sirve para describir la escena, las expresiones, los gestos y el movimiento de cámara.
Rango de duración del audio: el audio de entrada debe ser mp3 o wav, con una duración de 4 a 300 segundos y no superior a 15 MB; la duración del vídeo se corresponde con la del audio, lo que facilita planificar actuaciones continuas extensas.
Rango de especificaciones de la imagen: la imagen del personaje admite jpeg, png o webp, no supera los 10 MB, tiene una relación de aspecto entre 0,4 y 2,5 y entre 300 y 6000 píxeles por lado.
Casos de uso
- Creadores de vídeos de locución para redes sociales: suben un retrato del presentador y un audio explicativo, generan un vídeo del personaje hablando a cámara y lo usan directamente para publicar vídeos cortos en plataformas sociales y actualizar la cuenta a diario.
- Actuaciones musicales y de canto virtual: con imágenes de cantantes o de avatares virtuales junto con el audio de una canción, se producen imágenes del personaje cantando como material de actuación para contenidos musicales.
- Vídeos cortos de embajadores de marca: con una imagen de la imagen de marca y la locución de un texto promocional, se generan vídeos cortos del embajador o presentador en pantalla para mostrarlos en anuncios y páginas de campañas.
- Desarrolladores de aplicaciones de humanos digitales: integran la interfaz para enviar por lotes imágenes de personajes y audios, y ofrecen a las aplicaciones de creación de vídeo fragmentos de humanos digitales en pantalla para generar tomas de recurso o de diálogo.
Limitaciones y recomendaciones de selección
El audio de entrada es obligatorio: el contenido del vídeo se rige por el audio y además hay que proporcionar la imagen del personaje; la duración del audio de entrada debe estar entre 4 y 300 segundos, y las tareas de menos de 4 segundos fallan y se reembolsan íntegramente. La imagen del personaje debe cumplir los requisitos de formato y tamaño: relación de aspecto entre 0,4 y 2,5 y entre 300 y 6000 píxeles por lado. El prompt es opcional y admite un máximo de 300 caracteres.
Novedades
Ver el registro de cambios →- Nuevo modelo OmniHuman 2.0 disponible: un retrato y un audio para generar un vídeo de una persona hablando de hasta 5 minutos
Preguntas frecuentes
Ver todas las preguntas →-
¿Basta con una sola imagen y una pista de audio para generar un video?
Sí, la entrada de este modelo es una imagen de una persona más una pista de audio de conducción; los únicos campos obligatorios son image_url y audio_url. La imagen admite jpeg, png y webp, con un máximo de 10 MB por archivo, una relación de aspecto entre 0.4 y 2.5, y entre 300 y 6000 píxeles por lado; el audio admite mp3 y wav, con una duración de 4 a 300 segundos y un máximo de 15 MB. El contenido del video se genera a partir del audio, su duración coincide con la del audio y el resultado final conserva la relación de aspecto de la imagen.
-
¿Qué duración puede tener el vídeo de humano digital que se puede generar?
La duración máxima de un plano continuo es de 5 minutos, lo que corresponde a un límite de audio de 300 segundos, sin necesidad de dividir y empalmar segmentos. La duración mínima del audio es de 4 segundos; las tareas con menos de 4 segundos fallarán y se reembolsarán en su totalidad. Si deseas una actuación continua de larga duración, envía la narración o el diálogo completo en un solo archivo de audio; es más sencillo que generar por segmentos y luego empalmarlos, y también es menos propenso a saltos de sincronización labial y de expresiones en las uniones.
-
¿Cuál es la resolución de salida? ¿Puede generar 1080p?
Este modelo no tiene parámetro de resolución, por lo que no se puede especificar 1080p. El formato y la resolución del vídeo final siguen a la imagen de retrato de entrada; por ejemplo, un retrato de 960×960 dará como resultado un vídeo de 960×960, y tanto el material vertical como el horizontal se pueden usar directamente. Para que el vídeo final sea más nítido, utilice una imagen de retrato nítida y con una composición limpia, además de un audio limpio.
-
¿Hay que usar modelos distintos para la narración, el canto y el diálogo?
No es necesario: un mismo modelo cubre las tres categorías de audio (narración, canto y diálogo), no existe un modo de canto independiente. Su sincronización labial, sus expresiones faciales y sus movimientos corporales cambian de forma sincronizada siguiendo el tono, el ritmo, la emoción y la semántica del audio; para cambiar de tipo de audio basta con cambiar el propio audio. Esta es también la principal diferencia en expresividad respecto a las herramientas anteriores que solo hacían alineación labial.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: omnihuman-2.0
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para omnihuman-2.0 y la ruta default; consulta la tabla de parámetros a continuación.
promptstringOpcionalmaxLength 300Parámetro opcional que describe la escena, las expresiones, los gestos y los movimientos de cámara, por ejemplo, asentir con la cabeza mientras se sonríe o un acercamiento lento.
audio_urlstringObligatorioDirección del audio de voz o canto utilizado para sincronizar los labios; la duración del vídeo es igual a la del audio, la duración del audio debe ser de 4 a 300 segundos, el formato debe ser mp3 o wav y el tamaño no debe superar los 15 MB.
image_urlstringObligatorioDirección de la imagen del retrato de la persona que se va a animar, puede ser una persona real o un personaje ilustrado; admite formatos jpeg, png y webp, con un tamaño no superior a 10 MB, una relación de aspecto entre 0,4 y 2,5, y entre 300 y 6000 píxeles por lado; el vídeo de salida conserva la relación de aspecto y la resolución de esta imagen.
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "omnihuman-2.0",
  "input": {
    "audio_url": "…",
    "image_url": "…"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "omnihuman-2.0",
input: {
"audio_url": "…",
"image_url": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "omnihuman-2.0",
"input": {
"audio_url": "…",
"image_url": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 Wan 2.6 Flash Alibaba $0.043 /segundo
-
 Hailuo 2.3 MiniMax $0.270 /vídeo
-
 Runway Gen 4.5 Runway $0.172 /segundo
-
 PixVerse V6 Max PixVerse $0.030 /segundo
-
 Grok Imagine 1.5 xAI $0.011 /segundo
-
 Muse Video 1.0 Meta $0.034 /vídeo
-
 HeyGen Avatar V HeyGen $0.150 /segundo
-
 Kling 3.0 Kuaishou $0.100 /segundo
-
 LTX 2.5 Fast Lightricks $0.086 /segundo
-
 Ray 3.2 Luma $0.214 /vídeo
-
 Creatify Boreal Creatify $0.015 /segundo
-
 Kling 2.5 Kuaishou $0.090 /segundo