
Gemini Omni 1.1 Flash
gemini-omni-1.1-flash
Modelo multimodal para generación y edición de video: una única interfaz cubre texto a video, imagen a video, referencia de imagen a video y edición de video, con salida por capas desde borrador hasta 4K e incluye pista de audio propia
Probar gemini-omni-1.1-flash
Entrada
Creaciones
Ver todas las creacionesSalida
videoNotas visuales del lenguaje de cámara: esquemas de movimiento de cámara a partir de un fotograma inicial
Estilo Movimiento de cámara · Guion gráfico · film-grammar
Entradas de referencia
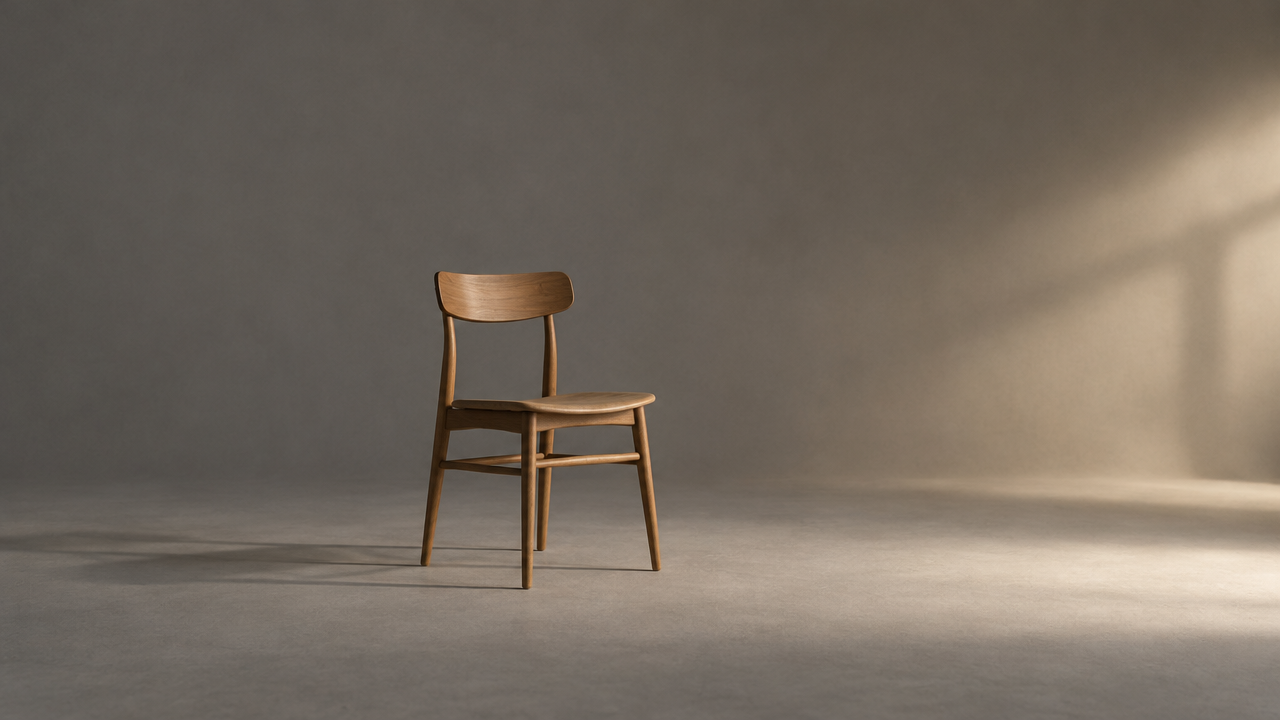
first_frame_url
Prompt
Demostración de un único plano continuo en un estudio moderno y minimalista, con una silla de madera solitaria como sujeto filmado, luz lateral cálida con atenuación suave y una paleta neutra de tonos suaves. El plano comienza con una composición de gran angular y plano general, avanza hacia la silla con un travelling lento y constante, y termina con una composición de plano medio corto; movimiento de cámara estable como de estabilizador, sin cortes, sin zooms repentinos, con el sujeto y la geometría del decorado siempre coherentes, poca profundidad de campo al final del movimiento, partículas de polvo tenues en los haces de luz, grano cinematográfico, composición 16:9, estética de storyboard didáctico.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
gemini-omni-1.1-flash per video
Descripción general
Gemini Omni 1.1 Flash es un modelo multimodal de Google presentado para escenarios de generación y edición de vídeo, que se invoca en HiAPI.ai a través de una interfaz unificada. En una misma vía cubre texto a vídeo, imagen a vídeo, referencia de imagen a vídeo y edición de vídeo, y puede modificar clips existentes mediante instrucciones en lenguaje natural, prolongar escenas y controlar el movimiento de cámara y las transiciones con el primer y el último fotograma. Ofrece una duración de salida de 4 a 10 segundos y una resolución seleccionable de 360p a 4k, lo que lo hace idóneo para desarrolladores y equipos de contenido que necesitan generar borradores con alta frecuencia, iterar en varias rondas y unificar los flujos de generación y edición.
Puntos clave
- Generación y edición unificadas en el mismo modelo: la generación desde texto, desde imagen, desde referencia y la edición de vídeo comparten una única ruta de invocación, lo que reduce el coste de alternar entre varios modelos.
- Flujo por etapas desde borrador de baja resolución hasta 4K: primero se puede iterar rápidamente con 360p para tantear el resultado y, tras confirmar la dirección, producir en 720p, 1080p o 4k, equilibrando eficiencia y calidad final.
- Control del movimiento de cámara mediante el primer y el último fotograma: basta con establecer las imágenes del primer y del último fotograma para acotar la trayectoria de cámara y las transiciones, lo que hace más controlable el movimiento de los fragmentos narrativos.
- Materiales de referencia que participan en la generación: se pueden pasar hasta 7 imágenes como referencia, y la entrada de vídeo es mutuamente excluyente con la configuración del primer fotograma, con límites de entrada bien definidos.
Descripción de capacidades
Múltiples modos de generación de vídeo: admite cuatro tipos de tarea (texto a vídeo, imagen a vídeo, referencia de imagen a vídeo y vídeo a vídeo); el desarrollador elige la modalidad de entrada según los materiales disponibles y la salida es siempre un recurso de vídeo.
Edición de vídeo en lenguaje natural: basta con describir la intención de modificación mediante un prompt para repintar y ajustar un vídeo existente, sin necesidad de reconstruir todo el flujo de generación.
Prolongación de escenas: al pasar un clip de vídeo existente como entrada, se puede continuar el contenido sobre él para construir una narración continua más larga.
Restricción de cámara mediante el primer y el último fotograma: el uso conjunto de first_frame_url y last_frame_url fija las imágenes de inicio y fin, y controla el movimiento de cámara y el ritmo de las transiciones.
Resolución y formato seleccionables: la resolución admite 360p, 720p, 1080p y 4k, y el formato admite 16:9 y 9:16, lo que facilita la adaptación a publicaciones en horizontal y vertical.
Casos de uso
- Borradores de vídeo rápidos para equipos creativos: a partir de un guion o de la imagen del primer fotograma, generar rápidamente varias versiones de borrador en baja resolución de 360p para la revisión del guion y la selección de la dirección.
- Producción de publicidad y contenido social: generar clips en 16:9 o 9:16 con imágenes de referencia y un prompt y, tras confirmarlos, ampliarlos a alta resolución para el material de publicación.
- Modificación y continuación de material existente: tomar un vídeo ya existente como entrada y modificar la imagen o prolongar el clip con instrucciones en lenguaje natural, para ajustes de posproducción del resultado final.
- Fragmentos narrativos que requieren transiciones precisas: fijar el inicio y el fin con el primer y el último fotograma para producir fragmentos cinematográficos con movimiento controlado, destinados a la previsualización de guiones gráficos.
Limitaciones y recomendaciones de elección
El modelo limita cada salida a una duración de 4 a 10 segundos, por lo que el contenido más largo debe generarse por segmentos y ensamblarse después. Los resultados en 360p son más adecuados como borrador y no deberían usarse directamente como resultado final. Al pasar una imagen de primer fotograma no se pueden añadir además entradas de imagen o vídeo, y last_frame_url debe usarse junto con first_frame_url, de modo que existen restricciones en las combinaciones de entrada. El enfoque Flash prioriza la velocidad y la eficiencia de iteración; si la tarea exige una calidad de imagen rigurosa o una duración mayor por segmento, conviene evaluar otros modelos al elegir y guiarse por los resultados de las pruebas reales.
Novedades
Ver el registro de cambios →- Cambio de parámetro Actualizar la documentación de gemini-omni-1.1-flash
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: gemini-omni-1.1-flash
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para gemini-omni-1.1-flash y la ruta default; consulta la tabla de parámetros a continuación.
seedintegerOpcionalmin 0max 2147483647Semilla aleatoria utilizada para controlar la aleatoriedad de los resultados generados; introduzca un número entero para reproducir la misma salida.
promptstringObligatoriominLength 1maxLength 20000Indicación de texto que describe el contenido que se desea generar, en formato de cadena.
durationintegerObligatorioPredeterminado: 8min 4max 10Duración del vídeo generado, valor entero, por defecto 8.
46810image_urlsarrayOpcionalminItems 0maxItems 7Matriz de URL de imágenes de referencia; cada elemento es una cadena con la dirección de una imagen, utilizada para proporcionar entrada de imagen a la generación.
Array [ string ]
resolutionstringOpcionalPredeterminado: "720p"Resolución del vídeo generado, valor de cadena, por defecto 720p.
360p720p1080p4kvideo_listarrayOpcionalmaxItems 1
Matriz de fragmentos de vídeo; cada elemento contiene la dirección del vídeo y los tiempos de inicio y fin, y se utiliza para especificar el intervalo de un vídeo de entrada que se va a utilizar.
Array [ object ]
Elementos del array
urlstringObligatoriominLength 1Dirección del vídeo del elemento de la matriz, valor de cadena, que apunta a un único archivo de vídeo.
endsnumberOpcionalmin 0Tiempo de finalización de ese fragmento de vídeo, valor numérico.
startnumberOpcionalPredeterminado: 0min 0Tiempo de inicio de ese fragmento de vídeo, valor numérico, por defecto 0.
aspect_ratiostringOpcionalPredeterminado: "16:9"Relación de aspecto del vídeo generado, valor de cadena, por defecto 16:9.
16:99:16last_frame_urlstringOpcionalminLength 1URL de la imagen del último fotograma, valor de cadena, que especifica la imagen final del vídeo generado.
first_frame_urlstringOpcionalminLength 1URL de la imagen del primer fotograma, valor de cadena, que especifica la imagen inicial del vídeo generado; es obligatorio cuando se proporciona last_frame_url.
callbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "gemini-omni-1.1-flash",
  "input": {
    "prompt": "…",
    "duration": 8,
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gemini-omni-1.1-flash",
input: {
"prompt": "…",
"duration": 8,
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gemini-omni-1.1-flash",
"input": {
"prompt": "…",
"duration": 8,
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Comparativa
Recraft v4.1 Flash comparativa horizontal de texto a imagen: guía de selección y migración para desarrolladores
Con un coste de $0.01 por imagen y capacidad pura de texto a imagen, evalúa si encaja en tu pipeline de generación de imágenes
-

Comparativa
hailuo-2.3-fast/image-to-video comparativa horizontal: cómo elegir un modelo de imagen a video y puntos clave para migrar
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 MiniMax H3 MiniMax $0.072 /segundo
-
 Seedance 2.5 ByteDance $0.121 /segundo
-
 Gemini Omni Google --
-
 PixVerse V6 PixVerse $0.036 /segundo
-
 Vidu Q4 Preview Vidu $0.051 /segundo
-
 Veo 3.1 Google $0.290 /segundo
-
 HeyGen Avatar IV HeyGen $0.150 /segundo
-
 Veo 3.1 Lite Google $0.060 /segundo
-
 HappyHorse 1.1 Alibaba $0.160 /segundo
-
 Vidu Q3 Vidu $0.149 /segundo
-
 Runway Gen 4.5 Runway $0.172 /segundo
-
 Kling AI Avatar Kuaishou --
Mismo proveedor
-
 Nano Banana Pro Google $0.057 /imagen
-
 Lyria 3.5 Google $0.090 /canción
- Gemini Omni Google --
-
 Nano Banana 2 Lite Google $0.033 /imagen
-
 Veo 3.1 Fast Google $0.170 /segundo
-
 Nano Banana Google $0.021 /imagen
- Veo 3.1 Google $0.290 /segundo
-
 Google Virtual Try-On Google $0.107 /imagen
-
 Lyria 3 Pro Google $0.140 /canción
- Veo 3.1 Lite Google $0.060 /segundo
-
 Nano Banana 2 Google $0.036 /imagen
-
 Gemini 3.1 Flash TTS Google --