
Alibaba
Wan 2.7 Video
wan2.7-video/image-to-video
Modelli di generazione video della serie Alibaba WAN, supportano la generazione di video da testo, da immagine e guidata da riferimenti; input multipli di riferimento mantengono la coerenza di persone e prodotti tra diverse inquadrature
Prova wan2.7-video/image-to-video
Input
Creazioni
Vedi tutte le creazioniOutput
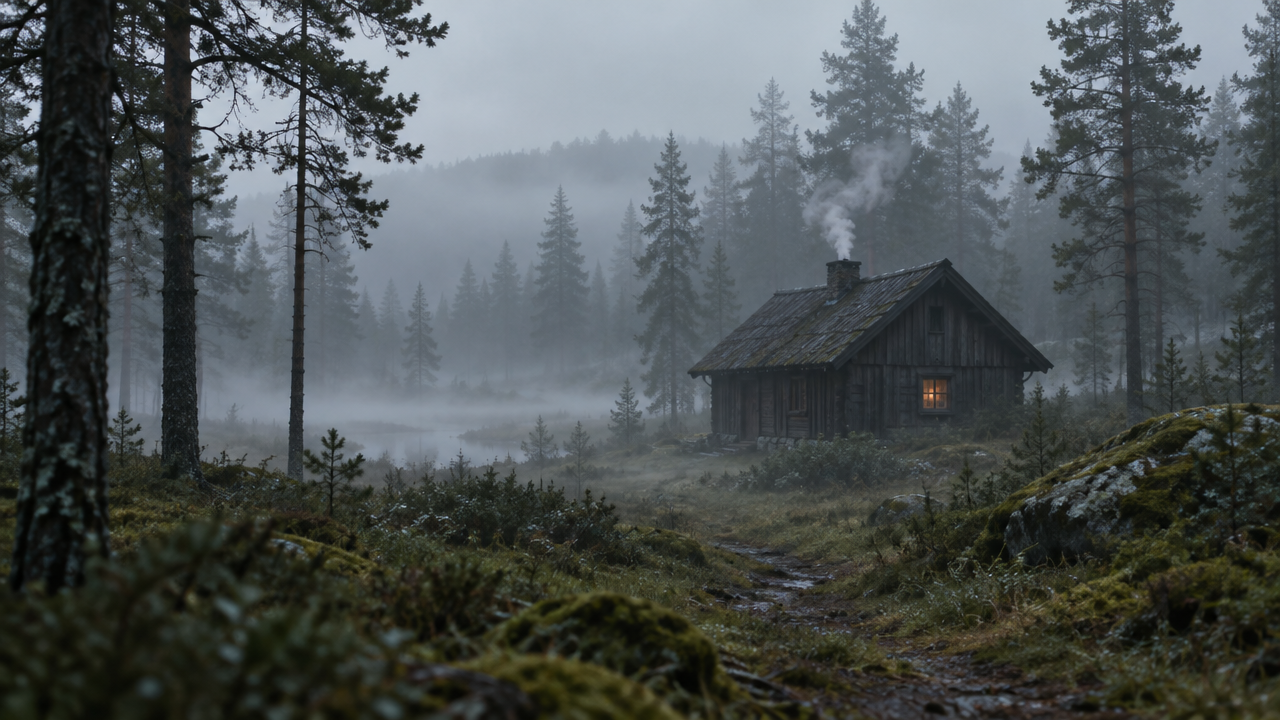
videoNebbia mattutina alla baita: piano mattutino in lento avvicinamento
Stile Atmosfera · Scena naturale · slow-cinema
Input di riferimento
media
Prompt
In una foresta leggermente nebbiosa all'alba, la camera avanza verso una piccola baita con un movimento di carrellata lento e stabile. La cinepresa si avvicina in avanti a una velocità estremamente delicata e costante, senza mai ruotare né inclinarsi. Strati di nebbia scorrono bassi sul terreno boschivo umido, fluendo tra i pini e ammorbidendo lo sfondo in sagome grigio chiaro. La baita è costruita in legno scuro stagionato, con un tetto ripido, e un sottile filo di fumo sale dritto dal camino. Da una piccola finestra filtra una debole luce calda color ambra, in contrasto con il fresco mattino grigio-azzurro. Gocce di rugiada pendono dai fili d'erba e dal muschio, la luce è morbida e diffusa, senza sole diretto né raffiche di vento. Nella scena non c'è quasi alcun movimento oltre alla nebbia che fluttua e al fumo del camino, le foglie sono quasi immobili. Inquadratura cinematografica in formato panoramico 16:9, profondità di campo ridotta, tonalità morbide e poco sature, grana sottile da pellicola, atmosfera tranquilla e meditativa, resa realistica da documentario naturalistico.
Copia il prompt completo e adattalo alla tua generazione.
Tag
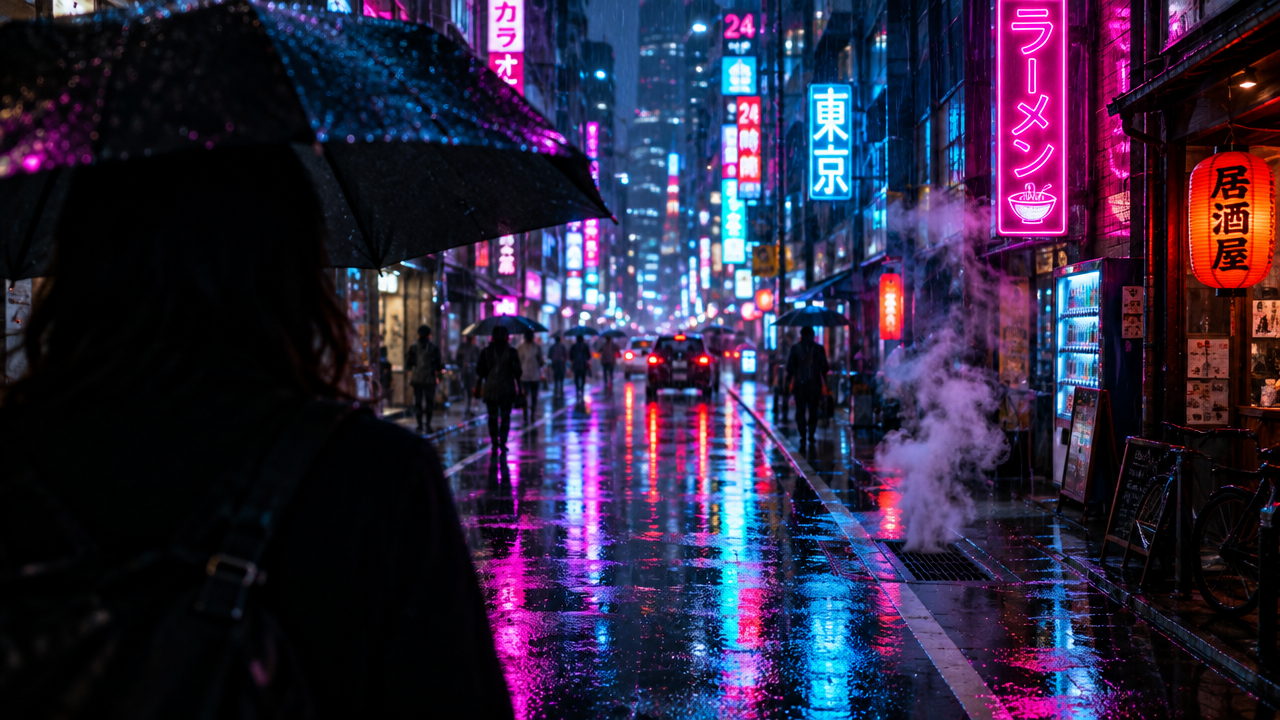
Piano sequenza verticale con zoom indietro nella neon notte piovosa
Stile Cyberpunk · Inquadratura verticale · camera-pullback
Input di riferimento
media
Prompt
Inquadratura verticale 9:16, la camera parte da vicino, dietro le spalle del soggetto e all'altezza dello sguardo, e arretra lentamente lungo una stretta strada al neon sotto la pioggia, mostrando gradualmente i riflessi sull'asfalto bagnato, le insegne sovrapposte magenta e ciano, il vapore che esce dalle griglie di ventilazione e i livelli di profondità creati dai passanti in lontananza. Arretramento stabile e lento, senza tagli intermedi, con un leggero respiro da camera a mano, profondità di campo che si amplia gradualmente da ridotta a una messa a fuoco più ampia. Notte, forte pioggia, aloni al neon ad altissima saturazione, contrasto cinematografico, resa a 24fps.
Copia il prompt completo e adattalo alla tua generazione.
Tag
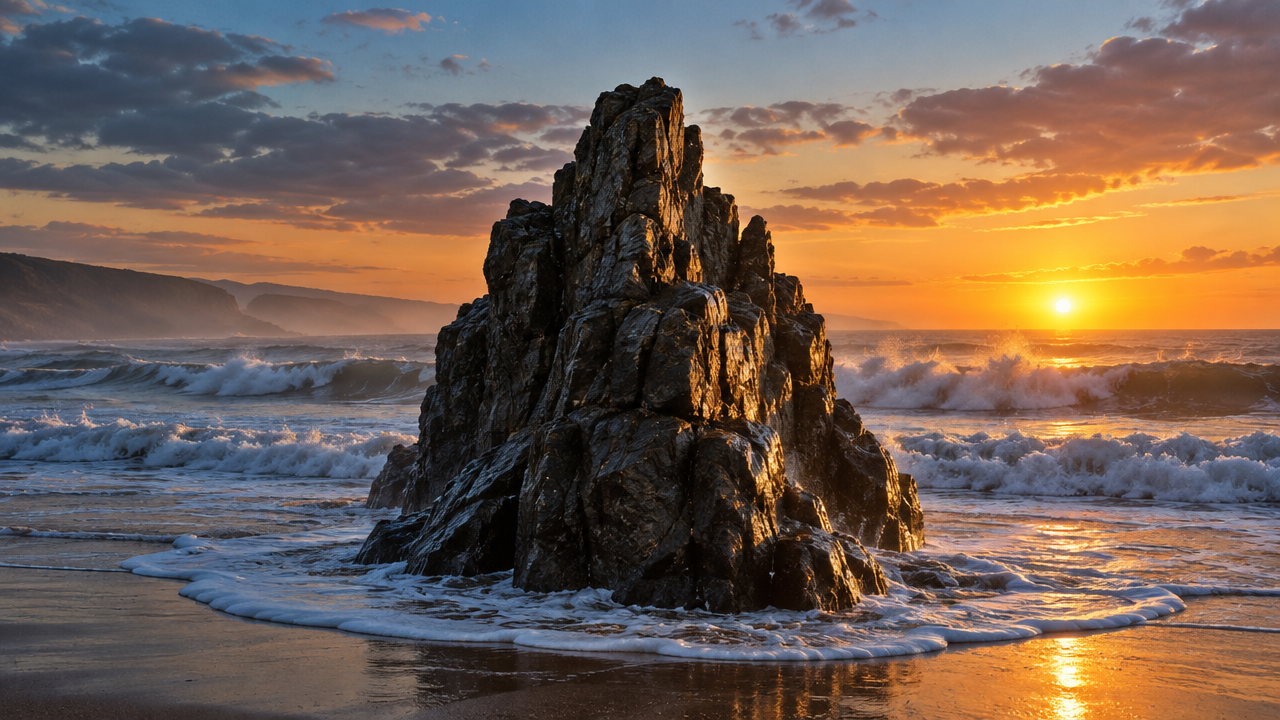
Piano orbitale attorno agli scogli al crepuscolo: dettagli delle onde in image-to-video
Stile Cinematografico · Natura · Piano sequenza
Input di riferimento
media
Prompt
Piano sequenza cinematografico a singola inquadratura, la cinepresa orbita lentamente attorno a uno strato di basalto scuro su una costa al crepuscolo, completando un intero arco circolare; la roccia resta sempre al centro dell'inquadratura come punto d'ancoraggio in primo piano, mentre la linea dell'orizzonte e le nuvole scorrono lentamente alle sue spalle. Le onde si infrangono alla base della roccia, la schiuma sale e si ritira, e le gocce visibili e la sottile nebbia sono delineate in controluce dalla luce dorata del sole a bassa angolazione. Movimento di slittamento da un punto di vista basso fino all'altezza degli occhi, movimento stabile su stabilizzatore, nessun taglio, motion blur naturale. Luce di contorno calda del tramonto, luce di riempimento fredda blu nelle ombre, riflessi speculari sulle rocce bagnate, nebbia sottile e morbida. Realismo fotografico, elevata gamma dinamica, resa cinematografica a 24fps.
Copia il prompt completo e adattalo alla tua generazione.
Tag
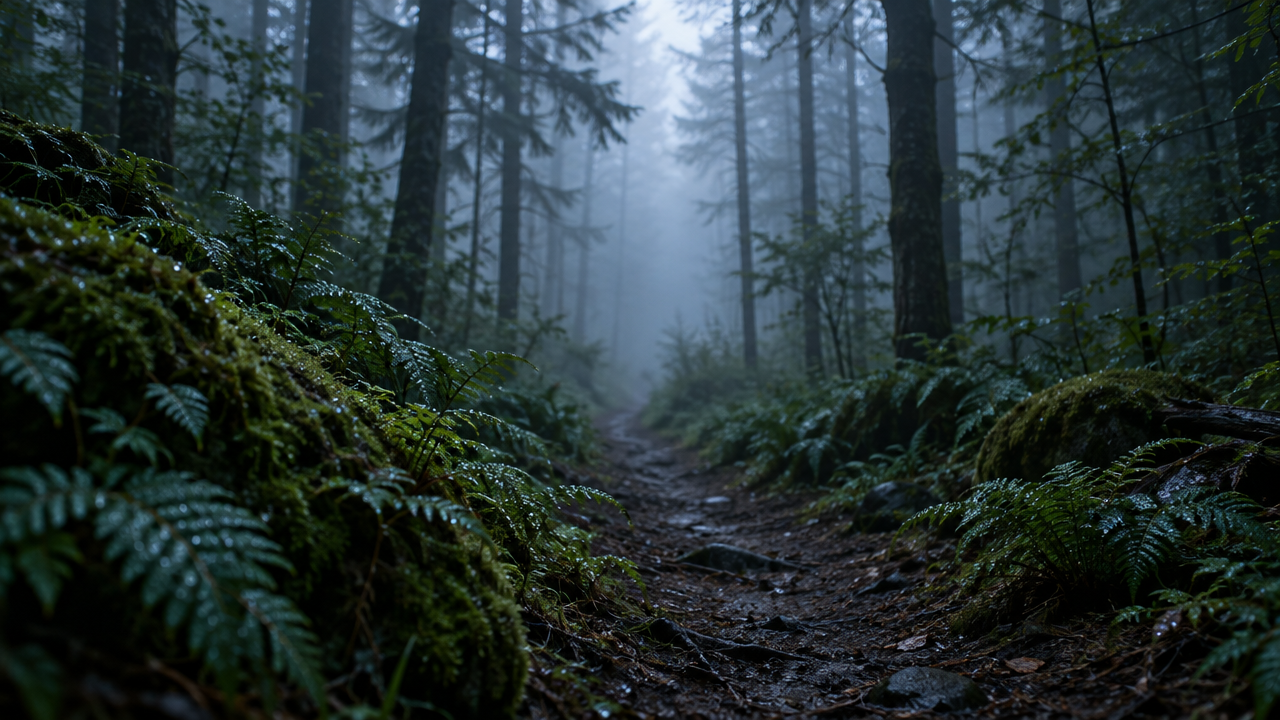
Sentiero nel bosco nebbioso · avanzamento della luce mattutina
Stile Natura · Lento carrello in avanti · Atmosfera
Input di riferimento
media
Prompt
All'alba, avanza lentamente e con fluidità lungo uno stretto sentiero nel bosco; la camera si muove in avanti a velocità costante e ridotta, con una leggera sensazione di galleggiamento all'altezza degli occhi, senza tremolii da ripresa a mano. Una fitta nebbia mattutina si distende a strati nel piano intermedio e si dirada gradualmente con l'avanzare della camera. All'inizio la luce è di un grigio-blu freddo nelle zone d'ombra, poi il sole filtra attraverso la chioma degli alberi e si scalda progressivamente, proiettando una morbida luce divina e lunghi fasci volumetrici che attraversano il sentiero. Muschi umidi, felci e foglie cadute risultano nitidi nei dettagli in primo piano, con una lieve parallasse tra gli alberi. Profondità di campo ridotta, color grading naturale, esposizione che passa gradualmente dalla penombra a un oro caldo, ritmo atmosferico calmo, composizione cinematografica in 16:9.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
wan2.7-video/image-to-video per second
| Specifiche | Prezzo unitario |
|---|---|
| 720P | $0.100 |
| 1080P | $0.167 |
Panoramica della posizione
wan2.7-video/image-to-video è il modello di generazione video guidato da immagini della serie video Alibaba WAN, richiamabile tramite l'interfaccia unificata di HiAPI.ai. Genera video partendo da un'immagine e supporta anche la guida tramite immagini o clip di riferimento, consentendo di controllare il contenuto visivo e il movimento di camera tramite prompt. La risoluzione di output è selezionabile tra 720P e 1080P, la durata singola va da 2 a 15 secondi e supporta l'input combinato di primo frame, ultimo frame, audio guida e clip iniziale. È adatto agli sviluppatori che necessitano di produrre video brevi a partire da risorse immagine esistenti, per materiali pubblicitari, vetrine e-commerce e previsualizzazione di storyboard.
Punti di forza principali
- Generazione guidata da immagini con controllo del primo e dell'ultimo frame——è possibile specificare contemporaneamente l'immagine del primo e dell'ultimo frame, vincolando la composizione iniziale e finale dell'inquadratura e riducendo i costi di rigenerazione dovuti alla casualità.
- Clip di riferimento e audio guida partecipano alla generazione——oltre al primo e all'ultimo frame, si possono passare anche una clip iniziale e un audio guida, così che il risultato generato abbia un riferimento nel ritmo di movimento e nell'audio-visivo.
- Durata e risoluzione regolabili in base alle esigenze——la durata di una singola generazione è impostabile tra 2 e 15 secondi e la risoluzione di output è selezionabile tra 720P e 1080P, adattandosi a diversi requisiti di consegna.
Descrizione delle capacità
Generazione da immagine a video: utilizza una o più immagini come base visiva e, insieme a un prompt testuale, genera video; il prompt può arrivare fino a 5000 caratteri, ideale per trasformare materiali visivi esistenti in contenuti dinamici.
Controllo combinato di primo e ultimo frame: in una singola richiesta è possibile specificare insieme il primo e l'ultimo frame, oppure aggiungere una clip iniziale come riferimento di partenza, per delimitare le immagini di inizio e fine dell'inquadratura.
Input di audio guida: supporta il passaggio di un audio guida come input multimediale, così che il video generato corrisponda nel ritmo al materiale sonoro fornito, riducendo le fasi di sincronizzazione in post-produzione.
Espansione del prompt e prompt negativo: prompt_extend consente di attivare l'espansione automatica del prompt, negative_prompt permette di dichiarare gli elementi visivi da evitare e tramite seed è possibile riprodurre lo stesso risultato.
Risoluzione e durata parametrizzate: risoluzione di output e durata sono entrambe parametri della richiesta; nella stessa interfaccia è possibile passare da 720P/1080P e a lunghezze di clip da 2 a 15 secondi in base allo scenario.
Scenari applicativi
- E-commerce e brand: generazione di vetrine dinamiche da immagini di prodotto——inserendo l'immagine principale del prodotto e i requisiti di presentazione, si produce un breve video dinamico del prodotto, utilizzabile per pagine di dettaglio, campagne in feed e materiali social.
- Team di contenuti: conversione di immagini di personaggi o scene in clip——usando l'immagine di design di un personaggio come primo frame o riferimento, si generano brevi inquadrature conformi alla descrizione dello storyboard, per cortometraggi, previsualizzazioni animate e proposte creative.
- Team di design: inquadrature di transizione vincolate da primo e ultimo frame——specificando insieme l'immagine iniziale e quella finale, si genera la clip di transizione tra le due, per sigle, transizioni e presentazioni di soluzioni visive.
- Fornitori di materiali audio: generazione visiva guidata dall'audio——inserendo materiale audio e la descrizione visiva, si generano segmenti video sincronizzati con il ritmo del suono, per brevi video musicali e contenuti parlati.
Limiti e consigli di selezione
La durata massima di una singola generazione è di 15 secondi; per narrazioni più lunghe è necessario generare a segmenti e montare in post-produzione, e la coerenza tra le clip dipende dal controllo di prompt e materiali di riferimento. La risoluzione di output è disponibile in due livelli, 720P e 1080P; esigenze di qualità superiore vanno valutate a parte. Gli input multimediali sono al massimo tre e ogni tipo può comparire una sola volta. Se l'attività è incentrata su idee puramente testuali e non richiede una base visiva, si può considerare il modello di text-to-video della stessa serie; quando servono inquadrature continue molto lunghe, questo modello non è la scelta adatta.
Domande frequenti
Vedi tutte le domande →-
Wan 2.7 Image to Video richiede il caricamento di un'immagine?
Sì. Attualmente wan2.7-video/image-to-video è un percorso image-to-video: l'immagine di input definisce il soggetto e la composizione iniziale, mentre il Prompt definisce i movimenti, la telecamera e i cambiamenti dell'ambiente.
-
Quali durate e risoluzioni supporta Wan 2.7 Image to Video?
L'attuale contratto di richiesta HiAPI supporta 2–15s, con risoluzioni di output 720P e 1080P. I valori disponibili sono quelli indicati nel pannello dei parametri della pagina e nella documentazione API.
-
Come viene fatturato Wan 2.7 Image to Video?
L'attività viene fatturata in base alla durata dell'output e al livello selezionato. La pagina mostra il prezzo in tempo reale seguendo l'unità monetaria globale; l'addebito finale fa fede al record dell'attività completata con successo.
-
Come migliorare la stabilità del soggetto nella generazione di video da immagine?
Usa un'immagine di input con soggetto nitido, poche occlusioni e composizione completa; nel Prompt descrivi prima l'azione principale e la telecamera, poi elenca gli elementi di aspetto, materiale e relazione con lo sfondo che devono essere preservati. Per il primo test si consiglia una durata breve.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: wan2.7-video/image-to-video
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per wan2.7-video/image-to-video e la route default — vedi la tabella dei parametri sotto.
seedintegerOpzionalemin 0max 2147483647Seme casuale, utilizzato per controllare la casualità dei risultati generati; assumere un valore intero, lo stesso seme con altri parametri coerenti permette di riprodurre risultati simili.
mediaarrayObbligatoriominItems 1maxItems 3
Array di input multimediali, che contiene i vari materiali necessari per la generazione di video da immagine; gli elementi sono oggetti con url e type, i tipi supportati sono first_frame, last_frame, driving_audio, first_clip, ogni tipo può comparire al massimo una volta.
Array [ object ]
Elementi dell'array
urlstringObbligatorioL'indirizzo del materiale multimediale, assumere un URL pubblico, un URL OSS o una stringa base64 data URI supportata.
typestringObbligatorioIl tipo di questo materiale multimediale, assumere una stringa, utilizzato per identificare il suo ruolo nel flusso di generazione (ad esempio primo frame, ultimo frame, audio di guida, primo clip).
first_framelast_framedriving_audiofirst_clippromptstringObbligatoriomaxLength 5000Il prompt testuale per la generazione di video da immagine, che descrive il contenuto visivo e gli effetti dinamici desiderati.
durationintegerOpzionalePredefinito: 5min 2max 15La durata del video generato, in secondi, assumere un valore intero, predefinito 5.
watermarkbooleanOpzionalePredefinito: falseSe aggiungere una filigrana al video generato, assumere un valore booleano, predefinito false.
resolutionstringOpzionalePredefinito: "1080P"La risoluzione del video generato, assumere una stringa; la fatturazione è calcolata al secondo e il prezzo unitario dipende da questo valore, predefinito 1080P.
720P1080Pprompt_extendbooleanOpzionalePredefinito: trueSe abilitare l'estensione del prompt, una volta attivata il modello espande automaticamente il prompt di input, assumere un valore booleano, predefinito true.
negative_promptstringOpzionalePredefinito: ""maxLength 500Prompt negativo, utilizzato per descrivere contenuti che non si desidera compaiano nel video generato, predefinito stringa vuota.
callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "wan2.7-video/image-to-video",
  "input": {
    "media": "…",
    "prompt": "…",
    "duration": 5,
    "watermark": false,
    "resolution": "1080P",
    "prompt_extend": true,
    "negative_prompt": ""
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "wan2.7-video/image-to-video",
input: {
"media": "…",
"prompt": "…",
"duration": 5,
"watermark": false,
"resolution": "1080P",
"prompt_extend": true,
"negative_prompt": ""
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "wan2.7-video/image-to-video",
"input": {
"media": "…",
"prompt": "…",
"duration": 5,
"watermark": False,
"resolution": "1080P",
"prompt_extend": True,
"negative_prompt": ""
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 Grok Imagine 1.5 Lite xAI $0.029 /secondo
-
 Kling 2.5 Kuaishou $0.060 /secondo
-
 HappyHorse 1.1 Alibaba $0.160 /secondo
-
 Seedance 2.5 ByteDance $0.121 /secondo
-
 Seedance 2.0 ByteDance $0.017 /secondo
-
 Veo 3.1 Google $0.290 /secondo
-
 FLUX 3 Max Black Forest Labs $0.061 /secondo
-
 Wan 3.0 Video Alibaba $0.040 /secondo
-
 Gemini Omni 1.1 Flash Google $0.450 /video
-
 Grok Imagine 1.5 xAI $0.011 /secondo
-
 HappyHorse 1.0 Alibaba $0.168 /secondo
-
 Hailuo 2.3 MiniMax $0.270 /video
Stesso fornitore
-
 Wan 2.6 Flash Alibaba $0.043 /secondo
- HappyHorse 1.0 Alibaba $0.168 /secondo
-
 Wan 2.7 Image Alibaba $0.035 /immagine
-
 Z-Image Alibaba $0.008 /immagine
- HappyHorse 1.1 Alibaba $0.160 /secondo
- Wan 3.0 Video Alibaba $0.040 /secondo
-
 Qwen Image 2.1 Alibaba $0.020 /immagine
-
 Qwen Image 2.0 Alibaba $0.042 /immagine
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1.000 caratteri
-
 Qwen Image 3.0 Alibaba $0.036 /immagine