
Veo 3.1
veo-3.1/image-to-video
Modello di generazione video di Google: l'input immagine permette di generare nativamente video di 8 secondi con audio ambientale e dialoghi, con supporto fino al 4K e mantenimento dell'aspetto coerente del soggetto
Prova veo-3.1/image-to-video
Input
Creazioni
Vedi tutte le creazioniOutput
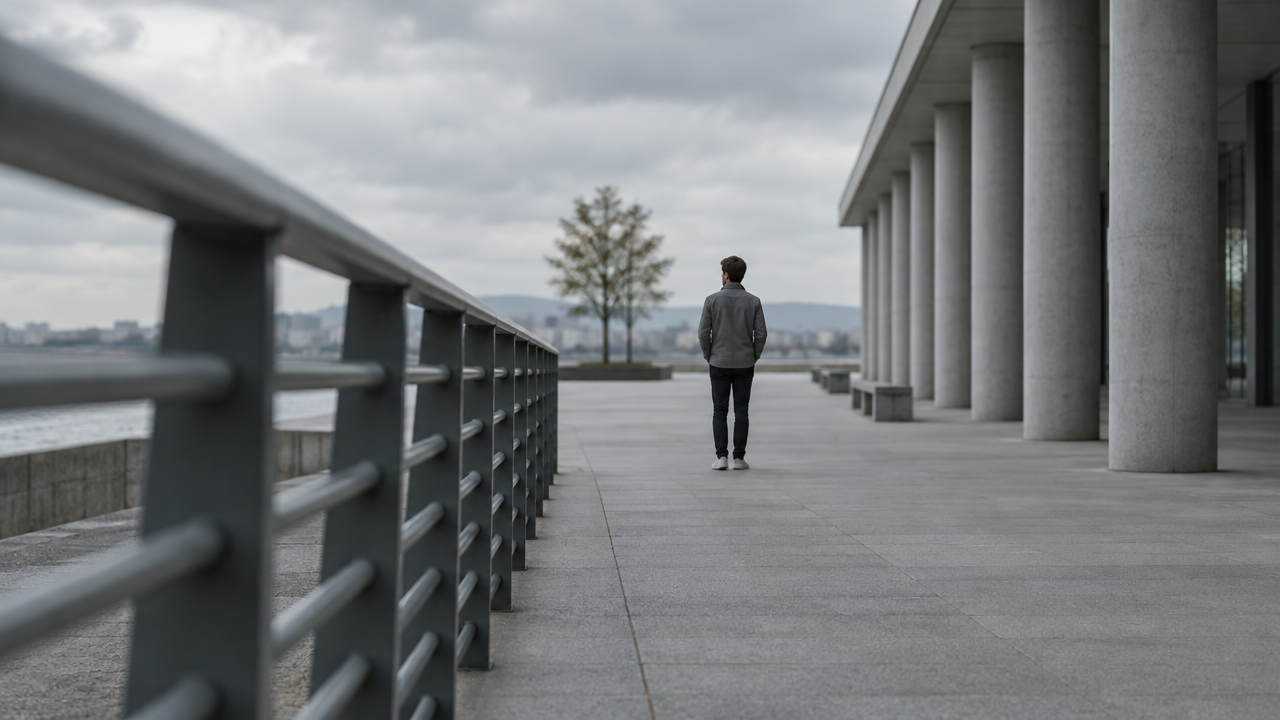
videoNote visive di movimento di camera: dimostrazione del linguaggio cinematografico per la generazione video da immagine
Stile Movimento della camera · Storyboard · grammatica-cinematografica
Input di riferimento
image_url
Prompt
Anima il fermo immagine con un carrello in avanti lento e deliberato: la cinepresa avanza a velocità costante lungo l'asse dell'obiettivo, mantenendo l'orizzonte livellato e il soggetto centrato, mentre la profondità di campo si comprime e gli elementi in primo piano acquisiscono progressivamente parallasse. Stabilizzazione impercettibile senza effetto a mano, nessun effetto di respirazione dello zoom, nessuna distorsione prospettica. Mantieni l'illuminazione neutra e cinematografica del fotogramma di origine, con una profondità di campo ridotta che si restringe gradualmente. Color grading desaturato, bordi dell'immagine puliti, motion blur coerente con un obiettivo da 35mm. Resa da dimostrazione didattica di movimento di camera, un'unica ripresa continua senza tagli.
Copia il prompt completo e adattalo alla tua generazione.
Tag
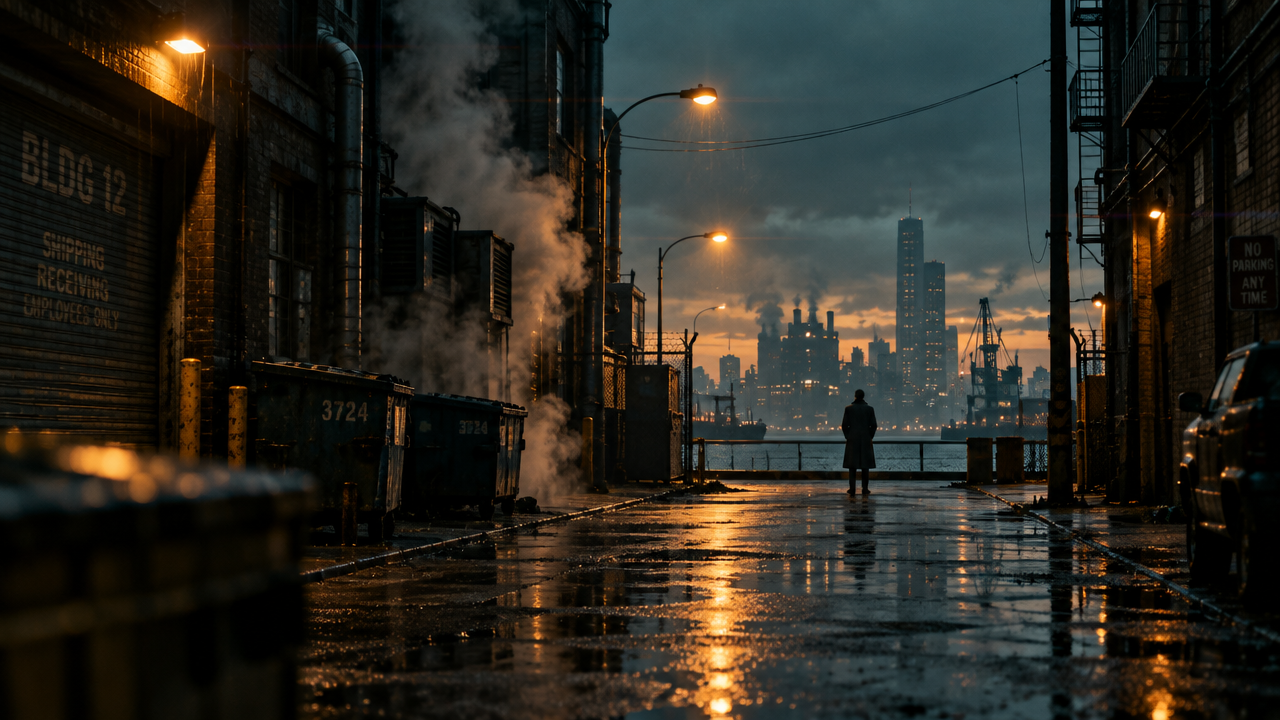
Visualizzazione del concept di storyboard: dal testo al primo frame e al movimento di camera
Stile Storyboard · Cinematografico · Immagine in video
Input di riferimento
image_url
Prompt
Trasforma un singolo fotogramma chiave dal taglio cinematografico in un movimento di camera lento e controllato: un dolce avvicinamento da un campo lungo grandangolare verso il soggetto, con polvere in primo piano e nebbia sottile sospesa che creano un lieve parallasse. Mantieni invariati la composizione originale e la color grading, preserva la profondità di campo ridotta e lascia che la luce cambi dolcemente come ombre di nuvole che scorrono. Il vento ambientale e il leggero rumore di fondo di un interno lontano valorizzano la scena; nessun taglio, nessuna sovrapposizione di testo, ritmo costante entro otto secondi.
Copia il prompt completo e adattalo alla tua generazione.
Tag
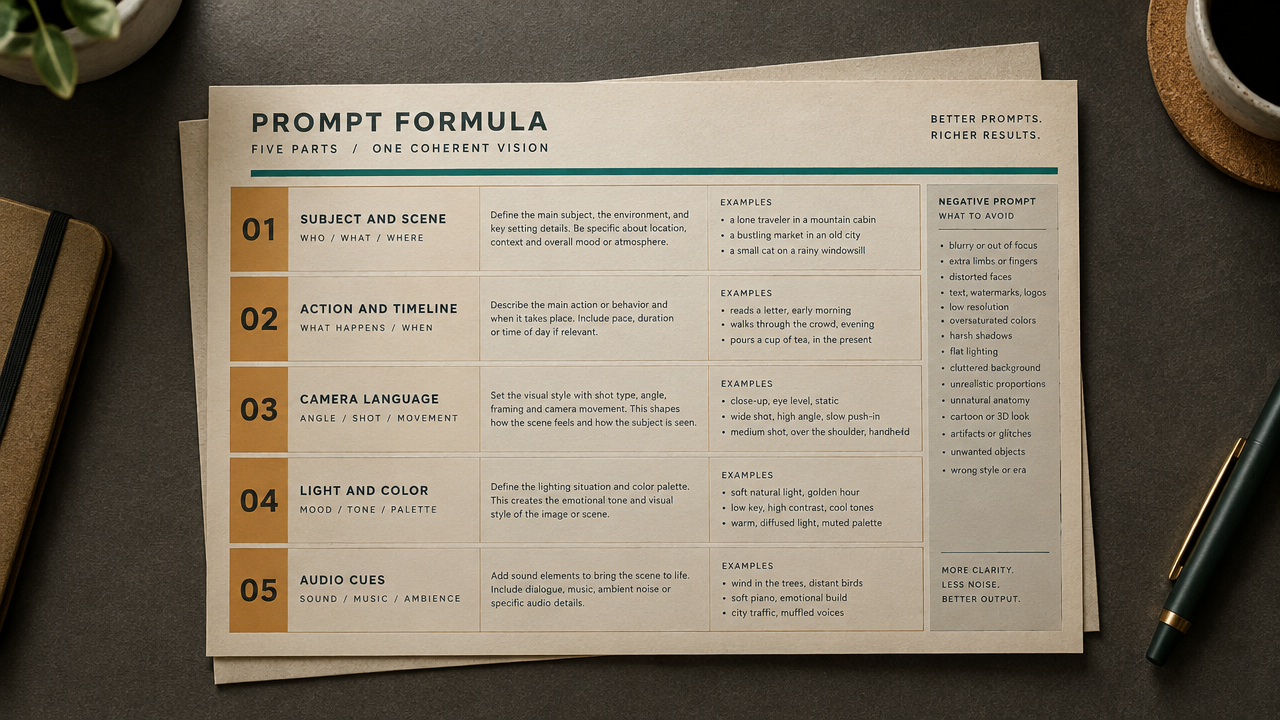
Scheda formula dei prompt per la generazione video da immagine di Veo 3.1
Stile Ingegneria dei prompt · Spiegazione · Motion design
Input di riferimento
image_url
Prompt
Singola inquadratura in avanzamento continuo, ripresa dall'alto di una scheda con la formula dei prompt distesa su una scrivania color grafite caldo. La scheda adotta uno stile editoriale pulito ed essenziale e contiene cinque righe di contenuti etichettati — soggetto e scena, azione e timeline, linguaggio di ripresa, luce e colore, indizi audio — disposte con un carattere sans-serif preciso, con una piccola colonna di negative prompt sulla destra. La camera scorre in avanti a velocità lenta e costante, creando un sottile parallasse sopra i bordi dei fogli sovrapposti, senza tagli né movimenti bruschi. Una morbida luce principale diffusa proviene dall'angolo in alto a sinistra e si attenua delicatamente verso gli angoli; la palette complessiva è in toni ambra e bianco avorio desaturati, con una linea d'accento ciano. La profondità di campo ridotta mantiene nitido il centro della scheda mentre la scrivania si ammorbidisce. Solo rumore ambientale di fondo della stanza, silenzioso e concentrato, adatto a un documentario o a una spiegazione tutorial.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Guida illustrata ai parametri di image-to-video di Veo 3.1: dimostrazione in un'unica inquadratura
Stile Immagine in video · Spiegazione tecnica · Demo del prodotto
Input di riferimento
image_url
Prompt
Trasforma un'immagine statica in un'animazione cinematografica con un carrello in avanti lento e controllato. La macchina da presa avanza con ritmo costante, accompagnata da un leggero micro-movimento a mano, mantenendo il soggetto sempre al centro dell'inquadratura e a fuoco nitido. La luce ambientale varia leggermente nella scena e minuscole particelle fluttuano nel fotogramma. Profondità di campo ridotta, motion blur naturale, color grading cinematografico, resa a 24fps. Nessun taglio, nessuna vibrazione violenta della camera, un'unica ripresa continua in piano sequenza.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
veo-3.1/image-to-video per second
Panoramica della posizione
La linea image-to-video di Veo 3.1 è la versione guidata da immagini del modello di generazione video di Google su HiAPI.ai: riceve un'immagine e un prompt testuale e produce un video dinamico con traccia audio nativa. È particolarmente efficace nel controllare il movimento della camera e l'evoluzione della scena preservando l'aspetto del soggetto dell'immagine di input, ed è adatta agli sviluppatori che devono convertire rapidamente materiali visivi statici in clip riproducibili, per scenari come pubblicità, social media e previsualizzazione di concept.
Punti di forza principali
- Generazione nativa sincronizzata di audio e video — durante la generazione del video vengono prodotti contemporaneamente suoni ambientali, dialoghi ed effetti sonori, riducendo le fasi di doppiaggio ed effetti sonori separati in post-produzione.
- Risoluzione selezionabile fino a 4K — l'output supporta tre livelli: 720p, 1080p e 4k, con formato automaticamente adattato all'immagine di input oppure specificabile in 16:9 o 9:16.
- Durata e audio controllabili — la durata è selezionabile tra 4, 6 e 8 secondi, la traccia audio può essere attivata o disattivata, per adattare le specifiche di generazione ai canali di distribuzione e al budget.
- Supporto a prompt negativi e seed fisso — tramite negative_prompt è possibile escludere elementi indesiderati, mentre con seed si possono riprodurre risultati di generazione simili.
Descrizione delle capacità
Generazione di animazioni guidata da immagini: partendo da un'immagine e con un prompt fino a 20000 caratteri che descrive il movimento, produce clip video da 4 a 8 secondi, adatte a convertire direttamente materiali visivi esistenti in contenuti dinamici.
Generazione di traccia audio nativa: per impostazione predefinita viene generato audio nativo; disattivando generate_audio si ottiene un video muto, utile per applicare musica o doppiaggio nel flusso di post-produzione.
Controllo di risoluzione e formato: è possibile specificare output a 720p, 1080p o 4k; il formato può seguire automaticamente l'immagine di input oppure essere forzato a 16:9 o 9:16, per adattarsi a distribuzioni orizzontali e verticali.
Controllabilità dei risultati: tramite negative_prompt si descrivono i contenuti da evitare, mentre con seed si fissa il seme casuale, utile per mantenere stabilità di stile nelle generazioni in batch o per confronti A/B.
Scenari di applicazione
- Team di marketing che convertono immagini di prodotto in spot pubblicitari — inserendo un'immagine statica del prodotto e una descrizione del movimento, si producono clip orizzontali a 4K o 1080p, utilizzabili direttamente per campagne pubblicitarie online e vetrine del sito.
- Gestori di social media che creano contenuti dinamici verticali — con immagini in formato verticale e prompt si generano video 9:16 con effetti sonori nativi, da pubblicare come materiali sulle piattaforme di video brevi.
- Pre-produzione audiovisiva che converte concept art in previsualizzazioni dinamiche — storyboard o design concept vengono trasformati in clip dinamiche, aiutando il team a confermare movimento della camera e atmosfera prima della produzione effettiva.
- Sviluppatori che generano materiali dinamici in batch — in flussi programmatici si passano immagini e prompt e, combinando seed, si producono in batch clip video con stile uniforme, per test o riempimento di contenuti.
Limiti e suggerimenti per la scelta
La durata massima di una singola generazione è di 8 secondi; narrazioni più lunghe richiedono generazioni segmentate e successivo montaggio, e la coerenza multi-inquadratura necessita comunque di regia manuale. Si consiglia un'immagine di input di almeno 720p e in formato 16:9 o 9:16; altri rapporti vengono ritagliati. Risoluzione e attivazione audio influenzano la fatturazione, quindi prima di generazioni in batch conviene fare una prova a specifiche ridotte. Se serve costruire l'immagine da zero invece di animare un'immagine esistente, è opportuno scegliere la linea text-to-video della stessa famiglia.
Domande frequenti
Vedi tutte le domande →-
Che tipo di modello video è Veo 3.1 Text to Video?
È una linea di generazione video puramente text-to-video: richiede solo un Prompt testuale e non necessita del caricamento di un'immagine iniziale.
-
Quali specifiche di output supporta Veo 3.1 Text to Video?
Supporta video da 4 a 8 secondi, con risoluzioni che includono 720p, 1080p e 4k, e formati d'immagine che includono 16:9 e 9:16.
-
È possibile generare una voce o utilizzare un riferimento audio?
La generazione audio è abilitata per impostazione predefinita
-
Come viene fatturato Veo 3.1 Text to Video?
La fatturazione si basa sulla durata dell'output e sul livello in tempo reale; eventuali differenze dovute a risoluzione, modalità o opzioni audio sono determinate dai prezzi indicati nella pagina e dai record delle attività.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: veo-3.1/image-to-video
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per veo-3.1/image-to-video e la route default — vedi la tabella dei parametri sotto.
seedintegerOpzionaleSeme casuale utilizzato per rendere riproducibile il risultato della generazione; passando lo stesso seme si ottiene un output coerente.
promptstringObbligatoriominLength 1maxLength 20000Prompt testuale che descrive in che modo si desidera animare l'immagine di input.
durationintegerObbligatorioPredefinito: 8min 4max 8Durata del video generato (in secondi); il costo aumenta con la durata; valore predefinito 8 secondi.
468image_urlstringObbligatorioURL dell'immagine di input da animare; si consiglia una risoluzione pari o superiore a 720p e un formato 16:9 o 9:16, gli altri formati verranno ritagliati.
resolutionstringObbligatorioPredefinito: "720p"Risoluzione del video di output; più alta è la risoluzione, maggiore è il costo; valore predefinito 720p.
720p1080p4kaspect_ratiostringOpzionalePredefinito: "auto"Proporzioni del video di output; valore predefinito auto, che indica di seguire le proporzioni dell'immagine di input.
auto16:99:16generate_audiobooleanOpzionalePredefinito: trueIndica se generare una traccia audio nativa; se attivato il prezzo è più alto, attivo per impostazione predefinita.
negative_promptstringOpzionalePrompt negativo che descrive i contenuti da evitare nel video generato.
callbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "veo-3.1/image-to-video",
  "input": {
    "prompt": "…",
    "duration": 8,
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "auto",
    "generate_audio": true
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "veo-3.1/image-to-video",
input: {
"prompt": "…",
"duration": 8,
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "auto",
"generate_audio": true
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "veo-3.1/image-to-video",
"input": {
"prompt": "…",
"duration": 8,
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "auto",
"generate_audio": True
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 HeyGen Avatar V HeyGen $0.150 /secondo
-
 Seedance 2.0 ByteDance $0.017 /secondo
-
 FLUX 3 Video Black Forest Labs $0.090 /secondo
-
 Grok Imagine 1.5 Lite xAI $0.029 /secondo
-
 Gemini Omni 1.1 Flash Google $0.450 /video
-
 Kling 3.0 Kuaishou $0.100 /secondo
-
 Kling 4.0 Kuaishou $0.330 /secondo
-
 Gemini Omni Google --
-
 Veo 3.1 Fast Google $0.170 /secondo
-
 HappyHorse 1.1 Alibaba $0.160 /secondo
-
 Kling 2.5 Kuaishou $0.060 /secondo
-
 Wan 2.6 Flash Alibaba $0.043 /secondo
Stesso fornitore
-
 Veo 3.1 Lite Google $0.060 /secondo
-
 Nano Banana 2 Google $0.036 /immagine
-
 Lyria 3 Pro Google $0.140 /brano
-
 Imagen 4 Google $0.030 /immagine
- Gemini Omni Google --
-
 Nano Banana Google $0.021 /immagine
- Veo 3.1 Fast Google $0.170 /secondo
-
 Nano Banana 2 Lite Google $0.033 /immagine
-
 Gemini 3.1 Flash TTS Google --
-
 Lyria 3.5 Google $0.090 /brano
-
 Nano Banana Pro Google $0.057 /immagine
- Gemini Omni 1.1 Flash Google $0.450 /video