
Руководство по использованию
Руководство по началу работы с gpt-6.2-sol: границы возможностей, интеграция через API и тарификация токенов
Ключевые моменты принятия решений и практики интеграции для инженерных команд

На этой странице
Что такое gpt-6.2-sol и кому она подходит
gpt-6.2-sol — текстовая модель от OpenAI, уже доступная через единый интерфейс HiAPI.ai. Это основная рабочая модель серии GPT-6: OpenAI позиционирует её как универсальную модель, подходящую от написания кода до масштабного управления агентами. Тип её вывода — только текст, и это первый критерий, по которому стоит оценивать, подходит ли она вам, а не воспринимать её как универсальный «чёрный ящик, который умеет всё».
Наиболее комфортные сценарии: ответы на вопросы и сведение результатов поиска, первичные черновики и переписывание контента, извлечение и классификация структурированных данных, семантические решения в многошаговых диалогах, а также текстовые решения как часть процесса (сортировка, разметка, суммаризация, определение намерений). Общая черта таких задач — входные данные и ожидаемый результат являются текстом, а модель можно встроить в существующий сервис и вызывать как функцию.
Целевая аудитория — инженерные команды: те, кто оценивает, стоит ли вводить новую текстовую модель, или готовится массово перевести существующие вызовы на новую модель. Если вам нужно генерировать изображения или аудио, это выходит за её границы и должно быть исключено ещё на этапе выбора.
Практичный критерий: сформулируйте задачу одним предложением и спросите: «Входные и выходные данные этой задачи — это текст?». Если ответ отрицательный, модель в лучшем случае возьмёт на себя только текстовую часть процесса.
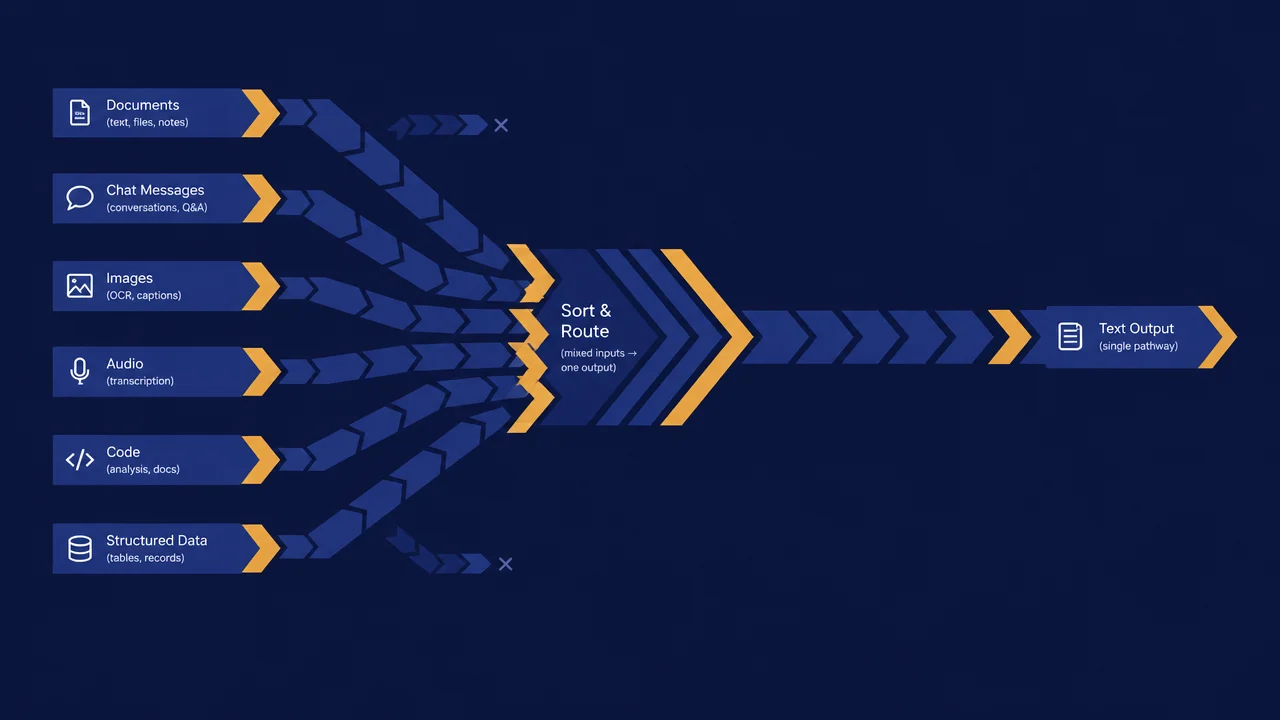
Границы возможностей: что модель может и чего не может при текстовом выводе
Рассматривайте gpt-6.2-sol как канал «текст на входе — текст на выходе». То, что он умеет, предельно ясно: получив текстовый контекст, выдать текстовый результат. Исходя из этого, напрямую решаемые задачи включают классификацию и разметку, суммаризацию и переписывание, извлечение информации, генерацию ответов на вопросы, преобразование форматов (например, из свободного текста в согласованный структурированный текст), а также ранжирование и объяснение нескольких вариантов результата.
Части, которые требуют дополнительных звеньев, нужно заранее понимать:
- Требуется строго структурированный вывод: при вызове через Responses API можно передать JSON Schema в
text.formatи включить strict, чтобы ответ генерировался сразу по определению полей; при использовании Chat Completions такой опции нет, остаётся только ограничение через промпт. В Chat Completions нужно полагаться на ограничение промптом плюс серверную валидацию и повторные попытки, нельзя предполагать, что первый ответ обязательно будет разбираемым. - Требуются актуальные факты: вывод модели не равно источнику фактов. Содержимое о данных, времени и внешнем состоянии должен предоставлять ваш слой поиска или база данных, а модель лишь облекает его в слова.
- Требуются нетекстовые продукты: генерация изображений, речи и т. п. не входит в её тип вывода, для этого нужно подключать отдельные звенья.
- Требуется детерминированное поведение: один и тот же запрос не гарантирует дословного воспроизведения; части со строгой согласованностью должны находиться в коде, а не передаваться на усмотрение модели.
Записать границы в проектный документ гораздо дешевле, чем потом латать дыры в продакшене. Всё, что выходит за рамки текстовых возможностей, явно помечайте как «требует внешнего компонента», тогда на ревью не будет расхождений в ожиданиях.
Ключевые параметры и цена gpt-6.2-sol
Ниже приведена подтверждённая информация о вызове gpt-6.2-sol через HiAPI; дальнейшие разделы об интеграции и оценке затрат опираются на неё.
- Позиционирование: основная рабочая модель серии GPT-6. OpenAI позиционирует её как универсальную модель, подходящую от написания кода до масштабного управления агентами; по сравнению с GPT-6.1 Sol она умнее и экономичнее по токенам.
- Контекст и вывод: окно контекста 1 050 000 токенов, максимальный вывод за один раз — 128 000 токенов.
- Дата отсечения знаний: 2026-06-01.
- Вывод и возможности: текстовый вывод, поддержка потокового вывода и вызова инструментов (
tools). - Способы вызова: поддерживаются Responses API (
https://api.hiapi.ai/v1/responses) и Chat Completions (https://api.hiapi.ai/v1/chat/completions). Уровень рассужденийreasoning.effort(low / medium / high / xhigh / max, по умолчанию medium) и структурированный вывод JSONtext.formatдоступны только в Responses API. - Цена: текущая цена на странице модели (за миллион токенов) — вход $0.500, кэшированный вход $0.025, выход $2.500, запись в кэш (5 минут) $0.625. Тарификация определяется в реальном времени по отображению на странице модели gpt-6.2-sol.
Как выбрать между ней и gpt-6.2-astra
Модель той же серии gpt-6.2-astra — флагманская, ориентирована на самые сложные и длительные проекты, и цена за единицу у неё выше. Рекомендуется для большинства задач сначала использовать Sol; а при трудных задачах, с которыми Sol не справляется, например при сложном межмодульном рефакторинге или при высоких требованиях к профессиональным документам, переключаться на Astra. Способ вызова у обеих одинаков, для переключения достаточно изменить имя модели.
Информация об интерфейсе, которую нужно подтвердить перед интеграцией
При интеграции через HiAPI.ai точка входа для информации — /models/gpt-6.2-sol. Следующий список рекомендуется сверить по пунктам до написания первой строки кода вызова, причём опираться на официальную документацию и документацию платформы, а не угадывать по постам в сообществе или конфигурации из старых проектов:
- Учётные данные и способ аутентификации: откуда берётся ключ, где хранится, как безопасно внедряется на сервере — ни в коем случае не передавайте его в браузер.
- Поля запроса и обязательные элементы: точные названия и ограничения значений для идентификатора модели, структуры сообщений, верхнего предела длины генерации и т. п.
- Ограничения контекста и длины вывода: окно контекста gpt-6.2-sol — 1 050 000 токенов, максимальный вывод за один раз — 128 000 токенов; то, как действует верхний предел вывода, напрямую определяет вашу стратегию разбиения на части.
- Метрики лимитов и квот: по какому измерению считаются ограничения скорости (число запросов или объём токенов) и как выглядит ответ при их срабатывании.
- Семантика кодов ошибок: какие ошибки имеет смысл повторять, а какие являются проблемой параметров и повтор не поможет — это нужно различать.
- Метрика тарификации: данная модель тарифицируется по токенам, на странице модели отдельно указаны цены за вход, кэшированный вход, выход и запись в кэш.
Зафиксируйте эти выводы во внутренней инструкции по интеграции команды, чтобы при смене людей или модели можно было напрямую переиспользовать этот чек-лист. Если какой-то пункт ещё не подтверждён, не вносите его в производственную ветку.
Ключевые моменты вызова API и организации параметров
Основная работа на стороне вызова — не отправить один запрос, а организовать запросы в обёртку, которую можно переиспользовать, наблюдать и деградировать. Сначала минимальный пример: получение структурированного JSON через Responses API. При использовании официального SDK OpenAI достаточно указать base_url на HiAPI:
from os import environ
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key=environ["HIAPI_API_KEY"])

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions="Извлеки поля из заявки, отсутствующие поля заполни null.",
    input=ticket_text,
    text={
        "format": {
            "type": "json_schema",
            "name": "ticket",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "category": {"type": "string", "enum": ["billing", "bug", "account", "other"]},
                    "order_id": {"type": ["string", "null"]},
                },
                "required": ["category", "order_id"],
                "additionalProperties": False,
            },
        }
    },
)
print(resp.output_text)
Если у вас уже есть клиент Chat Completions, достаточно заменить имя модели на gpt-6.2-sol, чтобы вызывать её, но уровень рассуждений и структурированный вывод JSON в Chat Completions недоступны. Далее действуйте в следующем порядке:
Структура запроса
Разделите сообщения на два уровня: системные ограничения и пользовательское содержимое. В системный уровень поместите роль, требования к формату вывода и запреты, в пользовательский — бизнес-данные. Не смешивайте бизнес-данные и инструкции в одном фрагменте, иначе при проблеме нельзя будет определить, дело в данных или в инструкции.
Контракт вывода
Чётко опишите ожидаемую форму вывода (например, имена полей, допускается ли пояснительный текст). Даже если описали, на сервере всё равно нужно один раз разобрать и проверить: неудачный разбор считается неудачным вызовом, запускаются повтор или деградация, а не передача полуфабриката напрямую во фронтенд.
Исключения и повторные попытки
Повтор должен происходить только при восстановимых ошибках, например при кратковременном сетевом сбое или ограничении скорости. Для ошибок вроде недопустимых параметров или слишком длинного содержимого повтор бессмысленен — нужно сразу сообщать о них. У повторов должен быть верхний предел числа и интервал отката, чтобы не превратить один сбой в лавину.
Минимальный набор наблюдений
При каждом вызове фиксируйте как минимум: длительность, объём входных и выходных токенов, был ли повтор, итог — успех или деградация. Эти пункты определяют, сможете ли вы потом посчитать затраты и локализовать проблему. Интеграция без логов равносильна отсутствию интеграции.
Структура затрат при тарификации по токенам
gpt-6.2-sol тарифицируется по токенам, а значит стоимость одного запроса — не фиксированная величина, а линейно накапливается вместе с объёмом входа и выхода. В инженерии нужно строить модель затрат, а не запоминать какое-то число:
- Сторона входа: системный промпт, история диалога, найденный контекст — всё это учитывается. Если не обрезать многошаговый диалог, вход будет непрерывно расти с каждым шагом.
- Сторона выхода: чем длиннее генерация, тем больше счёт. Требование к модели давать длинные объяснения неконтролируемо повышает затраты.
- Общая стоимость: стоимость одного запроса складывается из входа и выхода, поэтому оптимизировать нужно обе стороны.
Соответствующие меры контроля: сокращать системный промпт и переиспользовать его; применять скользящее окно или сжатие через суммаризацию к истории диалога; длинные документы сначала разбивать на части и подавать по мере необходимости; задавать разумный верхний предел вывода; выполнять дедупликацию и кэширование для пакетных задач, чтобы не платить повторно за одинаковый вход.
Правильный способ оценки бюджета — прогнать реальные образцы, посчитать средний объём входных и выходных токенов, умножить на масштаб вызовов и получить оценку порядка величин. Текущие цены см. в разделе «Ключевые параметры и цена» выше; цены могут меняться, тарификация определяется в реальном времени по отображению на странице модели.
Определение необходимости переключения через горизонтальное сравнение
Выбор не должен опираться только на одну оценку или единственную метрику. Надёжнее сравнить gpt-6.2-sol и вашу текущую модель-кандидат на одной и той же партии реальных бизнес-образцов:
- Выборка: извлеките из онлайн-логов или размеченных данных представительную партию запросов, охватывающую частые и длиннохвостые задачи.
- Единый вход: один и тот же промпт, одна и та же партия данных, меняется только идентификатор модели — так исключается влияние различий в промптах.
- Многомерная оценка: смотрите не только на баллы, но и на долю соблюдения формата, долю ошибок, средний расход токенов и среднюю длительность.
- Ручная выборочная проверка: качество формулировок и фактические ошибки, которые не видны по машинным метрикам, должен проверять человек.
- Решение: задайте порог допуска для переключения, например при каком уровне соблюдения формата и доли ошибок можно выпускать в продакшн.
Цель сравнения — не доказать, что новая модель лучше, а ответить на вопрос: «Покрывает ли выгода от переключения на текущих задачах затраты на миграцию и сопровождение?». Если разница незначительна, сохранить текущее состояние — тоже правильное решение. В той же серии для самых сложных и длительных задач можно включить в сравнение и gpt-6.2-astra; для большинства задач рекомендуется сначала использовать Sol.
Частые вопросы и способы диагностики
Частые проблемы начального этапа интеграции быстрее всего диагностируются в следующем порядке:
- Тайм-аут: сначала проверьте, не слишком ли длинный вход, из-за чего выросло время обработки, затем — не связано ли это с сетью или серверным ограничением скорости. План деградации должен быть готов заранее, до сбоя.
- Вывод обрезан: проверьте, не установлен ли слишком маленький верхний предел длины генерации и не требует ли системный промпт слишком длинного вывода. Обрезка часто связана не с моделью, а с параметрами.
- Несоответствие формата вывода: убедитесь, что требования к формату в промпте достаточно конкретны, и на сервере добавлены валидация и повтор; при повторных сбоях попробуйте заменить на более явные ограничения примерами.
- Ошибка аутентификации: проверьте, правильно ли внедрён ключ, не утёк ли по ошибке серверный ключ во фронтенд, не отсутствуют ли переменные окружения.
- Ошибка ограничения скорости: определите измерение и порог ограничения, добавьте откат и очередь, чтобы мгновенная параллельность не исчерпывала лимит.
Основная дисциплина диагностики: сначала определите, в чём проблема — в построении запроса, в серверных ограничениях или в разборе ответа бизнес-кодом — и только потом вносите изменения. Не полагайтесь на удачу, подкручивая параметры.
Мониторинг и итерации после запуска
Запуск — не финальная точка. Относитесь к интеграции как к постоянно работающей цепочке и отслеживайте как минимум следующие метрики: объём вызовов и доля успеха, доля соблюдения формата, средний объём входных и выходных токенов, средняя длительность, доля деградаций и повторов. Они соответствуют четырём измерениям: ёмкость, качество, затраты и стабильность.
По ритму итераций рекомендуется через фиксированные интервалы пересматривать неудачные образцы и отзывы пользователей, превращать типичные ошибки в новые тестовые случаи и на их основе корректировать промпты, стратегию разбиения и верхние пределы вывода. При изменении конфигурации модели или платформы прогоняйте регрессию на той же партии тестовых образцов, прежде чем решать о расширении трафика.
Практичный принцип запуска: сначала проверьте реальный эффект на небольшом трафике с постепенным увеличением, и в любой момент сохраняйте переключатель для возврата к старой модели. Если хотите сначала посмотреть подробности модели и информацию об интеграции, начните со /models/gpt-6.2-sol. Только когда границы возможностей, модель затрат и мониторинг проработаны одновременно, gpt-6.2-sol станет стабильным и надёжным текстовым звеном вашей системы.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с gpt-6.2-astra: границы возможностей текстовой модели, ключевые моменты интеграции и контроль затрат
-

Руководство по использованию
Руководство по началу работы с Tripo H3.1: три способа ввода, параметры и как выбрать тариф
Практическое руководство для разработчиков по принятию решений и контролю затрат при интеграции генерации 3D
-

Руководство по использованию
Генерация изображений товаров для электронной коммерции с помощью qwen-image-2.1-turbo через HiAPI API
Быстрый рабочий процесс визуализации каталога для разработчиков: прозрачный вывод PNG и работающий API-запрос