
OpenAI
GPT Image 2
gpt-image-2/text-to-image
Modèle de génération et d'édition d'images d'OpenAI, axé sur le photoréalisme, le rendu de texte de haute précision et la sortie native en 4K, adapté aux supports commerciaux contenant du texte et aux visuels produits
Essayer gpt-image-2/text-to-image
Entrée
Créations
Voir toutes les créationsSortie
image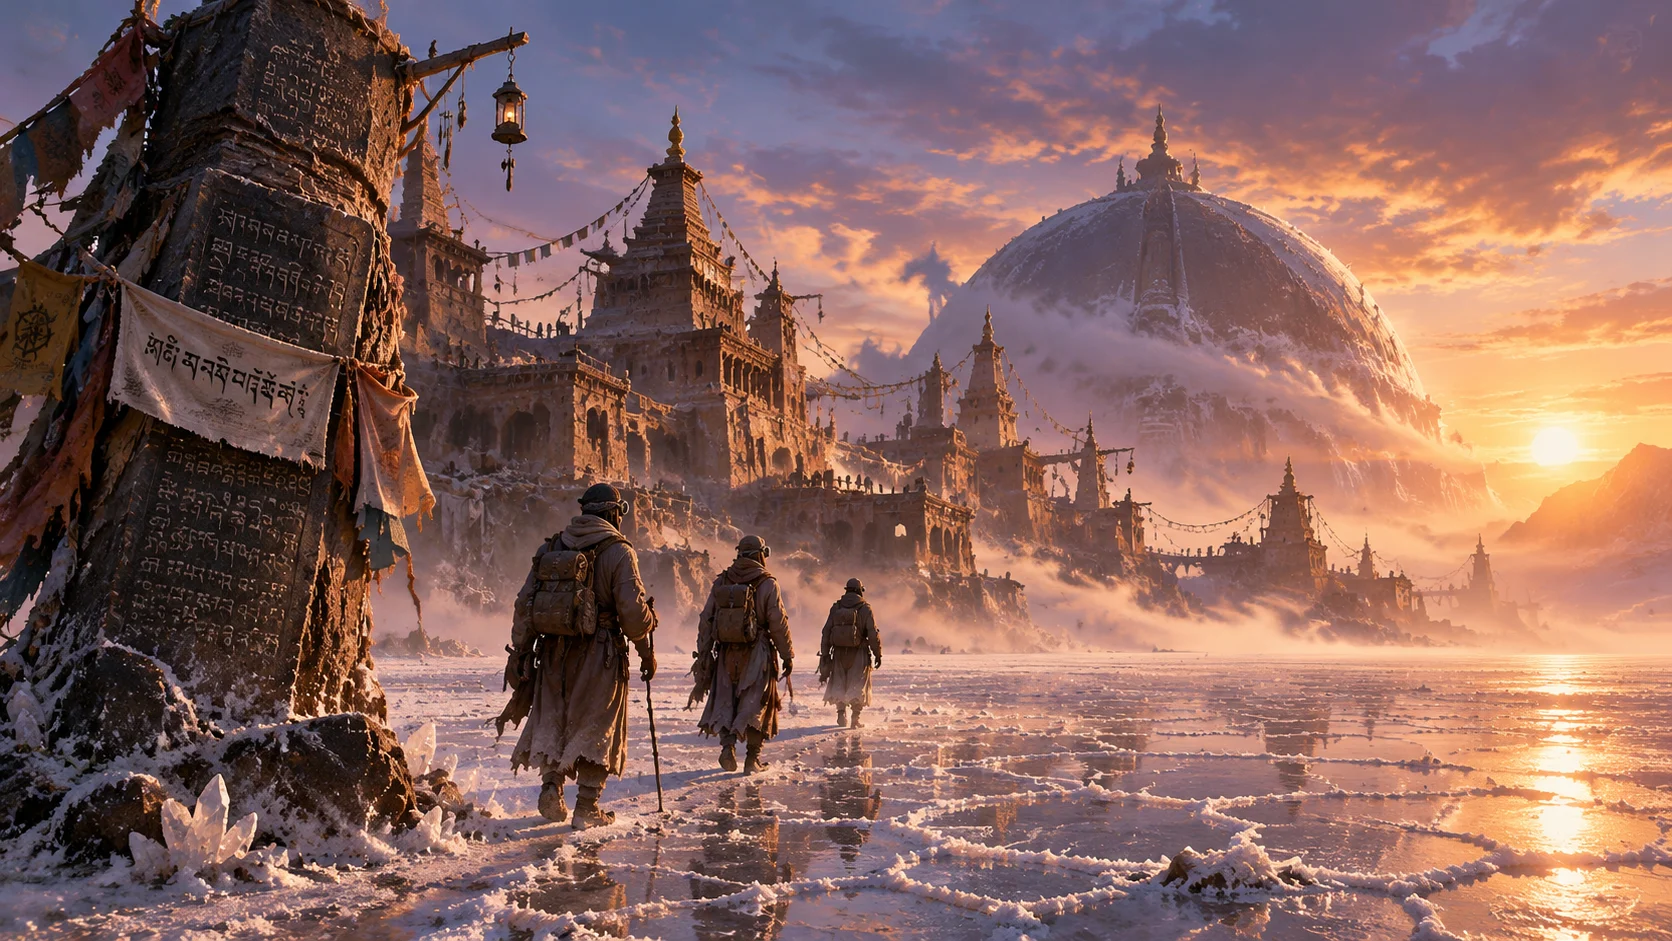
Carte conceptuelle de worldbuilding : le crépuscule d'une cité de pèlerinage dans le désert de sel
Style Art conceptuel · Construction de l'univers · Cinématographique
Prompt
Un plan de fondation de cité en grand-angle et à hauteur d'œil basse : au crépuscule, une cité de pèlerinage bâtie sur une vaste plaine de sel. Premier plan : une petite caravane de trois voyageurs, vêtus de longues robes poussiéreuses superposées et de lunettes protectrices couvertes de cristaux de sel, se dirige vers la ville en passant devant une colonne de basalte inclinée, gravée d'inscriptions denses et ornée de bannières de prière décolorées portant un texte clairement lisible. Plan moyen : des arcades en grès superposées, des ponts de corde et des tours de prière à étages, garnies de carillons éoliens et de lanternes suspendues. Arrière-plan : un immense dôme à demi ensablé, à moitié englouti par une brume de sel mouvante, se découpant en silhouette sous un ciel aux tons ambre chaud à violet. Le sol est une croûte de sel blanche fissurée en blocs polygonaux, reflétant le ciel, avec des éclats de cristal épars qui captent la lumière. Lumière volumétrique cinématographique issue d'un soleil en contre-jour bas, longues ombres, fine poussière de sel en suspension, brume atmosphérique subtile créant une profondeur progressive du premier plan à l'arrière-plan. Rendu de concept art pictural, avec une restitution des matériaux de niveau photographique : textures de pierre rugueuse, tissage usé des étoffes, garnitures en bronze oxydé. Ombres violet froid contrastant avec des hautes lumières ambre chaud, plage dynamique élevée, composition panoramique 16:9, séparation nette entre premier plan, plan moyen et arrière-plan, large espace vide dans le ciel.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
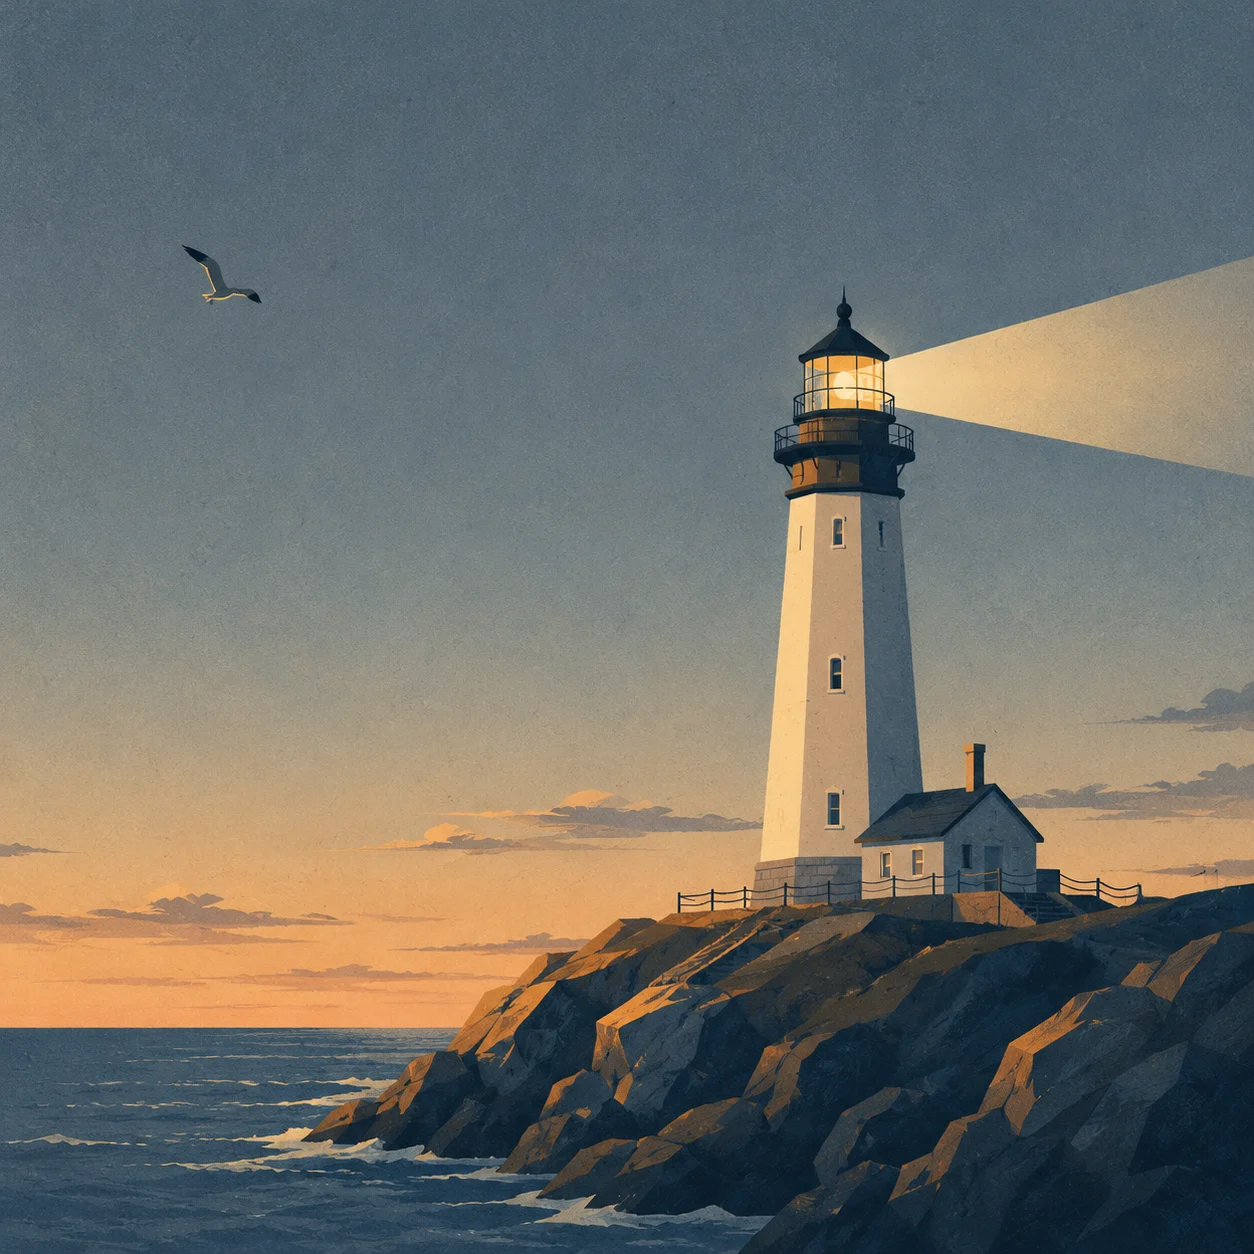
Du réalisme à l'aplat : le spectre des styles d'illustration pour un même sujet
Style Illustration · style-spectrum · éditorial-imprimé
Prompt
Illustration éditoriale d'un phare solitaire sur un cap rocheux au crépuscule, vu en contre-plongée sous un angle aux trois quarts, la ligne d'horizon située au tiers inférieur de l'image. Un oiseau marin traverse le ciel en haut à gauche ; le faisceau du phare balaie vers la droite. Composition et sujet maintenus fixes sur toute la lignée stylistique. Style : illustration vectorielle semi-aplatie, à mi-chemin entre le réalisme et l'aplat — volumes géométriques simplifiés, palette restreinte dominée par le bleu ardoise, l'ocre chaud et le crème pâle, clair-obscur doux en deux tons plutôt qu'en dégradé, bords nets et francs, légère texture de papier, espace négatif volontairement ménagé dans le ciel. Sans texte, sans logo, sans filigrane. Composition carrée 1:1, généreusement aérée, netteté adaptée à l'impression.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
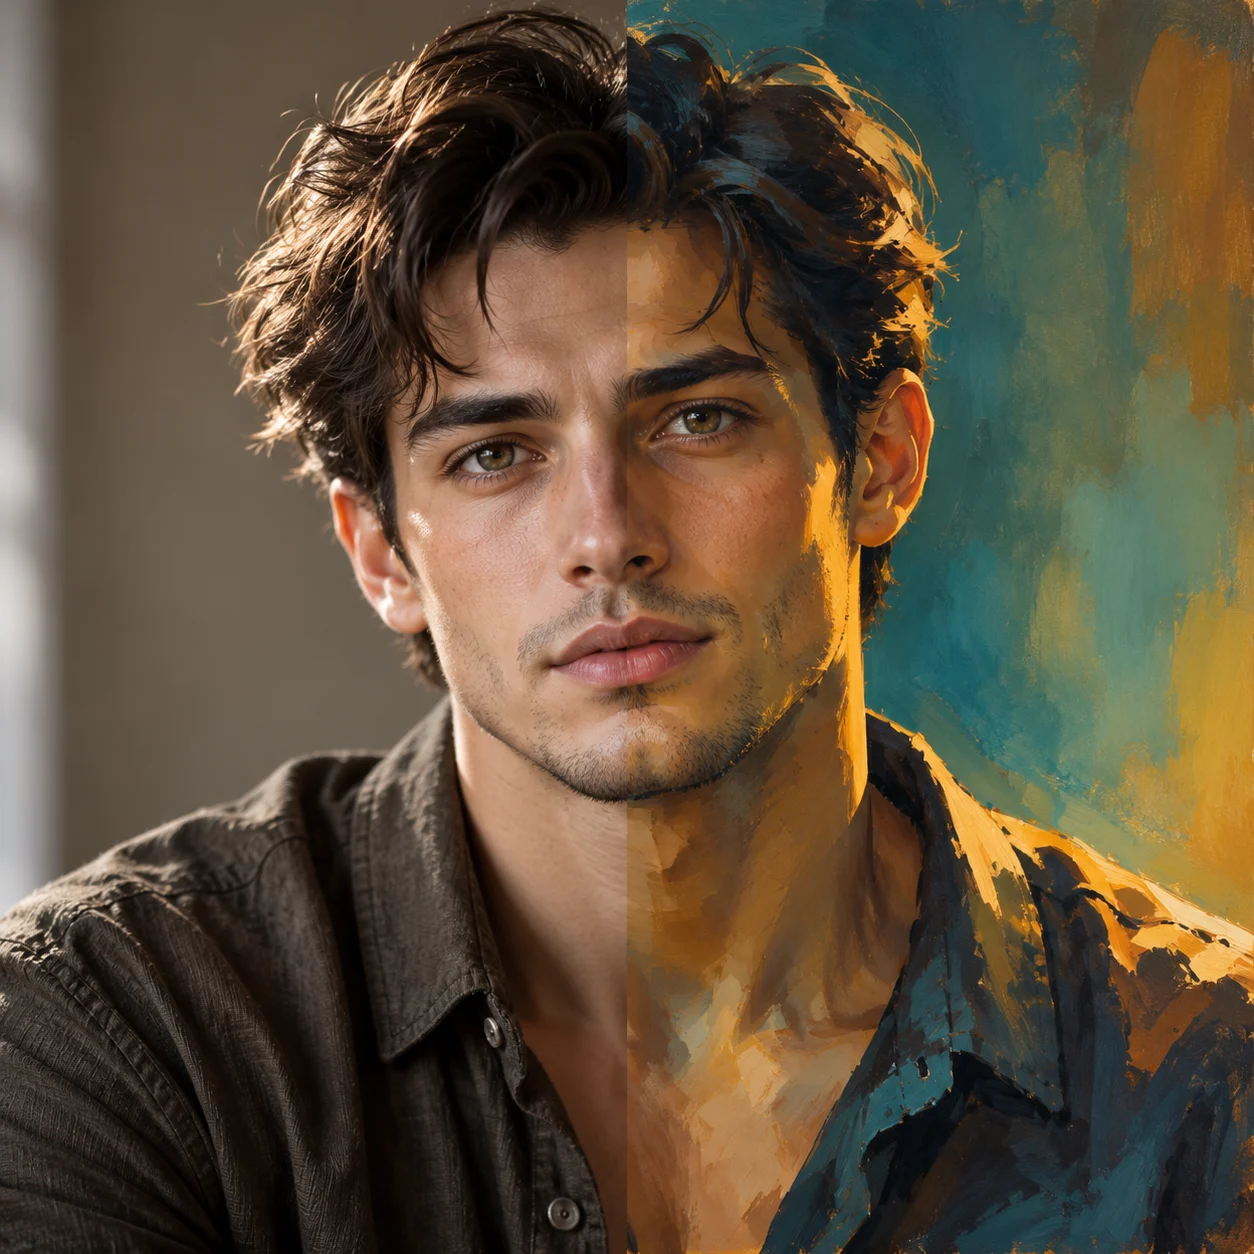
Comparaison des styles de portrait gpt-image-2 : prompts réalistes et artistiques
Style Photographie de portrait · Photoréalisme · Référence des prompts
Prompt
Démonstration de portrait carré 1:1, présentant côte à côte deux intentions stylistiques : photographie réaliste et art pictural. La moitié photographie réaliste : portrait en gros plan de trois quarts d'un jeune adulte, texture de peau naturelle, pores visibles et fin duvet facial, lumière douce et diffuse de fenêtre venant de la gauche de l'appareil, transition douce vers un fond neutre gris chaud sans couture, effet d'objectif 85 mm et faible profondeur de champ, reflets délicats dans les yeux, tenue aux tons terreux discrets, expression calme et neutre, plage dynamique élevée, étalonnage retenu, aucune trace de retouche visible. Variante au rendu pictural : même sujet, rendu avec des coups de pinceau visibles, palette saturée de bleu-vert et d'ambre, lumière de contour sculpturale accompagnée de masses d'ombres douces, fond simplifié en larges champs de couleur, bords expressifs. Composition équilibrée, sujet centré avec de l'espace au-dessus de la tête, mise au point nette sur les yeux, image propre et non encombrée, adaptée comme référence de portrait commercial.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
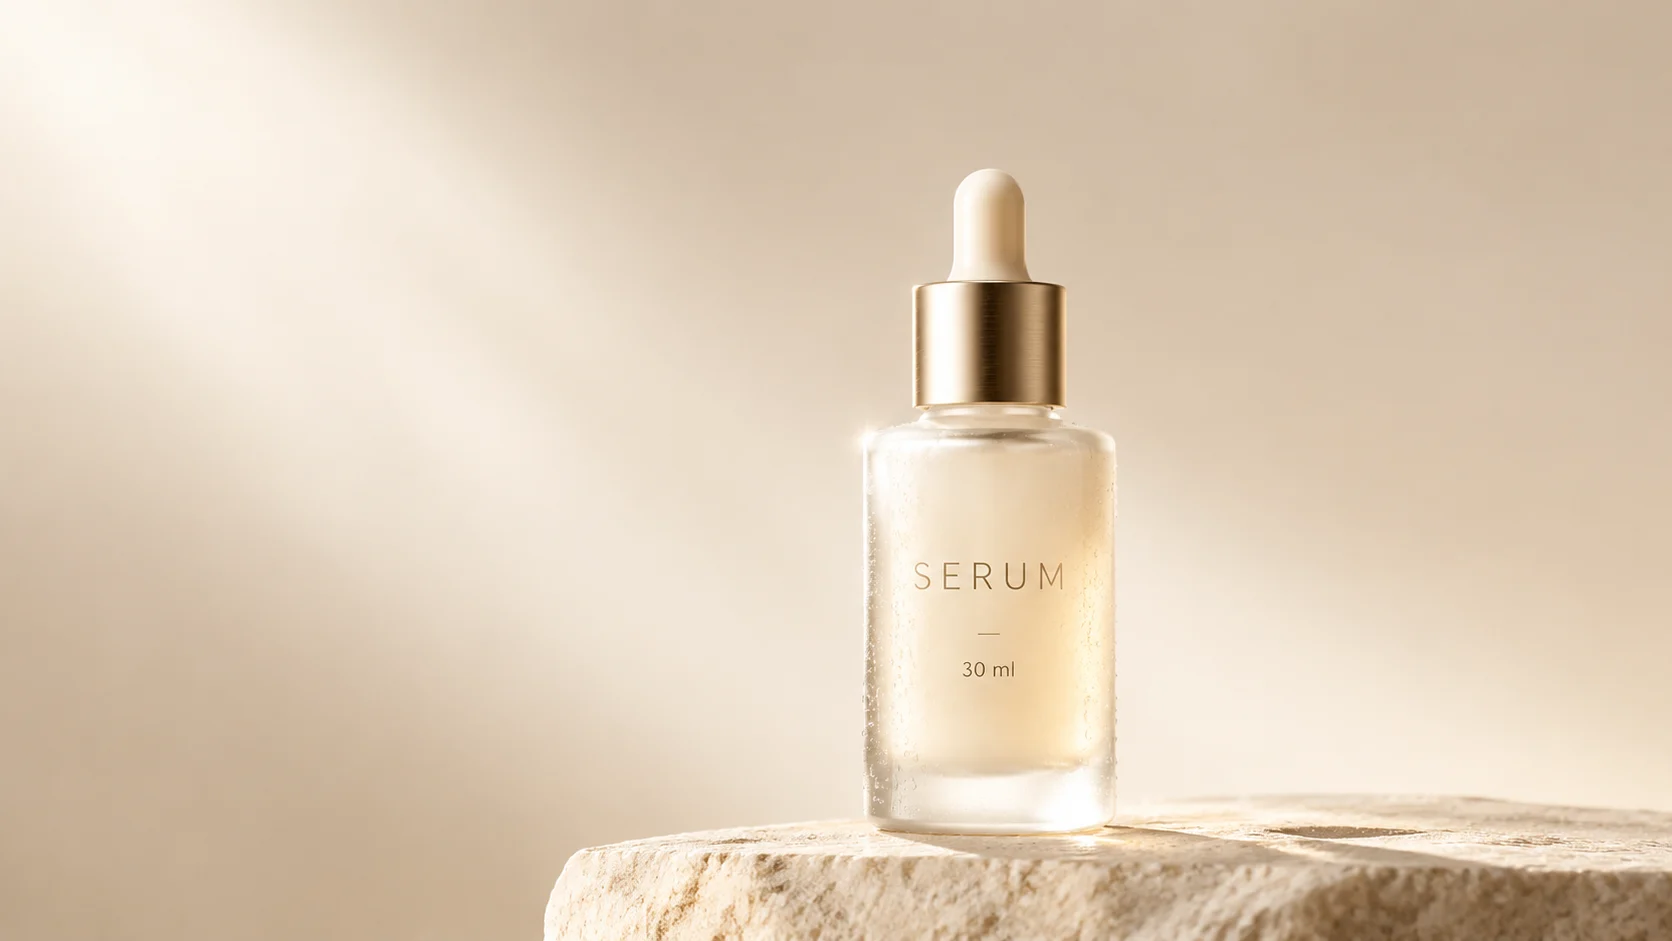
Photographie de produit de niveau e-commerce : pratique des prompts de génération d'images avec gpt-image-2
Style Image produit · e-commerce · Éclairage de studio
Prompt
Une image de photographie publicitaire de produit : un flacon unique de sérum de soin pour la peau placé au centre sur un socle en pierre mate, avec en arrière-plan une toile de fond de studio sans couture blanc cassé doux et chaleureux. Le flacon en verre dépoli est doté d'un capuchon compte-gouttes en champagne doré brossé, le corps du flacon présente de légères traces de condensation, et le bord gauche offre un reflet net et propre ; sur l'étiquette figure l'inscription « SERUM » en fines lettres majuscules sans empattement, au-dessous de laquelle se trouve une petite ligne « 30 ml », parfaitement lisible. Éclairage : en haut à gauche, une grande boîte à lumière douce sert de lumière principale ; à l'arrière droit, une lumière de contour étroite souligne la silhouette ; l'arrière-plan présente un dégradé doux et atténué, sans ombres dures. Prise de vue sous un angle aux trois quarts légèrement en contre-plongée, offrant le rendu d'un objectif équivalent 85 mm, avec une faible profondeur de champ qui garde le capuchon et l'étiquette nets tandis que l'arrière-plan est doucement flouté. Palette limitée à l'ivoire, au beige chaud et au champagne doré ; un espace négatif généreux est laissé en haut pour y placer du texte. Réalisme photographique, plage dynamique élevée, retouche propre et soignée, qualité de niveau e-commerce, composition horizontale 16:9.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
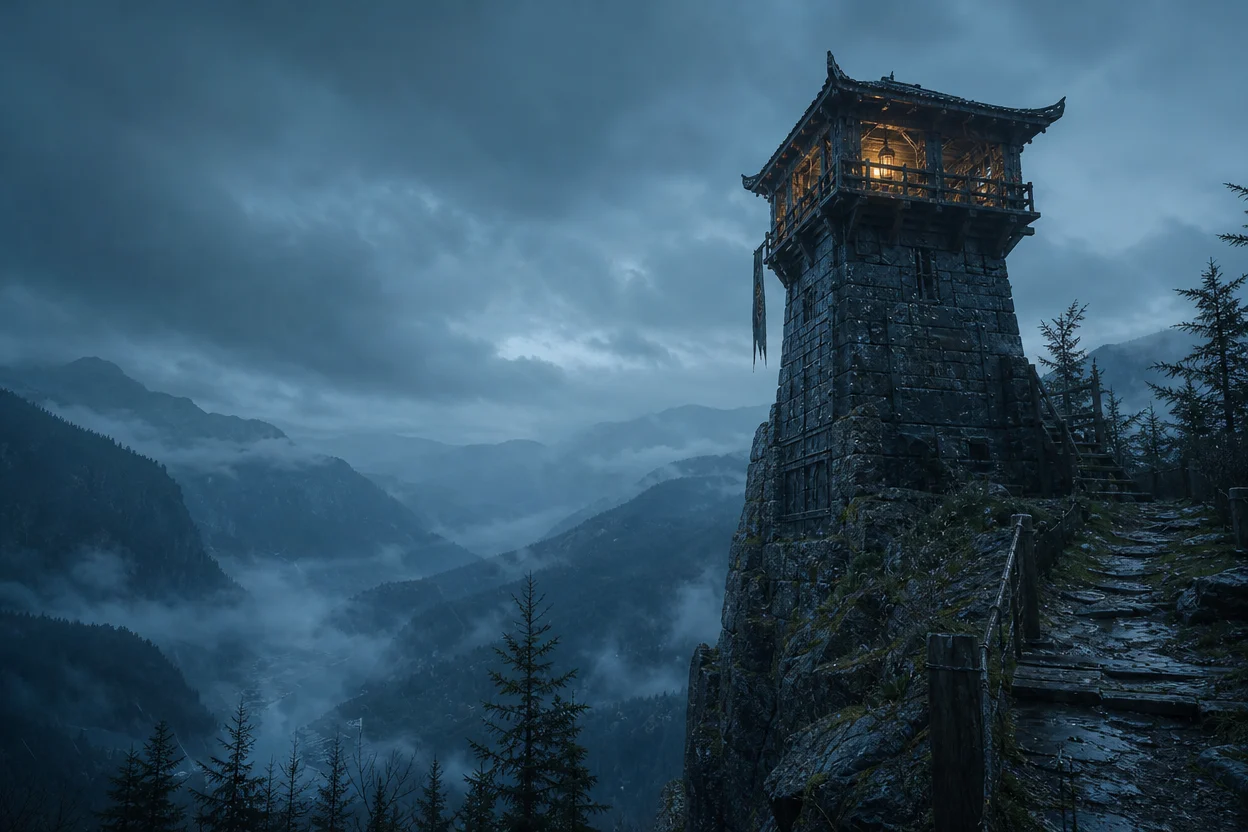
Conception visuelle de scénario de worldbuilding : exploration visuelle atmosphérique
Style Art conceptuel · Construction de l'univers · Cinématographique
Prompt
Concept art cinématographique en écran large : à l'heure bleue, une tour de guet solitaire en pierre altérée par les intempéries se dresse au sommet d'une falaise, dominant une vaste vallée noyée de brouillard. La tour est bâtie d'ardoises empilées en couches, serties de rivets de fer, avec de la mousse dans les fissures et une lanterne chaude luisant à la fenêtre de l'étage supérieur. Un brouillard bas roule en volutes entre les crêtes, s'estompant progressivement en silhouettes blafardes. Palette froide et désaturée de bleu-vert et de bleu indigo profond, la lanterne apportant la seule touche d'ambre chaud, doux faisceaux volumétriques, fines poussières et bruine flottant dans l'air. Composition ultra-large 21:9, forte stratification de la profondeur du premier plan à l'arrière-plan, contre-plongée légère depuis un point de vue bas vers la tour, composition selon la règle des tiers, détails réalistes des matériaux de pierre et de bois mouillé, grain de pellicule subtil, sans texte, sans logo.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
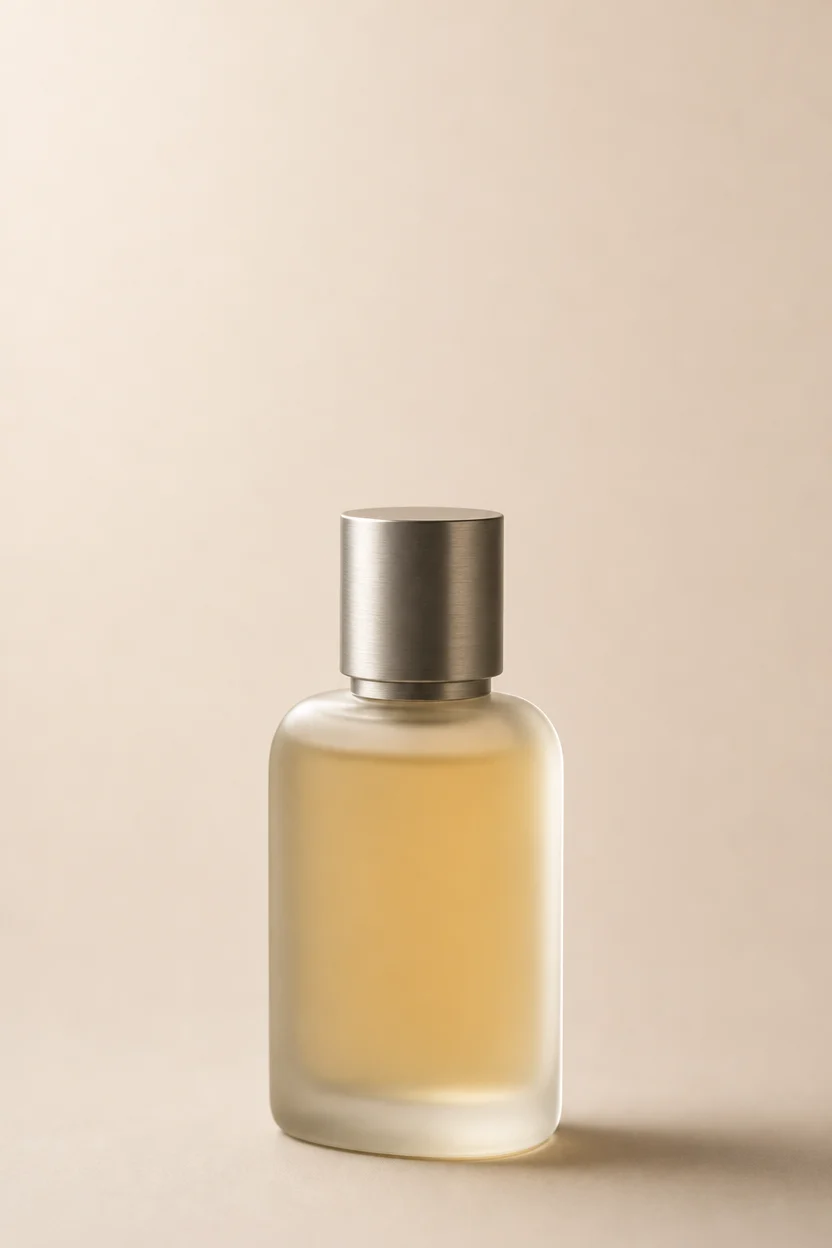
Photographie produit de niveau e-commerce : décomposition du prompt gpt-image-2
Style Image produit · ecommerce · Éclairage de studio
Prompt
Photographie produit en studio d'un flacon de parfum en verre dépoli, avec un bouchon en métal brossé mat, centré sur un fond en toile sans couture blanc cassé chaleureux. Rendu d'appareil photo moyen format, objectif macro 100 mm, léger angle de trois quarts, hauteur d'appareil au niveau de l'étiquette. Grande boîte à lumière douce en lumière principale en haut à gauche, formant le long du bord du flacon un dégradé de hautes lumières doux ; une subtile lumière de contour à droite détache le verre de l'arrière-plan ; panneau diffuseur doux à gauche. Lumière réaliste traversant le verre dépoli, avec une faible lueur ambrée du liquide, transitions précises de reflets spéculaires, ombre de contact subtile ancrant fermement le flacon sur la surface. Étalonnage neutre et propre, contraste doux, sans halo prononcé. Faible profondeur de champ, plan de l'étiquette d'une netteté extrême, arrière-plan joliment flouté. Tiers supérieur laissé avec un espace négatif suffisant pour une mise en page ultérieure, aucun autre élément dans l'image, aucun texte, aucun filigrane, qualité d'image principale e-commerce commerciale, composition verticale 4:5.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
gpt-image-2/text-to-image per image
| Spécifications | Prix unitaire |
|---|---|
| 1K | $0.030 |
| 2K | $0.040 |
| 4K | $0.060 |
gpt-image-2/text-to-image @beta per image
| Spécifications | Prix unitaire |
|---|---|
| With Reference Resources | $0.020 |
gpt-image-2/text-to-image @ext per image
Présentation du positionnement
gpt-image-2 est le modèle de génération d'images à partir de texte d'OpenAI, destiné aux développeurs qui ont besoin de produire de manière fiable des visuels de qualité professionnelle. Il excelle à respecter les multiples contraintes d'un prompt complexe, conserve une bonne propreté typographique dans les affiches, packagings et mises en page contenant du texte, et prend en charge des résolutions allant de 1K à 4K ainsi que divers formats d'image. Il suffit de transmettre un prompt via l'interface unifiée de HiAPI.ai pour générer une image, ce qui convient aux équipes souhaitant intégrer la génération d'images dans leurs outils de design, leurs pipelines de supports marketing ou leur back-office de production de contenu.
Points forts essentiels
- Bonne fidélité aux prompts complexes — héritant de la compréhension sémantique de la série GPT, il génère des images conformes à l'intention même face à des prompts combinant sujet, style, texte et contraintes de mise en page.
- Rendu plus fiable des images contenant du texte — il offre une bonne restitution et une bonne composition du contenu textuel des enseignes, packagings et mises en page, réduisant les retouches de texte après génération.
- Large couverture des résolutions et des formats — prise en charge des sorties 1K, 2K et 4K ainsi que de plus de dix ratios allant de 1:1 à 21:9, pour s'adapter en une seule intégration à de multiples formats de diffusion.
- Plusieurs versions produites en un seul appel — possibilité de générer plusieurs images à la fois, facilitant la comparaison de variantes et l'exploration de styles à partir d'un même prompt.
Description des capacités
Génération d'images à partir de prompts textuels : il suffit de transmettre un prompt de 20000 caractères maximum pour générer une image, ce qui permet de convertir directement une description en langage naturel en visuel exploitable.
Sorties multi-résolutions et multi-formats : choix entre 1K, 2K et 4K, et sélection du ratio horizontal ou vertical selon l'emplacement de diffusion ; le ratio auto et les ratios extrêmes comme 9:21 ou 3:1 sont limités à 1K, et le 1:1 ne prend pas en charge le 4K.
Sortie sur fond transparent : le paramètre background prend en charge trois modes — auto, opaque et transparent ; une image sur fond transparent peut être directement utilisée pour la composition et la superposition, ce paramètre n'étant effectif qu'en 1K.
Rendu du texte et de la mise en page : bonne restitution et bonne composition des images mêlant texte et visuel, adapté aux visuels commerciaux nécessitant un rendu finalisé.
Plusieurs résultats renvoyés en une fois : un seul prompt peut produire plusieurs images de style cohérent, facilitant la comparaison rapide des versions et la sélection des meilleures.
Cas d'usage
- Équipes marketing : affiches publicitaires et visuels principaux — saisir le thème de la campagne et les exigences de mise en page pour produire des visuels principaux de campagne directement diffusables ou à retoucher ensuite.
- E-commerce : images produit et rendu de style photographique — générer des images produit de style photographique à partir d'une description de produit, pour les pages de détail, les visuels de rayon et les supports sociaux.
- Équipes design : packagings et maquettes avec texte — saisir les textes et la relation texte-image pour produire des maquettes de packaging, d'enseigne et de mise en page contenant du texte multilingue.
- Plateformes de contenu : itérations multi-versions — générer des images en lot à partir d'un même prompt pour explorer des styles, puis soumettre les variantes candidates à validation avant la version finale.
Limites et conseils de choix
Le modèle produit uniquement des images et ne prend pas en charge d'autres modalités comme la vidéo. La vitesse de génération est évaluée comme moyenne par l'éditeur, ce qui le rend inadapté aux scénarios interactifs en temps réel très sensibles à la latence ; la haute résolution et la génération par lots allongent à la fois les délais et le coût des appels, un compromis à arbitrer selon le format de diffusion. La relecture humaine reste recommandée pour les visuels contenant du texte précis. Si le besoin penche vers le raisonnement de composition de scènes complexes ou une vitesse de génération extrême, il convient d'évaluer d'autres modèles ; HiAPI.ai propose également une ligne image-vers-image de cette série, à utiliser lorsqu'une image existante doit servir d'entrée. La facturation se fait au nombre d'images, le montant précis étant indiqué dans le panneau de tarifs.
Nouveautés
Voir le journal des modifications →- Changement de paramètre gpt-image-2 ajoute des paliers de résolution 1K / 2K / 4K
Questions fréquentes
Voir toutes les questions →-
Qu'est-ce que GPT Image 2 ?
GPT Image 2 est le modèle de génération d'images à partir de texte d'OpenAI, adapté à la création d'affiches, de fiches de connaissances, de visuels produits et à la génération d'images comportant des exigences précises de texte et de mise en page.
-
GPT Image 2 et GPT Image 2.0 sont-ils le même modèle ?
GPT Image 2.0 est un raccourci de recherche courant ; utilisez l'ID de modèle exact indiqué sur la page GPT Image 2 et dans la documentation de l'API.
-
Quels point de terminaison et ID de modèle l'API GPT Image 2 utilise-t-elle ?
Envoyez une requête POST /v1/tasks, définissez model sur gpt-image-2/text-to-image pour la génération d'images à partir de texte, et transmettez prompt, aspect_ratio et resolution dans input. L'API renvoie d'abord un taskId, puis l'image finale est obtenue via l'interrogation de la tâche ou un callback.
-
Comment utiliser GPT Image 2 ?
Dans le Playground, décrivez le sujet, la scène, la mise en page et le texte qui doit apparaître, puis choisissez le format, la résolution et l'arrière-plan, cliquez sur Exécuter et consultez le résultat.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : gpt-image-2/text-to-image
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour gpt-image-2/text-to-image et la route default — voir le tableau des paramètres ci-dessous.
promptstringRequisminLength 1maxLength 20000Texte d'invite, obligatoire, longueur maximale de 20 000 caractères.
backgroundstringOptionnelMode d'arrière-plan, ce paramètre n'est pris en charge qu'en résolution 1K.
autoopaquetransparentresolutionstringOptionnelDéfaut: "1K"Résolution de l'image générée, 1K par défaut. Lorsque aspect_ratio vaut auto, seule la résolution 1K est prise en charge ; le format 1:1 ne prend pas en charge la 4K ; lorsque aspect_ratio vaut 3:1/1:3/9:21, seule la résolution 1K est prise en charge ; lorsque background vaut auto/opaque/transparent, seule la résolution 1K est prise en charge.
1K2K4Kaspect_ratiostringOptionnelDéfaut: "auto"Rapport largeur-hauteur de l'image générée, auto par défaut. S'il est omis ou défini sur auto, seule la résolution 1K est prise en charge.
auto1:13:22:34:33:45:44:5Tout afficher (8)
16:99:162:11:23:11:321:99:21callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentmodelstringRequisValeur fixe actuelle : gpt-image-2/text-to-image
routestringOptionnelValeur fixe actuelle : beta
inputobjectRequis
Objet de paramètres métier pour gpt-image-2/text-to-image et la route beta — voir le tableau des paramètres ci-dessous.
sizestringOptionnelDéfaut: "auto"pattern ^(auto|[1-9][0-9]{2,4}x[1-9][0-9]{2,4})$Output image size. Use auto or a compliant WIDTHxHEIGHT value such as 2048x2048.
promptstringRequismaxLength 20000Text prompt describing the image to generate. Max 20000 characters.
callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentmodelstringRequisValeur fixe actuelle : gpt-image-2/text-to-image
routestringOptionnelValeur fixe actuelle : ext
inputobjectRequis
Objet de paramètres métier pour gpt-image-2/text-to-image et la route ext — voir le tableau des paramètres ci-dessous.
promptstringRequisminLength 1maxLength 20000图像生成提示词 Max 20000 characters.
qualitystringRequisDéfaut: "low"lowmediumhighresolutionstringRequisDéfaut: "1K"1K2K4Kaspect_ratiostringOptionnelDéfaut: "1:1"输出画幅比例
auto1:13:22:34:33:45:44:5Tout afficher (8)
16:99:162:11:23:11:321:99:21callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "gpt-image-2/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "auto"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/text-to-image",
input: {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/text-to-image",
"input": {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
-H "Authorization: Bearer $HIAPI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2/text-to-image@beta",
"input": {
"size": "auto",
"prompt": "…"
}
}'const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/text-to-image@beta",
input: {
"size": "auto",
"prompt": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/text-to-image@beta",
"input": {
"size": "auto",
"prompt": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
-H "Authorization: Bearer $HIAPI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2/text-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"resolution": "1K",
"aspect_ratio": "1:1"
}
}'const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/text-to-image@ext",
input: {
"prompt": "…",
"quality": "low",
"resolution": "1K",
"aspect_ratio": "1:1"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/text-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"resolution": "1K",
"aspect_ratio": "1:1"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Tutoriel pour kandinsky-6.0-pro/image-to-video sur HiAPI : curl + Python
Lancer une requête image-vers-vidéo exploitable sur HiAPI : de l'envoi de la première image à l'interrogation asynchrone jusqu'au téléchargement final
-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment utiliser kling-4.0/text-to-video via l'API HiAPI : curl, Python et un exemple de requête fonctionnel
Guide pratique pour les développeurs : prompts cinématographiques, audio synchronisé, interrogation asynchrone et téléchargement des sorties
-

Comparatif et évaluation
Comparatif horizontal de Recraft v4.1 Flash en génération d'images à partir de texte : guide de sélection et de migration pour les développeurs
Avec un coût de 0,01 $ par image et ses capacités de génération pure à partir de texte, déterminez s'il convient à votre pipeline de génération d'images
-

Tutoriel
Comment appeler kling-4.0/image-to-video sur HiAPI : curl, Python et interrogation périodique
-

Comparatif et évaluation
Comparatif transversal de hailuo-2.3-fast/image-to-video : comment choisir un modèle image-to-video et les points clés de migration
-

Tutoriel
recraft-v4.1-flash génération d'images texte-à-image en pratique : 5 scénarios métier à forte valeur et points d'intégration clés
À partir d'un coût de 0,01 $ par image, planifier le déploiement de la génération d'images dans de vrais contextes métier
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat
Modèles associés
Voir tous les modèles →Même type
-
 Imagen 4 Google $0.030 /image
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /image
-
 Wan 2.7 Image Alibaba $0.035 /image
-
 Ideogram V3 Character Ideogram $0.090 /image
-
 BRIA Eraser Bria $0.058 /image
-
 FLUX 3 Image Black Forest Labs $0.041 /image
-
 Recraft Creative Upscale Recraft $0.357 /image
-
 Nano Banana 2 Lite Google $0.033 /image
-
 GPT Image 2 OpenAI $0.007 /image
-
 Grok Imagine Quality xAI $0.070 /image
-
 FLUX.1 Schnell Black Forest Labs $0.005 /image
-
 Nano Banana 2 Google $0.036 /image


