
OpenAI
GPT Image 2
gpt-image-2/image-to-image
Modèle de génération et d'édition d'images d'OpenAI, axé sur le photoréalisme, le rendu de texte de haute précision et la sortie native en 4K, adapté aux supports commerciaux contenant du texte et aux visuels produits
Essayer gpt-image-2/image-to-image
Entrée
Créations
Voir toutes les créationsSortie
image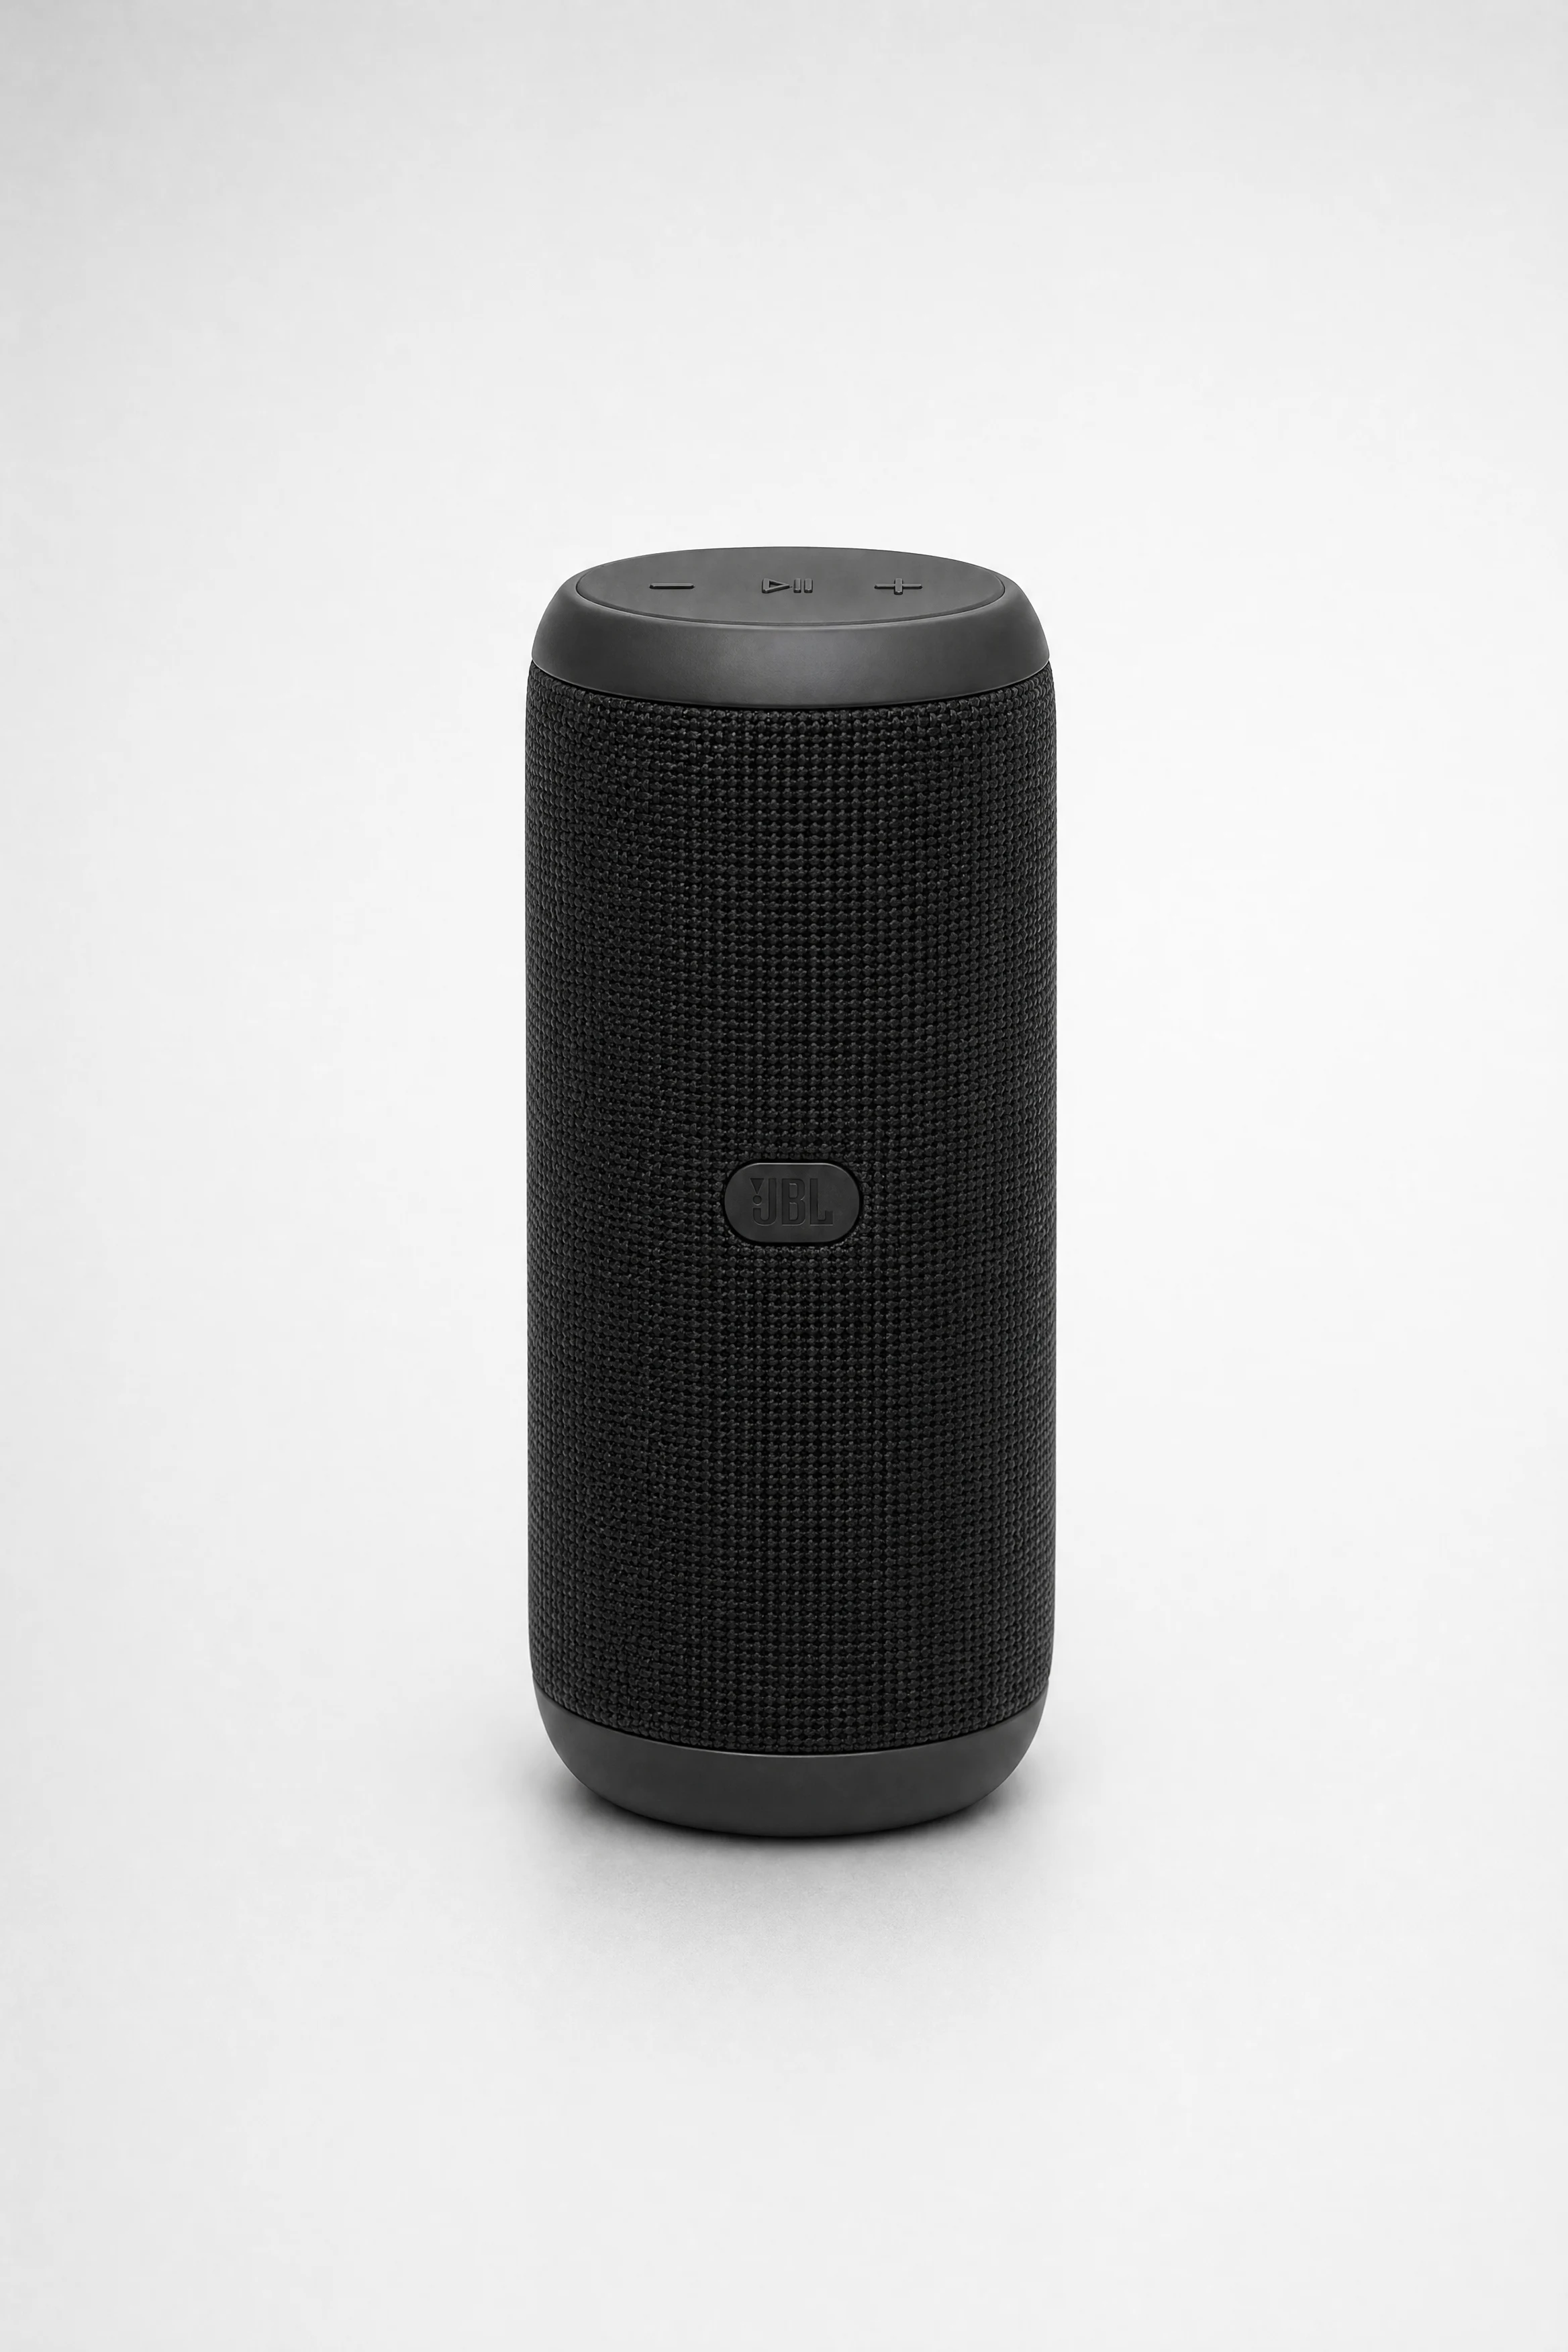
Qualité de la photographie de produits e-commerce : génération commerciale par image à image
Style Image produit · ecommerce · Photoréalisme
Entrées de référence
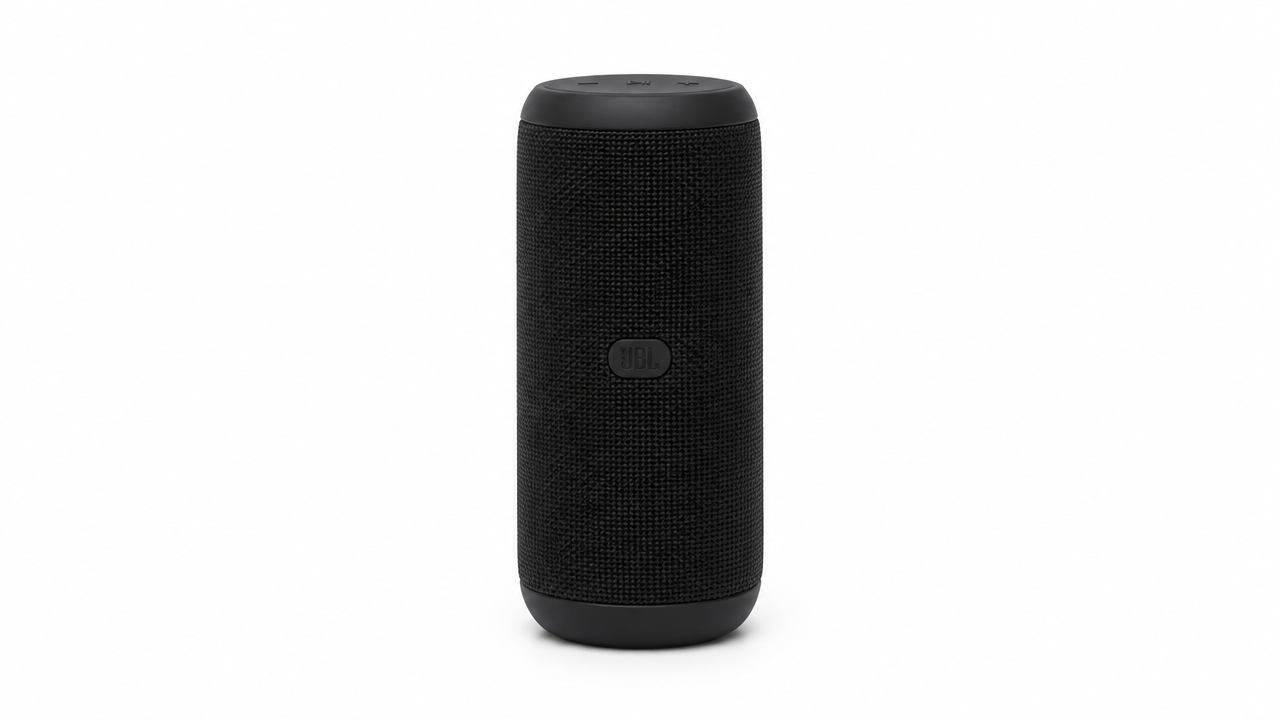
Image de référence
Prompt
Recomposer la photo de produit de référence pour en faire un visuel principal e-commerce haut de gamme. Conserver à l'identique la forme, la couleur, la position du logo et les proportions du produit ; ne rien ajouter ni retirer aux caractéristiques du produit. Remplacer le fond d'origine par un fond de studio dégradé gris clair sans raccord. Utiliser un éclairage à trois softbox : une grande softbox principale à 45 degrés en avant-gauche, un léger éclairage d'appoint à droite, et une lumière de contour étroite sur le bord supérieur, afin de détacher le produit du fond. Préserver la réponse réaliste des matières — les surfaces brillantes présentent des hautes lumières en dégradé doux, les tissus et le caoutchouc une micro-texture mate, le métal une atténuation propre des reflets spéculaires. Ajouter une ombre de contact douce sous le produit, sans ombre portée dure. Cadrer sous un angle de trois quarts légèrement surélevé, avec un objectif équivalent 85 mm, une profondeur de champ assez grande, le produit occupant environ 70 % de l'image et un espace négatif suffisant en haut pour le texte marketing. Qualité de retouche commerciale, couleurs fidèles, aucun accessoire, aucun reflet de studio sur le produit, aucune superposition de texte.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
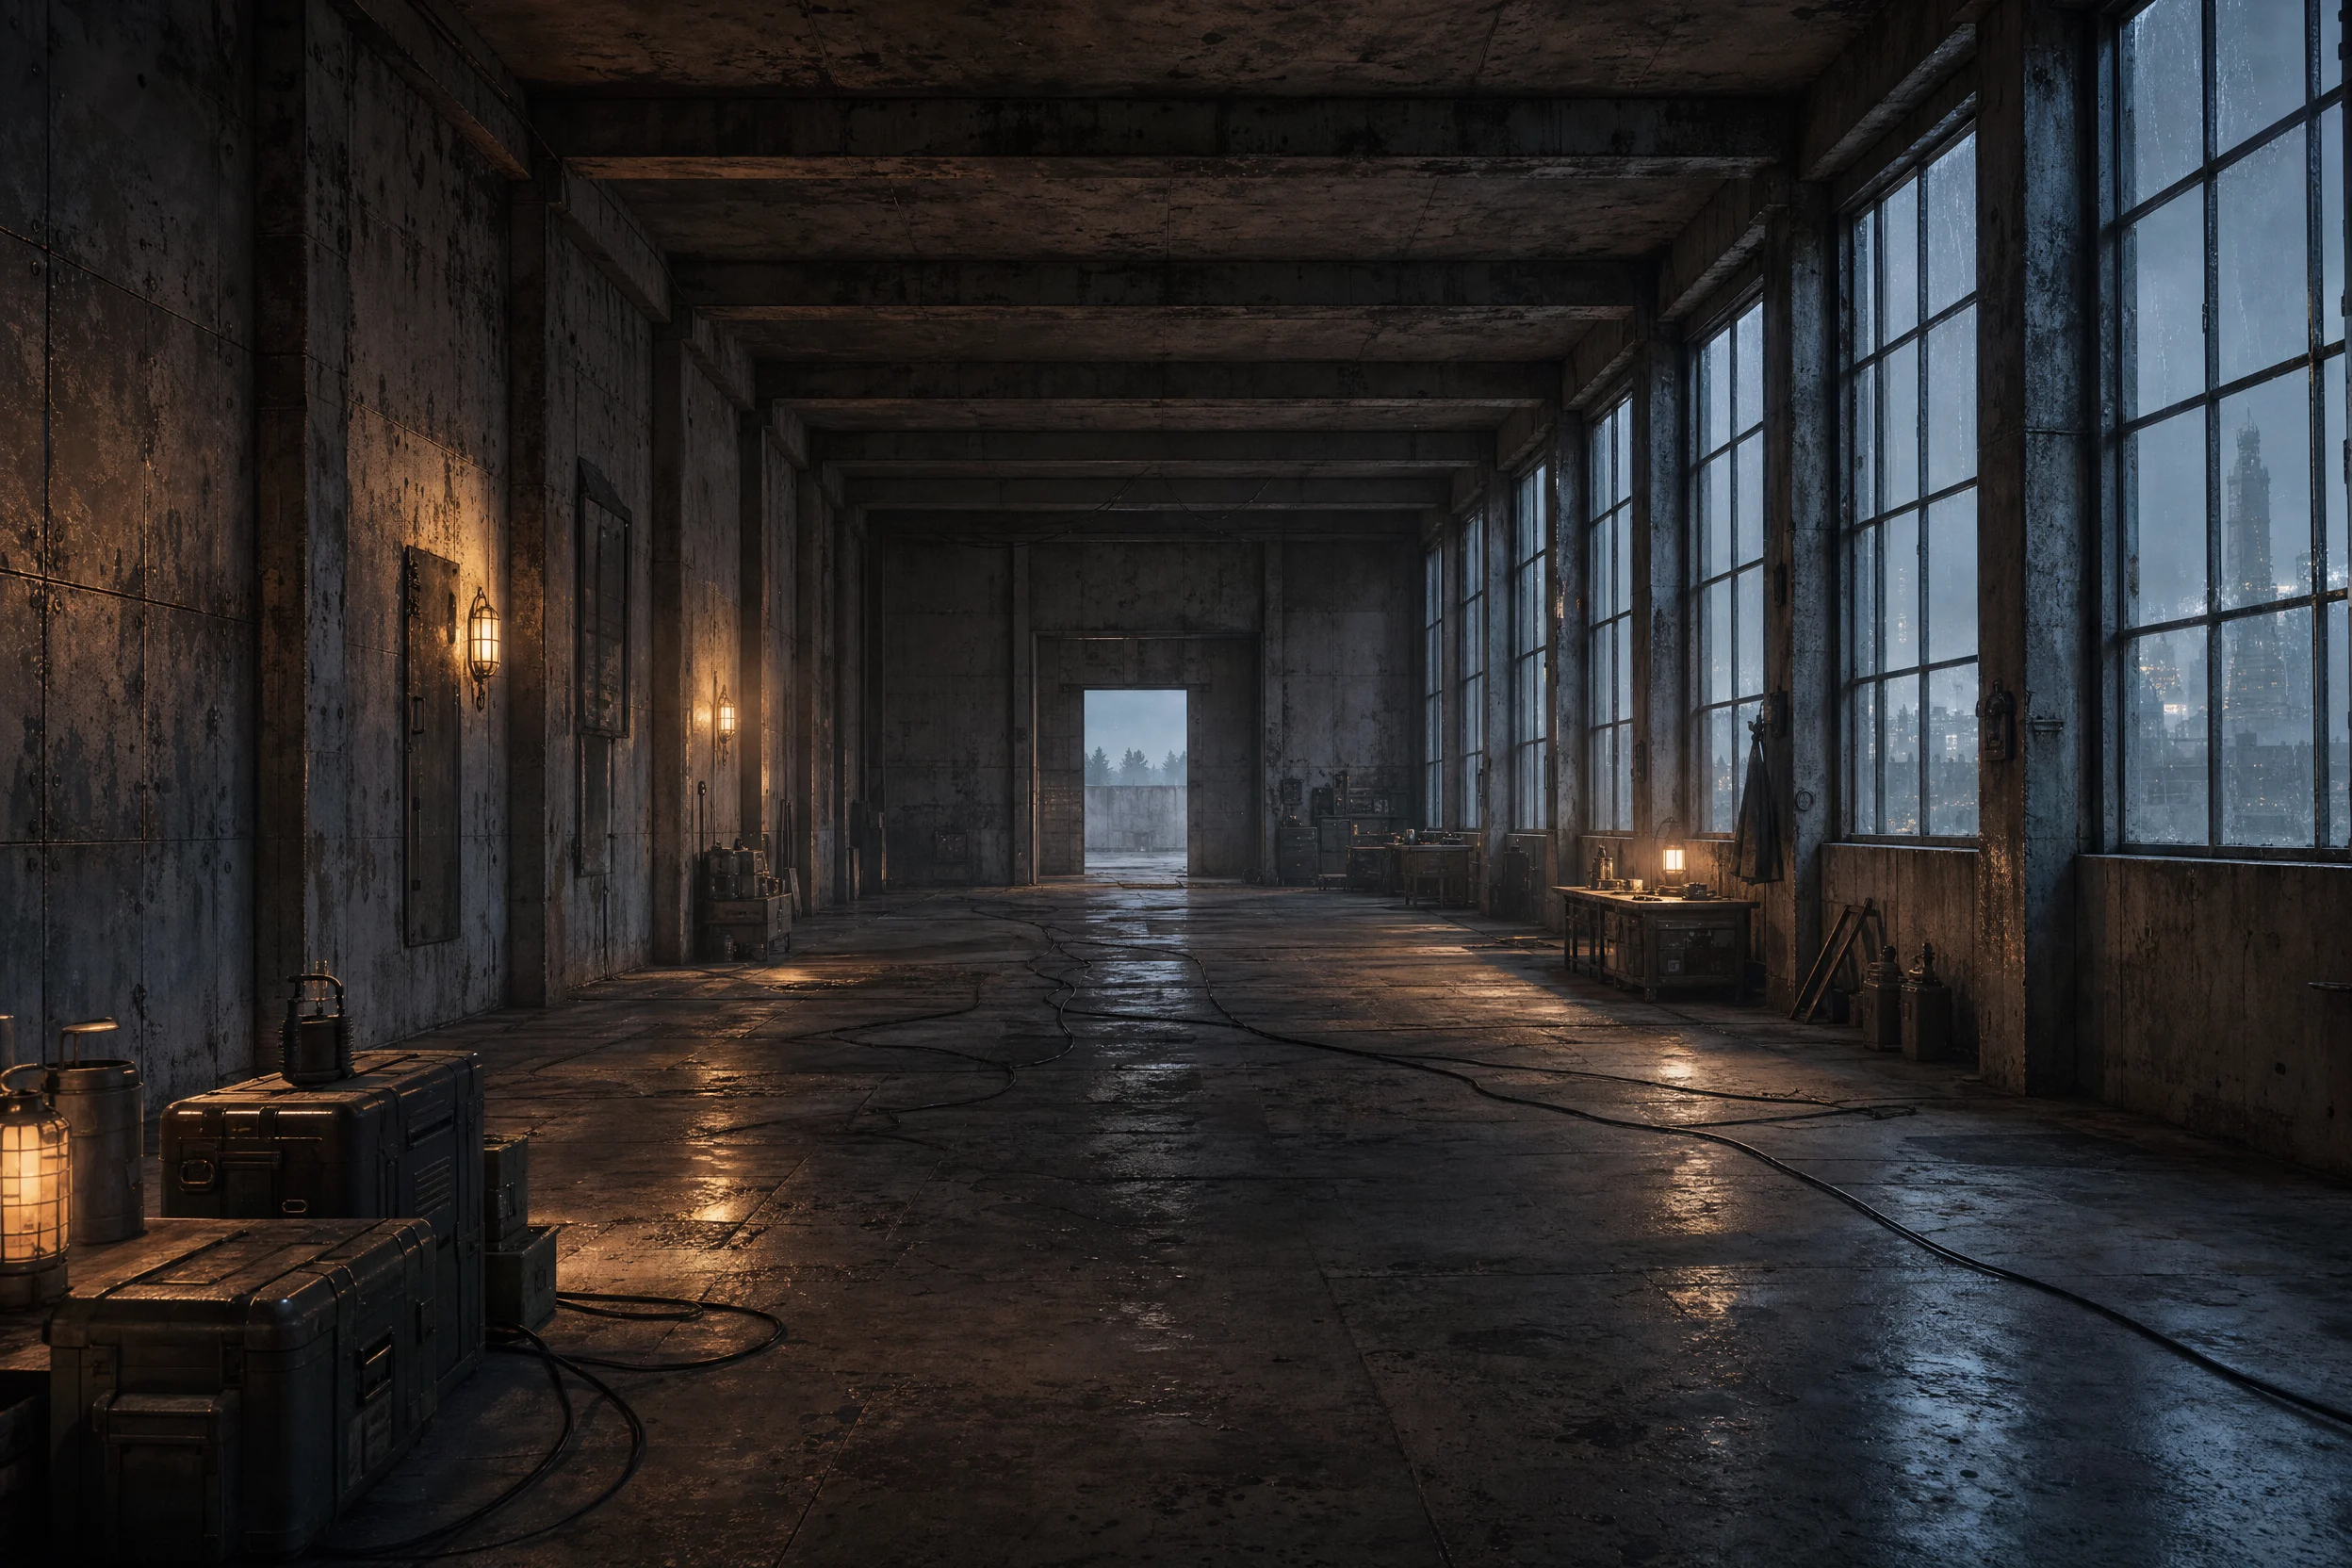
Conception visuelle de scène d'univers : réécriture d'ambiance guidée par une image de référence
Style Art conceptuel · Construction de l'univers · image-edit
Entrées de référence
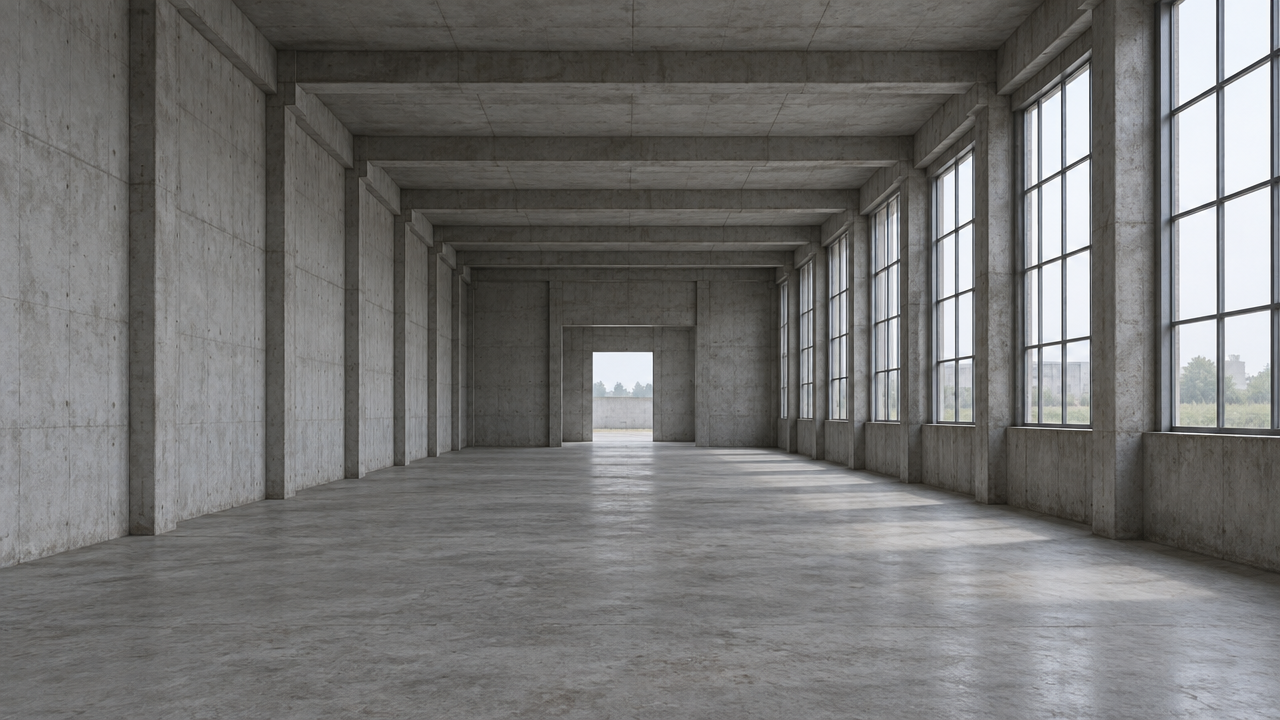
Image de référence
Prompt
Art conceptuel d'univers en image-à-image. Conserver inchangés la position de caméra, la perspective et la disposition des murs et des ouvertures de l'image de référence ; recréer entièrement l'ambiance, les matériaux et l'éclairage. Transformer la scène en un avant-poste de recherche frontalière altéré par le temps, au crépuscule : plaques métalliques rapiécées, rivets oxydés, béton marqué de taches, câbles courant au sol, hautes fenêtres étroites laissant filtrer une lumière extérieure bleu froid, luminaires utilitaires intérieurs d'un ambre chaleureux, poussière volumétrique dans l'air, légère condensation sur les vitres, silhouette de tours en ruine au loin derrière les fenêtres. Composition cinématographique en 16:9, avec des plans avant, intermédiaire et arrière clairement distincts, une forte séparation des valeurs claires et sombres, une palette sobre et désaturée relevée d'une seule touche chaude, un grain de film subtil, une texture picturale d'art conceptuel, sans texte, sans filigrane.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
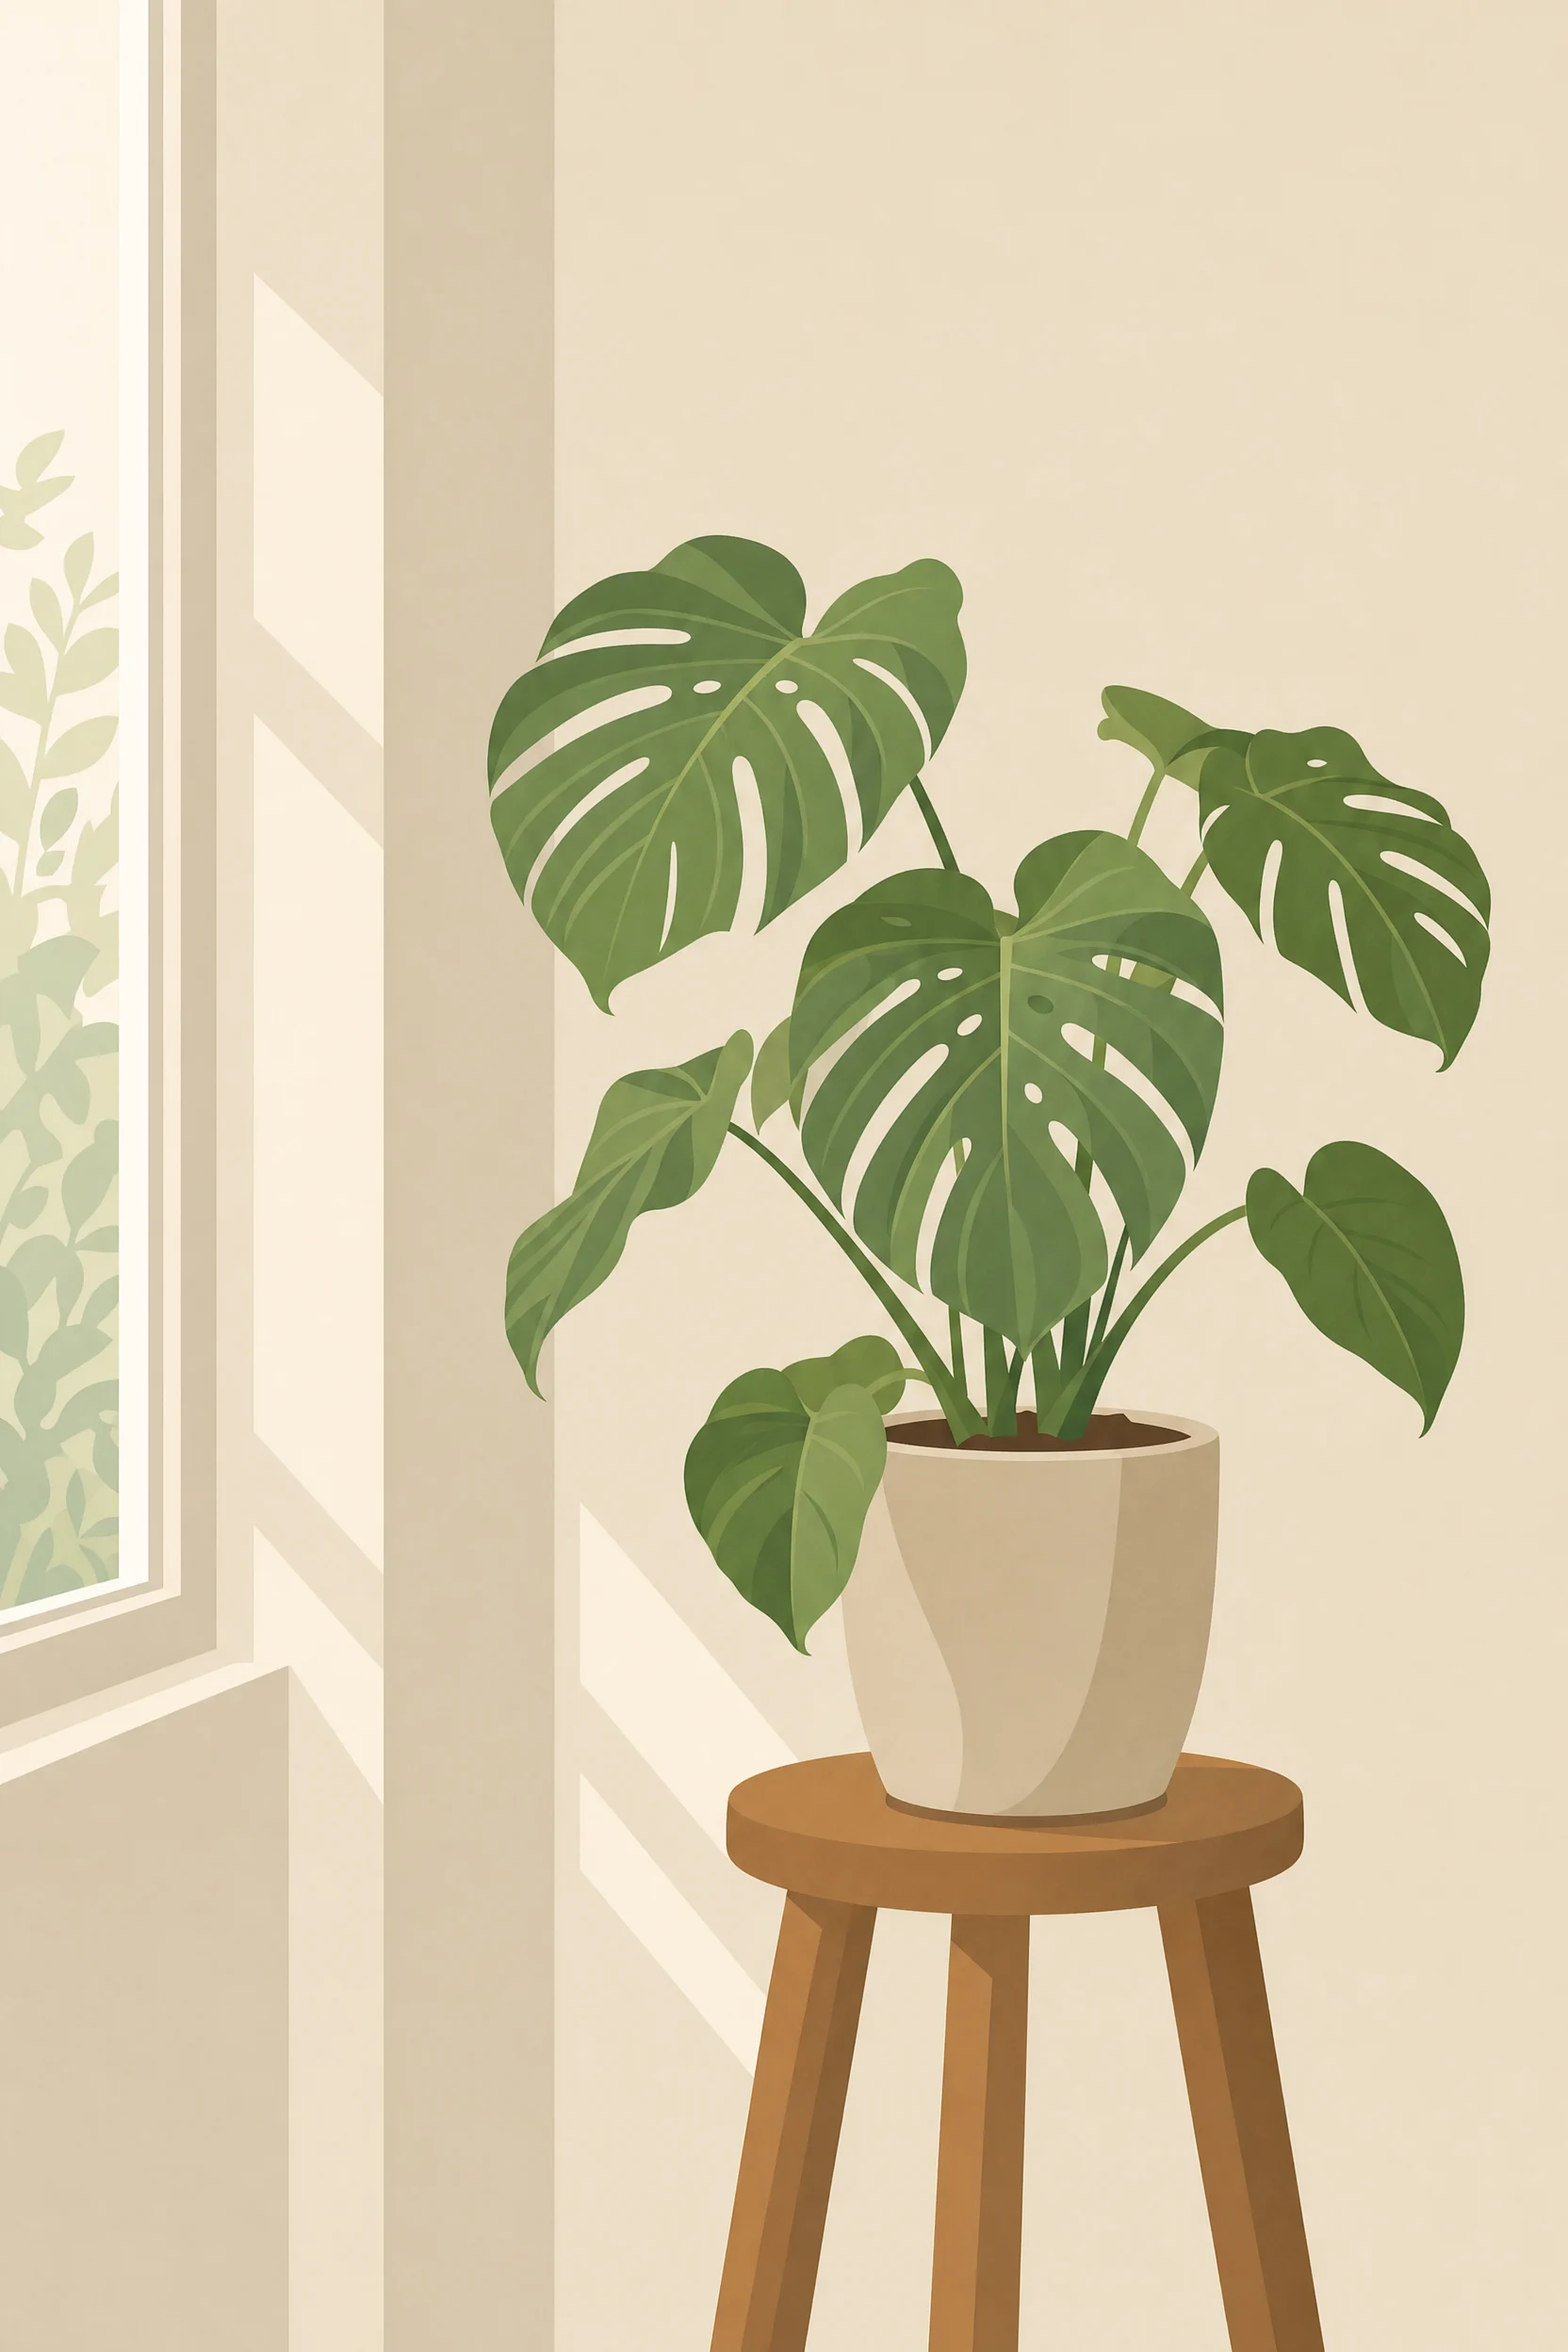
Du réalisme à l'aplat : une illustration en spectre de styles avec gpt-image-2 en image-à-image
Style transfert-de-style · illustration-éditoriale · Design plat
Entrées de référence
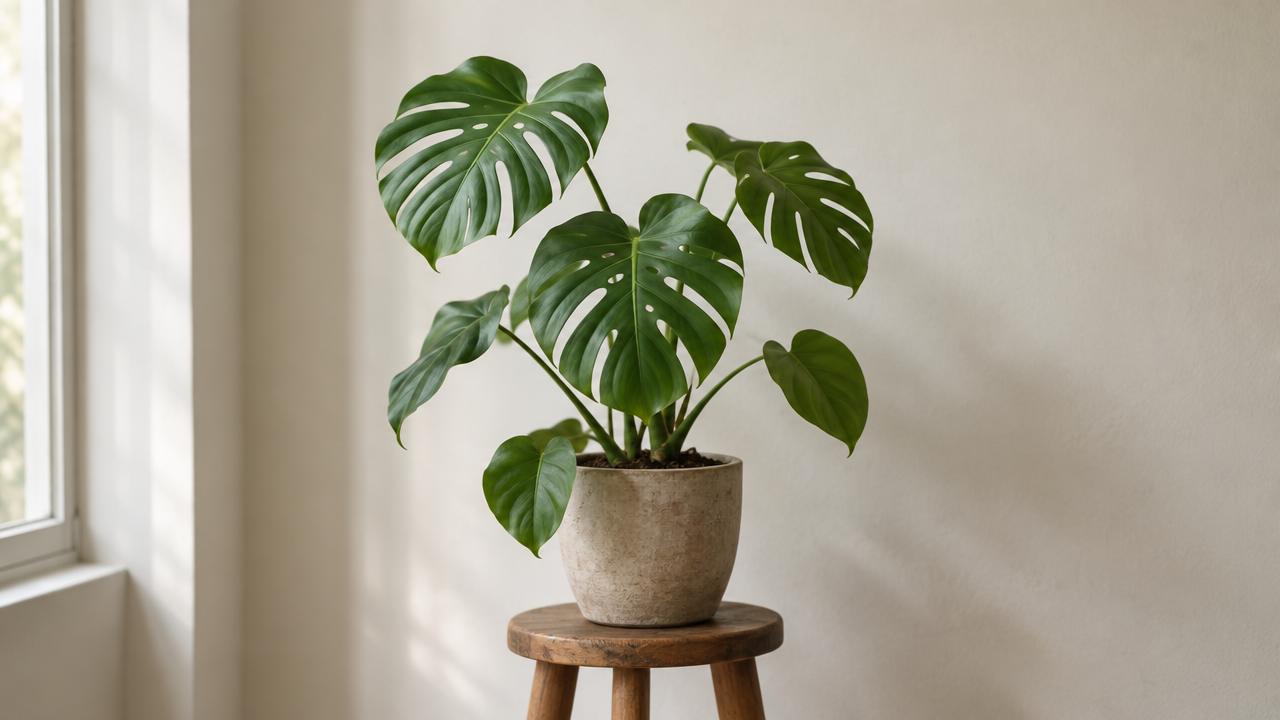
Image de référence
Prompt
Réaliser une migration de style image-à-image sur une photo de référence unique, pour la convertir en illustration éditoriale à plat. Conserver la silhouette du sujet, la position des objets et la composition globale de l'image source ; simplifier progressivement les détails photographiques en formes géométriques épurées, en bords nets de type vectoriel, et en une palette limitée de 5 à 6 couleurs peu saturées avec une touche de couleur chaude. Supprimer le bruit de texture, les dégradés et les reflets de lumière ; remplacer les ombres par des formes en aplats de couleur unie. Composition verticale 4:5, sujet centré avec un espace négatif généreux, suggérant un éclairage doux et uniforme par des aplats plutôt que par un rendu lumineux. Bords nets, aucune ligne de contour plus épaisse qu'un cheveu, aucun grain photoréaliste, et aucun élément supplémentaire ajouté en dehors de la scène source.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
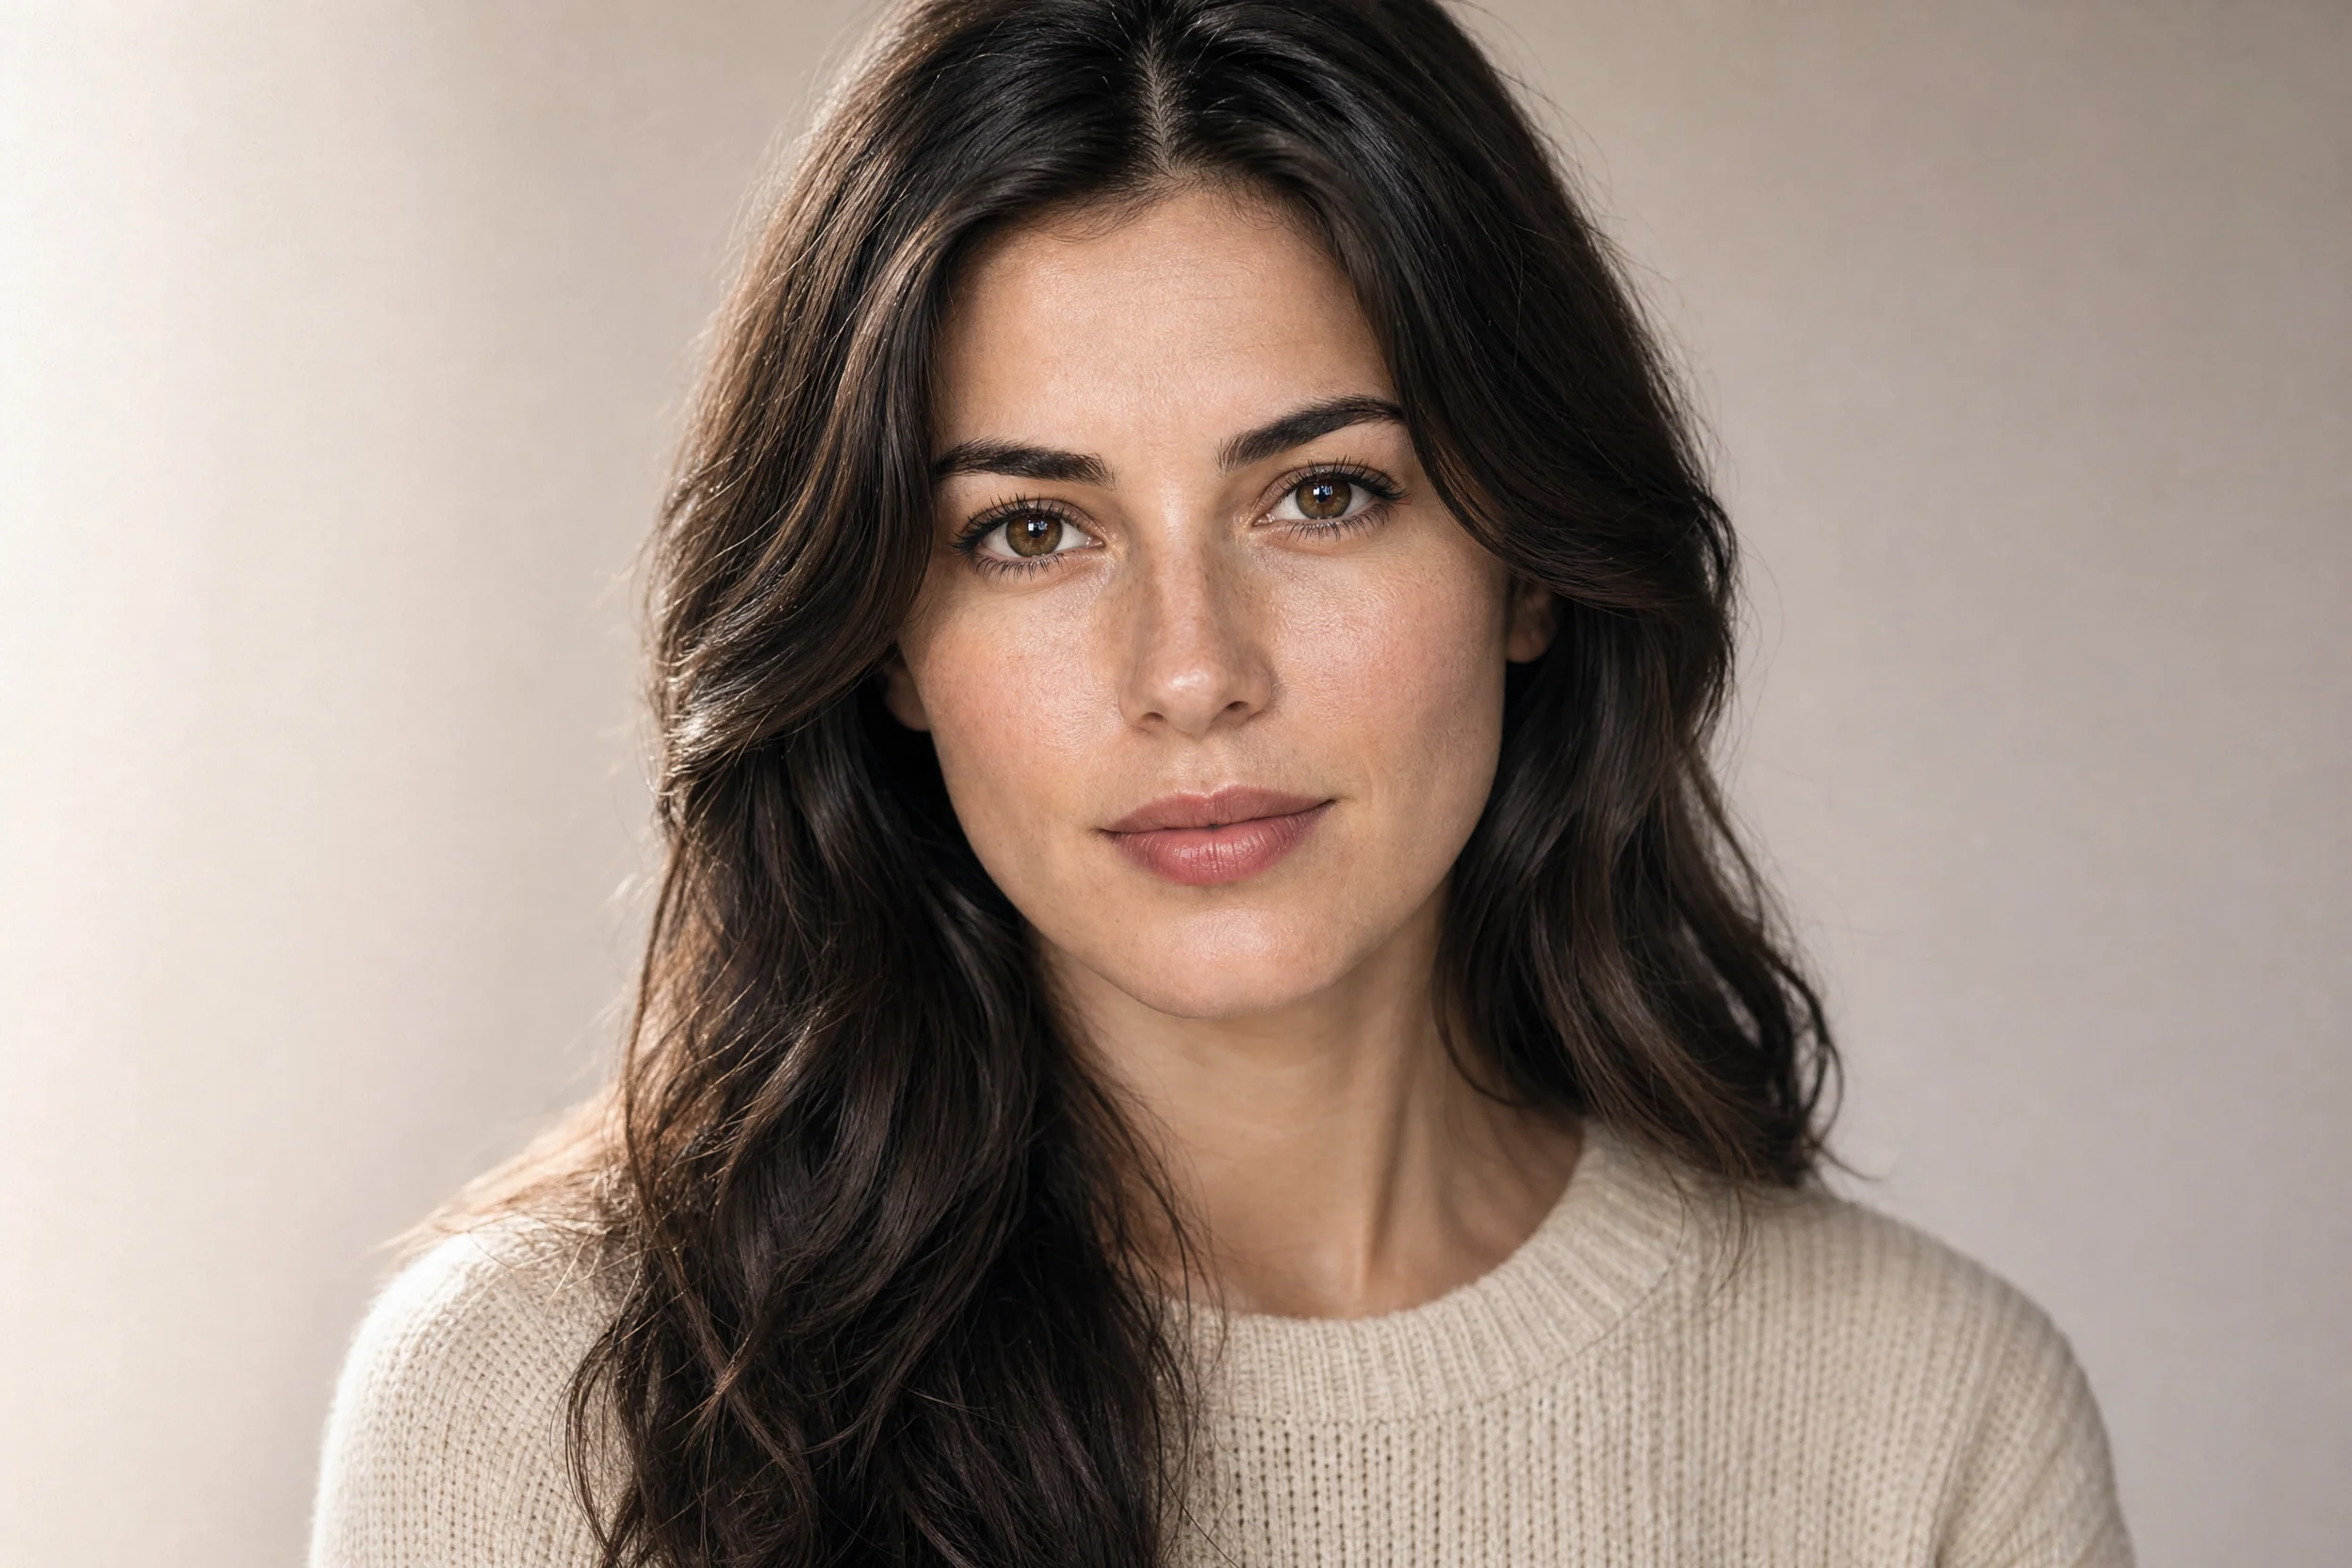
Démonstration de style de portrait image-à-image avec gpt-image-2 : double approche, réalisme et artisticité
Style Portrait et photographie · transfert-de-style · Photographie commerciale
Entrées de référence
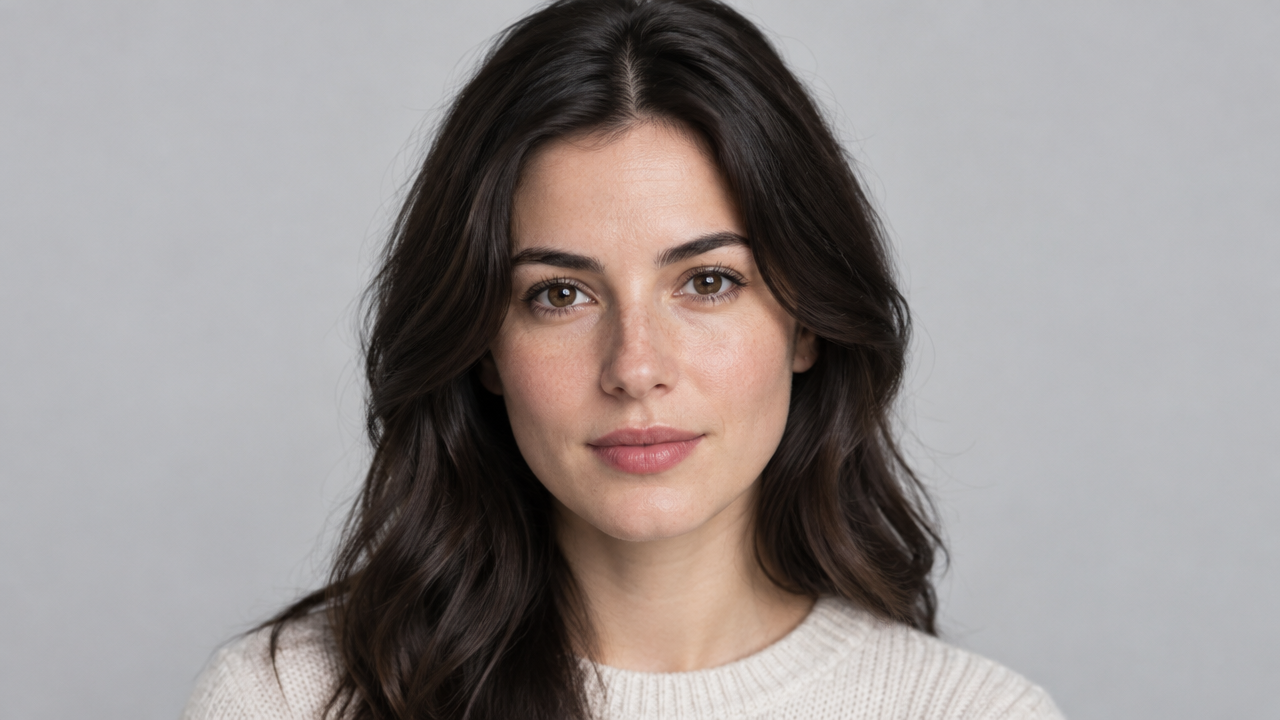
Image de référence
Prompt
Redessin de style de portrait en image-à-image. Conserver l'identité faciale, la pose et la composition du personnage de l'image de référence ; modifier uniquement l'éclairage, l'étalonnage des couleurs et le rendu de surface. Voie réaliste : texture de peau naturelle, pores visibles et fin duvet, lumière de fenêtre directionnelle douce venant de la gauche de l'appareil, transition douce vers les ombres, balance neutre blanc chaud, angle de vue équivalent 85mm, faible profondeur de champ, léger grain de film, rendu de portrait commercial moyen format, fond neutre propre et net. Composition verticale 4:5, cadrage tête et épaules, yeux sur la ligne du tiers supérieur, sans texte, sans filigrane.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
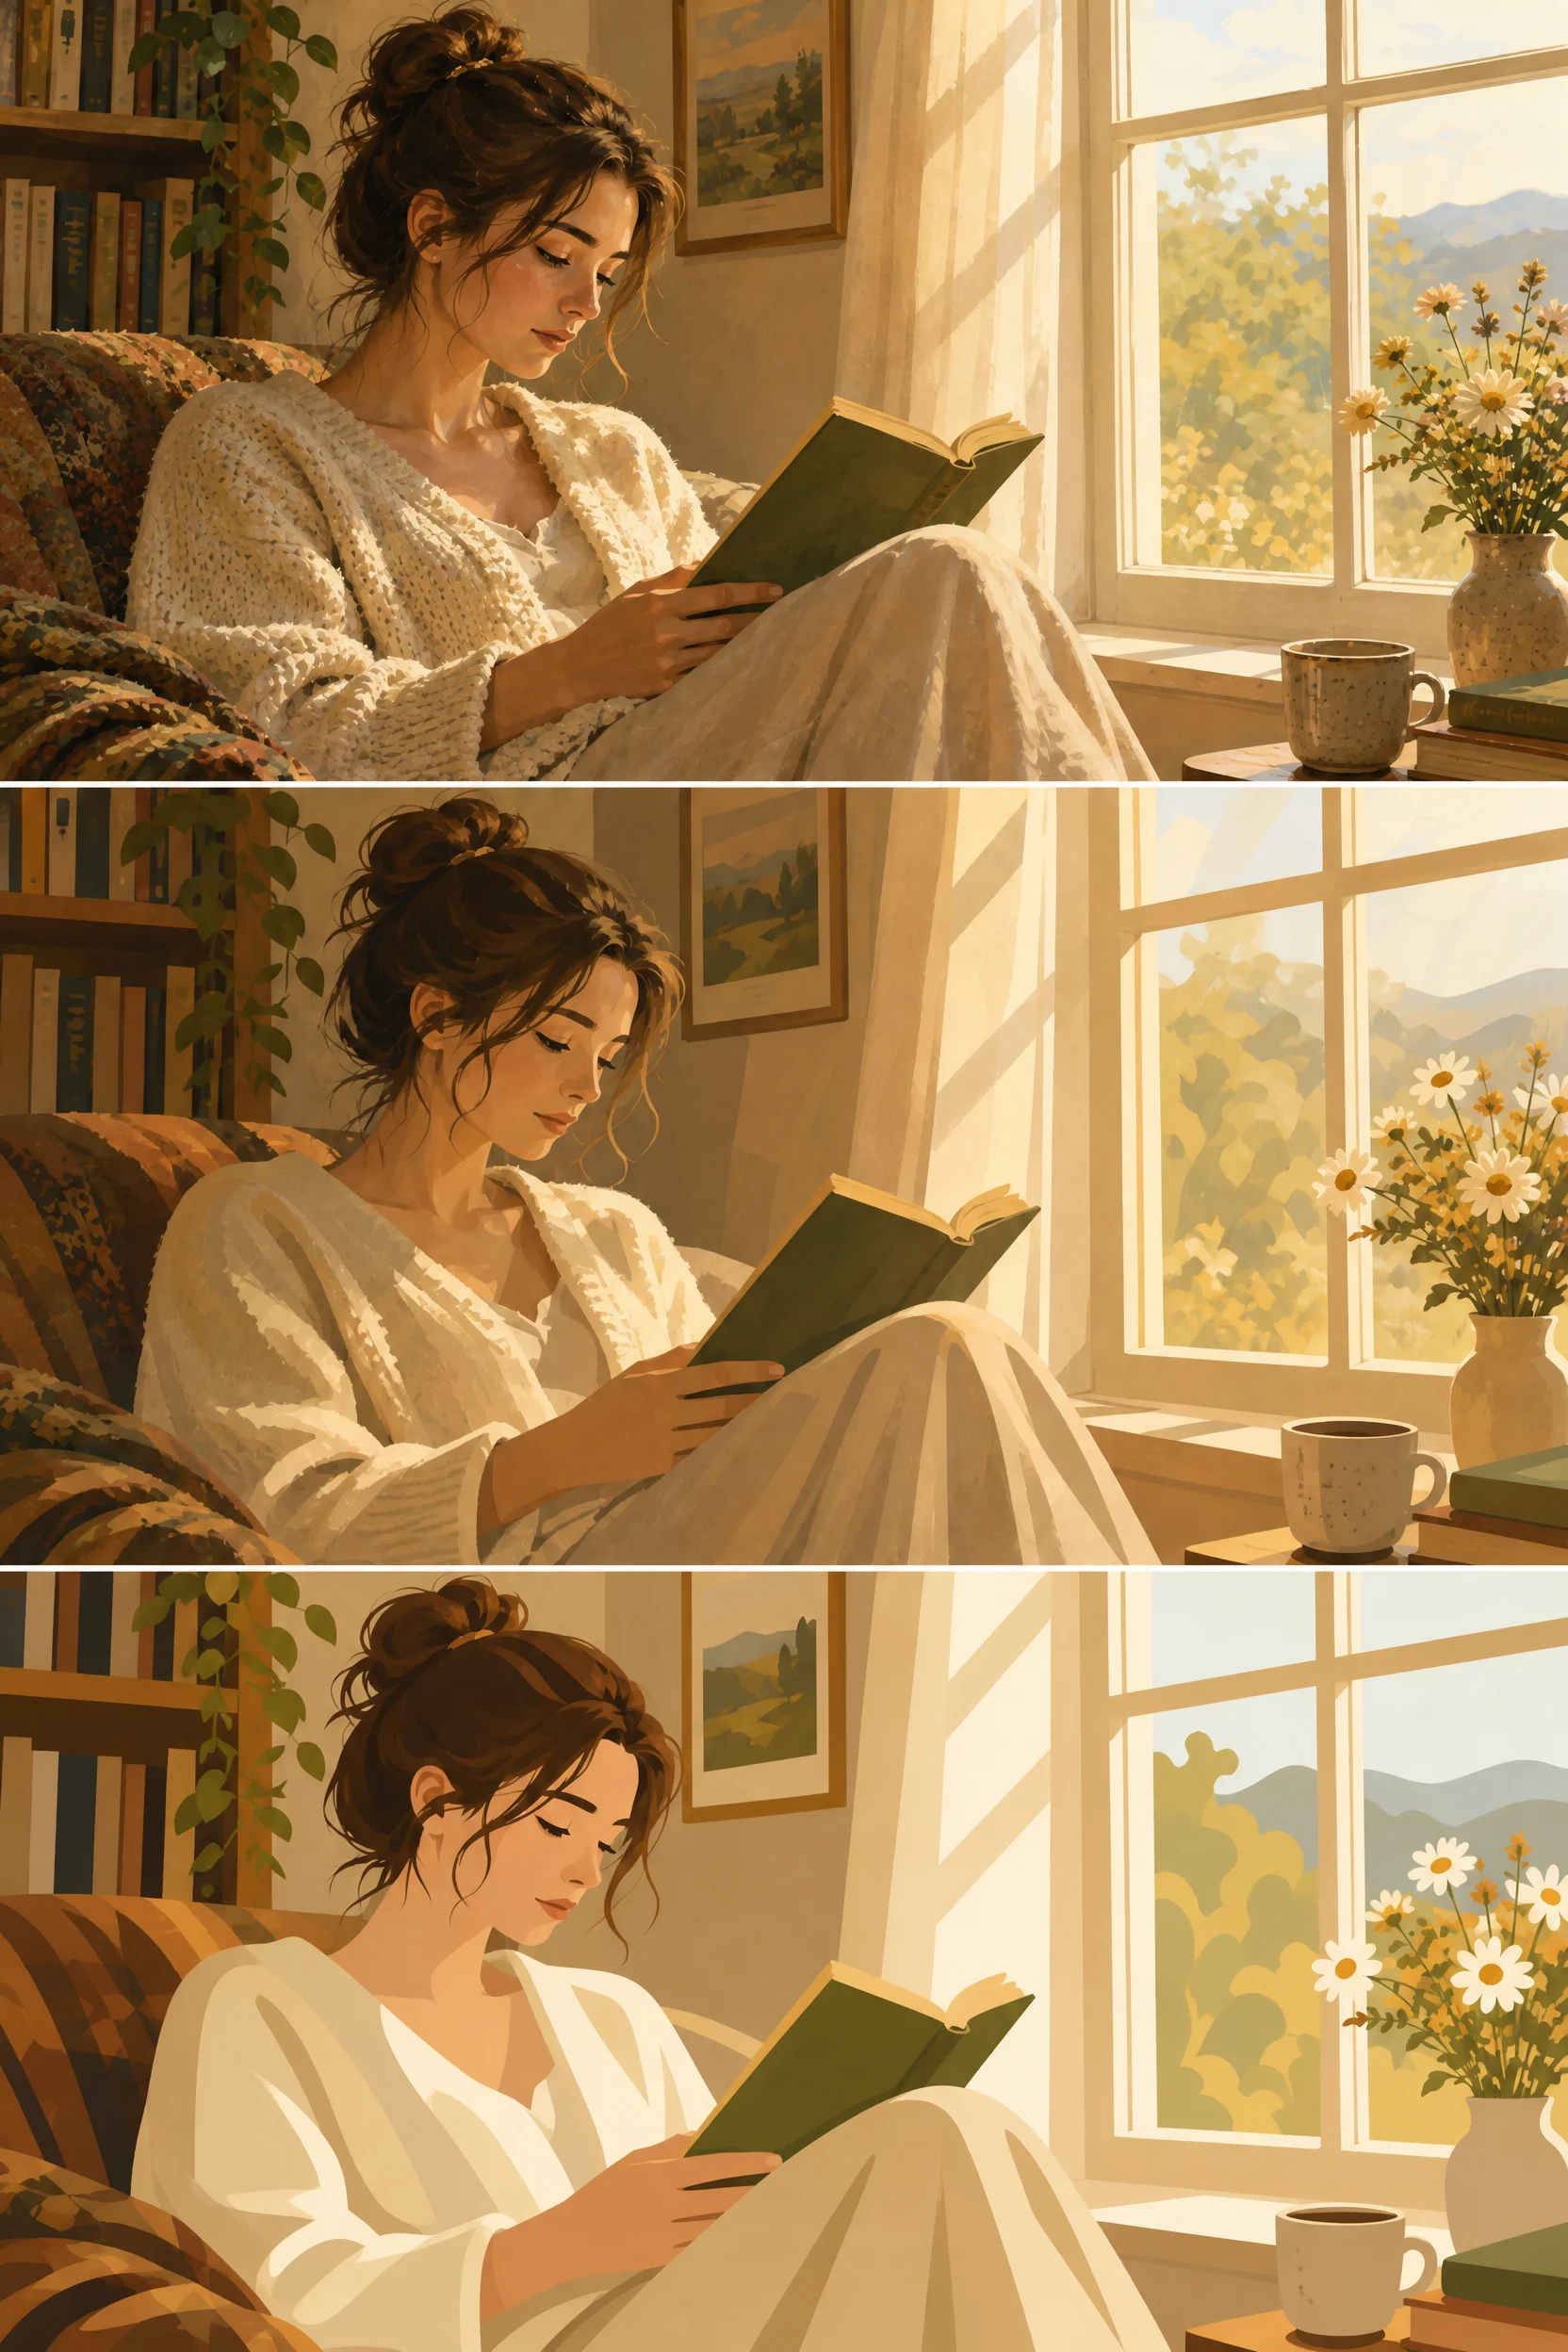
Spectre de styles : de la même illustration réaliste au plat dégradé
Style Illustration · transfert-de-style · Design plat
Entrées de référence
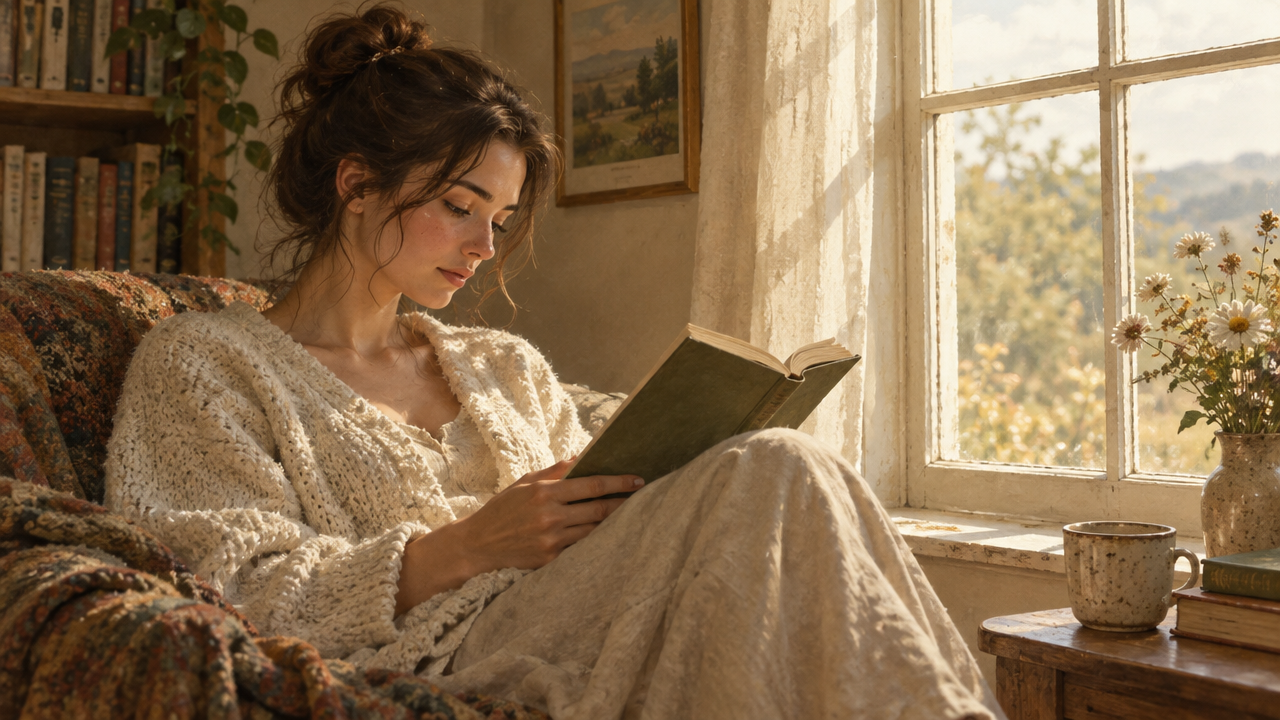
Image de référence
Prompt
Une série d'illustrations montrant un spectre de styles allant du réaliste au plat. En partant d'une scène intérieure réaliste, chaleureuse et à la lumière douce, où une femme lit près d'une fenêtre, on la réinterprète ensuite selon trois niveaux de stylisation : (1) semi-réaliste, avec des dégradés picturaux doux et des détails préservés ; (2) semi-plat, avec des ombres simplifiées, des silhouettes grossières et moins de textures ; (3) un style vectoriel entièrement plat, utilisant des blocs de couleurs unies, des formes géométriques nettes et des lignes minimalistes. Le sujet, la composition et la palette de couleurs restent cohérents à tous les niveaux. Composition 16:9, bords nets, sans texte.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
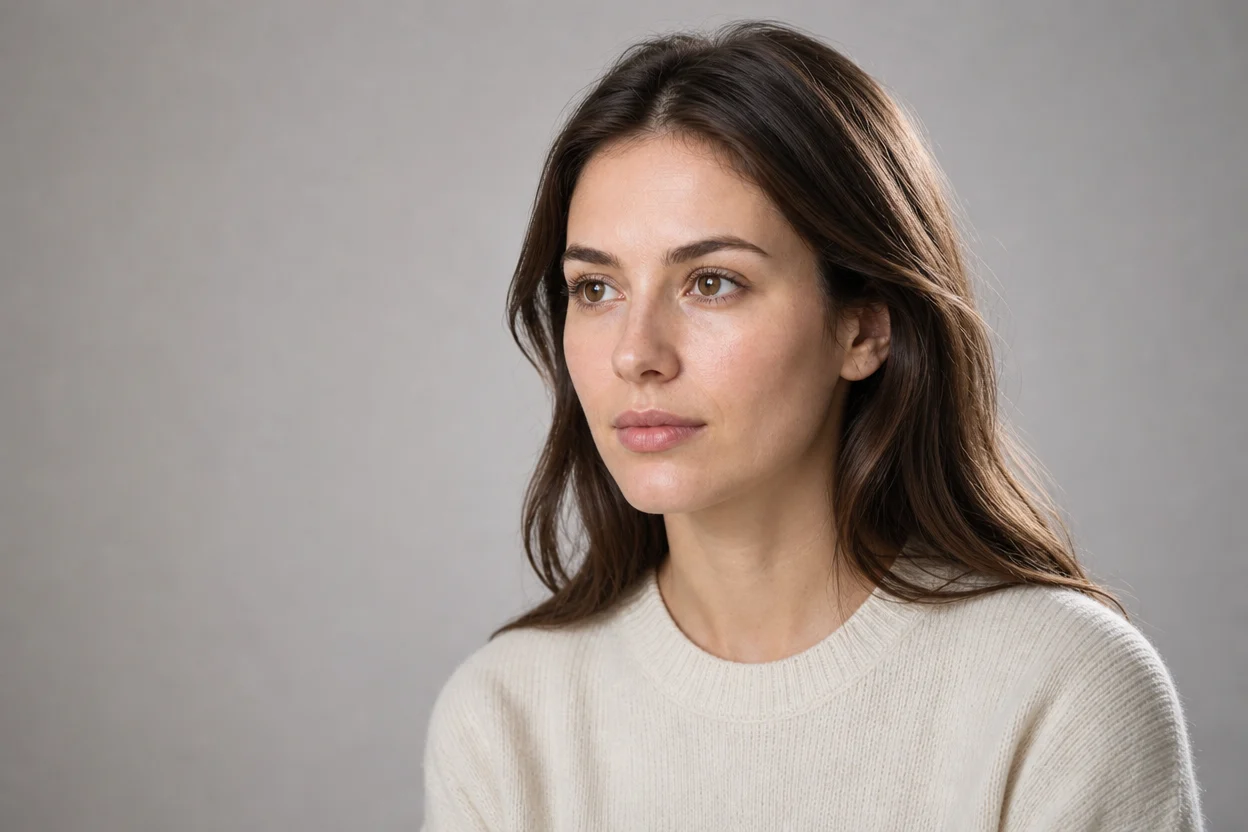
Reprise de style de portrait : double approche, réalisme et artistique
Style Portrait et photographie · image-vers-image · transfert-de-style
Entrées de référence
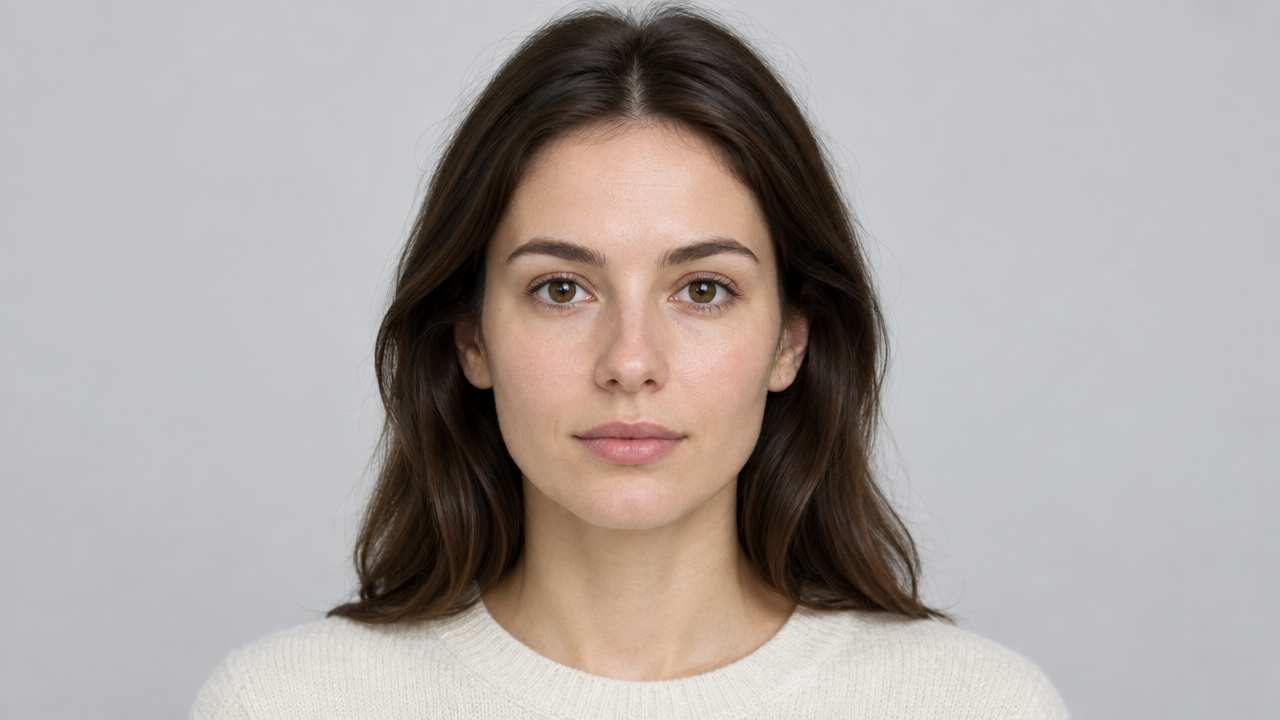
Image de référence
Prompt
Portrait de studio photoréaliste, vue de trois quarts en biais dans un style éditorial de magazine, un sujet adulte unique légèrement tourné vers la gauche, lumière principale douce provenant d'une grande boîte à lumière placée à droite de la caméra, complétée par un léger éclairage d'appoint et un doux filet de lumière sur les contours des cheveux, faible profondeur de champ, fond gris neutre en dégradé lisse, texture de peau naturelle préservée, pores visibles et fins cheveux détaillés, expression calme et assurée, étalonnage des couleurs dans le style des magazines de mode contemporains, composition horizontale 16:9, espace négatif généreux à gauche, détails riches, sans texte, sans logo
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
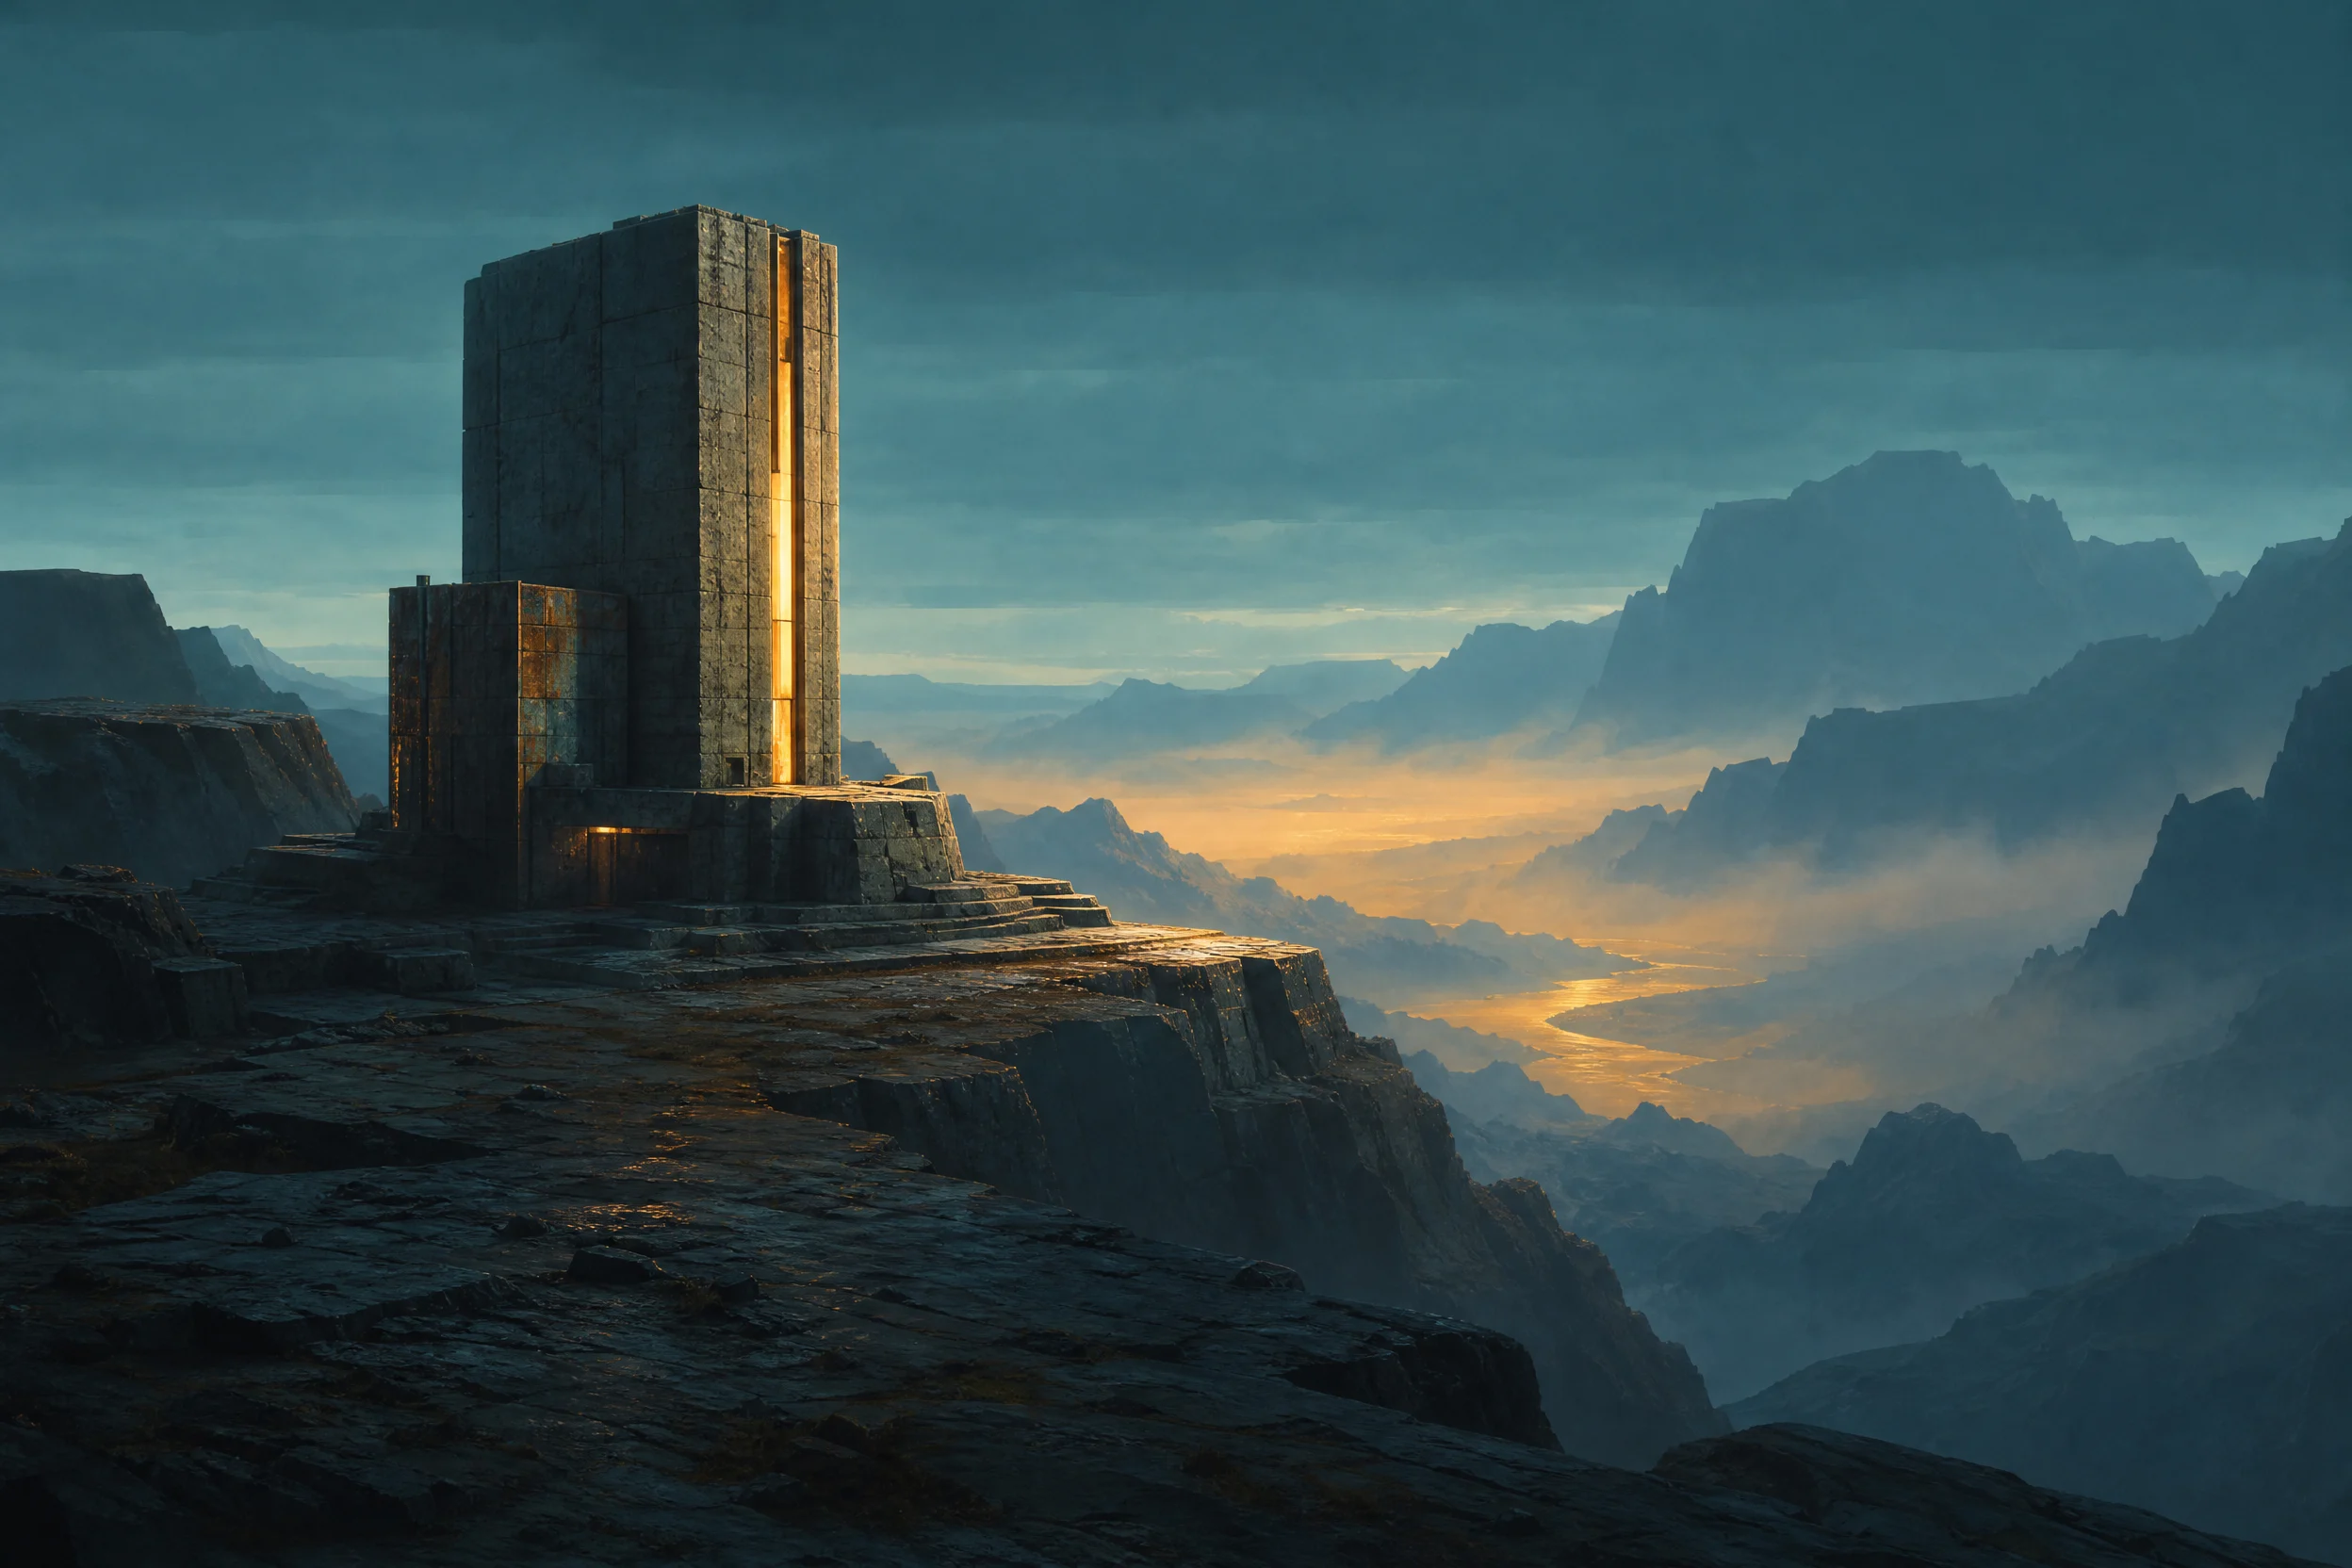
Concept visuel de scène d'univers : exploration visuelle atmosphérique
Style Art conceptuel · Construction du monde · Cinématographique
Entrées de référence
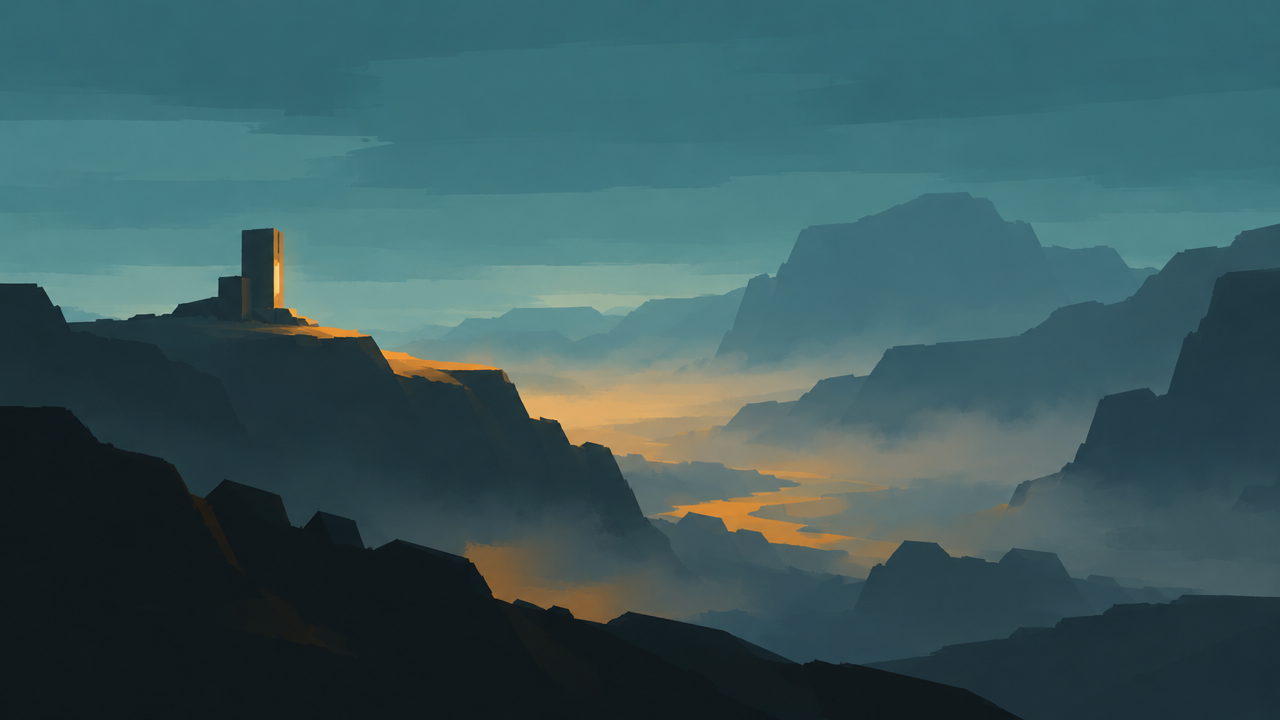
Image de référence
Prompt
Art conceptuel environnemental de qualité cinématographique, repensé à partir d'une planche d'ambiance de référence : une station d'observation géante et isolée, encastrée dans une falaise de basalte, surplombant une vallée brumeuse au crépuscule à l'heure bleue. Conserver les tons froids bleu-vert et ambrés, le langage des silhouettes et la position de l'horizon de l'image de référence ; ajouter des détails matériels solides — pierre patinée par les intempéries, nervures métalliques oxydées, lumière intérieure chaude s'échappant par d'étroites fissures. Composition panoramique 16:9, avec au premier plan une plateforme rocheuse servant de repère d'échelle, au plan moyen la structure architecturale, et une brume atmosphérique stratifiée s'étendant vers les montagnes lointaines. Lumière volumétrique douce, léger rim light sur le bâtiment, rendu pictural mais crédible, plage dynamique élevée, sans texte, sans filigrane.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
gpt-image-2/image-to-image per image
| Spécifications | Prix unitaire |
|---|---|
| 1K | $0.030 |
| 2K | $0.040 |
| 4K | $0.060 |
gpt-image-2/image-to-image @ext per image
Présentation
gpt-image-2/image-to-image est la déclinaison de la gamme de modèles d'image OpenAI dédiée à la régénération et à l'édition d'images : elle accepte de 1 à 16 images de référence accompagnées d'un prompt textuel et produit une image reconstruite. Elle convient aux scénarios de développement nécessitant de réécrire, d'étendre, d'harmoniser le style ou de remplacer la mise en page à partir de supports existants, avec un choix de format et une résolution allant jusqu'à 4K selon les spécifications de diffusion. Par rapport à la génération purement textuelle, l'intérêt de cette déclinaison est d'ancrer le résultat sur les images de référence fournies par le développeur.
Points clés
- Entrée multi-images de référence — un seul appel permet de soumettre de 1 à 16 images de référence et d'utiliser cet ensemble de supports comme base de génération, au lieu de s'appuyer uniquement sur une description textuelle.
- Choix du format selon les spécifications de diffusion — plus de dix ratios sont intégrés, de 1:1 et 16:9 à 21:9 et 9:21, pour s'aligner directement sur les pages de destination, les fils d'actualité et les supports verticaux.
- Résolution jusqu'à 4K — trois paliers de sortie sont disponibles : 1K, 2K et 4K ; le format 1:1 ne prend pas en charge le 4K, et la haute résolution convient aux supports de niveau impression ou grand écran.
- Sortie avec fond transparent — en résolution 1K, il est possible de choisir un fond transparent, opaque ou automatique, ce qui facilite l'intégration directe dans d'autres calques de conception.
Description des capacités
Réécriture d'image guidée par les références : génère une nouvelle image à partir des images d'entrée, adaptée au remplacement de style, à l'ajustement de la composition ou à la création de variantes à partir de supports existants ; le résultat hérite des indices visuels des images de référence.
Contrôle combiné du format et de la résolution : les paramètres aspect_ratio et resolution déterminent les spécifications de sortie ; avec le choix auto ou un ratio particulier, le format est limité à 1K, il faut donc anticiper cette contrainte dans les paramètres.
Contrôle du mode de fond : le paramètre background propose trois valeurs — auto, opaque et transparent — qui ne s'appliquent qu'en résolution 1K, adaptées aux traitements en aval nécessitant un détourage ou une composition par calques.
Prompt long : la limite du prompt est de 20 000 caractères, ce qui permet d'y intégrer en une seule fois plusieurs contraintes, des instructions de mise en page et le contenu rédactionnel, en réduisant les descriptions complémentaires sur plusieurs tours.
Fusion de supports multi-images : input_urls permet de transmettre plusieurs images en une fois, en fournissant séparément le sujet, les références de style et les exemples de mise en page, que le modèle synthétise en une seule sortie.
Cas d'usage
- Déclinaison multi-formats par les équipes de design à partir d'un visuel principal existant — téléverser le visuel principal et les différentes exigences de format, produire en lot des versions adaptées aux fils d'actualité, aux écrans d'ouverture et aux supports verticaux, et les intégrer directement à la banque de créations publicitaires.
- Régénération scénarisée de visuels produit par les équipes e-commerce — fournir des photos produit réelles et générer des visuels finis sous différents arrière-plans et éclairages, pour remplacer ceux des pages de détail et des emplacements publicitaires.
- Itération de mises en page texte-image en design visuel — prendre une maquette existante comme référence, remplacer le texte et les éléments graphiques via le prompt, et produire une nouvelle version de la maquette à soumettre à validation.
- Flux de composition nécessitant des supports à fond transparent — activer la sortie à fond transparent en 1K et superposer directement le résultat à d'autres calques ou scènes, en s'affranchissant du détourage manuel.
Limites et conseils de sélection
Cette déclinaison ne produit que des images, sans autre modalité comme la vidéo ou le texte. La résolution et le format sont liés par des contraintes : le mode automatique ou les ratios particuliers ne prennent en charge que le 1K, le format 1:1 ne prend pas en charge le 4K, et le fond transparent n'est disponible qu'en 1K ; il faut donc arbitrer entre hautes spécifications et contrôle du fond au niveau des paramètres. La haute résolution et les références multi-images augmentent le temps de génération et le coût d'appel, ce qui ne convient pas aux scénarios d'interaction en temps réel à très faible latence ; si l'on souhaite uniquement générer une image à partir de texte, sans support de référence, il faut choisir la déclinaison text-to-image de la même famille.
Nouveautés
Voir le journal des modifications →- Changement de paramètre gpt-image-2 ajoute des paliers de résolution 1K / 2K / 4K
Questions fréquentes
Voir toutes les questions →-
Qu'est-ce que GPT Image 2 ?
GPT Image 2 est le modèle de génération d'images à partir de texte d'OpenAI, adapté à la création d'affiches, de fiches de connaissances, de visuels produits et à la génération d'images comportant des exigences précises de texte et de mise en page.
-
GPT Image 2 et GPT Image 2.0 sont-ils le même modèle ?
GPT Image 2.0 est un raccourci de recherche courant ; utilisez l'ID de modèle exact indiqué sur la page GPT Image 2 et dans la documentation de l'API.
-
Quels point de terminaison et ID de modèle l'API GPT Image 2 utilise-t-elle ?
Envoyez une requête POST /v1/tasks, définissez model sur gpt-image-2/text-to-image pour la génération d'images à partir de texte, et transmettez prompt, aspect_ratio et resolution dans input. L'API renvoie d'abord un taskId, puis l'image finale est obtenue via l'interrogation de la tâche ou un callback.
-
Comment utiliser GPT Image 2 ?
Dans le Playground, décrivez le sujet, la scène, la mise en page et le texte qui doit apparaître, puis choisissez le format, la résolution et l'arrière-plan, cliquez sur Exécuter et consultez le résultat.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : gpt-image-2/image-to-image
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour gpt-image-2/image-to-image et la route default — voir le tableau des paramètres ci-dessous.
promptstringRequisminLength 1maxLength 20000Invite de texte, obligatoire, longueur maximale de 20000 caractères, décrivant le contenu de l'image souhaitée.
backgroundstringOptionnelMode d'arrière-plan, contrôle le traitement de l'arrière-plan de l'image générée ; ce paramètre n'est pris en charge qu'avec une résolution 1K.
autoopaquetransparentinput_urlsarrayRequisminItems 1maxItems 16Tableau d'URL d'images de référence, fournit une ou plusieurs images comme référence pour la génération image-vers-image ; prend en charge de 1 à 16 images.
Array [ string ]
resolutionstringOptionnelDéfaut: "1K"Résolution de l'image générée, 1K par défaut. Lorsque aspect_ratio vaut auto, la résolution 1K est obligatoire ; le format 1:1 ne prend pas en charge la 4K ; lorsque aspect_ratio vaut 3:1/1:3/9:21, seule la résolution 1K est prise en charge ; lorsque background vaut auto/opaque/transparent, seule la résolution 1K est prise en charge.
1K2K4Kaspect_ratiostringOptionnelDéfaut: "auto"Rapport largeur-hauteur de l'image générée, auto par défaut. Lorsque la valeur est auto ou omise, seule la résolution 1K est prise en charge.
auto1:13:22:34:33:45:44:5Tout afficher (8)
16:99:162:11:23:11:321:99:21callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentmodelstringRequisValeur fixe actuelle : gpt-image-2/image-to-image
routestringOptionnelValeur fixe actuelle : ext
inputobjectRequis
Objet de paramètres métier pour gpt-image-2/image-to-image et la route ext — voir le tableau des paramètres ci-dessous.
promptstringRequisminLength 1maxLength 20000图像编辑提示词 Max 20000 characters.
qualitystringRequisDéfaut: "low"lowmediumhighimage_urlsarrayRequisminItems 1maxItems 6参考图 URL 或 data URI,最多 6 张
Array [ string ]
resolutionstringRequisDéfaut: "1K"1K2K4Kaspect_ratiostringOptionnelDéfaut: "auto"输出画幅比例
auto1:13:22:34:33:45:44:5Tout afficher (8)
16:99:162:11:23:11:321:99:21callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "gpt-image-2/image-to-image",
  "input": {
    "prompt": "…",
    "input_urls": "…",
    "resolution": "1K",
    "aspect_ratio": "auto"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/image-to-image",
input: {
"prompt": "…",
"input_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/image-to-image",
"input": {
"prompt": "…",
"input_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
-H "Authorization: Bearer $HIAPI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2/image-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"image_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}'const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/image-to-image@ext",
input: {
"prompt": "…",
"quality": "low",
"image_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/image-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"image_urls": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat
-

Tutoriel
Comment utiliser kling-4.0/text-to-video via l'API HiAPI : curl, Python et un exemple de requête fonctionnel
Guide pratique pour les développeurs : prompts cinématographiques, audio synchronisé, interrogation asynchrone et téléchargement des sorties
-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Comment appeler kling-4.0/image-to-video sur HiAPI : curl, Python et interrogation périodique
-

Tutoriel
Tutoriel pour kandinsky-6.0-pro/image-to-video sur HiAPI : curl + Python
Lancer une requête image-vers-vidéo exploitable sur HiAPI : de l'envoi de la première image à l'interrogation asynchrone jusqu'au téléchargement final
Modèles associés
Voir tous les modèles →Même type
-
 BRIA Product Shot Bria $0.058 /image
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /image
-
 851 Labs Background Remover 851 Labs $0.002 /image
-
 FLUX 3 Image Black Forest Labs $0.041 /image
-
 Qwen Image 3.0 Alibaba $0.036 /image
-
 Muse Image 1.0 Meta $0.015 per task
-
 Nano Banana 2 Google $0.036 /image
-
 Imagen 4 Google $0.030 /image
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /image
-
 Grok Imagine Image 2.0 xAI $0.052 /image
-
 Z-Image Alibaba $0.008 /image
-
 Krea 3 Krea $0.036 /image


