
Руководство по использованию
Создание коротких видео с помощью heygen-avatar-iv через API HiAPI: руководство для разработчиков
Входные данные цифрового ведущего и аудио, темп сценария, соотношение сторон и длительность, а также пакетная генерация — с рабочими запросами к HiAPI
На этой странице
Почему для коротких видео выбирают heygen-avatar-iv
Короткие видео стали каналом распространения по умолчанию для запусков продуктов, анонсов обновлений версий, объяснений документации и фрагментов для соцсетей. Для большинства инженерных команд узкое место не в монтаже, а в стабильном производстве видеозаписей с говорящим человеком в кадре, без бронирования студии и без пересылки материалов туда-сюда с человеческим ведущим.
Именно эту нишу закрывает генерация видео с цифровым ведущим. Вы предоставляете визуальный образ и источник аудио/голоса, а модель возвращает отрендеренный фрагмент, в котором цифровой ведущий читает сценарий. heygen-avatar-iv — это эндпоинт в каталоге HiAPI, ориентированный на этот сценарий: короткие фрагменты с приоритетом вертикальной ориентации, где ведущий смотрит прямо в камеру и говорит.
Модель подходит для следующих случаев:
- Вам нужен масштабируемый выпуск. Десять локализованных версий одного анонса или ежедневный фрагмент к каждому релизу — это цикл, а не одна съёмка.
- Контент управляется сценарием. Если суть заключена в тексте, цифрового ведущего достаточно.
- Вам нужна воспроизводимость. Один запрос — один файл, который можно сравнивать, версионировать и повторно запускать, в отличие от записанной сессии.
- Вы уже работаете через API. Один HTTP-вызов встраивается в существующий пайплайн без внедрения нового инструмента с отдельным UI.
Он не подходит для импровизированных представлений с активной жестикуляцией и для сценариев, где продаёт именно физическое присутствие конкретного человека. Относитесь к heygen-avatar-iv как к рендереру: при одинаковых входных данных должен получаться один и тот же тип вывода — именно поэтому он поддаётся скриптованию.
Остальная часть руководства ведёт от одного тестового вызова к пакетному циклу, с рабочими примерами на curl и Python, которые вы сможете адаптировать. Детали модели и параметры смотрите на странице модели heygen-avatar-iv.
Из чего состоит запрос к heygen-avatar-iv
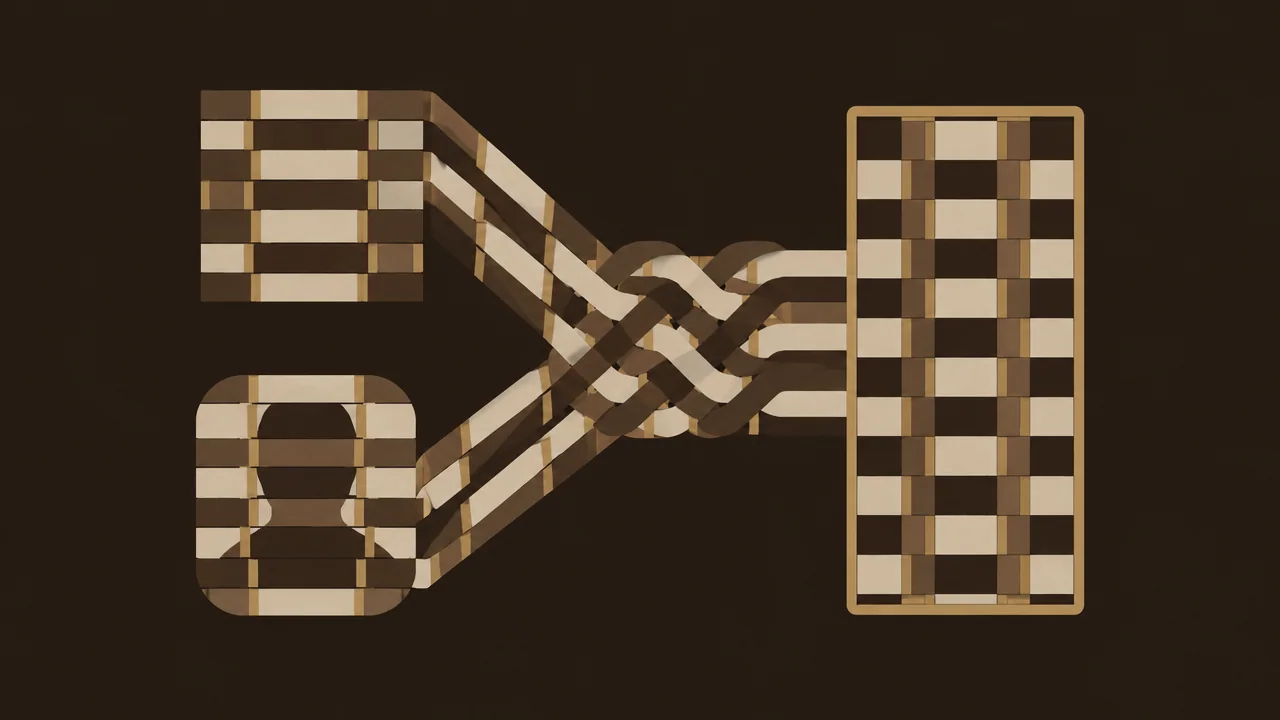
Прежде чем писать код генерации, смоделируйте запрос как две отдельные группы входных данных. Почти все ранние баги возникают из-за их смешения.
Группа первая: визуальный образ
Это кто в кадре — выбор цифрового ведущего, который определяет лицо ведущего, композицию и общий вид. В рамках одной кампании держите эту группу неизменной. Если вы делаете пять фрагментов об одном продукте, они должны использовать один и тот же блок образа, чтобы серия выглядела как один ведущий.
Группа вторая: аудио и голос
Это что говорится и как. В зависимости от запроса источником аудио может быть выбор голоса, читающего текст вашего сценария, либо предоставленная звуковая дорожка. Эта группа меняется в каждом фрагменте: новый сценарий, новый темп, иногда новый голос для локализации.
Как они отражаются в вызове
Запрос HiAPI отправляет обе группы в одном теле на эндпоинт генерации. Концептуально:
request
├── avatar / identity block   → остаётся неизменным в рамках серии
└── audio / voice block       → меняется в каждом фрагменте
        └── текст сценария или источник аудио
Из такого разделения вытекают два практических правила:
- Параметризуйте аудиогруппу, заморозьте группу образа. В коде держите образ как константу уровня модуля, а сценарий и голос передавайте как аргументы функции. Так визуальная согласованность серии обеспечивается структурно.
- При отладке меняйте только одну группу за раз. Если фрагмент выглядит неправильно, заменяйте только образ; если звучит неправильно — только аудиогруппу. Отладка с двумя переменными на платных вызовах рендеринга обходится дорого.
Также сразу определите, управляется ли ваша аудиогруппа текстом или звуковой дорожкой, поскольку этот выбор определит темп из следующего раздела: предоставленная дорожка задаёт синхронизацию, а сгенерированная речь следует вашему сценарию.
Точные имена полей, допустимые значения и значения по умолчанию перечислены на странице модели; прочитайте их и закрепите в объекте конфигурации, а не разбрасывайте литералы по коду.
Первый вызов через curl
Начните с короткого фрагмента. Цель этого вызова не качество вывода, а сквозная проверка учётных данных, формы тела запроса и пути загрузки, прежде чем что-либо автоматизировать.
Задайте ключ как переменную окружения, чтобы он никогда не попадал в историю shell в открытом виде:
export HIAPI_API_KEY="your_key_here"
Затем отправьте минимальный запрос. Замените на собственный выбор цифрового ведущего и короткую строку сценария:
curl -X POST "https://api.hiapi.ai/v1/generate" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "avatar": "<avatar_identifier>",
      "script": "Это тридцатисекундный тест пайплайна цифрового ведущего. Если вы читаете это на экране, форма запроса верна.",
      "voice": "<voice_identifier>",
      "aspect_ratio": "9:16",
      "duration": 30
    }
  }'
Проверяйте по порядку:
- Аутентификация. Ошибка учётных данных здесь означает остановку — всё ниже по потоку не имеет значения.
- Валидация тела запроса. Ошибка схемы укажет на проблемное поле. Исправляйте по одному полю за раз.
- Приём задания. Успешный вызов возвращает ссылку на job или task, а не обязательно готовый файл. Запишите этот идентификатор.
- Получение результата. Согласно контракту ответа на странице модели, опрашивайте статус или получайте URL результата по возвращённой ссылке.
- Воспроизведение. Скачайте фрагмент и посмотрите его. Убедитесь, что композиция, ориентация и произносимый текст соответствуют сценарию.
Сохраните эту curl-команду в черновом файле с вашими реальными идентификаторами. Она станет вашим контрольным экспериментом: когда версия на Python сломается, снова запустите curl, чтобы определить, проблема в вашем коде или во входных данных.
Переход к Python для воспроизводимой генерации
После успешного вызова curl оберните его в функцию. Смысл не в абстракции ради абстракции, а в том, чтобы каждый параметр был явным аргументом, и фрагмент полностью описывался точкой вызова.
import os
import requests

API_URL = "https://api.hiapi.ai/v1/generate"
API_KEY = os.environ["HIAPI_API_KEY"]

# Остаётся неизменным в рамках серии
AVATAR = "<avatar_identifier>"


def generate_clip(script: str, voice: str, aspect_ratio: str = "9:16",
                  duration: int = 30) -> dict:
    payload = {
        "model": "heygen-avatar-iv",
        "input": {
            "avatar": AVATAR,
            "script": script,
            "voice": voice,
            "aspect_ratio": aspect_ratio,
            "duration": duration,
        },
    }
    resp = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=120,
    )
    resp.raise_for_status()
    return resp.json()


if __name__ == "__main__":
    job = generate_clip(
        script="Это тридцатисекундный тест пайплайна цифрового ведущего.",
        voice="<voice_identifier>",
    )
    print(job)
Решения, которые окупятся позже:
- Значения по умолчанию отражают ваш самый частый фрагмент. Если большинство результатов — вертикальные короткие фрагменты, сделайте их значениями по умолчанию и переопределяйте редко.
- Образ на уровне модуля. Выбор цифрового ведущего существует в одном месте, и для ребрендинга достаточно изменить одну строку.
- Возвращайте весь ответ. Не извлекайте URL сразу и не выбрасывайте объект job; идентификатор понадобится для логов и повторных попыток.
- Бросайте исключение при HTTP-ошибках. Тихонький сбой в пакетном цикле хуже падения.
- Явно обрабатывайте асинхронные шаги. Добавьте небольшой вспомогательный
poll(job_id)вместо sleep внутри функции генерации.
Закрепите логику обработки ответа на контракте, описанном на странице модели: имена полей состояния job и получения результата чаще всего расходятся с вашими предположениями.
Написание сценария озвучивания и управление темпом
Видео с цифровым ведущим ориентировано на аудио. Сценарий, который нормально читается на бумаге, при озвучивании часто оказывается слишком длинным, а обрезка после генерации означает оплату рендеринга текста, который будет вырезан.
Сначала пишите под длину, потом сокращайте
Оцените длительность до вызова API. Комфортный темп речи — примерно 130–160 слов в минуту; для технического контента, за которым аудитория должна успевать следить, используйте нижнюю границу. Таким образом, для 30-секундного фрагмента нужно около 65–80 слов, для 60-секундного — около 130–160. Пишите черновик в этом бюджете, прочитайте вслух с таймером, затем сокращайте. Если приходится сокращать, удаляйте целые предложения, а не слова: сокращение на уровне предложений сохраняет ритм.
Пишите для слуха
- Короткие предложения. Одна мысль на предложение. Придаточные предложения — там, где внимание падает.
- Никаких отсылок, требующих только зрения. «Как показано ниже» не работает без слайда.
- Ставьте главное вперёд. Зрители коротких видео решают в первые секунды; утверждение должно быть в первом предложении.
- Расшифровывайте то, что TTS прочтёт неправильно. Аббревиатуры, строки версий и названия продуктов с необычным регистром пишите так, как их нужно произносить.
Управляйте темпом по таймлайну
Разложите сценарий на блоки по целевой длине:
0–5s    крючок: утверждение или проблема
5–20s   основная часть: механизм, два-три предложения
20–28s  деталь: одна цифра или пример, которые стоит запомнить
28–30s  финал: единственный призыв к действию
Эта блочная структура одновременно является артефактом для ревью: ревьюер может отклонить блок, не заставляя вас перерендеривать что-либо. Храните сценарий каждого фрагмента в отдельном файле под контролем версий вместе с кодом, который его рендерит, и пакетный цикл из следующего раздела станет полностью воспроизводимым.
Настройка соотношения сторон, длительности и вывода
Определите ориентацию и длину по целевой платформе до первого рендеринга. Повторный рендеринг готового фрагмента в другой ориентации — чистая трата, а повторное редактирование чересчур длинного фрагмента означает перегенерацию аудио.
Соотношение сторон
- 9:16 вертикальное — по умолчанию для лент коротких видео: shorts, reels, stories и мобильных размещений. Проектируйте композицию в первую очередь под него; где возможно, вырезайте другие пропорции из вертикального мастера.
- 16:9 горизонтальное — встроенные плееры, лендинги, видео в документации и презентации.
- 1:1 квадратное — размещения в лентах, предпочитающих квадрат. Хорошо как вторичная производная версия.
Если вашей кампании нужны две ориентации, рассматривайте их как две разные задачи с разными сценариями, а не рендерите один и тот же сценарий дважды: реплика, подходящая для 30-секундного вертикального видео, в более коротком квадратном монтаже часто оставляет мёртвую паузу.
Длительность
Задавайте длительность исходя из бюджета сценария из предыдущего раздела, а не наоборот. Передавайте длительность, соответствующую реальной длине озвучивания; фрагменты с заполнением или обрезанные посреди фразы выглядят сломанными. Храните платформенные цели в конфигурации, чтобы их было легко менять:
TARGETS = {
    "vertical": {"aspect_ratio": "9:16", "duration": 30},
    "horizontal": {"aspect_ratio": "16:9", "duration": 45},
}
Вывод
Скачивайте и храните готовые фрагменты самостоятельно, а не полагайтесь на временные URL результатов. Простое соглашение — {clip_id}-{orientation}-{version}.mp4 — сохраняет производные версии отслеживаемыми и делает устаревшие файлы очевидными. Записывайте идентификатор job вместе с файлом, чтобы любой фрагмент можно было проследить до его точного запроса.
Оплата взимается за запрошенную генерацию — по длительности и количеству фрагментов, — поэтому сокращение сценария до рендеринга — самая дешёвая доступная вам оптимизация. Актуальные тарифы смотрите на панели цен.
Пакетная генерация нескольких фрагментов
Когда функция работает, пакетная обработка — это цикл по списку задач. Ключевой момент: каждая задача полностью описывает один фрагмент.
JOBS = [
    {"id": "launch-vertical", "script_file": "scripts/launch.txt",
     "voice": "<voice_a>", "aspect_ratio": "9:16", "duration": 30},
    {"id": "launch-square", "script_file": "scripts/launch_sq.txt",
     "voice": "<voice_a>", "aspect_ratio": "1:1", "duration": 20},
    {"id": "changelog-vertical", "script_file": "scripts/changelog.txt",
     "voice": "<voice_b>", "aspect_ratio": "9:16", "duration": 30},
]

results = []
for job in JOBS:
    with open(job["script_file"]) as f:
        script = f.read().strip()
    print(f"submitting {job['id']} ({len(script.split())} words)")
    resp = generate_clip(
        script=script,
        voice=job["voice"],
        aspect_ratio=job["aspect_ratio"],
        duration=job["duration"],
    )
    results.append({"id": job["id"], "job": resp})
Паттерны, которые стоит перенять:
- Сценарии как файлы, а не строковые литералы. Их можно ревьюить, сравнивать и переиспользовать в разных ориентациях.
- Логирование количества слов. Печать числа слов для каждой задачи выявляет сценарии, которые выйдут за пределы длительности, ещё до траты денег на рендеринг.
- Стабильные id задач. Используйте их в именах выходных файлов и логах, чтобы сбои в фрагментах можно было опознать среди двадцати запусков.
- Мягкий сбой, затем отчёт. Оборачивайте каждую отправку в try/except, собирайте сбои и продолжайте — один плохой сценарий не должен прерывать весь пакет.
- Соблюдайте ограничения скорости и параллелизма. Начинайте последовательно; добавляйте пул рабочих потоков с ограничением только после того, как последовательный запуск стабилизируется.
- Сохраняйте список результатов. Записывайте id задач в JSON-файл, чтобы частично выполненные пакеты можно было продолжить, а не начинать заново.
Частые точки отказа и проверки
Это проблемы, которые проявляются первыми. У каждой есть дешёвая изолирующая проверка.
Ошибка формата входных данных
Ошибки схемы — самая частая первая неудача. Проверка: запустите исходную curl-команду с теми же идентификаторами. Если curl проходит, а Python падает, баг в вашей сериализации — обычно несовпадение типов, например строка вместо целочисленного duration или лишний перевод строки в конце файла сценария.
Несоответствие аудио и сценария
Если голос говорит не то, что предполагалось на экране, или фрагмент беззвучный, проблема в аудиогруппе. Проверка: определите, управляется ли запрос текстом или звуковой дорожкой, и убедитесь, что передали соответствующее поле. Одновременная передача и дорожки, и поля сценария — типичный беззвучный конфликт: решите, что имеет приоритет, и удалите другое.
Неправильная ориентация или чёрные полосы
Фрагмент возвращается с чёрными полосами или неожиданной рамкой. Проверка: убедитесь, что aspect_ratio действительно попал в тело запроса — значение по умолчанию в функции могло молча переопределить то, что вы думали, что передаёте. Логируйте собранное тело перед отправкой.
Несовпадение длительности
Фрагмент обрывается посреди фразы или затягивается в конце. Проверка: сравните количество слов в сценарии с бюджетом длительности. Исправляйте сценарий, а не длительность, если только сама цель не была неверной.
Дрейф образа внутри серии
Фрагменты одной кампании выглядят как разные ведущие. Проверка: убедитесь, что идентификатор цифрового ведущего берётся из одной константы, а не из конфигурации каждой задачи.
Усечённый или отсутствующий вывод
Job успешен, но файл неполный. Проверка: перед загрузкой убедитесь, что job достиг конечного успешного состояния, и что вы следуете контракту получения на странице модели, а не угадываете URL.
Общее правило: один тестовый фрагмент, один curl-запрос, одна переменная за раз. Сначала выполните короткий вертикальный рендеринг через модель heygen-avatar-iv, проверьте сквозным образом, а затем масштабируйте циклом.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с gpt-6.2-sol: границы возможностей, интеграция через API и тарификация токенов
Ключевые моменты принятия решений и практики интеграции для инженерных команд
-

Руководство по использованию
Руководство по началу работы с gpt-6.2-astra: границы возможностей текстовой модели, ключевые моменты интеграции и контроль затрат
-

Руководство по использованию
Руководство по началу работы с Tripo H3.1: три способа ввода, параметры и как выбрать тариф
Практическое руководство для разработчиков по принятию решений и контролю затрат при интеграции генерации 3D