
Руководство по использованию
Qwen Image 3.0 图生图:превратите одно фото продукта в целый набор материалов для электронной коммерции
Один реальный тест: одно базовое фото продукта, три сценария, настоящие промпты и процесс, который можно масштабировать на всю партию.
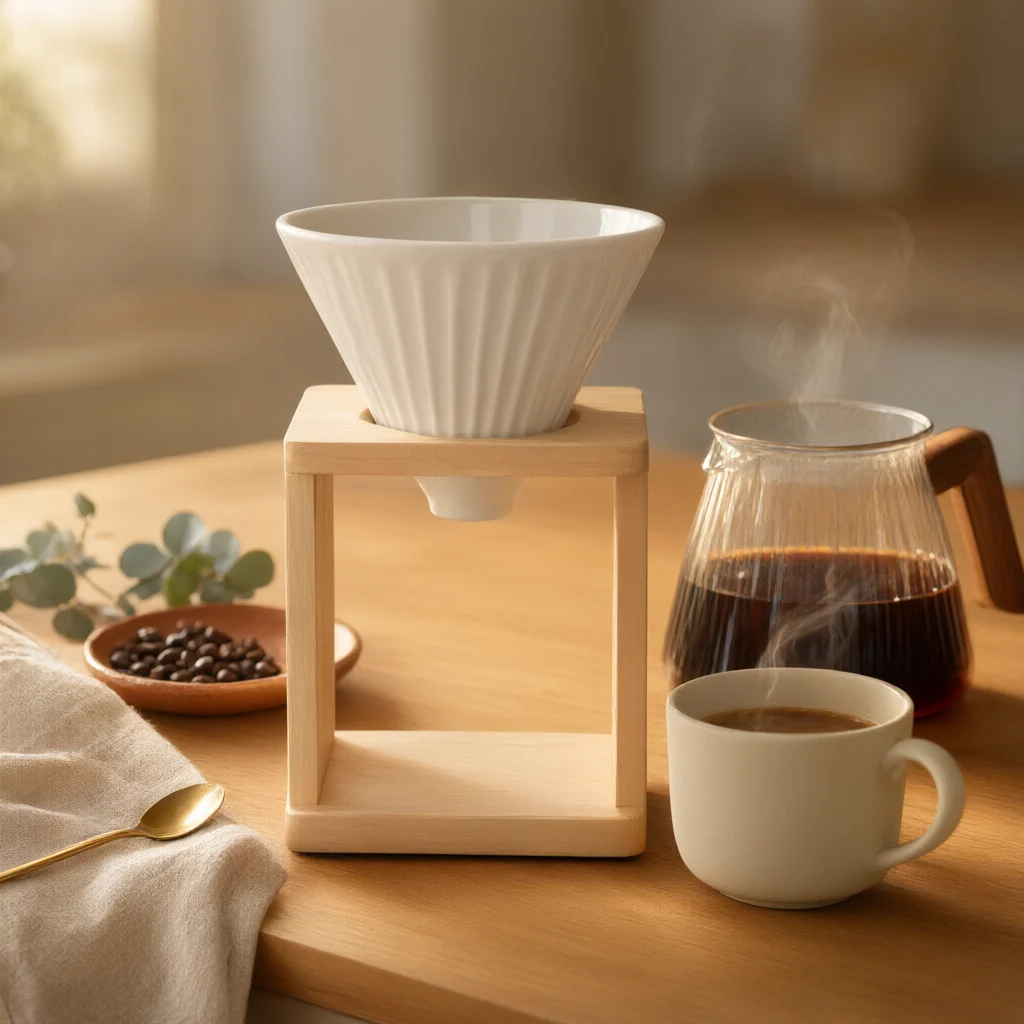
Большинство каталогов продуктов до сих пор ограничиваются одной чистой студийной фотографией на каждый SKU. Для миниатюр в списке товаров этого достаточно, но как только вам нужна лайфстайл-картинка для рекламы, сезонный баннер или изображение для маркетплейса, где товар должен быть показан «в использовании дома», одного снимка категорически не хватает. Переснимать каждый сценарий — значит привлекать фотографа, студию и тратить несколько дней на каждый продукт.
Мы провели небольшой реальный тест, чтобы проверить, способна ли qwen-image-3.0/image-to-image закрыть этот разрыв: взяв одну студийную фотографию продукта, с помощью редактирования «изображение в изображение» поместить его в три разных лайфстайл-сценария без второй съёмки. Ниже — результаты теста, точные промпты, которые мы использовали, и процесс пакетной обработки, масштабируемый на множество продуктов.
Почему «изображение в изображение» лучше пересъёмки для каждого сценария
Если попросить модель «текст в изображение» нарисовать «кофейную воронку на кухонной столешнице», она нарисует какую-то кофейную воронку — но не обязательно вашу, не обязательно с теми же пропорциями, материалом и брендингом. Модели «изображение в изображение» решают другую задачу: они берут реальную фотографию за референс и генерируют новое изображение, сохраняя узнаваемость объекта, но меняя окружение, освещение или стилизацию.
Для электронной коммерции эта разница критична. Покупатели сравнивают лайфстайл-изображения с фотографиями продукта на одной и той же странице товара — если форма не совпадает, это воспринимается как подделка или несоответствие товара. Тест ниже проверяет, способен ли режим «изображение в изображение» qwen-image-3.0 сохранять такую согласованность в трёх действительно разных сценариях.
Тест: одно фото продукта, три готовых к использованию сценария
Сначала мы сгенерировали с помощью gpt-image-2/text-to-image студийное фото белой керамической воронки для пуровера на чисто белом фоне — именно такую базовую фотографию уже имеет большинство продавцов.
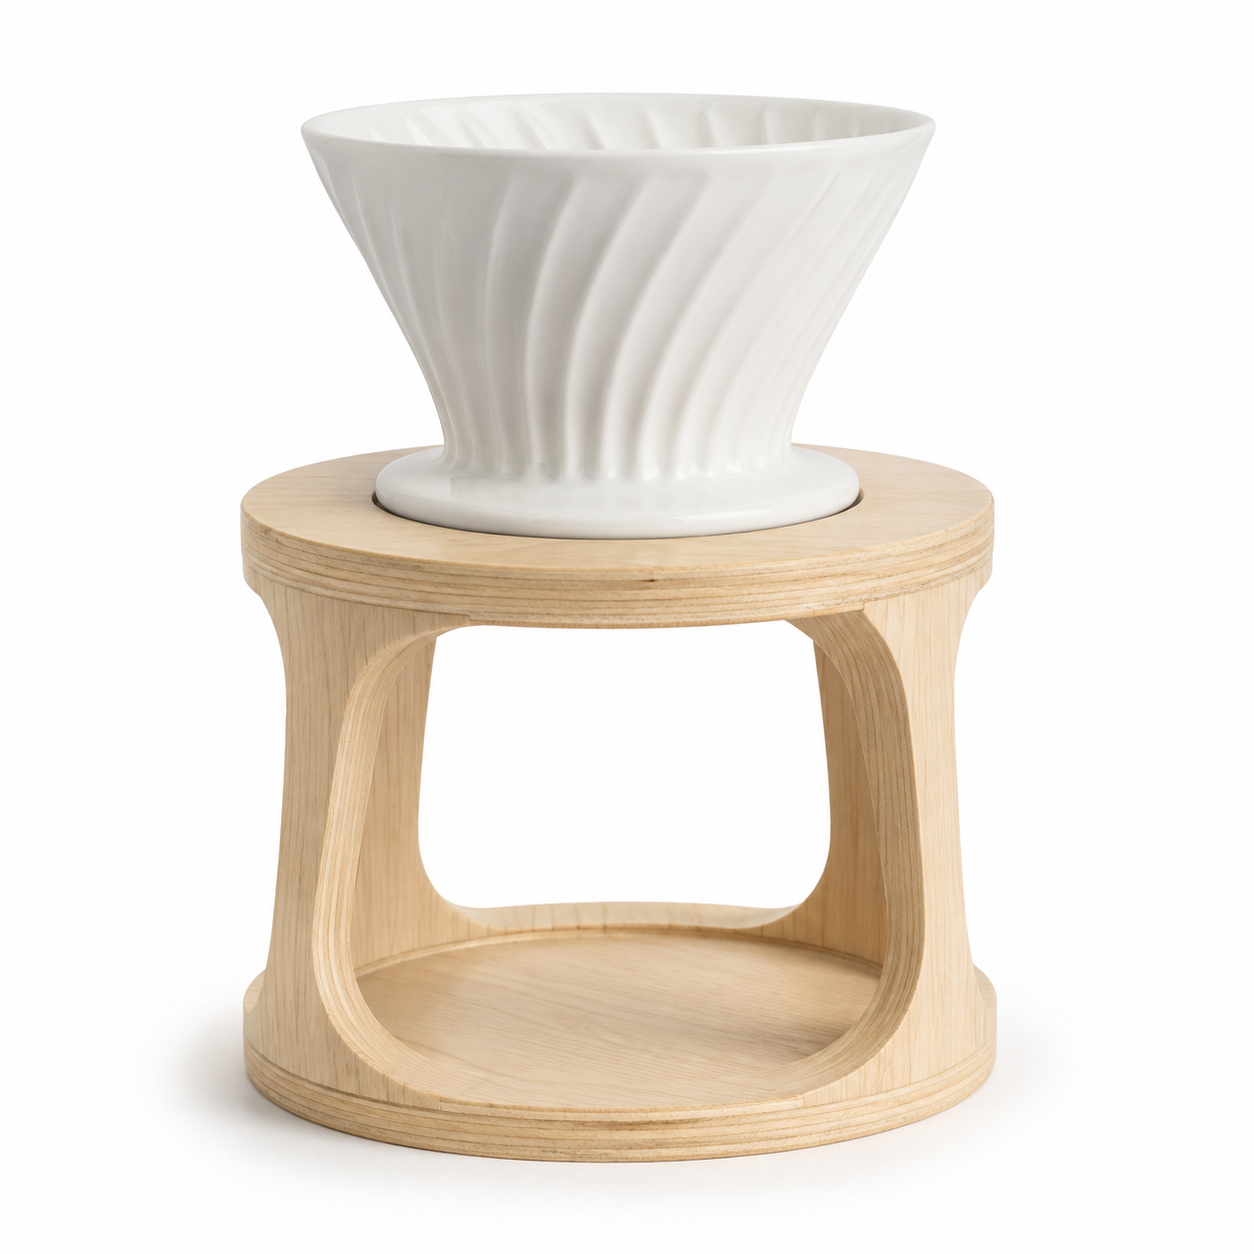 Промпт: «Professional e-commerce studio product photograph of a white ceramic pour-over coffee dripper with a light birch wood stand, centered, straight-on angle, on a seamless pure white background, soft even studio lighting, subtle natural shadow beneath the base, crisp focus, no text, no logo, no props, high-resolution commercial catalog photography.»
Затем мы трижды подали эту фотографию в qwen-image-3.0/image-to-image — по одному разу на каждый сценарий, оставляя референсное изображение неизменным и меняя только промпт.
Сценарий 1: кухонная столешница, утренний свет
Промпт: «White ceramic pour-over coffee dripper with birch wood stand on a warm wooden kitchen countertop, morning light»
Это фотография повседневного использования — та, что отвечает на вопрос «как это будет выглядеть на моей столешнице».
Сценарий 2: столик в кафе
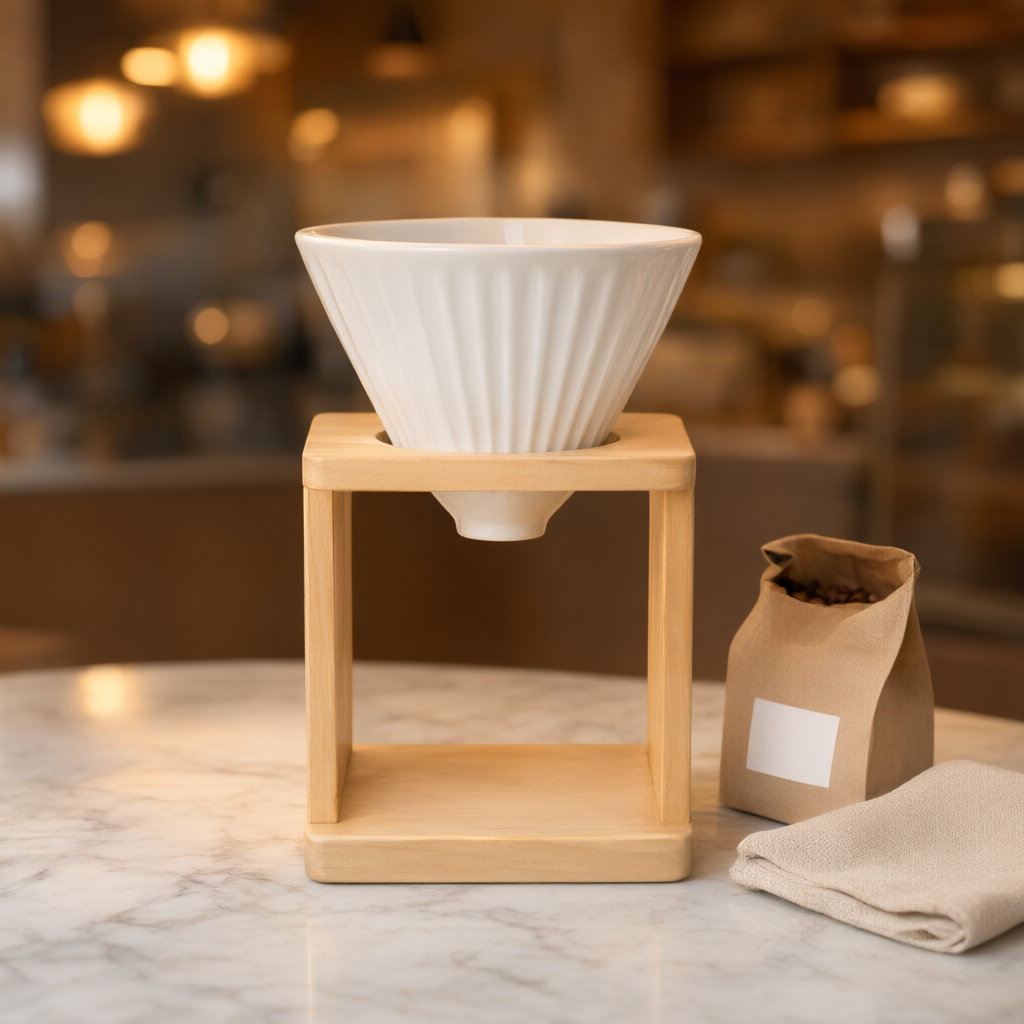 Промпт: «White ceramic pour-over coffee dripper with birch wood stand staged on a marble cafe counter»
Более журнальный и вдохновляющий сценарий, лучше подходящий для рекламы в соцсетях или баннера на главной странице.
Сценарий 3: праздничная подарочная стилизация
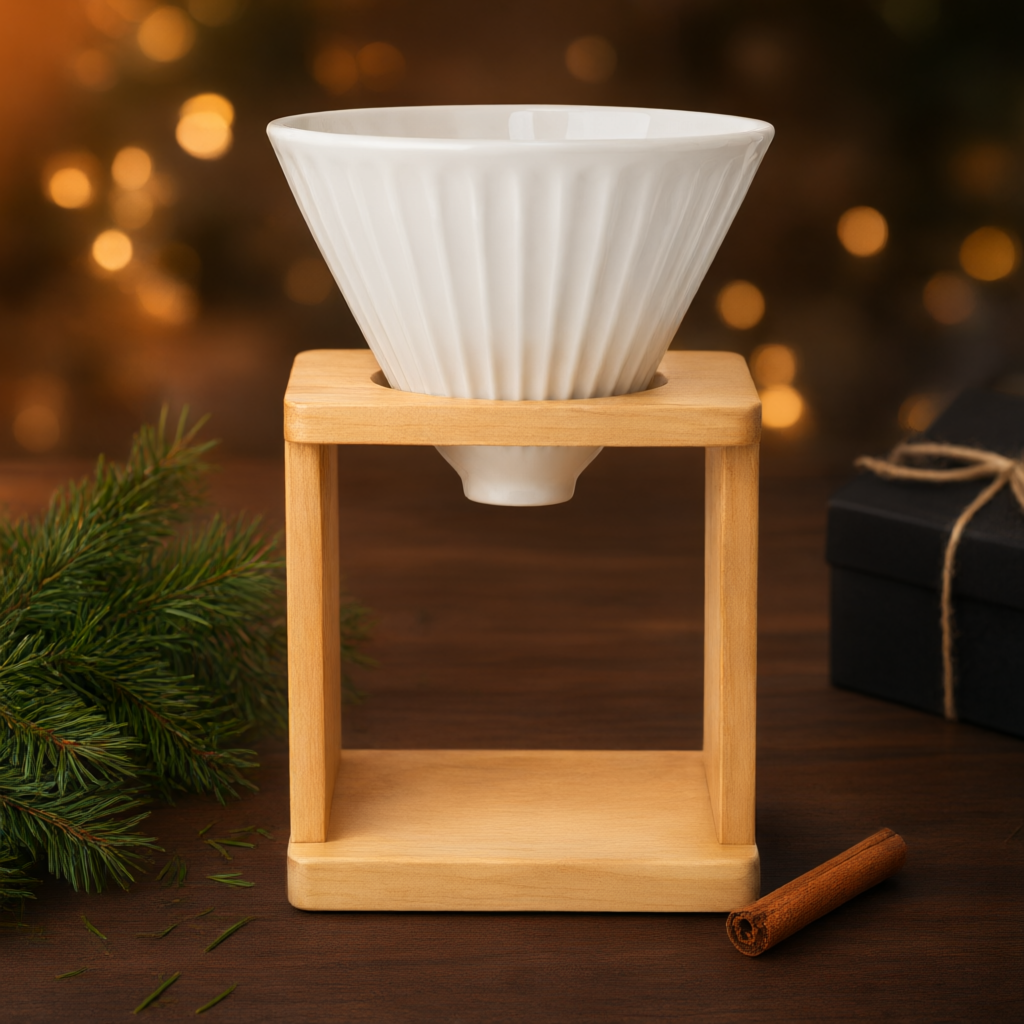 Промпт: «White ceramic pour-over coffee dripper with birch wood stand styled for a winter holiday gift photo»
Тот же продукт, сезонная упаковка — подходит для подарочных подборок без ожидания специальной праздничной съёмки.
Что на самом деле показал тест
- Идентичность продукта сохранилась во всех трёх сценариях. Форма воронки, берёзовая подставка и цвет керамики остались неизменными — это важнейшее свойство для электронной коммерции, поскольку несоответствие изображений продукта подрывает доверие покупателей.
- Каждое редактирование заняло меньше минуты. Все три сценария уложились в типичное время ожидания в пределах нескольких минут, так что небольшой каталог из 20–30 продуктов — это работа на один день, а не многодневная съёмка.
- Конкретность промпта важнее его длины. Приведённые выше промпты намеренно короткие — назвать материал, объект и сцену достаточно. В наших ранних импровизированных тестах расплывчатые промпты (вроде «сделай уютно») давали менее предсказуемые изменения сцены.
- Для этого продукта хватило одного референсного изображения. qwen-image-3.0/image-to-image принимает до трёх референсных изображений за вызов; для такого простого главного объекта одного чистого референсного фото уже достаточно для стабильного результата, поэтому нам не пришлось тратить деньги на дополнительные референсы.
Базовый тариф vs. Pro: что выбрать
Оба тарифа работают одинаково — те же референсные изображения, та же структура промпта — но для трёх сценариев выше мы использовали базовый тариф, и он неизменно справлялся. Выбирайте Pro, когда продукт имеет сложные материалы (стекло, узорчатая ткань, тонкая металлическая текстура) или запутанную композицию, и вам важнее точность передачи материалов, чем скорость. О ценах (сверено с актуальной страницей цен hiapi): базовый тариф — около $0.036 за изображение плюс небольшая плата за каждое референсное изображение; Pro примерно на 40% дороже за изображение при той же плате за референс — в любом случае это дешевле пересъёмки.
Масштабирование на весь каталог продуктов
Суть «изображения в изображение» здесь не в одной фотографии — а в превращении одного базового изображения в целую библиотеку сценариев. Схема — простой цикл: фиксируем референсное изображение, перебираем промпты.
import os
import requests

API_BASE = "https://api.hiapi.ai/v1/tasks"
TOKEN = os.environ["HIAPI_API_KEY"]

def edit_scene(base_image_url: str, scene_prompt: str) -> str:
    resp = requests.post(
        API_BASE,
        headers={"Authorization": f"Bearer {TOKEN}"},
        json={
            "model": "qwen-image-3.0/image-to-image",
            "input": {"prompt": scene_prompt, "image_urls": [base_image_url]},
        },
        timeout=60,
    )
    task_id = resp.json()["data"]["taskId"]

    while True:
        task = requests.get(
            f"{API_BASE}/{task_id}",
            headers={"Authorization": f"Bearer {TOKEN}"},
            timeout=30,
        ).json()["data"]
        if task["status"] == "success":
            return task["output"][0]["url"]
        if task["status"] == "fail":
            raise RuntimeError(task["error"])

base_photo = "https://your-cdn.example.com/products/dripper-base.jpg"
scenes = [
    "on a warm wooden kitchen countertop, morning light",
    "staged on a marble cafe counter",
    "styled for a winter holiday gift photo",
]
for scene in scenes:
    url = edit_scene(base_photo, f"White ceramic pour-over coffee dripper with birch wood stand {scene}")
    print(url)  # download immediately — output URLs expire
Подставьте свои фотографии продуктов и набор описаний сценариев, и тот же цикл сгенерирует полный набор сцен для каждого SKU. Каждый выходной URL является временным, поэтому скачивайте и сохраняйте результаты сразу после завершения задачи (на свой CDN или в любое место, где хранятся изображения вашего каталога).
Часто задаваемые вопросы
Можно ли использовать существующую фотографию в качестве референса, или обязательна студийная съёмка? Лучше всего работают чистые, хорошо освещённые фотографии, поскольку модель воспроизводит то, что видит — загромождённый или плохо освещённый референс привнесёт беспорядок в каждый сценарий. Студийные снимки на чистом фоне, как в этом тесте, дают наиболее предсказуемый результат.
Сколько референсных изображений отправлять за вызов? qwen-image-3.0/image-to-image принимает от 1 до 3. Для одного главного объекта в нашем тесте хватило одного референса. Несколько референсов полезнее, когда нужно, чтобы модель согласовала продукт сразу с нескольких ракурсов.
Сохранит ли модель мой логотип или текст на этикетке? Мелкий печатный текст и логотипы — самое сложное для точного сохранения при редактировании для любой модели изображений. Считайте этот рабочий процесс надёжным в отношении формы, цвета и материала — перед публикацией вручную проверяйте любые надписи или логотипы на выходных изображениях, как вы поступили бы с любым сгенерированным ИИ изображением (сравнение API «изображение в изображение» от hiapi также рассматривает этот компромисс на других моделях).
Заменит ли это полностью продуктовую фотографию? Нет — вам всё ещё нужна одна надёжная базовая фотография для каждого продукта. Это заменяет вторую, третью и четвёртую съёмки для каждого нужного вам лайфстайл-варианта.
Что делать, если какой-то сценарий получился неудачным? Повторите тот же промпт — результаты каждого запуска не идентичны — или уточните промпт более конкретными деталями сцены, как в приведённых выше промптах, где указаны конкретная поверхность и условия освещения вместо расплывчатого настроения.
Ключевые выводы
- Одна студийная фотография продукта плюс qwen-image-3.0/image-to-image дают три разных, согласованных с продуктом сценария без второй съёмки.
- В этом тесте идентичность продукта (форма, материал, цвет) оставалась неизменной во всех трёх сценариях.
- Короткие, конкретные промпты — с названием объекта и сцены — превосходят расплывчатые промпты, основанные на настроении.
- Для простого главного объекта достаточно одного референсного изображения; если продукту не требуется согласование нескольких ракурсов, можно сэкономить на дополнительных референсах.
- Та же схема цикла линейно масштабируется: одно базовое изображение плюс набор промптов сценариев дают полный набор сцен для каждого SKU.
Готовы попробовать на своём каталоге продуктов? Начните со страницы модели qwen-image-3.0/image-to-image, протестируйте редактирование сцен на своих фотографиях продуктов или посмотрите, как она сравнивается с другими моделями редактирования, в обзоре API «изображение в изображение» от hiapi.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков