
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
Importez une seule photo avec un script pour générer une vidéo d'avatar parlant avec synchronisation labiale, expressions faciales et gestes, avec une prise en charge de la sortie 1280p+, idéale pour les présentateurs numériques et les contenus en voix off
Essayer heygen-avatar-iv
Entrée
Créations
Voir toutes les créationsSortie
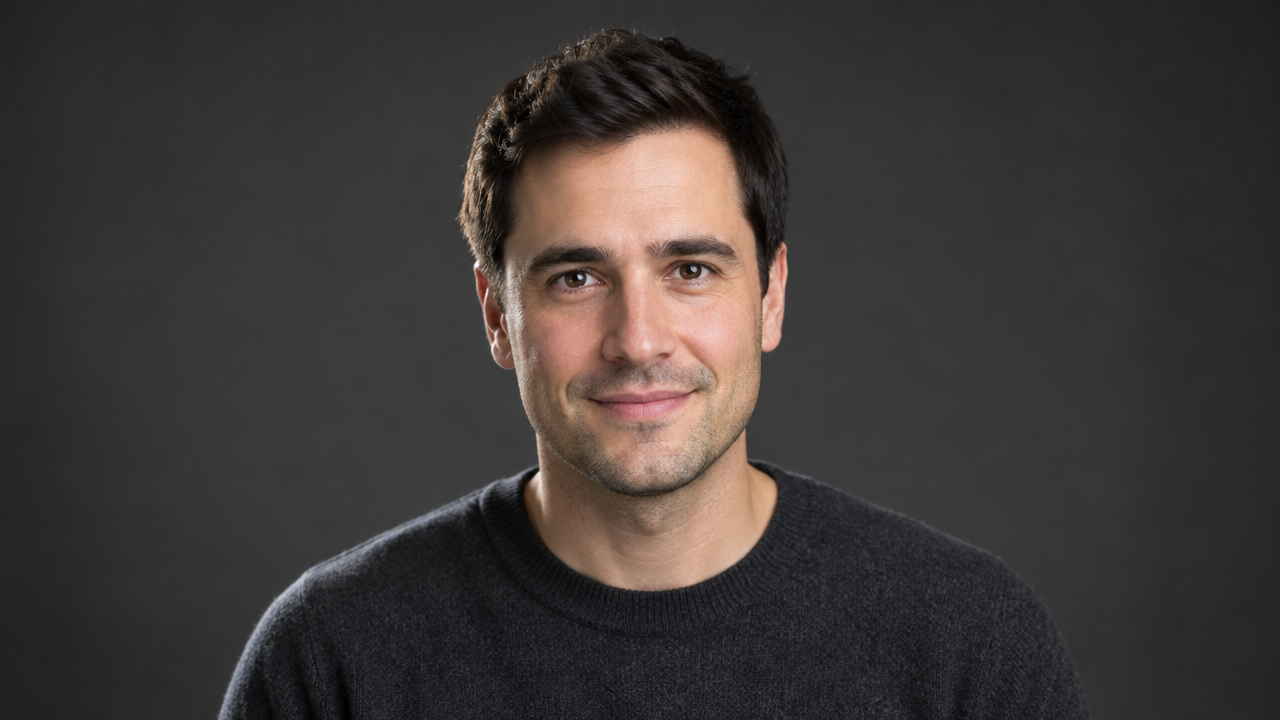
videoGuide visuel des capacités de génération vidéo à partir de texte de HeyGen Avatar IV
Style Voix off · Explication · Vidéo d'avatar
Entrées de référence
image_url
Prompt
Un présentateur s'adresse directement à la caméra dans un décor de studio épuré : cadrage buste, orientation frontale, contact visuel stable avec l'objectif, légers mouvements de tête et gestes naturels accompagnant le rythme de la parole ; lumière principale douce en avant-gauche avec un léger éclairage d'appoint, fond uni gris anthracite neutre, faible profondeur de champ, cadrage large 1080p 16:9, style réaliste de présentation d'entreprise, rythme posé et assuré.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
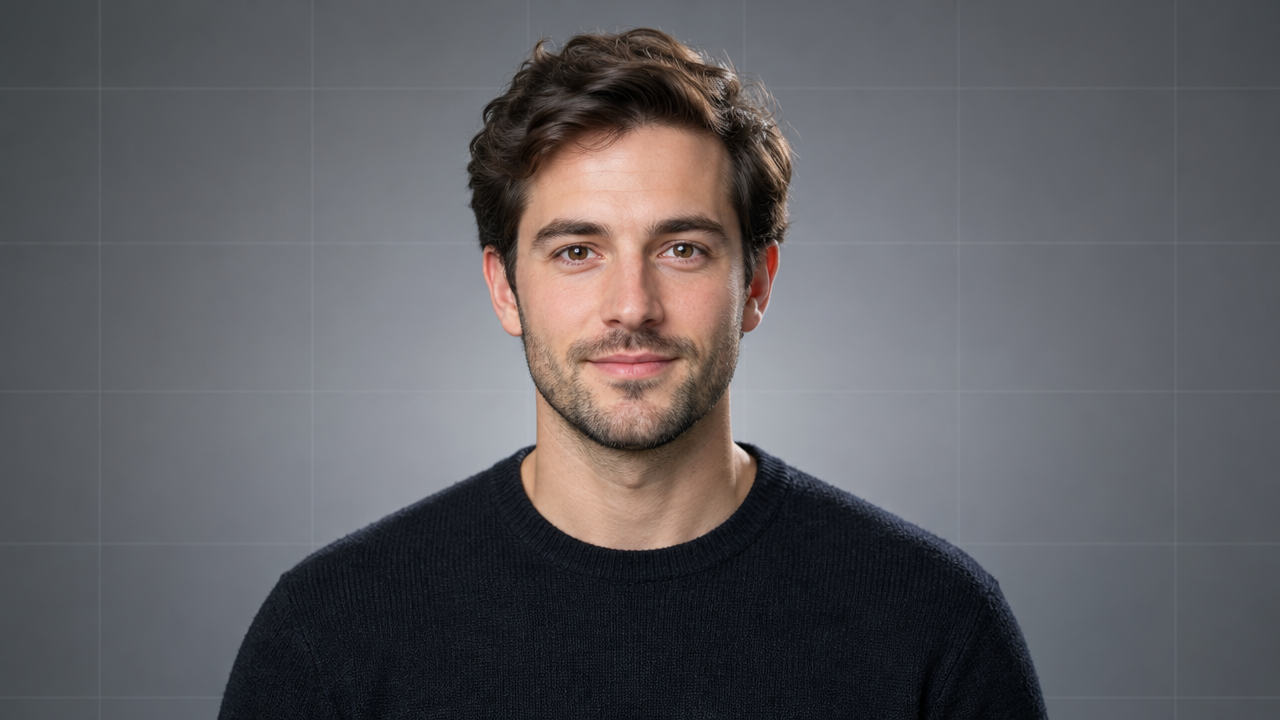
Carte de formule de prompt HeyGen Avatar IV : guide visuel de rédaction structurée
Style Explication · Ingénierie de prompt · avatar parlant
Entrées de référence
image_url
Prompt
Un présentateur face caméra s'adresse directement à l'objectif dans un décor de studio soigné, en brandissant une fiche de formule de prompt imprimée ; plan mi-rapproché, lent et léger travelling avant accompagné d'un doux flottement caméra à l'épaule, éclairage principal doux avec lumière de séparation sur le contour, faible profondeur de champ gardant les bords de la fiche nets et lisibles tout en préservant la netteté du visage ; rythme posé et pédagogique, avec de petits gestes naturels désignant la fiche à chaque paragraphe, arrière-plan en dégradé neutre doux traversé de fines lignes de grille suggérant une mise en page documentaire ; image nette, très détaillée, rendu 1080p.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Notes visuelles sur le langage du mouvement de caméra : démonstration de prise de parole Avatar IV
Style langage-cinématographique · avatar parlant · Explication
Entrées de référence
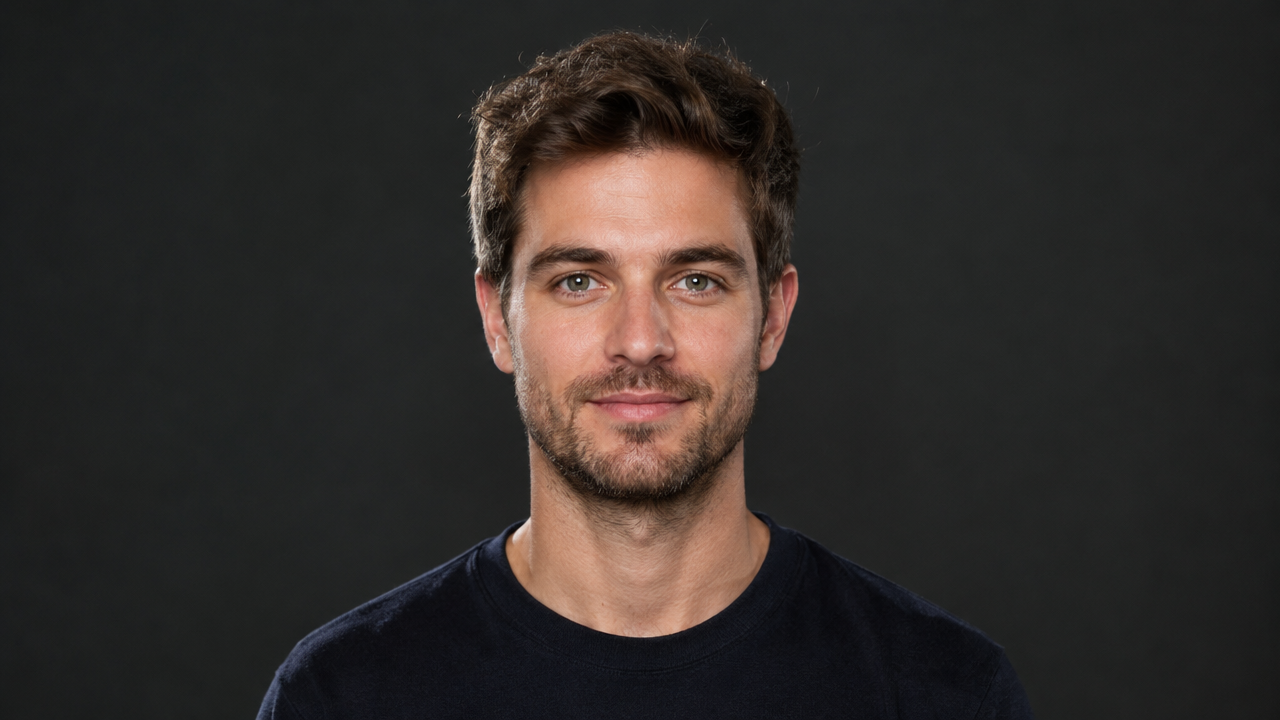
image_url
Prompt
Une personne face caméra s'adresse directement à l'objectif d'un ton calme et explicatif, comme si elle commentait devant la caméra une note visuelle sur les mouvements de caméra. Le regard reste stable, fixé sur l'objectif, la tête bouge légèrement de façon naturelle, avec parfois des gestes explicatifs pour désigner un panoramique horizontal, un travelling avant et des mouvements de tangage. Composition neutre en studio, à l'éclairage uniforme, arrière-plan sombre et peu saturé, ambiance générale d'enregistrement d'écran, rythme posé, avec de courtes pauses entre chaque terme de mouvement de caméra.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Concept de storyboard HeyGen Avatar IV : du texte à l'image parlante
Style avatar parlant · Storyboard · Narration
Entrées de référence
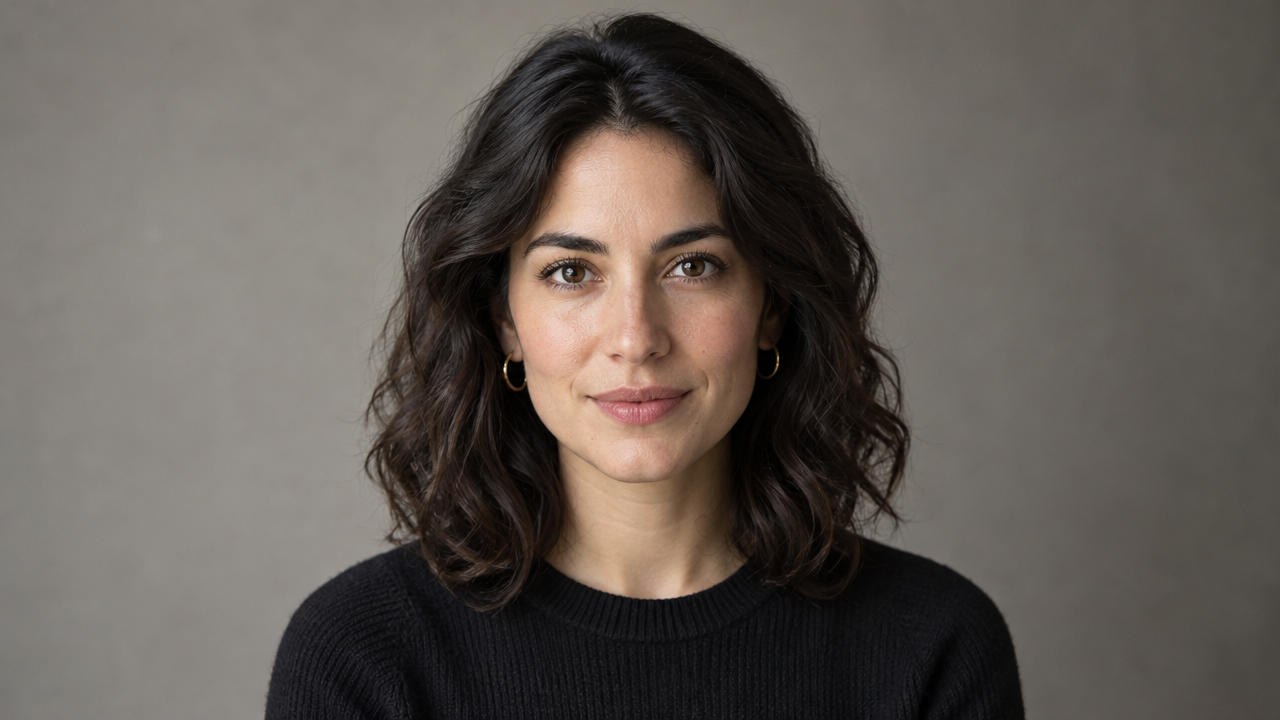
image_url
Prompt
Un portrait solo de face est transformé en vidéo parlante : la personne raconte avec une synchronisation labiale naturelle un court commentaire de storyboard, accompagnée de légers mouvements de tête et de gestes expressifs, au format 16:9 sur un fond neutre et épuré, plan rapproché poitrine stable, éclairage principal doux, rythme posé et assuré.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
heygen-avatar-iv per second
| Prix unitaire | $0.150 |
|---|
Présentation
heygen-avatar-iv est un modèle de vidéo d'avatar parlant proposé par HeyGen, accessible via l'interface unifiée de HiAPI.ai. Le développeur téléverse une photo de visage de face, puis fournit un script textuel ou un fichier audio, pour générer une vidéo parlante avec synchronisation labiale, expressions faciales et gestes. Il prend en charge les sorties 720p et 1080p ainsi que plusieurs formats d'image, ce qui convient aux développeurs et aux équipes de contenu qui ont besoin de produire rapidement des porte-parole numériques ou des séquences de présentation par un personnage.
Points forts
- Une seule photo suffit à animer toute une vidéo parlante — une photo de visage de face accompagnée d'un script ou d'un audio suffit, sans tournage ni création d'actifs 3D pour obtenir un rendu final.
- Expressions et gestes coordonnés à la voix — le rendu ne se limite pas à la synchronisation labiale : les expressions du visage et les mouvements de tête évoluent naturellement avec la parole, pour un rendu proche d'une présentation réelle.
- Double entrée : script texte ou audio — vous pouvez saisir directement un script et choisir une voix, ou transmettre un audio HTTPS pour la synchronisation labiale, ce qui s'adapte aux workflows de doublage existants.
- Format et arrière-plan configurables — plusieurs ratios (16:9, 9:16, 1:1, etc.) et un arrière-plan uni ou une image pour remplir le cadre.
Capacités
Générer une vidéo parlante à partir d'une photo : il suffit de fournir une photo de visage de face pour générer une vidéo parlante ; la sortie est un fichier vidéo directement exploitable ou montable ensuite.
Script converti en voix et synchronisation labiale : saisissez un script et choisissez une voix intégrée ; le modèle synthétise la voix et anime l'avatar, avec un script de 5000 caractères maximum par segment.
Synchronisation labiale sur audio : transmettez un lien audio HTTPS pour que la photo parle en suivant les lèvres de l'audio, avec un audio de 600 secondes maximum ; dans ce cas, les paramètres de script et de voix ne s'appliquent pas.
Contrôle des spécifications de sortie : choisissez une résolution 720p ou 1080p et un ratio 16:9, 9:16, 4:5, 5:4, 1:1 ou identique à l'image d'origine, pour s'adapter aux diffusions horizontales, verticales et carrées.
Remplissage de l'arrière-plan : lorsque le ratio de sortie diffère de celui de la photo, une couleur unie ou une image d'arrière-plan comble les zones vides, évitant les bords blancs.
Cas d'usage
- Équipes marketing produisant des vidéos de porte-parole numériques — générer une vidéo de présentation à partir d'un script produit et d'une photo de personnage de marque, pour le site web, les espaces publicitaires et les réseaux sociaux, sans planifier de tournage avec un présentateur réel.
- Services de formation générant des supports de cours — transformer un support de cours en script et générer en lot des vidéos explicatives à l'image uniforme, à intégrer dans une plateforme d'apprentissage ou un cours.
- Créateurs de vidéos courtes produisant des présentations verticales — choisir un format 9:16 et une voix donnée pour générer des séquences de présentation verticales, directement utilisables pour alimenter une plateforme de vidéos courtes.
- Adaptation multilingue de contenus déjà doublés — transmettre un audio de doublage existant pour la synchronisation labiale et générer, avec une photo, une présentation dans la langue correspondante, pour la localisation de contenus.
Limites et conseils de choix
La photo d'entrée doit montrer un visage net et de face ; un profil, une occlusion ou une photo de groupe dégradent nettement le résultat, et la qualité de génération dépend fortement de l'image source. La sortie est une vidéo et non un texte final ; il faut donc préparer un script ou un audio au préalable. La limite est de 600 secondes par audio et de 5000 caractères par script ; les contenus trop longs doivent être générés par segments. Si vous avez seulement besoin d'un avatar prédéfini ou d'un jumeau numérique d'une personne réelle, choisissez la ligne de modèles correspondante.
Nouveautés
Voir le journal des modifications →- Nouveau modèle Nouveau modèle : heygen-avatar-iv, importez une photo de portrait pour générer une vidéo parlante avec synchronisation labiale à partir d'un texte et d'une voix prédéfinie ou d'un audio de pilotage ; propose…
Questions fréquentes
Voir toutes les questions →-
Quelles entrées sont nécessaires pour HeyGen Avatar IV ?
Une photo de portrait, puis choisissez un mode de pilotage : saisir un script et sélectionner une voix, ou téléverser un fichier audio. Si vous utilisez un script sans sélectionner de voix, la voix par défaut Warm Pro Narrator est utilisée.
-
Quel type de photo donne le meilleur résultat ?
Les photos individuelles de face, avec des traits du visage nets et non masqués, un éclairage uniforme et la bouche naturellement fermée donnent les résultats les plus fiables. Les photos de profil, avec un masque, des photos de groupe ou des photos où le visage est très petit ne conviennent pas.
-
Quelle est la durée de la vidéo générée ?
Il n'est pas nécessaire de transmettre une durée. Lors d'un doublage de dialogue, la durée est déterminée par le dialogue et le débit de parole ; en mode piloté par l'audio, elle correspond à la longueur de l'audio téléchargé, l'audio pouvant atteindre 600 secondes au maximum.
-
Quels formats d'image et résolutions sont pris en charge ?
Les formats d'image pris en charge sont 16:9, 9:16, 4:5, 5:4, 1:1 et auto (conserve le ratio de la photo) ; les résolutions prises en charge sont 720p et 1080p.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : heygen-avatar-iv
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour heygen-avatar-iv et la route default — voir le tableau des paramètres ci-dessous.
voicestringOptionnelDéfaut: "Warm Pro Narrator"minLength 1Spécifie la voix utilisée pour la lecture du script par l'avatar numérique ; par défaut Warm Pro Narrator. Ce paramètre est ignoré lorsqu'un audio_url est fourni.
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer BrittneyTout afficher (94)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstringOptionnelminLength 1maxLength 5000Texte du script que l'avatar numérique devra lire ; obligatoire lorsqu'aucun audio_url n'est fourni.
audio_urlstringOptionnelpattern ^https://Adresse audio HTTPS utilisée pour la synchronisation labiale, d'une durée maximale de 600 secondes ; une fois fournie, prompt et voice sont tous deux ignorés.
image_urlstringRequispattern ^https://Adresse HTTPS de la photo à animer, devant contenir un seul visage net et de face ; formats pris en charge : jpg, jpeg, png, webp, gif, avif, heic, heif.
backgroundobjectOptionnel
Lorsque le rapport largeur-hauteur de sortie diffère de celui de la photo d'origine, définit le réglage d'arrière-plan utilisé pour remplir les zones de l'image non couvertes par le portrait ; peut être spécifié par une couleur ou une image, blanc par défaut.
typestringRequisMode de remplissage de l'arrière-plan, qui détermine si le champ value est interprété comme une couleur ou comme une URL d'image.
colorimagevaluestringRequisminLength 1Valeur concrète de l'arrière-plan : lorsque type vaut couleur, transmettre une valeur hexadécimale #RRGGBB ; lorsqu'il s'agit d'une image, transmettre une adresse HTTPS d'image.
resolutionstringOptionnelDéfaut: "720p"Résolution de la vidéo de sortie, 720p par défaut.
720p1080paspect_ratiostringOptionnelDéfaut: "16:9"Rapport largeur-hauteur de la vidéo de sortie, 16:9 par défaut ; avec la valeur auto, le rapport de la photo source est conservé en priorité, avec un repli sur 16:9 s'il est illisible.
16:99:164:55:41:1autocallbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →-

Tutoriel
Comment utiliser kling-4.0/text-to-video via l'API HiAPI : curl, Python et un exemple de requête fonctionnel
Guide pratique pour les développeurs : prompts cinématographiques, audio synchronisé, interrogation asynchrone et téléchargement des sorties
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Tutoriel pour kandinsky-6.0-pro/image-to-video sur HiAPI : curl + Python
Lancer une requête image-vers-vidéo exploitable sur HiAPI : de l'envoi de la première image à l'interrogation asynchrone jusqu'au téléchargement final
-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler kling-4.0/image-to-video sur HiAPI : curl, Python et interrogation périodique
Modèles associés
Voir tous les modèles →Même type
-
 Vidu Q4 Preview Vidu $0.051 /seconde
-
 HappyHorse 1.0 Alibaba $0.168 /seconde
-
 Kling 3.0 Kuaishou $0.100 /seconde
-
 Wan 2.7 Video Alibaba $0.100 /seconde
-
 Grok Imagine 1.5 Lite xAI $0.029 /seconde
-
 Kling 4.0 Kuaishou $0.330 /seconde
-
 HeyGen Avatar V HeyGen $0.150 /seconde
-
 FLUX 3 Video Black Forest Labs $0.090 /seconde
-
 Gemini Omni 1.1 Flash Google $0.450 /vidéo
-
 Kling AI Avatar Kuaishou --
-
 HappyHorse 1.1 Alibaba $0.160 /seconde
-
 Vidu Q3 Vidu $0.149 /seconde