
Meta
Muse Image 1.0
muse-image-1.0/image-to-image
Modèle de génération et d'édition d'images par raisonnement de Meta, qui décompose d'abord les invites complexes avant de les rendre, peut fusionner plusieurs images de référence et s'appuie sur une recherche web pour garantir l'exactitude factuelle
Essayer muse-image-1.0/image-to-image
Entrée
Créations
Voir toutes les créationsSortie
image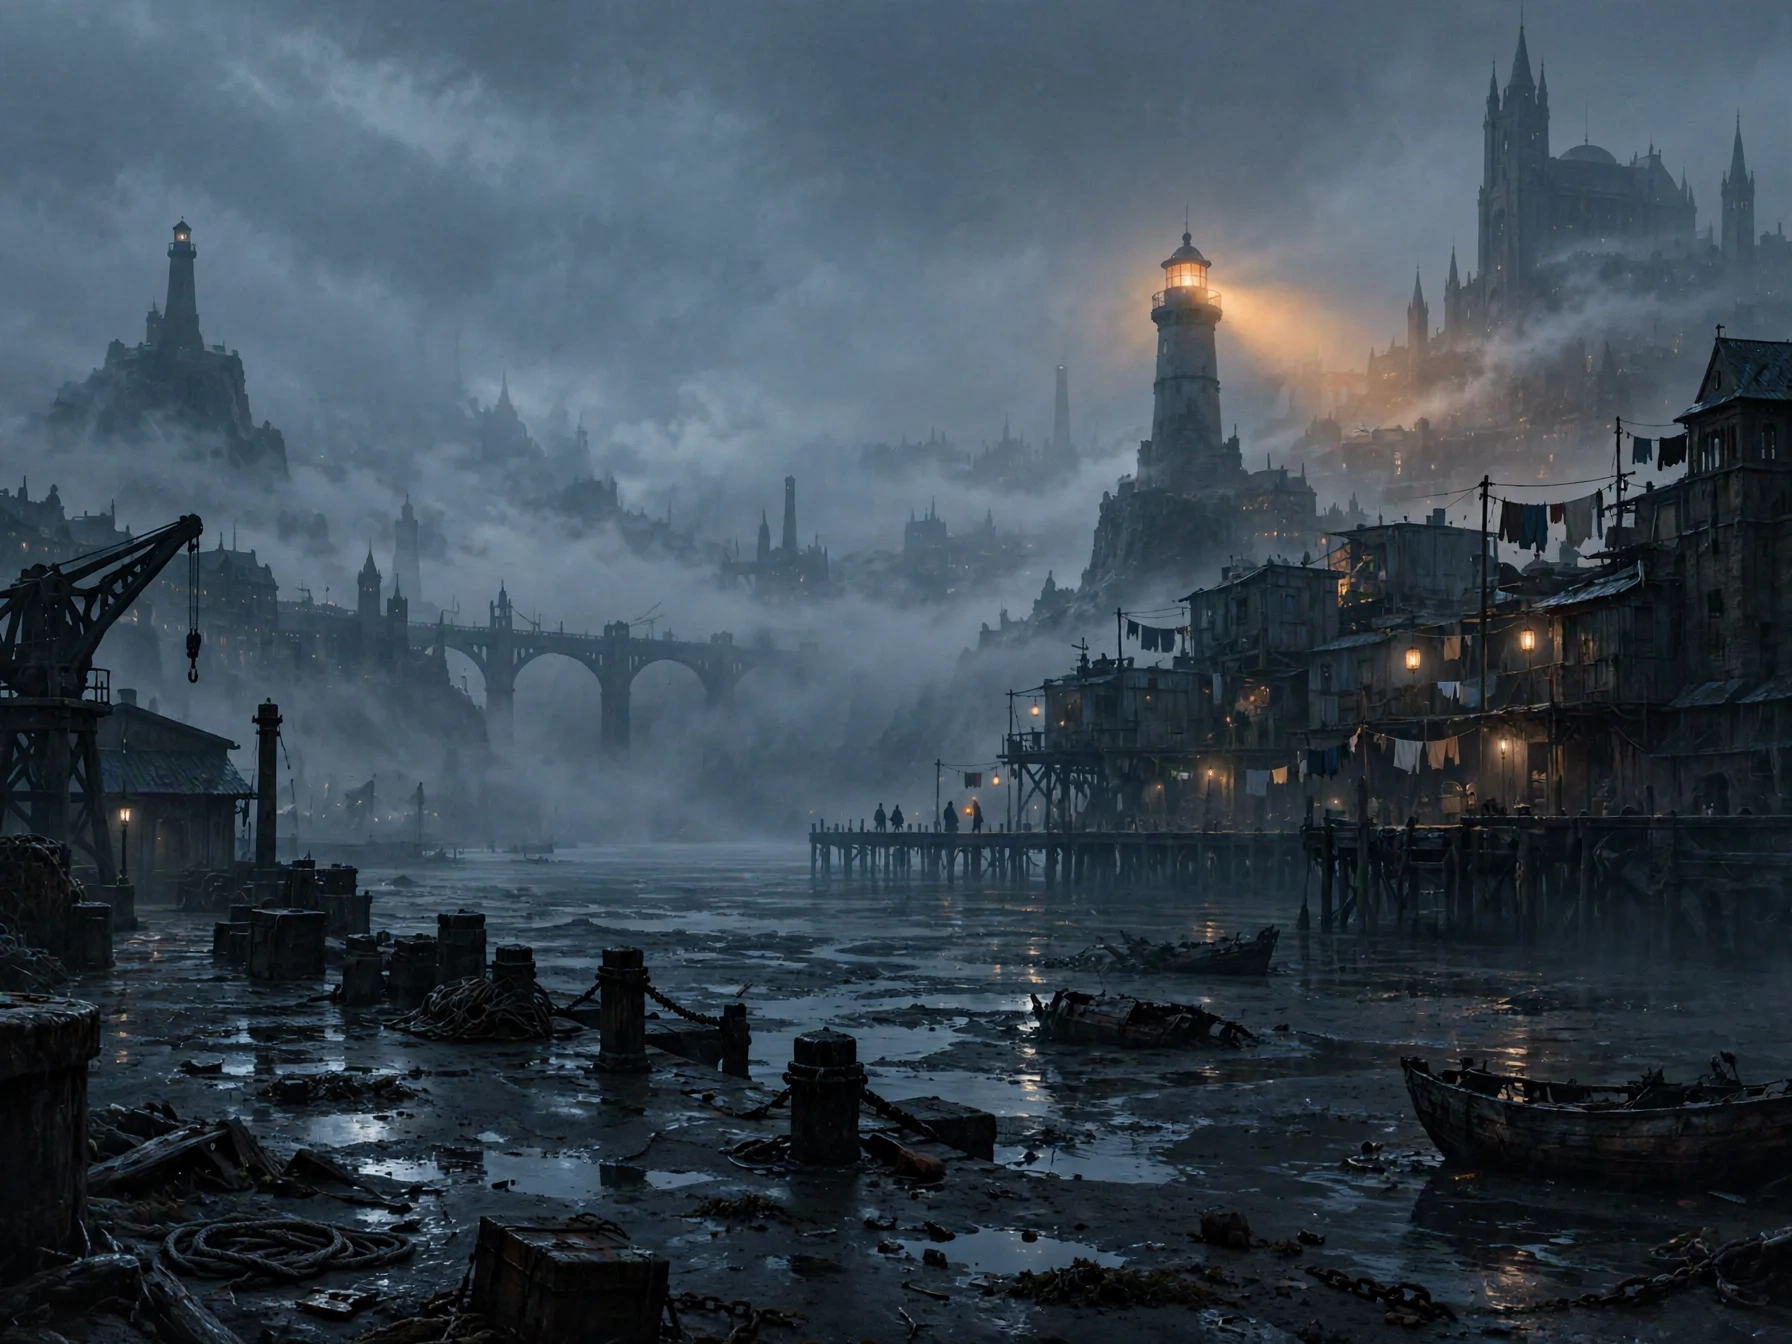
Illustration conceptuelle du monde : exploration atmosphérique de la cité des marées de cendres
Style Art conceptuel · Construction de l'univers · Planche d'humeur
Entrées de référence
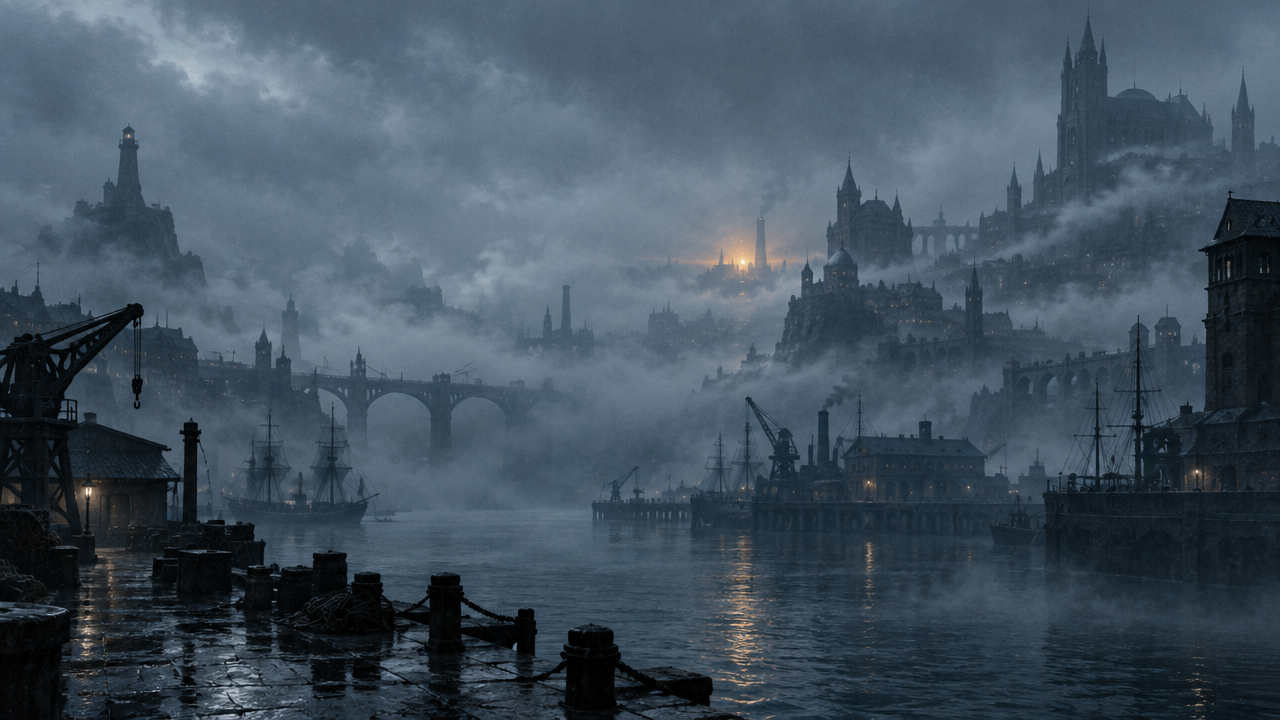
image_urls
Prompt
Concept art cinématographique d'une ville côtière à marée basse, composition panoramique 16:9. Premier plan : une rue de sable noir humide dégagée par la marée, jonchée de coques de navires et de cordages couverts d'une croûte de sel, fins reflets froids du clair de lune. Plan moyen : des arches en acier rongées par le sel et des habitations modulaires empilées sur pilotis, des cordes à linge et des lanternes suspendues, quelques silhouettes marchant le long d'une passerelle en planches. Arrière-plan : un haut phare de marée, un faisceau ambré tamisé traversant un épais brouillard marin, une digue en ruine au loin se fondant dans la brume. Conserver la palette bleu-gris froid, la faible saturation et la densité de brouillard atmosphérique de l'image de référence ; prolonger ses touches de lumière ambrée chaude sur les lanternes et le faisceau du phare. Lumière volumétrique, grain de film doux, rendu de matte painting numérique pictural, détails sobres, contraste doux, sans texte, sans logo.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
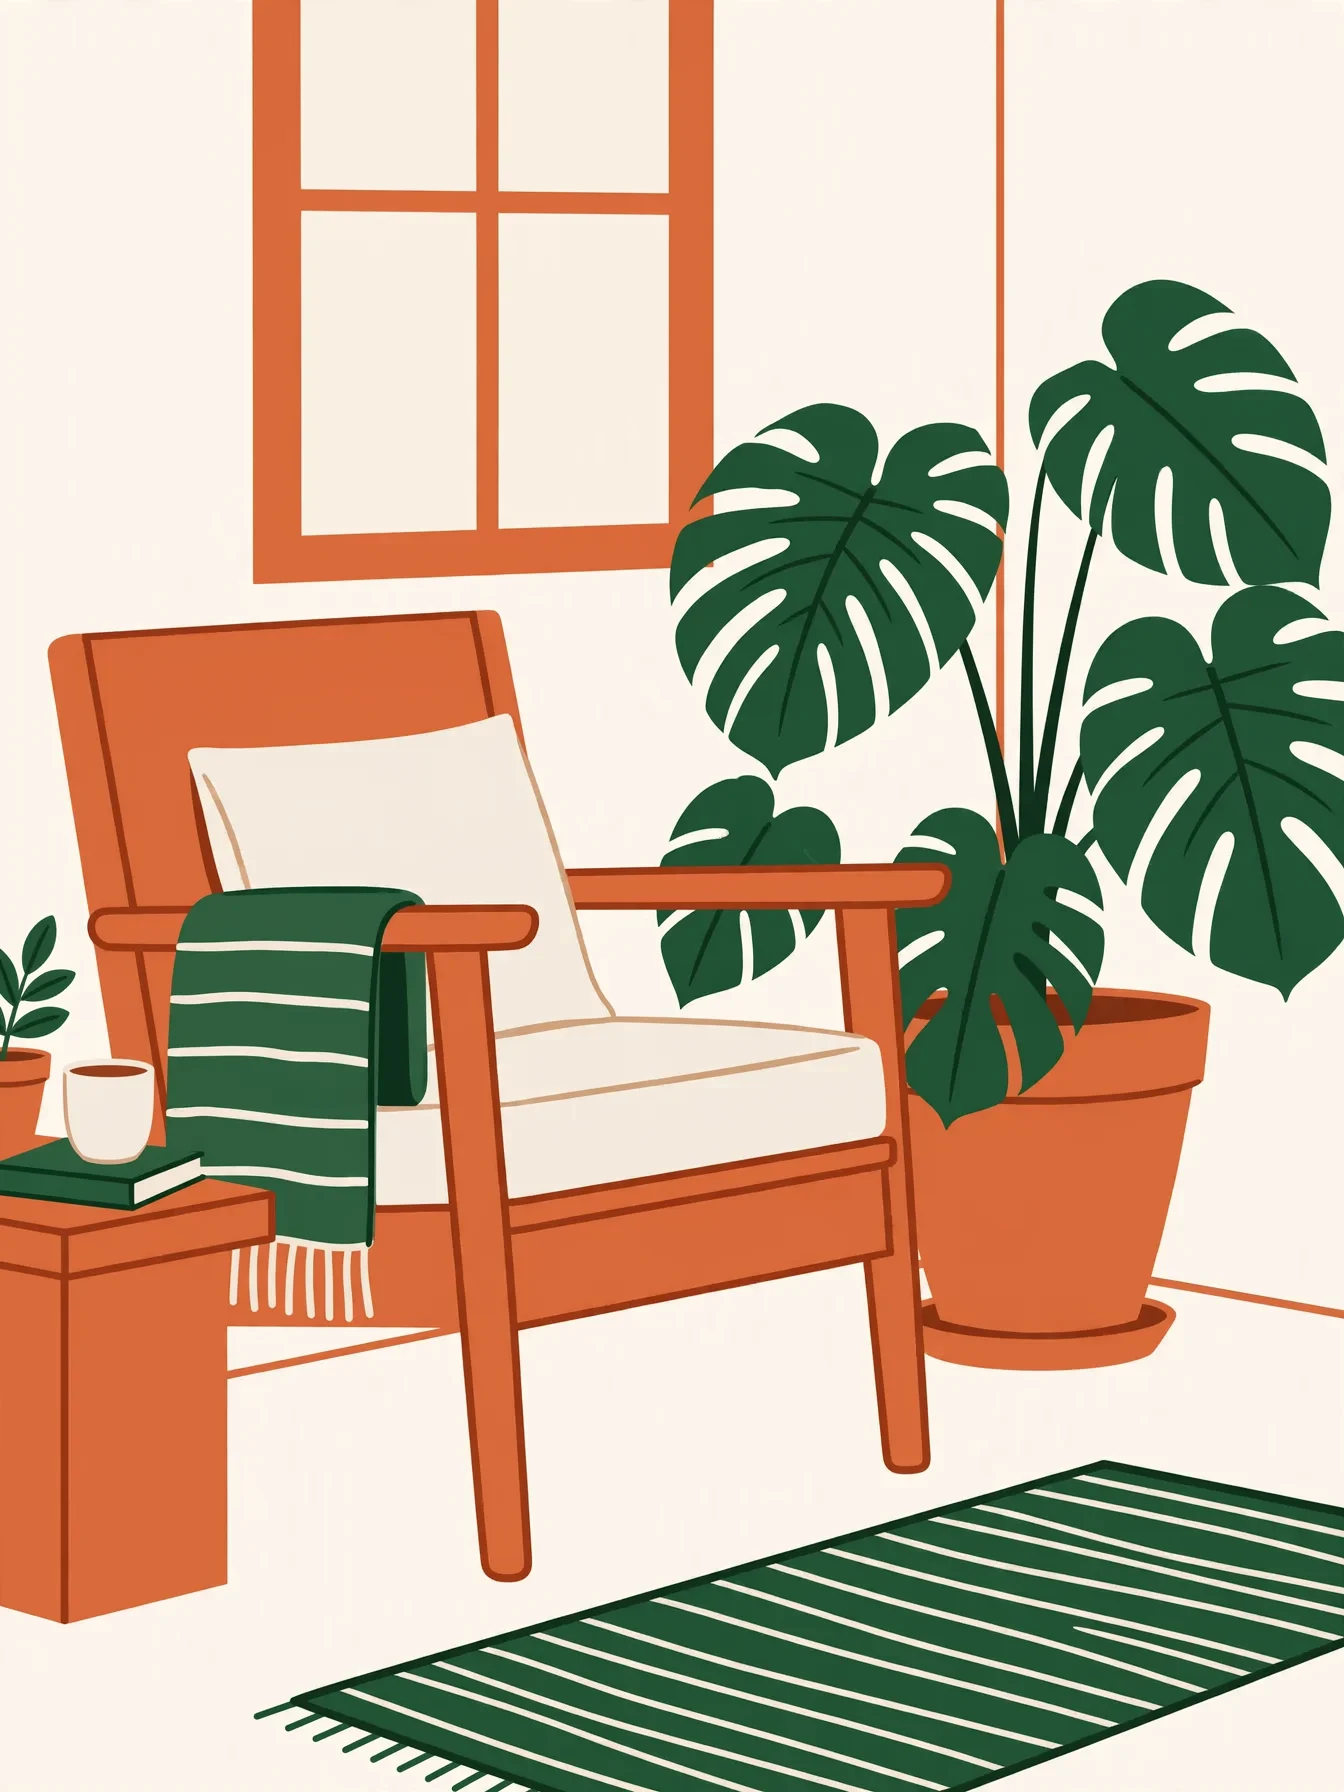
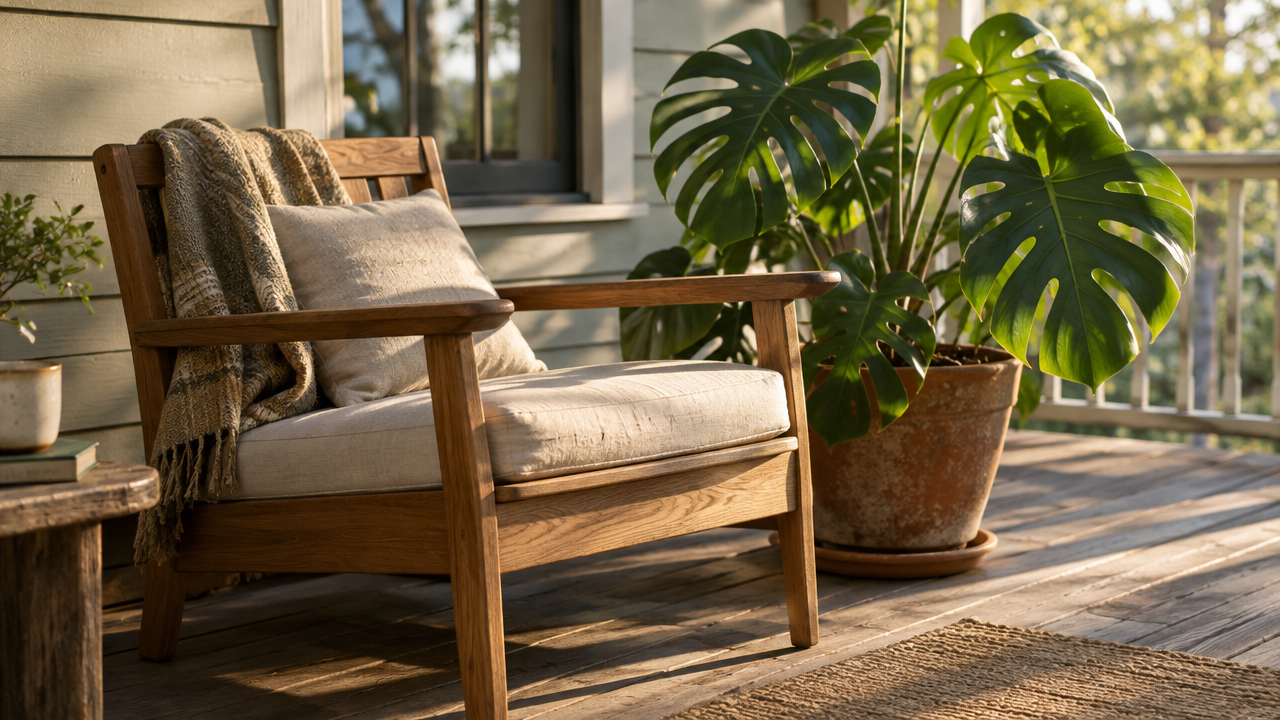
Spectre stylistique : traduction progressive d'une photo réaliste vers l'illustration plate
Style transfert-de-style · Illustration plate · Guidage par référence
Entrées de référence
image_urls
Prompt
Illustration vectorielle plate convertie à partir de la photo de référence : conserver à l'identique l'identité du sujet, la silhouette du fauteuil et la position des plantes de l'image de référence, mais aplatir entièrement tout le reste. Remplacer l'éclairage photographique par deux ou trois teintes unies, compresser la profondeur de champ en plans superposés, supprimer les textures et le grain, utiliser des lignes de contour nettes et franches, ainsi qu'une palette sobre composée de terre cuite chaude, de blanc cassé et de vert profond. Sans dégradés, sans ombres portées, sans conservation des détails photographiques. Composition centrée, avec un espace négatif généreux, dans un style d'illustration éditoriale.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
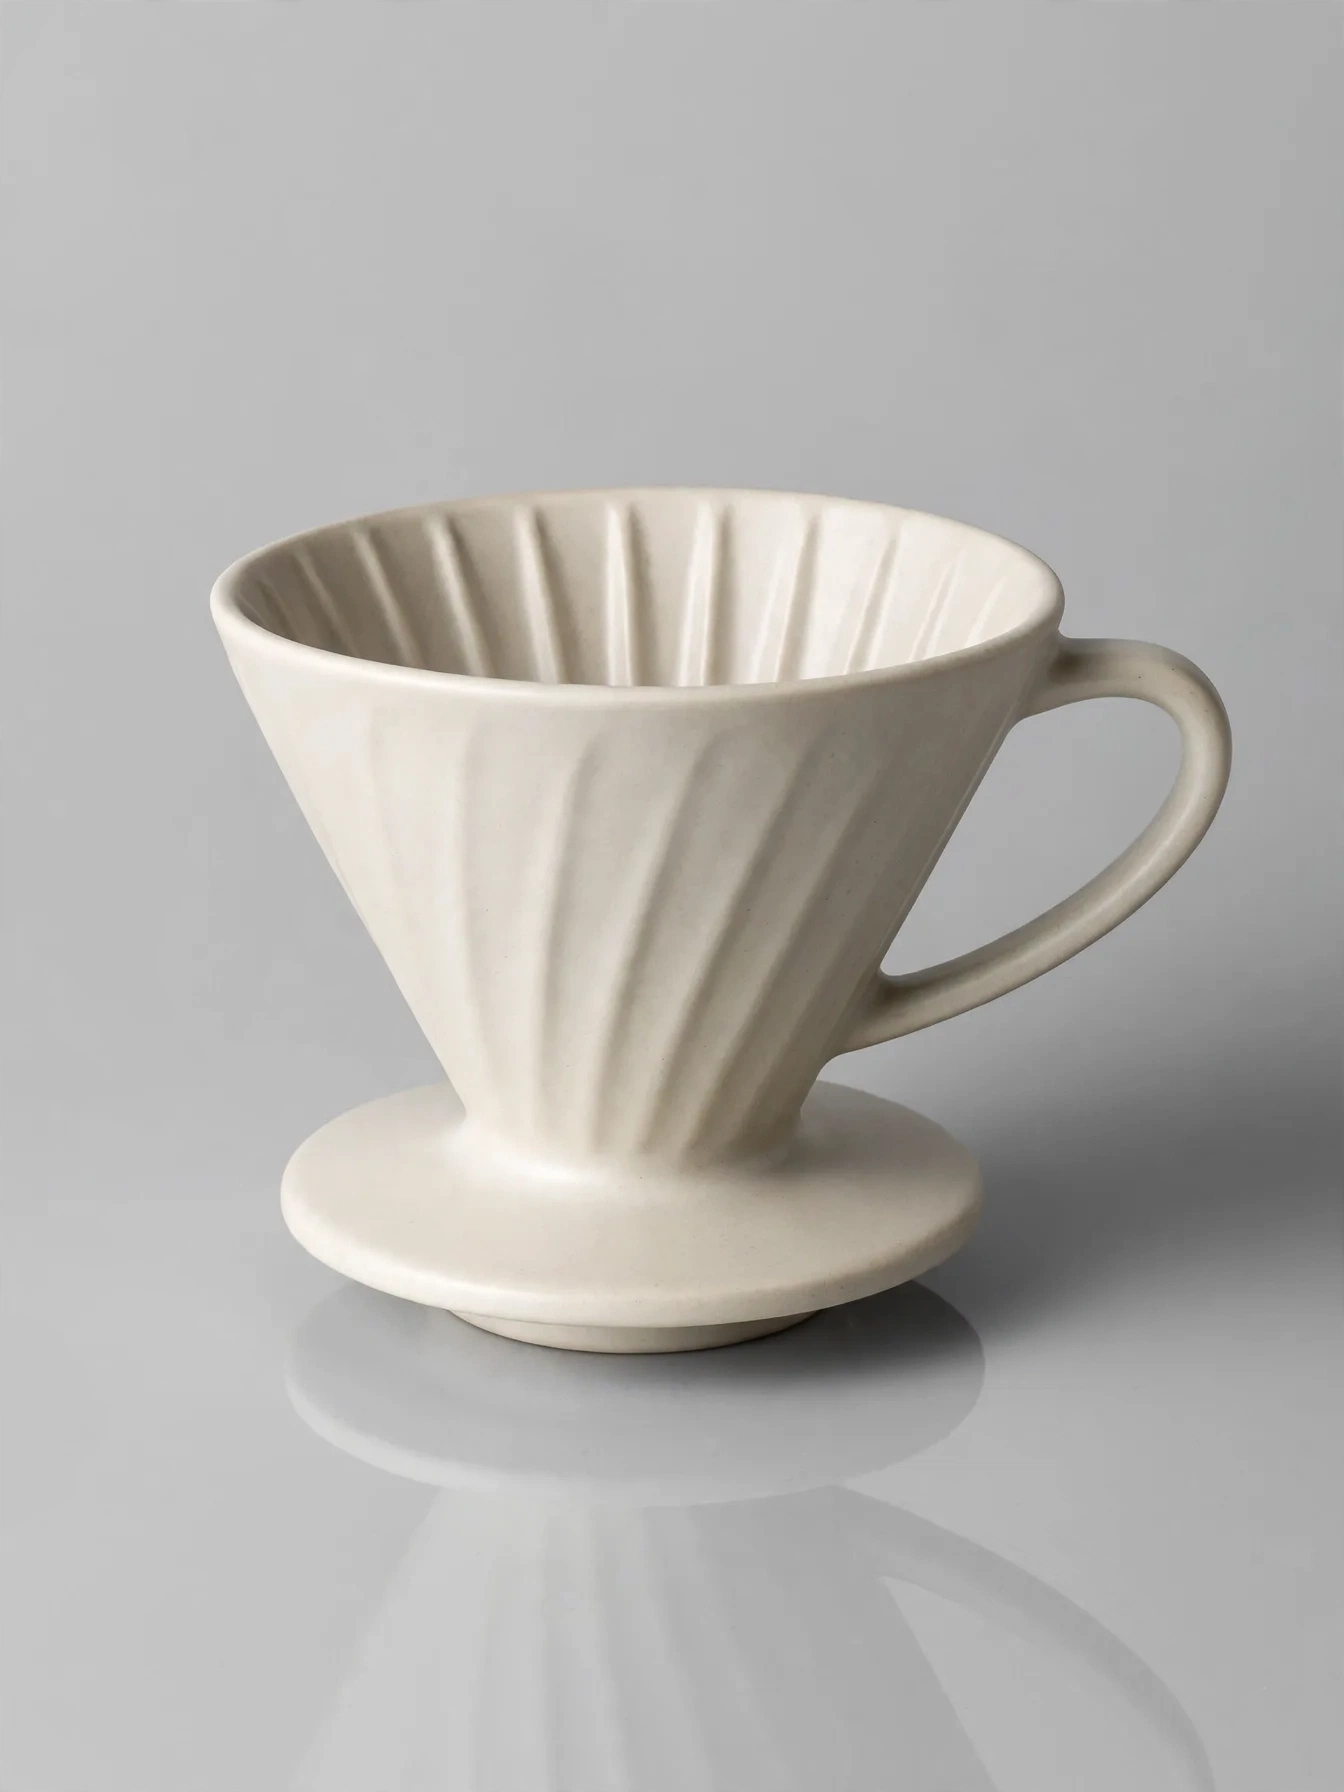
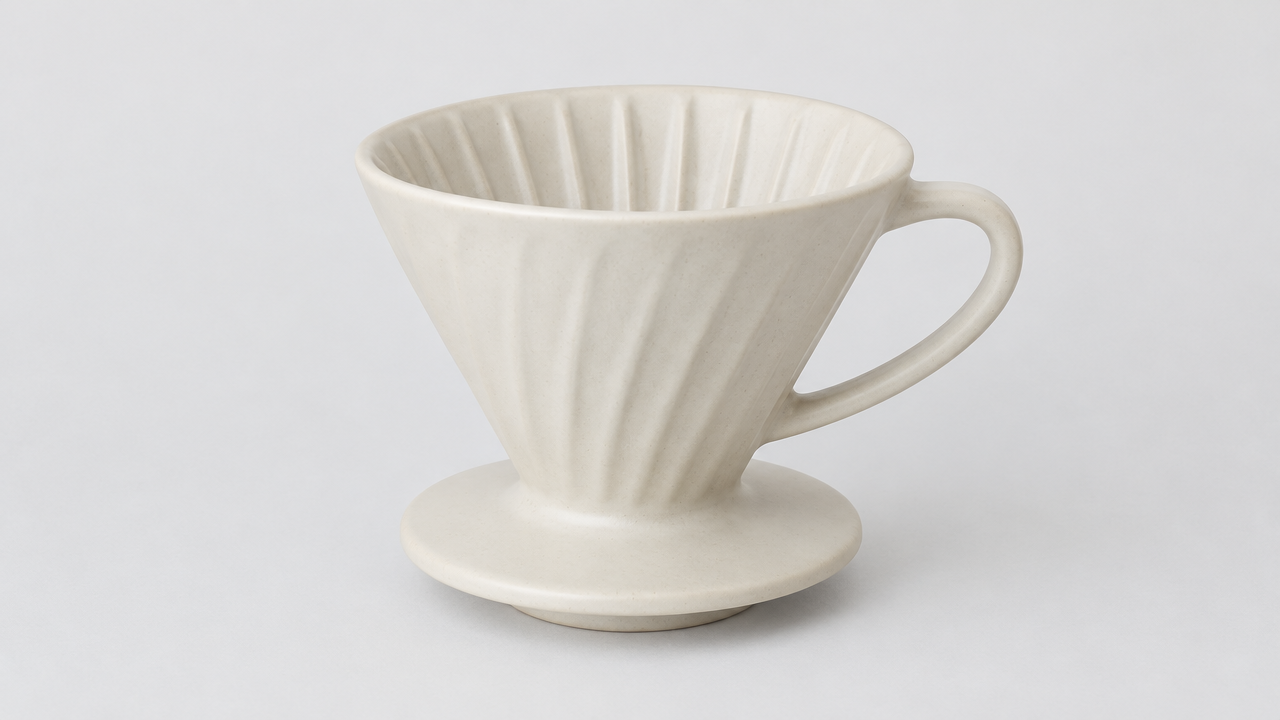
Qualité de photographie produit de niveau e-commerce : d'une image de référence à un rendu de qualité commerciale
Style Image produit · ecommerce · Éclairage de studio
Entrées de référence
image_urls
Prompt
Restyliser le produit de l'image de référence en une photo de produit e-commerce commerciale. Conserver la forme exacte, les proportions, les couleurs, la position du logo et les détails de matière du produit strictement identiques à l'image de référence ; ne pas ajouter, retirer ou redessiner aucune caractéristique. Le placer sur un fond de studio sans raccord gris clair mat, avec une subtile réflexion douce en bas. Éclairage : grande boîte à lumière en source principale depuis le haut à gauche, dégradé doux vers la droite, lumière de contour fine et étroite le long des bords du produit pour le détacher du fond, aucun point spéculaire éclatant sur l'étiquette. Appareil : objectif produit équivalent 85 mm, à hauteur des yeux du produit, angle légèrement de trois quarts, profondeur de champ suffisamment grande pour garder tout le produit net. Composition : produit centré, espace négatif propre et abondant, cadrage horizontal 16:9, adapté à une bannière de boutique. Post-traitement : bords nets, balance des blancs neutre, couleurs fidèles, sans poussière, sans traces de doigts, sans accessoires, sans superposition de texte.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
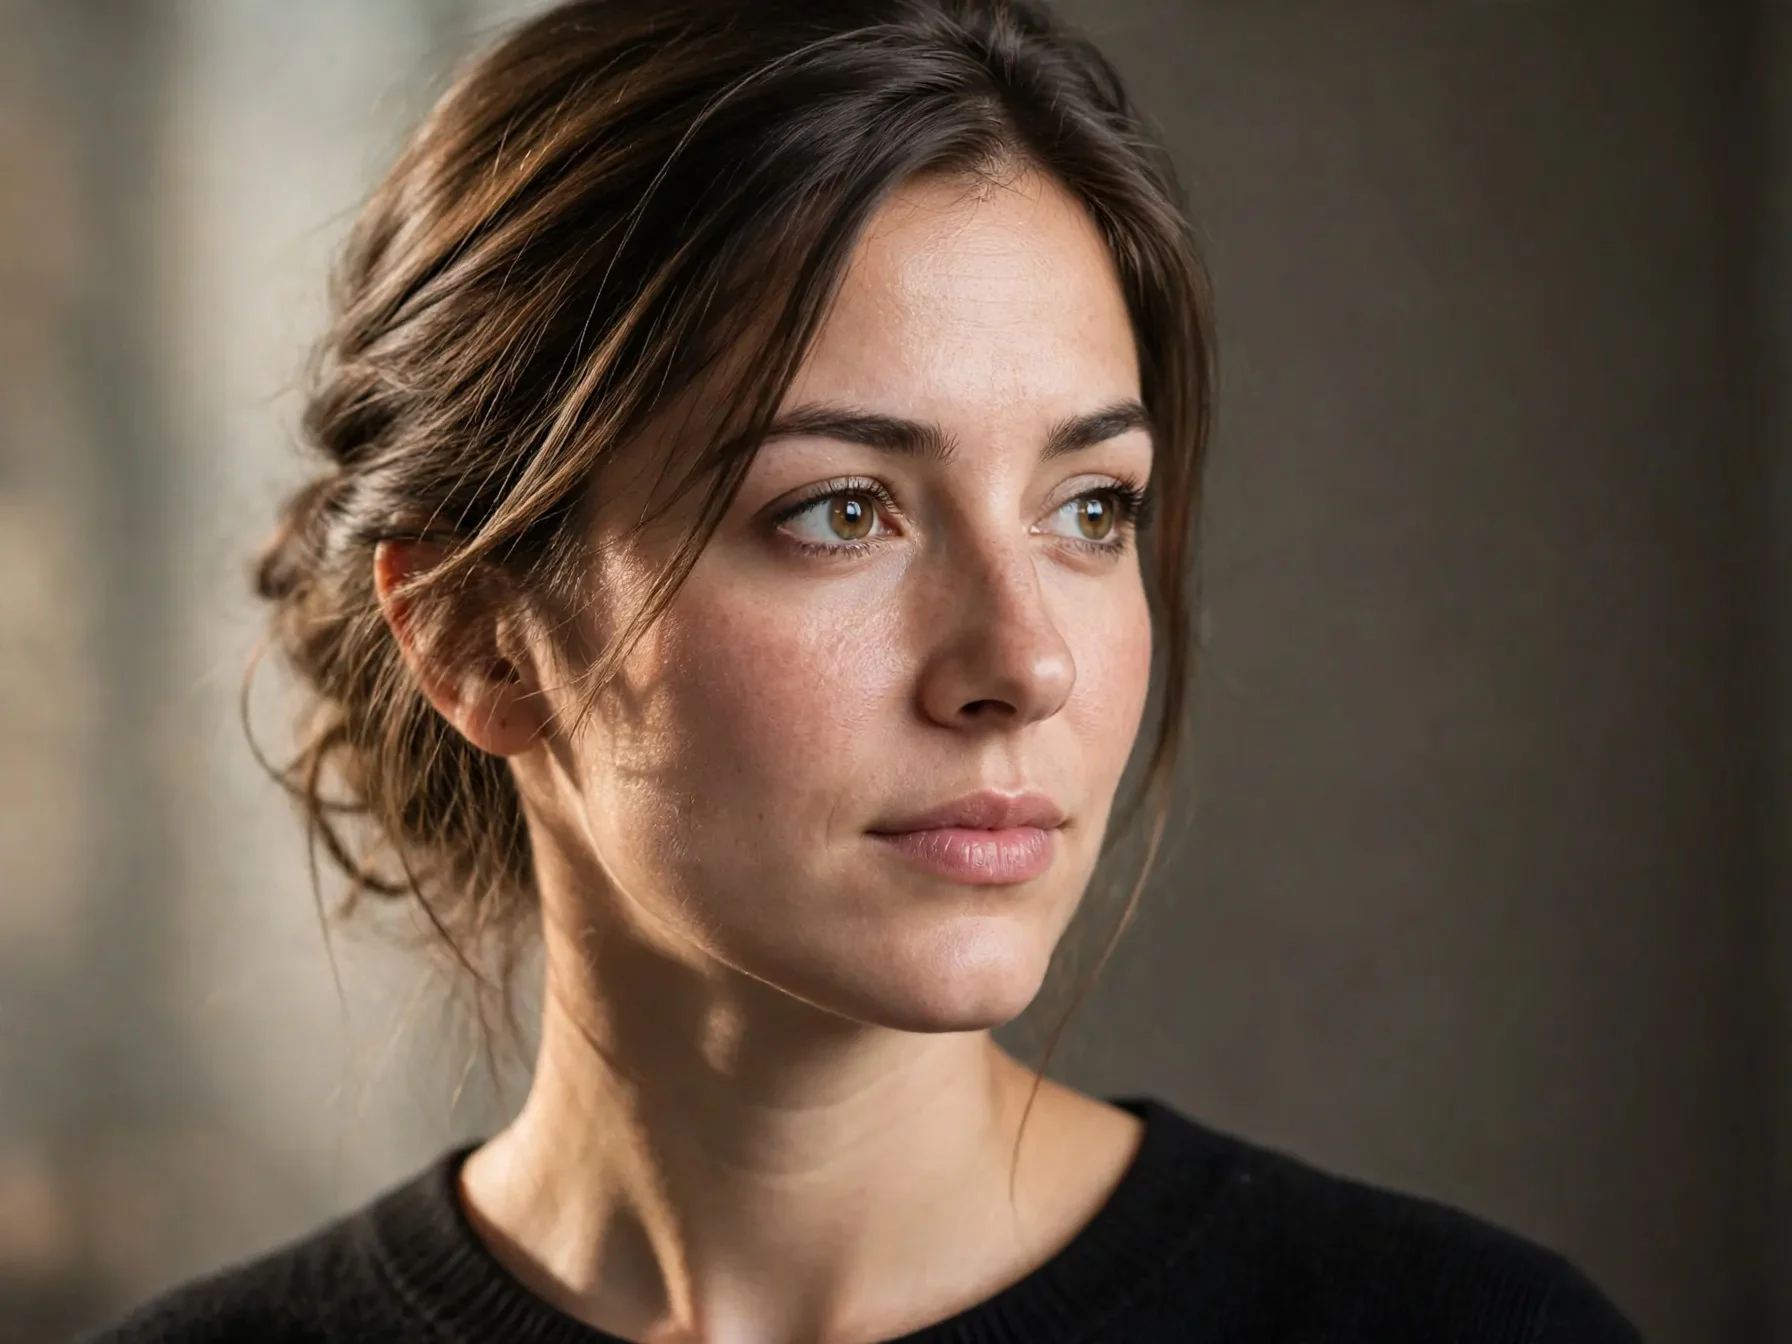
Reproduction de portraits réalistes et artistiques guidée par une image de référence
Style Portrait et photographie · transfert-de-style · Photoréalisme
Entrées de référence
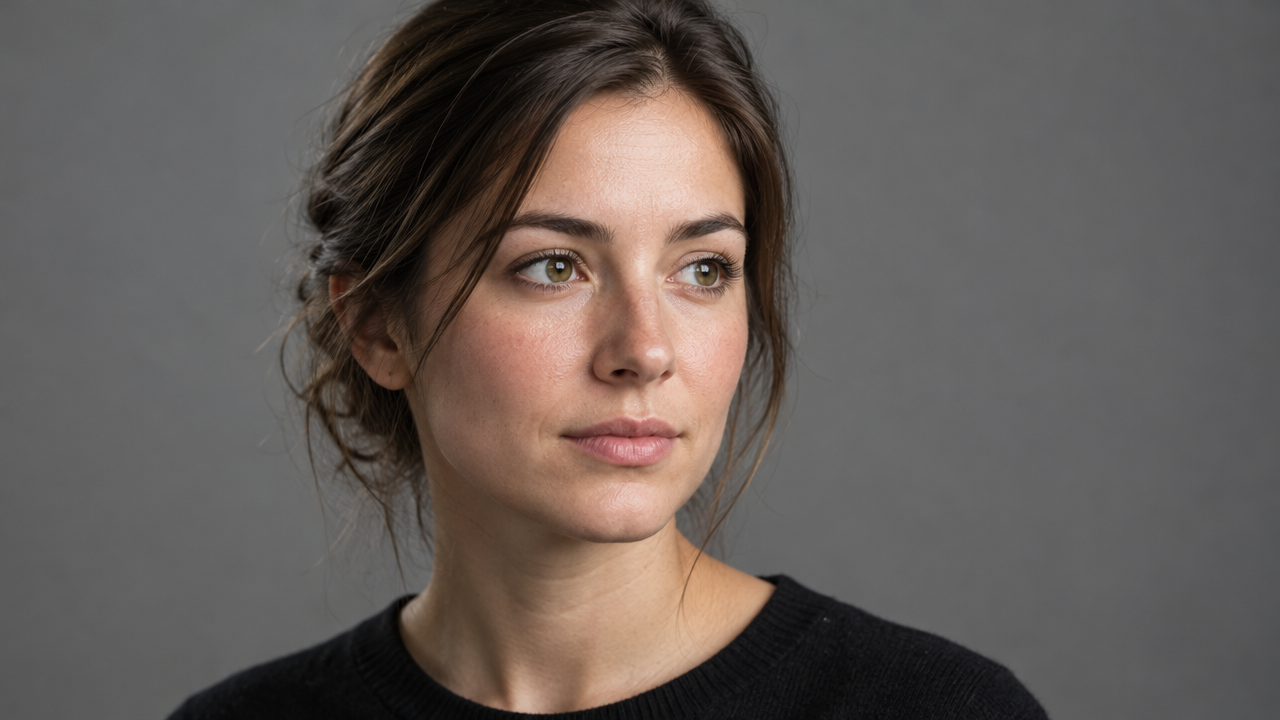
image_urls
Prompt
Style de réinterprétation de portrait en image-vers-image. Utiliser la photo de référence fournie comme unique source pour l'identité du sujet et la composition : conserver la même structure faciale, la même silhouette de coiffure, le même angle de tête et la même posture des épaules. Rendre un portrait unique en plan mi-rapproché, composition verticale 3:4, avec une lumière principale directionnelle douce venant de la gauche de l'appareil photo et une transition légère vers un fond uni gris chaud neutre. Préserver une texture de peau naturelle, avec pores visibles et fins cheveux, de subtils reflets spéculaires sur les pommettes et l'arête du nez, des yeux réalistes avec un reflet de lumière visible, et des transitions de teintes fidèles. Étalonnage sobre, avec un léger contraste de rendu argentique ; pas de stylisation excessive, pas de lissage plastique de la peau, pas d'accessoires ni de texte supplémentaires. Faible profondeur de champ, mise au point nette sur les yeux, effet d'objectif portrait 85 mm.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
muse-image-1.0/image-to-image per task
| Prix unitaire | $0.015 |
|---|
Présentation
muse-image-1.0/image-to-image est un modèle de génération et d'édition d'images guidé par référence, lancé par Meta et accessible via l'interface unifiée de HiAPI.ai. Il prend en entrée une ou plusieurs images de référence, accompagnées d'un prompt textuel, pour réaliser la génération d'une scène, le remplacement d'éléments et la réécriture de style, et décompose puis planifie la mise en page des instructions complexes à plusieurs segments avant le rendu. Il convient aux développeurs qui souhaitent partir de supports existants et recherchent une fidélité au prompt ainsi qu'une efficacité de production par lots, par exemple pour des variantes de supports, des visuels de produits en situation et des compositions personnalisées.
Points clés
- Un processus de génération qui raisonne avant de rendre — avant le rendu, le prompt à plusieurs segments est décomposé et la mise en page planifiée, ce qui réduit le risque que des instructions complexes soient perdues lors d'une génération en une seule passe.
- Génération et édition au sein d'un même modèle — la fusion d'images de référence et la réécriture selon les instructions ne nécessitent pas d'outils d'édition supplémentaires, ce qui réduit le nombre d'appels.
- Plusieurs images de référence en une seule requête — jusqu'à 10 images de référence sont acceptées, chacune pouvant se voir attribuer dans le prompt un rôle de sujet, de style ou de composition.
- Spécifications de sortie contrôlées directement par les paramètres — le rapport d'aspect et le format de sortie jpeg, png ou webp peuvent être spécifiés, facilitant l'intégration aux chaînes de production en aval.
Fonctionnalités
Édition d'image guidée par référence : à partir d'une image de référence et d'un prompt textuel, le contenu de l'image est modifié ou conservé selon le prompt ; idéal pour des ajustements ciblés sur des supports existants plutôt que pour une génération à partir de zéro.
Fusion multi-images : une requête peut contenir de 1 à 10 images de référence, chacune pouvant être annotée dans le prompt avec un rôle de sujet, de style ou de composition, pour des tâches de composition.
Exécution décomposée de prompts complexes : les descriptions à plusieurs segments sont d'abord planifiées puis rendues, ce qui permet de mieux appliquer intégralement des prompts comportant plusieurs sujets et exigences de mise en page.
Contrôle des spécifications de sortie : neuf rapports d'aspect, de 1:1 à 21:9, sont pris en charge, avec un choix de format jpeg, png ou webp, pour une production directement conforme aux besoins de diffusion ou de stockage.
Cas d'usage
- Équipes publicitaires et de diffusion : générer des variantes à partir de supports existants — téléversez un visuel de marque et adaptez la scène et le format via le prompt pour produire plusieurs jeux de supports destinés aux tests A/B et à la diffusion multicanale.
- E-commerce : mise en situation de visuels produits — à partir d'une photo réelle du produit comme référence, remplacez le fond et le décor via le prompt pour obtenir des visuels de catalogue ou de mise en situation destinés aux pages produit.
- Composition personnalisée : intégrer des photos d'utilisateurs dans une nouvelle scène — utilisez les photos téléversées par les utilisateurs comme images de référence pour composer une scène thématique et produire des visuels personnalisés pour des pages d'événements ou le partage sur les réseaux sociaux.
Limites et conseils de sélection
Les sources publiques ne divulguent pas de détails techniques tels que l'architecture du modèle ou la résolution de sortie ; les résultats doivent être évalués selon les effets réels. Le raisonnement en plusieurs étapes entraîne une latence supplémentaire et ne convient pas aux scénarios extrêmement sensibles au temps de réponse ; la sortie est limitée aux images, sans vidéo ni audio. Si la tâche consiste uniquement à générer une image à partir d'un texte, sans image de référence, on pourra choisir la ligne texte-vers-image de la même famille ; si l'on a besoin de génération vidéo ou d'une latence plus faible, il faudra envisager d'autres modèles.
Questions fréquentes
Voir toutes les questions →-
Comment choisir entre la génération d'images et la retouche d'images ?
Lorsque vous ne disposez que de texte et partez de zéro, choisissez la génération d'images ; lorsque vous devez conserver un sujet ou une mise en page existants, choisissez la retouche d'images et fournissez une image de référence.
-
Combien d'images peut-on obtenir à chaque fois ?
Chaque tâche renvoie une image, sans choix du nombre d'images. Pour comparer une autre composition, ajustez le prompt et soumettez une nouvelle tâche.
-
Peut-on choisir entre 1K, 2K ou 4K ?
Cette entrée ne propose pas de niveaux de résolution. Le format est choisi par vous, la taille en pixels est déterminée par le modèle, généralement environ 2,5 MP ; veuillez vous fier aux dimensions réelles du fichier téléchargé.
-
Quels formats de fichier puis-je choisir ?
Vous pouvez choisir JPEG, PNG ou WebP ; si aucun n'est sélectionné, WebP est utilisé. Choisissez selon les besoins des ressources web ou des outils de conception ultérieurs.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : muse-image-1.0/image-to-image
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour muse-image-1.0/image-to-image et la route default — voir le tableau des paramètres ci-dessous.
promptstringRequisminLength 1maxLength 5000Invite de texte décrivant l'image à générer, ou précisant les éléments à modifier et à conserver dans les images de référence ; lorsqu'elle est utilisée avec des images de référence, elle doit indiquer le sujet, le style ou le rôle de composition de chaque image.
image_urlsarrayRequisminItems 1maxItems 10Tableau d'images de référence, dont les éléments sont des adresses d'images, fournissant les images de référence nécessaires à la génération d'image à partir d'image ; il est recommandé d'indiquer dans le prompt le sujet, le style ou le rôle de composition correspondant à chaque image.
Array [ string ]
aspect_ratiostringOptionnelRapport largeur-hauteur de l'image de sortie ; il détermine uniquement les proportions et non une taille précise en pixels.
1:14:33:416:99:163:22:321:9Tout afficher (1)
9:21output_formatstringOptionnelDéfaut: "webp"Format de fichier de l'image téléchargée, webp par défaut.
jpegpngwebpcallbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/image-to-image",
  "input": {
    "prompt": "…",
    "image_urls": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/image-to-image",
input: {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/image-to-image",
"input": {
"prompt": "…",
"image_urls": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →-

Tutoriel
Comment utiliser kling-4.0/text-to-video via l'API HiAPI : curl, Python et un exemple de requête fonctionnel
Guide pratique pour les développeurs : prompts cinématographiques, audio synchronisé, interrogation asynchrone et téléchargement des sorties
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Tutoriel pour kandinsky-6.0-pro/image-to-video sur HiAPI : curl + Python
Lancer une requête image-vers-vidéo exploitable sur HiAPI : de l'envoi de la première image à l'interrogation asynchrone jusqu'au téléchargement final
-

Tutoriel
Comment appeler kling-4.0/image-to-video sur HiAPI : curl, Python et interrogation périodique
Modèles associés
Voir tous les modèles →Même type
-
 Nano Banana 2 Google $0.036 /image
-
 Ideogram V3 Character Ideogram $0.090 /image
-
 FLUX.1 Schnell Black Forest Labs $0.005 /image
-
 Nano Banana 2 Lite Google $0.033 /image
-
 Recraft Crisp Upscale Recraft $0.004 /image
-
 Recraft Creative Upscale Recraft $0.357 /image
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /image
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /image
-
 Grok Imagine Image 2.0 xAI $0.052 /image
-
 Grok Imagine Quality xAI $0.070 /image
-
 851 Labs Background Remover 851 Labs $0.002 /image
-
 FLUX.2 Black Forest Labs $0.035 /image