
Руководство по использованию
Руководство по началу работы с background-remover: границы возможностей, модель тарификации и практика интеграции
От границ возможностей до оценки затрат — быстрая интеграция модели вырезания изображений для разработчиков
Что такое background-remover и в какое звено конвейера его поместить
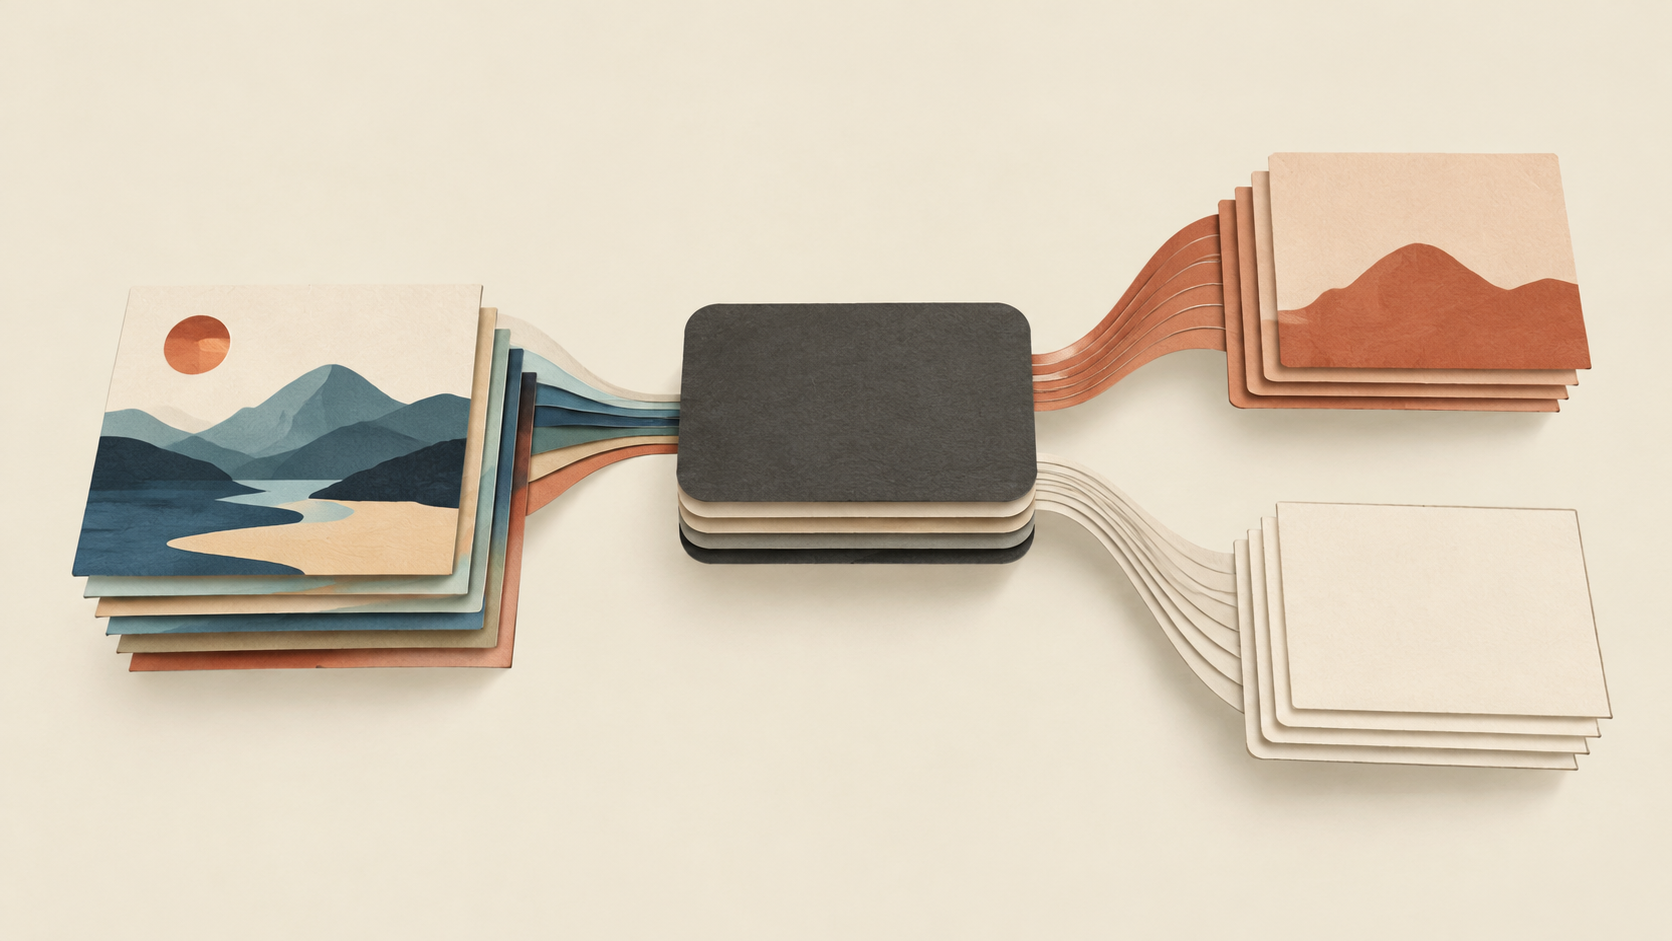
background-remover — это недавно появившийся класс моделей обработки изображений: на входе изображение, на выходе обработанное изображение (image-to-image, тип выхода — изображение). По своей функциональной позиции он относится к категории «вырезание / обработка фона», а не к моделям генерации текста или визуальных вопросов-ответов — вам нужно не текстовое описание картинки, а графический ресурс, который можно передать дальше по конвейеру.
В типичном конвейере обработки изображений его лучше всего разместить в промежуточном звене — после загрузки оригинала и до финального рендеринга:
загрузка оригинала → предобработка (обрезка/сжатие) → background-remover → постобработка (композитинг/цветокоррекция) → хранение/распространение
У такого размещения есть несколько практических преимуществ. Обрезка и сжатие выше по потоку выполняются первыми, что сокращает бесполезные вызовы; композитинг, замена на белый фон и генерация миниатюр ниже по потоку выполняются после получения чистого переднего плана, и логика становится проще. Напротив, если поместить его в самый конец цепочки как «последний штрих», то при несоответствии качества вывода всю предыдущую обработку, возможно, придётся повторять.
Следует заранее уяснить: это управляемый интерфейс модели — вы вызываете, получаете изображение и сами решаете, как его использовать; стратегия распространения, хранения и кэширования изображений по-прежнему остаётся за вашей бизнес-системой. Чтобы решить, стоит ли интегрироваться, первый шаг — не смотреть, сколько всего она умеет, а проверить, действительно ли в вашем конвейере есть стабильная потребность «выделить субъект из фона». Если эта потребность лишь эпизодическая и заменяемая ручной работой, затраты на интеграцию могут не окупиться; если же она массовая, повторяющаяся и требует автоматизированного потока, тогда она заслуживает места в проектном решении.
Границы возможностей: что он умеет и на что не стоит рассчитывать
Прежде чем писать код, стоит жёстко зафиксировать границы — это сэкономит массу времени на отладку интеграции. На основе доступной на данный момент информации мы можем очертить следующий диапазон:
Что можно подтвердить
- Тип задачи: image-to-image, то есть входное изображение — выходное изображение.
- Основное назначение: обработка изображений вроде удаления фона / вырезания субъекта; на выходе — изображение, пригодное для последующего композитинга.
- Способ интеграции: вызов через унифицированный интерфейс модели, тарификация за «штуку» (подробнее ниже).
Что пока не покрыто и не стоит предполагать
Следующие пункты не приведены в фактических материалах, поэтому не проектируйте исходя из «должно быть» — вам нужно самостоятельно провести проверку:
- Конкретные параметры: поддерживается ли указание выходного размера, формата вывода, альфа-канала (прозрачности), размытия краёв и т. п. Это необходимо подтвердить экспериментально.
- Ограничения входа: поддерживаемые форматы изображений, максимальное разрешение, ограничение объёма файла, принимается ли вход с альфа-каналом.
- Поведение на множественных субъектах и сложных сценах: несколько человек, волосы, полупрозрачные объекты, субъекты, близкие по цвету к фону — частоту ошибок на таких граничных сценах нужно измерять на собственном наборе образцов.
- Показатели производительности: время обработки одного изображения, лимит параллельных запросов, правила ограничения частоты.
- Структура ответа: возвращается ли бинарное изображение, временный URL или некая кодированная строка — ориентируйтесь на фактический ответ.
Практичный критерий: всё, что модель не гарантировала, считайте несуществующим, пока вы это не проверили. Особенно не стоит без проверки закладывать в код ниже по потоку предположения вроде «выход обязательно с альфа-каналом» или «разрешение обязательно сохраняется» — такие неявные допущения чаще всего ломаются на этапе постепенного развёртывания.
Если вашему бизнесу нужна классификация изображений, координаты рамок обнаружения объектов или распознавание текста — эта модель не подходит, не стоит её притягивать.
Тарификация за штуку: как рассчитать стоимость $0.002/шт.
background-remover использует тарификацию за штуку: единица расчёта — «за каждое обработанное изображение», а не за токены и не за секунды вывода. Это даёт одно весьма прямое преимущество: формула стоимости предельно проста.
Метод оценки
В основе оценки затрат три переменные: суточный объём обработки, цена за штуку, дополнительные вызовы из-за повторных попыток при сбоях.
суточное число вызовов = суточное число изображений × (1 + доля повторов)
суточные затраты       = суточное число вызовов × цена за штуку
месячные затраты       ≈ суточные затраты × 30
Например (цифры лишь демонстрируют алгоритм, фактическая цена — по панели цен на сайте): если обрабатывать 10 000 изображений в день при доле повторов 3%, суточное число вызовов составит около 10 300; умножьте это количество на цену за штуку — получите суточный бюджет. Суть не в конкретной сумме, а в том, что доля повторов — наиболее легко упускаемый множитель в затратах. Если доля повторов вырастет с 3% до 15%, затраты вырастут пропорционально, и обычно это происходит из-за нестандартного входа или тайм-аутов, а не из-за самой модели.
Контроль бюджета при пакетной обработке
- Дедупликация перед вызовом: частая трата — одно и то же оригинальное изображение обрабатывается в конвейере несколько раз. Идемпотентная проверка по хешу содержимого позволяет сэкономить значительную долю повторных списаний.
- Сначала малая выборка, потом масштабирование: прогоните несколько сотен реальных бизнес-образцов, проверьте качество и время обработки, и лишь затем решайте, запускать ли полный объём, чтобы не тратить бюджет на исследования.
- Установите бюджетные предохранители: настройте оповещения о превышении суточного числа вызовов вместе с лимитом числа повторных попыток (например, максимум 1–2 повтора), чтобы аномальный цикл не пробил бюджет насквозь.
- Разделяйте приоритеты: загрузки пользователей в реальном времени идут через немедленный вызов, исторические пакетные дозагрузки — через очередь; для них отдельно настраиваются ограничения частоты и параллелизма.
Стоит напомнить: тарификация идёт по числу вызовов, а не по «успешно вырезанным субъектам». То есть за вывод, не соответствующий качеству, тоже списываются средства. Поэтому проверка качества — не опция, она напрямую связана с затратами. Актуальные цены — по панели цен на сайте.
Процесс интеграции и ключевые параметры
Сама цепочка интеграции несложна, типичный порядок вызова: аутентификация → отправка изображения → получение обработанного изображения → проверка результата.
1. Получение учётных данных API
Создайте API Key на стороне платформы и поместите его в переменные окружения сервера. Не передавайте учётные данные в браузер или мобильный клиент и не включайте их в артефакты фронтенд-сборки. Если действительно нужна прямая передача с клиента, используйте собственный бэкенд с подписью и переадресацией.
2. Отправка изображения
Отправьте обрабатываемое изображение в соответствии с требованиями интерфейса. Ключевой момент здесь — не «удаётся ли вызвать», а стандартность входа:
- Перед отправкой выполните единообразную нормализацию формата и размера (например, приведите к распространённому растровому формату, ограничьте длинную сторону в пикселях).
- Для слишком больших изображений сначала выполните пропорциональное масштабирование, затем отправляйте — это снижает время передачи и обходит возможные ограничения объёма.
- При большом объёме тела запроса предпочтительнее читать локальный файл или объектное хранилище на стороне сервера, а не собирать большой body на периферии.
3. Получение результата
Ответ может быть бинарным изображением или временным URL — зависит от фактической формы интерфейса. Пишите код разбора исходя из фактического ответа, не фиксируйте один вариант заранее. Если это временный URL, не забудьте до истечения срока действия сохранить файл в собственное объектное хранилище и не записывайте этот URL в базу данных как постоянный адрес.
4. Чек-лист самостоятельной проверки параметров и ограничений
Поскольку нижеперечисленное не приведено в материалах, рекомендуется на одном тестовом изображении подтвердить каждый пункт и записать результаты:
- какие ошибки возвращаются для поддерживаемых и неподдерживаемых форматов входа;
- формат вывода, сохраняется ли альфа-канал, изменяется ли разрешение;
- тайм-аут и распределение времени обработки одного изображения (измерьте хотя бы 20 штук и возьмите квантили);
- поведение при параллелизме: ограничивается ли частота при одновременной отправке нескольких изображений, как выглядят коды ошибок;
- поведение на аномальном входе: пустое изображение, повреждённое, однотонное и т. п.
Закрепите эти выводы в виде внутреннего контракта интерфейса, и весь последующий код ниже по потоку пишите по этому контракту, а не по «я так думаю».
Проверка результата, повторные попытки при сбоях и резерв по качеству
Вывод модели не всегда будет соответствовать ожиданиям, а каждый вызов тарифицируется, поэтому проверка должна быть в конвейере, а не на глазок.
Проверка валидности вывода
Получив результат, выполните по порядку следующее:
- Декодируемость: убедитесь, что возвращённое содержимое действительно является разбираемым изображением, а не сообщением об ошибке, принятым за изображение.
- Разумность размера: совпадают ли ширина и высота вывода с ожидаемыми или попадают ли в допустимый диапазон, чтобы избежать аномалий вроде 0 байт или 1×1.
- Наличие субъекта: быстрая оценка по простому показателю — например, попадает ли доля пикселей переднего плана в разумный диапазон. Слишком высокая доля (почти ничего не удалено) или слишком низкая (субъект ошибочно удалён) должны помечаться как подозрительные.
- Воспроизводимость: записывайте вместе оригинал, вывод, параметры запроса и время обработки для последующего анализа.
Стратегия повторных попыток
Не все сбои стоит повторять:
- Стоит повторять: тайм-аут сети, обрыв соединения, ограничение частоты (типа 429), серверные 5xx. Обычно здесь применяется экспоненциальная задержка с установленным лимитом числа попыток (1–2).
- Не стоит повторять: недопустимый вход (неверный формат, повреждённый файл, некорректные параметры). Повтор лишь повторит списание — нужно исправлять вход.
- Неудовлетворительное качество: если проверка выявила аномальную долю субъекта, можно разрешить один «повтор с изменёнными параметрами» (например, сначала масштабировать, потом отправить), но с общим лимитом числа попыток.
Резерв по качеству
Когда вывод не отвечает бизнес-требованиям, подготовьте путь деградации:
- План деградации: откат к отображению без вырезания (оригинал + предустановленный фон) для сохранения работоспособности бизнеса.
- Очередь ручной обработки: подозрительные образцы направляются в очередь ручной проверки, после ручной обработки результат перезаписывается; это экономнее бюджета, чем повторные вызовы модели.
- Уровневая приёмка: для сценариев отображения на стороне потребителей можно использовать более низкий порог качества, а для главных изображений товаров, печатных материалов и т. п. — обязательно высокий порог; две стратегии настраиваются раздельно.
Принцип одной фразой: повторные попытки решают «не получили», резерв решает «получили, но плохо». Не смешивайте эти два понятия.
Типичные подводные камни и чек-лист диагностики
Ниже — самые частые ловушки при интеграции моделей обработки изображений, эффективнее всего проверять в порядке «вход → сеть/вызов → вывод → тарификация».
Этап входа
- Нестандартные форматы: загружаемые изображения смешаны из WebP, HEIC, CMYK JPEG и не нормализованы перед отправкой, что приводит к прямым сбоям части запросов.
- Превышение объёма/разрешения: большие изображения не сжаты, тело запроса чрезмерно велико, что проявляется как тайм-аут, а не явная ошибка, и легко ошибочно принимается за «нестабильность сервиса».
- Вход с альфа-каналом: после отправки PNG с альфа-каналом поведение отличается от обычных изображений, требует отдельной проверки.
- Повреждённые изображения: усечённые файлы из-за прерывания загрузки приводят к ошибке на стороне модели, но в ваших логах, возможно, видно лишь «сбой обработки».
Этап вызова и сети
- Отсутствие тайм-аута: слишком длинный тайм-аут по умолчанию на клиенте — при зависании интерфейса потоки занимаются полностью, что проявляется как замедление всего сервиса.
- Неограниченный параллелизм: пакетные задачи разом исчерпывают лимит параллелизма, после ограничения частоты идут массовые повторы, что ещё больше усиливает нагрузку.
- Неограниченные повторы: бесконечные повторные попытки после сбоя — самая частая причина выхода бюджета из-под контроля.
- Утечка учётных данных: ключ записан во фронтенд или закоммичен в репозиторий — это инцидент безопасности, а не просто проблема конфигурации.
Этап вывода
- Истечение временного URL: временный адрес сохраняется в базу как постоянный, через несколько дней всё превращается в 404.
- Предположение об альфа-канале: код композитинга ниже по потоку по умолчанию считает, что на выходе есть альфа-канал, а его нет — в результате появляются чёрные края или белый фон.
- Отсутствие проверки разрешения: размер вывода не совпадает с оригиналом, после масштабирования пропорции субъекта искажаются.
Понимание тарификации
- Восприятие сбоя как бесплатного: как только вызов обработки инициирован, тарификация может произойти; вывод неудовлетворительного качества тоже учитывается.
- Повторная обработка одного изображения: отсутствие идемпотентности — одно и то же изображение многократно отправляется в разных звеньях конвейера.
- Отсутствие панели затрат: нет ежедневной статистики числа вызовов, проблемы обнаруживаются только при аномальном счёте.
Рекомендация по диагностике: выводите для каждого вызова параметры запроса, время обработки, код статуса, размер вывода, долю переднего плана на выходе в одну строку структурированного лога. Большинство проблем можно локализовать по этапу именно по этим полям.
Когда стоит его выбирать, а когда — менять решение
Последний вопрос — не технический, а вопрос компромисса. Для решения можно использовать следующие критерии.
Случаи, когда подходит background-remover
- Потребность ясная и единственная: нужно именно выделить субъект из фона, без дополнительной классификации, описания, вывода координат.
- Объём значительный и повторяющийся: ежедневно нужно обрабатывать сотни-тысячи изображений, ручная обработка невыгодна, окупаемость собственной модели не оправдана.
- У команды нет CV-компетенций: нет размеченных данных, нет опыта обучения и эксплуатации инференса, и нет желания нанимать людей специально под это.
- Нужен быстрый запуск: управляемый интерфейс с тарификацией за штуку — затраты на интеграцию сводятся в основном к отладке интеграции и логике проверки, можно запустить за несколько дней.
- Структура затрат контролируема: тарификация за штуку даёт линейное соответствие бюджета и объёма вызовов, легко управлять лимитами.
Случаи, когда стоит рассмотреть другие решения
- Требуется очень сильная управляемость вывода: например, нужно точно контролировать параметры размытия краёв, обязательно гарантировать определённый формат вывода и цветовое пространство, а тесты показали, что управляемый интерфейс этого не обеспечивает.
- Сверхбольшой масштаб и долгосрочная стабильность: когда объём вызовов достаточно велик, а потребность достаточно стабильна, предельные затраты собственного или приватного развёртывания могут оказаться выгоднее, к тому же данные не покидают внутреннюю сеть.
- Ограничения по соответствию данных: изображения содержат конфиденциальную информацию, которую нельзя передавать вовне, обработка обязательно локальная.
- Использование лишь изредка: низкочастотная, неключевая потребность — ручная обработка или готовые инструменты редактирования изображений проще.
- Потребность по сути не в вырезании: например, вам нужна разметка изображений, контроль качества, модерация контента — ищите модели соответствующего типа, а не перекладывайте это на модель вырезания.
Практичный путь принятия решения: сначала проведите маломасштабную проверку на реальных образцах (охватив самые сложные 10% ваших сценариев), затем оцените долю достижения качества и совокупную стоимость за штуку. Если доля достижения достаточна и стоимость приемлема — интегрируйте; если доля достижения едва держится за счёт ручного резерва и доля резерва остаётся высокой, значит, это не подходящий инструмент для данного сценария, и своевременная смена решения выгоднее продолжения подбора параметров.
Сама интеграция несложна, сложно ясно продумать границы, затраты и резерв по качеству. Зафиксируйте эти три пункта — остальное будет делом инженерных деталей.
Похожие статьи
Все статьи →-

Руководство по использованию
Руководство по началу работы с seedream-5.0-pro/image-to-image: возможности, цены и ключевые моменты интеграции
Границы возможностей модели редактирования изображений ByteDance, принципы тарификации и практика инженерной интеграции
-

Руководство по использованию
Руководство по использованию seedream-5.0-pro text-to-image: границы возможностей, интеграция API и контроль затрат
Практический взгляд для разработчиков: от ключевых параметров до оценки стоимости $0.05 за изображение
-

Руководство по использованию
Руководство по началу работы с Hailuo 2.3 Fast для генерации видео из изображений: границы возможностей, цены и практика интеграции
Ключевые моменты выбора и интеграции модели MiniMax для генерации видео из изображений для разработчиков