
Guía de uso
Guía de inicio de background-remover: límites de capacidad, modelo de facturación e integración práctica
De los límites de capacidad a la estimación de costes, integración rápida del modelo de recorte de imágenes para desarrolladores
Qué es background-remover y en qué punto del pipeline encaja
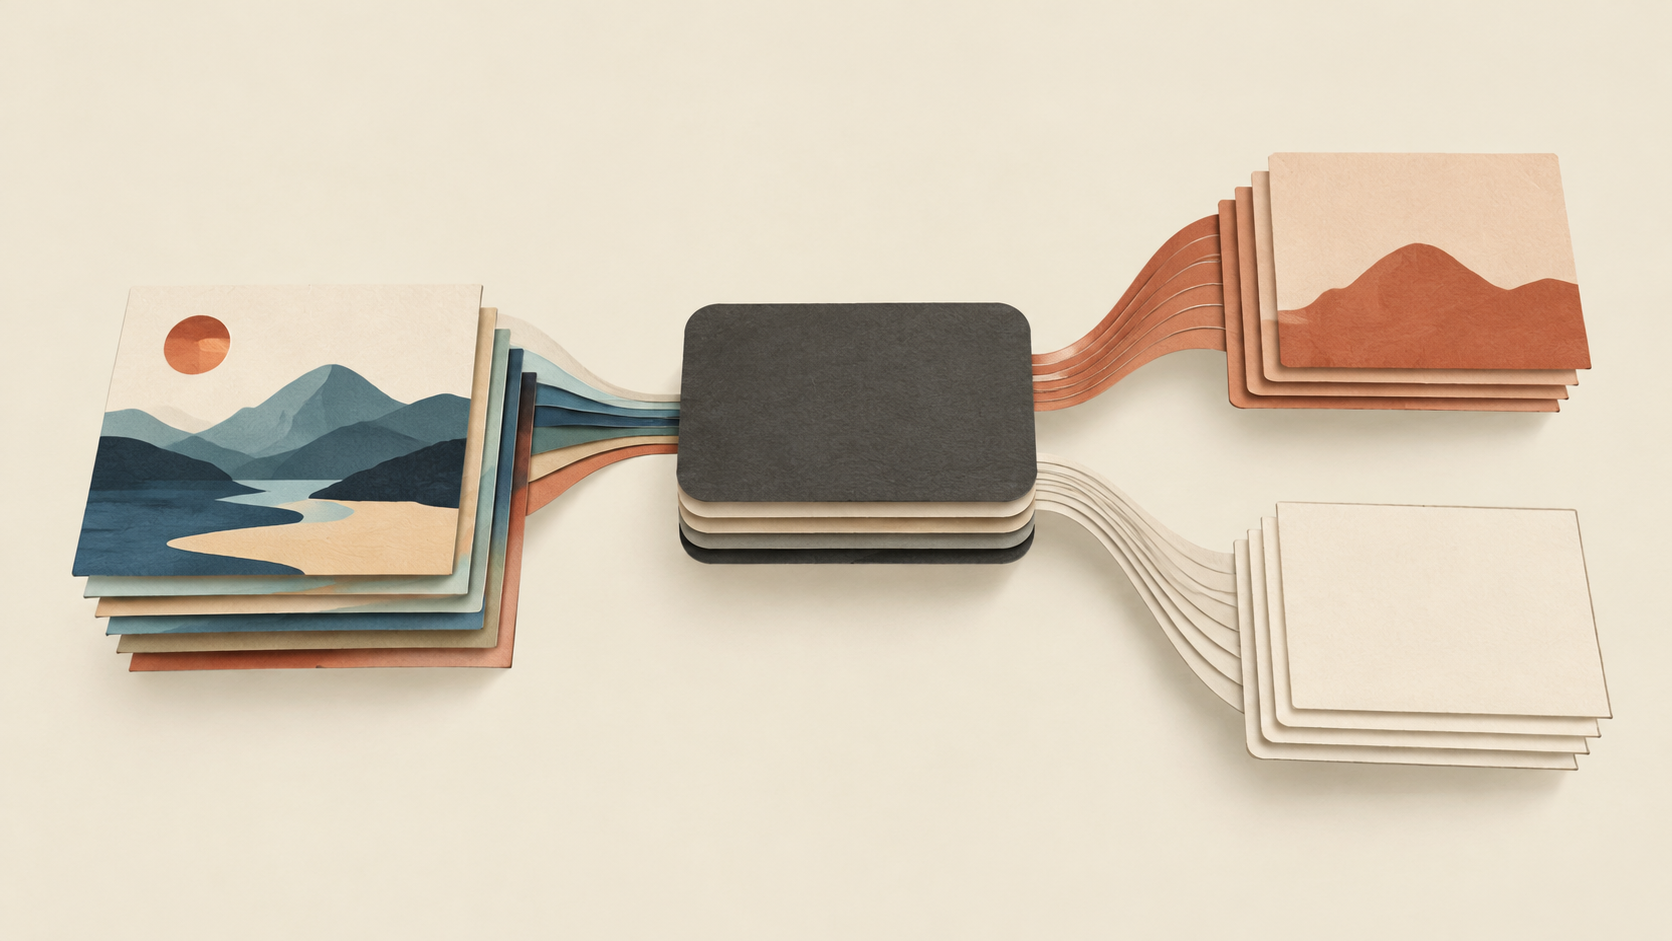
background-remover es un tipo de modelo de imagen lanzado recientemente: recibe una imagen y devuelve una imagen procesada (image-to-image, tipo de salida imagen). Por su posicionamiento de capacidad, pertenece a la categoría de «recorte / procesamiento de fondo», no a modelos de generación de texto o de respuesta visual a preguntas: lo que necesitas no es un texto que describa la imagen, sino un recurso de imagen que pueda seguir fluyendo hacia etapas posteriores.
En un pipeline típico de procesamiento de imágenes, el lugar más adecuado para él es el eslabón intermedio, después de la ingesta de la imagen original y antes del renderizado final:
Subida de imagen original → preprocesamiento (recorte/compresión) → background-remover → postprocesamiento (composición/ajuste de color) → almacenamiento/distribución
Colocarlo en esta posición tiene varias ventajas prácticas. Si el recorte y la compresión se hacen aguas arriba, se reducen las llamadas innecesarias; la composición, la sustitución por fondo blanco y la generación de miniaturas aguas abajo se realizan una vez obtenido el primer plano limpio, con una lógica más simple. A la inversa, si se coloca al final de la cadena como «último paso», en cuanto la calidad de salida no cumpla, todo el procesamiento previo podría tener que repetirse.
Conviene aclarar de antemano que se trata de una interfaz de modelo gestionado: tú llamas, obtienes la imagen y luego decides cómo usarla; las estrategias de distribución, almacenamiento y caché de las imágenes siguen siendo responsabilidad de tu sistema de negocio. Para decidir si integrarlo, el primer paso no es ver cuántas cosas puede hacer, sino comprobar si en tu pipeline existe realmente una necesidad estable de «extraer el sujeto del fondo». Si esa necesidad es solo ocasional y sustituible manualmente, el coste de integración puede no compensar; si es masiva, repetitiva y requiere automatización, entonces sí merece entrar en el diseño.
Límites de capacidad: qué puede hacer y qué no conviene esperar
Antes de ponerse a escribir código, fijar bien los límites ahorra mucho tiempo de integración y depuración. Según la información actualmente confirmable, el alcance que podemos delimitar es:
Confirmado
- Tipo de tarea: image-to-image, es decir, imagen de entrada e imagen de salida.
- Uso principal: procesamiento de imágenes del tipo eliminación de fondo / extracción de sujeto, cuya salida es una imagen utilizable para composiciones posteriores.
- Forma de integración: llamada a través de una interfaz de modelo unificada, con facturación por «imagen» (se detalla más adelante).
Aún no cubierto, no dar por supuesto
Los siguientes puntos no aparecen en los materiales factuales, por lo que no deben diseñarse como «deberían existir»; necesitas ejecutar tu propia ronda de verificación:
- Parámetros concretos: si admite especificar tamaño de salida, formato de salida, canal alfa, suavizado de bordes, etc. Todo esto debe confirmarse en pruebas reales.
- Restricciones de entrada: formatos de imagen admitidos, resolución máxima, límite de tamaño de archivo y si acepta entradas con canal alfa.
- Rendimiento con múltiples sujetos y escenas complejas: personas múltiples, cabello, objetos semitransparentes, sujetos con colores cercanos al fondo; la tasa de fallo en estos casos límite debe medirse con tu propio conjunto de muestras.
- Métricas de rendimiento: tiempo de procesamiento por imagen, límite de concurrencia y reglas de limitación de tasa.
- Estructura de respuesta: si devuelve binario de imagen, una URL temporal o algún tipo de cadena codificada; debe basarse en la respuesta real.
Un criterio pragmático de decisión es: todo lo que el modelo no haya prometido debe tratarse como inexistente hasta que lo hayas medido. En particular, no escribas en las suposiciones del código aguas abajo, sin verificación previa, cosas como «la salida siempre incluye canal alfa» o «siempre mantiene la resolución original»; ese tipo de suposiciones implícitas es lo que más fácilmente estalla en la fase de despliegue gradual.
Si tu negocio necesita clasificación de imágenes, coordenadas de cajas de detección de objetos o reconocimiento de texto, este modelo no es el adecuado; no lo fuerces.
Facturación por imagen: cómo calcular el coste de $0.002/imagen
background-remover utiliza facturación por imagen, y la unidad de precio es «por cada imagen procesada», no por token ni por segundos de salida. Esto aporta una ventaja muy directa: la fórmula de coste es extremadamente simple.
Método de estimación
La estimación de costes se basa en tres variables: volumen diario de procesamiento, precio por imagen y llamadas adicionales por reintentos fallidos.
Llamadas diarias = imágenes diarias × (1 + tasa de reintento)
Coste diario     = llamadas diarias × precio por imagen
Coste mensual    ≈ coste diario × 30
Por ejemplo (las cifras solo ilustran el algoritmo; el precio real debe consultarse en el panel de precios del sitio): si se procesan 10.000 imágenes al día con una tasa de reintento del 3%, el volumen diario de llamadas sería de unas 10.300; multiplicar esa cantidad por el precio unitario por imagen da el presupuesto diario. Lo importante no es la cifra concreta, sino que la tasa de reintento es el multiplicador más fácil de pasar por alto en el coste. Si la tasa de reintento sube del 3% al 15%, el coste sube en la misma proporción, y esto suele deberse a entradas no normalizadas o a tiempos de espera agotados, no al modelo en sí.
Control de presupuesto en procesamiento por lotes
- Deduplicar antes de llamar: es un desperdicio habitual que la misma imagen original se procese varias veces en la cadena. Hacer una comprobación de idempotencia con un hash de contenido puede eliminar una proporción considerable de facturación duplicada.
- Primero una muestra pequeña, luego escalar: validar la calidad y el tiempo de proceso con unos cientos de muestras reales de negocio antes de decidir si abrir a todo el volumen, para no usar el presupuesto en exploración.
- Establecer barandillas de presupuesto: alertas de límite sobre el volumen diario de llamadas, junto con un límite de reintentos (por ejemplo, máximo 1–2 reintentos), para evitar que un bucle anómalo agote el presupuesto.
- Distinguir prioridades: las subidas en tiempo real de los usuarios van a llamadas inmediatas; el relleno masivo de imágenes históricas va por cola; ambas se configuran por separado en limitación de tasa y concurrencia.
Cabe advertir que: la facturación se hace por número de llamadas, no por «sujeto extraído con éxito». Es decir, las salidas que no cumplen la calidad también se facturan. Por eso la validación de calidad no es opcional: afecta directamente al coste. Para precios en tiempo real, consulta el panel de precios del sitio.
Proceso de integración y puntos clave de los parámetros
La cadena de integración en sí no es compleja; el orden típico de llamada es: autenticación → envío de imagen → recepción de la imagen procesada → validación del resultado.
1. Obtener credenciales de API
Crea una API Key en la plataforma y colócala en las variables de entorno del servidor. No distribuyas las credenciales al navegador ni al cliente móvil, ni las incluyas en el artefacto de empaquetado del frontend. Si realmente necesitas subida directa desde el cliente, hazlo mediante tu propio backend con firma y reenvío.
2. Enviar la imagen
Envía la imagen a procesar según lo exija la interfaz. La clave de este paso no es «si la llamada funciona», sino si la entrada está normalizada:
- Realiza una normalización de formato y tamaño antes del envío (por ejemplo, convertir todo a un formato de mapa de bits común y limitar el lado largo en píxeles).
- Para imágenes muy grandes, redimensiónalas proporcionalmente antes de enviarlas; así reduces el tiempo de transferencia y evitas posibles límites de tamaño.
- Cuando el cuerpo de la petición sea grande, prioriza que el servidor lea el archivo local o el almacenamiento de objetos, en lugar de construir un body enorme en el borde.
3. Recibir el resultado
La respuesta puede ser binario de imagen o una URL temporal, según la forma real de la interfaz. Escribe el código de análisis basándote en la respuesta medida, no lo fijes de antemano a una sola forma. Si es una URL temporal, recuerda guardar el archivo en tu propio almacenamiento de objetos antes de que caduque; no escribas esa URL directamente en la base de datos como dirección permanente.
4. Lista de autoverificación de parámetros y restricciones
Como los siguientes contenidos no aparecen en los materiales, se recomienda confirmarlos y registrarlos uno por uno con una imagen de prueba:
- Qué error devuelve cada formato de entrada admitido y cada formato no admitido;
- Formato de salida, si conserva el canal alfa y si cambia la resolución;
- Tiempo de espera y distribución del tiempo de procesamiento por imagen (medir al menos 20 imágenes y tomar cuantiles);
- Comportamiento en concurrencia: si se aplica limitación de tasa al enviar varias a la vez y cómo son los códigos de error;
- Comportamiento ante entradas anómalas como imágenes vacías, corruptas o de color uniforme.
Consolida estas conclusiones en un contrato de interfaz interno; todo el código aguas abajo debe escribirse según ese contrato, no según «lo que yo pensaba».
Validación de resultados, reintentos fallidos y red de seguridad de calidad
La salida del modelo no siempre cumplirá lo esperado, y cada llamada se factura, así que la validación debe estar en la cadena, no depender del ojo humano.
Validación de la efectividad de la salida
Tras obtener el resultado, haz estas cosas en orden:
- Que se pueda decodificar: confirma que el contenido devuelto es realmente una imagen analizable y no un mensaje de error tratado como imagen.
- Tamaño razonable: si el ancho y alto de salida coinciden con lo esperado o caen en el rango permitido, evitando anomalías como 0 bytes o 1×1.
- Que exista el sujeto: hacer una comprobación rápida con métricas simples — por ejemplo, si la proporción de píxeles del primer plano de salida está en un rango razonable. Una proporción demasiado alta (casi no se eliminó nada) o demasiado baja (el sujeto fue borrado por error) debe marcarse como sospechosa.
- Que sea reproducible: registrar juntos la imagen original, la salida, los parámetros de la petición y el tiempo de proceso, para facilitar la trazabilidad.
Estrategia de reintentos
No todos los fallos merecen reintento:
- Merecen reintento: tiempo de espera de red, conexión interrumpida, limitación de tasa (tipo 429) y 5xx del servidor. En estos casos suele aplicarse retroceso exponencial y fijar un límite de intentos (1–2).
- No merecen reintento: entrada inválida (formato incorrecto, archivo corrupto, parámetros ilegales). Reintentar solo duplica la facturación; hay que corregir la entrada.
- Calidad no aceptable: si la validación detecta una proporción anómala del sujeto, se puede permitir un «reintento con parámetros distintos» (por ejemplo, redimensionar y volver a enviar), pero con un límite total de intentos.
Red de seguridad de calidad
Cuando la salida no cumple los requisitos de negocio, prepara rutas de degradación:
- Plan de degradación: volver a una forma de visualización sin recorte (imagen original + fondo predefinido), para garantizar la disponibilidad del negocio.
- Cola manual: enviar las muestras sospechosas a una cola de revisión manual y sobrescribir el resultado tras el procesamiento humano; esto ahorra más presupuesto que llamar repetidamente al modelo.
- Aceptación por niveles: las escenas de visualización para usuario final pueden usar un umbral de calidad más bajo; las imágenes principales de producto, material de impresión y similares deben usar un umbral alto; configura ambas estrategias por separado.
Principio en una frase: el reintento resuelve «no se obtuvo», la red de seguridad resuelve «se obtuvo pero no es bueno». No confundas ambos conceptos.
Errores comunes y lista de comprobación para diagnóstico
Estos son los errores más frecuentes al integrar este tipo de modelos de imagen; el orden de diagnóstico más eficiente es «entrada → red/llamada → salida → facturación».
Fase de entrada
- Formatos no unificados: las imágenes que sube el negocio mezclan WebP, HEIC y JPEG CMYK; si se envían sin normalizar, algunas peticiones fallan directamente.
- Tamaño/resolución fuera de límite: imágenes grandes sin comprimir, cuerpo de petición demasiado grande; se manifiesta como tiempo de espera agotado en lugar de un error claro, y se suele diagnosticar erróneamente como «servicio inestable».
- Entrada con canal alfa: un PNG con alfa enviado se comporta de forma distinta a una imagen normal; hay que verificarlo por separado.
- Imagen corrupta: archivos truncados por subidas interrumpidas; el modelo devuelve error, pero en tus logs quizá solo veas «procesamiento fallido».
Fase de llamada y red
- Sin tiempo de espera configurado: el tiempo de espera por defecto del cliente es demasiado largo; cuando la interfaz se bloquea, los hilos se ocupan y todo el servicio se ralentiza.
- Concurrencia sin límite: las tareas por lotes saturan la concurrencia de una vez, se activa la limitación de tasa y se producen muchos reintentos, amplificando aún más la presión.
- Reintentos sin límite: reintentar indefinidamente tras un fallo es la causa más común de descontrol del presupuesto.
- Fuga de credenciales: la Key escrita en el frontend o enviada al repositorio es un incidente de seguridad, no solo un problema de configuración.
Fase de salida
- URL temporal caducada: guardar la dirección temporal como dirección permanente en la base de datos; a los pocos días todo son 404.
- Suposición de canal alfa: el código de composición aguas abajo asume que la salida tiene alfa y en realidad no lo tiene, apareciendo bordes negros o fondo blanco en el resultado compuesto.
- Sin validar la resolución: el tamaño de salida no coincide con el original y, tras escalar, las proporciones del sujeto se deforman.
Conocimiento sobre facturación
- Creer que los fallos son gratis: basta con iniciar una llamada de procesamiento para que pueda facturarse; las salidas de calidad no aceptable también cuentan.
- Procesar la misma imagen repetidamente: falta de diseño idempotente; la misma imagen se envía repetidamente en varios eslabones de la cadena.
- Sin panel de costes: no se contabilizan las imágenes llamadas por día, y el problema se descubre cuando la factura es anómala.
Recomendación de diagnóstico: registra en una sola línea de log estructurado los parámetros de la petición, el tiempo de proceso, el código de estado, el tamaño de salida y la proporción del primer plano de salida de cada llamada. La gran mayoría de los problemas se localizan por fase directamente con estos campos.
Cuándo elegirlo y cuándo cambiar de solución
La última pregunta no es técnica, sino de compromiso. Puedes decidir con los siguientes criterios.
Casos en los que conviene usar background-remover
- Necesidad clara y única: se trata de separar el sujeto del fondo, sin necesidad de clasificación, descripción ni coordenadas adicionales.
- Volumen considerable y repetitivo: hay cientos o miles de imágenes diarias que procesar, el procesamiento manual no es económico y el retorno de la inversión en un modelo propio no se sostiene.
- El equipo no tiene capacidad de ingeniería de CV: no hay datos anotados, ni experiencia en entrenamiento y operación de inferencia, ni se quiere contratar específicamente para ello.
- Se necesita lanzar rápido: con una interfaz gestionada facturada por imagen, el coste de integración es principalmente la lógica de integración y validación; se puede tener funcionando en pocos días.
- Estructura de costes controlable: el precio por imagen hace que el presupuesto corresponda linealmente al volumen de llamadas, lo que facilita la gestión de límites.
Situaciones en las que conviene considerar otras soluciones
- Requisitos muy fuertes de control sobre la salida: por ejemplo, controlar con precisión los parámetros de suavizado de bordes, garantizar un formato de salida y un espacio de color específicos, y las pruebas muestran que la interfaz gestionada no puede cumplirlo.
- Escala muy grande y estabilidad a largo plazo: cuando el volumen de llamadas es suficientemente grande y la necesidad suficientemente estable, el coste marginal de un despliegue propio o privado puede ser más ventajoso, además de que los datos no salen de la red interna.
- Restricciones de cumplimiento de datos: las imágenes contienen información sensible que no puede salir al exterior y deben procesarse localmente.
- Uso solo ocasional: necesidades de baja frecuencia y no críticas; el procesamiento manual o las herramientas de edición de imágenes existentes resultan más sencillos.
- La necesidad no es realmente de recorte: por ejemplo, si lo que necesitas es anotación de imágenes, control de calidad o moderación de contenido, deberías buscar el tipo de modelo correspondiente en lugar de hacer que un modelo de recorte lo asuma.
Una ruta de decisión práctica es: primero ejecutar una ronda de validación a pequeña escala con muestras reales (cubriendo el 10% de escenarios más difíciles) y luego evaluar la tasa de cumplimiento de calidad y el coste integral por imagen. Si la tasa de cumplimiento es suficiente y el coste aceptable, intégralo; si la tasa se sostiene a duras penas con revisión manual y la proporción de esa revisión sigue siendo alta, eso indica que no es la herramienta adecuada para ese escenario; cambiar de solución a tiempo compensa más que seguir ajustando parámetros.
La integración en sí no es compleja; lo difícil es tener claros los límites, el coste y la red de seguridad de calidad. Una vez definidos estos tres puntos, el resto son detalles de ingeniería.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores