
Meta
Muse Image 1.0
muse-image-1.0/text-to-image
Модель Meta для генерации и редактирования изображений на основе рассуждений: сначала разбирает сложный запрос, затем выполняет рендеринг; может объединять несколько референсных изображений и использовать веб-поиск для обеспечения фактической точности
Попробовать muse-image-1.0/text-to-image
Ввод
Работы
Все работыВывод
image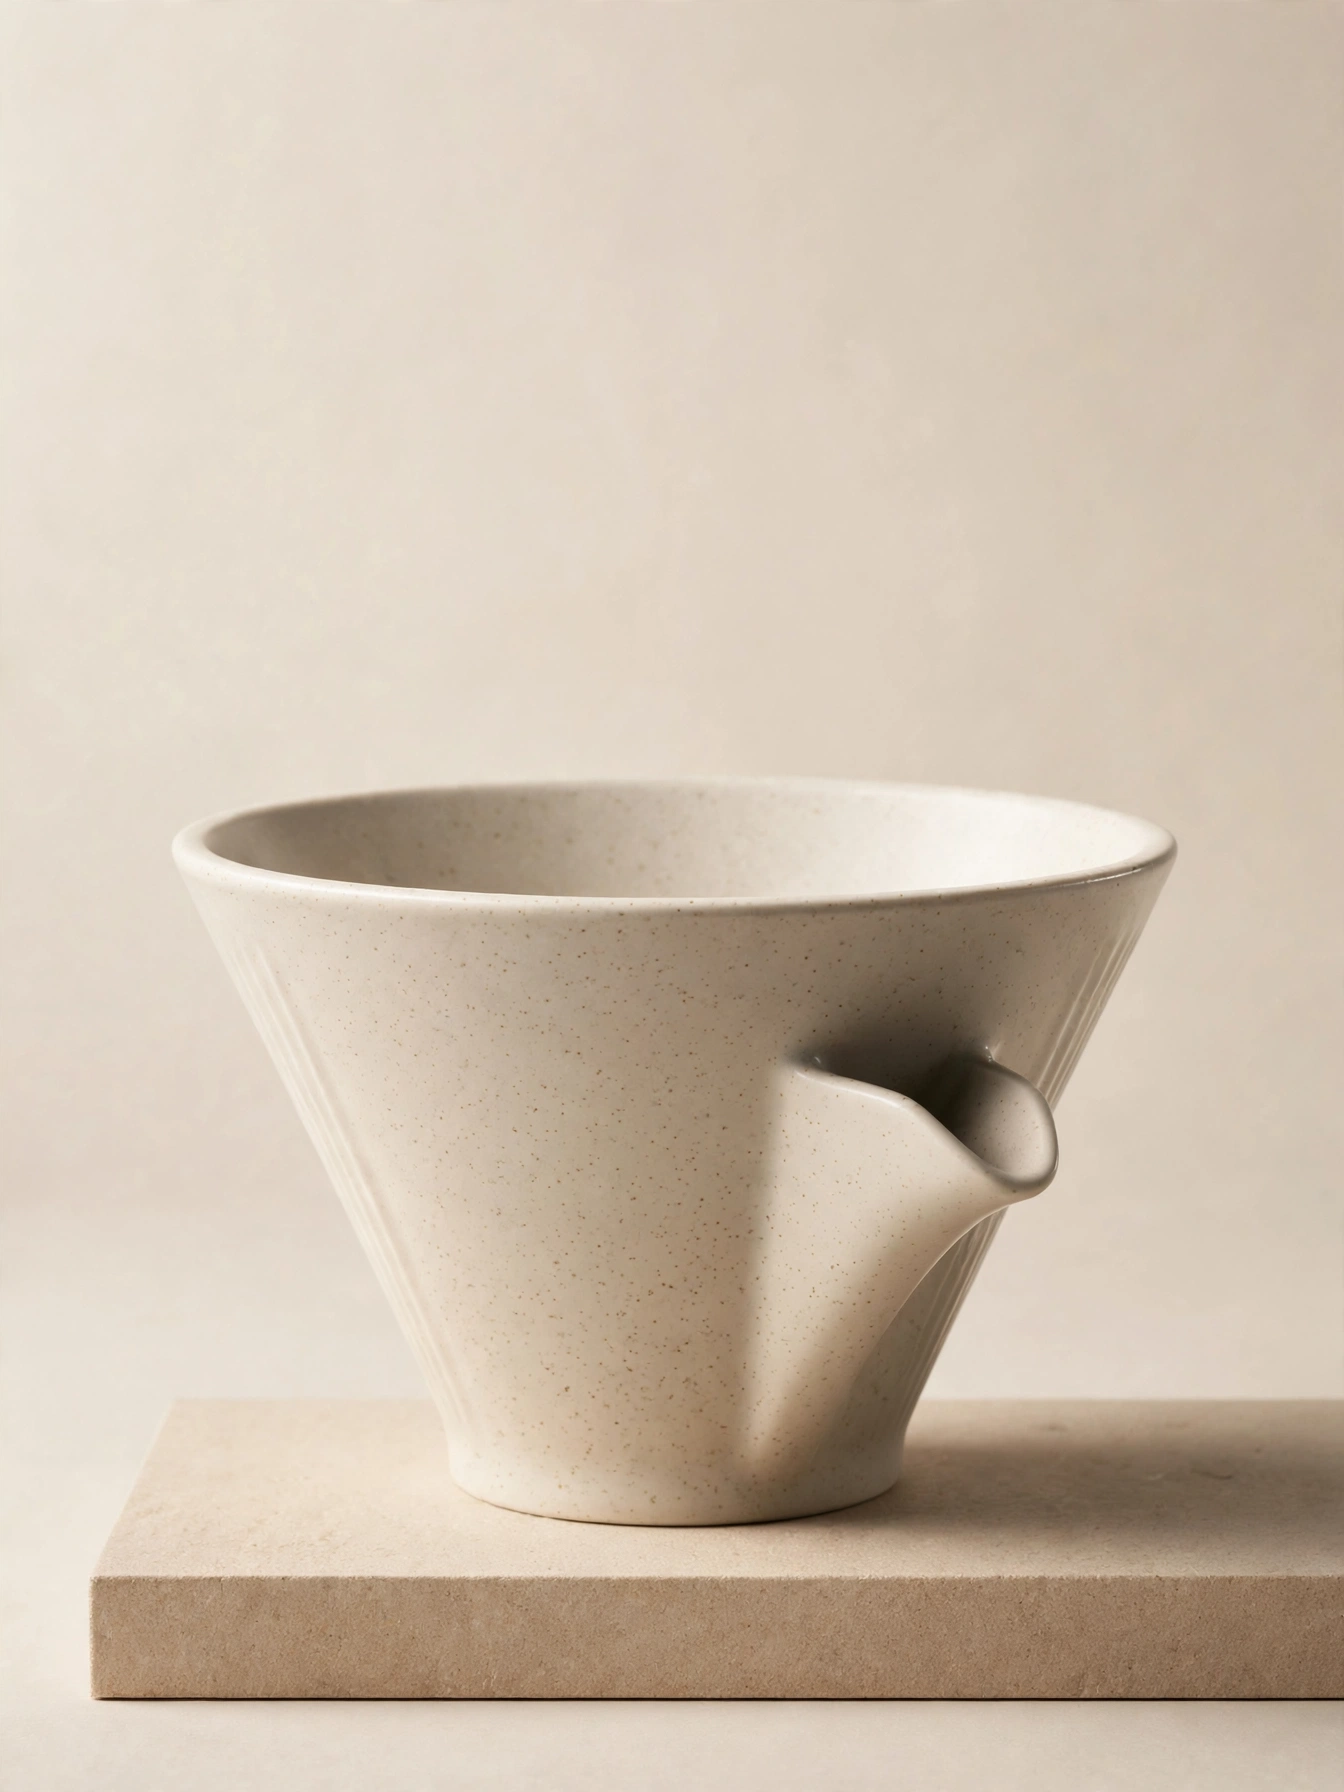
Качество продуктовой съёмки для электронной коммерции: генерация изображений в muse-image по тексту
Стиль Изображение продукта · Студийный свет · Бизнес
Промпт
Студийная продуктовая съёмка матовой керамической воронки для пуровер-кофе, тёплый белый с бежевым оттенком, ракурс три четверти с центром на низкой песочной подставке. Бесшовный светло-бежевый фон с мягким градиентным переходом. Основной свет — большой софтбокс под углом 45 градусов слева сверху, справа лёгкая отражающая панель для подсветки теней, по правому краю узкая полоса контрового света, отделяющая объект от фона. На глазури видна мелкая крапчатая текстура, ободок круглый и чёткий, носик геометрически точен. Съёмка объективом с эквивалентным фокусным расстоянием 85 мм, диафрагма f/8, мягкое затухание к дальнему краю, без дисторсии. Чистая коммерческая ретушь, нейтральный баланс белого, контролируемые блики без пересвета, мягкая контактная тень, фиксирующая объект на месте. Вертикальная композиция 4:3, сверху достаточно свободного пространства для вёрстки. Без текста, без логотипов, без лишнего реквизита.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
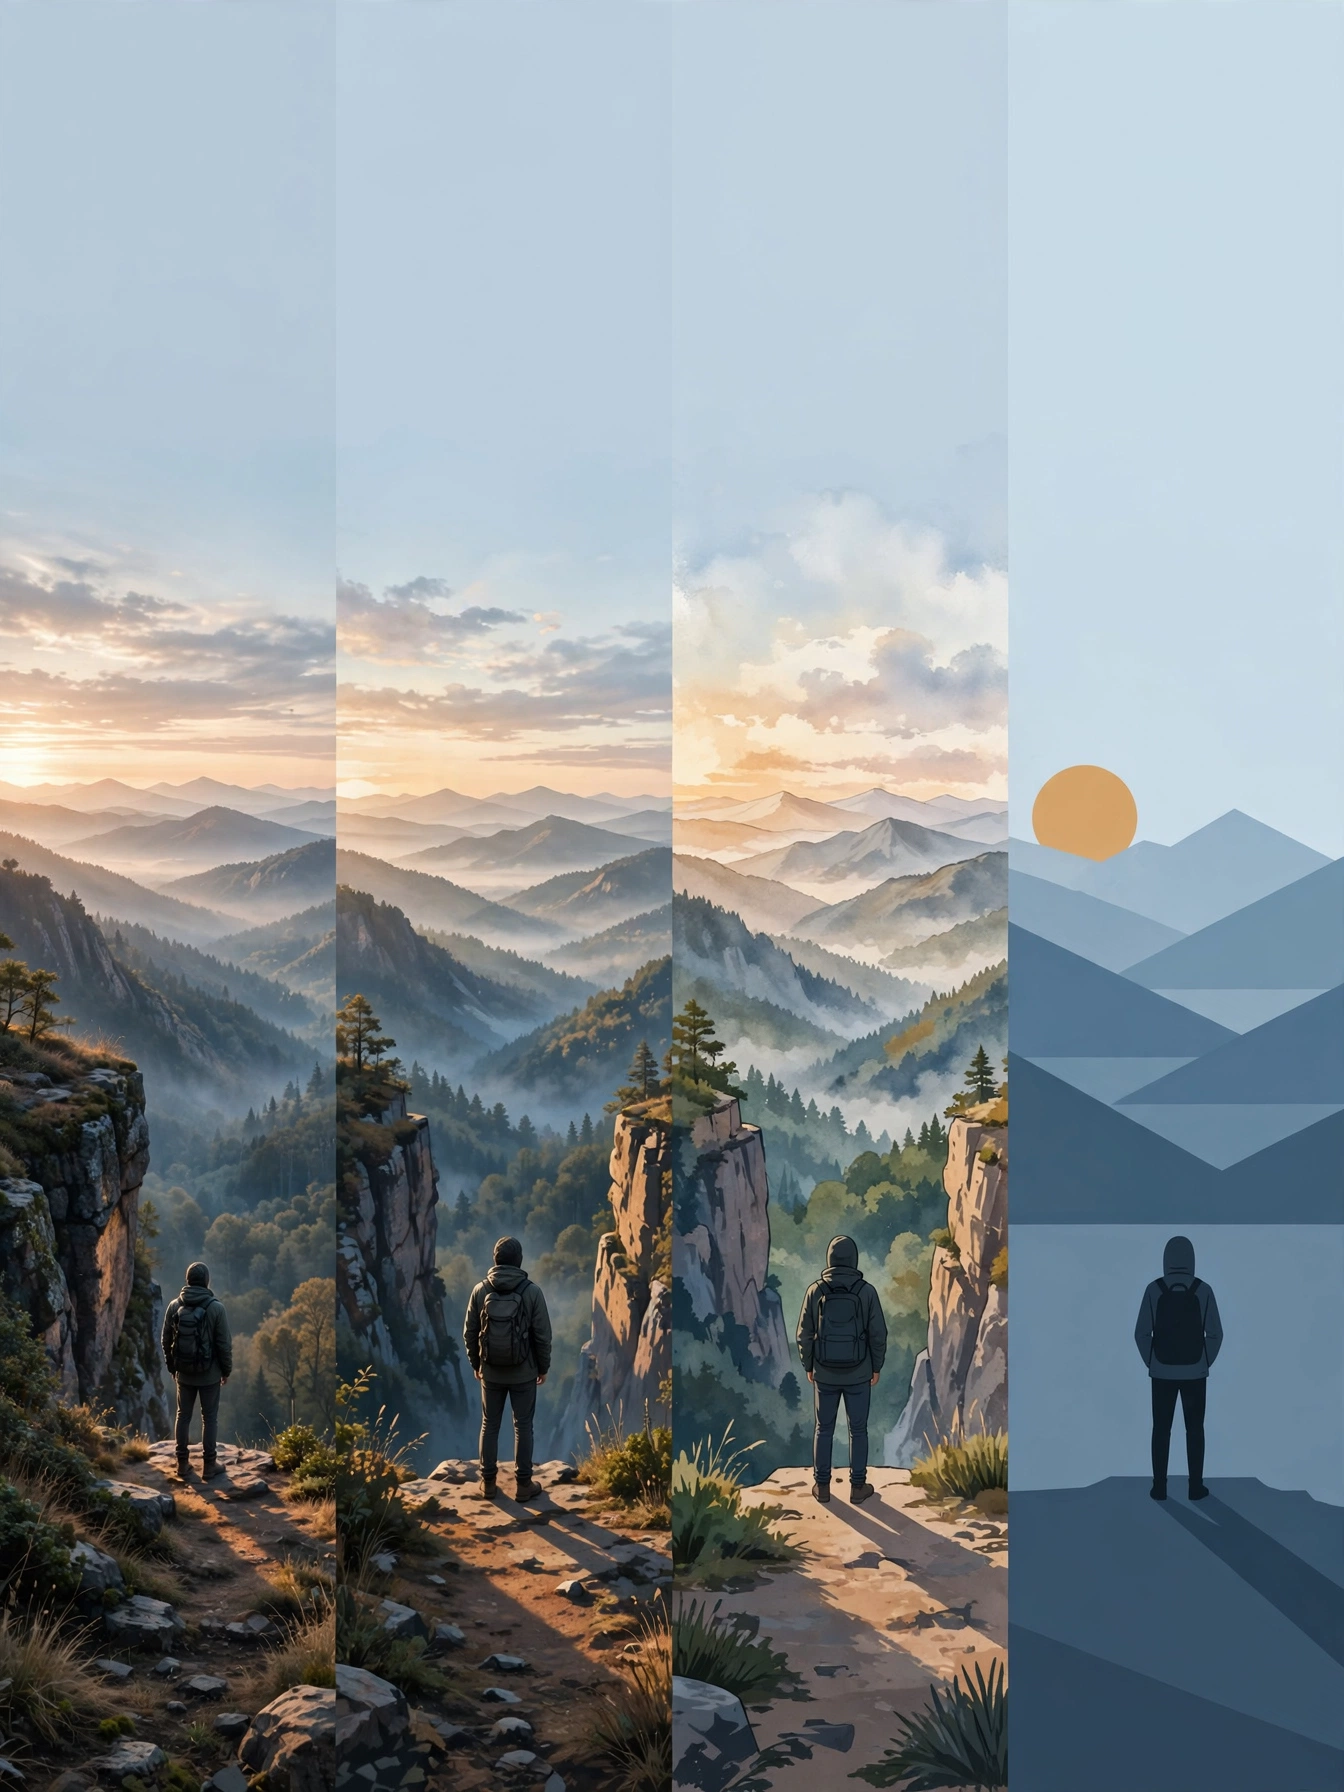
Спектр иллюстративных стилей: от реализма к плоскости
Стиль Иллюстрация · Исследование стиля · Арт-дирекшн
Промпт
Единый иллюстративный сюжет в редакционном стиле, представленный поперёк спектра от реализма к плоскости: одинокая фигура стоит на краю обрыва и смотрит вниз на многослойную долину на рассвете. Композиция: сюжет по центру, привязан к нижней трети кадра, долина ярусами уходит горизонтальными полосами к высокому далёкому горизонту, сверху оставлено обильное негативное пространство для вёрстки. Стиль: связный иллюстративный язык с намеренно упрощёнными ступенями — на одном конце фотографическая объёмность и атмосферная дымка, на другом — жёсткие векторные цветовые пятна без градиентов. Свет: тёплый низкий солнечный свет слева, мягкие длинные тени, холодная окружающая подсветка в долине. Палитра: приглушённые сланцево-синие тона с тёплыми охристыми акцентами, цветов немного и они сдержанны. Проработка: чёткая, резкая, готовая к печати работа, чистые силуэты, без текста и водяных знаков.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
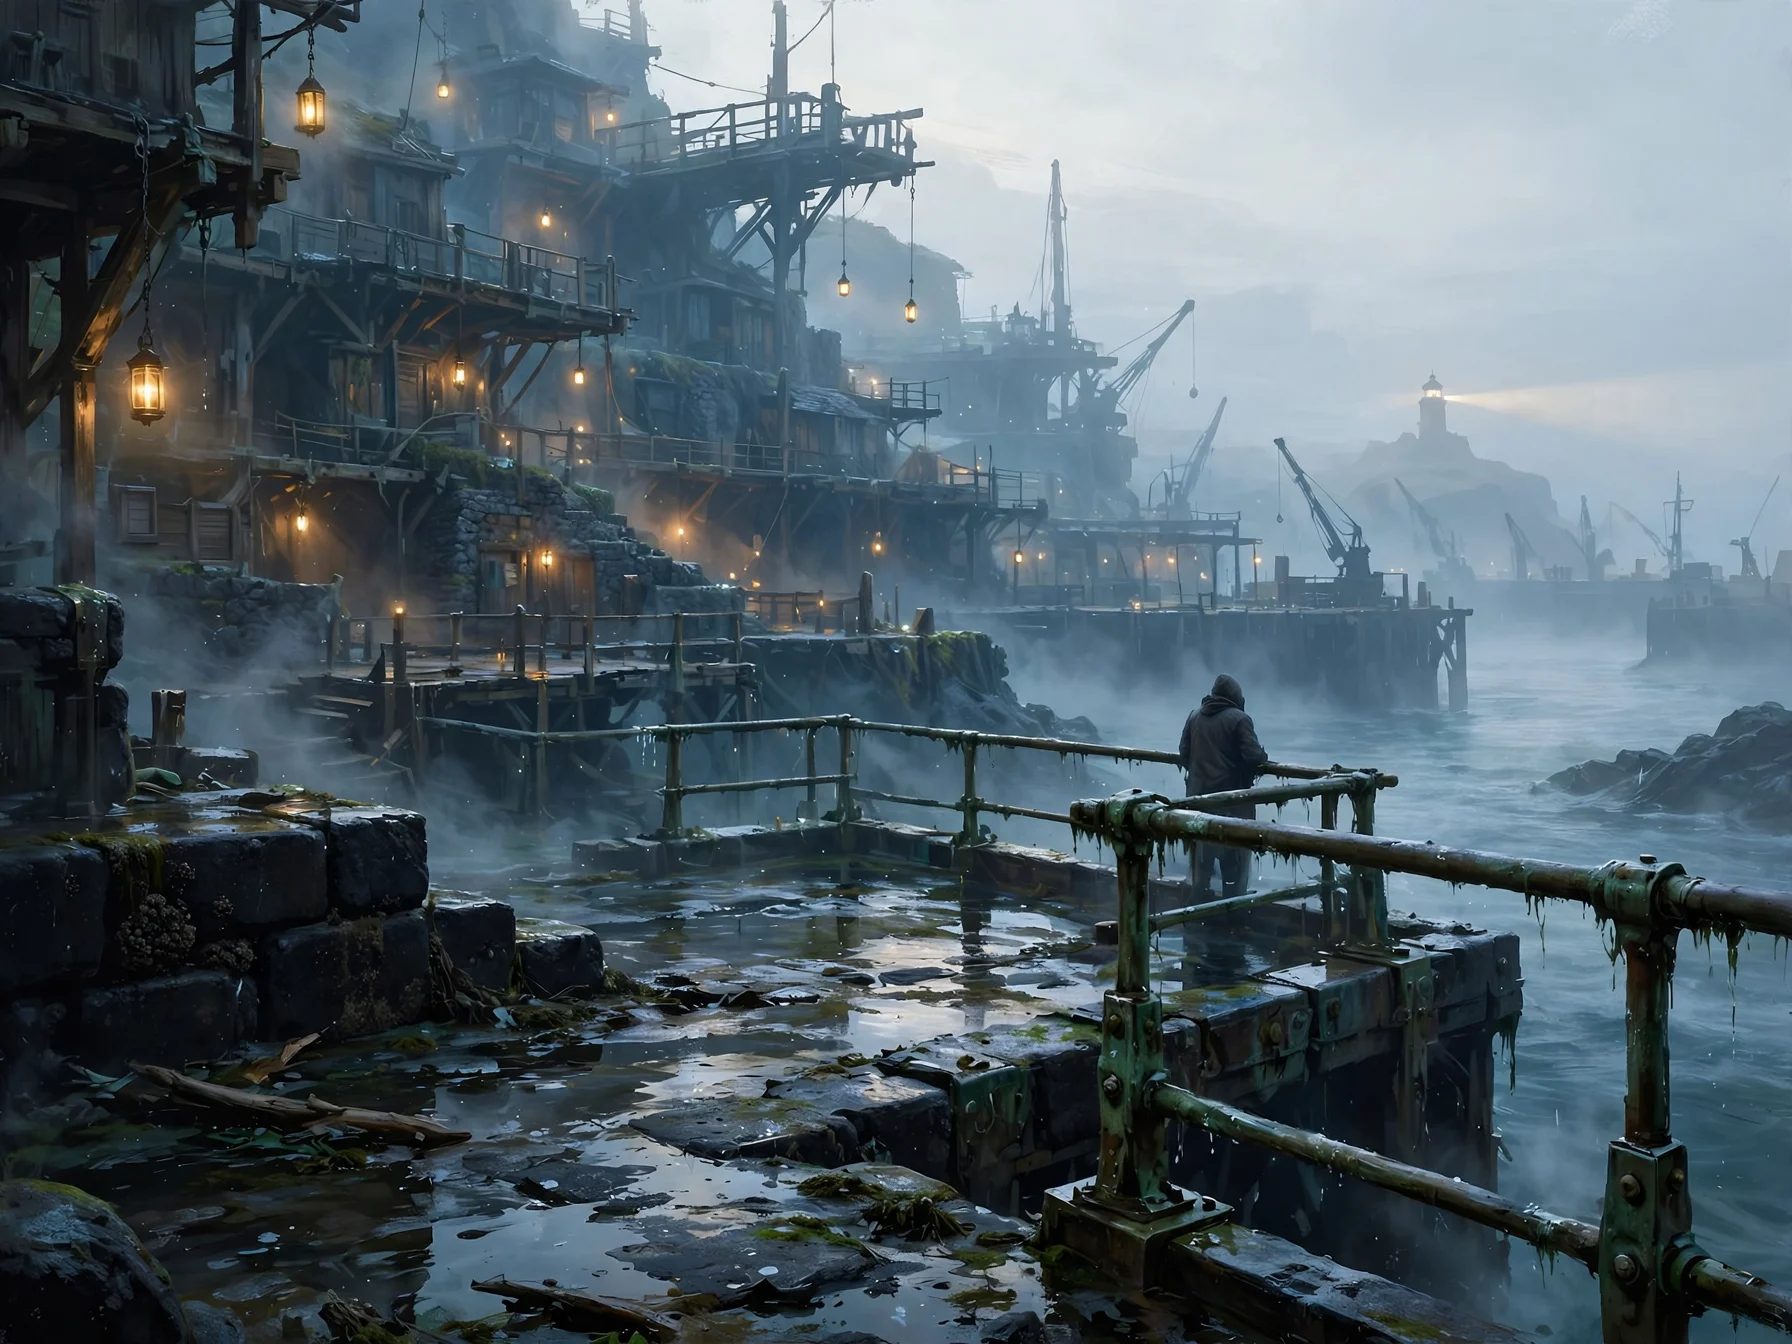
Концепт-арт сцены мира: Приливная платформа Туманганского порта
Стиль Построение мира · Концепт-арт · Атмосферность
Промпт
Широкоформатное кинематографичное концепт-арт-изображение, изображающее туманный приморский порт вымышленного мира, панорамная композиция 21:9. Передний план: разрушаемая морским ветром приливная наблюдательная платформа из тёмного базальта и окисленной латуни, наполовину обнажённая после отлива, влажная каменная поверхность отражает бледное небо. Средний план: построенные на скалах многоярусные портовые здания, деревянные настилы, висящие фонари излучают тёплый янтарный свет в холодном синем тумане, одинокая фигура в тяжёлом пальто стоит у перил платформы, задавая масштаб. Задний план: устье порта растворяется в слоях тумана, силуэтные краны и луч далёкого маяка медленно скользят. Атмосфера: густой морской туман, разлетающиеся брызги, низкоконтрастное затухание глубины резкости. Освещение: холодный пасмурный рассвет, единственный тёплый практический источник света от фонарей, мягкий объёмный свет. Стиль: живописный цифровой концепт-арт, сдержанная палитра — сланцево-синий, окисленный бирюзово-зелёный и приглушённый янтарный, детализированные материалы камня и металла, без текста, без логотипов.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
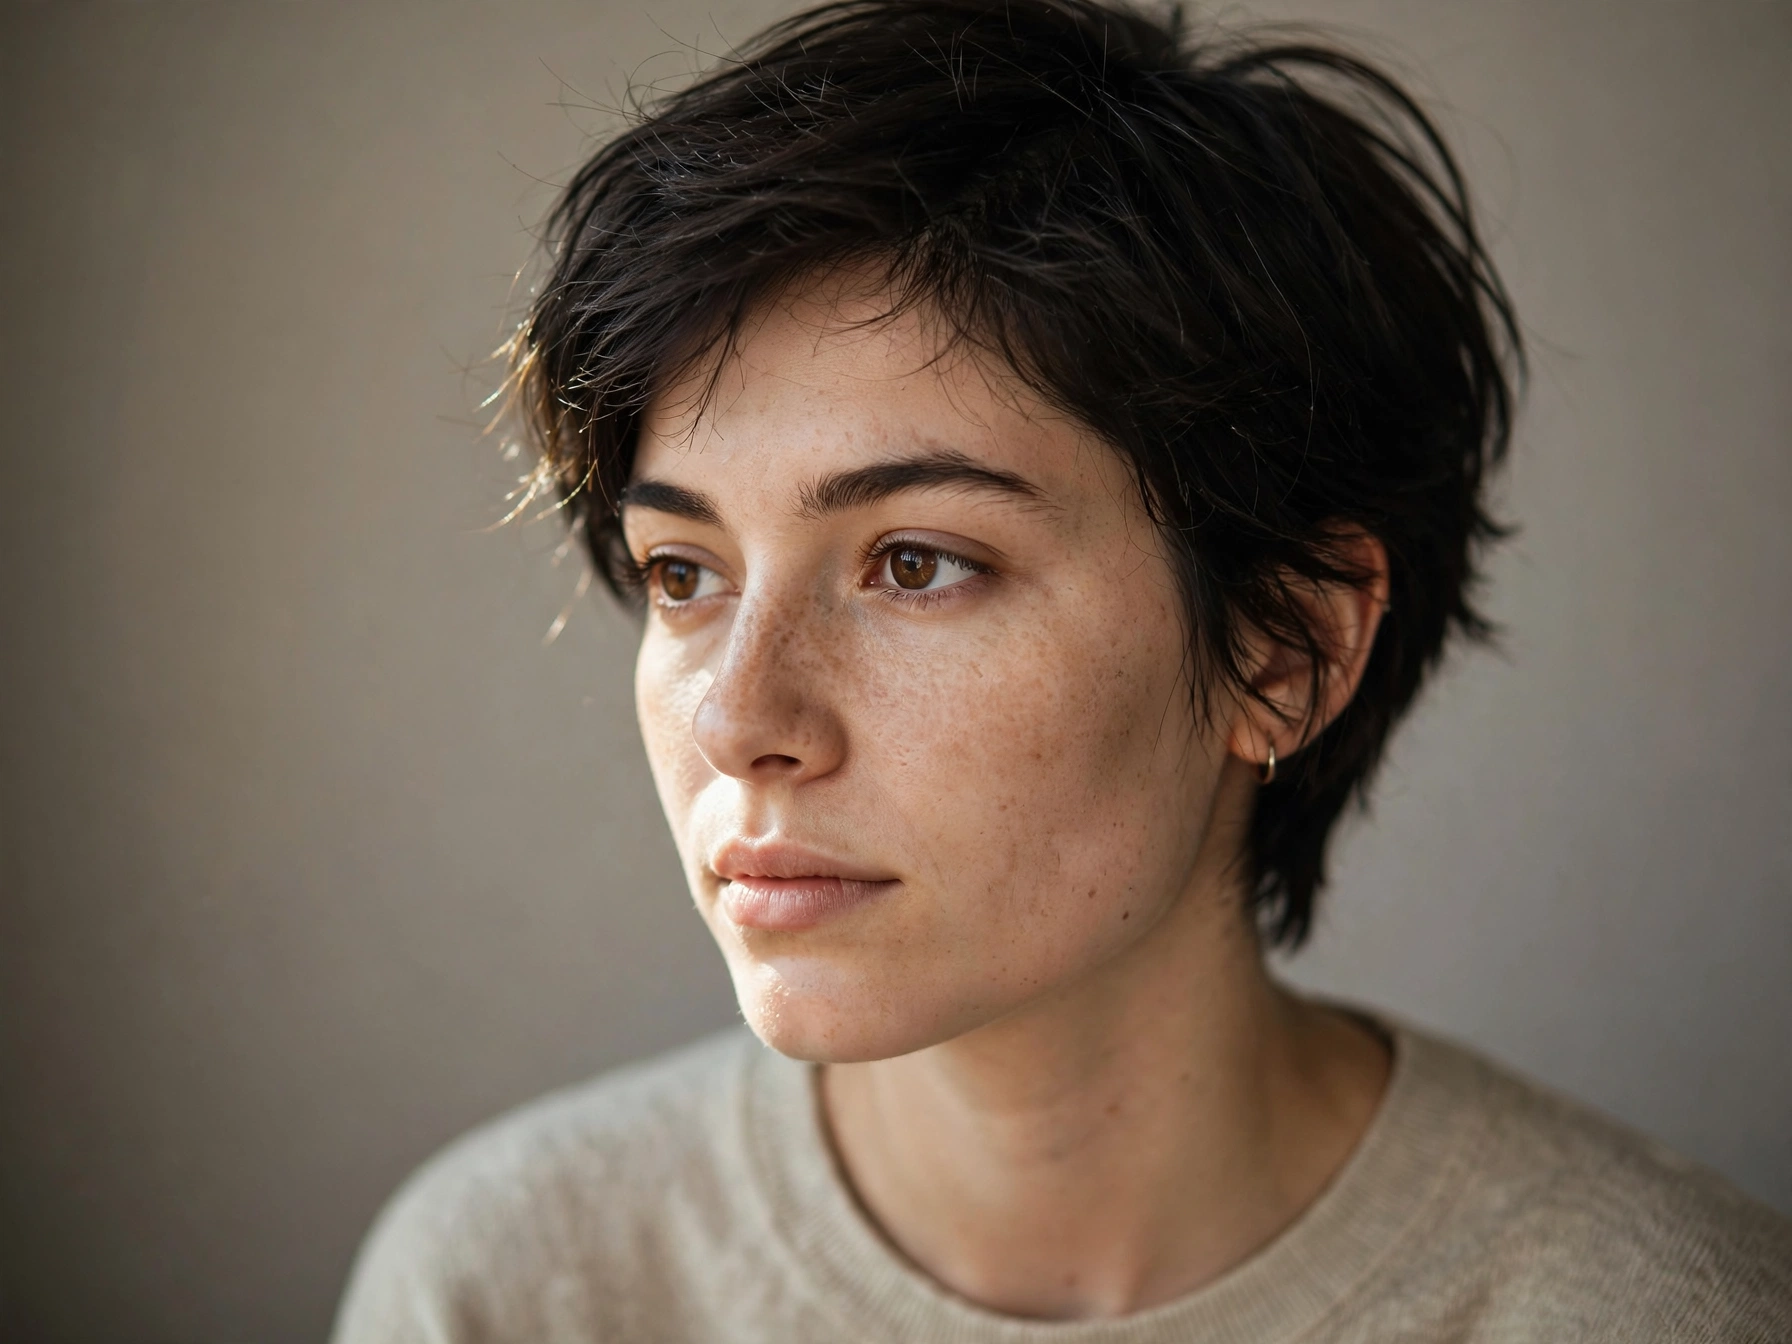
Muse Image: референс портретного стиля — два подхода к промптам: реалистичный и художественный
Стиль Портреты и фотография · Фотореалистичность · Редакционная категория
Промпт
Вертикальный студийный портрет 3:4: молодая женщина с веснушками и тёмными короткими волосами, плечи расслаблены, взгляд направлен прямо, слегка мимо камеры. Мягкий широкий основной свет слева от камеры создаёт тонкий контурный блик на волосах; свет плавно растворяется в тёплом сером бесшовном фоне. Снято объективом 85 мм при диафрагме f/2.0, малая глубина резкости, реалистичная текстура кожи с видимыми порами и мелкими волосками, сдержанная цветокоррекция, без следов ретуши. В целом эстетика редакционной фотографии, атмосфера спокойная и сдержанная, богатая детализация лица, фон намеренно лаконичен, чтобы внимание всегда оставалось на субъекте.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
muse-image-1.0/text-to-image per task
| Цена за единицу | $0.015 |
|---|
Краткое описание
muse-image-1.0/text-to-image — это чисто текстовая линия модели генерации изображений от Meta на платформе HiAPI.ai, использующая процесс генерации «сначала рассуждение, затем рендеринг»: перед созданием изображения она разбирает многочастные подсказки, планирует компоновку кадра и самокорректируется в ходе рассуждения. Она подходит разработчикам, которым нужна высоконагруженная пакетная генерация изображений со сложными подсказками, например для вариантов рекламных материалов, изображений для каталога товаров и т. п. При вызове через единый интерфейс HiAPI.ai достаточно текстовой подсказки для генерации изображения; соотношение сторон и формат вывода выбираются опционально.
Ключевые особенности
- Сначала рассуждение, затем рендеринг — сложные подсказки лучше контролируются — перед рендерингом в цепочке рассуждений разбираются многочастные подсказки, планируется компоновка и итеративно корректируется вывод, что лучше подходит для структурированных описаний, чем однократная прямая генерация.
- Знаниеёмкие подсказки могут опираться на веб-поиск — при подсказках, требующих информации о реальном мире, выполняется веб-поиск для калибровки содержимого, что снижает отклонения в фактологических иллюстрациях.
- Готовая картинка за один вызов, простое подключение — достаточно отправить текстовую подсказку, указать соотношение сторон и формат вывода jpeg, png или webp, и сразу получить готовый к использованию графический ресурс.
Описание возможностей
Рассуждающая генерация изображений по тексту: разбирает многочастные сложные подсказки на исполнимые элементы кадра, планирует компоновку перед рендерингом и самокорректируется, снижая затраты на многократную переработку подсказок.
Предустановленные соотношения сторон: доступны девять пропорций — 1:1, 4:3, 3:4, 16:9, 9:16, 3:2, 2:3, 21:9, 9:21; их можно выбрать сразу под рекламное место или макет, без последующей обрезки.
Вывод в нескольких форматах: поддерживаются форматы загрузки jpeg, png и webp, по умолчанию webp, что удобно выбирать под фронтенд-отображение, архивирование или последующую обработку.
Поддержка длинных подсказок: верхний предел подсказки — 5000 символов, что вмещает сложные запросы генерации с несколькими абзацами и ограничениями.
Сценарии применения
- Пакетная генерация рекламных вариантов командами размещения — пакетная генерация изображений по нескольким наборам текстовых подсказок для одного торгового предложения с выдачей материалов разных пропорций, сразу для тестирования рекламы на нескольких каналах.
- Создание сценных изображений товаров для электронной коммерции — генерация сценных изображений в разных стилях и композициях по текстовому описанию товара для дополнения каталога и карточек товара.
- Иллюстрации к познавательным темам для контент-команд — ввод описания темы с фактическими элементами и получение соответствующих контенту иллюстраций для статей, постов и публикаций в соцсетях.
Ограничения и рекомендации по выбору
В открытых источниках не раскрывается разрешение вывода этой линии; соотношение сторон задаёт только пропорцию, а не точные пиксельные размеры, поэтому в сценариях с жёсткими требованиями к разрешению его нужно проверять заранее. Рассуждающий процесс и веб-поиск по запросу создают дополнительную задержку, что не подходит для генерации в реальном времени с крайне низкой задержкой. Вывод ограничен изображениями, без видео и аудио. Если задача требует объединения или переработки на основе референсного изображения, следует выбрать линию image-to-image того же семейства.
Частые вопросы
Все частые вопросы →-
Как выбрать между генерацией изображения по тексту и редактированием изображения?
Если есть только текст и нужно начать с нуля, выбирайте генерацию изображения по тексту; если нужно сохранить существующий объект или макет, выбирайте редактирование изображения и предоставьте референсное изображение.
-
Сколько изображений можно получить за один раз?
Каждая задача возвращает одно изображение, выбора количества нет. Если нужно сравнить другую композицию, измените промпт и отправьте новую задачу.
-
Можно выбрать 1K, 2K или 4K?
В этом интерфейсе нет параметров разрешения. Соотношение сторон выбираете вы, а размер в пикселях определяет модель — обычно около 2,5 Мп; ориентируйтесь на фактические размеры скачанного файла.
-
Какие форматы файлов можно выбрать?
Можно выбрать JPEG, PNG или WebP; если ничего не выбрано, используется WebP. Выбирайте в зависимости от потребностей последующих веб-материалов или инструментов дизайна.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: muse-image-1.0/text-to-image
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для muse-image-1.0/text-to-image и маршрута default — см. таблицу параметров ниже.
promptstringОбязательноminLength 1maxLength 5000Используется для описания желаемого изображения или указания того, что нужно изменить и сохранить в референсном изображении; передаётся в виде строки.
aspect_ratiostringНеобязательноВыбор соотношения сторон выходного изображения; передаётся в виде строки; точный размер в пикселях здесь не задаётся.
1:14:33:416:99:163:22:321:9Показать все (1)
9:21output_formatstringНеобязательноПо умолчанию: "webp"Выбор формата файла для скачиваемого изображения; передаётся в виде строки, по умолчанию webp.
jpegpngwebpcallbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/text-to-image",
  "input": {
    "prompt": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/text-to-image",
input: {
"prompt": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/text-to-image",
"input": {
"prompt": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →-

Руководство
Практика генерации изображений по тексту с recraft-v4.1-flash: 5 ценных бизнес-сценариев и ключевые моменты интеграции
Отталкиваясь от стоимости $0.01 за изображение, спланируйте внедрение генерации изображений в реальные бизнес-процессы
-

Сравнительный обзор
hailuo-2.3-fast/image-to-video — горизонтальное сравнение: как выбрать модель «изображение в видео» и что учесть при миграции
-

Руководство
kandinsky-6.0-pro/image-to-video в HiAPI: руководство по curl + Python
Как выполнить рабочий запрос генерации видео из изображения в HiAPI: от загрузки первого кадра до асинхронного опроса и финальной загрузки
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Как использовать kling-4.0/text-to-video через HiAPI API: curl, Python и рабочий пример запроса
Практическое руководство для разработчиков: кинематографичные промпты, синхронный звук, асинхронный опрос и скачивание результатов
-

Руководство
Как вызывать kling-4.0/image-to-video на HiAPI: curl, Python и опрос
-

Сравнительный обзор
Recraft v4.1 Flash 文生图横向对比:开发者选型与迁移指南
用每张 $0.01 的成本与纯文生图能力,判断它是否适合你的图像生成流水线
-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
Похожие модели
Все модели →Тот же тип
-
 Recraft Creative Upscale Recraft $0.357 /изображение
-
 FLUX 3 Image Black Forest Labs $0.041 /изображение
-
 Ideogram V4 Ideogram $0.050 /изображение
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /изображение
-
 FIBO 1.5 Bria $0.058 /изображение
-
 Recraft Crisp Upscale Recraft $0.004 /изображение
-
 Muse Image 1.0 Meta $0.015 per task
-
 FLUX.1 Schnell Black Forest Labs $0.005 /изображение
-
 Wan 2.7 Image Alibaba $0.035 /изображение
-
 BRIA Eraser Bria $0.058 /изображение
-
 Imagen 4 Google $0.030 /изображение
-
 Nano Banana Pro Google $0.057 /изображение