
Alibaba
Qwen Image 3.0
qwen-image-3.0/text-to-image
Модель третьего поколения Alibaba для генерации и редактирования изображений, отличается плотной вёрсткой текста при длинных промптах и многоязычным рендерингом, поддерживает редактирование по референсному изображению
Попробовать qwen-image-3.0/text-to-image
Ввод
Работы
Все работыВывод
image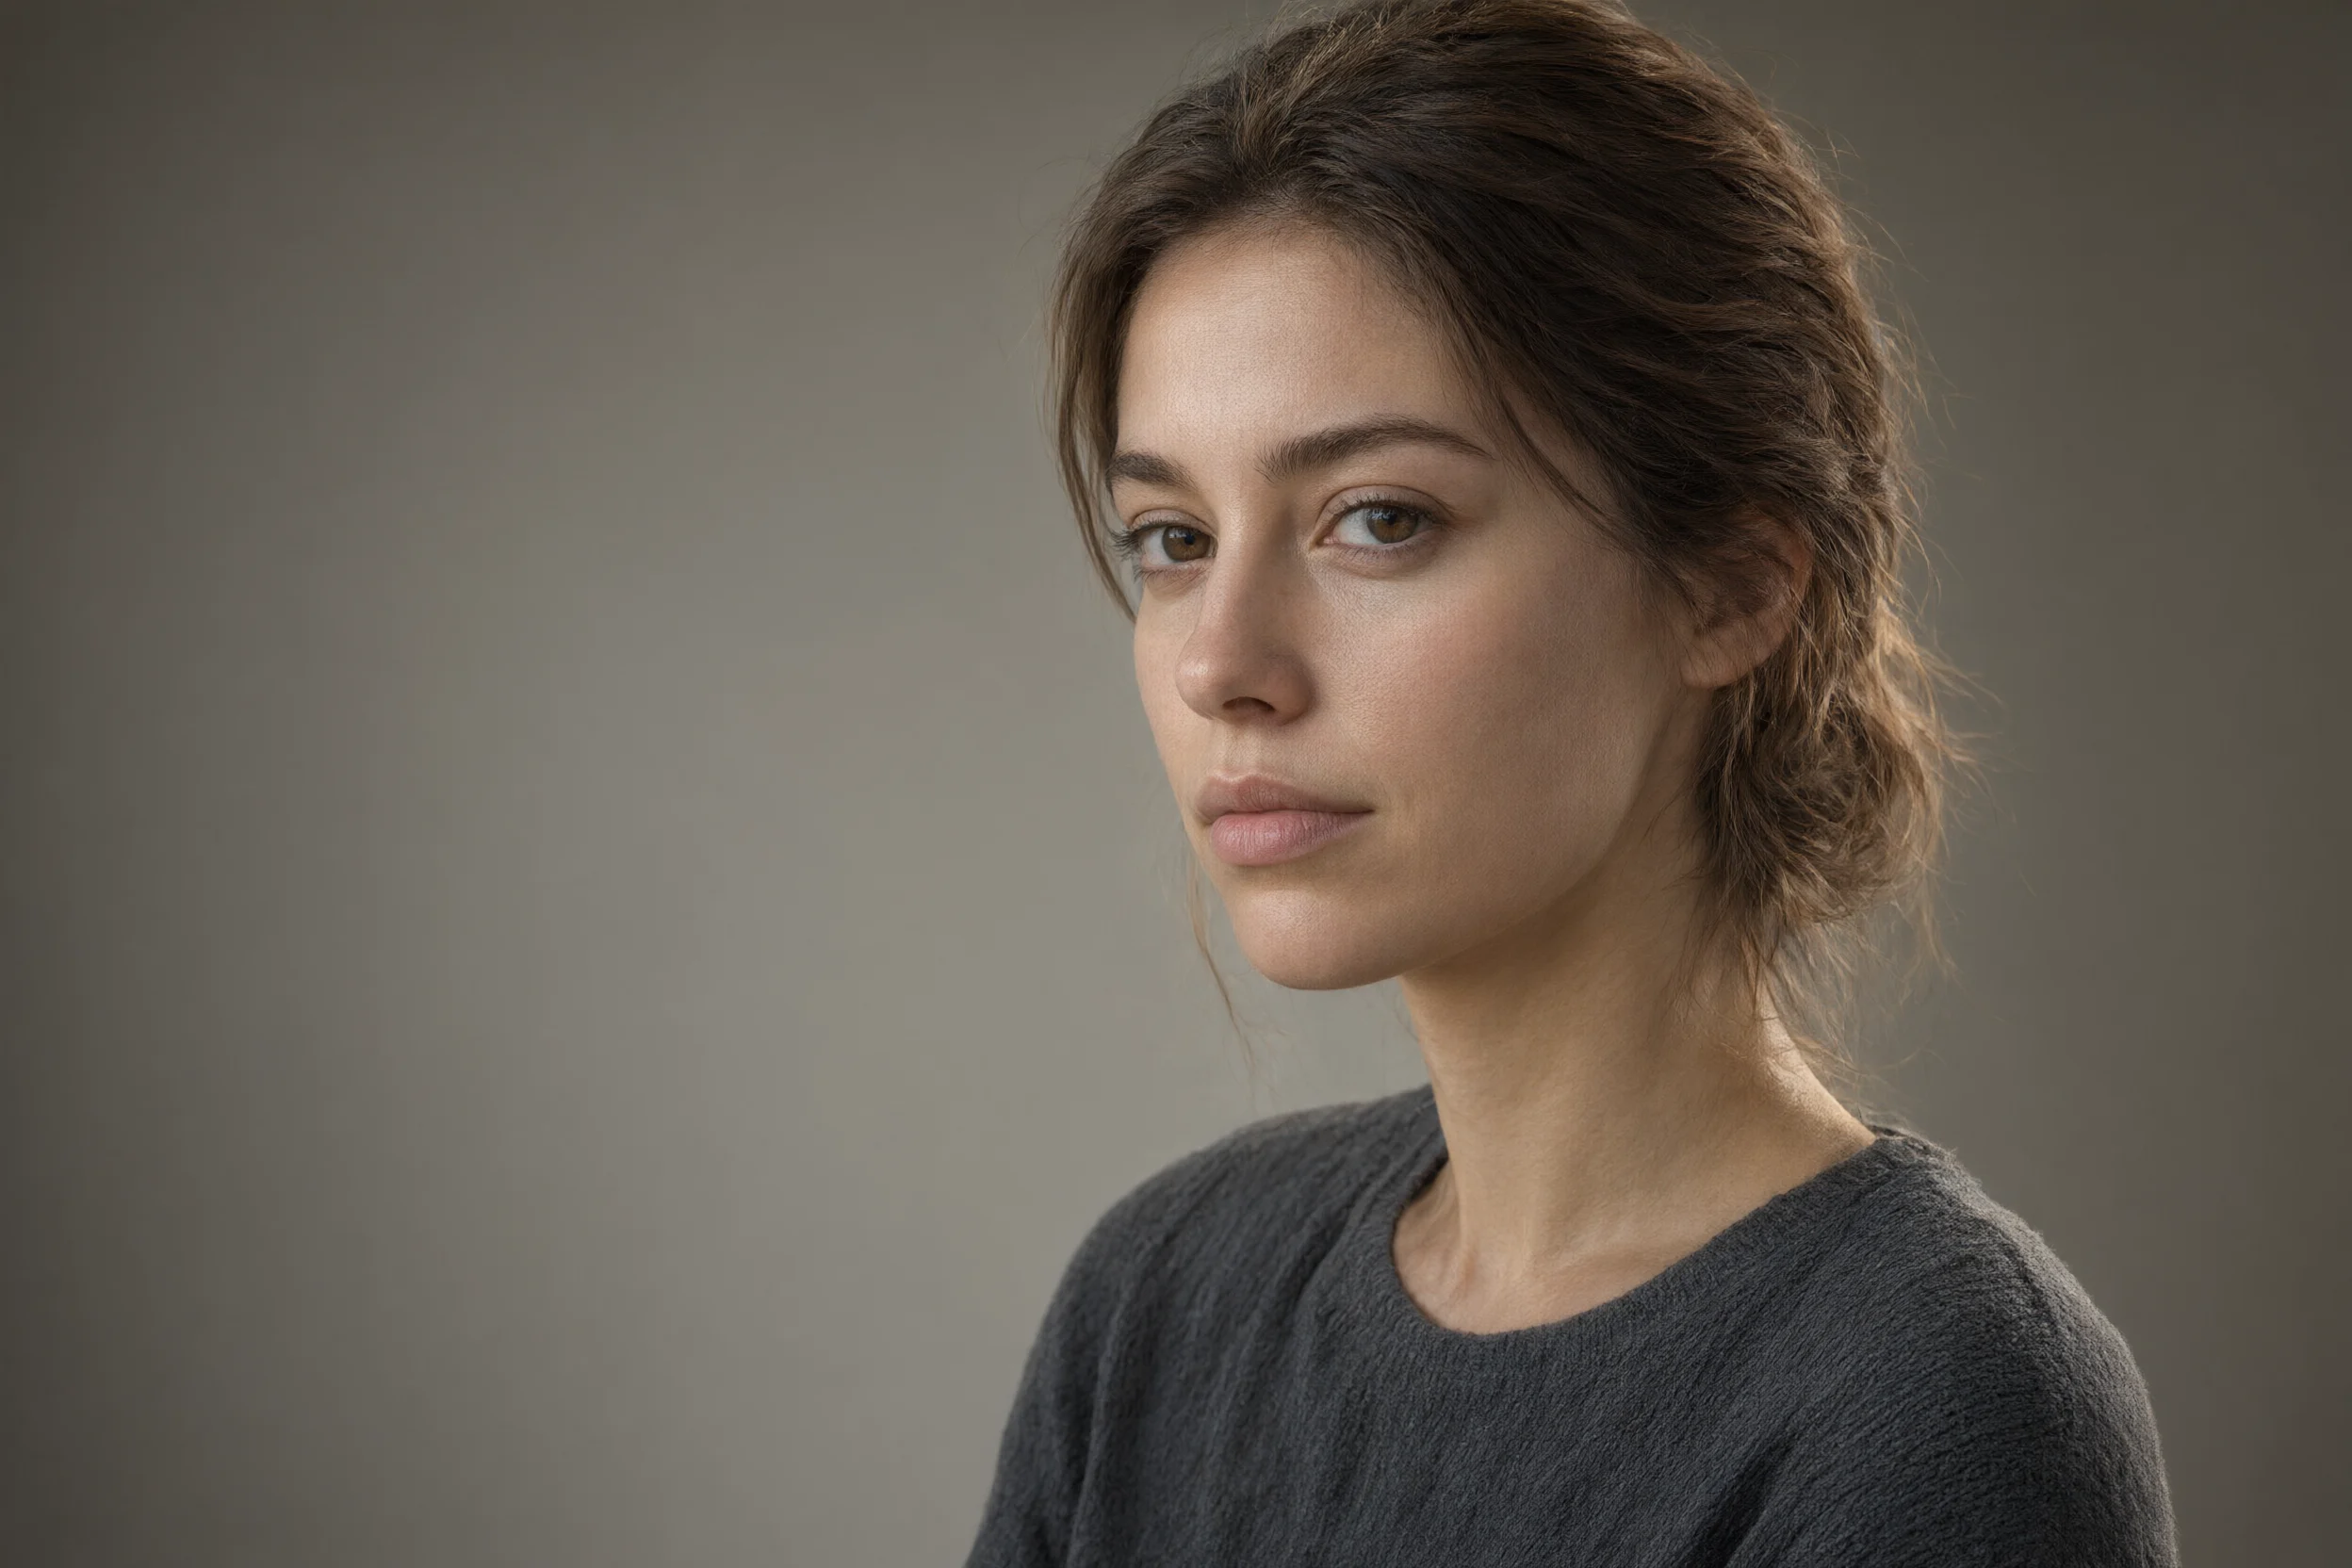
Qwen-Image-3.0 демонстрация двух стилей портрета: реализм и художественность
Стиль Портреты и фотография · Фотореалистичность · Текст в изображение
Промпт
Реалистичный крупноплановый портрет молодой женщины около тридцати лет, три четверти поворота лица, слегка влево, мягкий свет из окна падает справа от камеры, на скулах и по краю линии роста волос тонкие контурные блики, естественная текстура кожи, видимые поры, тонкие пушковые волоски и отдельные пряди отчётливо различимы в свете, спокойное выражение лица, расслабленные губы, очень лёгкий макияж, одета в однотонную угольно-серую вязаную кофту, малая глубина резкости, фон — мягко размытый тёпло-серый студийный, ощущение объектива 85mm, мягкие переходы света, низкая насыщенность естественных цветов, богатая детализация в области глаз и бровей, без тяжёлой ретуши, горизонтальная композиция 16:9, фигура расположена на правой линии третей кадра
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
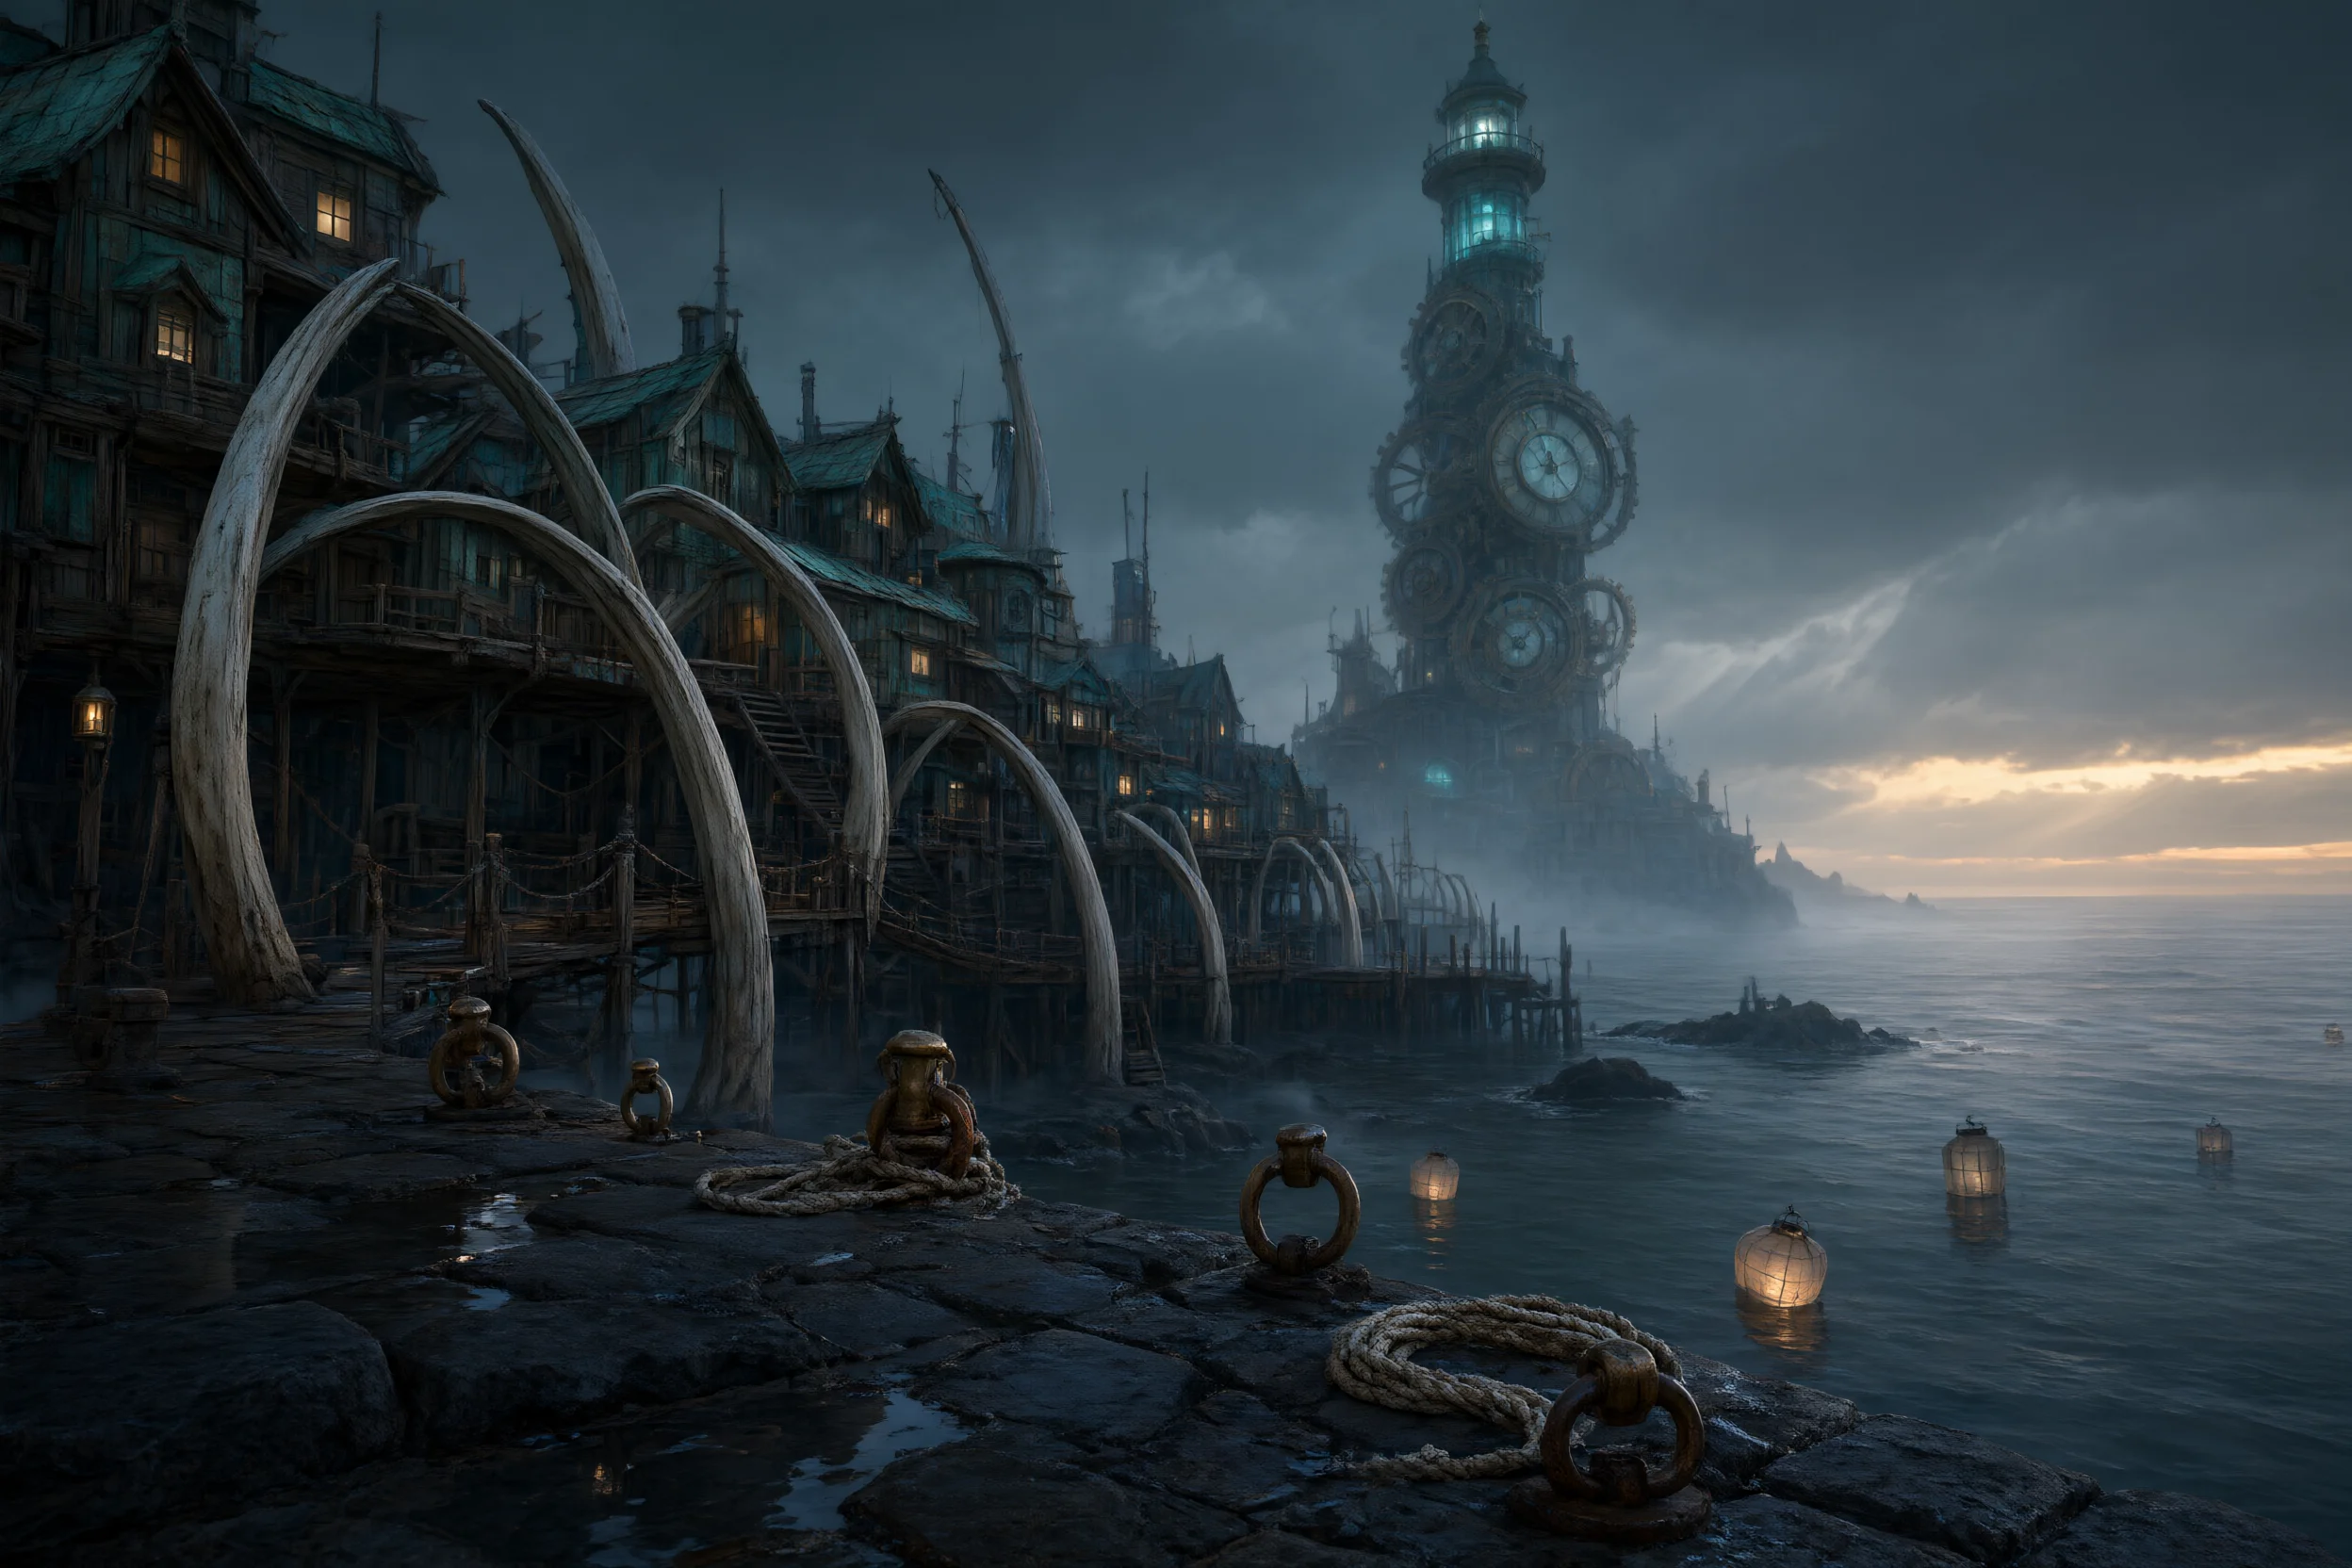
qwen-image-3.0 концепт-арт локаций: визуальное исследование атмосферы мира
Стиль Концепт-арт · Построение мира · Кинематографичный
Промпт
Широкоугольный концепт-арт кадр в кинематографическом стиле, изображающий мир под названием Порт Приливной Памяти в синий час сразу после шторма. Передний план: влажные блоки чёрного базальта на причале с неглубокими лужами-отражениями, ржавые латунные швартовные кольца, свёрнутые канаты, покрытые соляной коркой, несколько плавучих бумажных фонариков наполовину погружены в воду. Средний план: ряд изогнутых домов на сваях, построенных из переработанного корабельного дерева и окисленной меди, опирающихся на гигантские рёберные арки из китовых костей, перекинутые над узкими мостками; из маленьких окон льётся тёплый свет, намекая на то, что здесь живут; деревянные лестницы и верёвочные мосты соединяют уровни. Задний план: огромная башня, похожая на маяк, сложенная из шестерёнок приливных часов и стеклянных резервуаров для воды, испускает слабое бирюзовое свечение, поднимаясь из спокойной серой глади моря, а далёкие грозовые облака на горизонте разрываются тонкой янтарной полосой света. Атмосфера: низкий морской туман клубится между зданиями, мелкая морось, объёмный свет проникает сквозь туман справа, холодная палитра бирюзово-синих и аспидно-синих тонов с сдержанными янтарными акцентами, малоконтрастная кинематографическая цветокоррекция, тонкая хроматическая аберрация по краям кадра. Стиль: живописный реализм в сочетании с архитектурным концепт-дизайном, высокая достоверность материалов — влажного камня, выветренной древесной текстуры и ржавого металла, мягкая глубина резкости сохраняет чёткость среднего плана, сверхдетализированное негативное пространство в небе удобно для последующей вёрстки текста. Композиция 16:9, линия горизонта в нижней трети, направляющие линии мостков ведут взгляд к башне.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
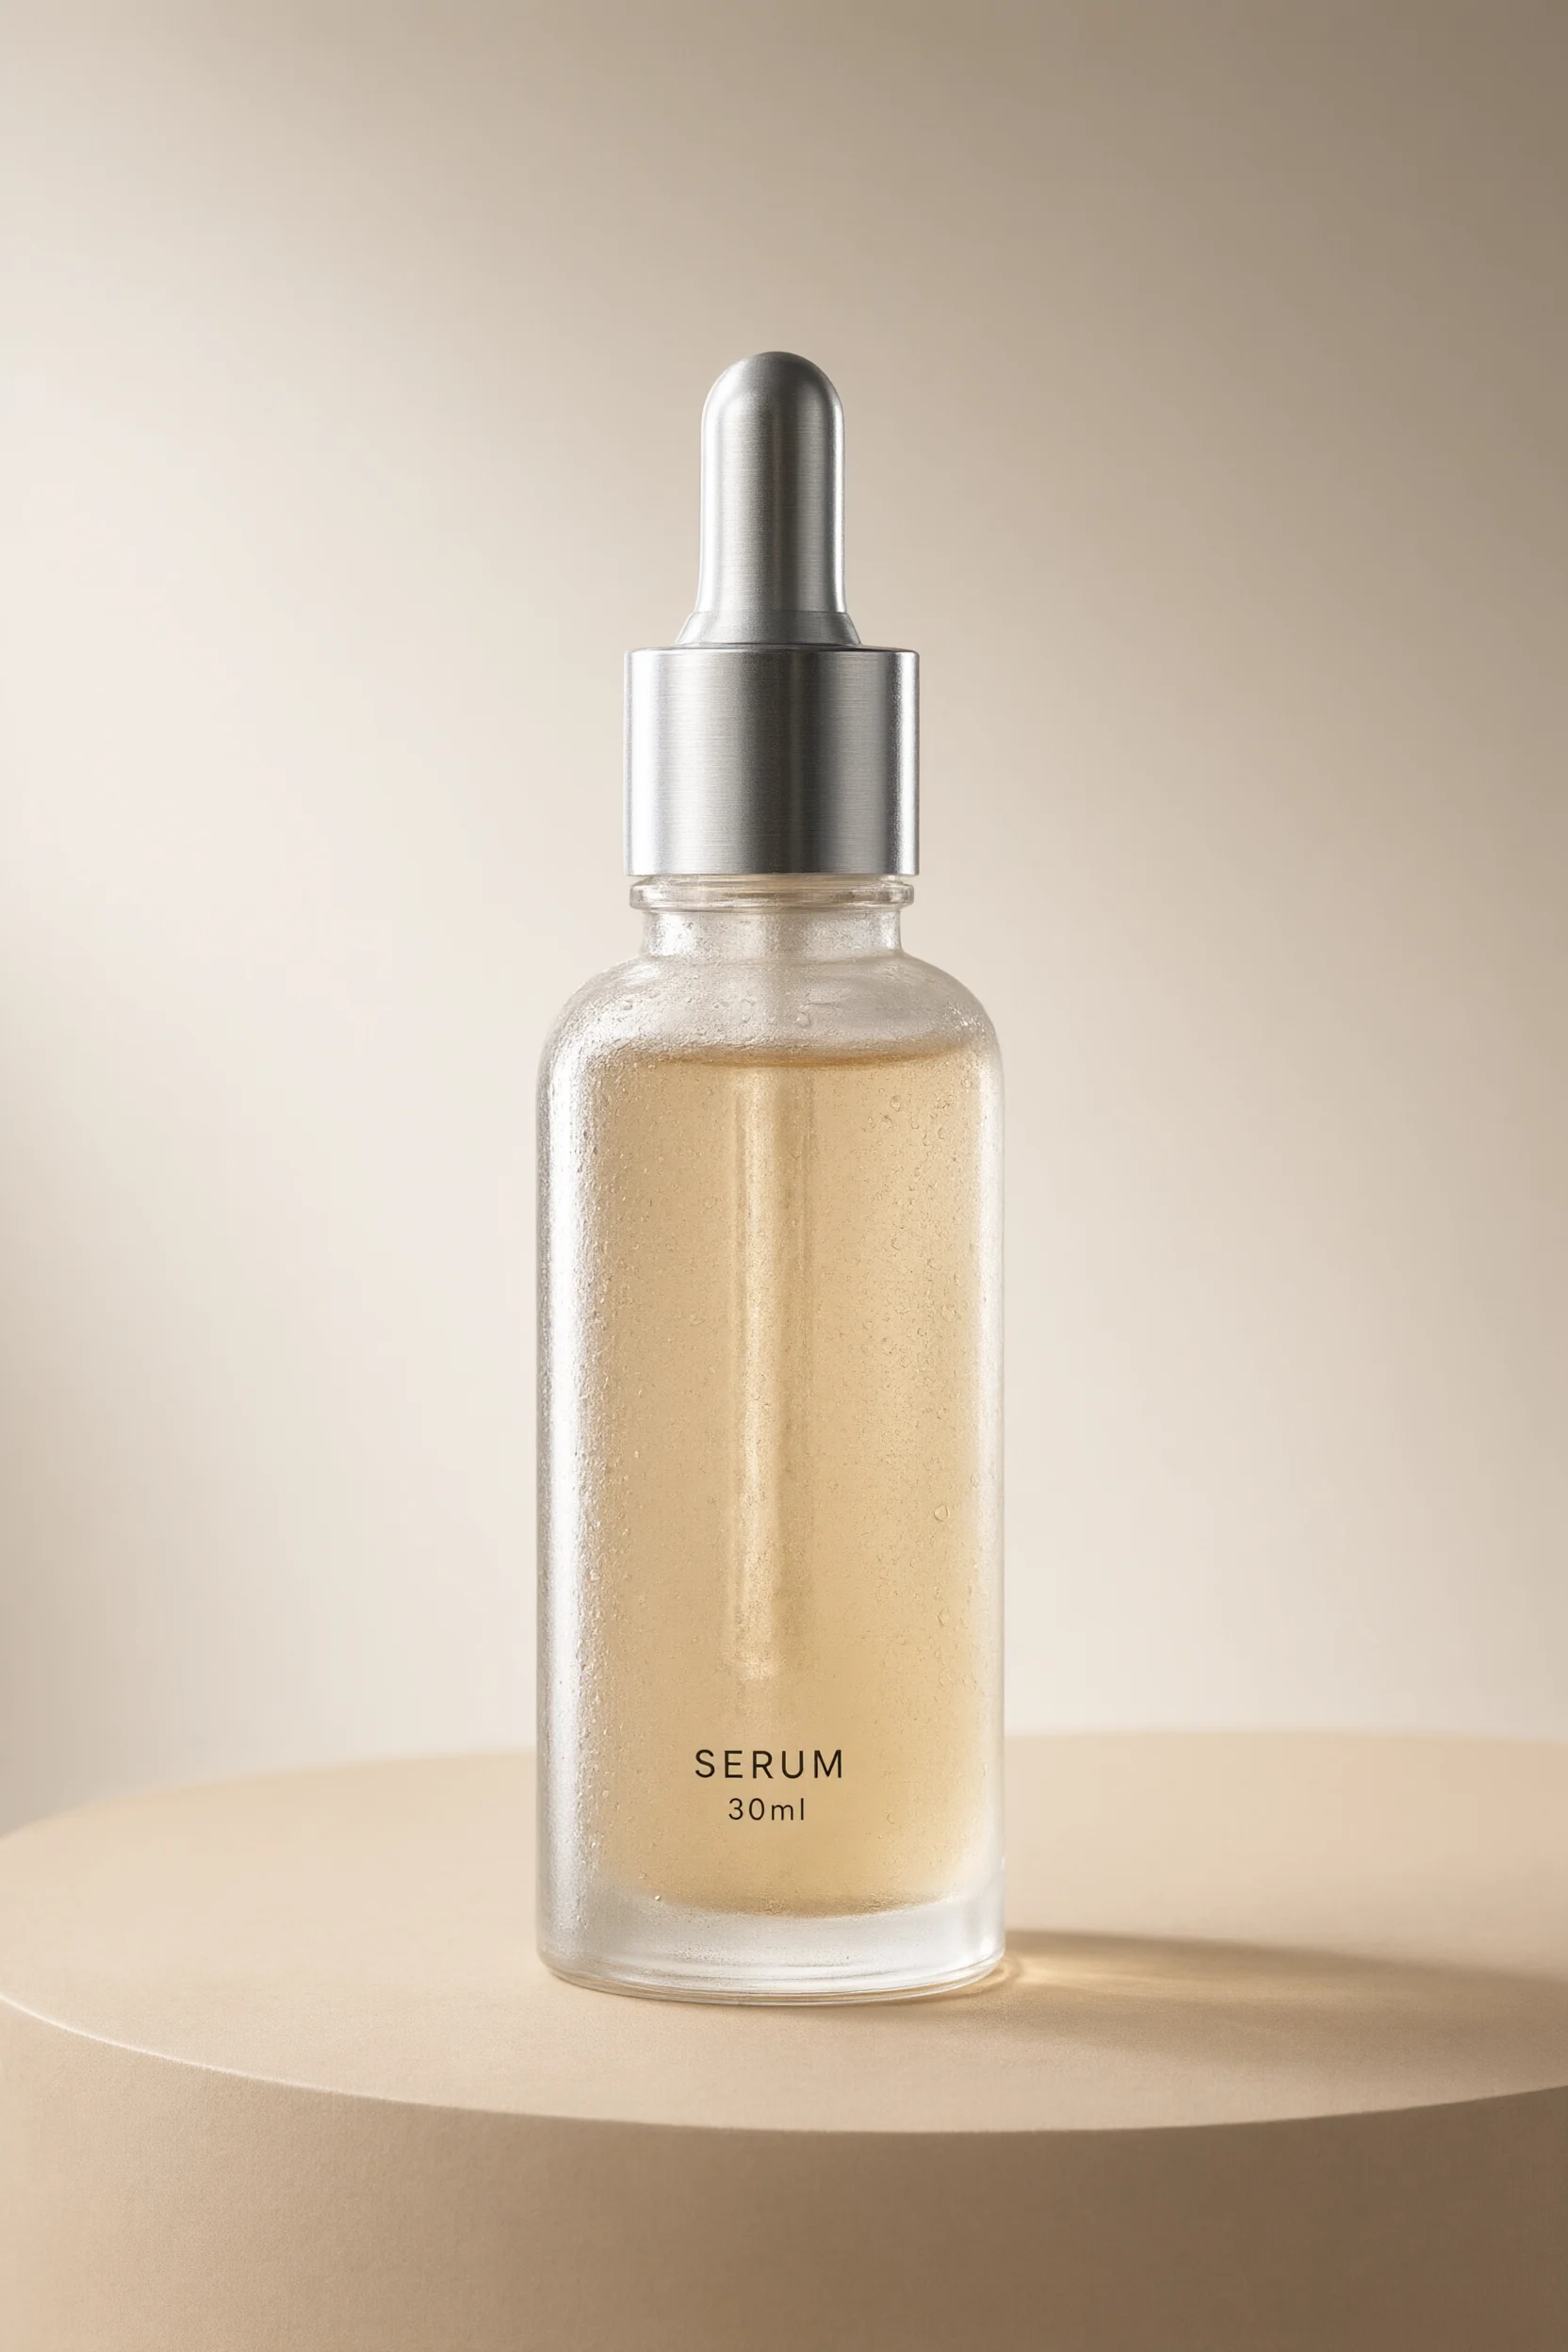
Качество продуктовой съёмки для электронной коммерции: примеры генерации изображений Qwen-Image-3.0
Стиль Изображение продукта · электронная коммерция · Студийный свет
Промпт
Студийная продуктовая съёмка одиночного флакона сыворотки для ухода за кожей из матового стекла с крышкой-дозатором из шлифованного алюминия, расположенного по центру на матовой тёплой бежевой подставке, на фоне мягкого градиента от кремового к светло-серо-коричневому. Трёхточечная студийная схема освещения: большой софтбокс слева сверху создаёт чистый вытянутый блик на левом краю стекла, справа добавлен тонкий контровой свет по контуру, мягкая заполняющая подсветка сохраняет детали теней. На поверхности стекла видны мельчайшие капли конденсата, жидкость имеет изысканный янтарный оттенок, на дне флакона переданы реальная толщина стекла и эффект преломления. На флаконе минималистичная маленькая этикетка с надписью "SERUM 30ml", выполненной лаконичным шрифтом без засечек, строго горизонтальной и хорошо различимой. Малая глубина резкости, характерная для макрообъектива 85 мм, мягкое размытие фона, отсутствие нагромождения лишних предметов, справа оставлено достаточно свободного пространства для наложения текста. Качество на уровне коммерческого каталога для электронной коммерции, резкий фокус на крышке и плечиках флакона, нейтральная цветокоррекция, высокая достоверность материалов, фотореалистичный рендеринг.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
qwen-image-3.0/text-to-image per image
| Цена за единицу | $0.0358 |
|---|
Краткое описание позиционирования
Линейка текст-в-изображение qwen-image-3.0 — это модель генерации изображений третьего поколения серии Qwen от Alibaba, ориентированная на сценарии разработки, где изображение должно нести реальную информацию. Она принимает промпты длиной до 18000 символов и хорошо справляется с созданием инфографики, газетных вёрсток, концепт-макетов UI, сеток товаров и других композиций с высокой плотностью элементов и текста. Поддерживаются два разрешения 1K/2K, восемь соотношений сторон, вывод в PNG/JPEG и случайное зерно (seed), что делает её продуктивным инструментом для дизайн-материалов, прототипов интерфейсов и маркетинговых материалов.
Ключевые особенности
- Длинные промпты для сложных вёрсток — лимит промпта 18000 символов позволяет одним описанием одновременно задавать многоблочную компоновку, элементы и текстовое содержимое.
- Вёрстка и текст для информационной графики — оптимизированы плотная вёрстка, мелкий кегль и многоязычный рендеринг, чтобы сгенерированные макеты и интерфейсы были ближе к готовым к использованию материалам.
- Управляемые параметры вывода — разрешение, соотношение сторон, формат файла и случайное зерно можно задавать; вместе с негативным промптом и автоматической оптимизацией промпта это удобно для пакетной генерации изображений в едином стиле.
Описание возможностей
Генерация сложных сцен на основе длинного текста: один промпт может достигать 18000 символов, что позволяет подробно описать композицию, стиль и информационную иерархию и сократить затраты на многократное дописывание промпта.
Вёрстка и интерфейсные макеты с плотным текстом: подходит для генерации инфографики, газетных полос, постеров и концепт-схем UI, где элементы и текст сосуществуют, давая результат, близкий к реальным рабочим материалам, а не к чисто эстетичным картинкам.
Точное управление параметрами вывода: доступны разрешение 1K или 2K, восемь соотношений сторон от 1:1 до 21:9, форматы PNG или JPEG, а также воспроизведение или тонкая настройка результата через случайное зерно.
Усиление промпта и негативные ограничения: prompt_extend по умолчанию включён и автоматически дополняет и оптимизирует промпт, а negative_prompt исключает нежелательные элементы, повышая управляемость генерации.
Сценарии применения
- Генерация вёрсточных материалов для дизайн- и контент-команд — ввод текста и описания компоновки для инфографики, газетных полос или постеров даёт изображения, пригодные как референс для вёрстки или иллюстрация к публикации.
- Концепт-макеты UI для продуктовых и фронтенд-команд — описание структуры интерфейса веб-сайта, игры или стримингового сервиса в промпте даёт концепт-схемы для обсуждения высокодетализированных прототипов и дизайн-ревью.
- Товарные и маркетинговые изображения для e-commerce — на входе информация о товаре и требования к показу, на выходе сетки товаров и маркетинговые материалы для черновиков карточек и страниц акций.
- Иллюстрации для обучения и документации — по содержанию объяснения генерируются материалы со смешанным текстом и изображениями или иллюстрации для документов, дополняющие учебные слайды, пояснительные страницы и внутренние материалы.
Ограничения и рекомендации по выбору
Эта линейка поддерживает только текст-в-изображение; для изменения изображения на основе референса нужно перейти на линейку изображение-в-изображение той же серии. Информация о возможностях модели в основном взята со страниц релизов производителя и сторонних презентаций, публичных независимых бенчмарков нет, поэтому перед запуском в эксплуатацию рекомендуется провести проверку на небольшой выборке с собственными бизнес-промптами. Длинные промпты и плотная текстовая вёрстка требуют высокой точности описания, а результат зависит от плотности вёрстки и языка, поэтому рекомендуется сочетать случайное зерно с многократной генерацией и отбором результатов. Если нужны только обычные эстетичные иллюстрации, можно использовать более лёгкие модели текст-в-изображение для экономии затрат.
Новости
Смотреть changelog →- Новая модель Новая модель: qwen-image-3.0-pro/text-to-image
- Новая модель Запущена модель преобразования изображений qwen-image-3.0-pro
- Новая модель Добавлена документация для qwen-image-3.0/text-to-image…
Частые вопросы
Все частые вопросы →-
Сколько референсных изображений поддерживает редактирование изображений в Qwen Image 3.0?
Поддерживается от 1 до 3 референсных изображений. Требуется как минимум одно, поле API — input.image_urls.
-
В чём разница между редактированием изображений в Standard и Pro?
Стандартная версия делает акцент на более низкой стоимости и быстрой итерации; Pro лучше подходит для точной замены текста, сложных материалов и финальной вёрстки.
-
Как тарифицируются 1K, 2K и референсные изображения?
1K и 2K используют один и тот же тарифный уровень вывода, за каждое референсное изображение взимается дополнительная плата; конкретные суммы указаны в актуальных ценах на этой странице.
-
Как уменьшить смещение субъекта, макета или текста?
В Prompt отдельно перечислите то, что нужно изменить, и то, что необходимо сохранить: субъект, текст, положение, материалы, ракурс камеры и освещение; если нужен точный текст, заключите целевой текст в кавычки.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: qwen-image-3.0/text-to-image
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для qwen-image-3.0/text-to-image и маршрута default — см. таблицу параметров ниже.
seedintegerНеобязательноmin 0max 2147483647Случайное зерно, используемое для управления случайностью результата генерации; принимает целое число. При одинаковом зерне и совпадении остальных параметров можно воспроизвести похожий результат; если не передано, сервер генерирует его случайно.
promptstringОбязательноminLength 1maxLength 18000Прямой промпт: текстовое описание желаемого содержания, стиля и композиции изображения; основной вход для генерации изображения по тексту.
resolutionstringНеобязательноПо умолчанию: "1K"Уровень выходного разрешения, задаваемый строкой и определяющий степень чёткости генерируемого изображения; по умолчанию 1K.
1K2Kaspect_ratiostringНеобязательноПо умолчанию: "1:1"Соотношение ширины и высоты выходного изображения, задаваемое строкой в виде пропорции; по умолчанию 1:1.
1:13:22:34:33:416:99:1621:9output_formatstringНеобязательноПо умолчанию: "png"Формат файла генерируемого изображения, задаваемый строкой; по умолчанию png.
pngjpegprompt_extendbooleanНеобязательноПо умолчанию: trueЛогическое значение, указывающее, следует ли автоматически оптимизировать промпт; при включении сервер дополняет и усиливает prompt; по умолчанию true.
negative_promptstringНеобязательноПо умолчанию: ""maxLength 500Негативный промпт, описывающий то, чего не должно быть на изображении; по умолчанию пустая строка, означающая отсутствие исключающих ограничений.
callbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen-image-3.0/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "1:1",
    "output_format": "png",
    "prompt_extend": true,
    "negative_prompt": ""
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "qwen-image-3.0/text-to-image",
input: {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": true,
"negative_prompt": ""
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "qwen-image-3.0/text-to-image",
"input": {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "1:1",
"output_format": "png",
"prompt_extend": True,
"negative_prompt": ""
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →-

Сравнительный обзор
hailuo-2.3-fast/image-to-video — горизонтальное сравнение: как выбрать модель «изображение в видео» и что учесть при миграции
-

Руководство
Практика генерации изображений по тексту с recraft-v4.1-flash: 5 ценных бизнес-сценариев и ключевые моменты интеграции
Отталкиваясь от стоимости $0.01 за изображение, спланируйте внедрение генерации изображений в реальные бизнес-процессы
-

Руководство
Как вызывать kling-4.0/image-to-video на HiAPI: curl, Python и опрос
-

Сравнительный обзор
Recraft v4.1 Flash 文生图横向对比:开发者选型与迁移指南
用每张 $0.01 的成本与纯文生图能力,判断它是否适合你的图像生成流水线
-

Руководство
Как использовать kling-4.0/text-to-video через HiAPI API: curl, Python и рабочий пример запроса
Практическое руководство для разработчиков: кинематографичные промпты, синхронный звук, асинхронный опрос и скачивание результатов
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата
-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
kandinsky-6.0-pro/image-to-video в HiAPI: руководство по curl + Python
Как выполнить рабочий запрос генерации видео из изображения в HiAPI: от загрузки первого кадра до асинхронного опроса и финальной загрузки
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
Похожие модели
Все модели →Тот же тип
-
 Seedream 5.0 ByteDance $0.025 /изображение
-
 Qwen Image 2.1 Alibaba $0.020 /изображение
-
 Nano Banana 2 Google $0.036 /изображение
-
 GPT Image 2.5 OpenAI $0.017 /изображение
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /изображение
-
 Z-Image Alibaba $0.008 /изображение
-
 Ideogram V4 Ideogram $0.050 /изображение
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /изображение
-
 Seedream 4.5 ByteDance $0.045 /изображение
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /изображение
-
 Nano Banana Google $0.021 /изображение
-
 Google Virtual Try-On Google $0.107 /изображение
Тот же вендор
- Z-Image Alibaba $0.008 /изображение
-
 Qwen Image 3.0 Alibaba $0.036 /изображение
-
 Wan 2.6 Flash Alibaba $0.043 /секунду
-
 Qwen Image 2.0 Alibaba $0.042 /изображение
-
 Wan 2.7 Image Alibaba $0.035 /изображение
-
 Wan 2.7 Video Alibaba $0.100 /секунду
- Qwen Image 2.1 Alibaba $0.020 /изображение
-
 HappyHorse 1.1 Alibaba $0.160 /секунду
-
 Wan 3.0 Video Alibaba $0.040 /секунду
-
 HappyHorse 1.0 Alibaba $0.168 /секунду
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1 000 символов