
使用指南
FLUX.3 视频短视频:通过 API 进行草稿、渲染、续写
一支带原生音频的竖屏 9:16 短片:用 $0.45 的草稿测试创意,720p 成片,再续写到 10 秒,全部在同一个模型 id 上完成,附真实输出。
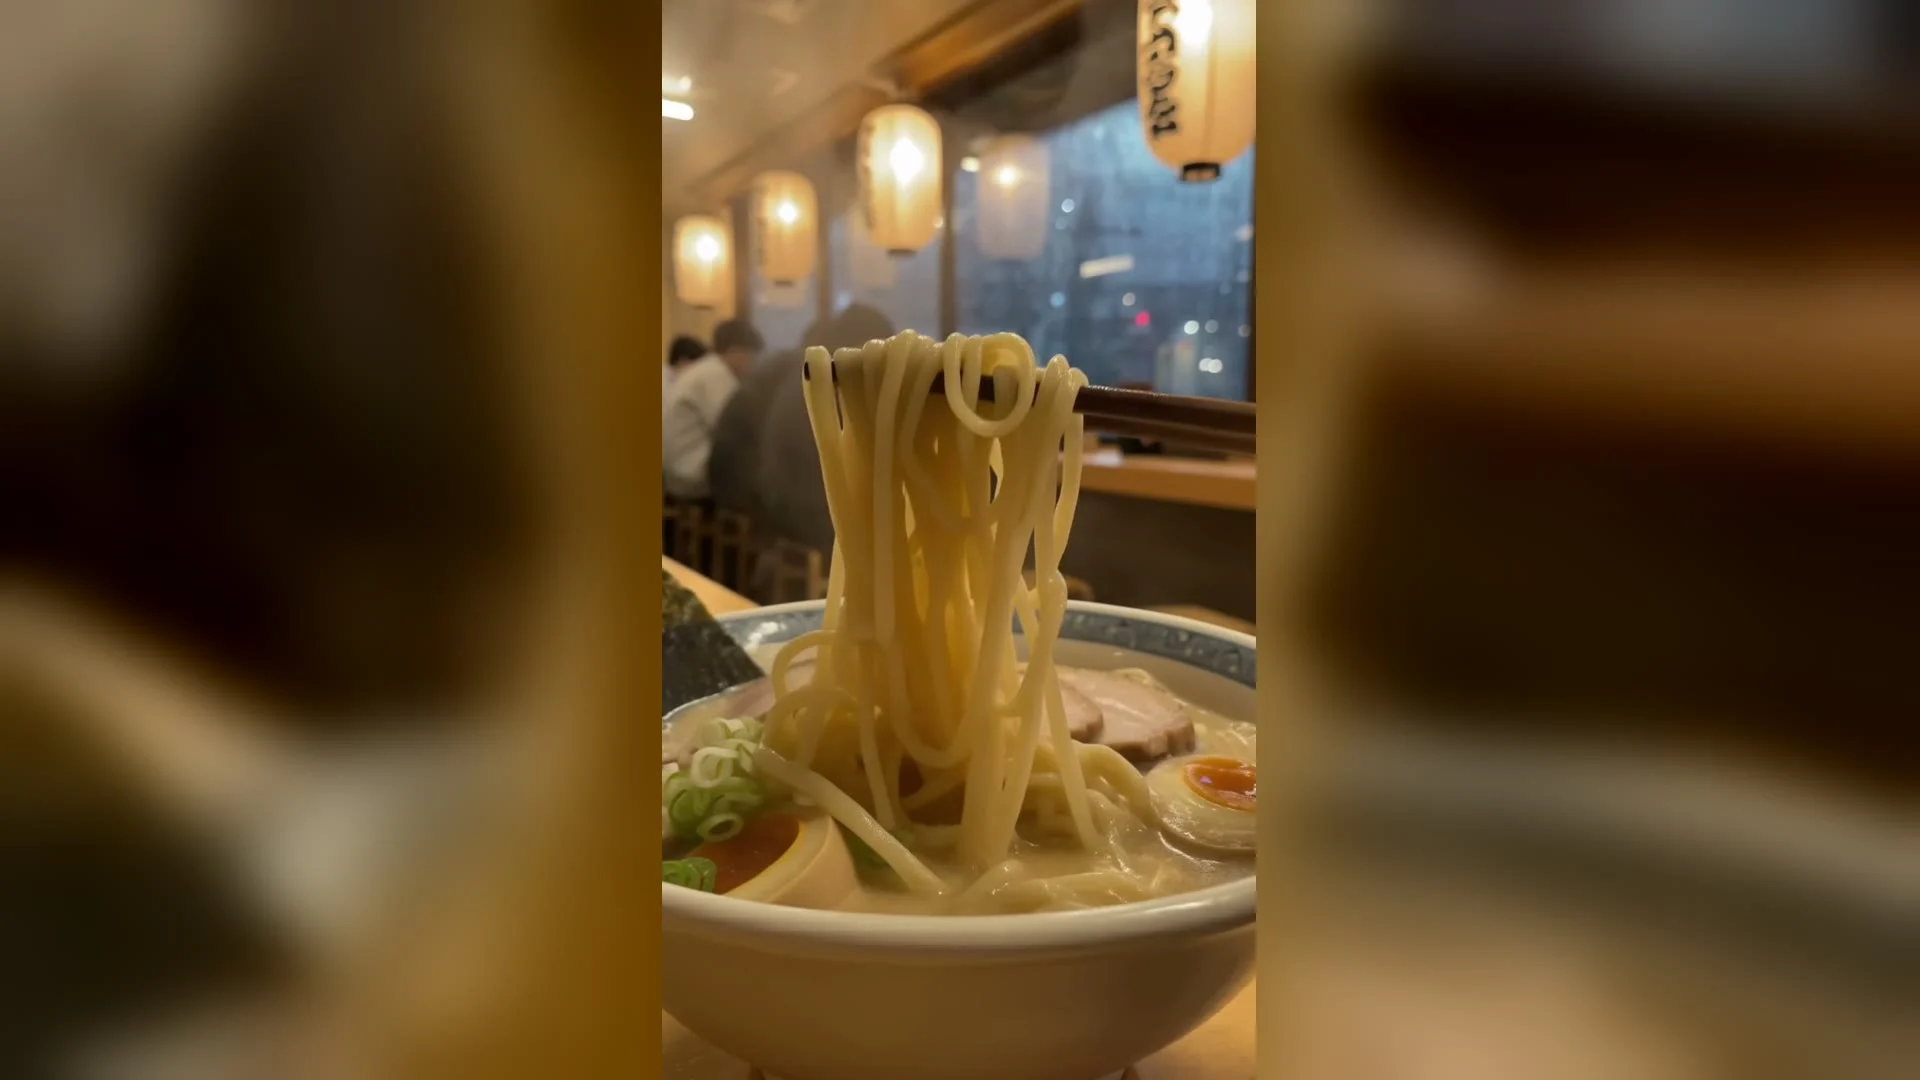
FLUX.3 Video(在 hiapi 上为 flux-3-video)用同一个模型 id 覆盖短视频工作流所需的三件事:竖屏 9:16 输出、与画面同步生成的音轨,以及从现有片段最后一帧接续的视频续写。本指南在一个小任务上使用这三项功能:为一家深夜拉面店制作一支 10 秒竖屏短片。先用便宜的草稿验证概念,再以 720p 渲染成片,然后通过续写把镜头延长到 5 秒以上。下面每个片段都是真实、未经编辑的 API 输出,每个价格都来自 hiapi 的实时价格表。
完整的参数参考和首次请求演练,请参阅 FLUX.3 Video API 指南。如果你想要单独的图生视频和关键帧端点、且每秒价格更低,FLUX 3 Max 短视频工作流 涵盖了那个模型。本文讲的是 flux-3-video 额外提供的东西:音频、草稿预览和续写。
三次调用完成的工作流
| 步骤 | 作用 | 关键字段 | 价格(每秒) | 5 秒费用 |
|---|---|---|---|---|
| 1. 草稿 | 检查提示词是否按预期呈现 | draft: true |
$0.09 | $0.45 |
| 2. 成片 | 渲染你将发布的片段 | resolution: "720p" |
$0.25 | $1.25 |
| 3. 续写 | 将成片片段再延长 5 秒 | start_video + draft: true |
$0.18 | $0.90 |
三者都使用同一个模型 id,在异步任务端点上使用相同的请求结构。本次运行总花费为 $2.60,得到一支带声音的 10 秒竖屏短片。在 1080p 下,普通渲染的费率升至 $0.42/秒,续写为 $0.76/秒,非草稿的 720p 续写为 $0.59/秒。当前费率见 flux-3-video 模型页面 和 价格页面。
第 1、2 步:草稿与成片,作为一批提交
提示词用一个句子块描述镜头,并用单独的 Audio: 行描述声音。开启 generate_audio: true 时,模型返回一个内嵌 AAC 音轨的 .mp4,而不是单独的音频文件。
{
  "model": "flux-3-video",
  "input": {
    "prompt": "夜间竖屏手持镜头:一碗豚骨拉面的热气升腾,筷子夹起油亮的面条伸向镜头,后方是一个只有六个座位的拉面吧台,温暖的纸灯笼,雨水在窗户上划出痕迹,浅景深。音频:汤底咕嘟声、轻柔的吸面声、雨打玻璃声、低低的交谈声。",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "draft": true,
    "generate_audio": true
  }
}
成片请求是相同的请求体,只是去掉 "draft": true。两个请求连续提交。二者互不等待,因为每次调用都会立即返回一个 taskId:
| 草稿 | 成片 720p | |
|---|---|---|
| 创建 → 完成(服务器时间戳) | 29 秒 | 64 秒 |
| 输出尺寸 | 704×1280 | 704×1280 |
| 时长 | 5.04 秒 | 5.04 秒 |
| 音频峰值电平 | −23 dB | −5 dB |
| 费用 | $0.45 | $1.25 |
以下是草稿:
以及同一提示词最终的 720p 成片:
这两个片段说明了草稿能告诉你什么、不能告诉你什么:
- 草稿是另一个版本,不是成片的低分辨率预览。 草稿取景为一只素白碗,面条已经夹起。成片则选了有花纹的碗,配有溏心蛋、葱花、吧台上的食客和热气。请求 schema 没有 seed 字段,因此你无法锁定草稿的构图再以全质量重新渲染。
- 像素尺寸完全相同。 两个输出都是 704×1280。差别在细节:草稿明显更柔和,背景模糊,而成片保留了面条和灯笼字样的纹理。
- 草稿的音轨音量低得多。 其峰值约为 −23 dB,而成片为 −5 dB。不要用草稿判断音频混音。
因此,用草稿以每份 $0.45 的成本在多个提示词变体上检查概念(提示词是否能生成夜间竖屏、带夹面动作的拉面特写?)。然后只为通过的提示词渲染成片,并从成片中挑选。
第 3 步:用续写延长镜头
5 秒的钩子对于一条帖子往往太短。与其生成另一段不相关的片段,不如把成片的公开 URL 作为 start_video 传入,并描述接下来发生什么:
{
  "model": "flux-3-video",
  "input": {
    "prompt": "继续同一镜头:面条被吸出画面,手持相机向右上方漂移,越过热气腾腾的碗,朝雨水划痕的窗户移动,发光的纸灯笼映在玻璃上,窗外有模糊的霓虹招牌。音频:吸面声,然后是雨打窗户声和吧台交谈声轻柔地渐强。",
    "start_video": "https://static.hiapi.ai/blog/flux-3-video-short-form-video/hook-final.mp4",
    "duration": 5,
    "resolution": "720p",
    "aspect_ratio": "9:16",
    "draft": true,
    "generate_audio": true
  }
}
该任务从创建到完成耗时 119 秒,费用 $0.90(5 秒 × $0.18 草稿续写)。返回结果如下:
有两点行为需要提前规划:
- 输出只包含新增的秒数。 返回文件长 5.0 秒。它从源片段的最后一帧开始(灯笼前被夹起的面条),然后按请求摇向窗户。它不包含原来的 5 秒,所以两个文件需要你自己拼接。
- 因为首帧匹配,拼接是无缝的。 简单的 concat 即可生成一段连续的 10 秒镜头:
ffmpeg -i hook-final.mp4 -i extend-draft.mp4 \
  -filter_complex "[0:v][0:a][1:v][1:a]concat=n=2:v=1:a=1[v][a]" \
  -map "[v]" -map "[a]" -c:v libx264 -crf 20 -c:a aac -movflags +faststart cut-10s.mp4
这里的续写以草稿模式渲染以节省费用,后半段比前半段更柔和,与独立草稿的情况相同。对于要发布的片段,非草稿的 720p 续写费用为 $0.59/秒(5 秒 $2.95)。以 5 秒为步长延长,可以让你在支付下一步之前逐段确认;而一次性渲染 20 秒 720p 成片需预付 $5.00。
异步批处理脚本
下面的脚本并行发送任意数量的任务,轮询每个 taskId 直到完成,并立即下载输出。位于 temp.hiapi.ai 的结果 URL 带有 expireAt 时间戳,因此请把文件复制到你自己的存储,而不要直接链接。端点文档见 Create Task 和 Get Task Detail。
import os, time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

BASE = {"duration": 5, "resolution": "720p", "aspect_ratio": "9:16",
        "generate_audio": True}

jobs = {
    "ramen_draft":  {**BASE, "draft": True,  "prompt": "夜间竖屏手持镜头:……"},
    "coffee_draft": {**BASE, "draft": True,  "prompt": "竖屏特写:浓缩咖啡滴落……"},
    "ramen_final":  {**BASE,                 "prompt": "夜间竖屏手持镜头:……"},
}

# 1. 全部提交;每次调用都会立即返回一个 taskId
task_ids = {}
for name, inp in jobs.items():
    r = requests.post(API, headers=HEADERS,
                      json={"model": "flux-3-video", "input": inp}, timeout=60)
    r.raise_for_status()
    task_ids[name] = r.json()["data"]["taskId"]

# 2. 轮询直到每个任务达到最终状态
pending = dict(task_ids)
while pending:
    time.sleep(10)
    for name, tid in list(pending.items()):
        data = requests.get(f"{API}/{tid}", headers=HEADERS, timeout=30).json()["data"]
        if data["status"] == "success":
            url = data["output"][0]["url"]
            with open(f"{name}.mp4", "wb") as f:
                f.write(requests.get(url, timeout=120).content)
            print(name, "已保存")
            pending.pop(name)
        elif data["status"] in ("fail", "failed"):
            print(name, "失败:", data.get("error"))
            pending.pop(name)
对于续写步骤,在 input 中加入 "start_video": "<已批准成片的公开 URL>"。该 URL 必须可公开访问,因此请先把已批准的成片上传到你自己的存储。
批量提交前值得了解的请求规则
这些响应是本次运行期间 API 返回的。无效请求在提交时即被拒绝,返回 400 INVALID_REQUEST,不会创建任何任务:
aspect_ratio接受auto、21:9、2:1、16:9、4:3、1:1、3:4、9:16。其他任何值都会被拒绝。duration最大值为 20(maximum: got 99, want 20)。start_video必须是字符串 URL。- 未知字段会被拒绝(
additional properties ... not allowed),因此拼写错误会大声报错,而不是被忽略。
反过来:通过校验的请求就是一个真实、会计费的任务。不要在没有 draft: true 的情况下发送“测试”提示词。一个裸的 {"prompt": "test"} 是有效的,并会渲染一个全价片段。
常见问题
试用 flux-3-video 提示词最便宜的方式是什么? 720p 草稿模式:$0.09/秒,因此 5 秒片段为 $0.45。它能显示概念是否可行,但成片渲染会是另一个版本。
flux-3-video 会生成声音吗?
会。开启 generate_audio: true 时,音轨会内嵌在返回的 .mp4 中。在本次测试中,在提示词中用单独的 Audio: 行描述声音,得到了匹配的环境音(咕嘟声、吸面声、雨声、交谈声)。
flux-3-video 片段可以多长?
每次请求最长 20 秒。使用 start_video 续写,你可以分步延长,并在支付下一步之前批准每一步。
续写会返回完整的拼接视频吗? 不会。在本次测试中,它只返回新增的 5 秒,从源片段的最后一帧开始。请自行拼接文件。
开始构建
打开 flux-3-video 模型页面 查看当前价格并使用演练场。然后用上面的批处理脚本草拟几个竖屏钩子,为可行的那些渲染成片,并延长最好的一个。
相关文章
查看全部文章 →-

使用指南
GPT Image 2.6 是什么?markup 编辑与已知规格
OpenAI API 规范里关于 GPT Image 2.6 的全部信息、新 markup 编辑参数怎么用,以及还没公布的部分。
4 -

使用指南
Vidu Q4 Preview API 多少钱?540p 每秒 $0.0515
两个模式同价,五档分辨率、3–16 秒怎么计费,$10 能跑多少条,以及和站内视频模型的价格对照。
3 -

使用指南
Recraft V4.1 Flash 电商产品图:每张 $0.01 批量目录图
在 recraft-v4.1-flash/text-to-image 上的一次真实并行批量:商品列表图与场景图、实测背景白度、耗时以及批量脚本。