
使用指南
在 hiapi 上使用 hailuo-2.3-fast/image-to-video 批量生成短视频
短视频的成败取决于迭代速度。如果你的工作流是面向 TikTok 或 Reels 的流水线,你并不需要电影级的 4K 输出——你需要的是一个能把产品静图在不到一分钟内变成可用片段的模型,而且成本要足够低,好让你在挑选最佳版本前跑上几十个变体。这正是 hailuo-2.3-fast/image-to-video 的定位:hailuo-2.3 的 Fast 层级兄弟版本,定价和调优都专门针对高产量、可弃用的多次尝试工作流。
本指南将带你把它当作批量短视频引擎来使用:如何选择源静图、如何通过异步任务 API 驱动它、如何校验那些不做就会让你吃 400 错误的 schema 细节,以及如何思考在 TikTok/Reels 规模下运行它的经济性。
模型能给你什么
hailuo-2.3-fast/image-to-video 接收一张静图和一个提示词,将其动画化为短视频片段。它位于 hailuo-2.3-fast/image-to-video 模型页面,并且——和 hiapi 上的所有模型一样——通过统一的 /v1/tasks 异步端点调用:你 POST 一个任务,轮询(或注册回调)直到完成,然后从短期有效的输出 URL 拉取视频。
撰写本文时已对照线上 API 验证:
- 输入:一张图片(
image_url)+ 描述你想要的运动效果的文本提示词 - 输出:MP4,固定时长 6s 或 10s(不支持任意长度)
- 定价:按视频一口价,而非按秒计费——6 秒片段 $0.27,10 秒片段 $0.46
- 周转时间:我们的测试片段端到端(提交 → 成功)约 80 秒完成
按视频一口价正是批量作业的关键细节:一个 6 秒尝试,无论你的提示词一次就命中运动效果,还是你已经试到第四次,成本都一样。按 Fast 层级的价格,为同一张主视觉图跑 5-6 个变体来找出运动最流畅的那一个,成本仍低于大多数高端视频模型单次尝试的费用。在编制批量预算前,请到 定价页 确认当前数字——价格会变动。
如果你需要完整参数参考、更长的时长选项,或与非 Fast 版 hailuo-2.3 层级的并排对比,请参阅我们的 hailuo-2.3-fast/image-to-video API 集成教程——本指南侧重批量/工作流角度,而非原始 API 参考。
工作流:静图 → 短视频片段
短视频的套路很简单:从你已有的静图出发(产品摄影、生成的 hero shot、品牌素材),让模型添加运动——缓慢推镜、细微旋转、飘动氛围——而不是从零生成视频。这样能锁定你的视觉识别(同一产品、同一布光、同一构图),同时产出不是静态帖子的内容。
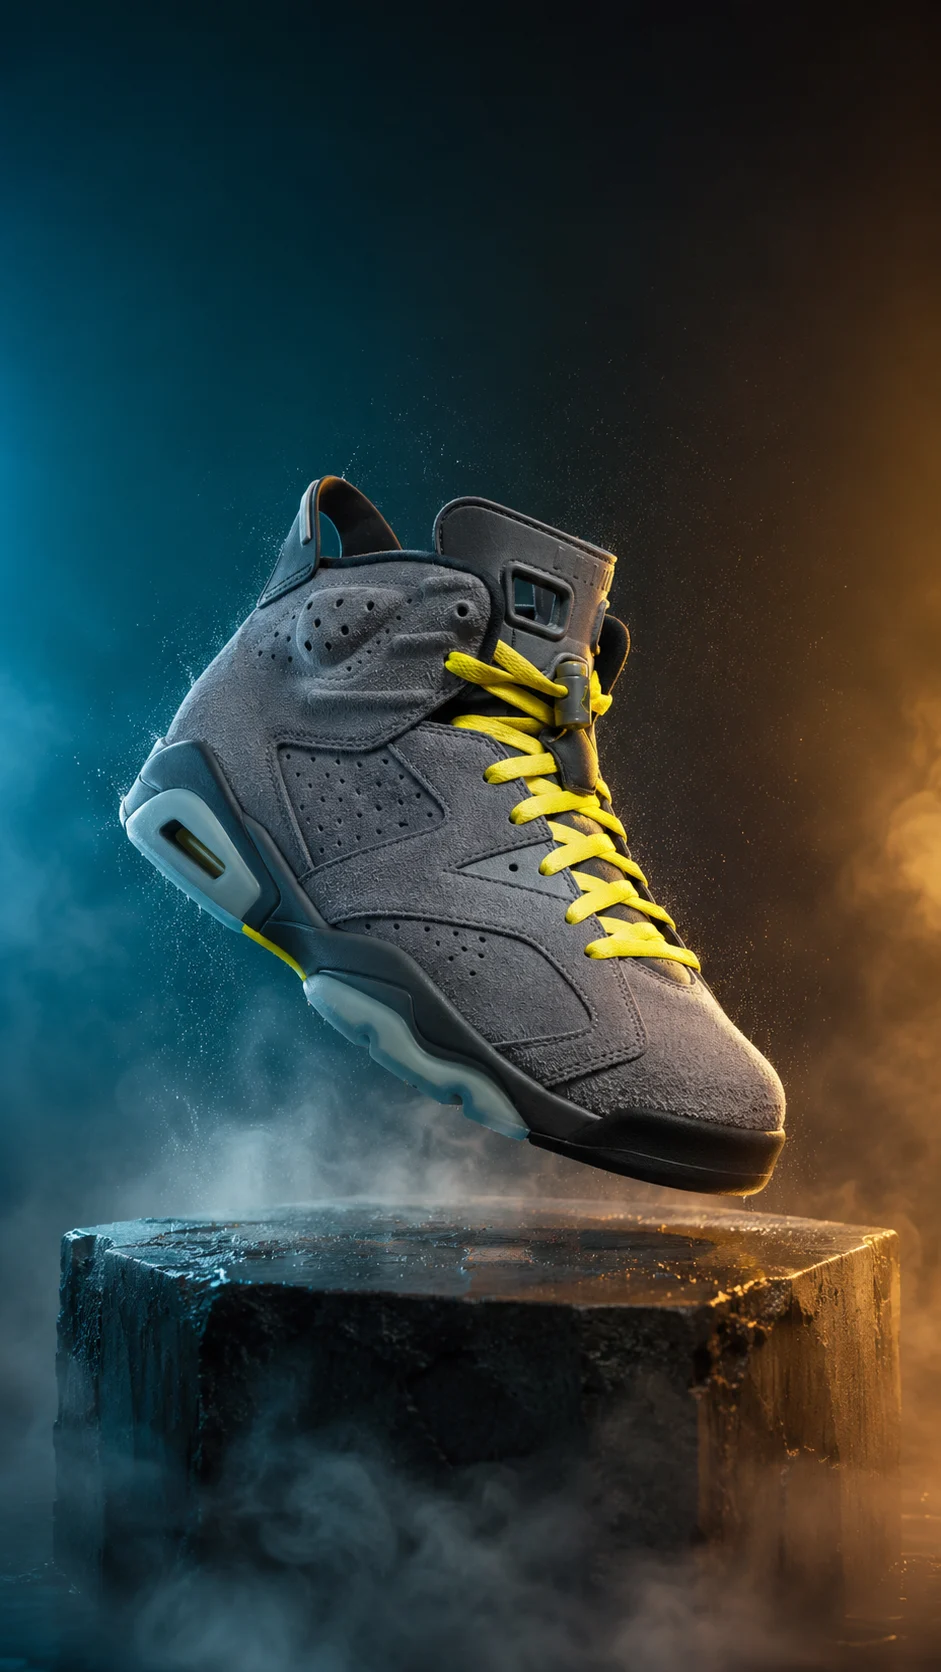
这是一个真实运行案例:一张竖直(9:16)的运动鞋静图放在打光底座上,用描述缓慢推镜和轻柔旋转的运动提示词驱动。
源静图及完整请求:
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "hailuo-2.3-fast/image-to-video",
    "input": {
      "prompt": "Slow smooth push-in on a chunky retro basketball sneaker in wolf-gray suede with volt yellow laces, floating above a wet concrete pedestal, subtle rotation revealing the side panel, mist drifting through teal-to-amber rim light, dust particles catching the light, stable cinematic camera movement, premium commercial product-video finish",
      "image_url": "https://static.hiapi.ai/gallery/2026/07/c2e71481d2eb81a7.jpg",
      "duration": "6",
      "prompt_optimizer": true
    }
  }'
响应:
{"code":200,"data":{"taskId":"tk-hiapi-01KZ5FJV0TB8EYKDCV58FQ1F2X"},"message":"success"}
轮询直到解析完成:
curl https://api.hiapi.ai/v1/tasks/tk-hiapi-01KZ5FJV0TB8EYKDCV58FQ1F2X \
  -H "Authorization: Bearer $HIAPI_API_KEY"
{
  "status": "success",
  "output": [{"type": "video", "url": "https://temp.hiapi.ai/.../result.mp4", "expireAt": 1786421652}]
}
那个 output[0].url 是临时的——立即下载并转存到你自己的存储。不要热链它,也不要把它存到数据库字段里指望它是稳定 URL。
输入 schema(已对照线上 API 验证)
这个模型的 schema 比你从平台上其他视频模型带来的预期要窄得多——没有宽高比控制、没有分辨率层级、没有 seed。
| 字段 | 类型 | 约束 | 必填 |
|---|---|---|---|
prompt |
string | 描述运动/场景 | 是 |
image_url |
string | 单数——一个公开 URL,不是数组 | 是 |
duration |
string | 枚举 "6" 或 "10"——作为字符串,不是数字 |
是 |
prompt_optimizer |
boolean | 允许平台重写/增强你的提示词 | 否 |
如果你把其他模型的假设带过来,会有两个坑让你吃 400:
image_url是单数,不是image_urls。 hiapi 上其他几个 i2v 模型接收参考图数组;这个模型只接收一张。发数组你会得到缺字段错误,而不是有帮助的类型转换。duration必须是字符串"6"或"10",不是数字6。 发送数字6会返回duration: got number, want string。而且该两值枚举之外的任何值都不被接受——这个层级没有任意时长控制。
发送 aspect_ratio、resolution、seed 或 watermark——这些在兄弟模型上都是常见字段——会被直接拒绝并返回 additional properties ... not allowed。模型从输入图片继承宽高比,所以如果你需要 9:16 输出用于 Reels/TikTok,请在提交前把源静图裁剪或生成为 9:16(我们上面那张运动鞋静图正是这么做的)。
端到端 Python
import requests
import time

API_BASE = "https://api.hiapi.ai/v1/tasks"
API_KEY = "your-api-key"

def make_short_clip(prompt: str, image_url: str, out_path: str, duration: str = "6"):
    resp = requests.post(
        API_BASE,
        headers={"Authorization": f"Bearer {API_KEY}"},
        json={
            "model": "hailuo-2.3-fast/image-to-video",
            "input": {
                "prompt": prompt,
                "image_url": image_url,
                "duration": duration,  # must be a string: "6" or "10"
                "prompt_optimizer": True,
            },
        },
        timeout=60,
    )
    resp.raise_for_status()
    task_id = resp.json()["data"]["taskId"]

    while True:
        task = requests.get(f"{API_BASE}/{task_id}",
                             headers={"Authorization": f"Bearer {API_KEY}"},
                             timeout=30).json()["data"]
        if task["status"] == "success":
            break
        if task["status"] == "fail":
            raise RuntimeError(task.get("error"))
        time.sleep(8)

    video_url = task["output"][0]["url"]  # temporary link — download immediately
    video_bytes = requests.get(video_url, timeout=120).content
    with open(out_path, "wb") as f:
        f.write(video_bytes)
    return out_path
对于真正的批量运行——比如对同一张源静图测试 6 个提示词变体以挑选最流畅的运动效果——把这个函数包进对提示词列表的循环,并对每个 task_id 独立检查,而不是顺序阻塞;按每个片段约 80 秒计算,并行跑多个才是让 Fast 层级真正感觉快的原因。
常见问题
我能控制输出的宽高比吗?
不能——这个模型没有 aspect_ratio 字段,发送它会返回 400。输出跟随输入图片的宽高比,所以请在提交前按所需比例准备源静图(Reels/TikTok 用 9:16,信息流帖子用 1:1)。
为什么我的请求失败并提示 "got number, want string"?
你把 duration 作为 JSON 数字发送了。它必须是字符串 "6" 或 "10"——这是仅有的两个有效值。
这和 hailuo-2.3/image-to-video(非 Fast)是同一个模型吗? 不是——Fast 层级是 hiapi 上一个独立的、单独定价的模型,有自己的 schema,为速度与成本而非标准层级调优。如果你需要非批量参考走查,请参阅 完整集成教程。
我能喂给它生成的图片而不是真实照片吗? 可以——源静图可以来自 hiapi 上(或其他地方)的任何图像模型,只要是公开可访问的 URL 即可。使用你已为其他格式产出的静图(产品主视觉、海报)通常是最快获得短视频的方式,无需单独的创意流程。
定价会随分辨率变化吗? 这个模型没有分辨率参数,所以无论输入图片分辨率如何,定价都按时长一口价——撰写本文时为 6s $0.27,10s $0.46。请到 定价页 确认。
要点
- hailuo-2.3-fast/image-to-video 把一张静图变成 6s 或 10s 的 MP4,按视频一口价($0.27 / $0.46)而非按秒计费——便宜到可以每张源图跑多个提示词变体。
- schema 有意收窄:
prompt、image_url(单数)、duration(字符串枚举 "6"/"10"),以及可选的prompt_optimizer——没有宽高比、分辨率或 seed 控制。 - 输出继承输入图片的宽高比,所以请在提交前把源静图准备成 9:16(或你平台需要的任何比例)。
- 最常见的两个集成错误是把
image_url作为数组发送,以及把duration作为数字而不是字符串发送。 - 对于批量短视频工作流,按视频一口价和约 80 秒的周转时间使得生成多个尝试并挑选最佳运动效果变得可行,而不是每个素材只能提交一次生成。
准备在你自己的产品图上试试了吗?前往 hailuo-2.3-fast/image-to-video 模型页面 直接测试请求,或者如果你要先对比 Fast 层级与其他图生视频选项,请查看 完整模型目录。


