
使用指南
Ray 3.2 文本生成视频:竖屏短视频批量工作流
仅凭文本即可批量产出可供一周使用的 9:16 社交媒体创意——无需输入帧,无需准备素材
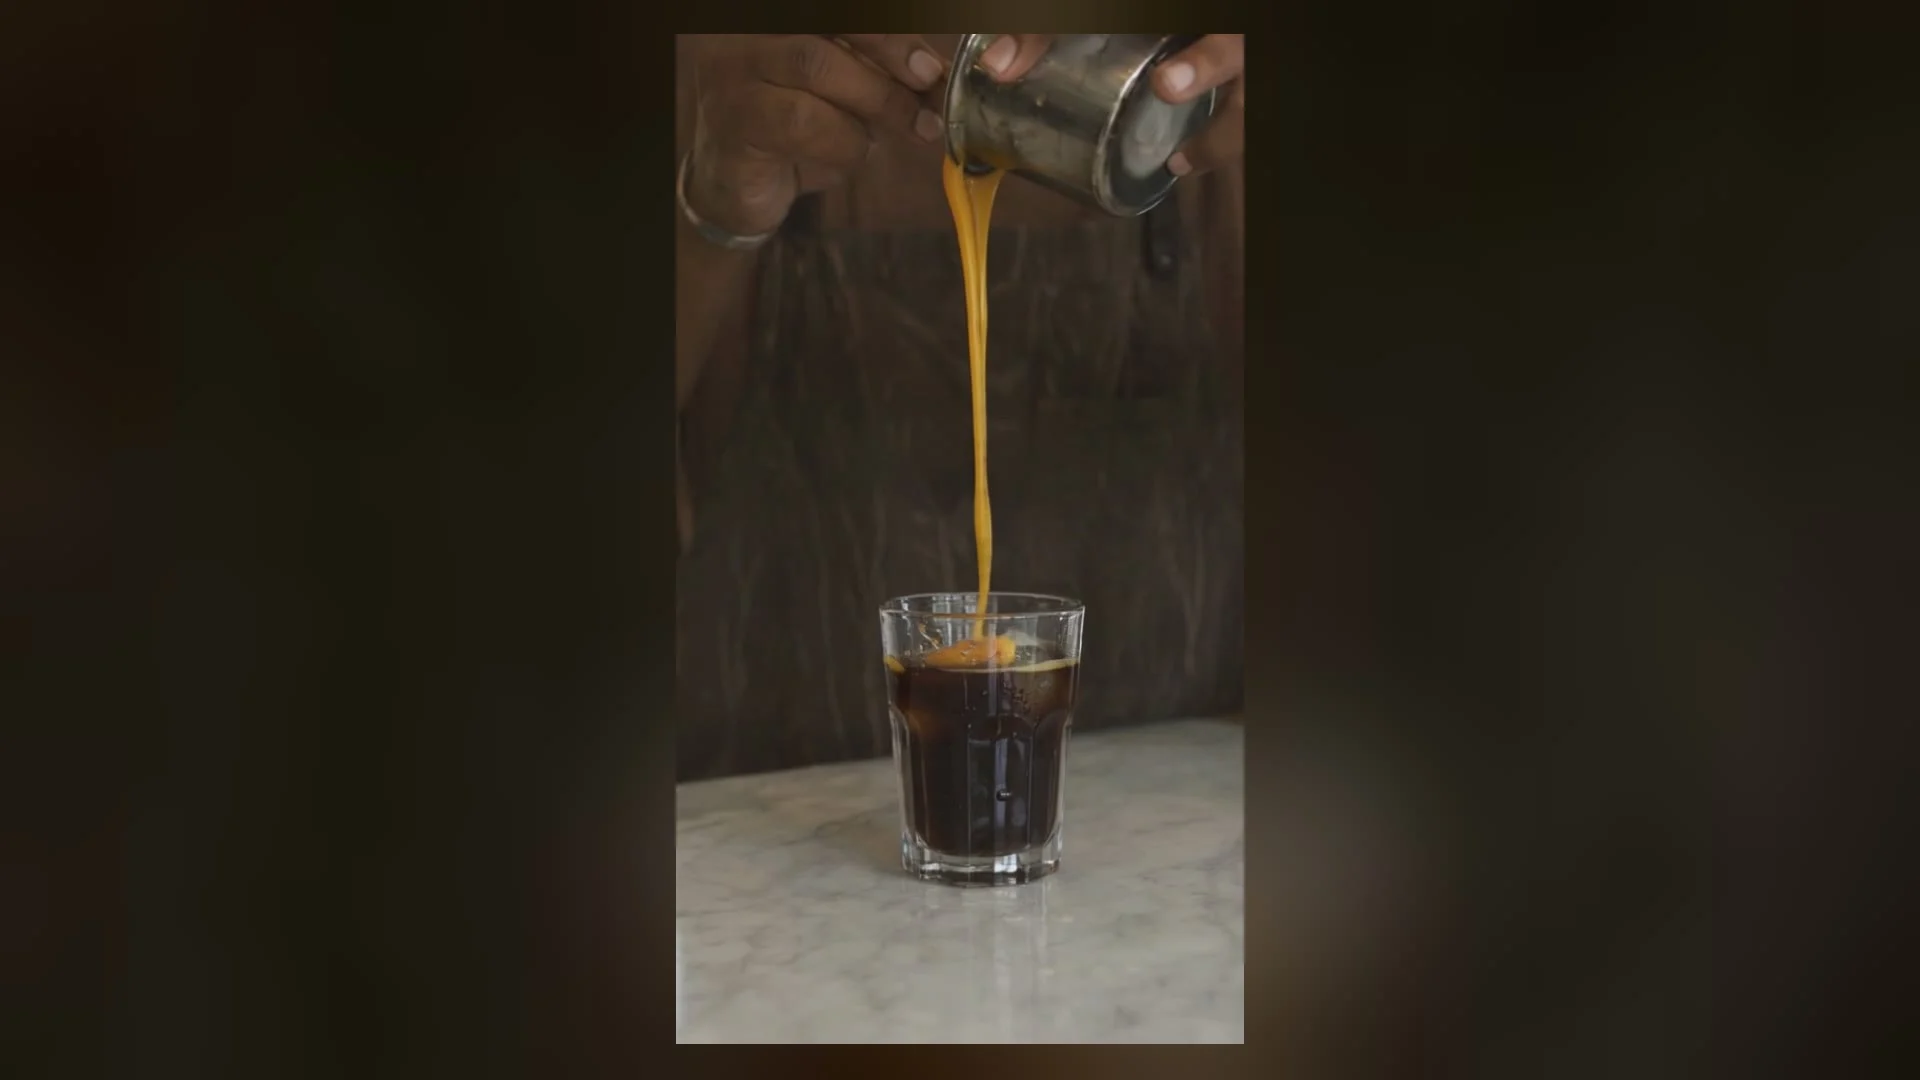
概要
- 这是什么:一套可重复的批量工作流,借助 hiapi API 上的 ray-3.2/text-to-video,把一行行文本转化为竖屏的 Reels/TikTok/Shorts 风格短片——无需输入图片,无需准备素材。
- 面向谁:需要产量的社交与内容团队——每周要产出若干全新的 9:16 创意用于测试,而非每月只做一支重点视频。
- 决定一切的核心事实:ray-3.2 t2v 仅按时长 × 分辨率计价。宽高比免费,因此 9:16 竖屏与 16:9 横屏价格完全相同。你唯一能控制产量的杠杆就是分辨率档位。
- 实证而非理论:下文每个短片都是为本文在单次批量任务中生成的——四个 5 秒 540p 9:16 短片,每条 $0.2145,总计 $0.858,每条在服务端渲染耗时 37–87 秒。
Ray 3.2(即 hiapi 所列的 Luma 文本生成视频模型)非常适合短视频,因为它能做到短视频真正需要的事:仅凭一句描述创造出一段全新的 5 秒镜头。无需提供帧,无需为产品照片制作动画,无需准备参考素材。你写一个钩子,就能得到一段短片。这使它在批量生成创意时成为正确的工具,也正因如此,这套工作流与针对其他模型的图生视频、参考生视频短视频指南看起来有所不同。
文本生成视频还是图生视频——先选对入口
两者都位于同一个异步任务 API 之下,但它们解决的是不同的问题:
- 文本生成视频(本页):仅从提示词出发。最适合全新的概念、氛围片段,以及你没有——或不想被束缚于——特定画面的 B-roll。模型可以自由地构图整个镜头,当你需要批量产出选项时,这正是你想要的。
- 图生视频:从你已有的首帧出发。如果你拥有一张重点产品照片,并想让那个物体动起来,请改用 ray-3.2/image-to-video——它会把画面锚定在你的帧上,并以此为基础制作动画。
经验法则:如果需求是“为这个活动给我三个全新的开场”,那就是文本生成视频。如果是“让这张确切的产品图动起来”,那就是图生视频。本文其余部分讨论的是第一种情况。
决定你整个工作流的定价事实
以下是 ray-3.2/text-to-video 完整、实时的价目表(已在撰写时对照 hiapi 定价核实——请始终在那里复查,而不是这里):
| 时长 | 分辨率 | 每条价格 |
|---|---|---|
| 5s | 540p | $0.2145 |
| 5s | 720p | $0.429 |
| 5s | 1080p | $1.7145 |
| 10s | 540p | $0.643 |
| 10s | 720p | $1.286 |
| 10s | 1080p | $5.143 |
注意表中没有出现的东西:宽高比。Ray 3.2 仅按时长和分辨率计费,因此9:16 竖屏与 16:9 横屏、1:1 或 21:9 价格相同。仅这一事实就重塑了你规划短视频批量的方式:
- 540p 是你的测试档位。每条 $0.2145,你可以用一条 1080p 重点视频的价格生成 10–15 个概念。竖屏社交信息流是在手机上以小尺寸观看的——540p(9:16 下输出为 540×960,详见下文)对于首轮 A/B 测试来说完全清晰可读。
- 720p / 1080p 是你的成品档位。一旦某个概念胜出,只需针对那个提示词重新生成 720p 或 1080p 版本,用于实际发布。
- 时长是固定档位,不是滑块。时长只有 5 秒或 10 秒两个固定选项——没有 7 秒选项——且 10 秒的成本约为 5 秒的 3 倍。对于钩子驱动的短视频,5 秒通常是你想要的单位,然后在剪辑中叠加多个。
这种“探索便宜、只为胜出者付费”的形态,正是这套工作流在 540p 下批量执行的全部原因。
一次请求,一个代码块
Ray 3.2 t2v 接受一小套封闭的输入字段:
| 字段 | 必填 | 取值 |
|---|---|---|
prompt |
是 | 你的场景描述 |
duration |
是 | 5 或 10(整数秒) |
resolution |
是 | 540p、720p 或 1080p |
aspect_ratio |
是 | 9:16、16:9、1:1、4:3、3:4、21:9 |
一条竖屏短片就是对异步任务端点的一次 POST:
curl -s https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ray-3.2/text-to-video",
    "input": {
      "prompt": "Vertical 9:16 first-person POV gliding down a neon night market alley...",
      "duration": 5,
      "resolution": "540p",
      "aspect_ratio": "9:16"
    }
  }'
响应会返回一个 data.taskId。然后你轮询 GET /v1/tasks/{taskId},直到 data.status 为 "success",并下载 output[0].url。这就是机制概要——完整的请求/响应演练、状态生命周期、Python 版本和错误处理,请参阅配套操作指南:Ray 3.2 文本生成视频 API:curl 与 Python 指南。初次接触任务 API?请从快速入门开始。
写出真正读起来像竖屏的提示词
5 秒且无输入帧,是一项紧凑的创作要求。以下四个习惯在这批任务中带来了显著差别:
- 在提示词中明确说出“vertical 9:16”(竖屏 9:16),并为高画幅构图——将单一主体居中堆叠,而非让裁剪与宽阔的横屏画面对抗。
- 把钩子花在第一秒。短视频成也第一帧、败也第一帧,因此要描述立刻动起来的东西(“the spiral catches the light in the first second”——螺旋在第一秒就捕捉到光线)。
- 点明镜头运动——推近、摇臂下移、缓慢环绕。Ray 3.2 对明确的运动方向响应良好,而运动正是让短片感觉像内容、而非幻灯片的关键。
- 一条短片只讲一个想法。五秒钟讲不了一个故事,但能落下一个节拍。只给它一个。
以下是本批次的四条提示词,每一条都是你确实会写进需求的不同短视频竖屏类型——餐饮、旅行 POV、电商产品和户外品牌氛围。每段短片都是模型原始输出,未经任何处理。
1 · 饮品 / 桌面(见上方封面短片)。食欲驱动的产品使用场景内容。提示词以倾倒和光线照射开头,让钩子落在第一帧:
Vertical 9:16 close-up: a barista's hands pour a slow spiral of golden honey
over a glass of iced coffee, condensation beading on the cup, morning light
raking across a marble counter, shallow depth of field, the honey spiral
catches the light in the first second — crisp appetizing tabletop commercial look
2 · 旅行 POV。没有人物出镜的第一人称能量——让信息流停下来的最快方式。“handheld bounce”(手持晃动)提示赋予了它 Vlog 的感觉:
Vertical 9:16 first-person POV gliding fast down a neon-lit night market alley,
steam rising from food stalls, string lights streaking into bokeh, the camera
pushes forward with a confident handheld bounce, vibrant saturated colors,
energetic short-form travel vlog feel
3 · 产品主角(电商)。干净的旋转展台镜头,带一个“揭示”节拍——适合新品发布或功能亮点的开场:
Vertical 9:16 product hero: a single pair of white running shoes rotates slowly
on a seamless gradient pedestal, a ribbon of fine sand swirls around them in slow
motion, soft studio key light with a crisp rim, clean minimalist e-commerce
aesthetic, the sand reveal lands on the opening beat
4 · 户外 / 品牌氛围。面向生活方式和旅行品牌的无人机俯冲——以“第一秒急速下压,然后缓入环绕”为方向,赋予它刻意的两段式运动:
Vertical 9:16 overhead drone shot snapping down toward a lone kayaker cutting a
clean V-wake across a glassy turquoise lake at sunrise, mist drifting off the
water, the camera descends fast in the first second then eases into a gentle
orbit, cinematic outdoor-brand mood
四条提示词,四个竖屏类型,一个模型,总计 $0.858。这就是一次批量。
无需全程盯着也能跑完批量
由于任务 API 是异步的,高效的范式是先扇形分发,再统一收集——不要生成一条、等待、再生成下一条。先一次性提交整批,让每条短片在上游并行渲染,拿到每个 taskId 的瞬间就保存,然后才开始轮询:
for each prompt:
    taskId = POST /v1/tasks  (model=ray-3.2/text-to-video, input=...)
    persist taskId to disk immediately   # it's billed at submit

for each saved taskId:
    poll GET /v1/tasks/{taskId} until status == "success"
    download output[0].url
这次运行教会(或再次确认)了两件值得内建到流程中的事:
- 轮询已保存的 taskId;绝不要重新提交。id 在你 POST 的瞬间就已计费,因此如果轮询因瞬时网络错误出错,捕获它并重试同一个 id——重新提交会让你被重复扣费。将 id 持久化到磁盘也意味着崩溃的运行可以通过轮询恢复,而非重新创建。
- 预计每条 540p 短片约 40–90 秒。在本批次中,四条短片在服务端分别在 37、38、70 和 87 秒完成。扇形分发意味着整套在约等于最慢一条的时间内完成,而不是它们的总和。
对于 540p 9:16 请求,你得到的是540×960、24fps、约 5.04 秒的 H.264 MP4——所以“540p”指的是短边,竖屏画面原生即为高画幅,你这边无需裁剪。
从原始短片到已发布的短视频
有两个需要提前规划的切实限制:
- 短片是无声的。Ray 3.2 t2v 只输出画面——没有音轨。这对短视频来说没问题:把短片导入你的剪辑软件,在那里加入热门音乐、旁白或字幕。要计划一次剪辑流程;不要期望 API 直接产出可发布的文件。
- 五秒是一个节拍,不是一支视频。可重复的做法是生成若干 5 秒短片(如上所述),然后将三到四条叠加成 15–20 秒的剪辑,并在节拍点硬切。每条短片是一个钩子;剪辑才是故事。
因此端到端循环是:以 540p 批量生成概念 → 选出胜出者 → 仅针对那个提示词重新生成 720p/1080p → 在剪辑软件中剪辑并配乐 → 发布。探索便宜,只为胜出者付费一次,最后手工完成。
常见问题
ray-3.2 文本生成视频会生成声音吗?不会——输出是无声 MP4。请在剪辑软件中添加音频。
我需要输入图片吗?不需要。这正是文本生成视频的意义:只用提示词。如果你想为已有帧制作动画,请使用 ray-3.2/image-to-video。
社交媒体应该用什么分辨率?540p 用于大批量概念测试(9:16 下为 540×960——手机上清晰可读),然后对你实际发布的短片使用 720p 或 1080p。
我能获得真正的竖屏而不裁剪吗?可以。传入 aspect_ratio: "9:16",模型会渲染原生高画幅(540p 下为 540×960)。宽高比不影响价格。
一条短片可以多长?5 秒或 10 秒——这是固定选项,不是连续范围。对于钩子驱动的短视频,每条 5 秒并在剪辑中叠加通常是更划算的花费。
这与操作指南有何不同?操作指南端到端覆盖单次请求(curl、Python、错误处理)。本页是其上的工作流:如何批量产出竖屏概念、在哪一步花哪一档分辨率,以及如何为 9:16 写提示词。
开始生成
Ray 3.2 文本生成视频现已在异步任务 API 上线。获取密钥,打开 ray-3.2/text-to-video 模型页查看完整参数参考和当前定价,并以 540p 批量生成你的第一组竖屏概念——你可以用不到一美元测试一周的短视频创意。在为同一任务比较模型?seedance-2.0-fast 和 Kling 3.0 图生视频的短视频工作流指南走的是同一循环,但取舍不同。


