
使用指南
使用 seedance-2.0-mini 制作短视频:端到端 hiapi API 工作流
TL;DR
- 这是什么:一套在 hiapi API 上用 seedance-2.0-mini 制作 TikTok/Reels 风格竖屏短片的端到端工作流——从第一次 curl 调用,到批量渲染一整周内容的脚本。本页演示片段正是用文中展示的原样请求生成的。
- 为什么短视频选这个模型:原生支持
9:16,内置同步音频(无需单独音效处理),时长可在 4–15 秒间灵活选择,480p 草稿仅需 每秒 $0.0272——一段 4 秒竖屏草稿约 $0.11(价格)。 - 已核实的 API 事实:
prompt、duration(4–15 的整数)和resolution(480p|720p)为必填项;aspect_ratio接受1:1、4:3、3:4、16:9、9:16、21:9、adaptive。图生视频使用first_frame_url/last_frame_url。模式严格——像seed这样的未知字段会以 400 拒绝。 - 工作流:在 480p 下生成以迭代提示词,将保留的片段重渲为 720p,并批量并行提交任务——异步的
/v1/tasks队列会替你完成扇出。
为什么 seedance-2.0-mini 适合短视频循环
短视频制作是量化工作:你草拟许多片段,保留少数,每日发布。该工作流需要视频 API 做到三件事——低成本迭代、竖屏输出和声音——seedance-2.0-mini 恰好三项全满足:
- 单次草稿成本低到足以反复迭代。在 480p 下,模型按每输出秒 $0.0272 计费,因此 4 秒草稿约 $0.11,即便完整 15 秒片段也仅约 $0.41。720p 档为 $0.0586/秒。(价格已对照实时价格页核实;视频按秒计费,因此
duration是你的成本杠杆。) - 原生 9:16。直接渲染竖屏,而非裁切横屏片段并丢失构图。
- 原生同步音频。输出的 MP4 自带随场景生成的 AAC 音轨——环境声、拟音、房间底噪。对于自动带声播放的信息流内容,这省去了一整个剪辑步骤。
若你想要更大的同级模型用于主视觉内容,同样工作流适用于 seedance-2-0——只是价格档不同。
设置
你只需一个 hiapi API 密钥,别无他物——无需 SDK。将密钥保存在环境变量中:
export HIAPI_API_KEY="sk-..."
hiapi 上所有视频模型均通过统一的异步任务端点运行:POST https://api.hiapi.ai/v1/tasks 立即返回 taskId,然后轮询 GET /v1/tasks/{taskId} 直至完成。详情见文档。
你的第一段竖屏片段(T2V)
最小有效请求需要 prompt、duration 和 resolution。为短视频添加 aspect_ratio: "9:16":
curl -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "seedance-2.0-mini",
    "input": {
      "prompt": "竖屏短视频。阳光洒落的咖啡馆吧台上,一杯新鲜抹茶拿铁被缓缓倒入透明玻璃杯中,绿色旋涡在牛奶间绽放,柔和的窗光,浅景深。原生音频:轻柔的咖啡馆环境声、液体倾倒声。清脆、诱人、照片级真实。",
      "duration": 4,
      "resolution": "480p",
      "aspect_ratio": "9:16"
    }
  }'
响应即时返回:
{"code": 200, "data": {"taskId": "tk-hiapi-01KWTTFDPHSDWZ0FP1QAS5J79Q"}, "message": "success"}
轮询任务直至 status 为 success,然后立即下载 output[0].url——输出 URL 是临时的且会过期。以下正是该请求生成的实际片段(4 秒、480p、9:16,带原生倾倒与环境音频——取消静音即可聆听):
本次渲染有两点实用提示:“480p”竖屏输出实测为 496×864 像素,音频作为标准 AAC 音轨进入 MP4——无需单独文件合成。
输入模式,已对照实时 API 核实
模式是严格的。以下是真实验证响应,逐字复现,便于你在日志中识别:
| 字段 | 类型 | 必填 | 取值 |
|---|---|---|---|
prompt |
string | ✅(最小长度 3) | 你的镜头描述 |
duration |
integer | ✅ | 4–15(秒) |
resolution |
string | ✅ | 480p、720p |
aspect_ratio |
string | 可选 | 1:1、4:3、3:4、16:9、9:16、21:9、adaptive |
first_frame_url |
string | 可选 | I2V 起始帧的图像 URL |
last_frame_url |
string | 可选 | 用于结束帧控制的图像 URL |
image_input |
array | 可选 | 多模态图像参考 |
reference_video_urls |
array | 可选 | 风格/运动参考视频(更低的每秒费率) |
省略必填字段,任务会在创建前被拒绝(不收费):
{"code": 400, "error_code": "INVALID_REQUEST", "message": "invalid input: resolution: missing required field \"resolution\"; duration: missing required field \"duration\""}
越界取值会指明确切边界——duration: maximum: got 16, want 15——未知字段会被拒绝而非忽略:
{"code": 400, "error_code": "INVALID_REQUEST", "message": "invalid input: <root>: additional properties 'seed' not allowed"}
最后这一行为值得内化:若你从其他模型沿用请求结构(一个 seed、一个 size、一个 audio 标志),seedance-2.0-mini 会返回 400,而非静默丢弃该字段。
可复用的 Python 函数
生产所需一切约 40 行——提交、轮询、下载:
import os, time, requests

API = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

def submit(prompt: str, duration: int = 4, resolution: str = "480p",
           aspect_ratio: str = "9:16", **extra) -> str:
    r = requests.post(API, headers=HEADERS, json={
        "model": "seedance-2.0-mini",
        "input": {"prompt": prompt, "duration": duration,
                  "resolution": resolution, "aspect_ratio": aspect_ratio, **extra},
    }, timeout=60)
    data = r.json()
    task_id = (data.get("data") or {}).get("taskId")
    if not task_id:
        raise RuntimeError(f"submit failed: {data}")
    return task_id

def wait(task_id: str, timeout_s: int = 900) -> dict:
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        task = requests.get(f"{API}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
        if task["status"] == "success":
            return task
        if task["status"] == "fail":
            raise RuntimeError(f"task failed: {task.get('error')}")
        time.sleep(8)
    raise TimeoutError(task_id)

def make_clip(prompt: str, out_path: str, **kw):
    task = wait(submit(prompt, **kw))
    url = task["output"][0]["url"]          # 临时 URL——请立即下载
    with open(out_path, "wb") as f:
        f.write(requests.get(url, timeout=120).content)
一段 4 秒 480p 片段通常几分钟内完成;高峰时段请预留至多约 10 分钟再判定超时。
图生视频:锁定首帧
对于产品导向的短片,提示词漂移是敌人——你想要你的产品入画,而非模型对它的想象。解决办法是用 first_frame_url 进行 I2V:生成(或拍摄)一张静帧,再将其动画化。像这样的竖屏参考静帧,通过同一 /v1/tasks 端点用 gpt-image-2 制作,很适合作为起始帧:
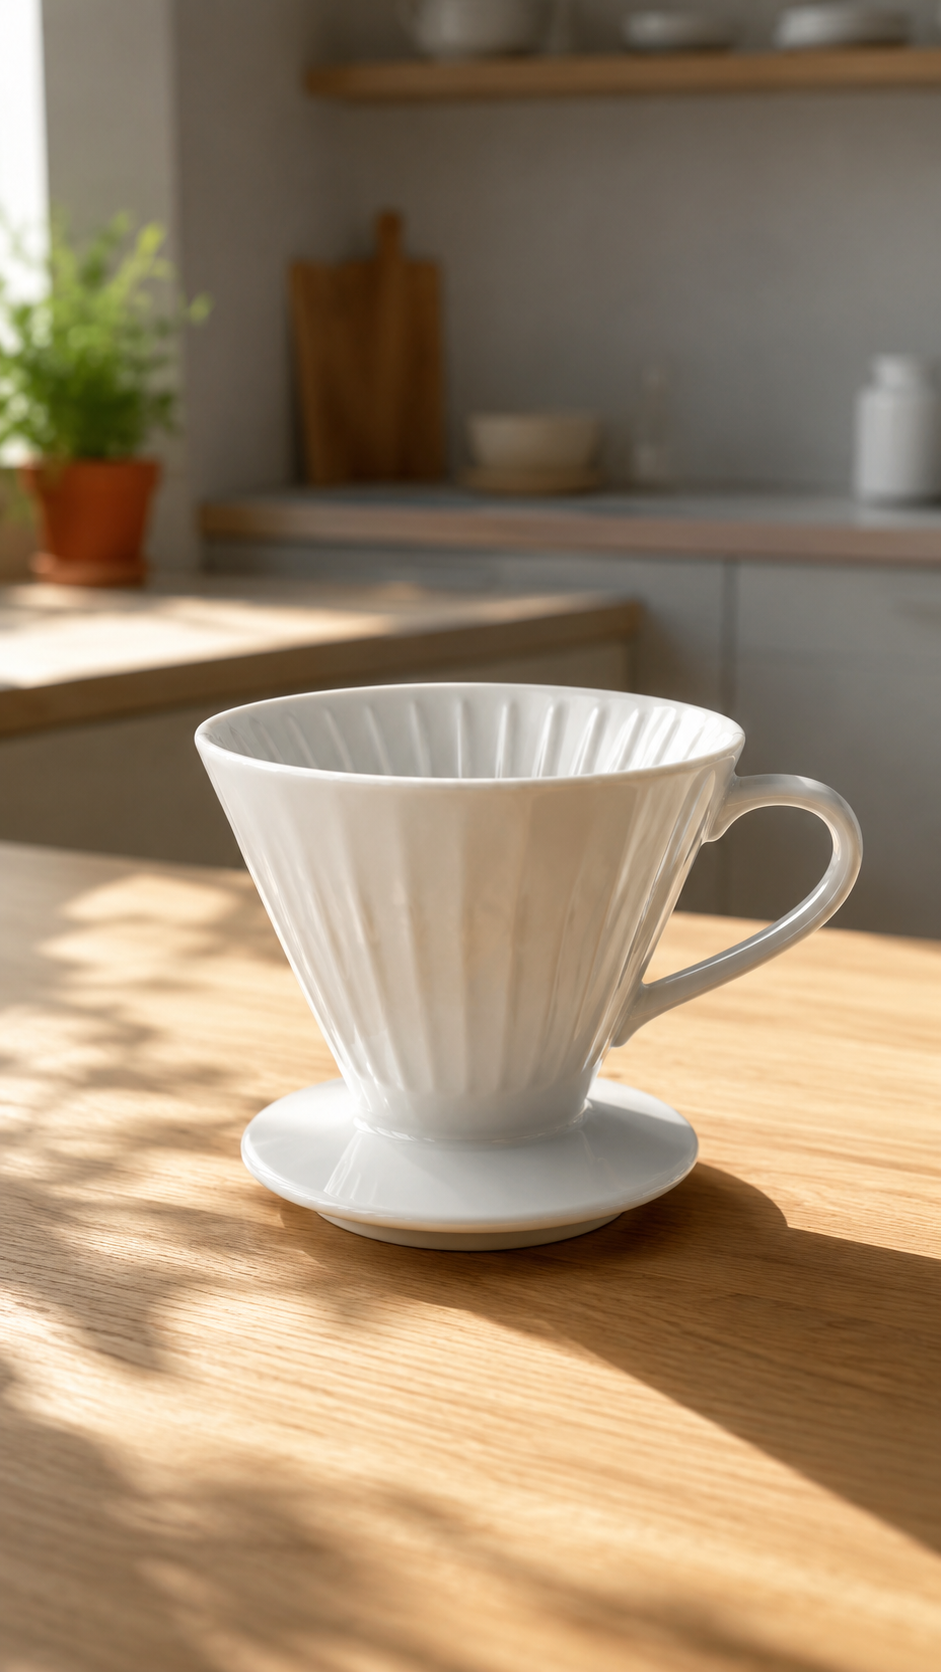
请求只需增加一个字段:
task_id = submit(
    "热水从上方缓缓绕圈注入,手冲滤杯开始升起蒸汽,"
    "水滴落入下方的玻璃分享壶,阳光映照蒸汽。缓慢轻柔地推进。"
    "原生音频:轻柔的水流声,安静的清晨房间底噪。",
    duration=4, resolution="480p", aspect_ratio="9:16",
    first_frame_url="https://your-cdn.example/pourover-ref.jpg",
)
以下是首帧动画的实际效果——来自我们 seedance-2.0-mini 配方库的一张静帧及其生成的片段,同一模型和请求结构(本例为 16:9):
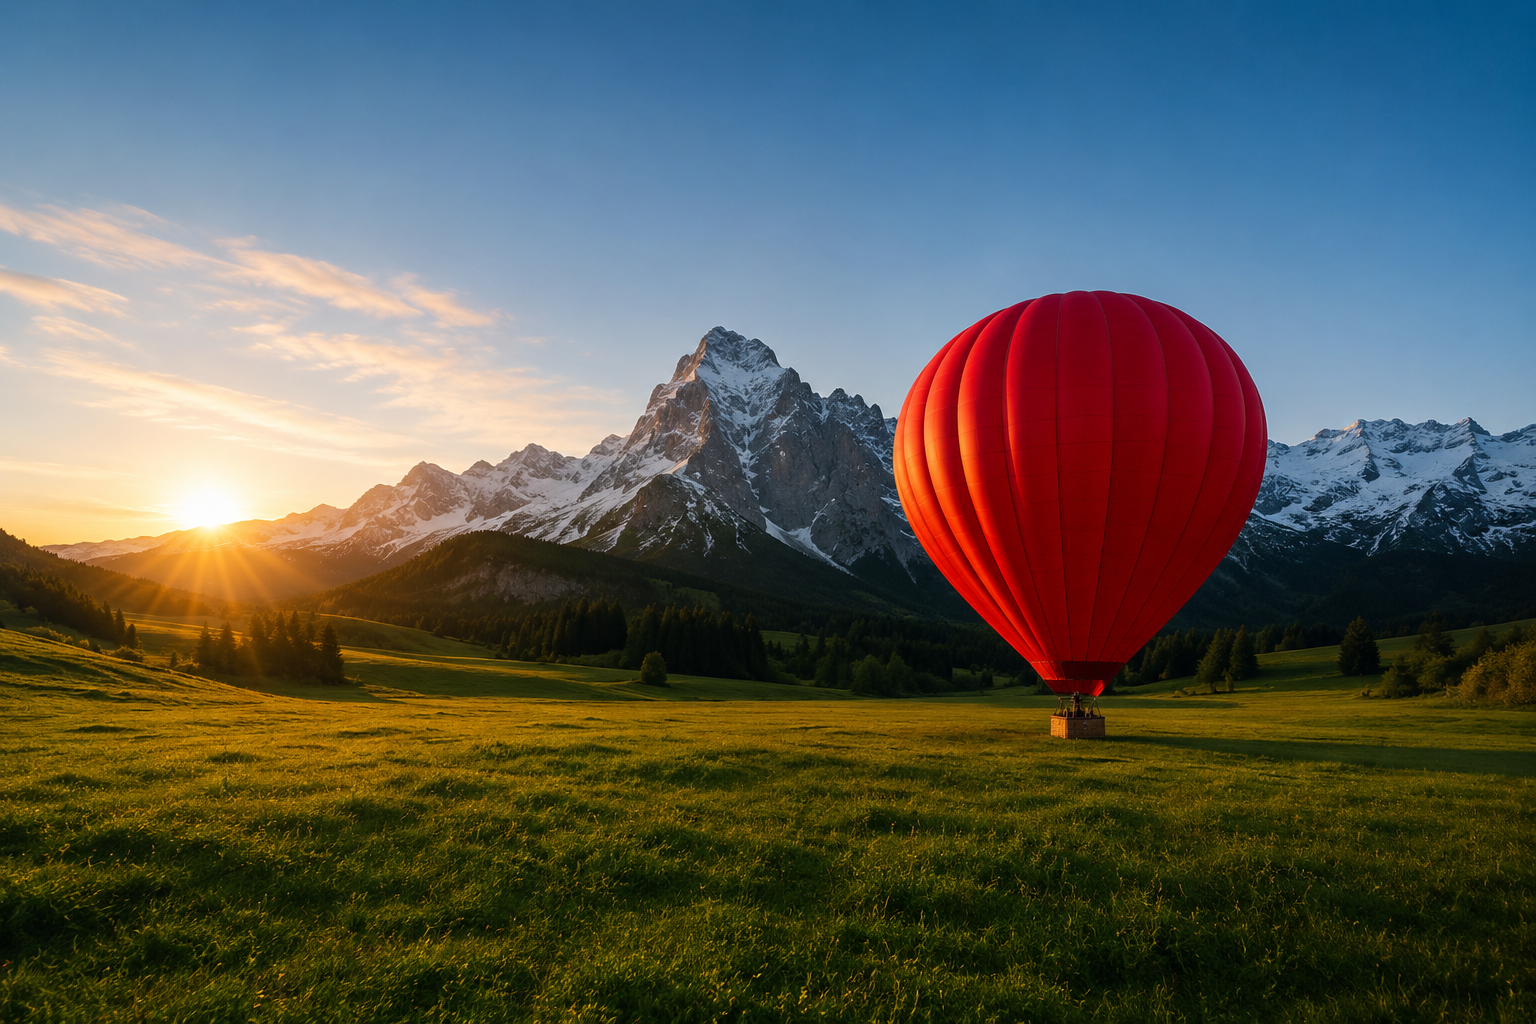
构图、色调和主体锁定在你的静帧上;提示词只需描述运动。若需要片段落在特定结束帧,还有 last_frame_url——适用于切回产品卡片的循环。
批量制作一周内容
由于 /v1/tasks 是异步的,批量制作就是:提交所有任务,然后轮询。无需客户端队列。
briefs = [
    ("mon-hook",  "竖屏片段。浓缩咖啡缓慢萃取,……"),
    ("tue-loop",  "竖屏无缝循环片段。热气从杯中卷起,……"),
    ("wed-recipe","竖屏片段。俯拍手冲冲泡序列,……"),
    # ……每个发布日一条
]

tasks = {name: submit(p, duration=6) for name, p in briefs}   # 扇出
for name, tid in tasks.items():                                 # 收集
    make = wait(tid)
    url = make["output"][0]["url"]
    open(f"{name}.mp4", "wb").write(requests.get(url, timeout=120).content)
成本计算保持可预测,因为按输出秒计费:
| 方案 | 规格 | 成本 |
|---|---|---|
| 1 次草稿迭代 | 4 秒 · 480p | 约 $0.11 |
| 1 条可直接发布片段 | 6 秒 · 480p | 约 $0.16 |
| 7 条片段(一周,每日一条) | 7 × 6 秒 · 480p | 约 $1.14 |
| 主视觉重渲 | 6 秒 · 720p | 约 $0.35 |
一个行之有效的工作流:每个创意先以 480p 草拟,保留胜出者,仅将其重渲为 720p。更多杠杆(分辨率档位、时长裁剪、批量调度),请参见我们的控制 AI 图像和视频 API 成本指南。
面向信息流的提示词技巧
在我们测试渲染中有效的做法,专为短视频调优:
- 写明“竖屏”并为其构图。以“竖屏短视频。”开头加上
aspect_ratio: "9:16",让主体居中于高画幅,而非框取会被裁切的横屏场景。 - 把钩子放在第一秒。信息流在第一秒就做决定——让最初的动作即是回报(倾倒已在进行、热气已在升腾),而非缓慢的建立镜头。
- 编写音频脚本。一句“原生音频:……”列出 2–3 个具体声音(液体倾倒、咖啡馆环境声)能可靠地塑造音轨。不提示,你只会得到通用房间底噪。
- 对可循环片段,最小化首尾变化。飘移粒子、脉动光晕、卷曲热气——描述稳态运动,首尾帧就会足够接近以循环。
总结
用 seedance-2.0-mini 制作短视频归结为一个异步端点、三个必填字段,以及让迭代廉价的按秒计费:以 480p 草拟竖屏片段每条约两毛五,用 first_frame_url 锁定产品镜头,批量提交你的发布日历,并将保留者重渲为 720p。获取 API 密钥,然后从上面的 4 秒 curl 请求开始——seedance-2.0-mini 模型页有参数参考和实时价格,可从此继续。


