
HeyGen
 HeyGen
 Avatar IV
heygen-avatar-iv
上传单张照片加脚本即可生成带口型同步、面部表情与手势的说话头像视频,支持 1280p+ 输出,适合数字发言人与口播内容
试用 heygen-avatar-iv
输入
作品灵感
查看全部作品输出
videoHeyGen Avatar IV 文生视频能力图解
风格 口播 · 讲解说明 · Avatar Video
参考输入
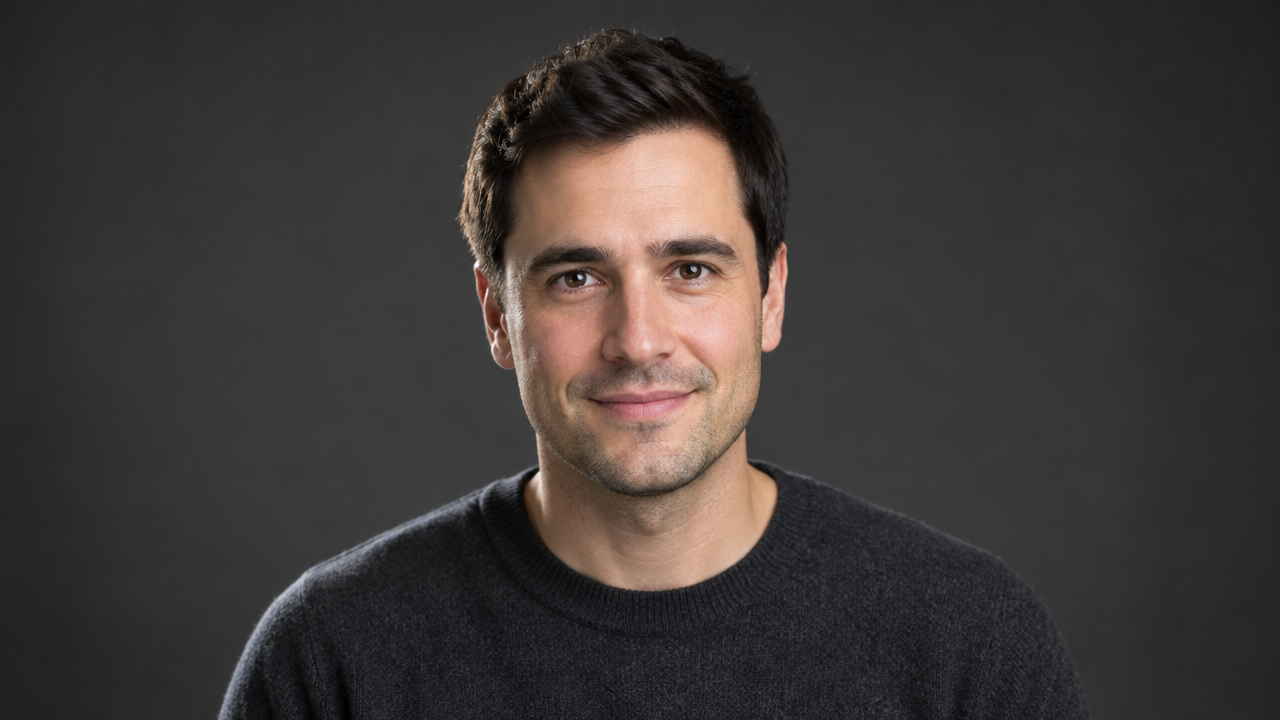
人像照片
提示词
一位主讲人在简洁的演播室布景中直接面对镜头讲话:头肩构图,正面朝向,目光稳定接触镜头,轻微头部动作与自然手势配合说话节奏;左前方柔和主光配以轻柔补光,中性深灰色无缝背景,浅景深,1080p 16:9 宽屏构图,写实的企业讲解风格,节奏沉稳自信。
复制完整提示词,改成你自己的生成任务。
标签
HeyGen Avatar IV 提示词公式卡片:结构化写法视觉指南
风格 讲解说明 · Prompt Engineering · talking avatar
参考输入
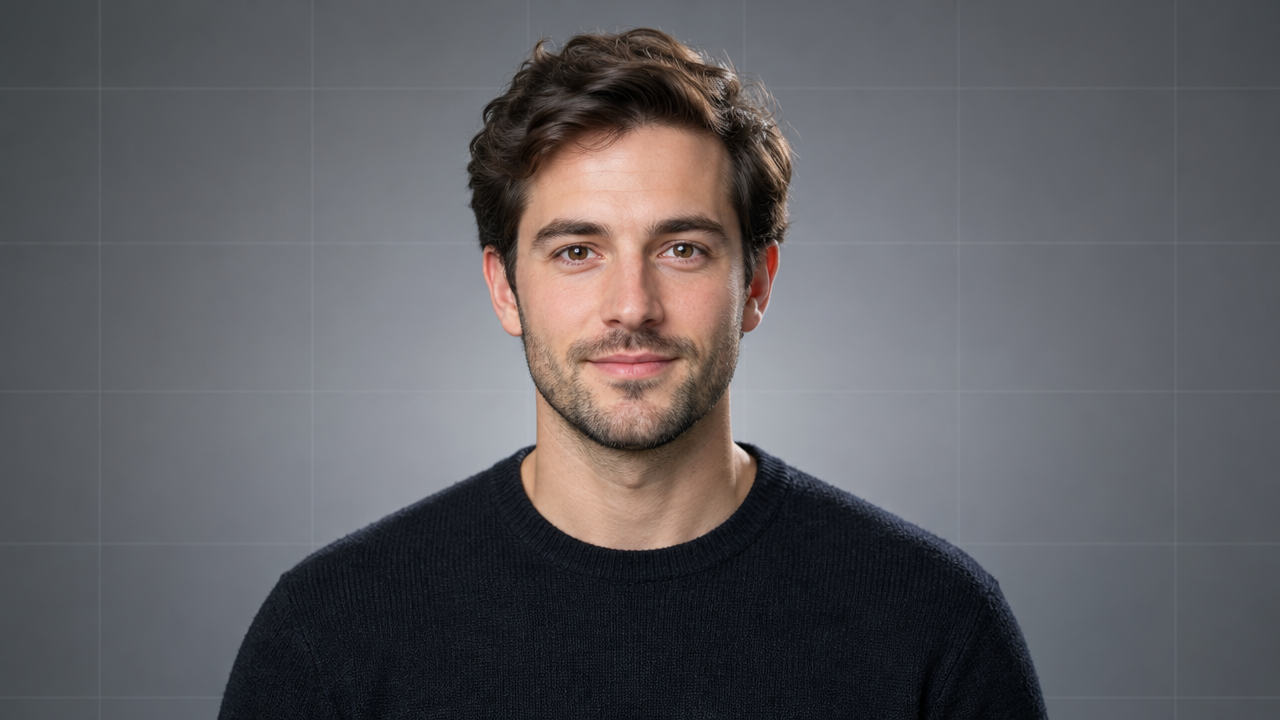
人像照片
提示词
一位正面出镜的主持人在整洁的演播室布景中直接对镜头讲话,举起一张打印好的提示词公式索引卡;中近景,缓慢细微的推镜与轻柔的手持漂移,柔和的主光配合轮廓分离光,浅景深使卡片边缘保持清晰可读、面部依然锐利;节奏沉稳、具教学感,在每个段落配合小幅自然的手势指向卡片,背景为柔和的中性渐变,带有淡淡的网格线,暗示文档排版布局;画面清晰、高细节,1080p 质感。
复制完整提示词,改成你自己的生成任务。
标签
运镜语言视觉笔记:Avatar IV 口播演示
风格 camera-language · talking avatar · 讲解说明
参考输入
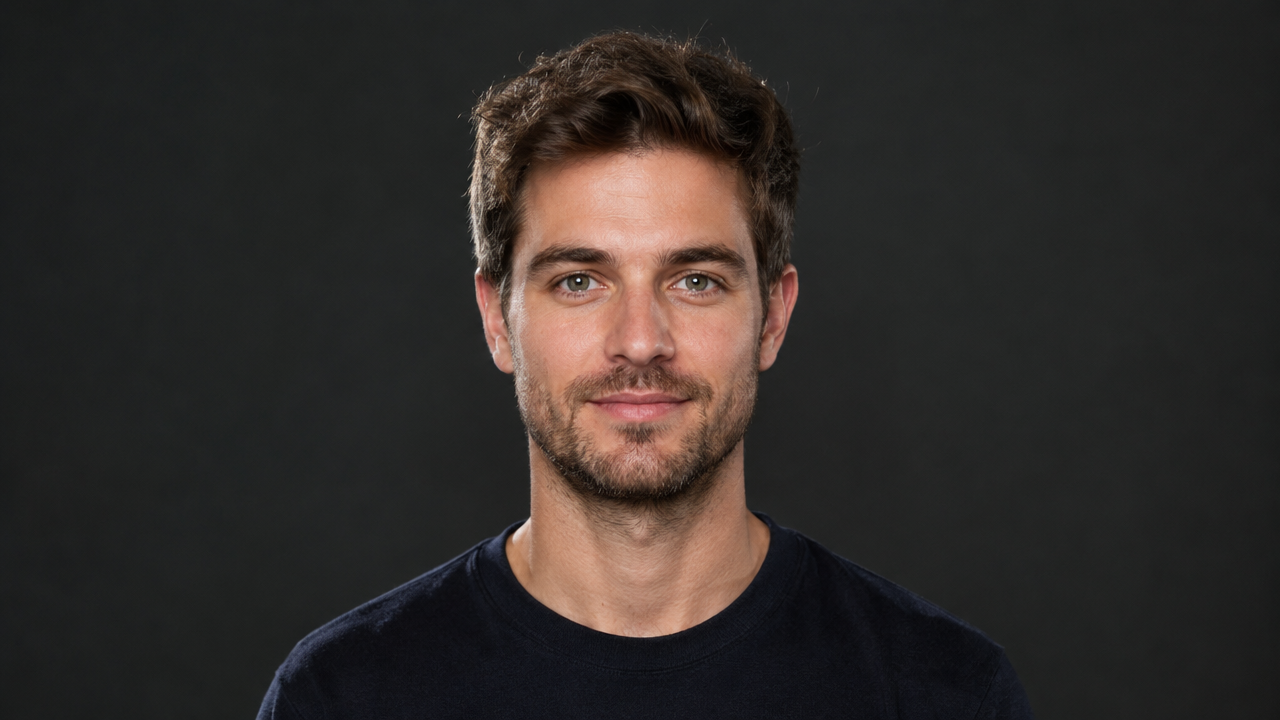
人像照片
提示词
一位正面朝向镜头的出镜人用平静、讲解式的语气直接对镜头说话,仿佛在镜头前为一份关于运镜的视觉笔记作注解。目光稳定地注视镜头,头部有轻微自然的动作,偶尔做出解释性的手势,示意横摇、推近和俯仰。中性的、光线均匀的棚拍构图,背景为暗色低饱和度,整体带有屏幕录制的氛围,节奏沉稳,在每个运镜术语之间留有短暂停顿。
复制完整提示词,改成你自己的生成任务。
标签
HeyGen Avatar IV 分镜概念:从文字到说话画面
风格 talking avatar · Storyboard · 叙事
参考输入
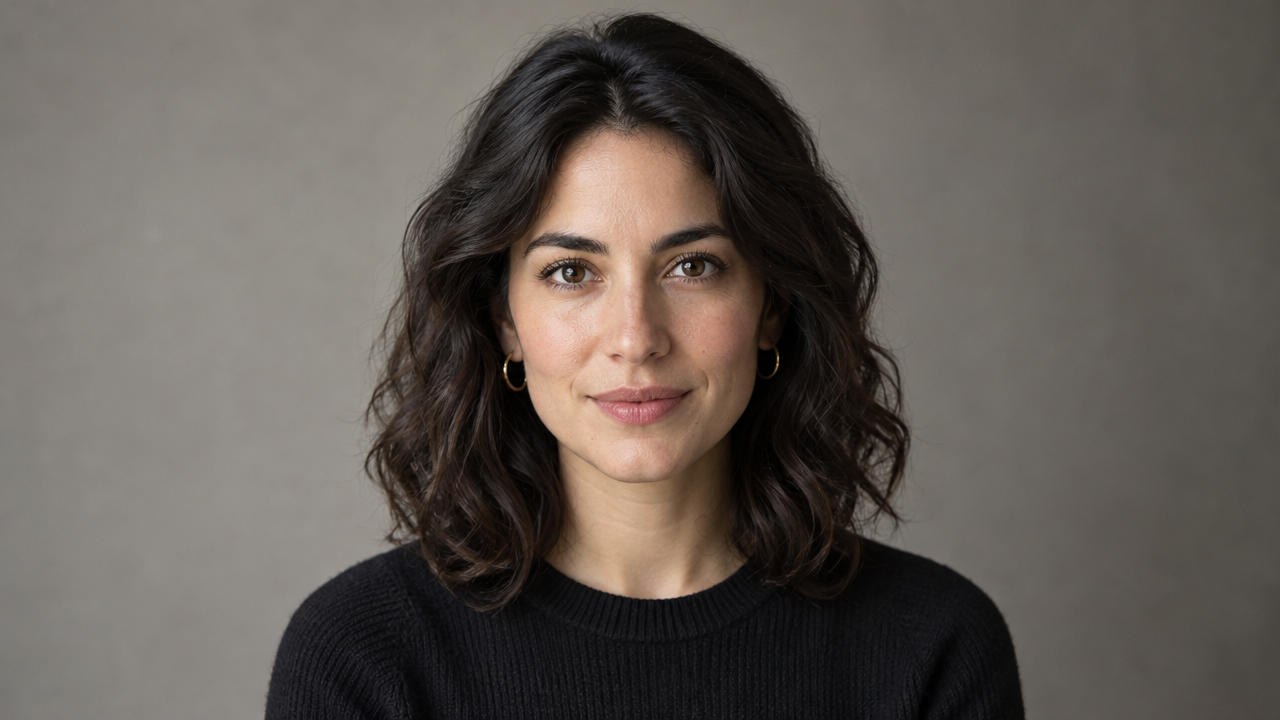
人像照片
提示词
一张正面单人肖像被制作成说话视频:人物以自然的口型同步讲述一段简短的分镜旁白,伴有轻微头部动作和富有表现力的手势,采用 16:9 画幅与干净的中性背景,稳定的中近景,柔和主光,节奏沉稳自信。
复制完整提示词,改成你自己的生成任务。
标签
价格
heygen-avatar-iv 每秒
| 单价 | $0.150 |
|---|
定位简介
heygen-avatar-iv 是 HeyGen 提供的说话头像视频模型,通过 HiAPI.ai 统一接口调用。开发者上传一张正面人脸照片,再给出一段脚本文本或一段音频,即可生成带口型同步、面部表情与手势的说话视频。支持 720p 与 1080p 输出及多种画幅比例,适合需要快速产出数字发言人或角色口播素材的开发者与内容团队。
核心亮点
- 单张照片驱动整段说话视频——只需一张正脸照片配合脚本或音频,无需拍摄或构建三维资产即可得到成片。
- 表情与手势随语音联动——输出不止于唇形对齐,面部表情与头部动作随语音自然变化,接近真人口播观感。
- 脚本文本与音频双输入——可直接填写脚本并选择音色,也可传入 HTTPS 音频做唇形同步,适配已有配音流程。
- 画幅与背景可配置——提供 16:9、9:16、1:1 等多种比例,并可指定纯色或图片背景填充画面。
能力说明
照片生成说话视频:传入一张正面人脸照片即可生成说话视频,输出为视频文件,可直接用于成片或后续剪辑。
脚本转语音并驱动口型:填写脚本文本并指定内置音色,由模型合成语音并驱动头像说话,单段脚本最长 5000 字符。
音频唇形同步:传入 HTTPS 音频链接即可让照片按音频口型说话,单段音频最长 600 秒,此时脚本与音色参数不生效。
输出规格控制:可选 720p 或 1080p 分辨率,并设置 16:9、9:16、4:5、5:4、1:1 或跟随原图的比例,适配横屏、竖屏与方形发布位。
画面背景填充:当输出比例与照片比例不一致时,可用纯色或图片背景填充留白区域,避免画面出现空边。
适用场景
- 营销团队制作数字发言人视频——用产品脚本配合品牌人物照片生成口播视频,用于官网、广告位与社媒投放,无需真人出镜排期。
- 培训部门生成讲解课程素材——将课程讲义写成脚本,批量生成统一形象的讲解视频,嵌入学习平台或课件。
- 短视频创作者产出竖屏口播——选择 9:16 画幅与选定音色生成竖屏口播素材,直接用于短视频平台内容更新。
- 已有配音的多语言内容适配——将已有配音音频传入做唇形同步,配合照片生成对应语言的口播画面,用于内容本地化。
限制与选型建议
输入照片必须是清晰、正面的人脸,侧脸、遮挡或多人合影会明显影响效果,生成质量对源图依赖较大。输出为视频而非纯文本成片,需要事先准备脚本或音频。单段音频上限 600 秒、脚本上限 5000 字符,超长内容需分段生成。若只需要预置形象头像或真人数字分身,应选择对应的其他模型线路。
近期更新
查看更新日志 →- 模型上新 新增模型:heygen-avatar-iv,上传一张人像照片,即可用台词与预置声音或驱动音频生成口型同步的说话视频;提供…
常见问题
查看全部常见问题 →-
HeyGen Avatar IV 需要哪些输入?
一张人像照片,再选一种驱动方式:输入台词并选择声音,或上传一段音频。用台词时不选声音,会使用默认声音 Warm Pro Narrator。
-
什么样的照片效果最好?
正脸、五官清晰无遮挡、光线均匀、嘴巴自然闭合的单人照片效果最稳。侧脸、戴口罩、多人合照或面部很小的照片不适合。
-
输出视频有多长?
不需要传时长。台词配音时长度由台词和语速决定;音频驱动时与上传的音频长度一致,音频最长 600 秒。
-
支持哪些画幅和分辨率?
画幅支持 16:9、9:16、4:5、5:4、1:1 和 auto(沿用照片比例);分辨率支持 720p 和 1080p。
提交生成任务
https://api.hiapi.ai/v1/tasks 请求头
Authorizationstring必填账号 API Key,所有请求必填。示例:Bearer YOUR_HIAPI_API_KEY。获取 API Key
Content-Typestring可选请求体固定按 JSON 解析;如携带,仅接受 application/json(可带 charset),其他取值返回 415。示例:application/json。
Idempotency-Keystring可选幂等键,最长 255 字节。同账户同键的重试只创建一次任务,重放返回首次 taskId。
网络超时或客户端自动重试时,同键只创建一次任务、不会重复扣费(幂等范围 = API Key 所属账户)。建议用业务侧唯一标识做键(如 "order-42");同键重放返回首次 taskId,键在首次提交 24 小时后过期。详细的场景矩阵见统一异步接口介绍页。
请求体
modelstring必填当前固定值:heygen-avatar-iv
routestring可选当前固定值:default
inputobject必填
heygen-avatar-iv 和线路 default 的业务参数对象,见下方参数表。
voicestring可选默认值: "Warm Pro Narrator"minLength 1指定数字人朗读脚本所用的音色,默认 Warm Pro Narrator;当提供 audio_url 时该参数被忽略。
Warm Pro NarratorChill BrianIvyJohn DoeMonika SogamHope Archer Brittney显示全部(94 项)
PatrickDavid CastlemoreMichael CAdam Stone JuniperCassidy Jessica Anne BogartArabellaAndrewSpuds Oxley Grace ElderHelenCanyon RiversDerya - Lifelike - ExcitedMellow MarcusJack Sterling - BroadcasterBrenda - UGC - 1.mp4ReidReaganTerryJennyRadio RickDeniseTim in car - ExcitedIskanderThompsonDelicate Daisy - ExcitedKingstonGeorge UGC 1Bold BlakeJaneExpressive EvanMarianne - IAAaronModern Recipe Host - Voice 1WillowCute Chloe - FriendlyRafaelJune - LifelikeCrisp ChloeSlick SimonNassim - InformativeBaritone BenMaxwellEllie Faye - ExcitedMilaniFeisty Fiona - ExcitedProfessor DeanRose - UGC - 1.mp4ShonaHudson WilderAnn - IAAlastair KensingtonOxleyChristinaAndrew Rizz PeytonGerardo - OutdoorChloe - LifelikeStephanieAnthony - IASignal - Voice 1LucaLisa - Voice 1T.W.TuckerJack Sullivan - SeriousWinterMireia - LifelikeGeorgiaStellaMasha - LifelikeCharming Charles - FriendlySerenityAnnie - ExcitedRalphBethanyDominicMason FinnLeenaVeteran VictorTamaraNik PublicCalm ChloeSevikReillyRaulImposing IanRelaxed RayDexter - ProfessionalRelaxed RickEdwinRupert BlackwoodGinnyHopepromptstring可选minLength 1maxLength 5000数字人将要朗读的脚本文本;当未提供 audio_url 时必填。
audio_urlstring可选pattern ^https://用于唇形同步的 HTTPS 音频地址,时长最长 600 秒;提供后 prompt 与 voice 均被忽略。
image_urlstring必填pattern ^https://待驱动动画的照片 HTTPS 地址,须包含一张清晰、正面的单张人脸,支持 jpg、jpeg、png、webp、gif、avif、heic、heif 格式。
backgroundobject可选
当输出宽高比与原始照片不一致时,用于填充画面中未被人像覆盖区域的背景设置,可通过颜色或图片指定,默认为白色。
typestring必填背景的填充方式,决定 value 字段按颜色还是图片 URL 解释。
colorimagevaluestring必填minLength 1背景的具体取值:按 type 为颜色时传 #RRGGBB 十六进制色值,为图片时传 HTTPS 图片地址。
resolutionstring可选默认值: "720p"输出视频的分辨率,默认 720p。
720p1080paspect_ratiostring可选默认值: "16:9"输出视频的宽高比,默认 16:9;取 auto 时优先保持源照片比例,无法读取时回退为 16:9。
16:99:164:55:41:1autocallbackobject可选
终态通知配置;为空则不回调,由调用方自行查询。详见下方回调说明。
创建任务时提供 callback.url,任务终态时 HiAPI 主动 POST 通知你的服务,可免去轮询。回调请求体与任务详情数据结构同构;签名校验、投递重试与幂等说明见统一异步接口介绍页的回调说明。
urlstring必填callback 存在时必填;任务终态后向该 URL 发起 POST,须为合法 http(s) URL。
whenstring可选默认值: "final"当前仅支持 final,即 success / fail 均回调。
finalstoragestring可选默认值: "temp"产物存储档位:temp(默认,保留约 7 天)或 persistent(长期保存,按大小计费)。余额不足或超出存储上限会静默降级为 temp;实际生效档位见任务详情响应。
temppersistent请求示例
# 提交异步任务,成功立即返回 taskId(不等待生成完成)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "heygen-avatar-iv",
  "input": {
    "voice": "Warm Pro Narrator",
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "16:9"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "heygen-avatar-iv",
input: {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "heygen-avatar-iv",
"input": {
"voice": "Warm Pro Narrator",
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "16:9"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
获取任务详情
https://api.hiapi.ai/v1/tasks/:id 响应字段
taskIdstring必填任务 ID,前缀固定 tk-hiapi-。
modelstring必填解析后的模型全名。用 route 参数提交的任务返回 base@线路(如 gpt-image-2/text-to-image@ext);否则与创建时传入的模型名一致。
routestring可选仅当任务用显式 route 参数提交时出现,回显提交时的原值。
statusstring必填任务状态。
queued 已入队,尚未开始。
handling 处理中。
archiving 处理完成,产物准备中。
success 终态:完成,产物可用(返回 output)。
fail 终态:失败(返回 error)。
提交后按 status 判断:success 或 fail 为终态,其余为非终态,建议按 1~3 秒间隔轮询直至终态。成功终态后从 output[].url 下载产物,并在 expireAt 前完成下载或转存;需要长期保留时在创建任务时使用 storage: "persistent"。
creatednumber必填任务创建时间(Unix 秒)。
completednumber必填进入终态的 Unix 秒;非终态固定为 0。
outputarray可选
仅 status == success 时出现。产物列表,始终为数组,同一任务可能同时返回多个 type(如 video + first_frame)。
Array [ object ]
数组元素
urlstring必填资源 URL,可直接下载。
typestring必填当前可能值:video、image、audio、first_frame、last_frame、thumbnail,后续可能会扩展。
expireAtnumber必填资源可访问截止时间(Unix 秒);过期前请完成下载或转存。
errorobject可选
仅 status == fail 时出现。
codestring必填业务错误码。
messagestring必填错误描述。
响应示例
成功
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
处理中(非终态)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
失败
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}相关文章
查看全部文章 →相关模型
查看全部模型 →同类型模型
-
 Kandinsky 6.0 Pro $1.93 /条
-
 Runway Gen 4.5 Runway $0.172 /秒
-
 Kling 2.5 Kuaishou $0.060 /秒
-
 Creatify Boreal Creatify $0.015 /秒
-
 Seedance 2.0 ByteDance $0.017 /秒
-
 HappyHorse 1.0 Alibaba $0.168 /秒
-
 HappyHorse 1.1 Alibaba $0.160 /秒
-
 Grok Imagine 1.5 Lite xAI $0.029 /秒
-
 Ray 3.2 Luma $0.214 /条
-
 Veo 3.1 Google $0.290 /秒
-
 FLUX 3 Max Black Forest Labs $0.061 /秒
-
 Grok Imagine 1.5 xAI $0.011 /秒
