
OpenAI
GPT Image 2
gpt-image-2/text-to-image
OpenAIs Modell zur Bilderzeugung und -bearbeitung mit Schwerpunkt auf fotorealistischer Wiedergabe, hochpräziser Textdarstellung und nativer 4K-Ausgabe, geeignet für kommerzielle Materialien mit Text und Produktbilder
gpt-image-2/text-to-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image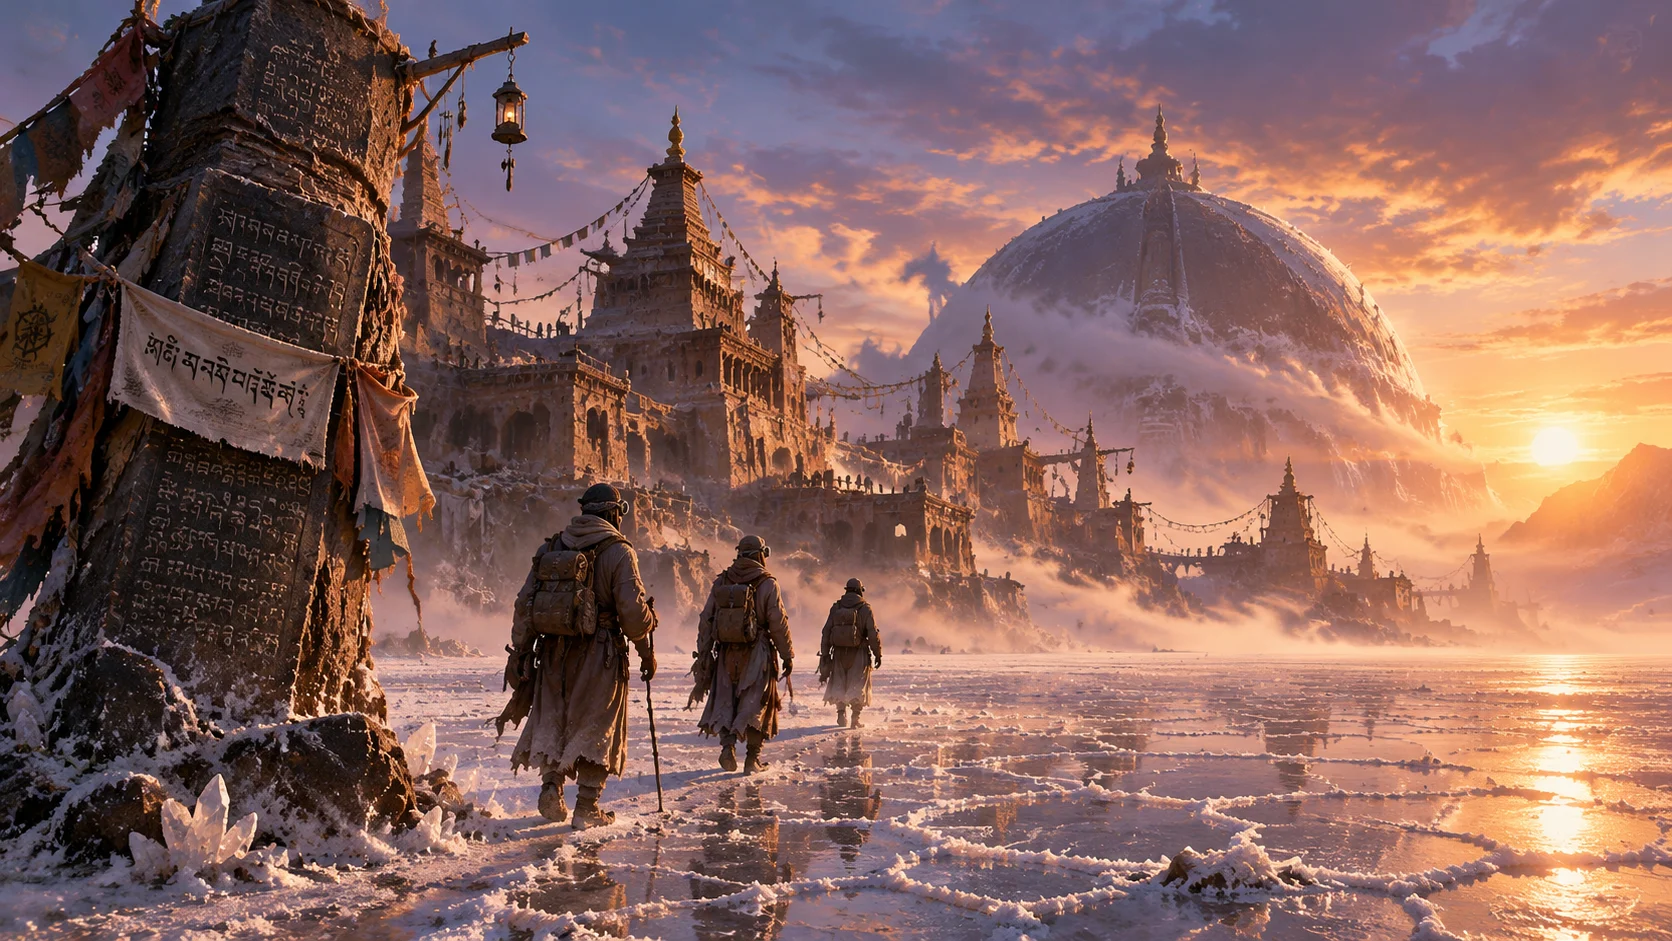
Weltbild-Konzeptkunst: Abenddämmerung in der Pilgerstadt der Salzebene
Stil Konzeptkunst · Weltbau · Filmisch
Prompt
Eine Weitwinkel-Stadtaufnahme aus niedriger Augenhöhe: zur Abenddämmerung eine Pilgerstadt in einer weiten Salzebene. Vordergrund: Eine kleine Karawane aus drei Reisenden in mehrschichtigen staubfarbenen Gewändern und Schutzbrillen voller Salzkristalle wandert auf die Stadt zu, vorbei an einer geneigten Basaltsäule mit dichten Inschriften und verblichenen Gebetsfahnen, auf denen klar lesbare Schrift steht. Mittelgrund: gestaffelte Sandsteinarkaden, Seilbrücken und terrassierte Gebetstürme mit Windspielen und Hängelaternen. Hintergrund: eine riesige, halb versunkene Kuppel, zur Hälfte von treibendem Salznebel verschluckt, als Silhouette vor einem warmen, von Bernstein bis Violett reichenden Himmel. Der Boden besteht aus einer weißen Salzkruste, die in polygonale Platten aufgebrochen ist, den Himmel spiegelt und in der verstreute Kristallsplitter das Licht einfangen. Filmisches Volumenlicht von der tief stehenden Gegenlichtsonne, lange Schatten, feiner Salzstaub in der Luft, subtiler atmosphärischer Dunst, der die Tiefe vom Vordergrund bis zum Hintergrund schrittweise staffelt. Malerisches Concept-Art-Rendering mit fotorealistischer Materialwiedergabe: raue Steintexturen, abgenutzte Gewebestrukturen, oxidiertes Bronzebeschläge. Kalte violette Schatten im Kontrast zu warmen bernsteinfarbenen Glanzlichtern, hoher Dynamikbereich, 16:9-Breitbildkomposition, klare Trennung von Vordergrund, Mittelgrund und Hintergrund, mit großzügiger freier Himmelsfläche.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
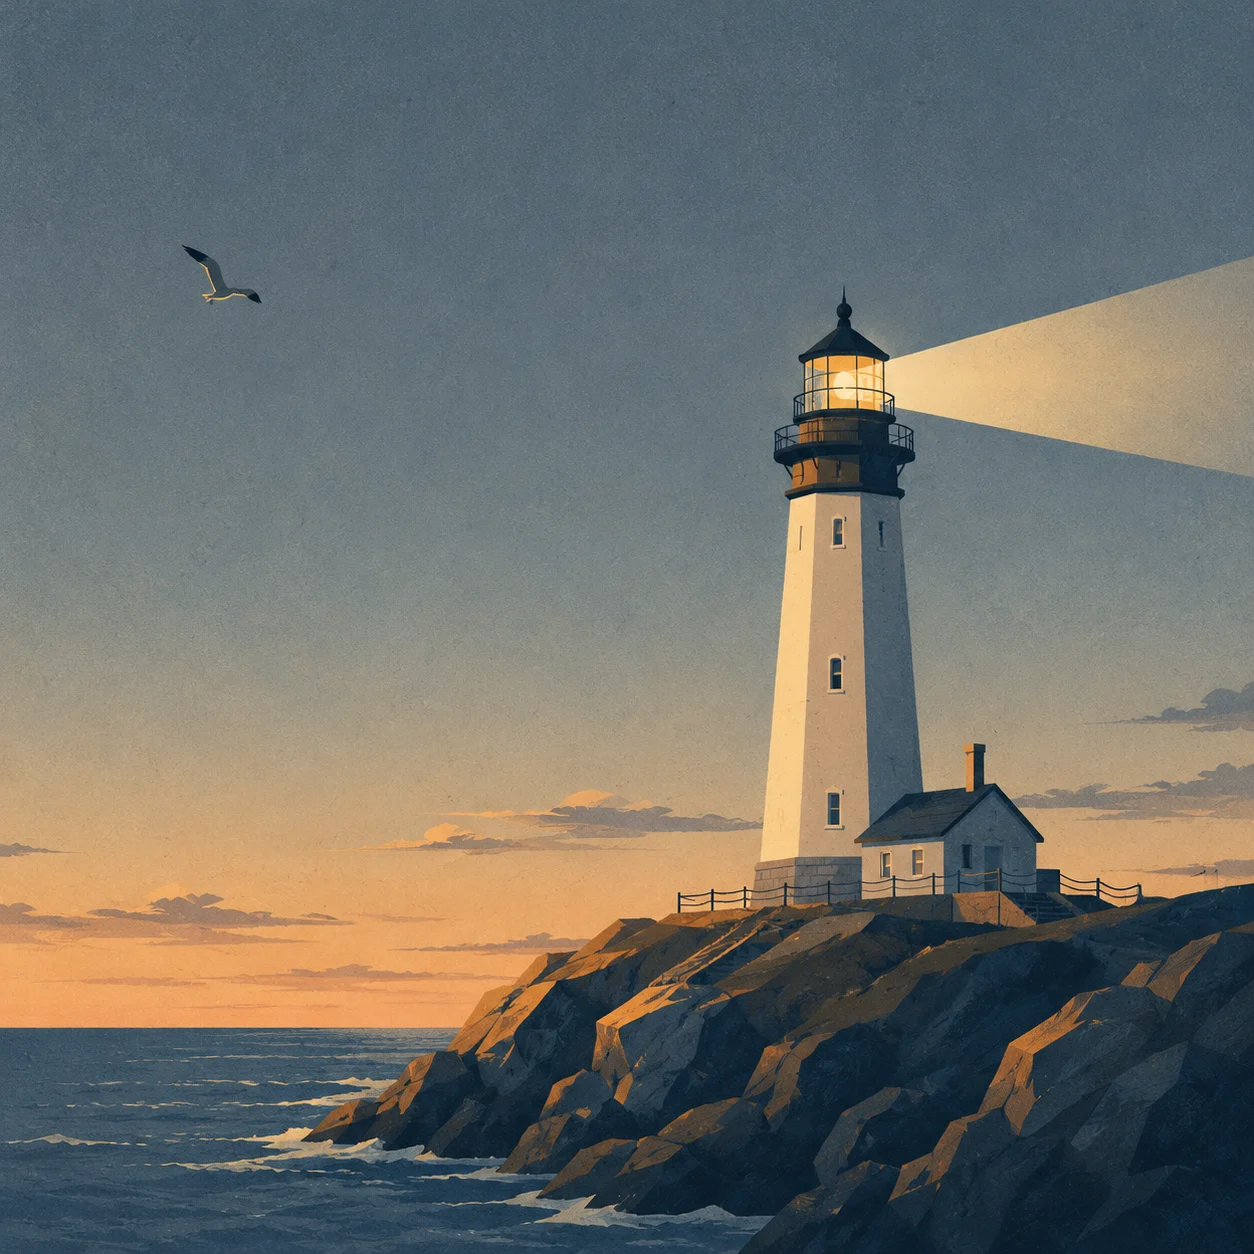
Vom Realismus zur Fläche: Das Illustrationsstil-Spektrum desselben Motivs
Stil Illustration · Stilspektrum · editorial-print
Prompt
Redaktionelle Illustration eines einsamen Leuchtturms auf einer zerklüfteten Landzunge in der Abenddämmerung, aus einer niedrigen Dreiviertelperspektive betrachtet, der Horizont im unteren Drittel des Bildes. Ein Seevogel gleitet über den oberen linken Himmel; der Leuchtturmstrahl schwenkt nach rechts. Über das gesamte Stilspektrum hinweg bleiben Komposition und Motiv unverändert. Stil: halbflächige Vektorillustration, zwischen Realismus und Fläche angesiedelt – vereinfachte geometrische Volumen, eine zurückhaltende Palette aus Schieferblau, warmem Ocker und blassem Creme, weiche zweistufige Hell-Dunkel-Abstufungen statt Verläufen, saubere Kanten, eine subtile Papierstruktur, bewusst belassener Negativraum im Himmel. Kein Text, keine Logos, kein Wasserzeichen. Quadratische 1:1-Komposition, großzügiger Freiraum, druckfähige Schärfe.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
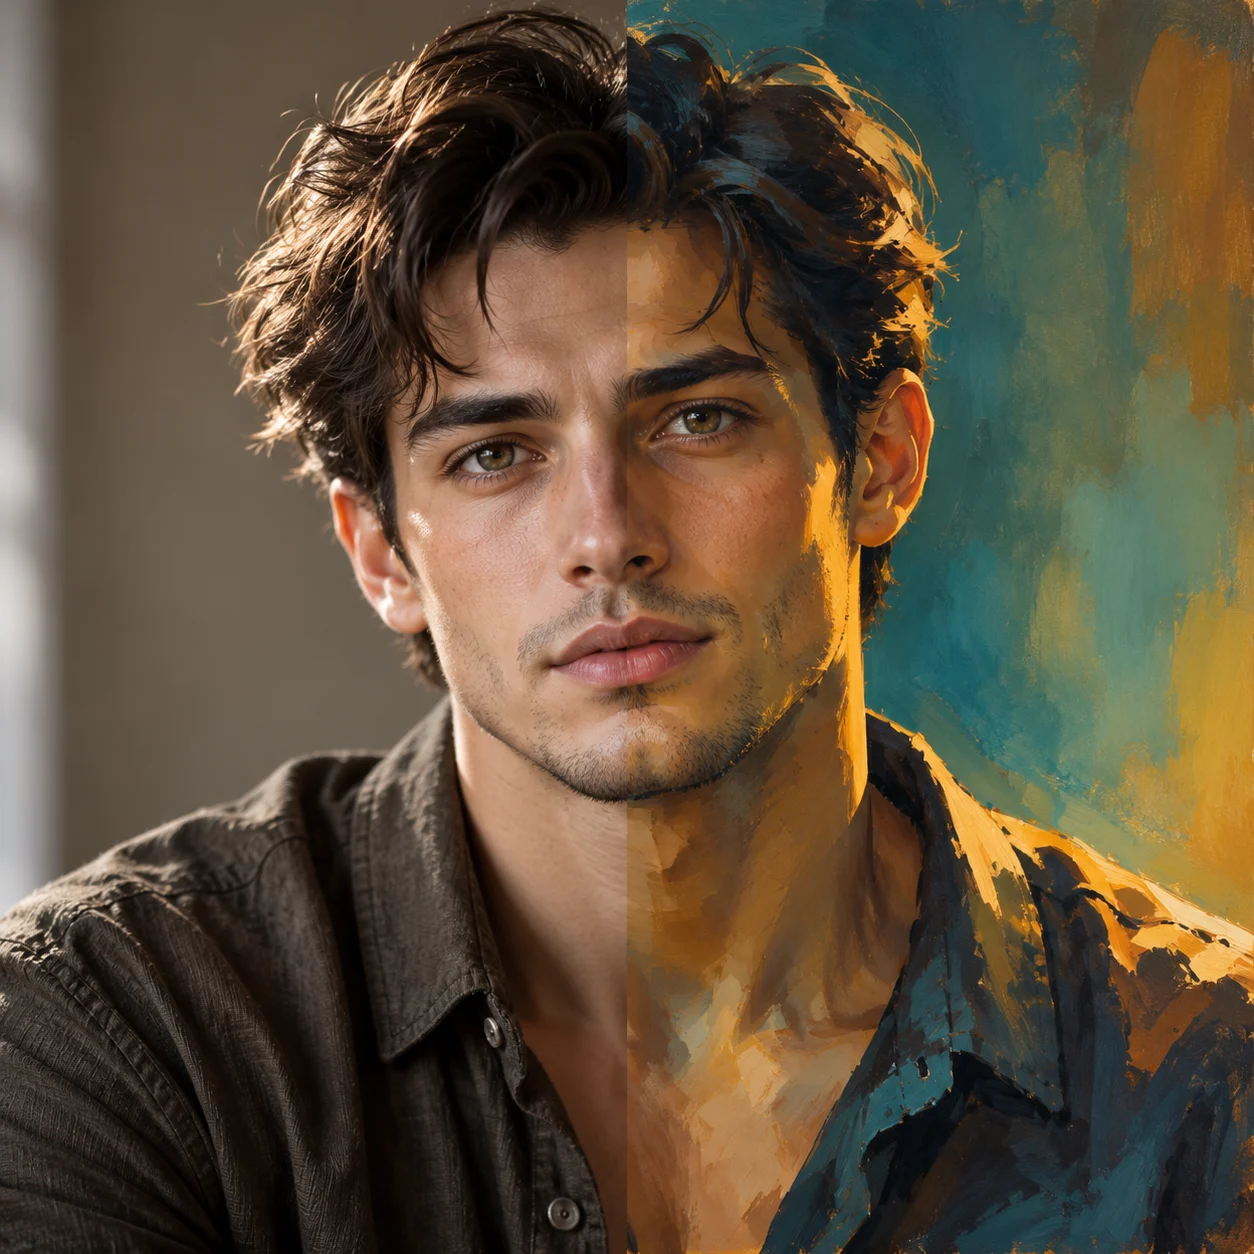
gpt-image-2 Porträtstil-Vergleich: realistische und künstlerische Prompts
Stil Porträtfotografie · Fotorealistisch · Prompt-Referenz
Prompt
Quadratische 1:1-Porträtdemonstration, die zwischen zwei Stilabsichten aufgeteilt wird: fotografischer Realismus und malerische Kunst. Die Hälfte mit realistischer Fotografie: eine Dreiviertelprofil-Nahaufnahme eines jungen Erwachsenen, natürliche Hauttextur, sichtbare Poren und feine Gesichtshärchen, weiches diffuses Fensterlicht von links aus Kameraperspektive, sanfter Übergang zu einem neutralen warmgrauen nahtlosen Hintergrund, 85-mm-Objektiveffekt mit geringer Schärfentiefe, feine Lichtreflexe in den Augen, dezente erdfarbene Kleidung, ruhiger neutraler Ausdruck, hoher Dynamikumfang, zurückhaltende Farbgebung, keine sichtbaren Spuren von Retusche. Die malerische Variante: dasselbe Motiv, mit sichtbaren Pinselstrichen dargestellt, gesättigte Blau-Grün- und Bernsteintöne, skulpturale Konturbeleuchtung mit weichen Schattenflächen, vereinfachter breiter Farbfeldhintergrund, ausdrucksstarke Kanten. Ausgewogene Komposition, Subjekt zentriert, Freiraum über dem Kopf, Fokus klar auf den Augen, sauberes und aufgeräumtes Bild, geeignet als kommerzielle Porträt-Referenz.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
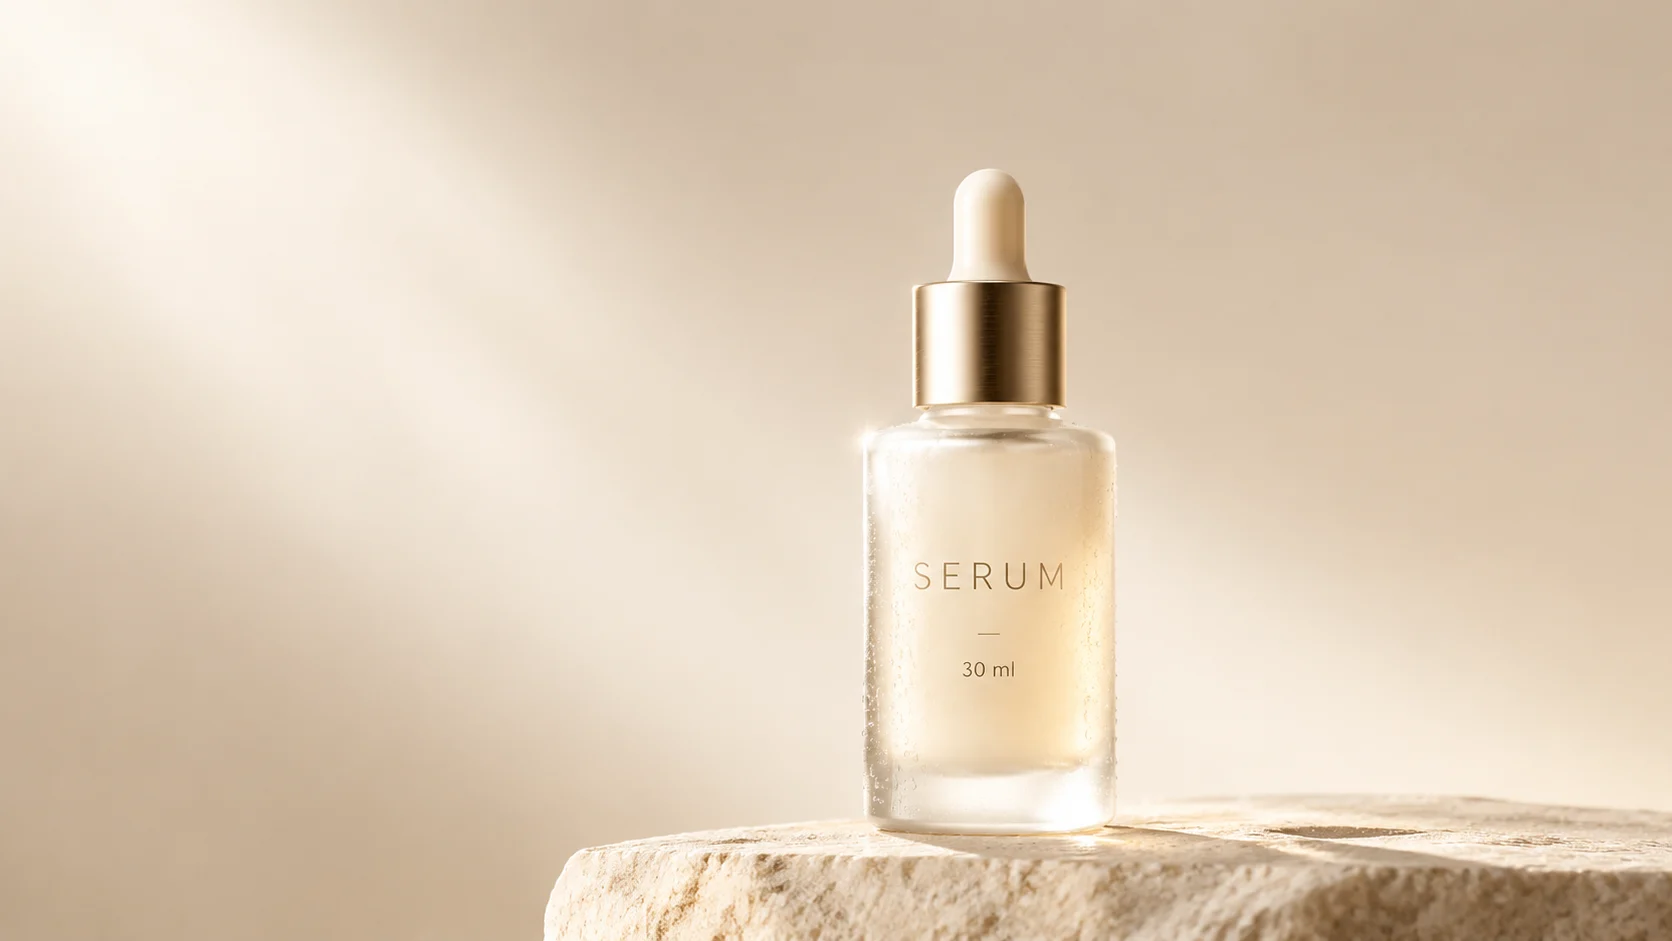
E-Commerce-Produktfotografie: Praxis mit gpt-image-2-Bildgebungs-Prompts
Stil Produktbild · E-Commerce · Studiobeleuchtung
Prompt
Eine kommerzielle Produktfotografie: Eine einzelne Hautpflege-Serumflasche mittig auf einem matten steinernen Sockel platziert, der Hintergrund ist ein weicher, warmer, nahtloser cremeweißer Studiohintergrund. Mattierte Glasflasche mit gebürstetem champagnergoldenem Pipettenverschluss, feine Kondenswasserspuren auf dem Flaschenkörper, an der linken Kante eine saubere Glanzreflexion; auf dem Etikett steht in feiner, großer serifenloser Schrift „SERUM“, darunter eine kleine Zeile „30 ml“, klar und lesbar. Beleuchtung: oben links eine große Softbox als Hauptlicht, hinten rechts ein schmales Konturlicht, das die Silhouette nachzeichnet, der Hintergrund zeigt einen weichen Verlaufsabfall, keine harten Schatten. Aufgenommen aus einem leicht niedrigen Dreiviertelwinkel mit der Anmutung eines 85-mm-Äquivalents, geringe Schärfentiefe hält Verschluss und Etikett scharf, der Hintergrund ist weich unscharf. Farbton begrenzt auf Elfenbeinweiß, warmes Beige und Champagnergold; oben großzügiger Negativraum für Textplatzierung. Fotorealistisch, hoher Dynamikumfang, sauber retuschiert, E-Commerce-Qualität, 16:9-Querformat.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
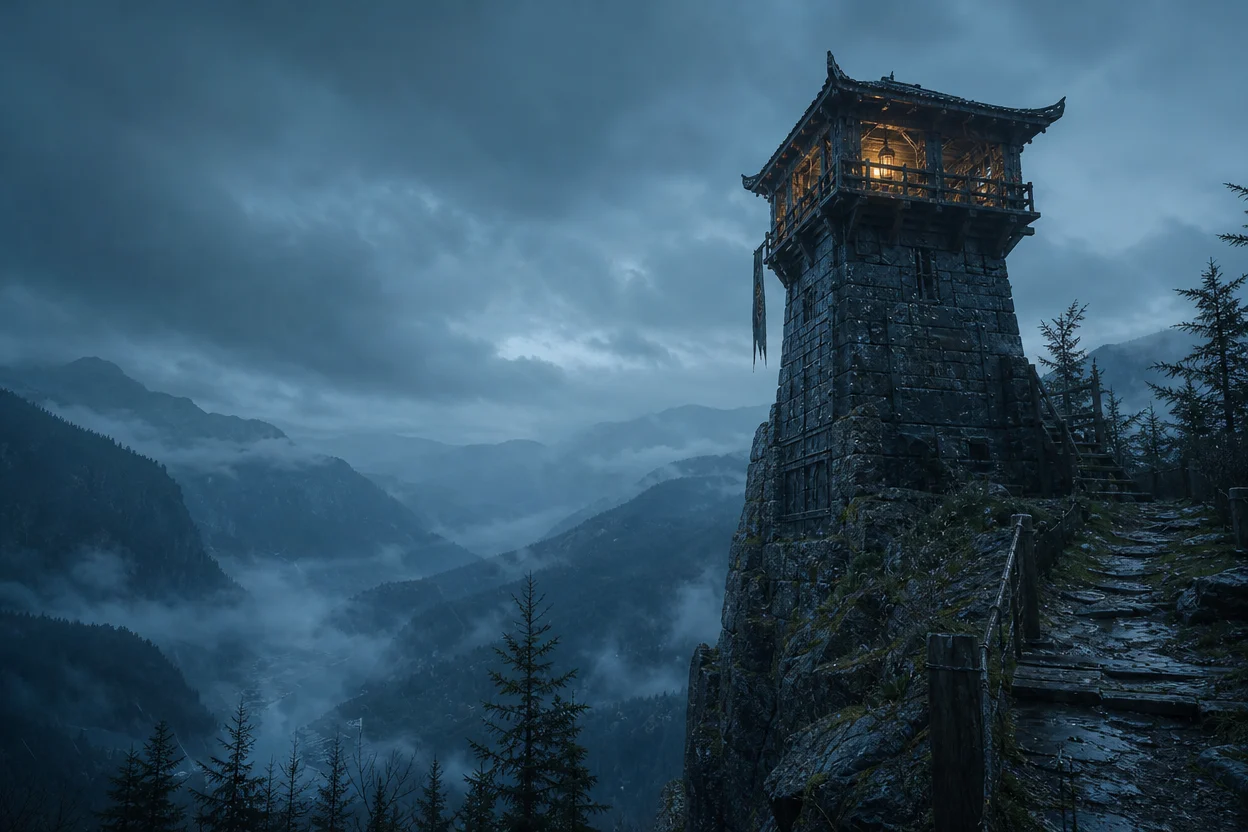
Weltbild-Szenenkonzept: Atmosphärische visuelle Erkundung
Stil Konzeptkunst · Weltbau · Filmisch
Prompt
Cinematografische Breitwand-Konzeptkunst: zur blauen Stunde steht ein einsamer, verwitterter Wachturm aus Stein auf einer Klippe und blickt über ein weites, nebelverhangenes Tal. Der Turm besteht aus übereinandergeschichteten Schieferblöcken, ist mit Eisennieten versehen, in den Rissen wächst Moos, und im oberen Fenster leuchtet eine warme Laterne. Tiefhängender Nebel wälzt sich in Schichten zwischen den Bergrücken und weicht allmählich zu blassen Silhouetten zurück. Kühle, entsättigte Blaugrün- und Tiefindigotöne, wobei die Laterne den einzigen warmen bernsteinfarbenen Akzent liefert, weiche volumetrische Lichtstrahlen, feiner Staub und Nieselregen in der Luft. Ultrabreite 21:9-Komposition, starke Tiefenstaffelung vom Vordergrund zum Hintergrund, niedrige Kameraposition mit leichtem Blick nach oben zum Turm, Drittelregel-Komposition, realistische Materialdetails von Stein und nassem Holz, dezentes Filmkorn, kein Text, keine Kennzeichnung.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
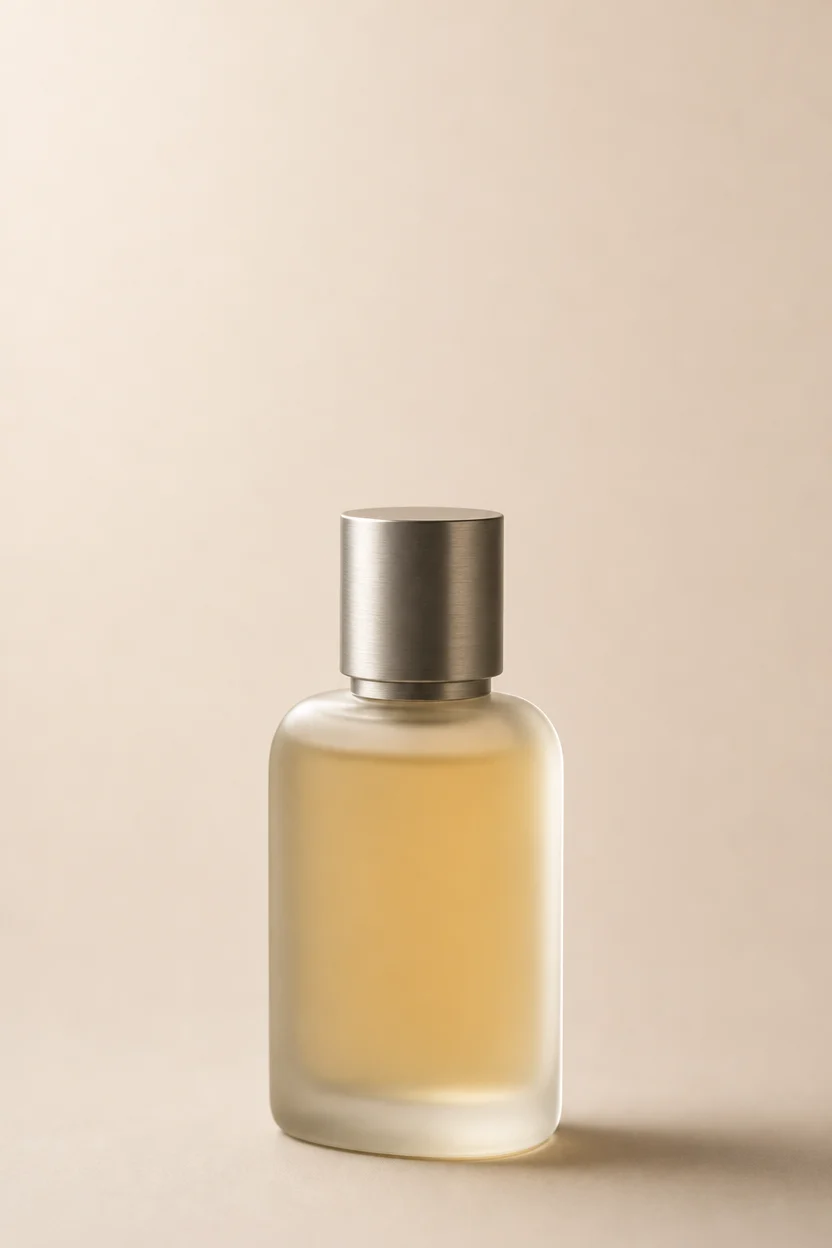
E-Commerce-Produktfotografie: gpt-image-2 Prompt-Analyse
Stil Produktbild · ecommerce · Studiobeleuchtung
Prompt
Studio-Produktfotografie eines Parfümflakons aus Mattglas mit gebürstetem, mattem Metallverschluss, zentriert auf einem warmen, cremeweißen, nahtlosen Hintergrundtuch platziert. Anmutung einer Mittelformatkamera, 100-mm-Makroobjektiv, leichte Dreiviertel-Perspektive, Kamerahöhe auf Höhe des Etiketts. Große Softbox als Hauptlicht von links oben, die entlang der Flanken des Flakons einen sanften, langen Verlaufshighlight erzeugt; rechts ein feines Konturlicht, das das Glas vom Hintergrund trennt; links ein weiches Aufhellpanel. Realistisches Licht, das durch das Mattglas dringt, mit schwachem bernsteinfarbenem Flüssigkeitsschimmer, präzisen Übergängen der Spiegelglanzlichter und einem feinen Kontaktschatten, der den Flakon fest auf der Oberfläche verankert. Saubere, neutrale Farbabstimmung, weicher Kontrast, kein starker Bloom. Geringe Schärfentiefe, die Etikettenebene gestochen scharf, der Hintergrund weich unscharf. Im oberen Drittel reichlich Negativraum für spätere Typografie, keine weiteren Elemente im Bild, kein Text, kein Wasserzeichen, Qualität eines kommerziellen E-Commerce-Hauptbilds, vertikales 4:5-Format.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
gpt-image-2/text-to-image per image
| Spezifikationen | Einzelpreis |
|---|---|
| 1K | $0.030 |
| 2K | $0.040 |
| 4K | $0.060 |
gpt-image-2/text-to-image @beta per image
| Spezifikationen | Einzelpreis |
|---|---|
| With Reference Resources | $0.020 |
gpt-image-2/text-to-image @ext per image
Positionierung im Überblick
gpt-image-2 ist ein Text-zu-Bild-Modell von OpenAI, das sich an Entwickler richtet, die verlässlich visuelle Assets in kommerzieller Qualität erzeugen müssen. Es zeichnet sich durch die Fähigkeit aus, mehrere Einschränkungen in komplexen Prompts zuverlässig umzusetzen, in Postern, Verpackungen und Layouts mit Text eine gute typografische Sauberkeit zu bewahren und Auflösungen von 1K bis 4K sowie verschiedene Seitenverhältnisse zu unterstützen. Über die einheitliche API von HiAPI.ai genügt die Übergabe eines Prompts, um ein Bild zu erzeugen – ideal für Teams, die Bildgenerierungsfunktionen in Designwerkzeuge, Marketing-Material-Pipelines und Content-Produktions-Backends integrieren möchten.
Zentrale Highlights
- Gute Befolgung komplexer Prompts – dank der semantischen Verständnisfähigkeiten der GPT-Reihe gelingen Bilder auch bei Prompts, die gleichzeitig Subjekt, Stil, Text und Layoutvorgaben enthalten, entsprechend der Absicht.
- Zuverlässigere Darstellung von Bildern mit Text – Schriftinhalte auf Schildern, Verpackungen und in Layouts werden gut wiedergegeben und gesetzt, was Nachbesserungen an der Schrift nach der Generierung reduziert.
- Breite Abdeckung von Auflösungen und Formaten – unterstützt 1K-, 2K- und 4K-Ausgaben sowie über ein Dutzend Seitenverhältnisse von 1:1 bis 21:9, sodass eine einmalige Integration viele Ausspielformate abdeckt.
- Mehrere Versionen pro Aufruf – es lassen sich mehrere Ergebnisse auf einmal erzeugen, was den Variantenvergleich und die Stilerkundung mit demselben Prompt erleichtert.
Fähigkeitenbeschreibung
Bildgenerierung aus Text-Prompts: Mit einem Prompt von bis zu 20000 Zeichen lässt sich ein Bild erzeugen – ideal, um natürlichsprachliche Beschreibungen direkt in nutzbare visuelle Assets zu verwandeln.
Ausgabe in mehreren Auflösungen und Formaten: Wählbar zwischen 1K, 2K und 4K sowie passend zum Ausspielplatz im Quer- oder Hochformat; das Format auto sowie extreme Formate wie 9:21 und 3:1 sind auf 1K beschränkt, 1:1 unterstützt kein 4K.
Ausgabe mit transparentem Hintergrund: background unterstützt die drei Modi auto, opaque und transparent; transparente Hintergründe eignen sich direkt zum Komponieren und Überlagern, der Parameter wirkt jedoch nur bei 1K.
Darstellung von Text und Layout: gemischte Bild-Text-Kompositionen mit Schrift werden gut gerendert und gesetzt, ideal für kommerzielle Motive, die einen fertigen Eindruck vermitteln sollen.
Mehrere Ergebnisse in einem Rückgabewert: Ein einzelner Prompt kann mehrere stilistisch konsistente Bilder erzeugen, was den schnellen Versionsvergleich und die Auswahl erleichtert.
Anwendungsfälle
- Marketing-Teams: Werbeplakate und Key Visuals – Kampagnenthema und Layoutvorgaben eingeben und Key Visuals erzeugen, die direkt in die Ausspielung oder zur Nachbearbeitung gehen können.
- E-Commerce-Betrieb: Produktbilder und Produktfotografie-Stil – aus Produktbeschreibungen fotorealistische Produktbilder für Detailseiten, Regalbilder und Social-Media-Material erzeugen.
- Designteams: Verpackungs- und Layoutentwürfe mit Text – Texte und Bild-Text-Beziehungen eingeben und Verpackungs-, Schilder- und Layoutentwürfe mit mehrsprachigem Text erzeugen.
- Content-Plattformen: Mehrere Varianten iterieren – mit demselben Prompt Bilder im Batch erzeugen, um Stile zu erkunden, und die Kandidaten erst nach dem Review finalisieren.
Einschränkungen und Auswahlhinweise
Es werden ausschließlich Bilder ausgegeben, andere Modalitäten wie Video werden nicht unterstützt. Die offizielle Generierungsgeschwindigkeit wird als mittel eingestuft, daher eignet es sich nicht für extrem latenzempfindliche Echtzeit-Interaktionsszenarien; hohe Auflösungen und Batch-Generierung verlängern die Dauer und erhöhen die Aufrufkosten gleichermaßen, was gegen die Ausspielformate abzuwägen ist. Bei Bildern mit exaktem Text wird weiterhin manuelle Prüfung empfohlen. Wenn der Bedarf eher in komplexer Szenenkomposition und -schlussfolgerung oder extremer Generierungsgeschwindigkeit liegt, sollten andere Modelle gesondert geprüft werden; auf HiAPI.ai gibt es zudem eine Bild-zu-Bild-Route dieser Serie, die genutzt werden kann, wenn ein vorhandenes Bild als Eingabe dienen soll. Die Abrechnung erfolgt pro Bild; der konkrete Betrag richtet sich nach dem Preispaneel.
Neuigkeiten
Changelog ansehen →- Parameteränderung gpt-image-2: Neue Auflösungsstufen 1K / 2K / 4K
Häufige Fragen
Alle Fragen ansehen →-
Was ist GPT Image 2?
GPT Image 2 ist ein Text-zu-Bild-Modell von OpenAI, geeignet für Poster, Wissenskarten, Produktvisuals und Bildgenerierung mit klaren Anforderungen an Text und Layout.
-
Sind GPT Image 2 und GPT Image 2.0 dasselbe Modell?
GPT Image 2.0 ist eine gängige Suchabkürzung; verwenden Sie die genaue Modell-ID, die auf der GPT Image 2-Seite und in der API-Dokumentation aufgeführt ist.
-
Welcher Endpunkt und welche Modell-ID werden für die GPT Image 2 API verwendet?
Sende eine Anfrage an POST /v1/tasks, setze für die Text-zu-Bild-Generierung model auf gpt-image-2/text-to-image und übergebe prompt, aspect_ratio und resolution in input. Die Schnittstelle gibt zunächst eine taskId zurück, anschließend erhältst du das endgültige Bild über die Aufgabenabfrage oder einen callback.
-
Wie verwende ich GPT Image 2?
Beschreibe im Playground das Motiv, die Szene, das Layout und den Text, der unbedingt erscheinen muss, wähle dann Bildformat, Auflösung und Hintergrund, klicke auf Ausführen und sieh dir das Ergebnis an.
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: gpt-image-2/text-to-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für gpt-image-2/text-to-image und Route default — siehe Parametertabelle unten.
promptstringPflichtminLength 1maxLength 20000Text-Prompt, erforderlich, maximale Länge 20000 Zeichen.
backgroundstringOptionalHintergrundmodus, dieser Parameter wird nur bei 1K-Auflösung unterstützt.
autoopaquetransparentresolutionstringOptionalStandard: "1K"Auflösung des generierten Bildes, Standard 1K. Wenn aspect_ratio auf auto gesetzt ist, wird nur 1K unterstützt; 1:1 unterstützt kein 4K; wenn aspect_ratio auf 3:1/1:3/9:21 gesetzt ist, wird nur 1K unterstützt; wenn background auf auto/opaque/transparent gesetzt ist, wird nur 1K unterstützt.
1K2K4Kaspect_ratiostringOptionalStandard: "auto"Seitenverhältnis des generierten Bildes, Standard auto. Wenn ausgelassen oder auf auto gesetzt, wird nur die 1K-Auflösung unterstützt.
auto1:13:22:34:33:45:44:5Alle anzeigen (8)
16:99:162:11:23:11:321:99:21callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentmodelstringPflichtAktueller Festwert: gpt-image-2/text-to-image
routestringOptionalAktueller Festwert: beta
inputobjectPflicht
Geschäftsparameter für gpt-image-2/text-to-image und Route beta — siehe Parametertabelle unten.
sizestringOptionalStandard: "auto"pattern ^(auto|[1-9][0-9]{2,4}x[1-9][0-9]{2,4})$Output image size. Use auto or a compliant WIDTHxHEIGHT value such as 2048x2048.
promptstringPflichtmaxLength 20000Text prompt describing the image to generate. Max 20000 characters.
callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentmodelstringPflichtAktueller Festwert: gpt-image-2/text-to-image
routestringOptionalAktueller Festwert: ext
inputobjectPflicht
Geschäftsparameter für gpt-image-2/text-to-image und Route ext — siehe Parametertabelle unten.
promptstringPflichtminLength 1maxLength 20000图像生成提示词 Max 20000 characters.
qualitystringPflichtStandard: "low"lowmediumhighresolutionstringPflichtStandard: "1K"1K2K4Kaspect_ratiostringOptionalStandard: "1:1"输出画幅比例
auto1:13:22:34:33:45:44:5Alle anzeigen (8)
16:99:162:11:23:11:321:99:21callbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "gpt-image-2/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "1K",
    "aspect_ratio": "auto"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/text-to-image",
input: {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/text-to-image",
"input": {
"prompt": "…",
"resolution": "1K",
"aspect_ratio": "auto"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
-H "Authorization: Bearer $HIAPI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2/text-to-image@beta",
"input": {
"size": "auto",
"prompt": "…"
}
}'const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/text-to-image@beta",
input: {
"size": "auto",
"prompt": "…"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/text-to-image@beta",
"input": {
"size": "auto",
"prompt": "…"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
-H "Authorization: Bearer $HIAPI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2/text-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"resolution": "1K",
"aspect_ratio": "1:1"
}
}'const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "gpt-image-2/text-to-image@ext",
input: {
"prompt": "…",
"quality": "low",
"resolution": "1K",
"aspect_ratio": "1:1"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "gpt-image-2/text-to-image@ext",
"input": {
"prompt": "…",
"quality": "low",
"resolution": "1K",
"aspect_ratio": "1:1"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 Ideogram V3 Character Ideogram $0.090 /Bild
-
 Krea 2 Medium Turbo Krea $0.021 /Bild
-
 Qwen Image 2.0 Alibaba $0.042 /Bild
-
 Nano Banana Google $0.021 /Bild
-
 FASHN Tryon v1.6 FASHN $0.107 /Bild
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /Bild
-
 FIBO 1.5 Bria $0.058 /Bild
-
 Recraft V4.1 Recraft $0.010 /Bild
-
 Qwen Image 2.1 Alibaba $0.020 /Bild
-
 Wan 2.7 Image Alibaba $0.035 /Bild
-
 Recraft Crisp Upscale Recraft $0.004 /Bild
-
 851 Labs Background Remover 851 Labs $0.002 /Bild



