
Krea
Krea 3
krea-3/text-to-image
Unterstützt Textgenerierung und Bearbeitung mit Referenzbildern, native 2K-Ausgabe, etwa 8 Sekunden pro Bearbeitung – ideal für häufige visuelle Iterationen und die Wiederverwendung von Material
krea-3/text-to-image ausprobieren
Eingabe
Galerie
Alle Arbeiten ansehenAusgabe
image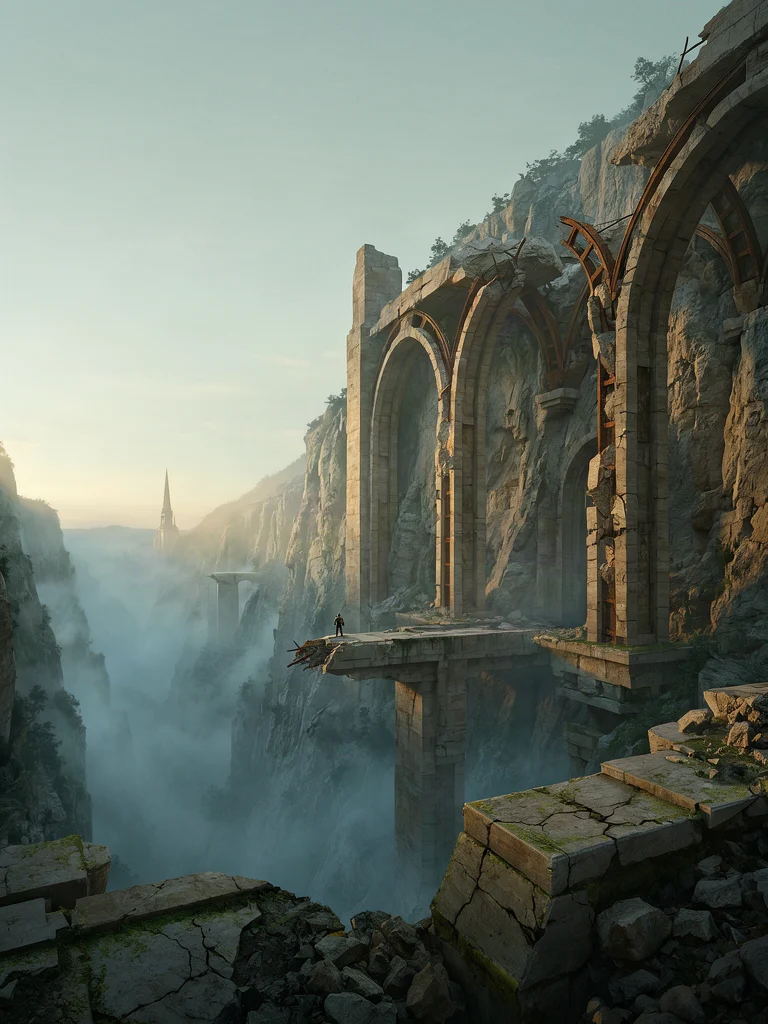
Weltbild-Szenenkonzept: Morgennebel über der Ruinenheiligtum
Stil Konzeptkunst · Weltbau · Atmosphäre
Prompt
Breitformatige, filmische Konzeptkunst eines verlassenen Heiligtums am Rand einer Klippe im Morgengrauen: ein gewaltiger Steinbogen, halb eingestürzt in einem nebligen Tal, ein einsamer Entdecker als Silhouette auf einer zerbrochenen Brücke, der dem Bild einen Größenmaßstab verleiht; klar gestaffelte Tiefenschärfe, Vordergrund aus Schutt, Mittelgrund aus Nebel, Hintergrund aus Türmen; weiches, gerichtetes Licht, das schräg durch den Morgennebel fällt; Farbpalette aus kühlem, entsättigtem Blaugrün und warmem Sandsteinton; verwitterter Stein und oxidiertes Metall; malerische Matte-Painting-Qualität mit feinen architektonischen Details; 16:9-Querformat mit starker Fluchtpunktperspektive und reichlich Negativraum im Himmel
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
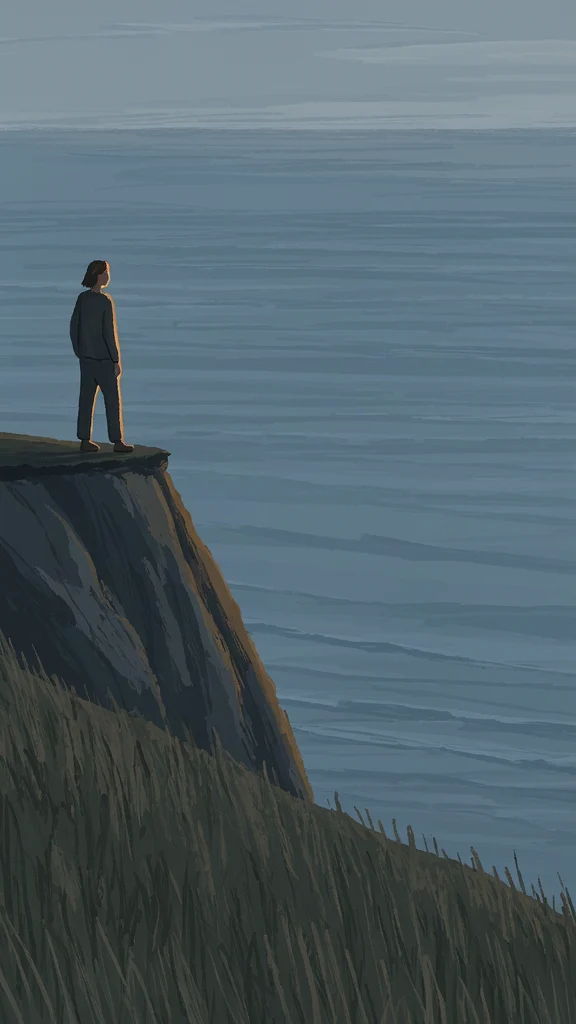
Von realistisch bis flach: Das Illustrationsstil-Spektrum von Krea 3
Stil Illustration · Stilspektrum · Bearbeitung
Prompt
Editorial-Stilillustration: In der Abenddämmerung steht eine einsame Gestalt am Rand einer Meeresklippe, dargestellt in einer Dreiviertelansicht aus niedriger Perspektive, komponiert in einem horizontalen 16:9-Format mit einer großen Negativfläche auf der rechten Seite. Die Szene wird mit deutlich sichtbaren malerischen Pinselstrichen wiedergegeben: Meer und Himmel durch geschichtete kühle blaugraue Farbflächen, die Klippen mit warmen Ockertönen akzentuiert, ein sanftes Konturlicht umreißt die Silhouette der Figur; die Formen sind vereinfacht, strukturell lesbar, aber keinesfalls fotorealistisch. Mittlere Detaildichte – die Gräser im Vordergrund mit ausdrucksstarken Pinselstrichen, je näher dem Horizont, desto breiter die Striche. Insgesamt eine weiche, entsättigte Farbpalette mit nur einem warmen Fokuspunkt. Kein Text, kein Wasserzeichen, keine überzähligen Gliedmaßen.
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
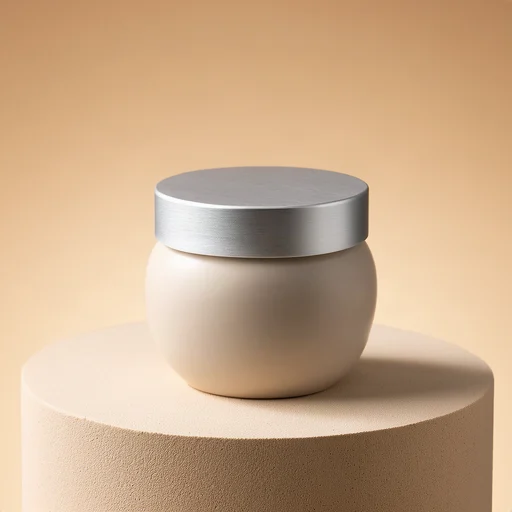
Krea 3 E-Commerce-Produktbilder: Licht und Schatten auf der Tischplatte und Materialtextur
Stil Produktbild · ecommerce · Studiobeleuchtung
Prompt
E-Commerce-Produktfotografie, ein matt keramischer Kosmetiktiegel mit gebürstetem Aluminiumdeckel, stehend auf einem warm beigen GipsSockel, zentrierte Dreiviertelansicht, Kamera auf Augenhöhe leicht nach unten geneigt, Anmutung eines 85-mm-Objektivs, geringe Schärfentiefe, eine große weiche Softbox als Hauptlicht von links oben erzeugt einen sanften Verlauf auf der gewölbten Keramikoberfläche, feines Kantenlicht trennt den Deckelrand vom Hintergrund, ein zarter Kontaktschatten stabilisiert den Sockel, nahtloser warm sandfarbener VerlaufsHintergrund, die Glasur zeigt eine klar erkennbare Mikrotextur, auf dem Deckel feine gebürstete Metallstrukturen, saubere kommerzielle Farbkorrektur, hohe Detailtreue, kein Text, keine störenden Requisiten, keine blendenden Spiegelglanzlichter
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
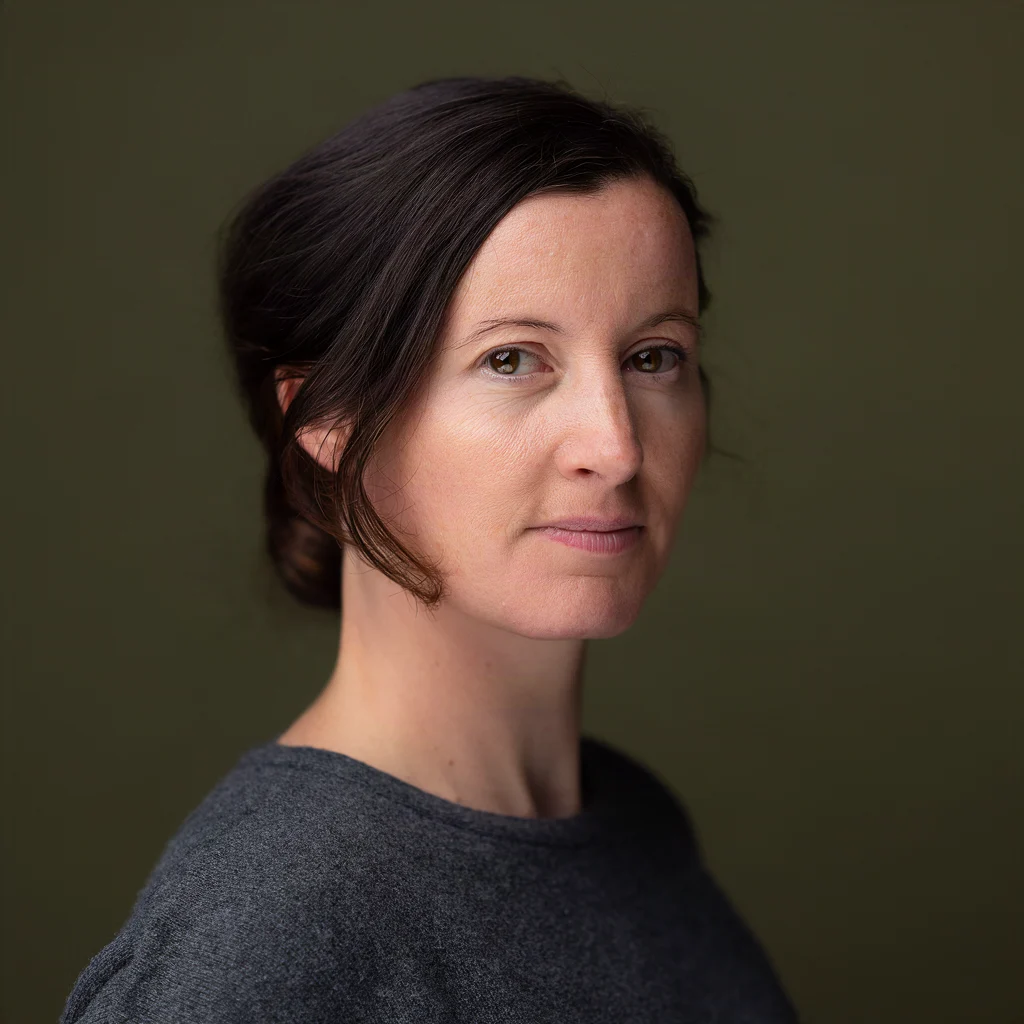
Krea 3 Porträt-Prompts im Doppelstil-Vergleich: Realistisch und künstlerisch
Stil Porträtfotografie · Prompt-Engineering · Bearbeitung
Prompt
Ein Porträtfoto einer Frau Anfang dreißig, Dreiviertelprofil, Blick leicht über die Kamera hinaus, natürliche, unretuschierte Haut mit sichtbaren Poren und feiner Textur, weiches Fensterlicht von links der Kamera, rechts ein subtiles kaltes Aufhelllicht, geringe Schärfentiefe von etwa f/2, 85-mm-Objektiv-Anmutung, entsättigte neutrale Farbtöne, dunkelolivfarbener nahtloser Hintergrundstoff, Haare nach hinten gebunden mit einigen losen Strähnen, dezentes Make-up, ruhiger neutraler Gesichtsausdruck, Hochformat 4:3 mit etwas Kopffreiraum, feine Körnung, keine Beauty-Retusche
Kopiere das vollständige Prompt und passe es an deine eigene Aufgabe an.
Tags
Preise
krea-3/text-to-image per image
| Einzelpreis | $0.036 |
|---|
Positionierung im Überblick
krea-3/text-to-image ist eine Modelllinie von Krea für Text-zu-Bild-Szenarien, die über die einheitliche Schnittstelle von HiAPI.ai aufgerufen wird. Sie nimmt Text-Prompts entgegen und erzeugt Bilder und bietet mehrere Größen-Presets wie quadratisch, Hochformat und Querformat mit Ausgabe als PNG oder JPEG. Die Linie unterstützt die beiden Varianten berry und jam, wobei erstere auf Bildqualität und letztere auf Geschwindigkeit ausgerichtet ist. Zusätzlich lassen sich die Inferenzintensität, negative Prompts und ein fester Zufallsseed einstellen, um dasselbe Ergebnis reproduzieren zu können. Sie eignet sich für Entwicklungsteams, die das Gleichgewicht zwischen Bildqualität und Ausgabegeschwindigkeit projektbezogen anpassen und die Generierung im Batch in eigene Abläufe einbinden möchten.
Zentrale Highlights
- Bildqualität und Geschwindigkeit separat wählbar – variant bietet die beiden Optionen berry und jam, wobei erstere stärker auf Qualität und letztere stärker auf Geschwindigkeit ausgerichtet ist; je nach Aufgabe lässt sich zwischen beiden wechseln.
- Inferenzintensität anpassbar – reasoning_level kann auf low oder medium gesetzt werden und steuert, wie stark der Prompt vor der Generierung durchdacht und erweitert wird; medium dauert länger.
- Ausgabegröße und -format kontrollierbar – sechs integrierte Presets für quadratisch, Hochformat 4:3/16:9 und Querformat 4:3/16:9, maximal 1024×1024, Ausgabe wahlweise als PNG oder JPEG.
- Reproduktion mit festem Seed – mit einem übergebenen seed lassen sich bei gleicher Eingabe identische Ergebnisse reproduzieren, was das Debuggen von Prompts und Versionsvergleiche erleichtert.
Funktionsbeschreibung
Bilderzeugung aus Text-Prompts: Eine Textbeschreibung dient als einzige erforderliche Eingabe und liefert ein einzelnes Bild zurück; prompt kann bis zu 5000 Zeichen lang sein und bietet Platz für recht vollständige Beschreibungen von Motiv, Stil und Komposition.
Ausschließen von Elementen per negativem Prompt: Über negative_prompt (bis zu 1024 Zeichen) lassen sich Inhalte festlegen, die nicht im Bild erscheinen sollen, was eine weitere Dimension der Bildsteuerung hinzufügt.
Sechs Größen-Presets und Formatwahl: Je nach endgültigem Einsatzort ein quadratisches, Hochformat- oder Querformat-Preset wählen und direkt als PNG oder JPEG ausgeben, was spätere Konvertierungsschritte reduziert.
Parametrisierte Reproduktion von Ergebnissen: Sind Parameter wie seed und reasoning_level festgelegt, liefert dieselbe Eingabe stabil dieselbe Ausgabe, was sich für eine wiederholbare Generierungsbasis eignet.
Anwendungsszenarien
- Batch-Generierung von Bebilderung für Content-Teams – das passende Preset zur Spaltengröße wählen und mit einem Aufruf ein Bild erzeugen, etwa für Artikel-Headerbilder, Social-Media-Bebilderung und andere Stellen, die eine verlässliche Bildausgabe erfordern.
- Prompt-Optimierung durch Design-Entwickler – nach Fixierung des seeds prompt und negativen Prompt schrittweise anpassen, die Ausgabeunterschiede vergleichen und wiederverwendbare Prompt-Vorlagen herausarbeiten.
- Quellenidentische Erzeugung von Hoch- und Querformat-Materialien – mit derselben Beschreibung zwischen portrait- und landscape-Presets wechseln, um stilmäßig passende Assets für Mobilgeräte und Web zu erhalten.
- Prototypenvalidierung bei Geschwindigkeitsanspruch – die Variante jam mit niedrigerer Inferenzintensität wählen, um früh im Projekt schnell mehrere Richtungen zu erhalten, und anschließend mit berry eine ausgearbeitete Version produzieren.
Einschränkungen und Auswahlhinweise
Es wird ausschließlich die Bilderzeugung aus Text-Prompts unterstützt; Referenzbilder werden nicht angenommen und lokale Bearbeitungen sind nicht möglich. Wenn Bild-zu-Bild oder regionale Änderungen benötigt werden, sollte ein Modell mit den entsprechenden Fähigkeiten gewählt werden. Die Ausgabe ist auf 1024×1024 begrenzt; hochauflösende Endprodukte müssen separat hochskaliert werden. negative_prompt wirkt nur bei der Variante berry; bei Wahl von jam hat dieser Parameter keine Wirkung. Jeder Aufruf liefert ein Bild, mehrere Varianten erfordern mehrere Anfragen. Wenn eine Aufgabe die strenge Reproduktion einer bestimmten bestehenden Figur oder Produktoptik verlangt, lässt sich mit reiner Textbeschreibung keine Konsistenz garantieren.
Häufige Fragen
Alle Fragen ansehen →-
Wofür eignet sich Krea 3?
Es eignet sich für realistische Fotografie, Porträts, Produktbilder, Food, Architektur und Innenräume, Illustrationen und Konzeptdesign; auch Poster mit Titeltext sind möglich. Schon kurze Prompts liefern ein vollständiges Bild, ideal zum schnellen Ausloten von Richtungen.
-
Was ist der Unterschied zwischen berry und jam?
Beides sind zwei Varianten desselben Modells mit größtenteils identischen Parametern (negative_prompt wirkt nur bei berry): Krea positioniert berry als qualitätsorientiert und jam als geschwindigkeitsorientiert, beide zum selben Preis. Umgeschaltet wird über input.variant, Standard ist berry. Im praktischen Vergleich unterscheiden sich beide bei gleichem seed in Bildaufbau und Farbton, die Bildqualität ist vergleichbar – man kann beide einmal ausprobieren und dann wählen.
-
Was ist reasoning_level? Welche Stufe sollte ich wählen?
Es steuert, wie viel Aufwand das Modell vor der Bilderzeugung in das Verstehen und Erweitern des Prompts investiert. Verfügbar sind low und medium (Standard). Verwende medium, wenn der Prompt sehr kurz oder sehr abstrakt ist; verwende low, wenn der Prompt bereits sehr konkret formuliert ist und du es schneller möchtest.
-
Welche Größen werden unterstützt?
image_size unterstützt 6 Varianten: square_hd (1024 × 1024, Standard), square (512 × 512), portrait_4_3 (768 × 1024), portrait_16_9 (576 × 1024), landscape_4_3 (1024 × 768), landscape_16_9 (1024 × 576).
Generierungsaufgabe erstellen
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringPflichtAccount-API-Schlüssel. Bei jeder Anfrage erforderlich. Beispiel: Bearer YOUR_HIAPI_API_KEY. API-Schlüssel holen
Content-TypestringOptionalDer Anfragekörper wird immer als JSON geparst; beim Senden ist nur application/json (optional mit charset) zulässig — andere Werte liefern 415. Beispiel: application/json.
Idempotency-KeystringOptionalIdempotenz-Schlüssel, bis 255 Bytes. Wiederholungen mit demselben Schlüssel desselben Kontos erstellen die Aufgabe nur einmal; Replays liefern die ursprüngliche taskId.
Bei Netzwerk-Timeouts oder Client-Wiederholungen erstellt derselbe Schlüssel die Aufgabe nur einmal — keine doppelte Abbuchung (Geltungsbereich = das Konto des API-Schlüssels). Empfohlen: geschäftsseitig eindeutige Kennung (z. B. "order-42"); Replays liefern die ursprüngliche taskId, Schlüssel laufen 24 Stunden nach der ersten Anfrage ab. Die vollständige Szenariomatrix steht in der Übersicht der Unified Async API.
Body
modelstringPflichtAktueller Festwert: krea-3/text-to-image
routestringOptionalAktueller Festwert: default
inputobjectPflicht
Geschäftsparameter für krea-3/text-to-image und Route default — siehe Parametertabelle unten.
seedintegerOptionalmin 0max 2147483647Fester Zufallsstartwert zur Reproduktion identischer Generierungsergebnisse; ganzzahliger Wert, wird bei Nichtangabe serverseitig zufällig festgelegt.
promptstringPflichtminLength 1maxLength 5000Textbeschreibung des zu generierenden Bildes, die als Prompt für den generierten Inhalt dient.
variantstringOptionalStandard: "berry"Generierungsvariantenstufe; berry legt den Schwerpunkt auf Qualität, jam auf Geschwindigkeit; Standard ist berry.
berryjamimage_sizestringOptionalStandard: "square_hd"Voreinstellung für die Ausgabegröße, maximal unterstützt 1024×1024; Standard ist square_hd.
square_hdsquareportrait_4_3portrait_16_9landscape_4_3landscape_16_9output_formatstringOptionalStandard: "png"Format des Ausgabebildes; Standard ist png.
pngjpegnegative_promptstringOptionalmaxLength 1024Gibt Inhalte an, die vom Bild ausgeschlossen werden sollen; wirkt nur bei der Variante berry.
reasoning_levelstringOptionalStandard: "medium"Steuert den Umfang der Schlussfolgerung und Erweiterung des Prompts vor der Generierung; höhere Werte bedeuten eine tiefergehende Verarbeitung, medium ist vergleichsweise langsamer; Standard ist medium.
lowmediumcallbackobjectOptional
Konfiguration der Endzustands-Benachrichtigung. Ohne Angabe wird kein Callback gesendet — selbst abfragen.
Beim Erstellen callback.url angeben, dann POSTet HiAPI im Endzustand an Ihren Service — kein Polling nötig. Der Callback-Body entspricht der Aufgaben-Detailstruktur; Signaturprüfung, Wiederholungen und Idempotenz sind in der Übersicht der Unified Async API beschrieben.
urlstringPflichtPflicht, wenn callback angegeben ist. Nach dem Endzustand wird an diese URL gepostet; muss eine gültige http(s)-URL sein.
whenstringOptionalStandard: "final"Derzeit wird nur final unterstützt — Benachrichtigung bei success und fail.
finalstoragestringOptionalStandard: "temp"Speicherstufe für Artefakte: temp (Standard, ca. 7 Tage) oder persistent (langfristig, nach Größe abgerechnet). Bei unzureichendem Guthaben oder Überschreitung des Speicherlimits erfolgt ein stiller Downgrade auf temp; die wirksame Stufe steht in der Aufgaben-Detailantwort.
temppersistentAnfragebeispiele
# Asynchrone Aufgabe senden; gibt sofort eine taskId zurück (wartet nicht auf die Generierung)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "krea-3/text-to-image",
  "input": {
    "prompt": "…",
    "variant": "berry",
    "image_size": "square_hd",
    "output_format": "png",
    "reasoning_level": "medium"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "krea-3/text-to-image",
input: {
"prompt": "…",
"variant": "berry",
"image_size": "square_hd",
"output_format": "png",
"reasoning_level": "medium"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "krea-3/text-to-image",
"input": {
"prompt": "…",
"variant": "berry",
"image_size": "square_hd",
"output_format": "png",
"reasoning_level": "medium"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Aufgabendetails abrufen
https://api.hiapi.ai/v1/tasks/:id Antwortfelder
taskIdstringPflichtAufgaben-ID, stets mit Präfix tk-hiapi-.
modelstringPflichtAufgelöster vollständiger Modellname. Mit route-Parameter eingereichte Aufgaben geben base@route zurück (z. B. gpt-image-2/text-to-image@ext); sonst identisch mit dem übermittelten Namen.
routestringOptionalErscheint nur bei explizitem route-Parameter; gibt den übermittelten Wert zurück.
statusstringPflichtAufgabenstatus.
queued Eingereiht, noch nicht gestartet.
handling In Verarbeitung.
archiving Verarbeitung abgeschlossen, Artefakte werden vorbereitet.
success Endzustand: abgeschlossen, Artefakte verfügbar (output wird zurückgegeben).
fail Endzustand: fehlgeschlagen (error wird zurückgegeben).
Nach dem Senden den status prüfen: success und fail sind Endzustände, alles andere nicht. Alle 1–3 Sekunden bis zum Endzustand pollen. Nach Erfolg Artefakte aus output[].url laden und vor expireAt übertragen; für Langzeitaufbewahrung storage: "persistent" beim Erstellen angeben.
creatednumberPflichtZeitpunkt der Aufgabenerstellung (Unix-Sekunden).
completednumberPflichtUnix-Sekunden des Endzustands; vor Abschluss stets 0.
outputarrayOptional
Nur bei status == success. Artefaktliste — immer ein Array; eine Aufgabe kann mehrere Typen gleichzeitig liefern (z. B. video + first_frame).
Array [ object ]
Array-Elemente
urlstringPflichtArtefakt-URL, direkt herunterladbar.
typestringPflichtAktuell mögliche Werte: video, image, audio, first_frame, last_frame, thumbnail; später können weitere folgen.
expireAtnumberPflichtUnix-Sekunden, bis wann das Artefakt verfügbar ist; vorher herunterladen oder übertragen.
errorobjectOptional
Nur bei status == fail.
codestringPflichtBusiness-Fehlercode.
messagestringPflichtFehlerbeschreibung.
Antwortbeispiele
Erfolg
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In Bearbeitung (nicht final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fehlgeschlagen
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
kandinsky-6.0-pro/image-to-video auf HiAPI: Tutorial mit curl und Python
Eine funktionierende Bild-zu-Video-Anfrage auf HiAPI ausführen: vom Upload des ersten Frames über asynchrones Polling bis zum finalen Download
-

Vergleichstest
Recraft v4.1 Flash 文生图横向对比:Entwickler-Auswahl und Migrationsleitfaden
Mit Kosten von $0,01 pro Bild und reiner Text-zu-Bild-Fähigkeit beurteilen, ob es zu Ihrer Bildgenerierungs-Pipeline passt
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses
-

Tutorial
So rufen Sie kling-4.0/image-to-video auf HiAPI auf: curl, Python und Polling
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Vergleichstest
hailuo-2.3-fast/image-to-video im Quervergleich: Wie man Bild-zu-Video-Modelle auswählt und worauf bei der Migration zu achten ist
-

Tutorial
So nutzt du kling-4.0/text-to-video über die HiAPI-API: curl, Python und ein lauffähiges Anforderungsbeispiel
Ein praxisnaher Leitfaden für Entwickler: filmische Prompts, synchrones Audio, asynchrones Polling und Download der Ausgabe
Ähnliche Modelle
Alle Modelle ansehen →Gleicher Typ
-
 FASHN Tryon v1.6 FASHN $0.107 /Bild
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /Bild
-
 Grok Imagine Image 2.0 xAI $0.052 /Bild
-
 BRIA Product Shot Bria $0.058 /Bild
-
 Muse Image 1.0 Meta $0.015 per task
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /Bild
-
 Nano Banana Pro Google $0.057 /Bild
-
 Grok Imagine Quality xAI $0.070 /Bild
-
 Qwen Image 2.1 Alibaba $0.020 /Bild
-
 Wan 2.7 Image Alibaba $0.035 /Bild
-
 Ideogram V4 Ideogram $0.050 /Bild
-
 Qwen Image 3.0 Alibaba $0.036 /Bild
