
Black Forest Labs
FLUX.1 Schnell
flux-schnell/text-to-image
Modèle de génération d'images à partir de texte distillé de Black Forest Labs, transformer à flot rectifié de 12 milliards de paramètres, privilégiant une génération d'images rapide à faible latence, adapté à la génération par lots de concepts et d'esquisses
Essayer flux-schnell/text-to-image
Entrée
Créations
Voir toutes les créationsSortie
image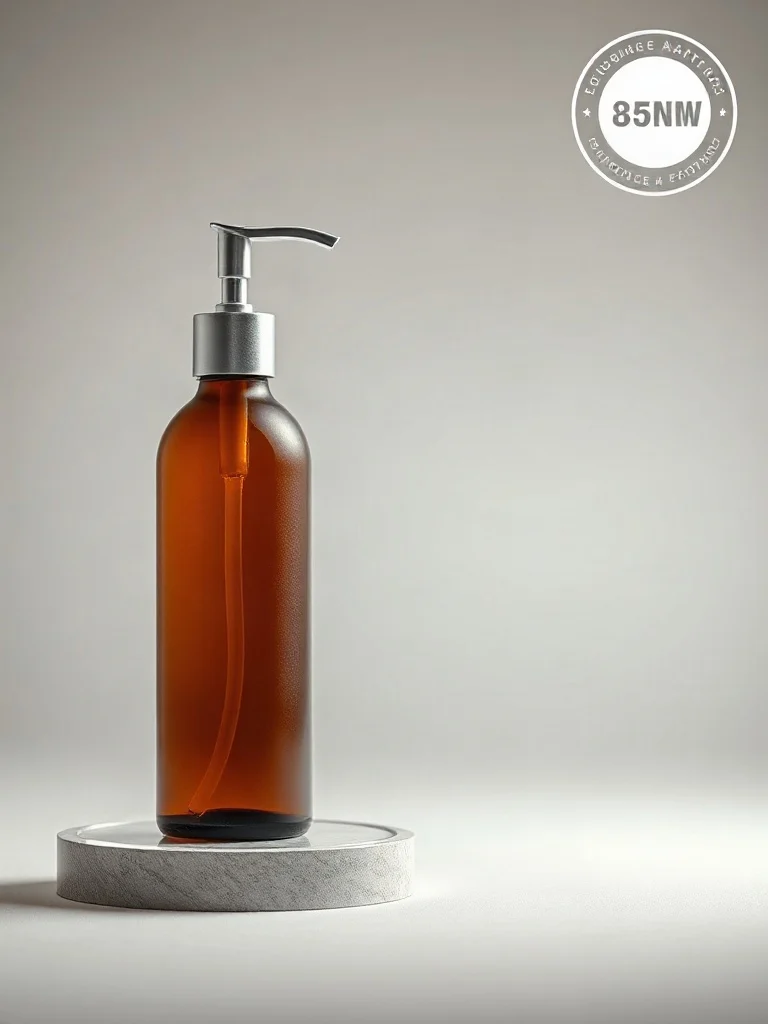
Rendu photo produit de qualité e-commerce avec FLUX.1-schnell
Style Image produit · ecommerce-studio · Lumière douce
Prompt
Photographie produit en studio, un flacon pompe en verre ambré mat avec collerette en métal brossé, posé légèrement à gauche sur un fond gris clair sans raccord, sur un discret plateau surélevé en acrylique. Une softbox en haut à gauche sert de lumière principale, un fin bandeau lumineux rasant le bord droit dessine un reflet de contour net, et un diffuseur au-dessus aplatit les reflets spéculaires sur le métal. Objectif équivalent 85 mm, faible profondeur de champ, mise au point sur l'étiquette, dégradé doux vers l'arrière-plan, balance des blancs neutre, rendu de retouche commerciale propre, espace négatif suffisant en haut à droite pour un badge e-commerce, composition 16:9.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
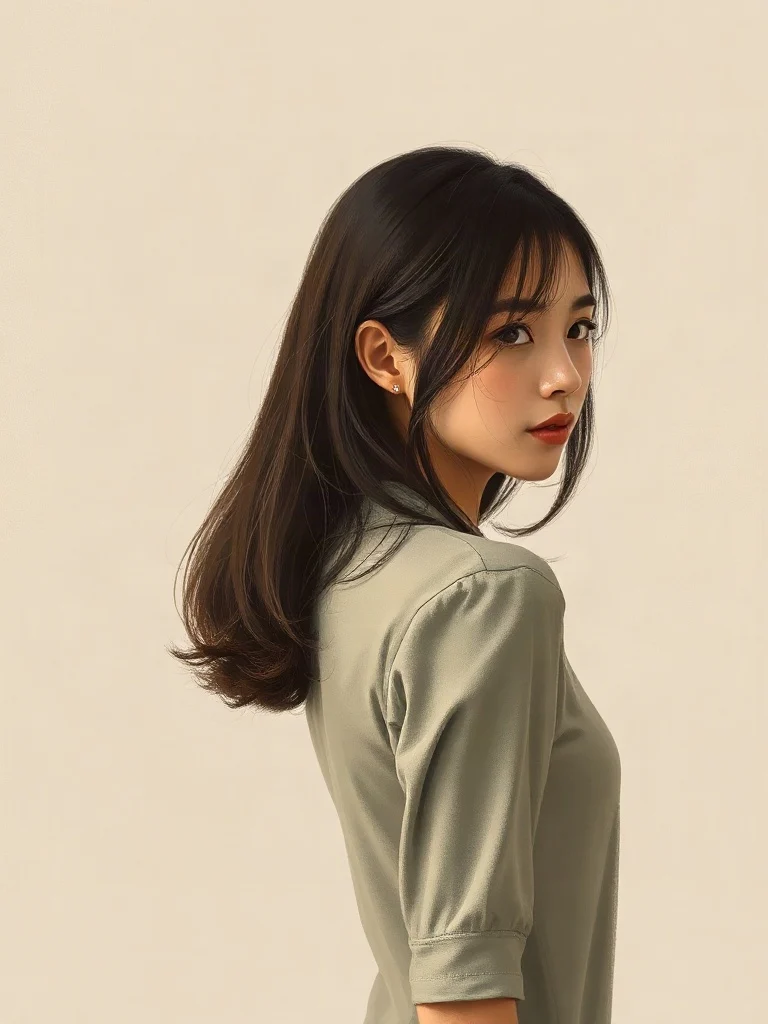
Spectre stylistique de FLUX.1-schnell : du portrait de jeune fille réaliste au portrait plat
Style Illustration · style-spectrum · portrait-de-personnage
Prompt
Portrait à mi-corps d'une jeune femme, de trois quarts dos tournant la tête, lumière douce de fenêtre venant de la gauche, fond gris chaud et sobre. Rendu dans un style de peinture réaliste : texture de coup de pinceau visible, sensation de transparence fine de la peau, cheveux dont chaque mèche se distingue, plis des vêtements avec de douces transitions d'ombre, palette naturelle peu saturée. Composition 16:9, personnage légèrement décentré, espace négatif généreux à droite.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
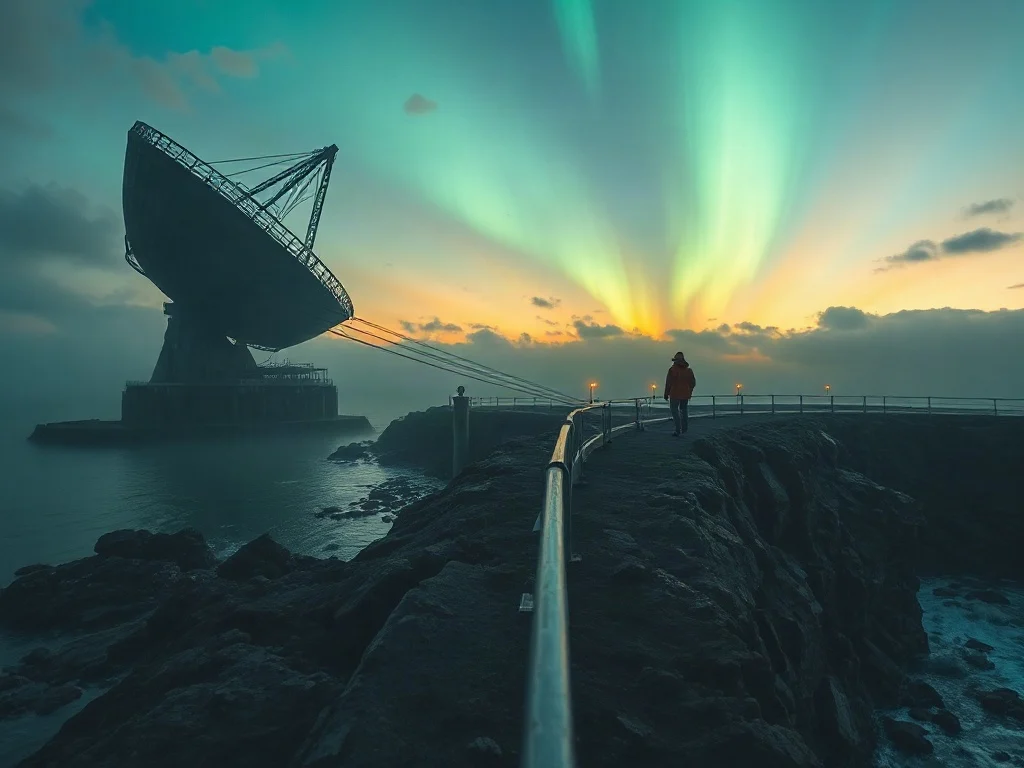
FLUX.1-schnell : concept art de scène d'univers
Style Art conceptuel · Construction de l'univers · Science-fiction
Prompt
Plan d'établissement en grand angle au rendu cinématographique, à l'heure du crépuscule, une station d'observation côtière abandonnée encastrée dans une falaise de roche volcanique, une immense antenne parabolique radioélectrique rongée par la rouille à demi immergée dans une mare de marée, de fins câbles tendus entre des pylônes en béton, au loin une aurore polaire infuse des teintes vertes et violettes dans de lourds nuages d'orage bas, le basalte humide reflète la lumière chaude de lampes au sodium, une silhouette solitaire vêtue d'une veste de sauvetage orange altérée par les intempéries marche sur la digue pour donner l'échelle, brumes atmosphériques stratifiées et embruns, palette douce de cyan-vert et d'ambre, rehauts froids en contre-jour, rayons volumétriques solennels, architecture à surfaces dures et textures rocheuses organiques finement détaillées, concept art photoréaliste, rendu d'objectif anamorphique 35 mm, faible profondeur de champ sur la rambarde au premier plan, composition 16:9, ligne d'horizon située au tiers inférieur de l'image
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
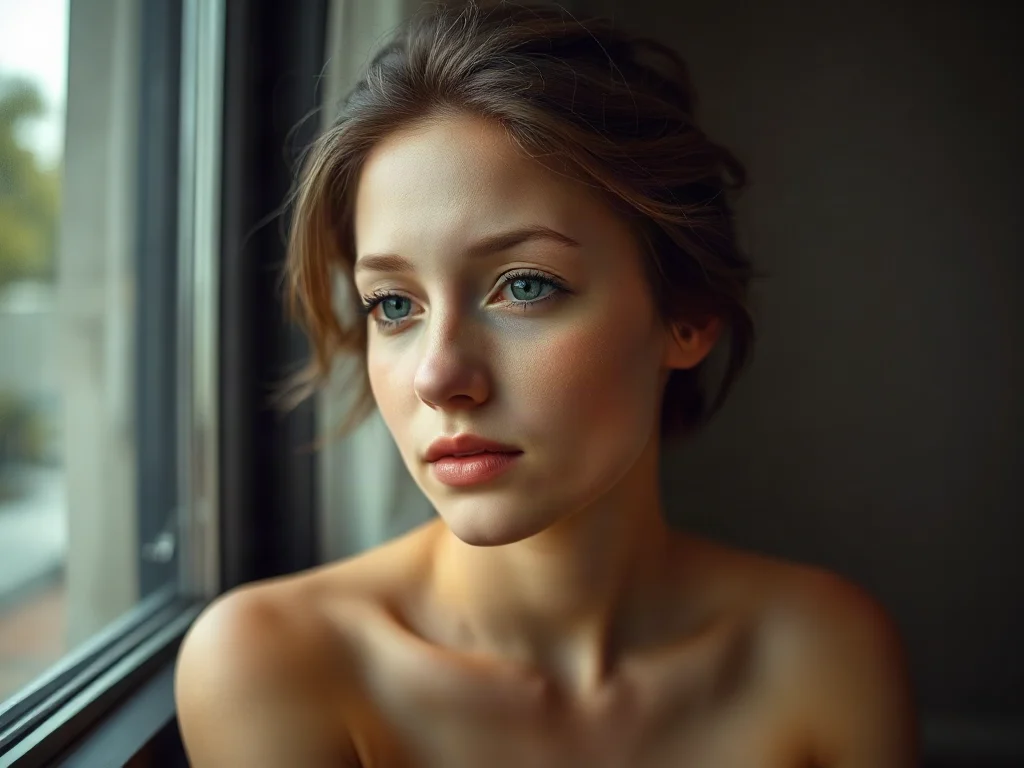
Démonstration de styles de portrait avec FLUX.1-schnell : réalisme et artisticité en comparaison
Style Portrait et photographie · Photoréalisme · Référence des prompts
Prompt
Portrait d'une jeune femme assise près d'une grande fenêtre, vue de trois quarts, regardant calmement l'objectif, texture de peau naturelle, pores et fins cheveux visibles, douce lumière du jour diffuse venant de la gauche, transition progressive et douce vers un arrière-plan intérieur gris chaud et feutré, faible profondeur de champ, rendu d'un objectif 85 mm, colorimétrie Kodak Portra, léger grain de film, exposition équilibrée, détails riches dans les yeux et les lèvres, sans retouche lourde, composition verticale 3:4, photographie.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
flux-schnell/text-to-image per image
| Prix unitaire | $0.005 |
|---|
Présentation
FLUX.1-schnell est un modèle de génération d'images à partir de texte lancé par Black Forest Labs. Il repose sur une architecture rectified flow transformer de 12 milliards de paramètres, optimisée par distillation, et permet de générer des images de haute qualité avec un nombre de pas d'inférence réduit, tout en offrant un bon équilibre entre le respect des prompts et le rendu des détails. Le modèle est accessible via l'interface unifiée de HiAPI.ai, ce qui le rend adapté aux développeurs et aux créateurs de contenu ayant besoin de produire rapidement des images conceptuelles ou des visuels.
Points clés
- Architecture distillée, génération rapide en peu de pas — la documentation officielle recommande 1 à 4 pas d'inférence pour achever la génération par débruitage, ce qui convient aux scénarios interactifs exigeant une grande réactivité.
- Bon compromis entre respect des prompts et rendu des détails — fondé sur un rectified flow transformer de 12 milliards de paramètres, il offre de bonnes performances en matière de détails d'image et d'alignement avec le prompt.
- Contrôle flexible du format et des proportions — prise en charge de cinq ratios d'image (1:1, 4:3, 3:4, 16:9, 9:16) et sortie au format jpeg ou png, pour s'adapter à différents besoins de mise en page.
Fonctionnalités
Génération d'images à partir de texte : il suffit de saisir un prompt textuel pour générer l'image correspondante, ce qui permet de transformer rapidement une description créative en visuel.
Réglage du nombre de pas d'inférence et du coefficient de guidage : il est possible de définir un nombre de pas d'inférence de 1 à 12 (1 à 4 pas recommandés par la documentation officielle) et un coefficient de guidage de 1 à 20, afin d'arbitrer selon les besoins entre rapidité et respect du prompt.
Reproductibilité des résultats via une graine fixe : en spécifiant une graine aléatoire, il est possible de reproduire un résultat avec les mêmes paramètres, ce qui facilite le débogage et la cohérence des tâches par lots.
Interrupteur de filtrage de sécurité du contenu : le contrôle de sécurité est activé par défaut, mais peut être désactivé si nécessaire, afin d'ajuster souplement la politique de contenu dans un environnement maîtrisé.
Cas d'usage
- Génération rapide de croquis conceptuels par les designers — saisir une description de scène ou de style pour produire rapidement plusieurs images conceptuelles, utiles aux échanges créatifs précoces et à la sélection de directions.
- Création d'applications de génération d'images à partir de texte par les développeurs — intégrer le modèle dans le flux de travail de leur propre produit afin de générer en temps réel des illustrations ou des visuels à partir des saisies des utilisateurs.
- Génération d'illustrations pour la création de contenu — produire en lot des illustrations aux proportions et formats spécifiés pour des articles, les réseaux sociaux ou d'autres usages, directement prêtes à être publiées.
Limites et conseils de sélection
Ce modèle prend uniquement en charge la génération d'images à partir de texte et ne couvre pas d'autres modalités telles que la vidéo ou le texte. En tant que version distillée, ses résultats peuvent être inférieurs à ceux d'un modèle non distillé dans des scénarios à prompts complexes ou exigeant une grande précision ; la sortie réelle dépend de la qualité du prompt, des paramètres d'échantillonnage et de l'environnement d'exécution. Si des capacités multimodales ou une génération d'images de plus haute précision sont nécessaires, il est recommandé d'évaluer d'autres modèles.
Questions fréquentes
Voir toutes les questions →-
À quelles tâches FLUX.1 [schnell] est-il principalement adapté ?
Modèle ultra-rapide et à faible coût en 1 à 4 étapes, adapté aux esquisses, à la génération d'images par lots et à l'exploration rapide de prompts.
-
FLUX.1 [schnell] prend-il en charge les images de référence ?
La ligne actuelle est de la génération d'images purement textuelle et n'accepte pas d'images de référence.
-
Quelles spécifications de sortie sont prises en charge ?
La page actuelle affiche 1-12 inference steps et les formats 1:1, 16:9, 9:16, 4:3, 3:4 ; les options finales dépendent des paramètres du Playground.
-
Comment la facturation de FLUX.1 [schnell] fonctionne-t-elle ?
La facturation est basée sur le nombre d'images générées avec succès ; toute différence selon la résolution ou le niveau de qualité est indiquée dans le prix en temps réel affiché sur la page.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : flux-schnell/text-to-image
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour flux-schnell/text-to-image et la route default — voir le tableau des paramètres ci-dessous.
seedintegerOptionnelGraine aléatoire permettant de reproduire le résultat de génération ; en fournissant la même graine, vous obtenez une sortie identique.
promptstringRequisInvite textuelle utilisée pour la génération d'image.
aspect_ratiostringOptionnelDéfaut: "4:3"Rapport largeur/hauteur de l'image de sortie, 4:3 par défaut.
1:14:33:416:99:16output_formatstringOptionnelDéfaut: "jpeg"Format de l'image de sortie, jpeg par défaut.
jpegpngguidance_scalenumberOptionnelDéfaut: 3.5min 1max 20Contrôle le degré de respect de l'invite par le résultat généré, 3.5 par défaut.
num_inference_stepsintegerOptionnelDéfaut: 4min 1max 12Nombre d'étapes de débruitage, 4 par défaut ; pour le modèle schnell, il est recommandé de choisir entre 1 et 4.
enable_safety_checkerbooleanOptionnelDéfaut: trueIndique si le filtrage de sécurité du contenu est activé, true par défaut.
callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "flux-schnell/text-to-image",
  "input": {
    "prompt": "…",
    "aspect_ratio": "4:3",
    "output_format": "jpeg",
    "guidance_scale": 3.5,
    "num_inference_steps": 4,
    "enable_safety_checker": true
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "flux-schnell/text-to-image",
input: {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": true
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "flux-schnell/text-to-image",
"input": {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": True
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat
-

Tutoriel
Comment appeler kling-4.0/image-to-video sur HiAPI : curl, Python et interrogation périodique
-

Tutoriel
Tutoriel pour kandinsky-6.0-pro/image-to-video sur HiAPI : curl + Python
Lancer une requête image-vers-vidéo exploitable sur HiAPI : de l'envoi de la première image à l'interrogation asynchrone jusqu'au téléchargement final
-

Tutoriel
Comment utiliser kling-4.0/text-to-video via l'API HiAPI : curl, Python et un exemple de requête fonctionnel
Guide pratique pour les développeurs : prompts cinématographiques, audio synchronisé, interrogation asynchrone et téléchargement des sorties
Modèles associés
Voir tous les modèles →Même type
-
 BRIA Product Shot Bria $0.058 /image
-
 Qwen Image 2.1 Alibaba $0.020 /image
-
 FLUX 3 Image Black Forest Labs $0.041 /image
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /image
-
 FASHN Tryon v1.6 FASHN $0.107 /image
-
 Grok Imagine Quality xAI $0.070 /image
-
 Wan 2.7 Image Alibaba $0.035 /image
-
 Krea 2 Medium Turbo Krea $0.021 /image
-
 Recraft Crisp Upscale Recraft $0.004 /image
-
 Seedream 4.5 ByteDance $0.045 /image
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /image
-
 851 Labs Background Remover 851 Labs $0.002 /image
Même fournisseur
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /image
- FLUX.1 Kontext Max Black Forest Labs $0.071 /image
- FLUX 3 Image Black Forest Labs $0.041 /image
-
 FLUX.2 Black Forest Labs $0.035 /image
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /image
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /image
-
 FLUX 3 Max Black Forest Labs $0.061 /seconde
- FLUX 1.1 Pro Black Forest Labs $0.050 /image
-
 FLUX 3 Video Black Forest Labs $0.090 /seconde