
Black Forest Labs
FLUX.1 Schnell
flux-schnell/text-to-image
Modelo de texto para imagem destilado da Black Forest Labs, transformer de fluxo retificado com 12 bilhões de parâmetros, focado em geração rápida de imagens com baixa latência, adequado para produção em lote de concept art e esboços
Experimentar flux-schnell/text-to-image
Entrada
Criações
Ver todas as criaçõesSaída
image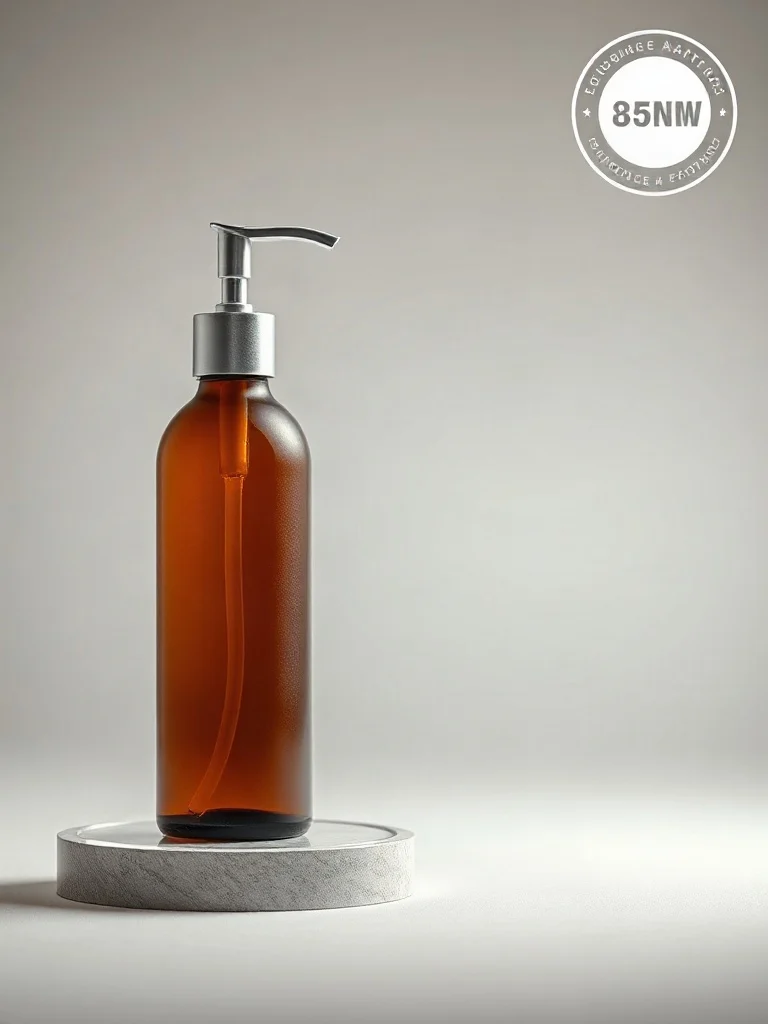
Geração de imagens com qualidade de fotografia de produto de nível e-commerce usando FLUX.1-schnell
Estilo Imagem do produto · ecommerce-studio · Luz suave
Prompt
Fotografia de produto em estúdio, um frasco de vidro âmbar fosco com bomba dosadora, com colar de metal escovado, posicionado ligeiramente à esquerda sobre um fundo cinza claro sem emendas, apoiado sobre uma base elevatória de acrílico discreta. Um softbox no canto superior esquerdo atua como luz principal, uma faixa de luz estreita à direita incide obliquamente sobre a borda direita criando um realce de contorno nítido, e um difusor suave no topo aplana os reflexos especulares no metal. Lente equivalente a 85mm, profundidade de campo rasa, foco no rótulo, transição suave para o fundo, balanço de branco neutro, aspecto de retoque comercial limpo, espaço negativo amplo no canto superior direito para o selo de e-commerce, composição 16:9.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
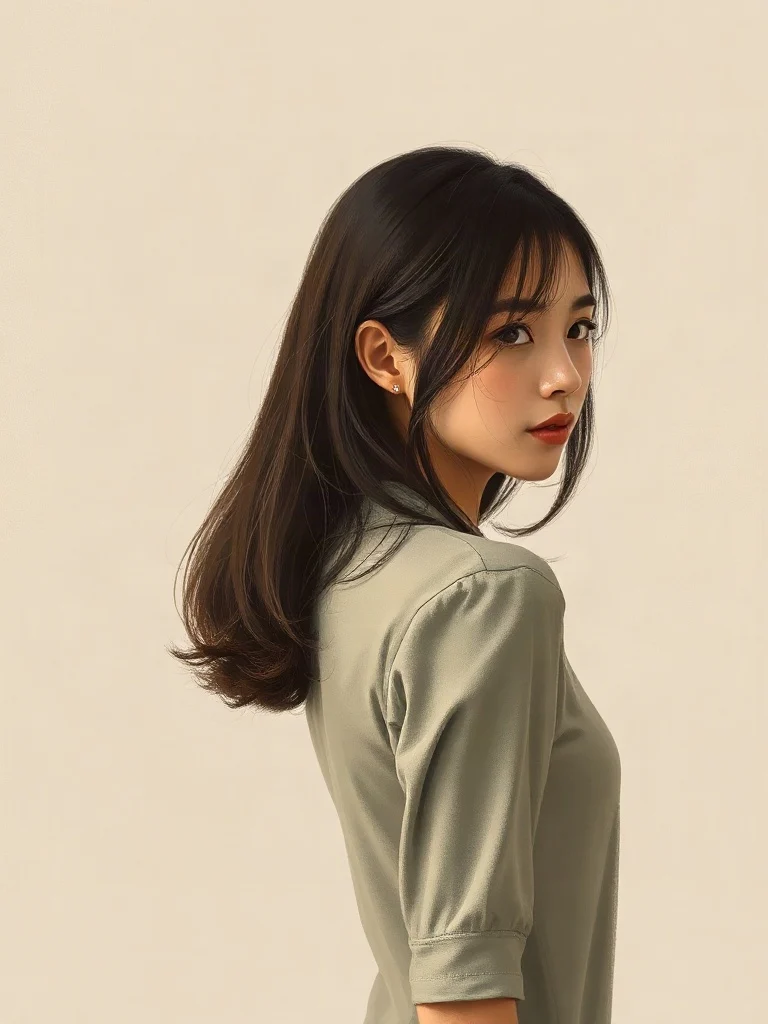
Espectro de estilos do FLUX.1-schnell: retratos de garota do realismo ao estilo flat
Estilo Ilustração · style-spectrum · character-portrait
Prompt
Retrato de meio corpo de uma jovem mulher, olhando para trás por cima do ombro, luz suave de janela entrando pela esquerda, fundo cinza-quente e sóbrio. Apresentado em estilo de pintura realista: textura de pinceladas visível, pele delicada e translúcida, fios de cabelo nítidos um a um, dobras da roupa com transições suaves de sombra, tons naturais de baixa saturação. Composição 16:9, figura ligeiramente deslocada do centro, com amplo espaço negativo à direita.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
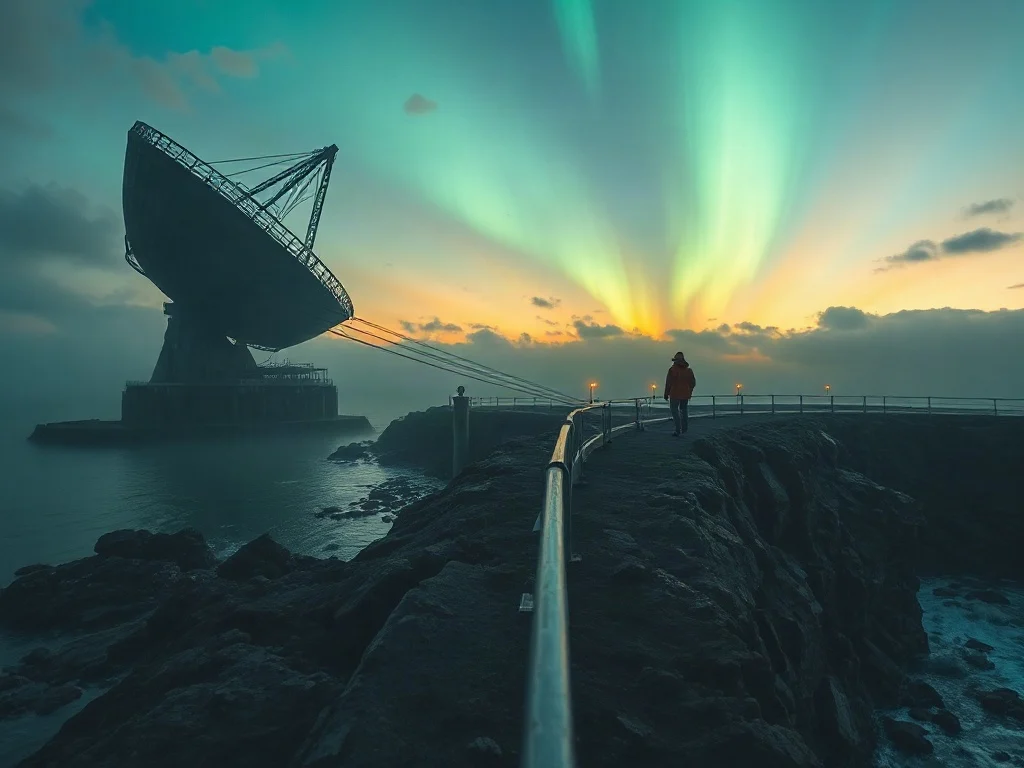
Concept art de cena de universo fictício com FLUX.1-schnell
Estilo Arte conceitual · Construção de mundo · Ficção científica
Prompt
Plano geral cinematográfico de estabelecimento, ao crepúsculo, uma estação de observação costeira abandonada incrustada em falésias de rocha vulcânica, uma enorme antena parabólica de rádio corroída meio submersa em uma piscina de maré, cabos finos esticados entre torres de concreto, auroras ao longe infiltram verde e roxo nas nuvens de tempestade baixas, basalto úmido reflete luzes de sódio quentes, uma figura solitária vestindo uma jaqueta salva-vidas laranja desgastada caminha na passarela como referência de escala, névoa atmosférica em camadas e espuma do mar, tons suaves de ciano-esverdeado e âmbar, com luz de contorno fria, feixes volumétricos divinos, arquitetura de superfície dura altamente detalhada e texturas de rocha orgânica, arte conceitual fotorrealista, visual de lente anamórfica 35mm, profundidade de campo rasa no corrimão em primeiro plano, composição 16:9, linha do horizonte no terço inferior do quadro
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
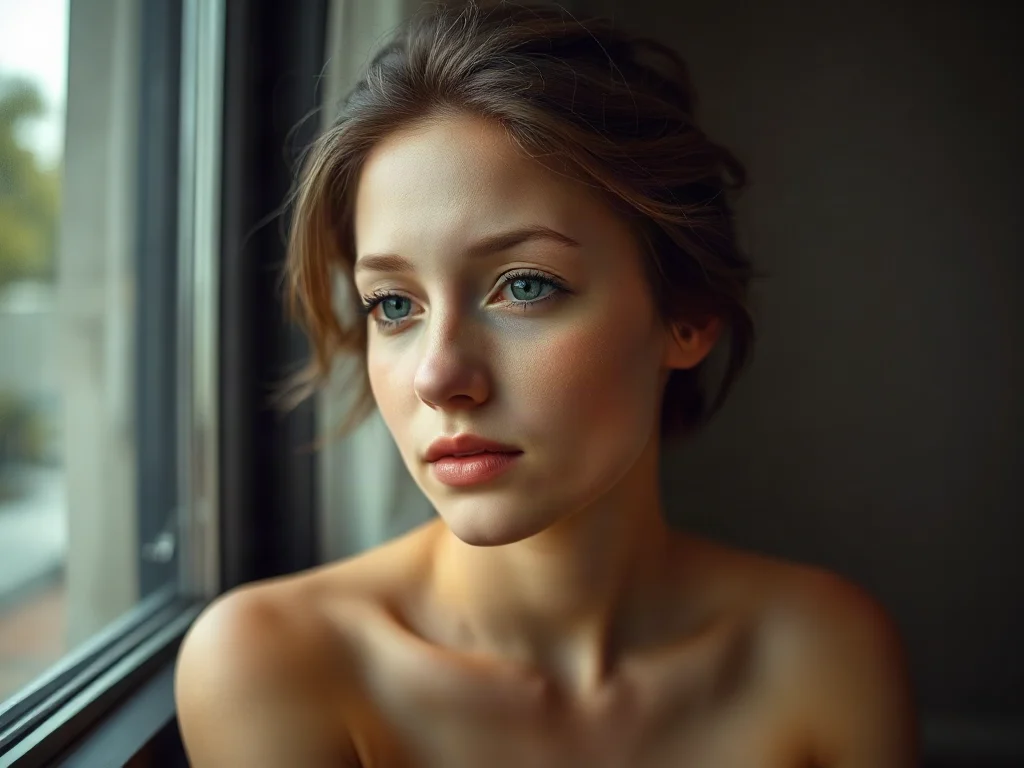
Demonstração de estilo de retrato com FLUX.1-schnell: comparação entre realismo e artisticidade
Estilo Retrato e fotografia · Fotorrealismo · Referência de prompts
Prompt
Retrato de uma jovem sentada ao lado de uma grande janela, vista em três quartos, olhando calmamente para a câmera, textura de pele natural, poros visíveis e fios de cabelo finos, luz do dia difusa e suave entrando pela esquerda, transicionando gradualmente para um fundo interior em tons de cinza quente discretos, profundidade de campo rasa, sensação de lente 85mm, estilo de cor Kodak Portra, grão de filme sutil, exposição equilibrada, detalhes ricos nos olhos e lábios, sem retoque pesado, composição vertical 3:4, fotografia.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
flux-schnell/text-to-image per image
| Preço unitário | $0.005 |
|---|
Posicionamento e visão geral
O FLUX.1-schnell é um modelo de geração de imagens a partir de texto lançado pela Black Forest Labs, que utiliza uma arquitetura rectified flow transformer com 12 bilhões de parâmetros, otimizada por destilação, capaz de gerar imagens de alta qualidade com um número reduzido de etapas de inferência, oferecendo um bom equilíbrio entre aderência ao prompt e riqueza de detalhes. O modelo pode ser acessado por meio da interface unificada do HiAPI.ai, sendo adequado para desenvolvedores e cenários de criação de conteúdo que precisam produzir rapidamente esboços conceituais e materiais visuais.
Destaques principais
- Arquitetura destilada, geração rápida com poucas etapas — a recomendação oficial é de 1 a 4 etapas de inferência para concluir a geração por remoção de ruído, ideal para cenários interativos que exigem velocidade de resposta.
- Aderência ao prompt aliada à riqueza de detalhes — baseado em um rectified flow transformer de 12 bilhões de parâmetros, apresenta bom desempenho tanto nos detalhes da imagem quanto no alinhamento com o prompt.
- Controle flexível de proporção e formato de saída — suporta cinco proporções (1:1, 4:3, 3:4, 16:9 e 9:16) e saída em jpeg ou png, facilitando a adaptação a diferentes necessidades de layout.
Descrição das capacidades
Geração de imagem a partir de texto: basta inserir um prompt textual para gerar a imagem correspondente, ideal para transformar rapidamente descrições criativas em materiais visualizáveis.
Ajuste do número de etapas de inferência e do coeficiente de orientação: é possível definir de 1 a 12 etapas de inferência (recomendação oficial: 1 a 4 etapas) e um coeficiente de orientação de 1 a 20, equilibrando velocidade e aderência ao prompt conforme a necessidade.
Reprodutibilidade com semente fixa: ao especificar uma semente aleatória, é possível reproduzir o resultado da geração com os mesmos parâmetros, facilitando a depuração e o gerenciamento de consistência em tarefas em lote.
Chave de filtragem de segurança de conteúdo: a verificação de segurança é ativada por padrão, mas pode ser desativada conforme necessário, permitindo ajustar com flexibilidade a política de conteúdo em ambientes controlados.
Cenários de aplicação
- Geração rápida de esboços conceituais por designers — ao inserir uma descrição de cena ou estilo, é possível produzir rapidamente vários esboços conceituais para comunicação criativa inicial e seleção de direções.
- Desenvolvimento de aplicativos de geração de imagens por texto por desenvolvedores — integrar o modelo ao fluxo de trabalho do próprio produto para gerar imagens ou materiais visuais em tempo real conforme a entrada do usuário.
- Geração de imagens de apoio em criação de conteúdo — gerar em lote imagens de apoio para artigos, redes sociais e outros cenários, com proporção e formato especificados, prontas para publicação.
Limitações e recomendações de seleção
Este modelo suporta apenas geração de imagem a partir de texto, não abrangendo outras modalidades, como vídeo ou texto. Por ser uma versão destilada, em cenários com prompts complexos ou requisitos de alta precisão, o desempenho pode ser inferior ao de modelos não destilados; a saída real é influenciada pela qualidade do prompt, pelos parâmetros de amostragem e pelo ambiente de execução. Caso sejam necessárias capacidades multimodais ou geração de imagens com maior precisão, recomenda-se avaliar outros modelos.
Perguntas frequentes
Ver todas as perguntas →-
Para quais tarefas o FLUX.1 [schnell] é principalmente adequado?
Modelo ultrarrápido e de baixo custo, com 1 a 4 etapas, adequado para esboços, geração de imagens em lote e exploração rápida de prompts.
-
O FLUX.1 [schnell] suporta imagem de referência?
A rota atual é somente texto para imagem e não aceita imagem de referência.
-
Quais especificações de saída são suportadas?
A página atual exibe 1-12 inference steps e 1:1, 16:9, 9:16, 4:3, 3:4; as opções finais estão sujeitas aos parâmetros do Playground.
-
Como é cobrado o FLUX.1 [schnell]?
Cobrado pelo número de imagens geradas com sucesso; eventuais diferenças por resolução ou nível de qualidade são exibidas no preço em tempo real na página.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: flux-schnell/text-to-image
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para flux-schnell/text-to-image e a rota default — veja a tabela de parâmetros abaixo.
seedintegerOpcionalSemente aleatória para reproduzir o resultado da geração; passar a mesma semente produz uma saída consistente.
promptstringObrigatórioPrompt de texto usado para a geração da imagem.
aspect_ratiostringOpcionalPadrão: "4:3"Proporção da imagem de saída, padrão 4:3.
1:14:33:416:99:16output_formatstringOpcionalPadrão: "jpeg"Formato da imagem de saída, padrão jpeg.
jpegpngguidance_scalenumberOpcionalPadrão: 3.5min 1max 20Controla o grau de aderência do resultado ao prompt, padrão 3.5.
num_inference_stepsintegerOpcionalPadrão: 4min 1max 12Número de etapas de remoção de ruído, padrão 4; para o modelo schnell recomenda-se 1-4.
enable_safety_checkerbooleanOpcionalPadrão: trueSe a filtragem de segurança de conteúdo está habilitada, padrão true.
callbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "flux-schnell/text-to-image",
  "input": {
    "prompt": "…",
    "aspect_ratio": "4:3",
    "output_format": "jpeg",
    "guidance_scale": 3.5,
    "num_inference_steps": 4,
    "enable_safety_checker": true
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "flux-schnell/text-to-image",
input: {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": true
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "flux-schnell/text-to-image",
"input": {
"prompt": "…",
"aspect_ratio": "4:3",
"output_format": "jpeg",
"guidance_scale": 3.5,
"num_inference_steps": 4,
"enable_safety_checker": True
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar kling-4.0/image-to-video na HiAPI: curl, Python e polling
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado
-

Tutorial
Como usar kling-4.0/text-to-video através da API HiAPI: curl, Python e um exemplo de requisição executável
Guia prático para desenvolvedores: prompts cinematográficos, áudio sincronizado, polling assíncrono e download da saída
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video na HiAPI: curl + Python
Faça uma requisição de imagem para vídeo funcional na HiAPI: do upload do primeiro quadro ao polling assíncrono e ao download final
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 Z-Image Alibaba $0.008 /imagem
-
 Google Virtual Try-On Google $0.107 /imagem
-
 Recraft V4.1 Recraft $0.010 /imagem
-
 Ideogram V4 Ideogram $0.050 /imagem
-
 Nano Banana Pro Google $0.057 /imagem
-
 FLUX 3 Image Black Forest Labs $0.041 /imagem
-
 FIBO 1.5 Bria $0.058 /imagem
-
 Grok Imagine Quality xAI $0.070 /imagem
-
 Nano Banana 2 Lite Google $0.033 /imagem
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /imagem
-
 Ideogram V4.5 Ideogram $0.011 /imagem
-
 Grok Imagine Image 2.0 xAI $0.052 /imagem
Mesmo provedor
-
 FLUX.2 Black Forest Labs $0.035 /imagem
- FLUX 3 Image Black Forest Labs $0.041 /imagem
-
 FLUX 3 Max Black Forest Labs $0.061 /segundo
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagem
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /imagem
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /imagem
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /imagem
-
 FLUX 3 Video Black Forest Labs $0.090 /segundo
- FLUX.2 Klein 9B Black Forest Labs $0.0086 /imagem