
Veo 3.1
veo-3.1/image-to-video
Modèle de génération vidéo de Google : à partir d'une image en entrée, il génère nativement une vidéo de 8 secondes avec son ambiant et dialogues, jusqu'à la 4K, tout en préservant la cohérence de l'apparence du sujet
Essayer veo-3.1/image-to-video
Entrée
Créations
Voir toutes les créationsSortie
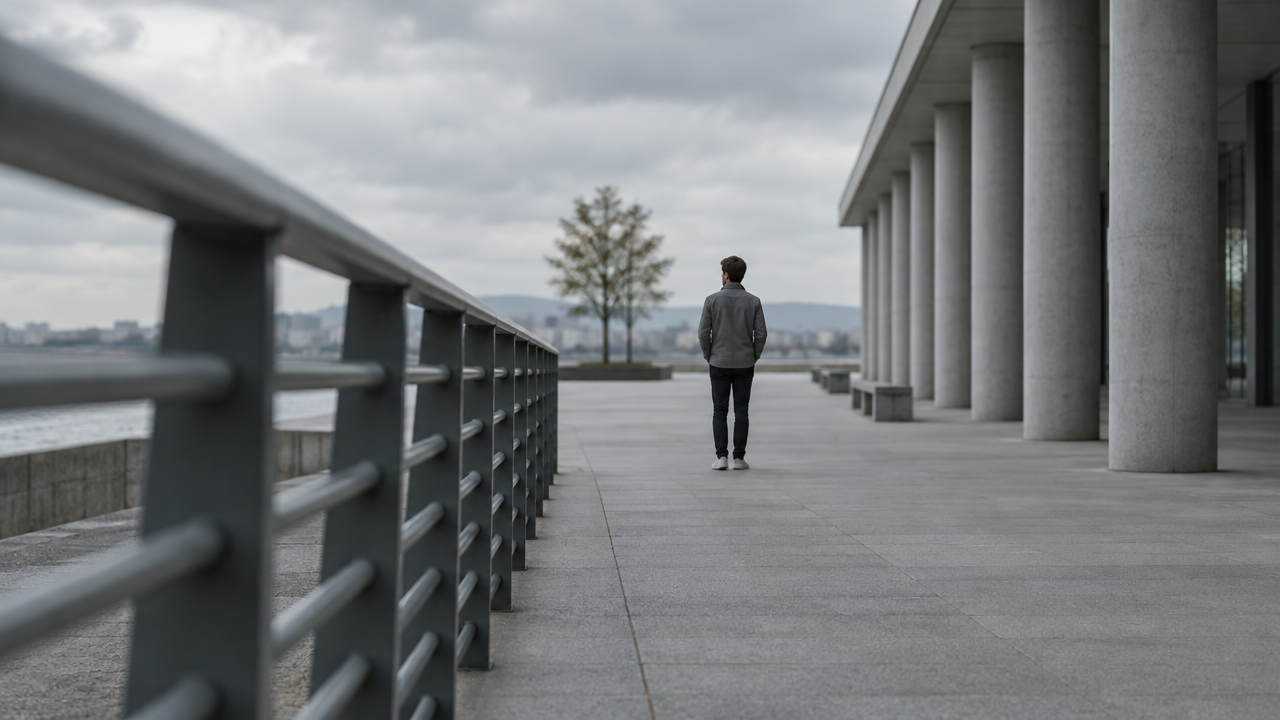
videoNotes visuelles de mouvement de caméra : démonstration du langage cinématographique pour la génération vidéo à partir d'image
Style Mouvement de caméra · Storyboard · grammaire-cinématographique
Entrées de référence
image_url
Prompt
Animez l'image fixe avec un travelling avant lent et délibéré : la caméra avance à vitesse constante le long de l'axe de l'objectif, en gardant l'horizon horizontal et le sujet centré ; à mesure que la profondeur de champ se comprime, les éléments du premier plan créent progressivement un effet de parallaxe. Léger traitement anti-tremblement sans caméra à l'épaule, sans pompage de zoom, sans distorsion de perspective. Conservez l'éclairage neutre et cinématographique de l'image source, avec une profondeur de champ faible qui se resserre progressivement. Étalonnage aux couleurs désaturées, bords de l'image propres, flou de mouvement cohérent avec un objectif 35 mm. Qualité d'une démonstration pédagogique de mouvement de caméra, un seul plan-séquence continu, sans montage.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
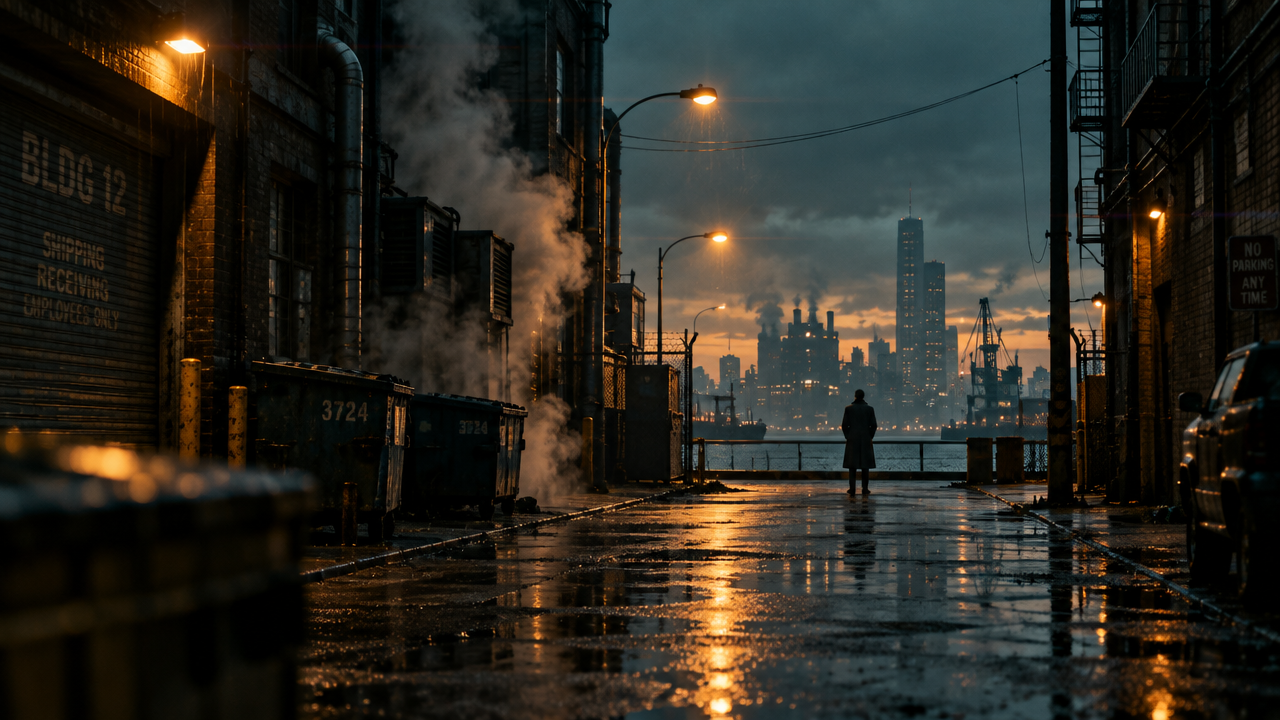
Visualisation de concept de storyboard : du texte à l'image clé puis au mouvement de caméra
Style Storyboard · Cinématographique · Image vers vidéo
Entrées de référence
image_url
Prompt
Transformer une seule image clé cinématographique en un mouvement de caméra lent et maîtrisé : un léger travelling avant depuis un plan large d'ensemble vers le sujet, avec un subtil parallaxe de la poussière et de la brume flottante au premier plan. Conserver la composition et l'étalonnage d'origine, maintenir une faible profondeur de champ, et faire varier la lumière doucement comme le passage d'ombres nuageuses. Le vent ambiant et le bruit de fond lointain d'intérieur soutiennent la scène ; sans montage, sans superposition de texte, avec un rythme régulier sur huit secondes.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
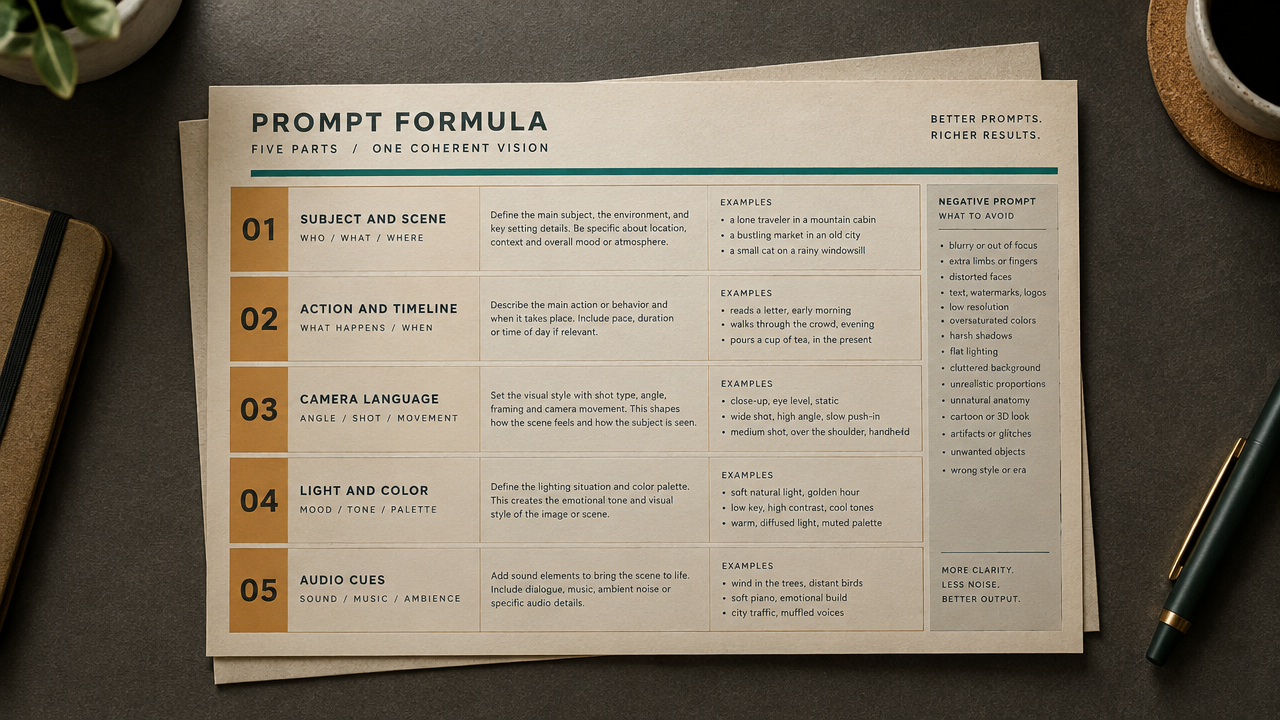
Fiche de formules de prompts image-to-video pour Veo 3.1
Style Ingénierie de prompt · Explication · Design dynamique
Entrées de référence
image_url
Prompt
Un plan unique en travelling continu, en plongée, sur une fiche de formules de prompts étalée à plat sur un bureau gris graphite chaud. La fiche adopte un style éditorial propre et net, avec cinq lignes de contenu étiquetées — sujet et scène, action et chronologie, langage caméra, lumière et couleurs, indices audio — composées dans une police sans empattement précise, ainsi qu'une petite colonne de negative prompts sur le côté droit. La caméra glisse vers l'avant à une vitesse lente et constante, créant un léger parallaxe au-dessus des bords des feuilles superposées, sans montage ni mouvement brusque. Une lumière principale douce et diffuse provient du coin supérieur gauche et s'atténue délicatement vers les coins ; l'ensemble baigne dans des tons ambre et blanc cassé peu saturés, avec une ligne d'accent cyan. Une faible profondeur de champ garde le centre de la fiche net tandis que le bureau devient flou. Seul un bruit de fond intérieur ambiant, calme et concentré, adapté à une narration documentaire ou pédagogique.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Diagramme des paramètres image-vers-vidéo de Veo 3.1 : démonstration en plan unique
Style Image vers vidéo · Explication technique · Démonstration du produit
Entrées de référence
image_url
Prompt
Transformer une image statique en une animation cinématographique à travelling avant, lente et maîtrisée. La caméra dérive vers l'avant à un rythme régulier, avec de légers micro-mouvements de type caméra à l'épaule, de sorte que le sujet reste toujours au centre du cadre et nettement mis au point. La lumière ambiante varie légèrement dans la scène, de fines particules flottent dans l'image. Faible profondeur de champ, flou de mouvement naturel, étalonnage cinématographique, rendu à 24 fps. Aucun montage, aucune secousse de caméra brutale, un seul plan-séquence continu.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
veo-3.1/image-to-video per second
Présentation
Le parcours image-vers-vidéo de Veo 3.1 est la version pilotée par image du modèle de génération vidéo de Google sur HiAPI.ai : il reçoit une image et une invite textuelle, et produit une vidéo animée avec une piste audio native. Il excelle à contrôler le mouvement de caméra et l'évolution de la scène tout en préservant l'apparence du sujet de l'image d'entrée ; il convient aux développeurs qui doivent transformer rapidement des visuels statiques en clips lisibles, pour la publicité, les réseaux sociaux et le prévisualisation de concepts.
Points clés
- Génération native synchronisée image-son — la vidéo est générée avec les sons d'ambiance, les dialogues et les effets sonores, ce qui réduit les étapes de doublage et de synthèse sonore en post-production.
- Résolution jusqu'à 4K en option — la sortie prend en charge 720p, 1080p et 4k, avec un cadrage 16:9 ou 9:16 automatiquement aligné sur l'image d'entrée ou spécifié manuellement.
- Durée et audio contrôlables — la durée est réglable sur 4, 6 ou 8 secondes, la piste audio peut être activée ou désactivée, ce qui permet d'ajuster les spécifications selon le canal de diffusion et le budget.
- Prise en charge des invites négatives et des graines fixes — negative_prompt permet d'exclure des éléments indésirables, et seed permet de reproduire des résultats de génération similaires.
Description des capacités
Génération d'animation pilotée par image : à partir d'une image et d'une invite décrivant le mouvement (jusqu'à 20000 caractères), le modèle produit un clip vidéo de 4 à 8 secondes, idéal pour convertir directement des visuels existants en contenu animé.
Génération de piste audio native : l'audio natif est généré par défaut ; désactiver generate_audio permet d'obtenir une vidéo muette, utile pour ajouter soi-même musique ou doublage en post-production.
Contrôle de la résolution et du cadrage : la sortie peut être spécifiée en 720p, 1080p ou 4k, et le cadrage peut suivre automatiquement l'image d'entrée ou être forcé en 16:9 ou 9:16, pour s'adapter aux diffusions horizontales et verticales.
Contrôle des résultats de génération : negative_prompt décrit les contenus à éviter, et seed fixe la graine aléatoire, ce qui facilite la stabilité stylistique ou les comparaisons A/B lors de générations par lots.
Cas d'usage
- Les équipes marketing transforment des photos produit en spots publicitaires — en saisissant une image statique du produit et une description du mouvement, elles obtiennent un clip horizontal en 4K ou 1080p, directement utilisable pour la publicité en ligne et la présentation sur le site web.
- Les community managers créent des contenus animés verticaux — avec une image verticale et une invite, ils génèrent une vidéo 9:16 avec sons natifs, à publier comme matériel sur les plateformes de vidéos courtes.
- La préproduction cinématographique transforme des concept arts en prévisualisations animées — les storyboards ou les designs conceptuels sont générés en clips animés, ce qui aide l'équipe à valider le mouvement de caméra et l'ambiance avant la production finale.
- Les développeurs génèrent des ressources animées par lots — dans un pipeline programmatique, ils fournissent images et invites, et produisent par lots, avec seed, des clips au style homogène pour des tests ou du remplissage de contenu.
Limites et conseils de sélection
La durée maximale d'une génération est de 8 secondes ; une narration plus longue nécessite une génération par segments puis un assemblage, et la cohérence entre plusieurs plans reste à orchestrer manuellement. L'image d'entrée est idéalement en 720p ou plus et au format 16:9 ou 9:16 ; les autres ratios sont recadrés. La résolution et l'activation de l'audio influent sur la facturation : il est conseillé de faire un essai à faible spécification avant les générations par lots. Pour construire une scène à partir de zéro plutôt que d'animer une image existante, il faut choisir le parcours texte-vers-vidéo de la même famille.
Questions fréquentes
Voir toutes les questions →-
Quel type de modèle vidéo est Veo 3.1 Text to Video ?
Il s'agit d'une solution de génération de vidéo à partir de texte uniquement : il suffit d'un Prompt textuel, sans besoin de téléverser une image de départ.
-
Quelles sont les spécifications de sortie prises en charge par Veo 3.1 Text to Video ?
Durée de 4 à 8 secondes, résolutions 720p, 1080p et 4k, formats d'image 16:9 et 9:16.
-
Peut-on générer de la voix ou utiliser une référence audio ?
La génération audio est activée par défaut
-
Comment Veo 3.1 Text to Video est-il facturé ?
La facturation est basée sur la durée de sortie et le niveau en temps réel ; les différences dues à la résolution, au mode ou aux options audio sont déterminées par le prix affiché sur la page et l'historique des tâches.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : veo-3.1/image-to-video
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour veo-3.1/image-to-video et la route default — voir le tableau des paramètres ci-dessous.
seedintegerOptionnelGraine aléatoire permettant de reproduire le résultat de la génération ; en utilisant la même graine, vous obtenez une sortie identique.
promptstringRequisminLength 1maxLength 20000Invite textuelle décrivant de quelle manière l'image d'entrée doit s'animer.
durationintegerRequisDéfaut: 8min 4max 8Durée de la vidéo générée (en secondes) ; le coût augmente avec la durée ; 8 secondes par défaut.
468image_urlstringRequisURL de l'image d'entrée à animer ; il est recommandé d'utiliser une résolution de 720p ou plus et un format 16:9 ou 9:16, les autres formats seront recadrés.
resolutionstringRequisDéfaut: "720p"Résolution de la vidéo de sortie ; plus la résolution est élevée, plus le coût est important ; 720p par défaut.
720p1080p4kaspect_ratiostringOptionnelDéfaut: "auto"Rapport largeur/hauteur de la vidéo de sortie ; auto par défaut, ce qui signifie qu'il suit le rapport largeur/hauteur de l'image d'entrée.
auto16:99:16generate_audiobooleanOptionnelDéfaut: trueIndique s'il faut générer une piste audio native ; lorsque cette option est activée, la tarification est plus élevée ; activée par défaut.
negative_promptstringOptionnelInvite négative décrivant le contenu à éviter dans la vidéo générée.
callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "veo-3.1/image-to-video",
  "input": {
    "prompt": "…",
    "duration": 8,
    "image_url": "…",
    "resolution": "720p",
    "aspect_ratio": "auto",
    "generate_audio": true
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "veo-3.1/image-to-video",
input: {
"prompt": "…",
"duration": 8,
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "auto",
"generate_audio": true
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "veo-3.1/image-to-video",
"input": {
"prompt": "…",
"duration": 8,
"image_url": "…",
"resolution": "720p",
"aspect_ratio": "auto",
"generate_audio": True
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Comment utiliser kling-4.0/text-to-video via l'API HiAPI : curl, Python et un exemple de requête fonctionnel
Guide pratique pour les développeurs : prompts cinématographiques, audio synchronisé, interrogation asynchrone et téléchargement des sorties
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat
-

Tutoriel
Tutoriel pour kandinsky-6.0-pro/image-to-video sur HiAPI : curl + Python
Lancer une requête image-vers-vidéo exploitable sur HiAPI : de l'envoi de la première image à l'interrogation asynchrone jusqu'au téléchargement final
-

Tutoriel
Comment appeler kling-4.0/image-to-video sur HiAPI : curl, Python et interrogation périodique
Modèles associés
Voir tous les modèles →Même type
-
 Kandinsky 6.0 Pro $1.93 /vidéo
-
 Creatify Boreal Creatify $0.015 /seconde
-
 Wan 2.7 Video Alibaba $0.100 /seconde
-
 LTX 2.5 Fast Lightricks $0.086 /seconde
-
 Seedance 2.0 ByteDance $0.017 /seconde
-
 PixVerse V6 PixVerse $0.036 /seconde
-
 Wan 3.0 Video Alibaba $0.040 /seconde
-
 HappyHorse 1.0 Alibaba $0.168 /seconde
-
 Vidu Q3 Vidu $0.149 /seconde
-
 Kling 3.0 Kuaishou $0.100 /seconde
-
 Vidu Q4 Preview Vidu $0.051 /seconde
-
 HeyGen Avatar IV HeyGen $0.150 /seconde
Même fournisseur
-
 Lyria 3.5 Google $0.090 /morceau
-
 Imagen 4 Google $0.030 /image
-
 Gemini Omni 1.1 Flash Google $0.450 /vidéo
-
 Veo 3.1 Fast Google $0.170 /seconde
-
 Nano Banana Pro Google $0.057 /image
-
 Nano Banana Google $0.021 /image
-
 Google Virtual Try-On Google $0.107 /image
-
 Nano Banana 2 Google $0.036 /image
-
 Veo 3.1 Lite Google $0.060 /seconde
-
 Lyria 3 Pro Google $0.140 /morceau
-
 Nano Banana 2 Lite Google $0.033 /image
-
 Gemini 3.1 Flash TTS Google --