
Guia de uso
Grok Imagine Quality 图生图用于电商产品图片
使用 hiapi API 上的 grok-imagine-quality/image-to-image,将一张棚拍照片转化为完整的产品目录
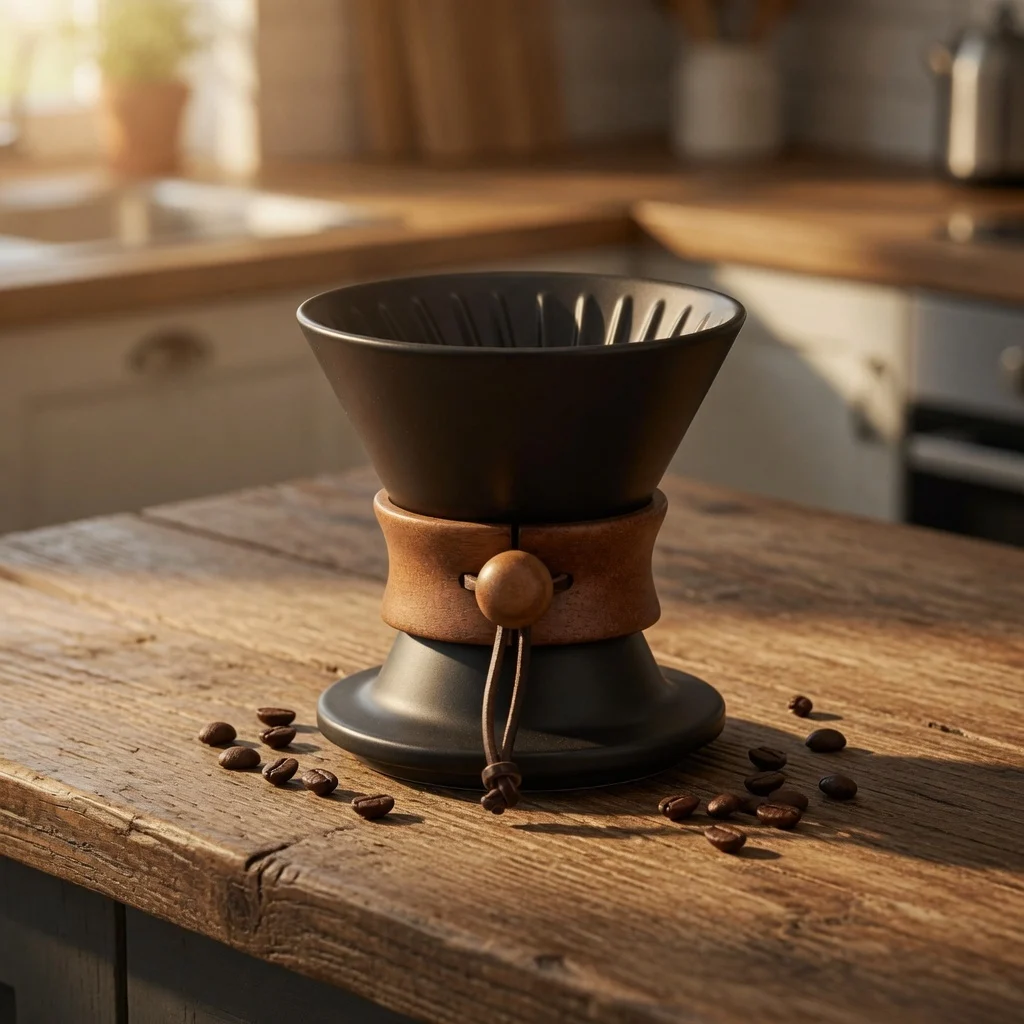
为每个新上架角度、季节性横幅或市场模板重新拍摄产品既慢又贵。grok-imagine-quality/image-to-image 解决了一个更窄但更实用的问题:给它一张干净的参考照片和一段文本提示,它就能把那个确切的产品——相同的形状、相同的颜色、相同的比例——放进一个新场景。一张棚拍照片就能变成生活方式照、平铺照和使用中照片,无需第二次实体拍摄。
本指南将走一遍 hiapi API 上的真实电商工作流:生成一张基础产品照片,用 grok-imagine-quality/image-to-image 对它执行三次场景变换,并将同样的模式批量应用到整个产品目录——附带可运行的代码和当前定价。
前置条件:
- 从你的仪表盘获取 hiapi API 密钥
- Python 3.9+ 及
requests(或直接用curl) - 你的基础产品图片托管在公开 URL 上——任务 API 通过 URL 获取
image_urls,而不是通过上传
为什么用图生图而不是第二次拍摄
文生图模型可以生成一个好看的咖啡滤杯,但它无法生成你的咖啡滤杯——那种客户已经从你的商品图片中认出的确切轮廓、釉色和壶嘴角度。grok-imagine-quality/image-to-image 将那个确切物体作为参考,并将其重新渲染到新环境中,这就是“一张产品照片”和“我们产品的照片”之间的区别。
这使它适合电商的反复需求:每个 SKU 一张主图,然后 N 个变体(生活方式场景、平铺、使用中、季节背景)用于产品图库、广告和市场列表——而无需每次都预订摄影棚。
工作流:一张基础照片,三次场景编辑
这里的基础照片是用 gpt-image-2/text-to-image 生成的(1K 下每张 $0.03)——任何干净、光线充足的产品照片都可以作为参考,包括你已有的真实照片:
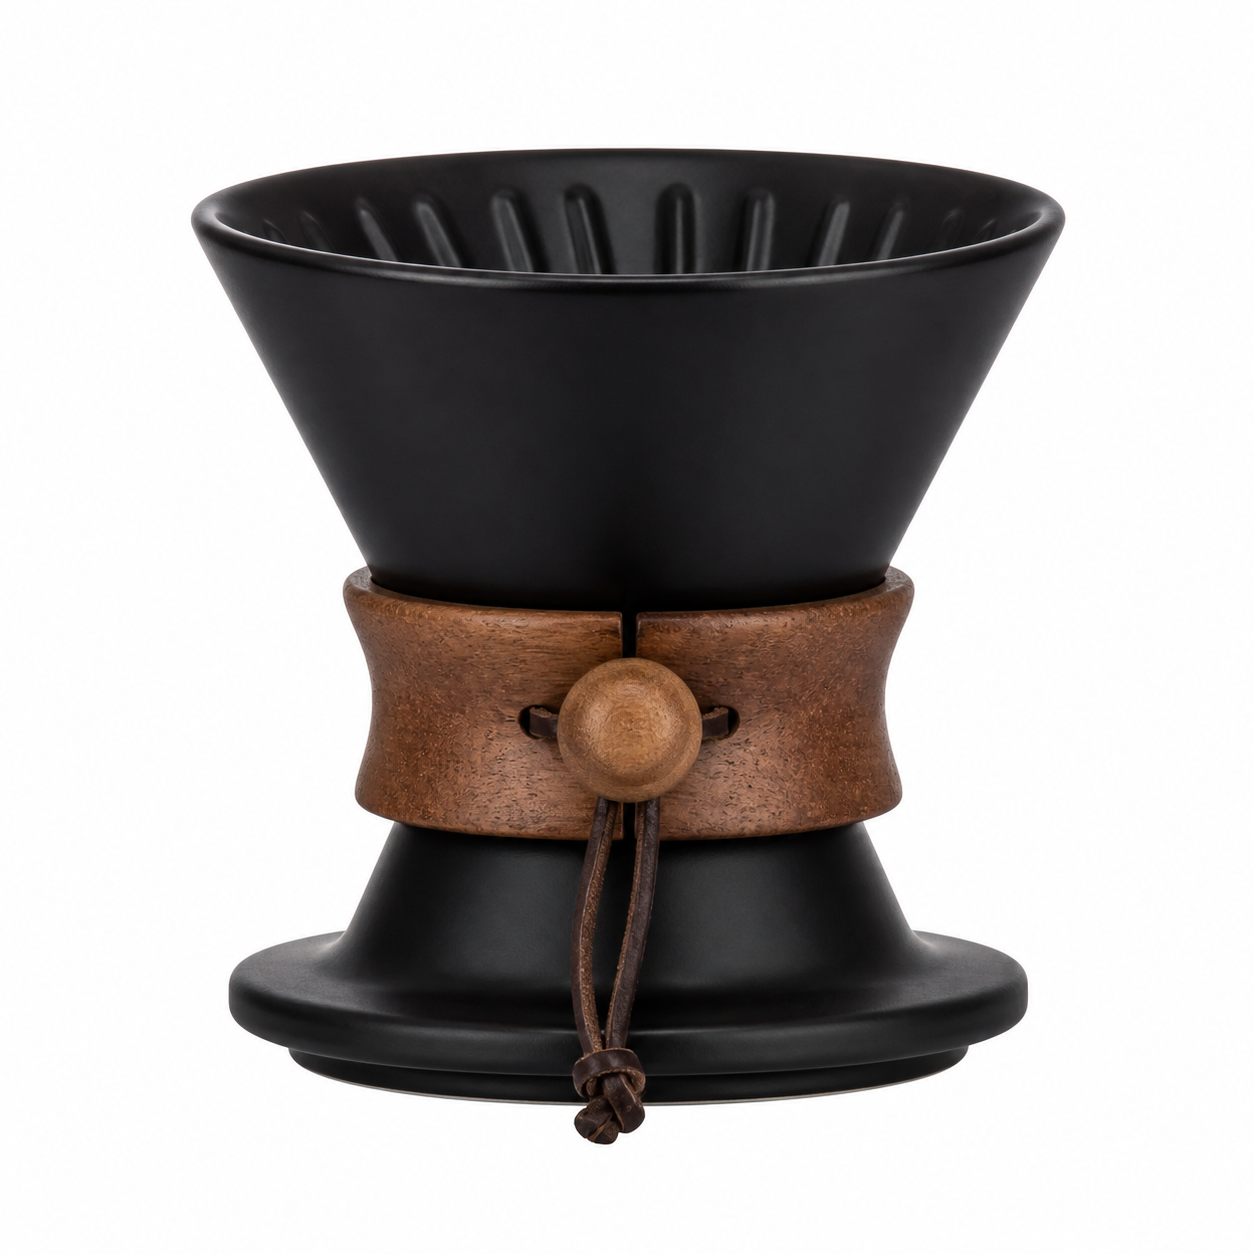
然后这个单一图片 URL 会在三次 grok-imagine-quality/image-to-image 调用中重复使用,每个目标场景一次:
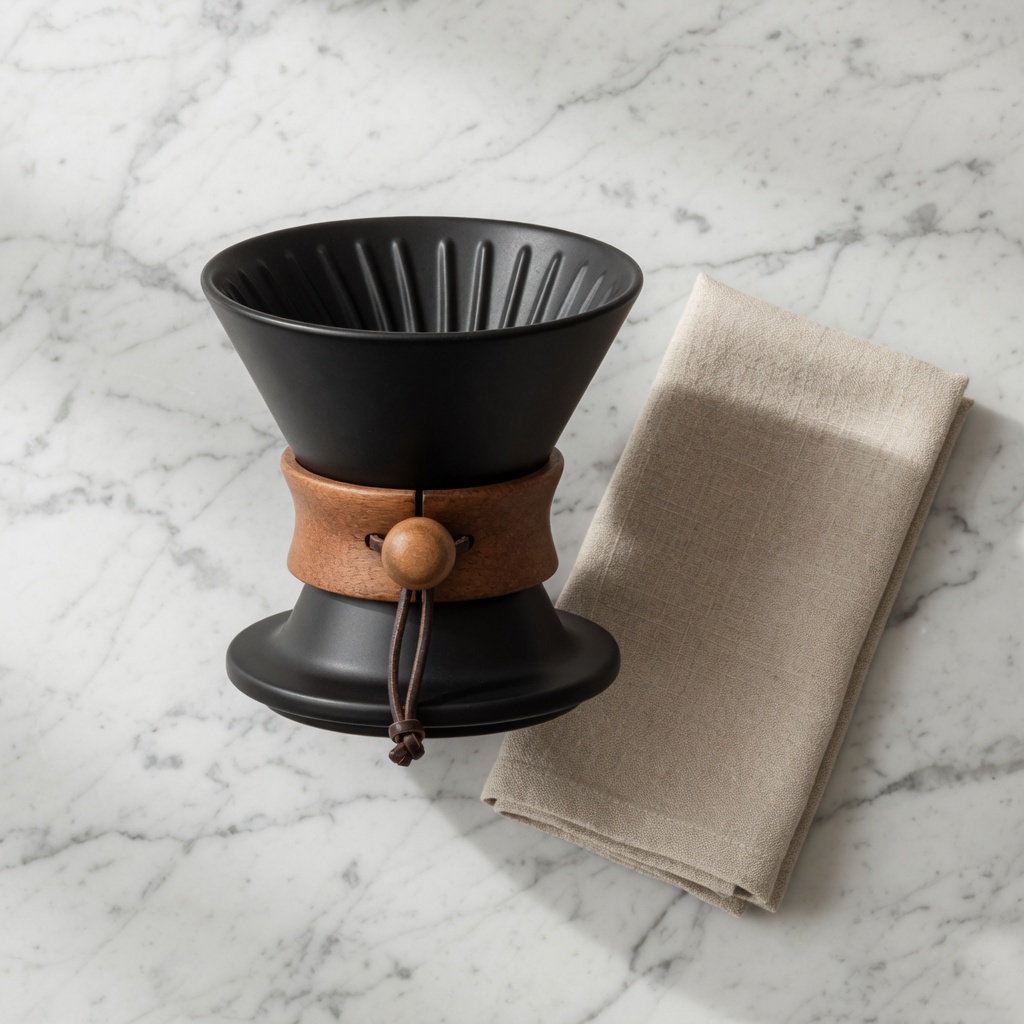
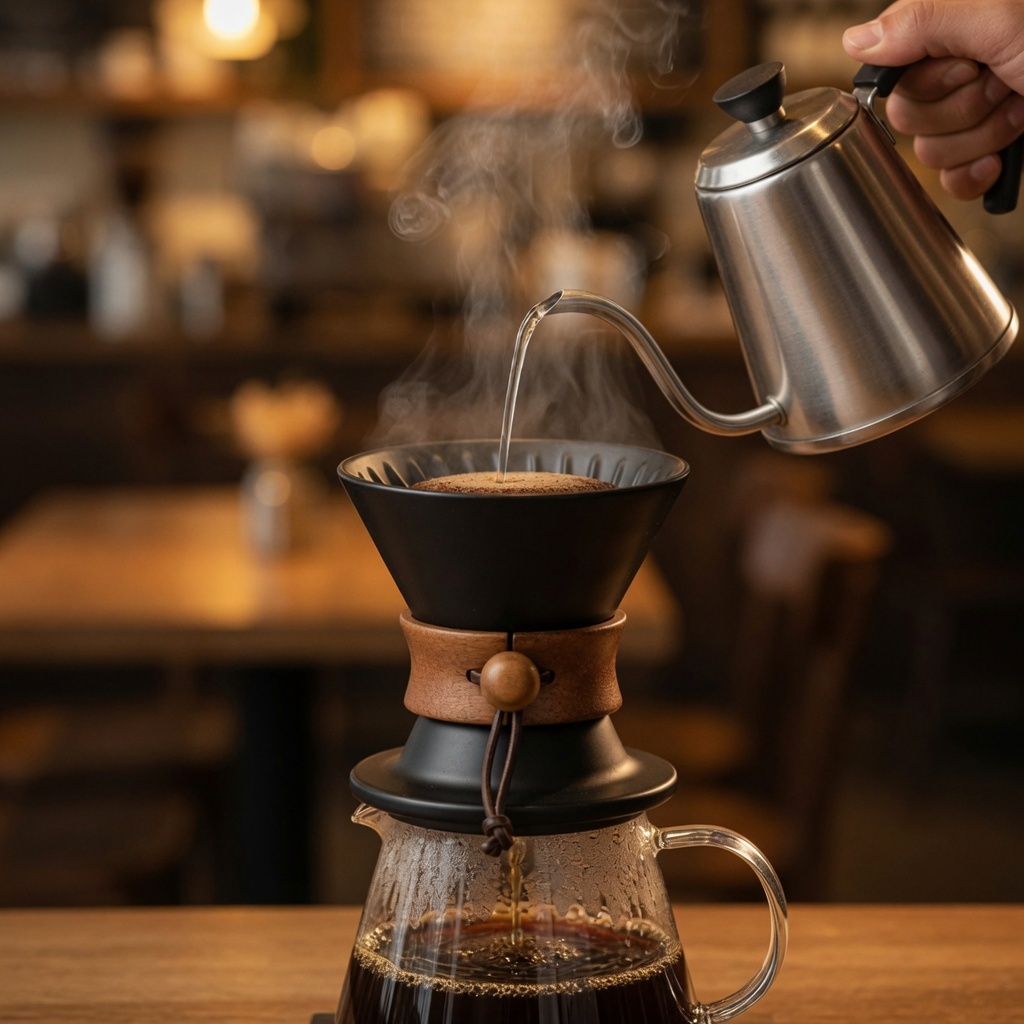
在三次结果中,滤杯的比例、釉色和手柄形状保持完全一致——只有周围场景改变。这种一致性正是在这里使用 i2i 而非为每个场景独立进行 t2i 生成的整个价值主张,后者会给你三个看起来不同的产品。
请求结构与定价
grok-imagine-quality/image-to-image 接受一个小而严格的输入模式——像 strength 或种子这样的额外字段会被拒绝:
| 字段 | 必填 | 说明 |
|---|---|---|
prompt |
是 | 描述新场景;明确指示模型保留参考图的形状/颜色/比例 |
image_urls |
是 | 1–3 个公开 URL。使用多个参考图时,输出画面跟随第一个 URL |
resolution |
否 | 1k 或 2k(小写) |
aspect_ratio |
否 | auto(默认,跟随输入画面)或固定比例,如 16:9、1:1、9:16 |
截至 2026-08 的定价(已对照 hiapi 的定价页面核实):grok-imagine-quality/image-to-image 为 1K 每张 $0.09,2K 每张 $0.11。gpt-image-2/text-to-image 上的基础棚拍照片在 1K 下为 $0.03。像上面这样的 4 张图集——一张基础照片加三次场景编辑——总成本为 $0.30。
代码:提交和轮询任务
hiapi 上的每次生成都遵循相同的异步任务生命周期——提交,轮询 GET /v1/tasks/{id} 直到 status 为 success,然后立即下载 output[0].url(URL 会过期)。完整契约见异步任务 API 参考。以下是 i2i 调用的具体示例:
import requests
import time

API_BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

def edit_product_scene(base_image_url: str, prompt: str) -> str:
    payload = {
        "model": "grok-imagine-quality/image-to-image",
        "input": {
            "prompt": prompt,
            "image_urls": [base_image_url],
            "resolution": "1k",
        },
    }
    resp = requests.post(API_BASE, headers=HEADERS, json=payload, timeout=60)
    task_id = resp.json()["data"]["taskId"]

    while True:
        task = requests.get(f"{API_BASE}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
        if task["status"] == "success":
            return task["output"][0]["url"]
        if task["status"] == "fail":
            raise RuntimeError(task.get("error"))
        time.sleep(5)
一致性实际上来自提示词——没有 strength 或参考权重参数,所以措辞必须承担这个作用:
Place this ceramic pour-over coffee dripper on a rustic wooden kitchen
countertop, warm morning sunlight streaming in from the left, a few
coffee beans scattered near the base, shallow depth of field, lifestyle
e-commerce photography, keep the dripper's shape, color and proportions
identical to the reference
那个结尾从句——“keep the shape, color and proportions identical to the reference”(保持形状、颜色和比例与参考图一致)——在测试中产生了可衡量的差异。去掉它,模型会更宽松地对待参考图,重新绘制比例并混入略微通用的细节。
一个注意事项:不要期望精确的姿态控制。在场景替换时要求“相同角度”不会被严格遵守——物体的方向往往会自然重新调整以适应新场景。如果确切方向很重要,请在保留从句中明确说明(例如“保持壶嘴朝左”)。
跨完整目录批量处理
同样的调用可以直接扩展到目录作业——循环遍历 (SKU, 基础图片, 场景提示) 元组,而不是硬编码一个产品:
CATALOG = [
    {"sku": "dripper-ceramic-01", "base_url": "https://cdn.example.com/dripper-01-base.jpg"},
    {"sku": "kettle-gooseneck-02", "base_url": "https://cdn.example.com/kettle-02-base.jpg"},
    # ...
]

SCENE_PROMPTS = {
    "lifestyle": "Place this product on a rustic wooden kitchen countertop, warm morning "
                 "sunlight, lifestyle e-commerce photography, keep shape, color and "
                 "proportions identical to the reference",
    "flatlay": "Place this product on a white marble countertop, top-down flat lay, soft "
               "diffused daylight, keep shape, color and proportions identical to the reference",
}

results = []
for item in CATALOG:
    for scene_name, prompt in SCENE_PROMPTS.items():
        url = edit_product_scene(item["base_url"], prompt)
        results.append({"sku": item["sku"], "scene": scene_name, "url": url})
        # download + upload to your own storage here — output URLs expire
任务 API 上没有原生的 idempotency_key 字段,因此如果批处理作业需要在崩溃后安全地重新运行,请在你自己的存储中按 (sku, scene_name) 去重后再重新提交,而不是依赖 API 来捕获重复。
按每张 $0.09 计算,一个 200 个 SKU 的目录,每个有 3 个场景变体,总共需要 $54——值得与拍摄这么多场景照片的摄影棚成本进行比较,尤其是对于会随季节重新调整的目录。
常见问题
grok-imagine-quality/image-to-image 支持一次调用批量或多图输出吗?
不——一次 image_urls 提交(1–3 张参考图)每个任务产生一张输出图像。通过循环单独的任务调用来批量处理场景,如上所示。
我能控制输出的确切相机角度吗? 不能直接控制——没有相机/姿态参数。方向往往会重新调整以适应新场景;如果特定角度很重要,请在提示词中明确说明,同时加上“保持形状/颜色/比例”的指示。
这与基础层 grok-imagine/image-to-image 有何不同?
Quality 层成本更高($0.09–$0.11,而基础层),但在更大的场景变化中更可靠地保持产品身份。对于简单的背景替换,我们的基础层电商工作流指南涵盖了更便宜的路径——当场景变换更剧烈时(例如从棚拍到生活方式,而不仅仅是背景),再选择 Quality。
如果我的源照片还不在公开 URL 上怎么办?
先将其上传到任何对象存储或 CDN——任务 API 在服务端获取 URL 来解析 image_urls,因此本地文件路径或数据 URI 无法工作。
自己试一试
完整的请求/响应结构、实时演练场和当前定价都在 grok-imagine-quality/image-to-image 模型页面上。如果你对任务 API 还不太熟悉,分步集成指南会更深入地讲解认证、轮询和错误处理。
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores