
Tutorial
Prática de imagem para vídeo com hailuo-2.3-fast: 5 cenários de negócio de alto valor e pontos de integração
Por que imagem para vídeo é mais fácil de aplicar do que texto para vídeo
A entrada do texto para vídeo é apenas um trecho de texto, e o modelo precisa escolher entre possibilidades visuais quase infinitas, resultando frequentemente em algo “visível, mas incontrolável”: composição, proporção do sujeito e movimento de câmera podem variar bastante entre duas chamadas. A imagem para vídeo troca o ponto de partida do texto pela imagem que você já confirmou — o que é o sujeito, para que lado ele está voltado, quão limpo é o fundo — tudo isso é fixado pela imagem. O modelo só precisa estender ao longo do eixo temporal, em vez de imaginar do zero.
Para equipes de engenharia, isso significa três coisas:
- Maior determinismo. Gerar repetidamente a partir do mesmo primeiro quadro mantém basicamente estáveis a identidade do sujeito e a composição; as diferenças concentram-se na amplitude do movimento e na oscilação de detalhes, convergindo muito mais do que descrições textuais.
- Barreira de material mais baixa. A maioria dos negócios já possui muitas imagens estáticas (fotos de produtos, capas, concept arts); não é preciso aprender antes a escrever prompts de vídeo para transformar ativos existentes em conteúdo dinâmico.
- Critério de aceitação mais claro. Você pode julgar a usabilidade por “o primeiro quadro foi fielmente continuado”, em vez de avaliar subjetivamente um vídeo gerado do nada.
Portanto, ao decidir a abordagem, pergunte-se primeiro: tenho um ponto de partida estático qualificado? Se sim, imagem para vídeo costuma ser o primeiro passo mais pragmático; se nem a imagem existe e há apenas uma ideia abstrata, então é necessário texto para vídeo. A seguir, usamos hailuo-2.3-fast/image-to-video como exemplo; ele é fornecido pela MiniMax, produz vídeo, tem capacidade image-to-video e é chamado pela interface unificada do HiAPI.ai, com integração consistente com os demais modelos de vídeo do site.
Cenário 1: Exibição dinâmica de imagens de produtos de e-commerce
O e-commerce é o setor mais típico de “ativos estáticos já no lugar”: cada produto tem sua imagem principal, mas a página de detalhes costuma ter apenas algumas imagens estáticas. Converter a imagem principal em um vídeo curto de 3–5 segundos, usado na primeira dobra da página de detalhes ou em posições de mídia paga, é o uso mais direto de imagem para vídeo em termos de retorno sobre investimento.
Requisitos para a imagem de entrada
O risco central de converter imagem de produto em vídeo não é “mover pouco”, mas “mover errado”. Por isso, a seleção do primeiro quadro é mais importante que o prompt:
- Sujeito nítido, bordas limpas. Recorte malfeito ou sujeito colado ao fundo tende a produzir sensação de rasgo nas bordas durante o movimento.
- Fundo simples. Fundo de cor sólida ou desfocado permite que o modelo concentre a atenção no produto e reduz movimentos indesejados de elementos de fundo.
- Evite textos ambíguos já presentes na imagem. Textos na imagem costumam sofrer leve distorção após a videoificação; se precisarem ser mantidos, recomenda-se sobrepor na pós-produção em vez de deixar ao modelo.
Design da direção do movimento
Não empilhe adjetivos como “cinematográfico, sofisticado, 8K” no prompt; use uma restrição de movimento concreta: aproximação leve, órbita lenta, tecido balançando suavemente, luz e sombra deslocando-se devagar. Gerar uma ação clara por vez tem taxa de aproveitamento muito maior do que descrições compostas.
Sugestões de aplicação
A mesma imagem principal pode gerar poucas variantes; escolha uma manualmente para publicar e use as demais como materiais alternativos em rotação, controlando custo e evitando que todos os produtos usem o mesmo ritmo de movimento. Em cenários com múltiplas categorias, recomenda-se manter modelos de primeiro quadro e descrição de movimento por categoria, em vez de ajustar parâmetros para cada SKU individualmente.
Cenário 2: Videoificação em lote de materiais de marketing
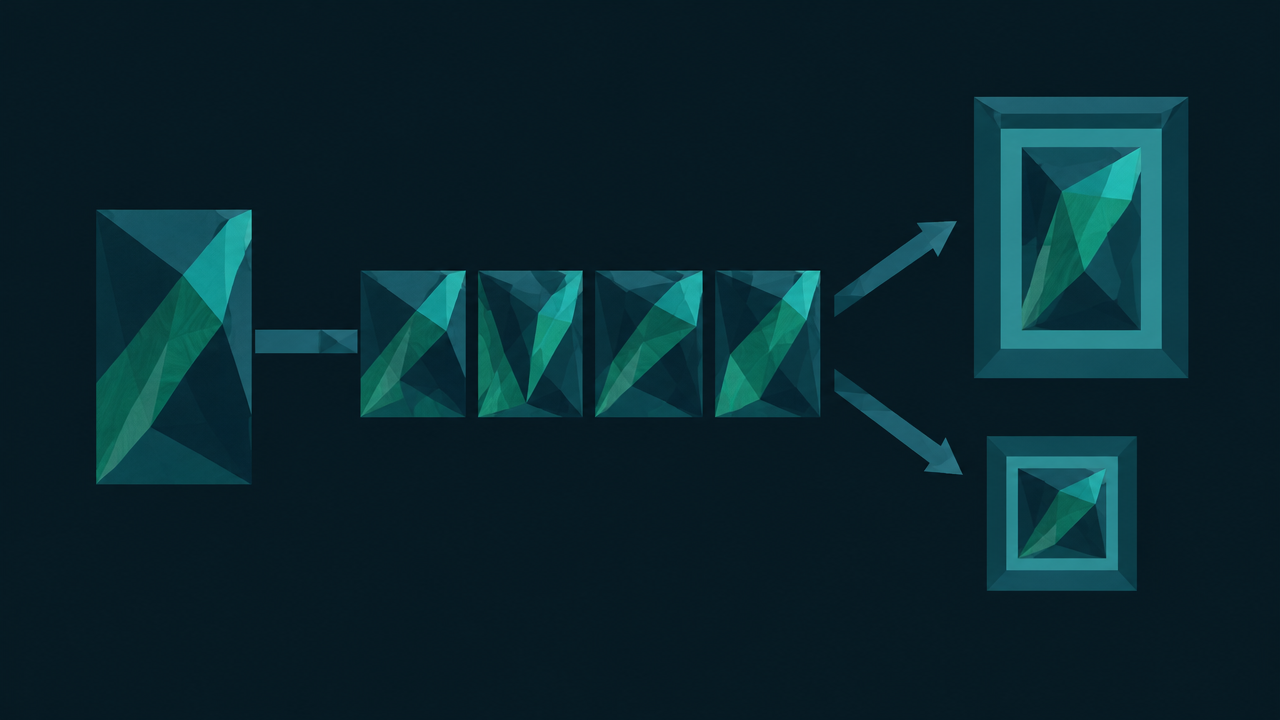
A necessidade real das equipes de marketing não é “gerar um bom vídeo”, mas “produzir dezenas a centenas de materiais veiculáveis em uma semana”. O valor de imagem para vídeo aqui está na orquestração: a imagem de modelo é fixa, as variáveis vêm das informações da campanha, e várias peças curtas são geradas em lote para testes A/B.
Decomposição do fluxo de trabalho
- Camada de modelo. Uma imagem-base de composição estável (posições de espaço em branco e elementos de marca fixas) que define o tipo de movimento de câmera.
- Camada de variáveis. Tema da campanha, tendência de cores etc. entram como variantes diferentes do primeiro quadro, em vez de serem enfiados no prompt.
- Camada de lote. Enviar solicitações de geração via fila de tarefas, marcando por lote para facilitar análise de atribuição posterior.
- Camada de triagem. A máquina não consegue julgar completamente a usabilidade; mantenha amostragem manual, e modelos com baixa taxa de aprovação na amostragem são descartados diretamente.
Raciocínio de controle de custos
Em cenários de lote, o custo é linearmente relacionado ao número de vídeos gerados; portanto, a chave do controle orçamentário é “validar o modelo com pequeno lote primeiro e depois escalar”. Use poucas amostras para confirmar a taxa de aproveitamento de um modelo em uma geração; modelos que não atingem a taxa não devem ser escalados. O retorno marginal de repetir a geração do mesmo modelo cai rapidamente; após duas ou três variantes, continuar gerando costuma ser apenas desperdício.
Consulte o painel de preços do site para o valor unitário específico; cobrança por peça significa que o orçamento é um “orçamento de quantidade”. Colocar um limite diário/semanal de peças no agendador de tarefas é mais eficaz do que olhar a fatura depois.
Cenário 3: Conversão de imagens de acompanhamento em vídeos curtos para redes e plataformas de conteúdo
Os ativos das equipes de conteúdo são principalmente capas, ilustrações e infográficos. Convertê-los em dinamismo curto pode transformar cartões estáticos no feed em formatos de conteúdo com maior retenção. A maior diferença em relação ao e-commerce é: consistência de estilo é mais importante que a qualidade de uma peça individual.
Trade-off da consistência de estilo
Ao videoificar primeiros quadros de ilustração, o modelo tende a adicionar detalhes realistas de luz e sombra, criando uma ruptura entre a versão dinâmica e o estilo da ilustração original. Abordagens viáveis:
- Priorizar ilustrações de traço simples e blocos de cor bem definidos como primeiro quadro; line art complexo e texturas densas tendem a tremer durante o movimento.
- Controlar a amplitude do movimento no nível de “micro-movimento” — vento, mudança de luz, leve deslocamento de elementos — em vez de grandes movimentos de câmera.
- Usar o mesmo conjunto de regras de primeiro quadro para a mesma coluna ou série, criando expectativa de estilo no público.
Alinhamento com o ritmo do conteúdo
Dinamismo curto é adequado para efeitos de capa, não para narrativa completa. Ele assume a responsabilidade de “fazer olhar mais uma vez”, não a de explicar o conteúdo. Portanto, no design do produto, deve ser tratado como parte da camada de capa, aparecendo junto com título e resumo, em vez de ocupar sozinho uma posição de reprodução.
Sugestões de programação
As equipes de conteúdo costumam planejar semanalmente; recomenda-se antecipar as tarefas de geração para a fase de pauta: após a definição da capa, gerar imediatamente a versão dinâmica e armazená-la, evitando gerar em cima da publicação e comprometer a qualidade.
Cenário 4: Aprimoramento de conteúdo gerado por usuários dentro do produto
Converter imagens enviadas por usuários em vídeos curtos é o uso mais produtizado de imagem para vídeo, e também onde o risco de engenharia se concentra mais: qualidade de entrada incontrolável, paciência limitada do usuário e necessidade de degradação digna em caso de falha.
Momento do disparo
Não dispare a geração automaticamente no instante em que o upload é concluído. Um design mais seguro é permitir que o usuário clique ativamente em “gerar versão dinâmica” e, antes do clique, informar claramente que é uma operação demorada. Isso evita consumo inútil e cria expectativa psicológica de espera.
Cadeia de degradação em falhas
Uma cadeia de produto robusta deve ter pelo menos três camadas:
- Camada de validação de entrada. Verificar dimensões, formato e identificabilidade do sujeito antes de enviar; se não atender, avisar o usuário para trocar a imagem, em vez de deixar o problema para o modelo.
- Camada de geração. Em caso de timeout ou falha na resposta, não repetir indefinidamente; após uma tentativa limitada, entrar em degradação.
- Camada de degradação. Degradar para imagem estática + efeito dinâmico leve (como zoom lento), garantindo experiência completa e registrando amostras de falha para otimizar as regras de primeiro quadro.
Gestão de expectativa de experiência
A tolerância do usuário a “geração por IA” depende de as expectativas terem sido definidas. Nos textos, evite prometer que “qualquer foto vira vídeo”; explique para que tipo de imagem serve. Quando o resultado não for bom, oferecer uma entrada para “trocar a imagem e tentar de novo” é mais útil do que ajustes complexos de parâmetros.
Cenário 5: Pré-visualização de conceitos em jogos e ativos virtuais
Na fase de avaliação de arte e design, o que mais falta não são imagens, mas “como é a sensação dessa imagem em movimento”. Converter concept arts, designs de personagem e imagens de atmosfera de cenário em prévias dinâmicas de poucos segundos permite alinhar direções rapidamente sem entrar no processo formal de produção.
Limites de uso adequados
O objetivo desse cenário é comunicar atmosfera e ritmo, não produzir ativos diretamente utilizáveis. Portanto, a expectativa de fidelidade de detalhes deve ser realista:
- Detalhes estruturais, articulações mecânicas e identificações textuais na imagem podem sofrer leve deformação após a dinamização; na avaliação, concentre-se na atmosfera geral, não em pixels locais.
- Grandes movimentos de câmera tendem a expor costas e laterais não definidas na concept art; recomenda-se usar pequenos deslocamentos ou efeitos ambientais (nuvens, partículas, luz e sombra).
- Uma única concept art pode gerar múltiplas variantes de direção de movimento como material comparativo para a reunião de avaliação, em vez de resposta única.
Posição no fluxo de avaliação
Coloque a prévia dinâmica entre a avaliação de conceito e a modelagem formal, validando com custo mínimo se “funciona em movimento”. Ela não substitui o previz de animação nem deve entrar no pipeline final de ativos, mas reduz significativamente retrabalho direcional.
Sugestões de organização de ativos
Arquive os resultados gerados por projeto e versão, e estabeleça associação com a concept art original, evitando perder a correspondência em avaliações futuras. Para direções já definidas, preserve sua descrição de movimento como modelo de geração para ativos semelhantes.
Custo e desempenho: estimativa de ordem de grandeza sob cobrança por peça
A lógica de cobrança de modelos de vídeo é diferente da de modelos de texto: texto é cobrado por token, com grande variação, mas custo unitário muito baixo; vídeo é cobrado por peça, com custo unitário alto e baixa variância, facilitando o orçamento. hailuo-2.3-fast/image-to-video é cobrado por peça; consulte o painel de preços do site para o valor unitário específico.
Método de estimativa
Não é preciso memorizar o preço unitário; basta estabelecer o “pensamento em quantidade de peças”:
- Primeiro estime a quantidade. Quantas peças um cenário precisa por lote? Incluindo variantes e tentativas, a quantidade real costuma ser 2–3 vezes a quantidade esperada de peças utilizáveis.
- Depois multiplique pelo coeficiente. Multiplique o preço unitário do painel do site pela quantidade para obter a ordem de grandeza do custo do lote.
- Por fim, defina o limite. Coloque o limite de peças na lógica de agendamento, em vez de depender de controle manual.
O que armazenar em cache e o que reutilizar
- Reutilize a entrada. Mesmo primeiro quadro + mesma descrição de movimento produzem diferenças limitadas; repetir a geração geralmente não compensa. Armazene os resultados em cache e selecione conforme necessário.
- Reutilize modelos. Em cenários de lote, reutilizar primeiros quadros e modelos de movimento já validados aumenta significativamente a taxa de aproveitamento em uma geração, reduzindo indiretamente o custo real por conteúdo utilizável.
- Não reutilize amostras de falha. Classifique solicitações com falha separadamente; não tente a sorte repetindo indefinidamente. Repetições devem ter limite de tentativas.
Expectativa de desempenho
A geração de vídeo é uma tarefa de longa duração; no design da cadeia, assuma que “espera síncrona não é viável”, adote envio assíncrono + polling ou callback para obter resultados e forneça feedback de progresso no front-end. Defina o limite de timeout no tempo máximo de espera aceitável pelo negócio, não no tempo máximo do modelo.
Checklist de integração e solução de problemas: o que confirmar antes do lançamento
Transportar diretamente os hábitos de integração de modelos de texto para cadeias de vídeo é a fonte de erro de maior custo na solução de problemas. Antes do lançamento, confirme item a item:
Lado da entrada
- Dimensões, formato e tamanho do primeiro quadro atendem aos requisitos da interface e são validados antes do envio.
- Descrição de movimento ou cena é específica e única; evite instruções compostas e acúmulo de adjetivos.
- Defina o que não deve aparecer no primeiro quadro (texto ambíguo, textura densa, sujeito pouco claro) e forneça orientação de seleção de imagem no produto.
Lado da chamada
- Projete como tarefa assíncrona: envio, consulta de status e obtenção de resultado separados; não assuma que uma única requisição retorna o vídeo final.
- Configure timeout razoável e tentativas limitadas; antes de repetir, identifique o tipo de falha.
- Registre o identificador de entrada e o identificador de tarefa de cada solicitação para facilitar a reprodução de problemas.
Classificação de falhas
Divida as falhas em três tipos e trate-os separadamente, em vez de repetir tudo igualmente:
- Tipo de entrada (parâmetros, dimensões, formato). Corrija a entrada diretamente; repetir não faz sentido.
- Tipo de conteúdo (imagem inutilizável, deriva do sujeito). Troque o primeiro quadro ou ajuste a descrição de movimento, em vez de repetir a mesma requisição.
- Tipo de sistema (timeout, anomalia de serviço). Pode repetir limitadamente; ao ultrapassar o limite, degrede e alerte.
Lado do resultado
- Projete exibição degradada para resultados gerados, garantindo que a experiência do usuário não seja interrompida em falhas.
- Salve metadados de resultados utilizáveis (primeiro quadro, descrição, tempo de execução), formando uma biblioteca interna de modelos para aumentar a taxa de aproveitamento em gerações futuras.
A dificuldade de integração de imagem para vídeo nunca está na interface em si, mas em três coisas: qualidade do primeiro quadro, restrições de cenário e tratamento de falhas. Ao aprimorar esses três pontos e integrar hailuo-2.3-fast/image-to-video pela interface unificada do HiAPI.ai, você poderá transformar ativos de imagem existentes em conteúdo dinâmico veiculável com custo relativamente controlável.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado