
Guia de uso
Guia de introdução ao qwen-image-3.0-pro/image-to-image: limites de capacidade, integração via API e controle de custos
Seleção e integração prática de modelos de edição de imagem para desenvolvedores
O lugar do image-to-image no fluxo de negócio
Antes de começar a integração, deixe claro uma coisa: a qual tipo de modelo de imagem sua necessidade realmente deve ser entregue.
Text-to-image resolve o "do nada ao algo" — você dá uma descrição textual e ele gera uma imagem totalmente nova. Modelos de compreensão de imagem resolvem o "entender" — você dá uma imagem e ele retorna rótulos, descrições ou informações estruturadas. O image-to-image fica no meio: recebe uma imagem existente, mais sua descrição da intenção de modificação, e devolve uma imagem modificada. Seu valor não está em criar conteúdo novo, mas em preservar o sujeito, a composição e a base de estilo da imagem original, alterando apenas o que você deseja alterar.
No fluxo real de negócio, esse tipo de modelo costuma aparecer em três pontos:
- Etapa de produção de conteúdo: após receber imagens de matéria-prima, a equipe de operações aplica estilização, troca de estação e de fundo, e gera múltiplas versões em lote.
- Etapa de interação com o usuário: o usuário final envia uma imagem e o produto devolve um resultado editado em poucos segundos.
- Etapa de pós-processamento: ajustes visuais além da nitidez em materiais existentes, como microajuste de composição e unificação de tonalidade.
O critério de decisão é simples: se na sua entrada já existe uma imagem e você precisa de "transformar esta imagem naquela" em vez de "desenhar uma do zero", então o image-to-image é a direção correta de seleção. Por outro lado, se você só tem uma necessidade textual ou precisa que o modelo diga o que há na imagem, ele não é a melhor escolha.
O qwen-image-3.0-pro/image-to-image é fornecido pela Alibaba, tem saída do tipo imagem e seu posicionamento de capacidade é exatamente image-to-image. Ele é adequado para ser tratado como um "nó de edição de imagem" no pipeline, conectado antes e depois à sua própria lógica de armazenamento, moderação e distribuição.
Limites de capacidade e cenários de aplicação
Prometer demais sobre a capacidade do modelo é o erro mais comum na fase de integração. Os limites abaixo baseiam-se no posicionamento de capacidade do modelo e são expectativas que devem ser alinhadas previamente no aspecto de engenharia.
Tarefas adequadas para ele
- Transferência de estilo global: converter uma foto em ilustração, aquarela, textura de filme e outros estilos uniformes, preservando em grande parte a estrutura do sujeito.
- Edição e substituição local: trocar a atmosfera do fundo, ajustar a paleta de cores, substituir elementos visuais de uma região.
- Variações em lote de materiais: gerar várias versões de estilo a partir da mesma imagem-base para veiculação de materiais em A/B.
- Reforço visual de esboços e rascunhos de baixa fidelidade: levar um esboço estrutural a uma apresentação visual mais completa.
Capacidades que não devem ser prometidas
- Reprodução precisa em nível de pixel: o image-to-image é um processo generativo, não um filtro de processamento de imagem. Demandas que exigem "cada pixel idêntico, exceto neste ponto" não são possíveis para ele e não deveriam ser feitas por ele.
- Determinismo na renderização de texto: a precisão do texto na imagem, a consistência da fonte e a posição da diagramação não podem ser garantidas. Cenários com identidade de marca ou textos legais devem passar por fluxo manual ou de diagramação dedicada.
- Medição espacial precisa e consistência geométrica: cenários que exigem alinhamento estrito, escala proporcional e saída mensurável devem usar bibliotecas determinísticas de processamento de imagem.
- Fidelidade total à entrada: existe um trade-off natural entre a amplitude da modificação e a fidelidade, e isso precisa ser gerenciado tanto no prompt quanto na expectativa do produto.
Um método pragmático de avaliação: primeiro faça um teste cego com dez a vinte imagens reais de negócio e peça à área de negócio para julgar a "taxa de utilização" em vez da "taxa de perfeição". O critério de lançamento para modelos de geração de imagem costuma ser a combinação de "taxa de utilização + custo de triagem manual", e não o teto de qualidade de uma única imagem.
Raciocínio sobre parâmetros a preparar antes da chamada
Os nomes dos campos das interfaces de geração de imagem variam entre fornecedores, mas os elementos da requisição são altamente convergentes. Pense bem nas seguintes categorias de informação; não importa como os nomes dos campos mudem, o mapeamento será direto.
Imagem de entrada
O item mais central. Na integração, é preciso definir antecipadamente: se será enviado URL ou binário/base64; uma ou várias imagens de referência; limite de tamanho e requisitos de formato da imagem; se é necessário comprimir previamente para controlar o tempo de transmissão. Recomenda-se padronizar o tamanho uma vez no cliente, para evitar que o mesmo negócio tenha entradas de especificações variadas e aumente a variância dos resultados.
Descrição da intenção de edição
Ou seja, o prompt. A forma de escrever prompts para image-to-image é diferente da do text-to-image: o foco é descrever "o que mudar" e não "o que desenhar". A estrutura recomendada é "o que preservar + o que mudar + estilo desejado". Quanto mais específica a descrição, menor o número de tentativas e erros.
Especificação de saída
Proporção, resolução, formato de saída. Observe que a especificação de saída afeta diretamente o tempo de geração e a base de cálculo de custo da chamada; procure fixar no lado do negócio uma ou duas especificações e não deixe o front-end enviar valores arbitrários.
Itens de controle de geração
Essa categoria de parâmetros determina a "amplitude da modificação" e costuma aparecer na forma de intensidade ou similaridade. Quanto maior o valor, mais próximo da imagem original; quanto menor, mais livre. Recomenda-se tratá-lo como item de configuração ajustável do negócio, e não como valor fixo no código, para facilitar o ajuste fino por cenário.
Aleatoriedade e idempotência
Se a interface suportar semente aleatória, registrar a semente é fundamental para investigar problemas e reproduzir resultados. A mesma entrada com a mesma configuração deve produzir saída reproduzível; caso contrário, problemas em produção não poderão ser localizados.
Timeout e concorrência
A geração de imagem é uma requisição demorada; certifique-se de definir um timeout de cliente razoável e deixar explícito o limite de concorrência. Esses dois itens são a base para o controle de custos e o design de estabilidade posteriores.
Fluxo de integração e chamada mínima viável
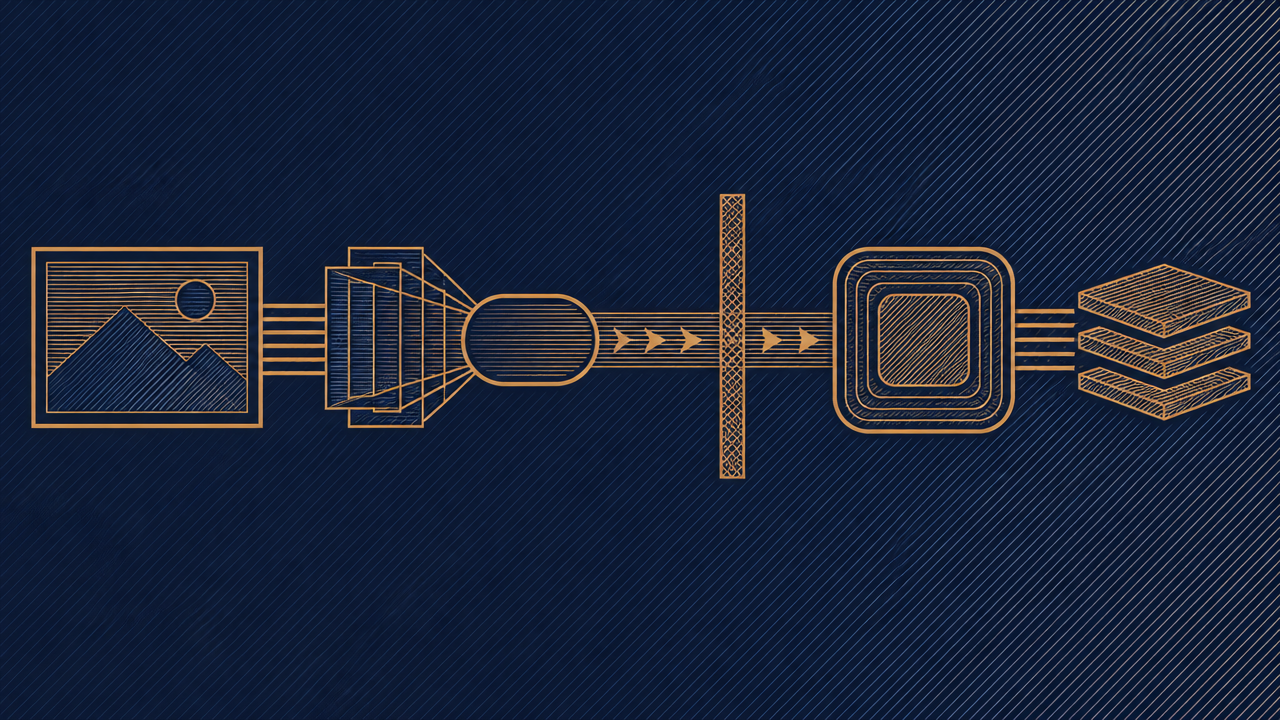
Um caminho ponta a ponta pode ser dividido em cinco passos; completar esses cinco passos já fornece o esqueleto para a integração em produção.
Primeiro passo: preparar a imagem de entrada
Escolha uma imagem de negócio com sujeito claro e composição completa. Envie para um armazenamento sob seu controle, obtenha uma URL acessível publicamente ou leia em binário para envio em base64. Registre também o tamanho e o formato dessa imagem.
Segundo passo: montar a requisição
No contexto da interface unificada da HiAPI.ai, o corpo da requisição contém aproximadamente: identificador do modelo (qwen-image-3.0-pro/image-to-image), imagem de entrada, descrição da intenção de edição, especificação de saída e itens de controle de geração. A maioria das interfaces segue o mesmo paradigma de chamada:
curl -X POST https://api.hiapi.ai/v1/images/generations \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-image-3.0-pro/image-to-image",
    "image": "https://your-cdn.example.com/input.jpg",
    "prompt": "Manter a pose e a composição da pessoa inalteradas, converter para estilo de ilustração em aquarela, simplificar o fundo para cor clara",
    "size": "1024x1024"
  }'
Os nomes exatos dos campos e valores opcionais devem seguir a página de documentação do modelo na HiAPI.ai; o exemplo acima apenas expressa a estrutura.
Terceiro passo: envio e tratamento de timeout
Defina o timeout do cliente (recomenda-se deixar margem suficiente) e capture separadamente erros de rede e erros de negócio. Os erros retornados pela interface de geração de imagem geralmente precisam ser diferenciados entre "problema de parâmetro" e "falha temporária"; o primeiro não faz sentido tentar de novo.
Quarto passo: tratar a resposta
Após receber a resposta, valide primeiro se foi bem-sucedida e depois extraia o endereço da imagem ou os dados binários. Transfira imediatamente para seu próprio armazenamento de objetos; não dependa a longo prazo do link temporário retornado, pois a expiração do link pode causar perda de material.
Quinto passo: persistência e observabilidade
Registre o ID da requisição desta chamada, o nome do modelo, o tempo gasto, o identificador da imagem de entrada e o endereço da imagem de saída. Esse registro é a única base para a contabilização de custos e a revisão de problemas posteriores. Recomenda-se gravá-lo desde o primeiro dia, sem esperar que surjam problemas para complementá-lo.
Estimativa de custo no modelo de cobrança por imagem
O qwen-image-3.0-pro/image-to-image usa cobrança por imagem, a $0.0497 por imagem. A base é simples, mas ao converter para orçamento mensal é preciso incluir alguns fatores de ampliação.
Fórmula de estimativa
Custo mensal ≈ preço por imagem × imagens chamadas por dia × 30 × fator de ampliação por retentativas
O fator de ampliação por retentativas é a variável-chave. Se a taxa de retentativa por falha for de 5% e a própria retentativa também for cobrada, o custo real de geração será maior que o teórico. Definir o fator entre 1.05 e 1.15 para o orçamento chega mais perto da realidade do que estimar com 1.0.
Três tipos de fatores de ampliação facilmente ignorados
- Retentativas: se uma requisição falha é ou não cobrada depende da fase em que a falha ocorre, mas a retentativa no cliente certamente aumenta o total de chamadas.
- Múltiplas versões: para dar opções ao usuário ou permitir a triagem pela operação, uma necessidade pode gerar várias imagens. Gerar três imagens de uma vez custa o triplo.
- Depuração e pré-visualização: chamadas em ambientes de desenvolvimento e teste também entram no consumo; faça isolamento de ambiente e separação de cotas.
Como criar proteções de orçamento
- Definir cotas por linha de negócio: cada módulo funcional recebe um orçamento de chamadas independente, evitando que um recurso experimental consuma toda a cota.
- Limitar por usuário: produtos em que o usuário final pode disparar gerações precisam de limite de frequência por usuário.
- Pré-geração em vez de geração em tempo real: materiais que podem ser gerados em lote antecipadamente não devem ficar no caminho da requisição do usuário.
- Monitorar quantidade de imagens, não apenas valor: a quantidade de imagens é a métrica original; o valor muda com ajustes de preço, a quantidade não.
O preço unitário e as cotas específicas devem seguir o painel de preços da HiAPI.ai; aqui discutimos apenas o método de conversão.
Práticas de engenharia: retentativas, cache e degradação
As chamadas de geração de imagem têm três características: demoradas, sujeitas a falha e cobradas por chamada. Esses três pontos determinam que o design de estabilidade deve girar em torno de "gastar menos dinheiro desnecessariamente".
Retentativas: precisam ter limites
Retentar não é quanto mais melhor. A prática correta é:
- Retentar apenas erros retentáveis: timeout de rede, 5xx do servidor e resposta de limitação de taxa podem ser retentados com backoff; erro de parâmetro e rejeição por política de conteúdo não fazem sentido retentar e devem retornar imediatamente.
- Backoff exponencial + número máximo: recomenda-se no máximo duas a três tentativas, com intervalo crescente, para evitar ampliar a pressão quando o servidor estiver instável.
- Identificador de idempotência: gere um ID único para cada requisição de negócio e envie-o nas retentativas, para diferenciar nos logs "retentativa da mesma requisição" de "envio repetido pelo usuário".
Cache: acerto por impressão digital de entrada
O resultado do image-to-image é determinado conjuntamente pela imagem de entrada, pelo prompt, pela especificação de saída e pelos itens de controle; esses quatro itens formam uma chave de cache natural. Faça o hash da combinação e armazene no cache; em caso de acerto, retorne diretamente o resultado existente:
- Se o usuário reenviar a mesma imagem com o mesmo prompt, não deve haver uma segunda cobrança.
- Quando a operação testa em lote com modelos fixos, a taxa de acerto do cache costuma ser considerável.
- O cache deve ter tempo de expiração e registrar a taxa de acerto, para avaliar se vale a pena manter a estratégia de cache.
Degradação: tenha um segundo caminho pronto
Quando o serviço de geração estiver indisponível, o produto deve ter um comportamento digno:
- Retornar placeholder ou imagem original: informar claramente ao usuário que "não foi gerado desta vez", em vez de entregar uma imagem errada.
- Alternar para modelo ou parâmetros de reserva: manter no centro de configuração um conjunto de identificadores de modelo alternáveis e, em caso de anomalia no caminho principal, degradar para o caminho de reserva.
- Enfileirar em vez de descartar: em cenários não em tempo real, gravar a requisição em fila e reprocessar após a recuperação.
Observabilidade
Colete pelo menos quatro métricas: volume de chamadas, taxa de sucesso, tempo P95 e taxa de acerto do cache. Essas quatro cobrem a grande maioria das anomalias em produção. Acrescente uma métrica derivada de "custo por imagem gerada com sucesso" e você verá estabilidade e economicidade ao mesmo tempo.
Lista de verificação antes do lançamento
Passe por esta lista antes do lançamento; a grande maioria dos problemas pode ser exposta antes de ir ao ar.
Lado de qualidade
- Fazer teste cego com pelo menos 20 imagens reais de negócio e calcular a taxa de utilização julgada pela área de negócio.
- Cobrir entradas extremas: tamanhos muito pequenos, proporções muito largas, baixa nitidez, imagens sem sujeito destacado.
- Validar os limites de expressão dos prompts e confirmar que a equipe tem um modelo de prompt reutilizável.
- Registrar explicitamente os cenários conhecidos em que o modelo não se aplica e incluir na descrição do produto.
Lado da interface
- A especificação da imagem de entrada já foi normalizada no cliente e não há ponto de entrada para valores arbitrários.
- Timeout, limite de concorrência e política de retentativas configurados e validados por teste de carga.
- O resultado da saída já foi transferido para armazenamento próprio, sem depender de links temporários.
- Códigos de erro classificados e mapeados; o front-end consegue diferenciar "retentável" de "não retentável".
Lado de custo
- O orçamento mensal no modelo de cobrança por imagem foi estimado com ampliação pelo fator de retentativas.
- Cotas nos dois níveis, linha de negócio e usuário, já estão em vigor.
- A chave de cache e a política de expiração já estão em produção, com monitoramento da taxa de acerto.
- Quantidade de imagens e volume de chamadas já estão no painel de monitoramento, permitindo verificar a tendência de consumo a qualquer momento.
Lado de operações
- O log de requisição inclui ID da requisição, nome do modelo, tempo gasto e identificadores de entrada e saída.
- Há um interruptor de degradação explícito, capaz de alternar com um clique em caso de anomalia.
- Há responsável e canal de alerta; queda da taxa de sucesso chega imediatamente.
- O preço e a base de consumo seguem o painel de preços da HiAPI.ai, e a equipe sabe onde consultar.
Passe por esta lista e só então vá para produção. O image-to-image é uma etapa que exige ajuste contínuo tanto de qualidade quanto de custo; a primeira versão funcionando é apenas o começo, e o ritmo das iterações seguintes depende dos dados de observabilidade que você plantou no primeiro dia.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao seedream-5.0-pro/image-to-image: capacidades, preços e pontos de integração
Limites de capacidade, modelo de cobrança e práticas de integração de engenharia do modelo de edição de imagem da ByteDance
-

Guia de uso
Guia prático do seedream-5.0-pro text-to-image: limites de capacidade, integração via API e controle de custos
Perspectiva prática para desenvolvedores: dos pontos-chave dos parâmetros à estimativa de custo de US$ 0,05 por imagem
-

Guia de uso
Guia de introdução ao Hailuo 2.3 Fast image-to-video: limites de capacidade, preços e práticas de integração
Pontos-chave de seleção e integração do modelo image-to-video MiniMax para desenvolvedores