
Black Forest Labs
FLUX 3 Image
flux-3-image
Modelo de imagem da família multimodal da Black Forest Labs, que compartilha a arquitetura de treinamento conjunto e o framework Self-Flow com vídeo e áudio, ideal para atualizar pipelines de geração de imagens baseados no sistema FLUX
Experimentar flux-3-image
Entrada
Criações
Ver todas as criaçõesSaída
image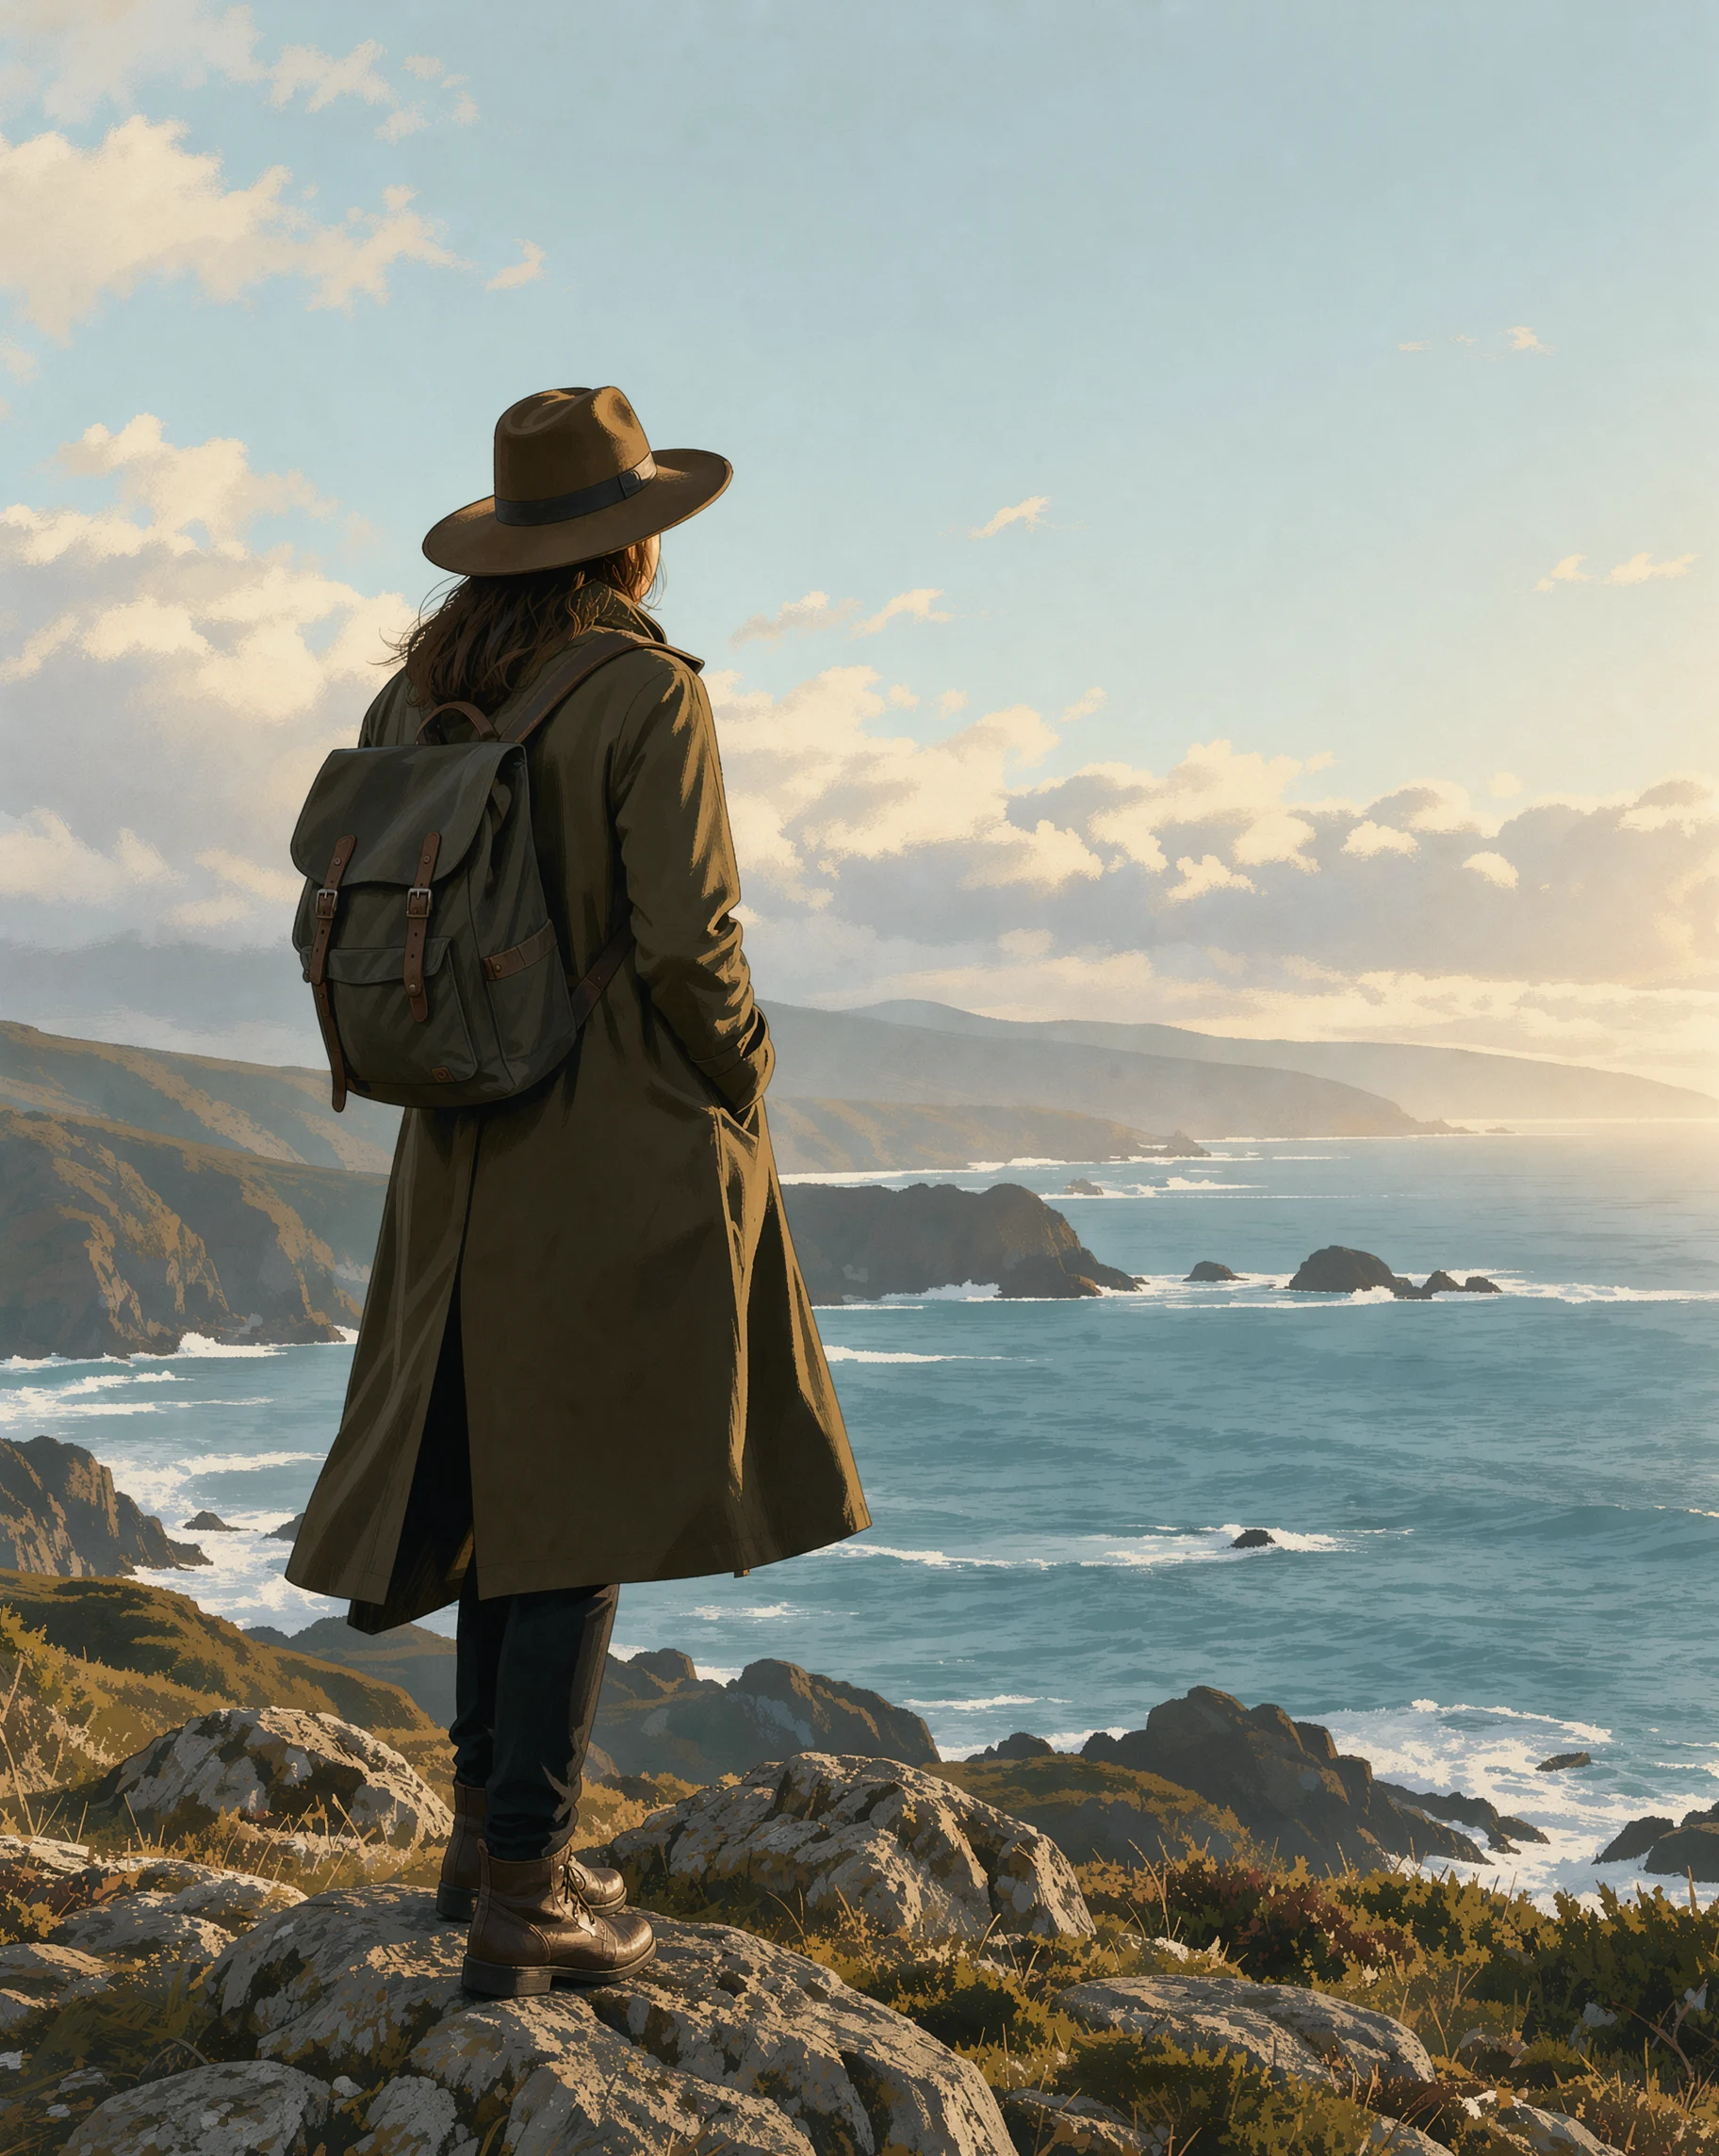
Espectro de estilo: do realismo ao flat no mesmo sujeito
Estilo style-spectrum · ilustração-editorial · Gráfico plano
Entradas de referência
image_urls
image_urls
Prompt
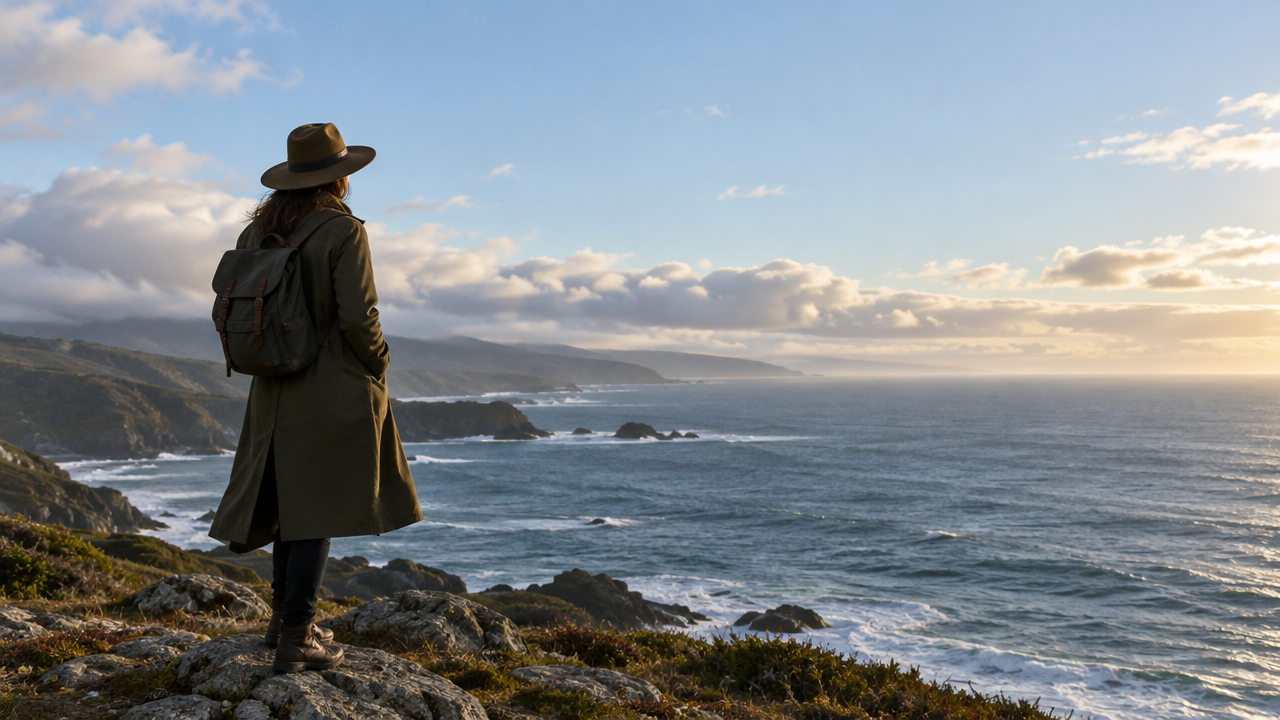
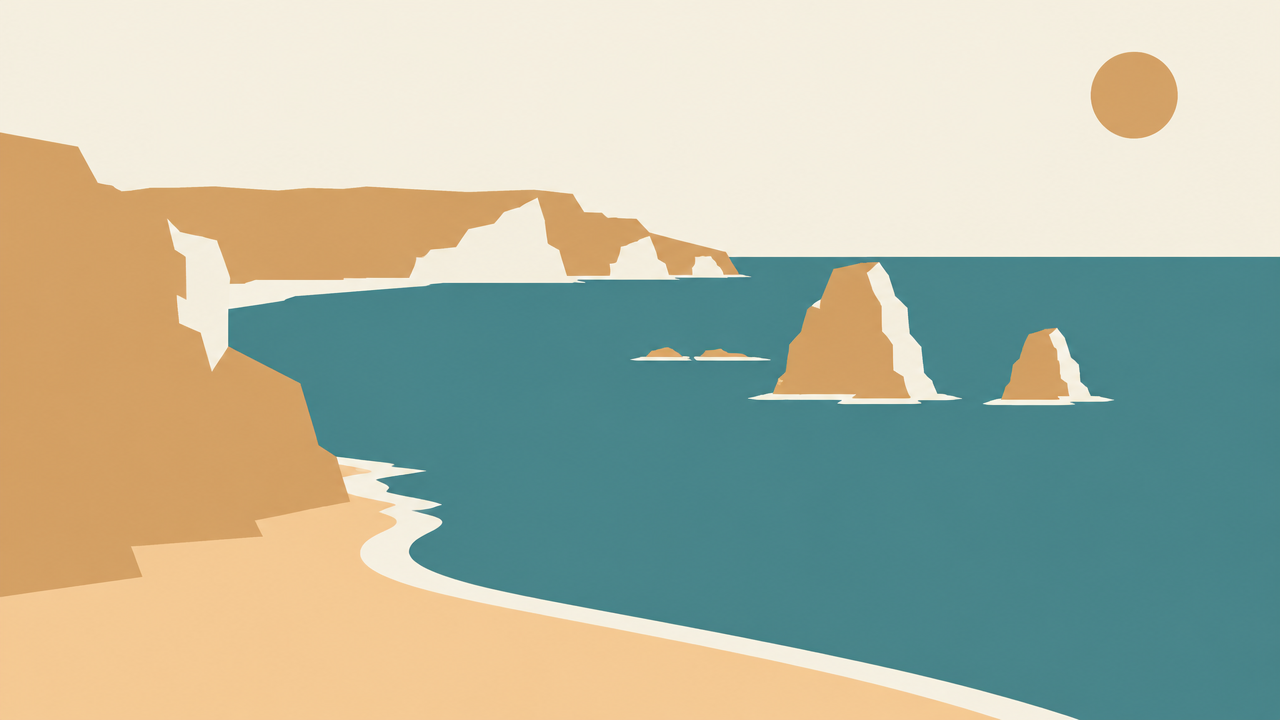
Ilustração de estilo editorial: um viajante solitário com chapéu de aba larga está em um mirante na costa rochosa, visto em três quartos de costas, com o mar e nuvens baixas ao fundo. A imagem de referência 1 define a identidade do sujeito e a composição; a imagem de referência 2 define os blocos de cor e a linguagem de pincelada. Meta de estilo: situar-se em um espectro entre o realismo pictórico e a ilustração gráfica plana — renderização semirrealista, com volume visível, luz de contorno suave vinda de um sol em ângulo baixo, paleta contida mas saturada, bordas simplificadas em formas limpas, sem textura espessa e sem gradientes além da névoa atmosférica. Composição em 4:3, sujeito à esquerda do centro, céu aberto à direita, amplo espaço negativo. Paleta em verde-azulado suave, areia quente e branco-creme, criando uma atmosfera calma e contemplativa, com qualidade de página dupla de revista de alto padrão.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
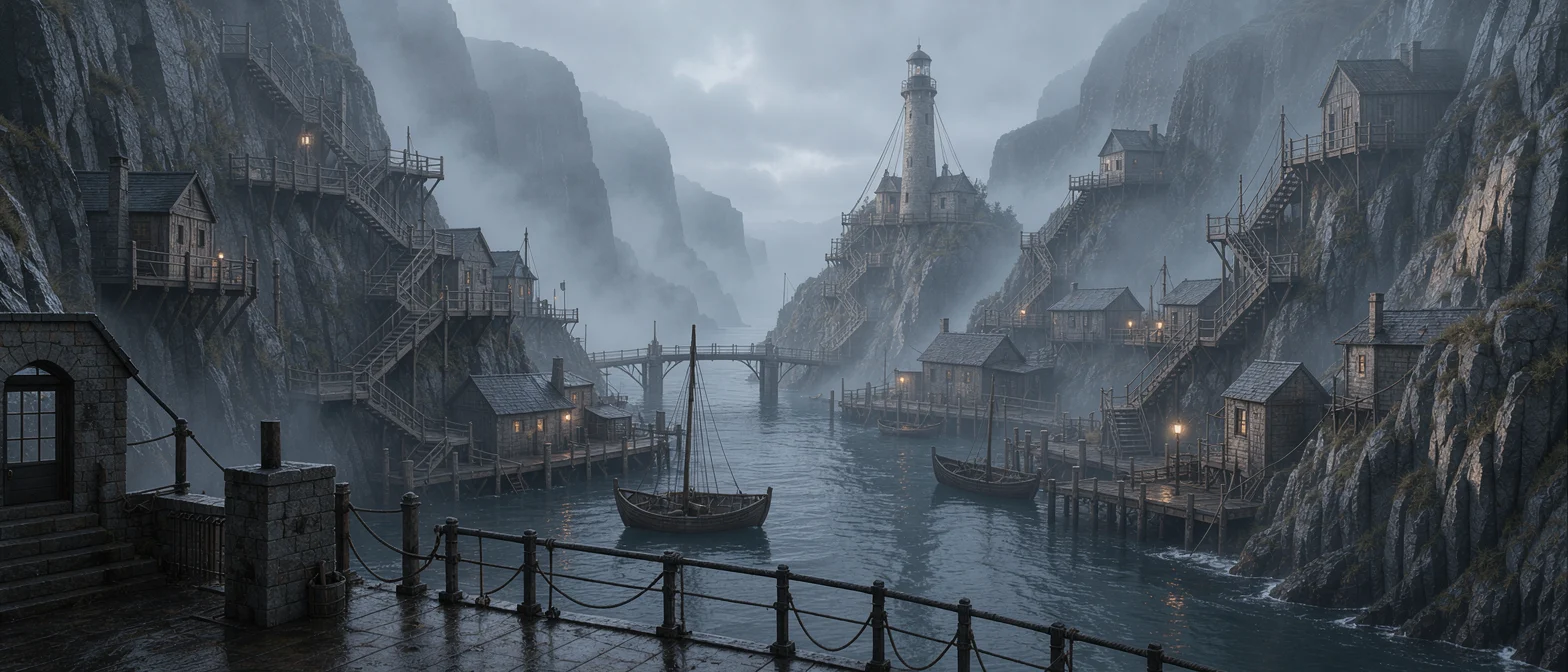
Arte conceitual de cenário de worldbuilding do FLUX 3: Luz da manhã no porto enevoado
Estilo Arte conceitual · Construção de mundo · Atmosfera
Entradas de referência
image_urls
image_urls
Prompt
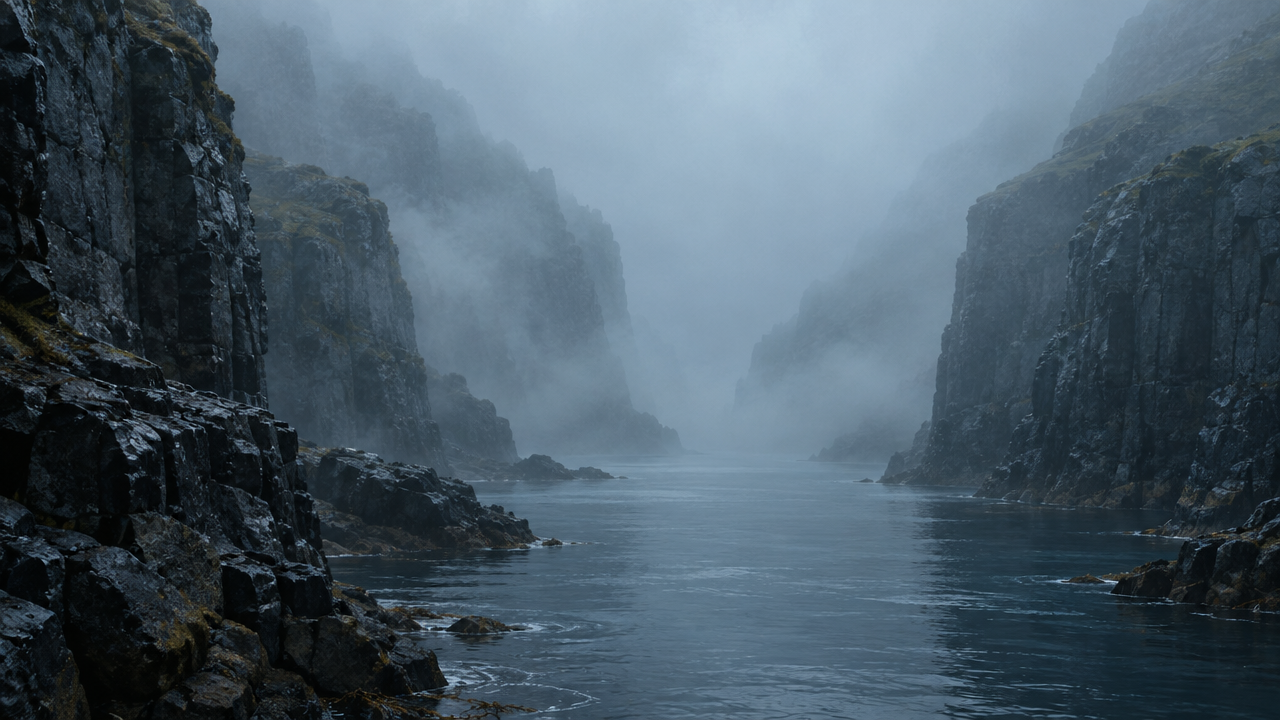
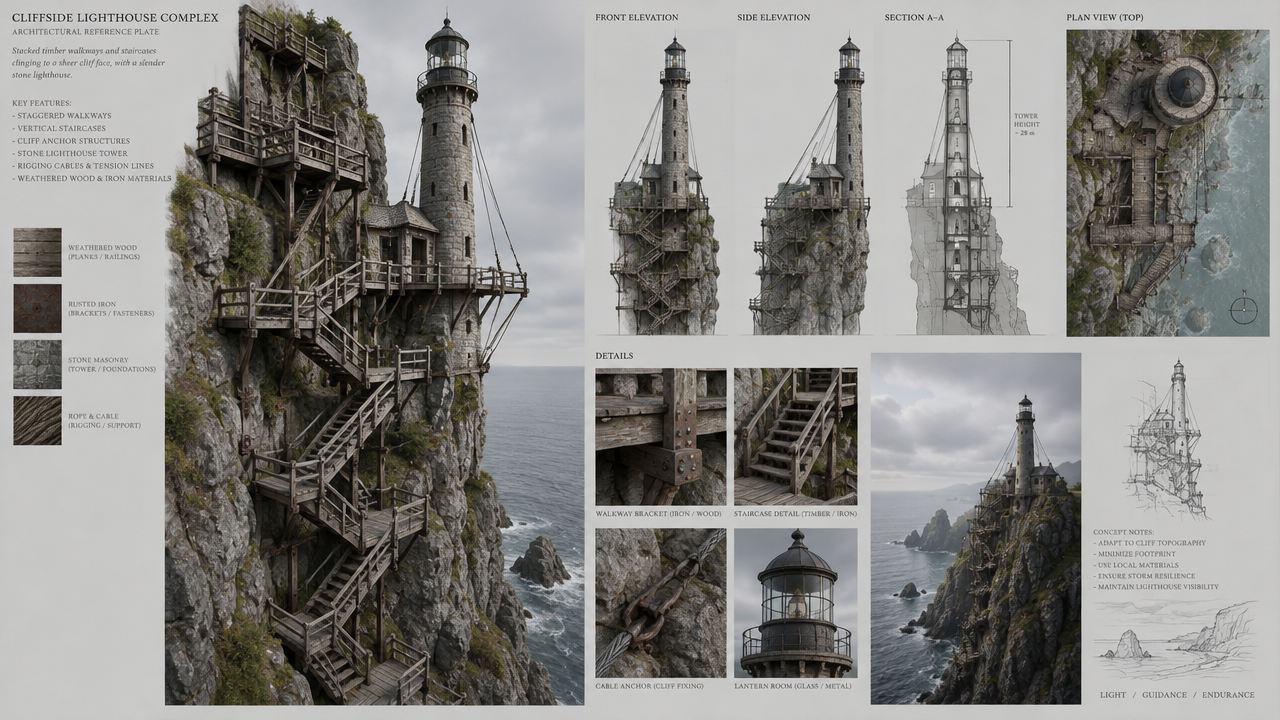
Arte conceitual cinematográfica de worldbuilding de uma cidade-cânion portuária envolta em névoa matinal. A imagem de referência 1 define a atmosfera, a paleta de cores e a névoa volumétrica; a imagem de referência 2 define a linguagem arquitetônica de passarelas de madeira empilhadas, faróis esguios e cordames. Combine-as em um assentamento coeso: terraços em níveis sucessivos sobem por falésias de basalto molhado, escadarias estreitas, pequenos barcos atracados, luz quente de lanternas atravessando a névoa azul-fria. Composição de plano de estabelecimento em formato amplo 16:9, forte profundidade em camadas, primeiro plano com grades em silhueta, plano médio com vãos de pontes, e o farol ao longe como ponto focal visual. Matte painting digital com qualidade pictórica, paleta contida e dessaturada com toques seletivos de cores quentes, luz de contorno suave, delicada perspectiva atmosférica. Sem texto, sem marca d'água.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
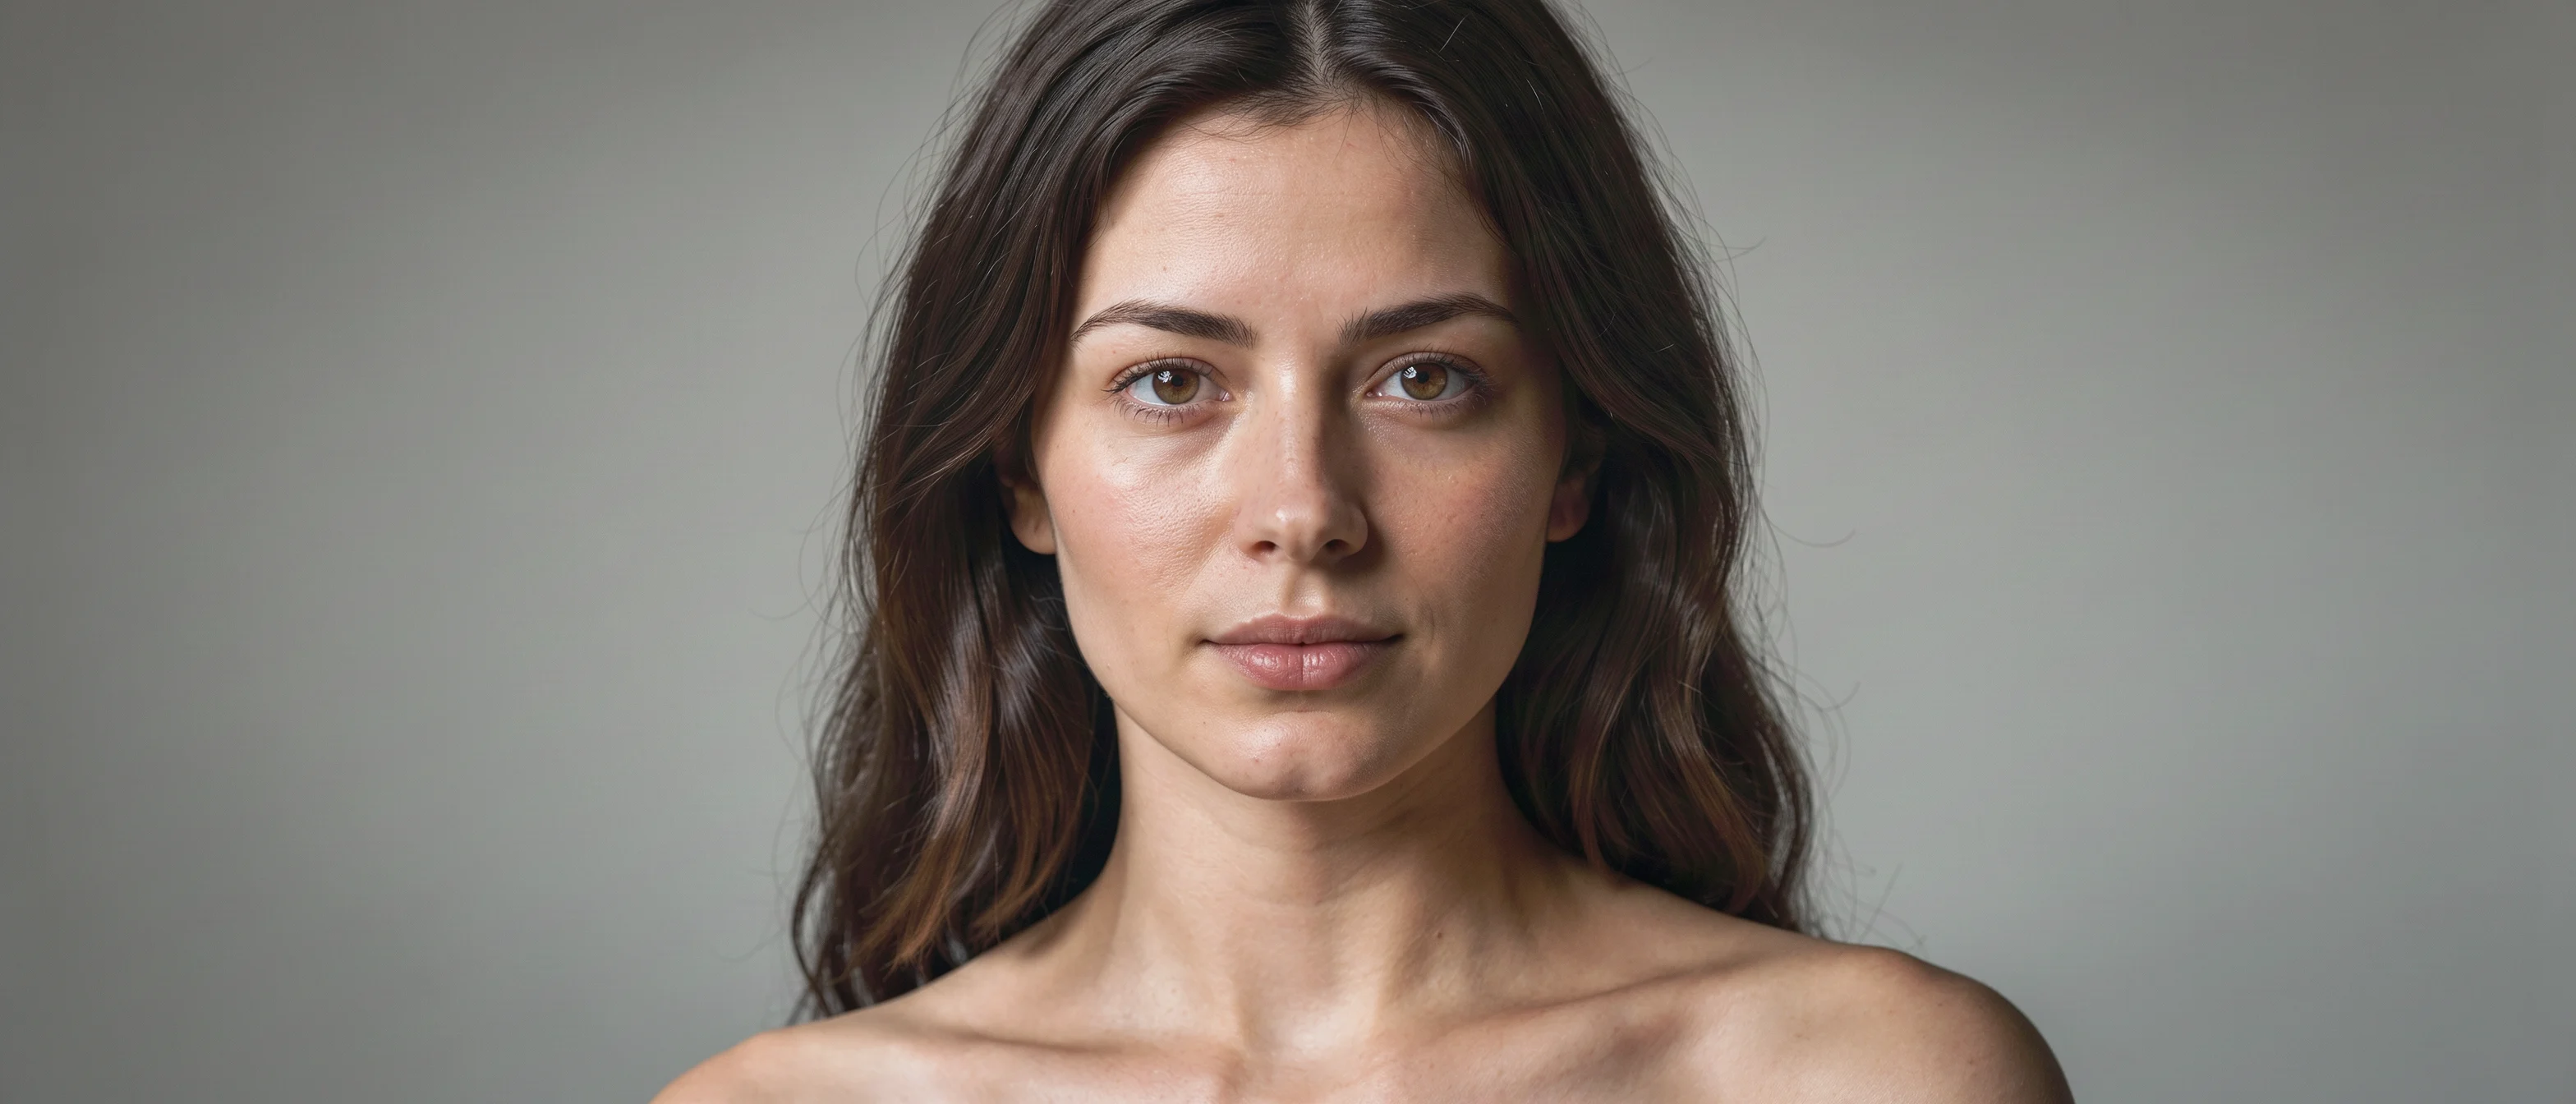
Demonstração de retrato FLUX 3: referência em estilos realista e artístico
Estilo Retrato e fotografia · Fotorrealismo · Editorial
Entradas de referência
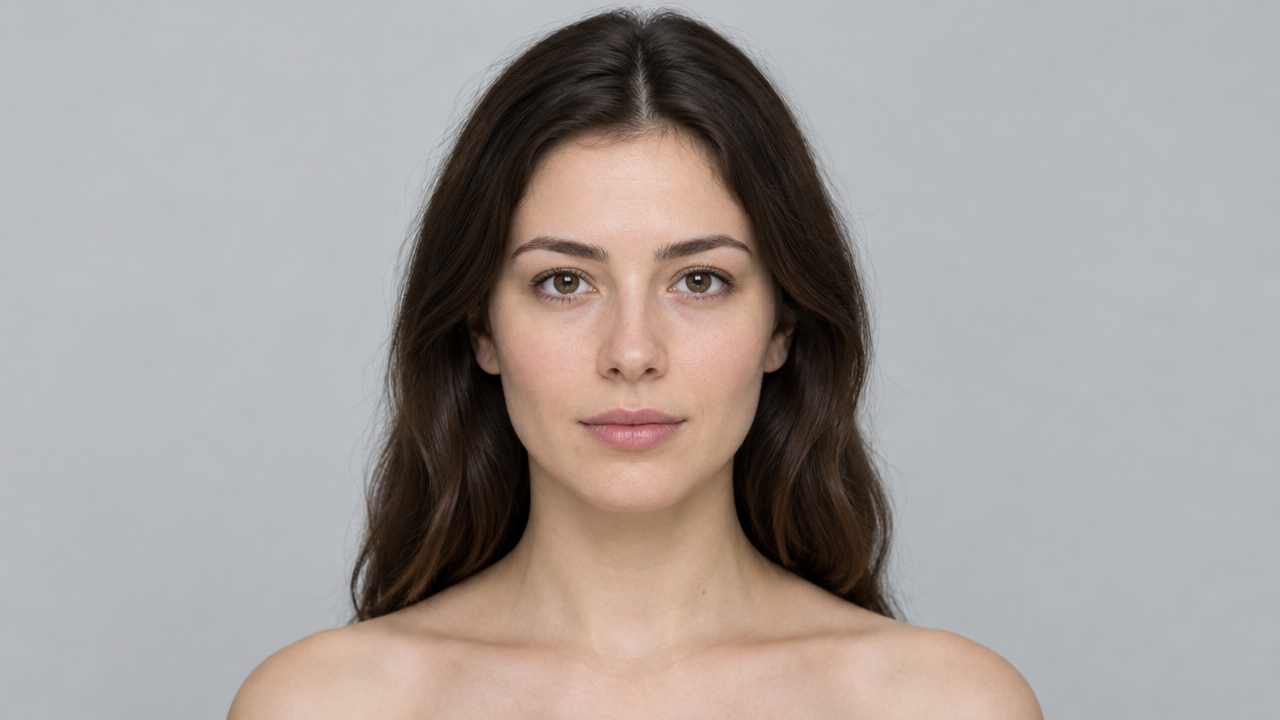
image_urls
Prompt
Retrato editorial de uma jovem, enquadramento de cabeça e ombros, proporção vertical 4:5. Luz de janela suave e direcional vinda da esquerda da câmera, com transição gradual para um fundo cinza-quente suave. Textura de pele natural, poros visíveis e fios finos de cabelo, brilho sutil nos olhos, profundidade de campo rasa f/2.0. Expressão calma e neutra, olhar ligeiramente desviado da câmera. Paleta de cores contida, alta faixa dinâmica, sem retoque pesado. Qualidade de fotografia realista, detalhes de médio formato.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
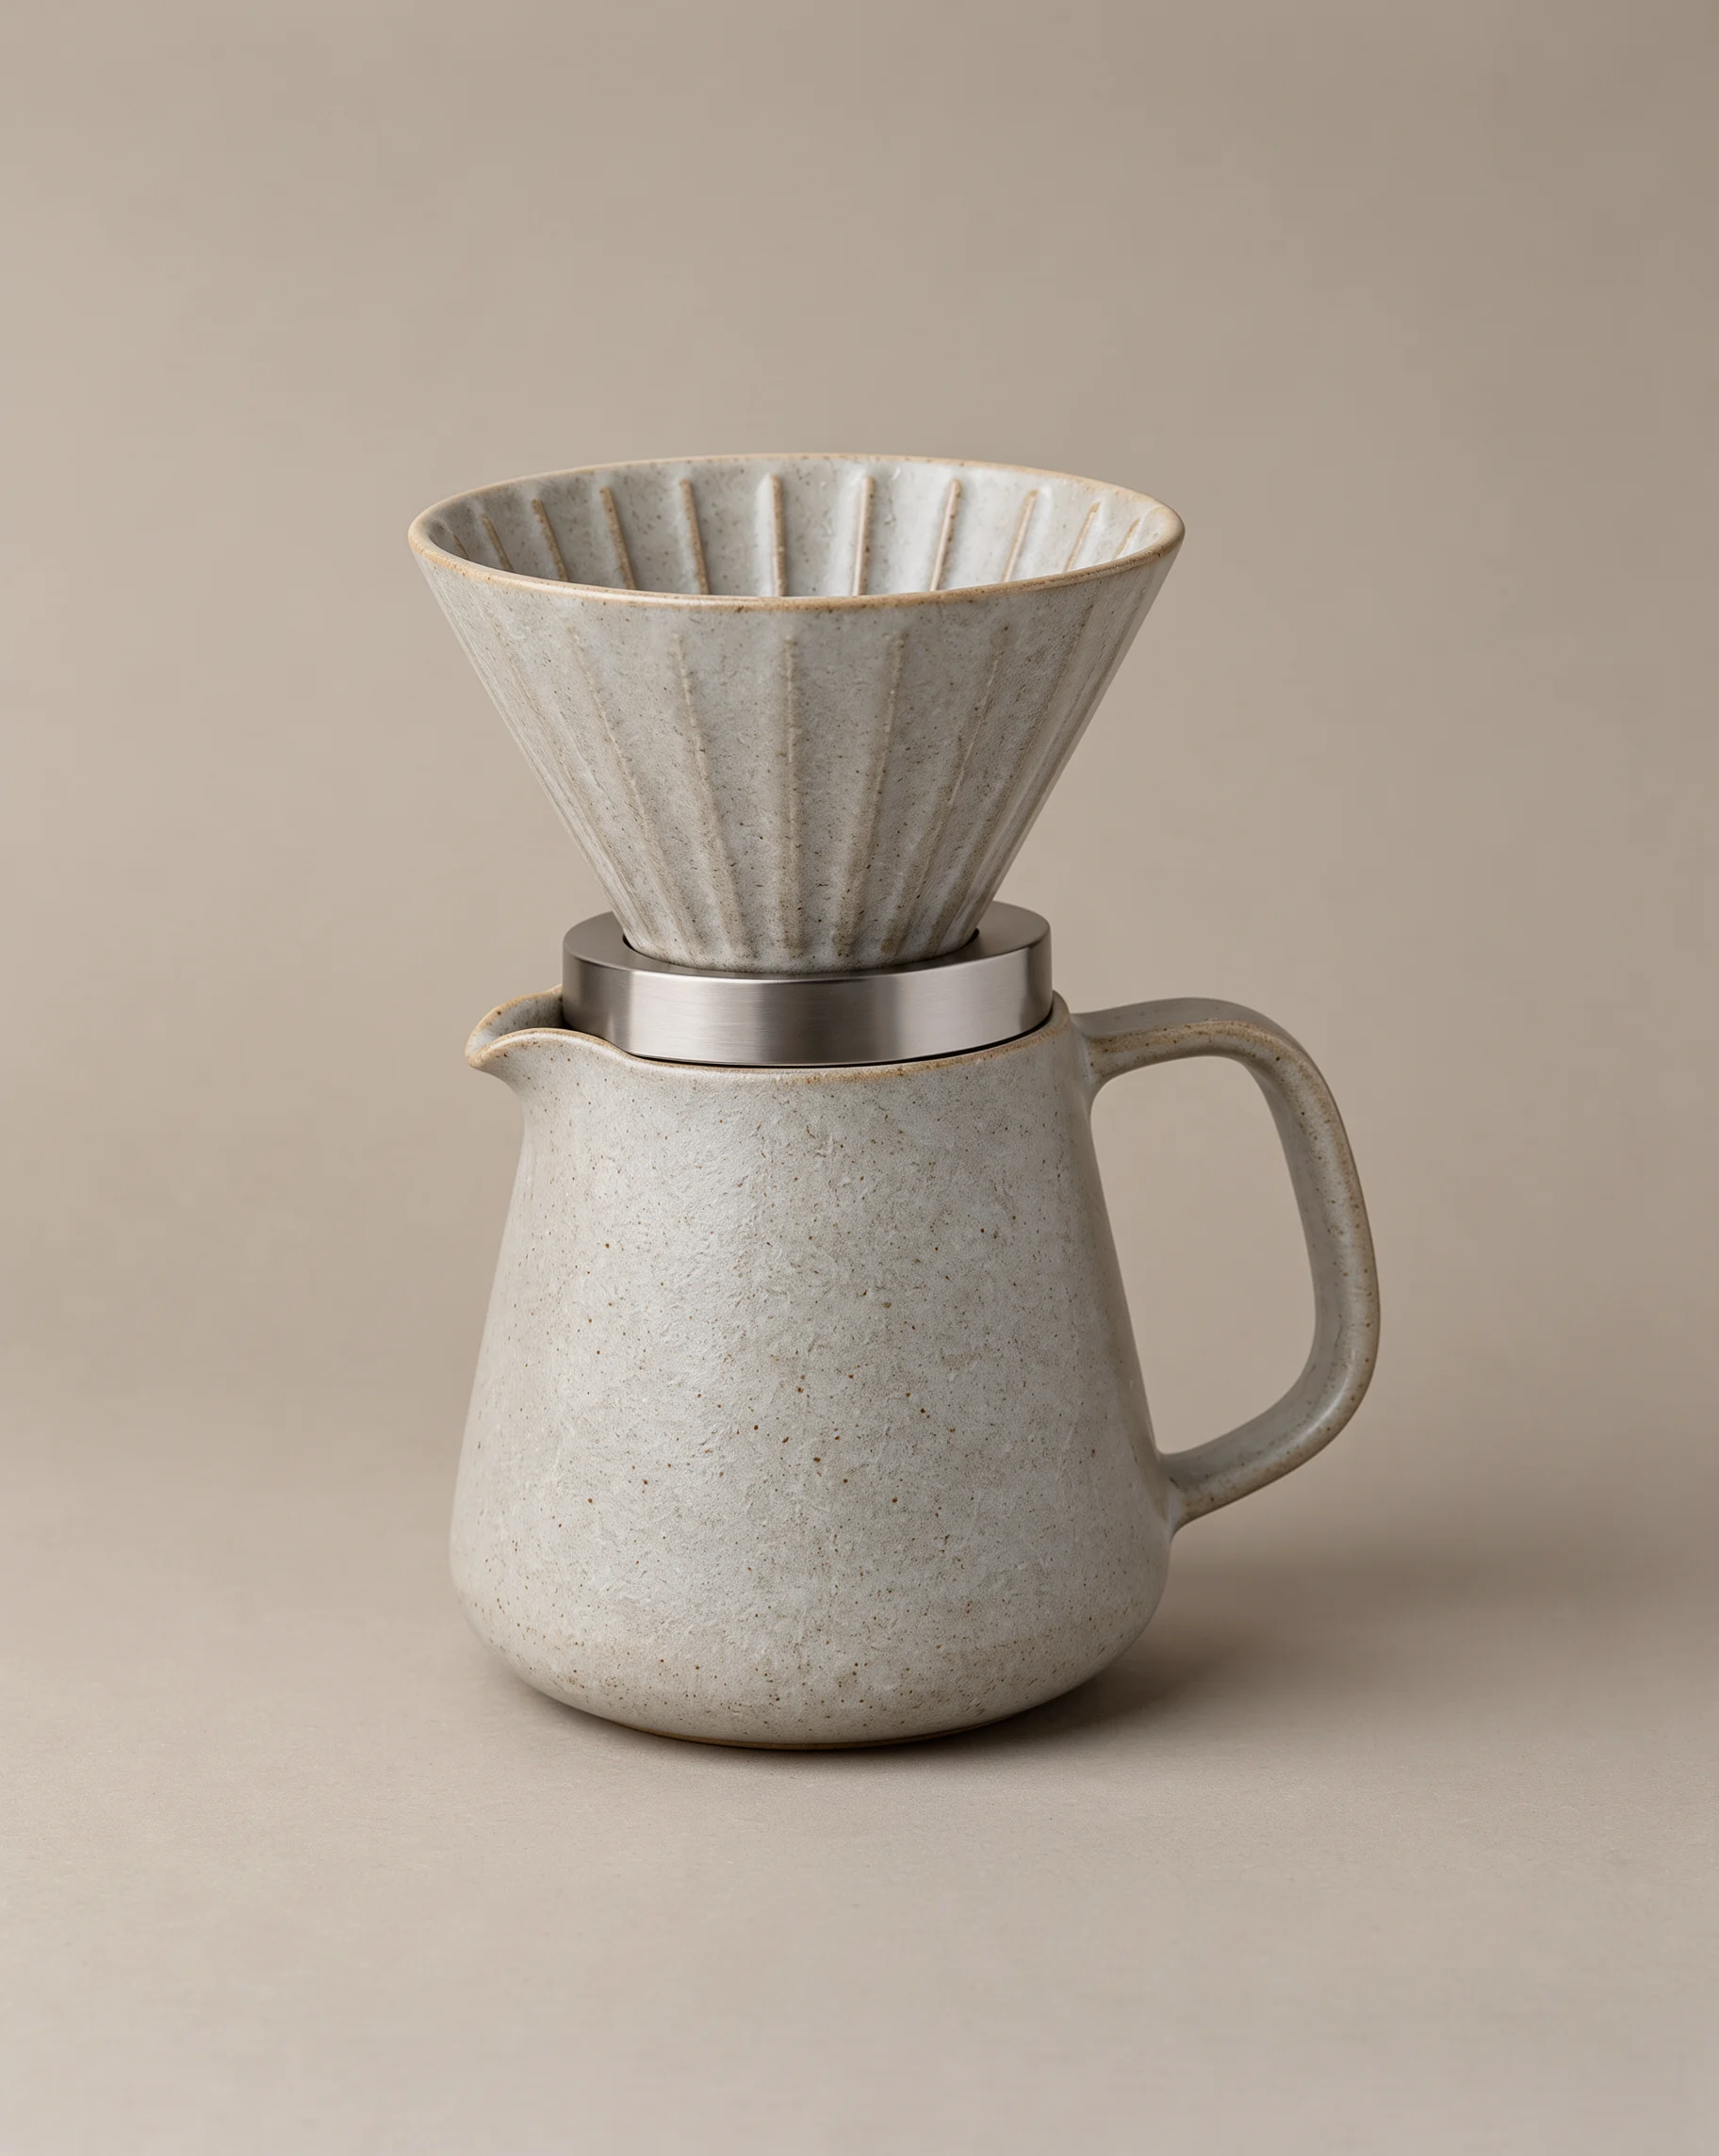
flux-3-image 质感 de fotografia de produto para e-commerce
Estilo Imagem do produto · ecommerce · Iluminação de estúdio
Entradas de referência
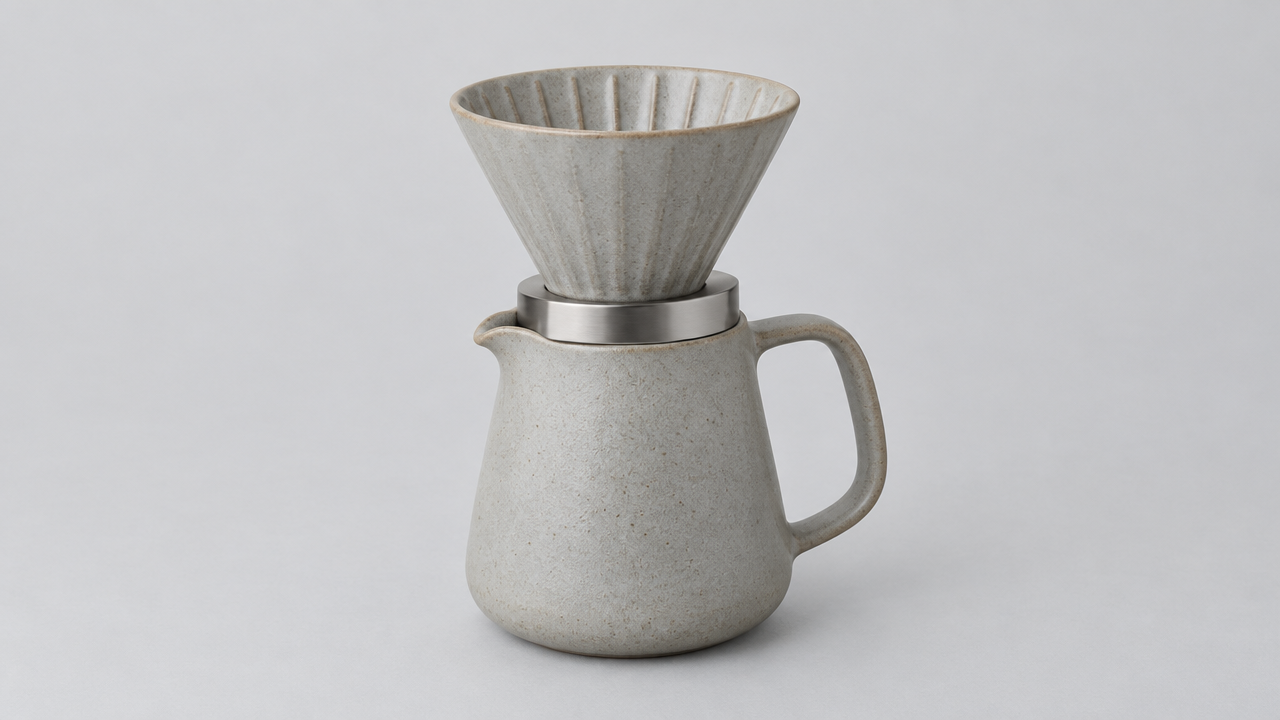
image_urls
Prompt
Fotografia de produto em estúdio: conjunto de café coado em cerâmica fosca, sujeito centralizado e ligeiramente fora do eixo, sobre fundo contínuo em cinza-areia quente. Grande softbox suave no canto superior esquerdo com atenuação de gradiente sutil, uma luz de contorno fina na borda direita separa o corpo do fundo, e uma sombra suave no chão estabiliza a base. Capturado com lente equivalente a 85mm e abertura f/8, alcançando nitidez de centro a borda, com profundidade de campo rasa o suficiente para desfocar suavemente o fundo. Nas bordas da cerâmica são visíveis microtexturas do esmalte e reflexos de realce, com detalhes nítidos do anel metálico. Color grading neutro, balanço de branco fiel, sem adereços desordenados, com amplo espaço negativo à direita para texto. Estética de catálogo comercial de e-commerce, limpa e de alta fidelidade, composição horizontal 3:2.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
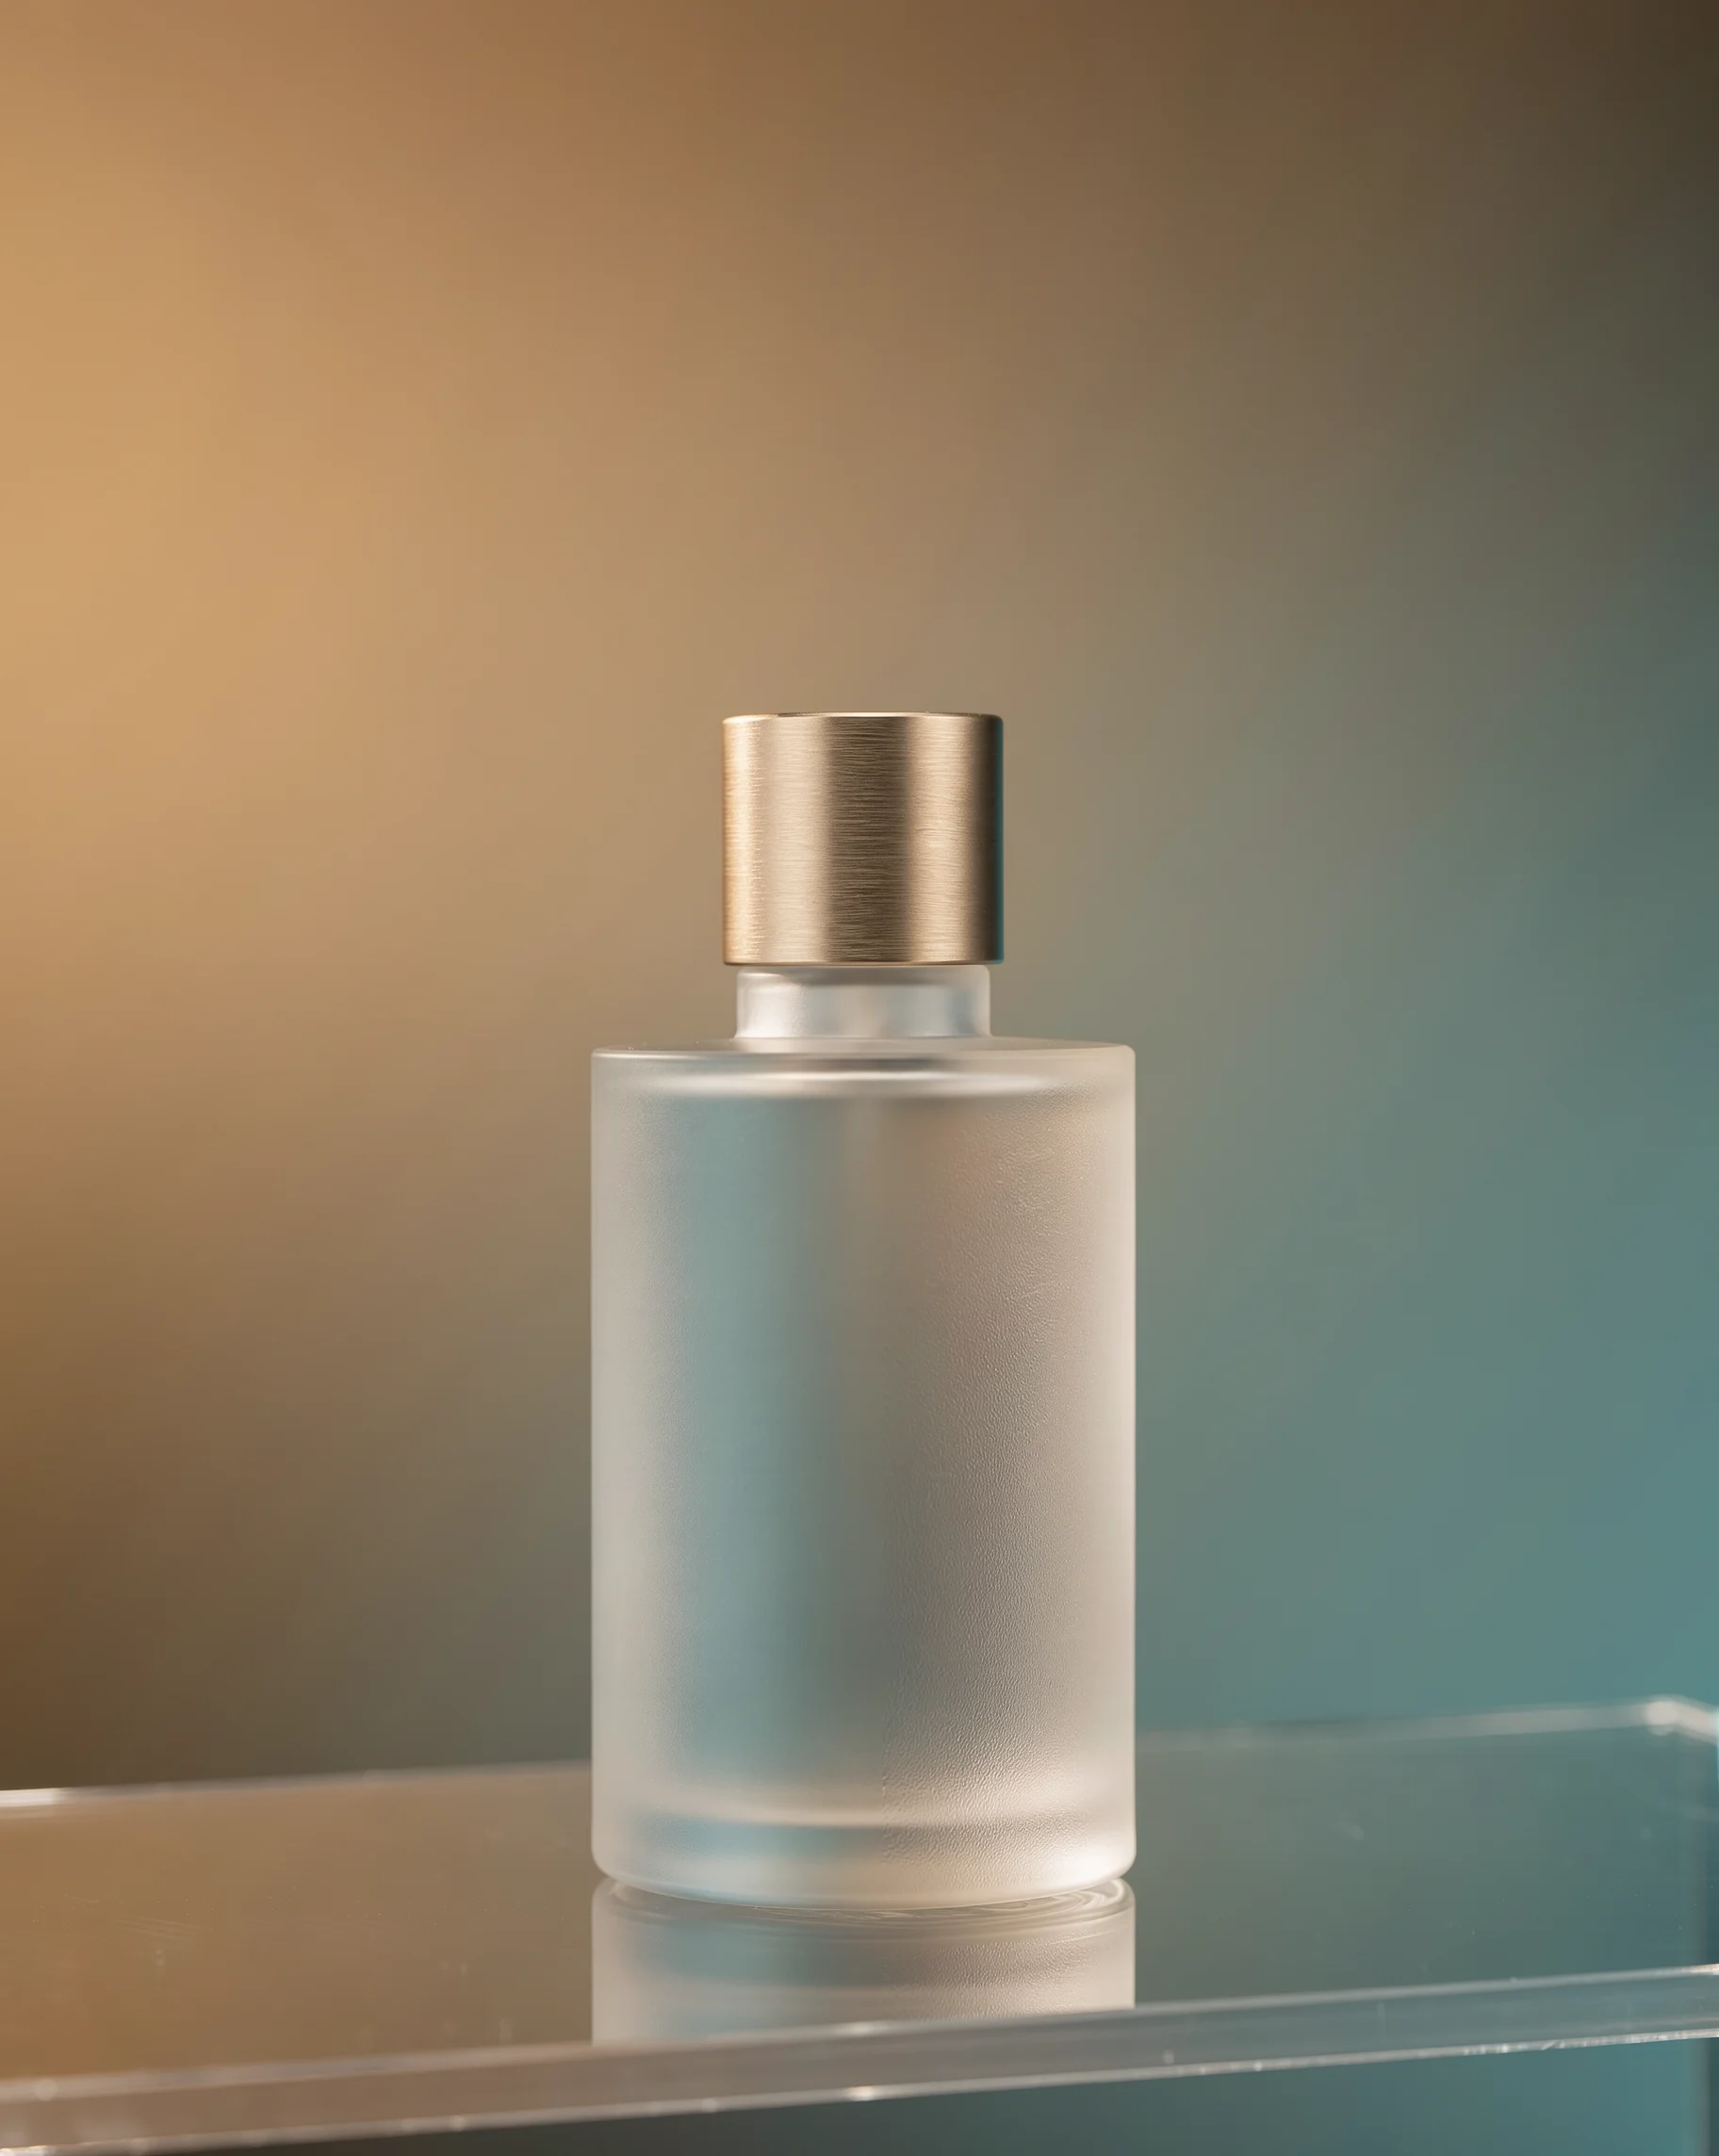
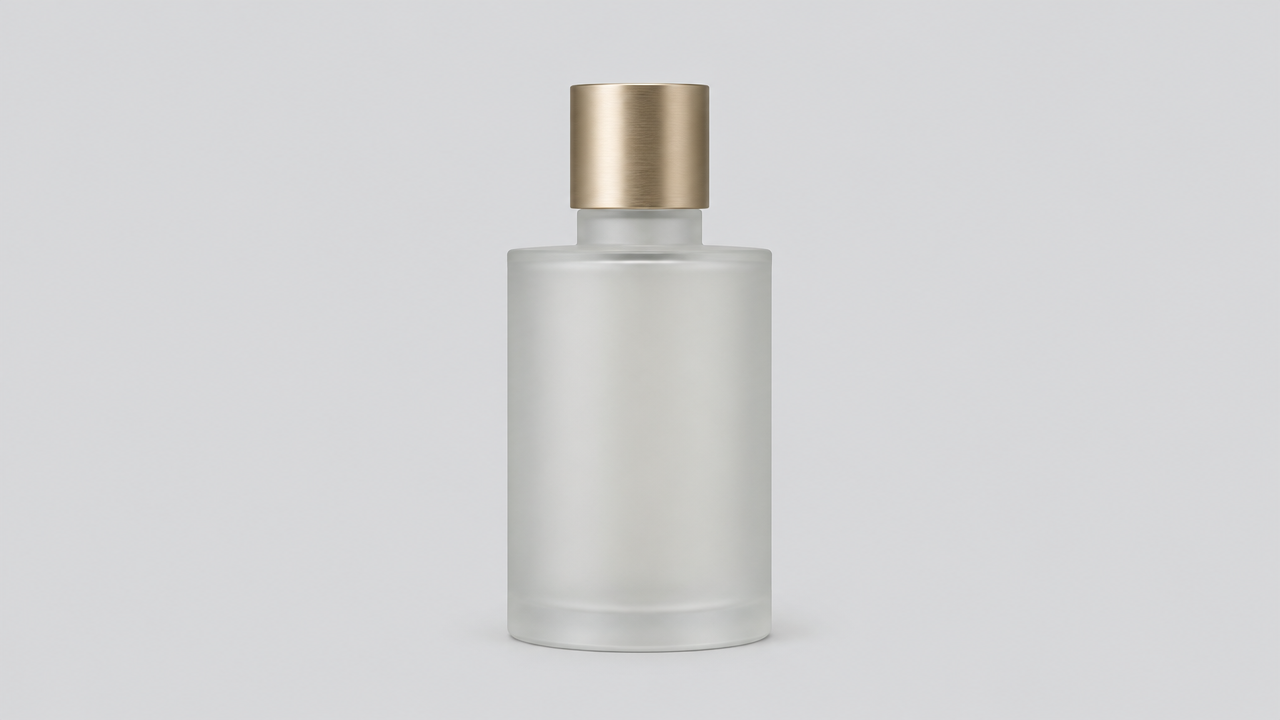
flux-3-image 静物 de produto nível e-commerce: fotografia de perfume com contraste entre quente e frio
Estilo Imagem do produto · ecommerce · Iluminação de estúdio
Entradas de referência
image_urls
Prompt
Fotografia de produto de e-commerce de alto padrão, um frasco de perfume de vidro fosco, com tampa em dourado champanhe escovado, posicionado ligeiramente fora do centro sobre uma plataforma de exibição de acrílico transparente, luz principal dura projetada do canto superior direito, formando reflexos nítidos e sharp nas bordas do frasco, grande softbox à esquerda preenchendo e clareando o lado em sombra, fundo em gradiente de âmbar quente transitando para ciano frio à direita, reflexo sutil na superfície brilhante sob o frasco, uma leve camada de condensação de vapor d'água no vidro, profundidade de campo rasa, rótulo nítido e sharp, fundo suavemente desfocado, composição vertical 4:5, espaço negativo amplo no topo para posicionar texto, estética de retoque comercial limpa, sem texto, sem logotipo, refração de vidro e microtextura metálica ultradetalhadas
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
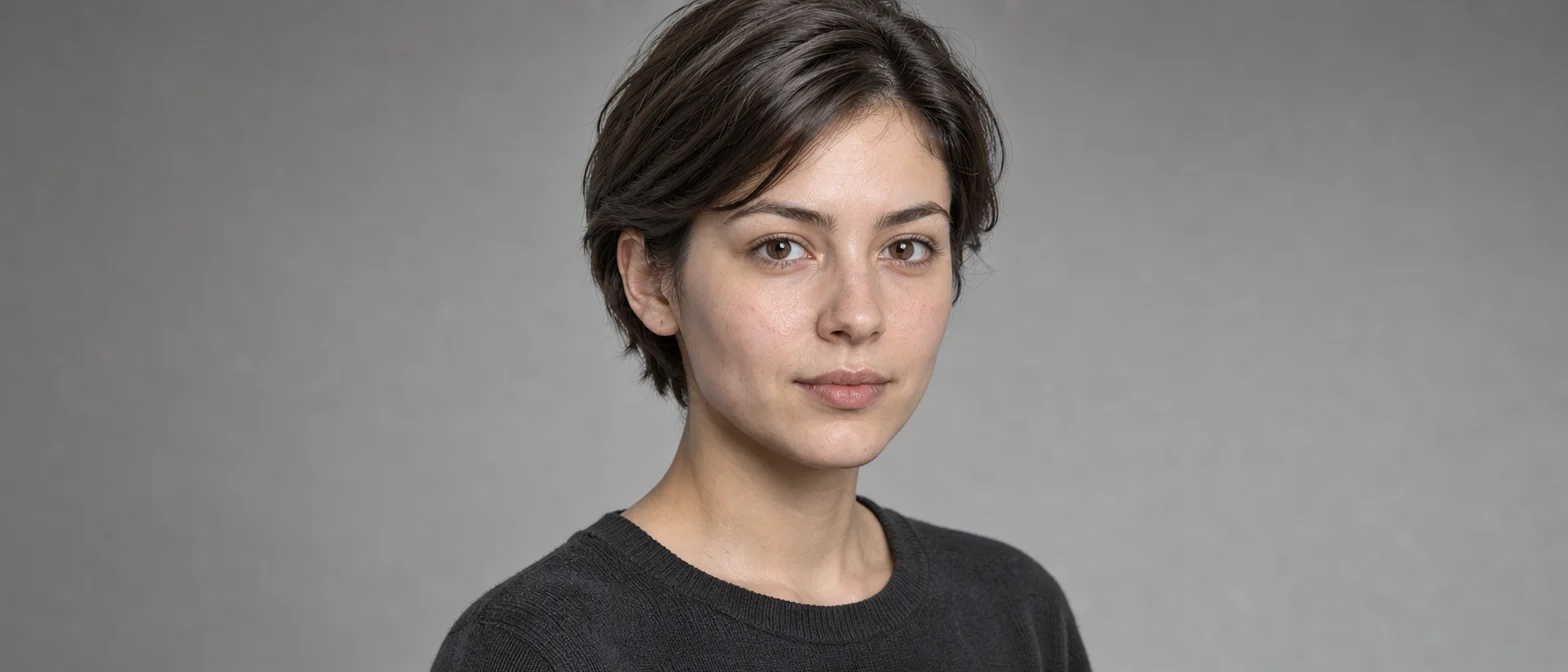
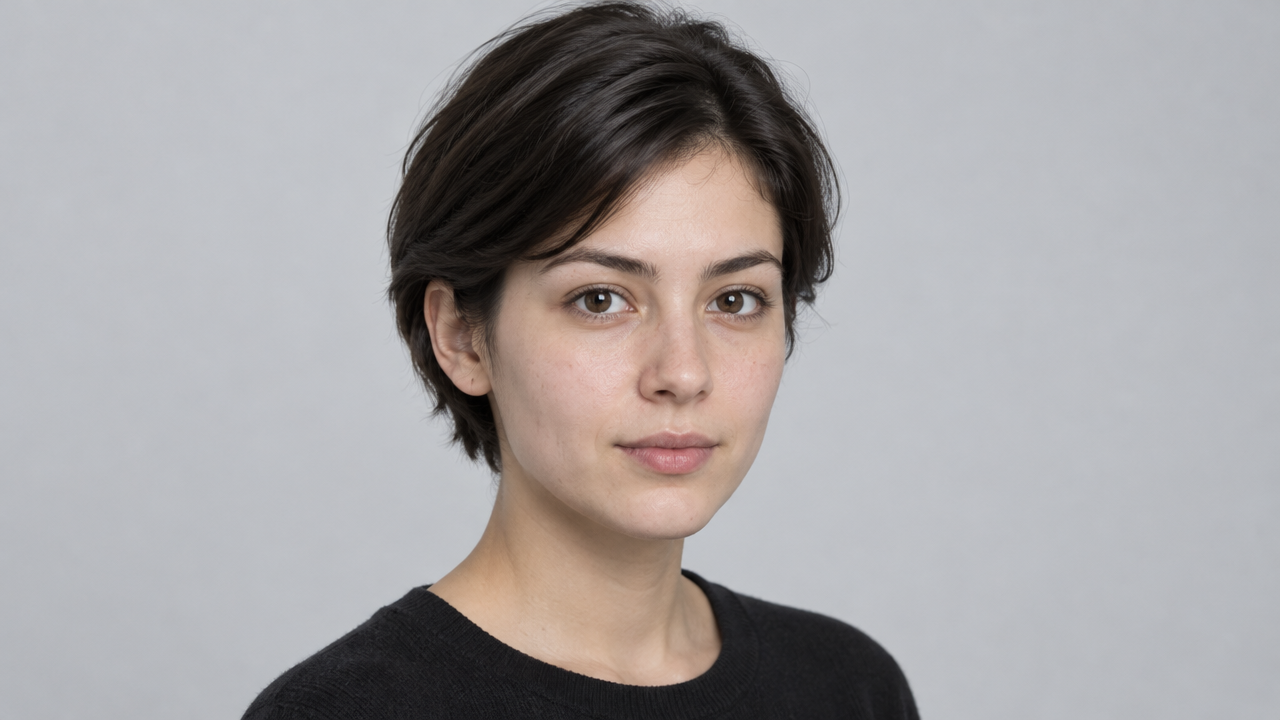
Demonstração de dois estilos de retrato com FLUX 3 Image: realismo e artisticidade
Estilo Retrato e fotografia · Fotorrealismo · Estilo de pintura
Entradas de referência
image_urls
Prompt
Retrato de estúdio fotorrealista, uma jovem de cabelo curto escuro, visão de três quartos, luz suave de janela entrando pela esquerda, textura de pele natural com poros e fios de cabelo finos visíveis, leve brilho nos olhos, fundo infinito cinza neutro, profundidade de campo rasa, textura de lente 85mm, color grading de baixa saturação, suéter de tricô cinza-escuro liso com detalhes ricos de tecido, expressão calma e neutra, estética de fotografia editorial de revista, composição vertical 4:5, espaço livre no topo
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
flux-3-image per image
| Especificações | Preço unitário |
|---|---|
| 768S | $0.041 |
| 1K | $0.048 |
| 1.5K | $0.070 |
| 2K | $0.100 |
| 4K | $0.607 |
Visão geral
flux-3-image é o modelo de imagem da família multimodal FLUX 3 da Black Forest Labs, acessível por meio da interface unificada do HiAPI.ai. Ele aceita tanto prompts de texto puro para gerar imagens diretamente quanto até 10 imagens de referência para participarem da geração e de modificações locais, com formato de saída, níveis de resolução e tolerância à segurança de conteúdo ajustáveis. É indicado para desenvolvedores que estão construindo pipelines de geração de conteúdo visual e para equipes que precisam integrar a nova geração de modelos aos fluxos de trabalho de imagem FLUX existentes.
Destaques principais
- Controle combinado de imagens de referência e prompt — é possível enviar até 10 imagens de referência e especificar no prompt, imagem por imagem, o papel de cada uma como sujeito, estilo ou composição.
- Busca na web opcional para complementar informações visuais — o grounding vem habilitado por padrão e, antes da geração, consulta páginas web e imagens para complementar entidades e detalhes de cena do prompt.
- Resolução e formato com opções detalhadas — a saída cobre cinco níveis de pixels, de 768 a 4K, e 16 proporções de imagem; o modo auto pode definir o formato automaticamente com base no prompt e nas imagens de referência.
Descrição das capacidades
Geração de imagem a partir de texto e geração guiada por imagens de referência: uma única requisição gera uma imagem a partir do prompt; ao fornecer imagens de referência, basta indicar no prompt o que deve ser modificado e o que deve ser preservado para concluir o ajuste direcionado, sem etapas separadas.
Combinação de múltiplas imagens de referência: é possível usar até 10 imagens de referência por requisição, cada uma desempenhando o papel de sujeito, estilo ou composição, o que é adequado para reunir diversos materiais visuais em uma mesma cena.
Controle de formato e resolução: aspect_ratio oferece 16 proporções, de imagens horizontais 21:9 a verticais 9:21, com seleção automática, e resolution cobre de 768 a 4K, facilitando a geração em lote conforme o canal de veiculação e os requisitos de nitidez.
Ajuste da tolerância à segurança de conteúdo: safety_tolerance é ajustável de 0 a 4, com padrão 2, permitindo que as equipes restrinjam ou afrouxem a intensidade do filtro conforme suas exigências de conformidade.
Cenários de aplicação
- Geração de imagens estilizadas por equipes de design criativo — inserir a descrição do design e imagens de referência de estilo para produzir peças visuais com composição e formato especificados, usadas em materiais publicitários e propostas conceituais.
- Atualização de modelos em pipelines FLUX existentes — substituir a chamada atual de geração de imagem por prompts de texto, mantendo o formato da interface de saída, o que facilita atualizar o modelo sem alterar os fluxos superiores.
- Produção de imagens de cena que exigem detalhes factuais — com o grounding habilitado, descrever o sujeito com um prompt curto e obter uma imagem complementada com informações de busca, usada para ilustrar conteúdos e representar cenários.
- Composição de múltiplos materiais e retoque de imagens — enviar várias imagens de referência e indicar o papel de cada uma para obter resultados compostos ou modificados em estilo unificado, usados em imagens de e-commerce e reutilização de materiais.
Limitações e recomendações de escolha
As informações públicas concentram-se na família FLUX 3 como um todo e na vertente de vídeo, com divulgação limitada de especificações específicas desta versão de imagem; as descrições de treinamento conjunto e capacidades de vídeo no nível da família não equivalem diretamente a todas as capacidades deste modelo. O grounding realiza a busca antes da geração, o que pode aumentar o tempo de cada requisição. Para desempenho em velocidade de geração, estabilidade e prompts extremamente difíceis, recomenda-se validar primeiro com amostras próprias antes de adotar em produção. Se a necessidade for geração de vídeo ou áudio, deve-se escolher o modelo da vertente correspondente dentro da mesma família.
Perguntas frequentes
Ver todas as perguntas →-
É possível gerar e editar em um único ponto de entrada?
Sim. Sem imagem de referência, gere a partir de texto; com 1 a 10 imagens de referência, edite com base no material existente. Basta preparar o texto ou as imagens de acordo com o objetivo de criação.
-
Como escolher entre os cinco níveis de resolução?
Comece com 768 ou 1K para discutir a direção; considere 1.5K ou 2K quando precisar de mais detalhes e 4K quando precisar de imagens maiores e espaço para recorte. Os níveis não são dimensões fixas; verifique a largura e a altura da imagem retornada.
-
Como as imagens de referência distribuem seus papéis?
Explique, em ordem, qual imagem fornece o sujeito, qual fornece o ambiente e qual fornece apenas o esquema de cores ou o estilo, indicando também quais elementos não devem ser trazidos.
-
Quantas imagens são geradas por vez?
Cada tarefa retorna uma imagem. Quando precisar de outra direção, ajuste a descrição e envie uma tarefa separada.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: flux-3-image
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para flux-3-image e a rota default — veja a tabela de parâmetros abaixo.
promptstringObrigatóriominLength 1maxLength 5000Descreva o conteúdo da imagem que deseja gerar; quando uma imagem de referência for fornecida, você também pode especificar aqui as partes da imagem que precisam ser modificadas e as que devem ser preservadas.
groundingbooleanOpcionalPadrão: trueValor booleano que controla se, antes da geração, deve-se pesquisar na web e em imagens para complementar as informações visuais do prompt; o padrão é true.
image_urlsarrayOpcionalminItems 1maxItems 10Array de URLs de imagens de referência, usado para fornecer referência visual à geração; o papel de cada imagem (sujeito, estilo ou composição) deve ser descrito no prompt.
Array [ string ]
resolutionstringOpcionalPadrão: "1K"Nível de resolução de saída; a largura e a altura específicas variam conforme a proporção da imagem; o padrão é 1K.
7681K1.5K2K4Kaspect_ratiostringOpcionalPadrão: "auto"Proporção da imagem de saída, podendo ser horizontal, vertical ou quadrada; auto indica que a proporção é determinada automaticamente com base no prompt e nas imagens de referência; o padrão é auto.
21:92:116:93:27:54:35:41:1Mostrar tudo (8)
4:53:45:72:39:161:29:21autosafety_toleranceintegerOpcionalPadrão: 2min 0max 4Número inteiro que indica a tolerância de segurança de conteúdo; o valor 0 é o mais rigoroso; o padrão é 2.
callbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "flux-3-image",
  "input": {
    "prompt": "…",
    "grounding": true,
    "resolution": "1K",
    "aspect_ratio": "auto",
    "safety_tolerance": 2
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "flux-3-image",
input: {
"prompt": "…",
"grounding": true,
"resolution": "1K",
"aspect_ratio": "auto",
"safety_tolerance": 2
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "flux-3-image",
"input": {
"prompt": "…",
"grounding": True,
"resolution": "1K",
"aspect_ratio": "auto",
"safety_tolerance": 2
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →-

Avaliação comparativa
hailuo-2.3-fast/image-to-video comparação lado a lado: como escolher modelos de imagem para vídeo e pontos de migração
-

Tutorial
recraft-v4.1-flash geração de imagens por texto na prática: 5 cenários de negócio de alto valor e pontos de integração
Partindo de um custo de US$ 0,01 por imagem, planeje como aplicar a geração de imagens em negócios reais
-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video na HiAPI: curl + Python
Faça uma requisição de imagem para vídeo funcional na HiAPI: do upload do primeiro quadro ao polling assíncrono e ao download final
-

Avaliação comparativa
Comparação lado a lado do Recraft v4.1 Flash em text-to-image: guia de seleção e migração para desenvolvedores
Com um custo de $0.01 por imagem e capacidade de text-to-image pura, avalie se ele é adequado para seu pipeline de geração de imagens
-

Tutorial
Como chamar kling-4.0/image-to-video na HiAPI: curl, Python e polling
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado
-

Tutorial
Como usar kling-4.0/text-to-video através da API HiAPI: curl, Python e um exemplo de requisição executável
Guia prático para desenvolvedores: prompts cinematográficos, áudio sincronizado, polling assíncrono e download da saída
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 Wan 2.7 Image Alibaba $0.035 /imagem
-
 FLUX.2 Black Forest Labs $0.035 /imagem
-
 Krea 2 Medium Turbo Krea $0.021 /imagem
-
 851 Labs Background Remover 851 Labs $0.002 /imagem
-
 BRIA Product Shot Bria $0.058 /imagem
-
 Recraft V4.1 Recraft $0.010 /imagem
-
 Nano Banana 2 Google $0.036 /imagem
-
 Nano Banana Pro Google $0.057 /imagem
-
 Recraft Creative Upscale Recraft $0.357 /imagem
-
 GPT Image 2.5 OpenAI $0.017 /imagem
-
 Grok Imagine Image 2.0 xAI $0.052 /imagem
-
 Seedream 4.5 ByteDance $0.045 /imagem
Mesmo provedor
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /imagem
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /imagem
-
 FLUX 3 Video Black Forest Labs $0.090 /segundo
-
 FLUX 3 Max Black Forest Labs $0.061 /segundo
- FLUX.2 Black Forest Labs $0.035 /imagem
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagem
-
 FLUX.1 Schnell Black Forest Labs $0.005 /imagem
-
 FLUX.1 Fill Pro Black Forest Labs $0.071 /imagem
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /imagem