
xAI
Grok Imagine Image 2.0
grok-imagine-image-2.0/text-to-image
Modelo de geração e edição de imagens da xAI, com forte aderência a instruções e renderização de layouts complexos, suporta iteração de edição de imagens com imagens de referência e pode gerar imagens 1K/2K em várias proporções
Experimentar grok-imagine-image-2.0/text-to-image
Entrada
Criações
Ver todas as criaçõesSaída
image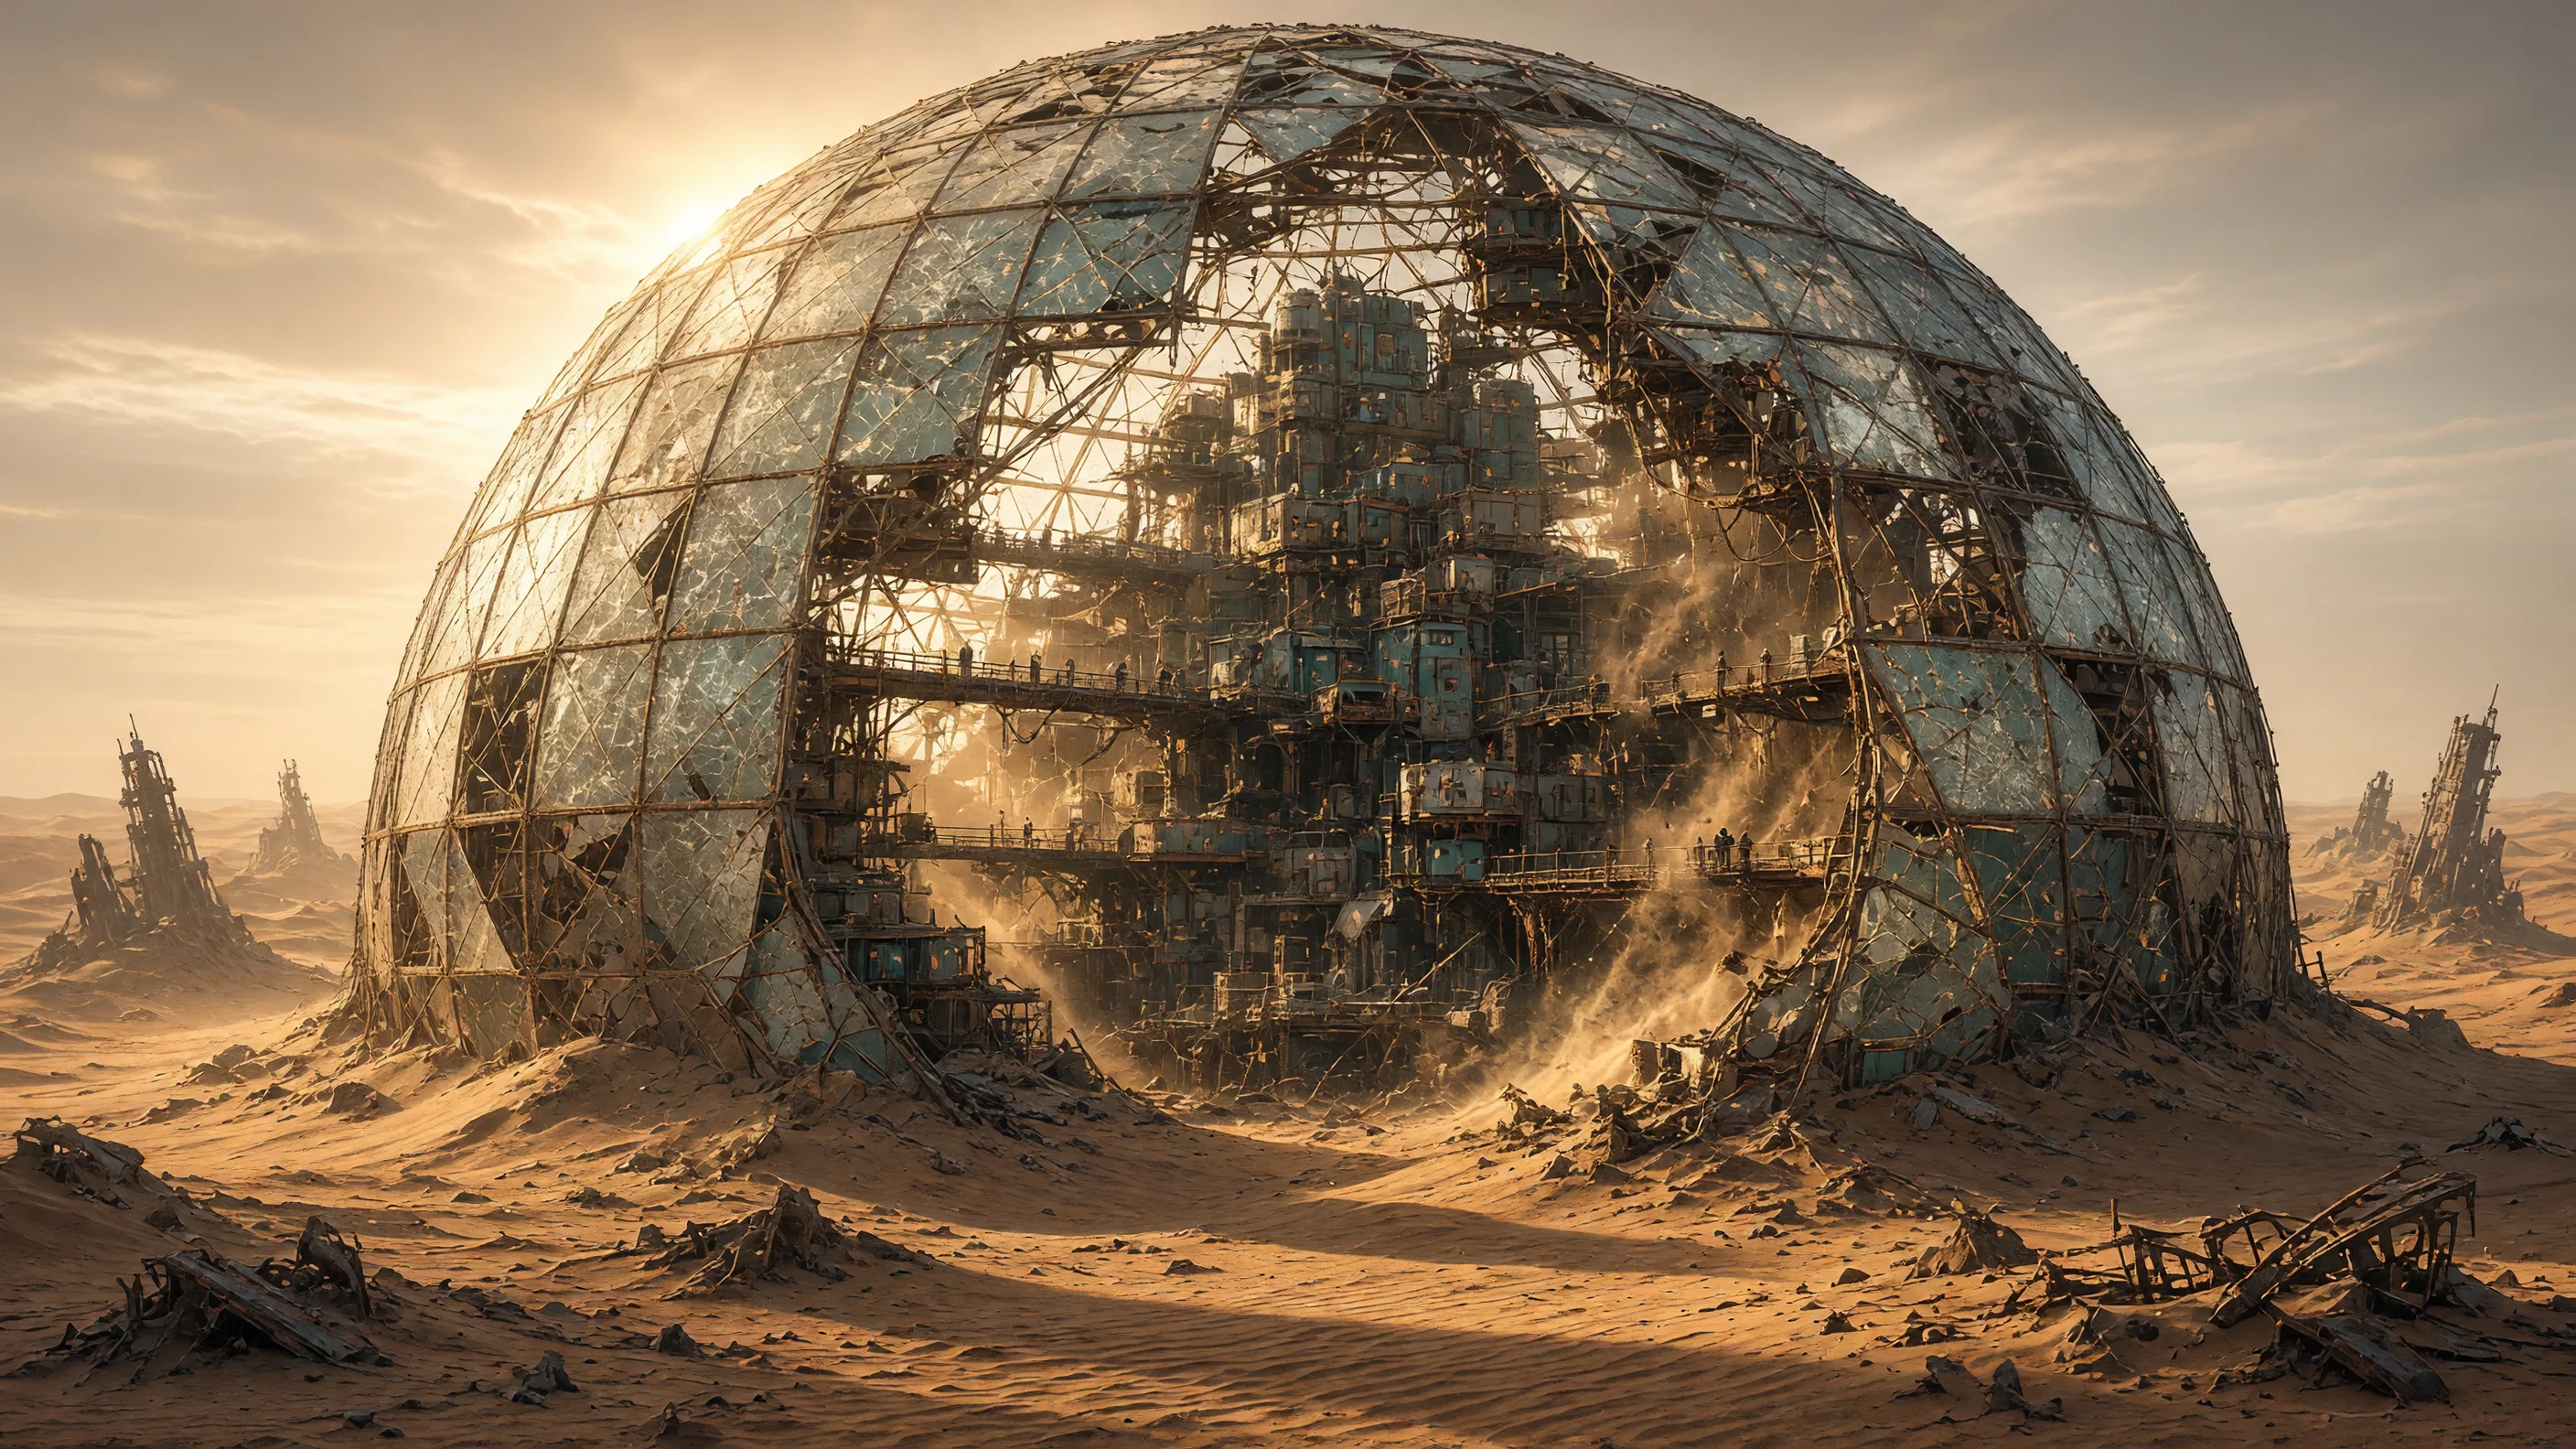
O amanhecer da cidade sob a cúpula do deserto: arte conceitual do universo
Estilo Ficção científica · Construção de mundo · Arte conceitual
Prompt
Uma arte conceitual cinematográfica de ficção científica sobre um universo, em composição panorâmica 16:9. Uma enorme cúpula geodésica de vidro rachado abriga um denso assentamento vertical no centro de um vasto mar de areia ocre; dunas irregulares e torres esqueléticas semienterradas se estendem até o horizonte. No interior da cúpula, módulos habitacionais empilhados, andaimes enferrujados e passarelas improvisadas sobem ao longo das nervuras internas, com pequenas silhuetas atravessando as pontes para transmitir a noção de escala. O vidro da cúpula está coberto de gelo e remendado com chapas soldadas; alguns painéis estão faltando e a areia escorre pelas frestas. A luz baixa do amanhecer atrás da cúpula cria um forte contraluz, com longas sombras varrendo as dunas e uma névoa de poeira volumétrica no ar; realces em âmbar quente contrastam com sombras em ciano-verde frio. A paleta geral é utilitária e dessaturada, com ocre-areia, aço oxidado, verde-azulado desbotado e branco-osso pálido. Textura de arte conceitual digital pintada à mão, estrutura clara e legível, detalhes ricos de desgaste arquitetônico e de materiais, perspectiva atmosférica sutil, sem texto, sem marca d'água, sem logotipo.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
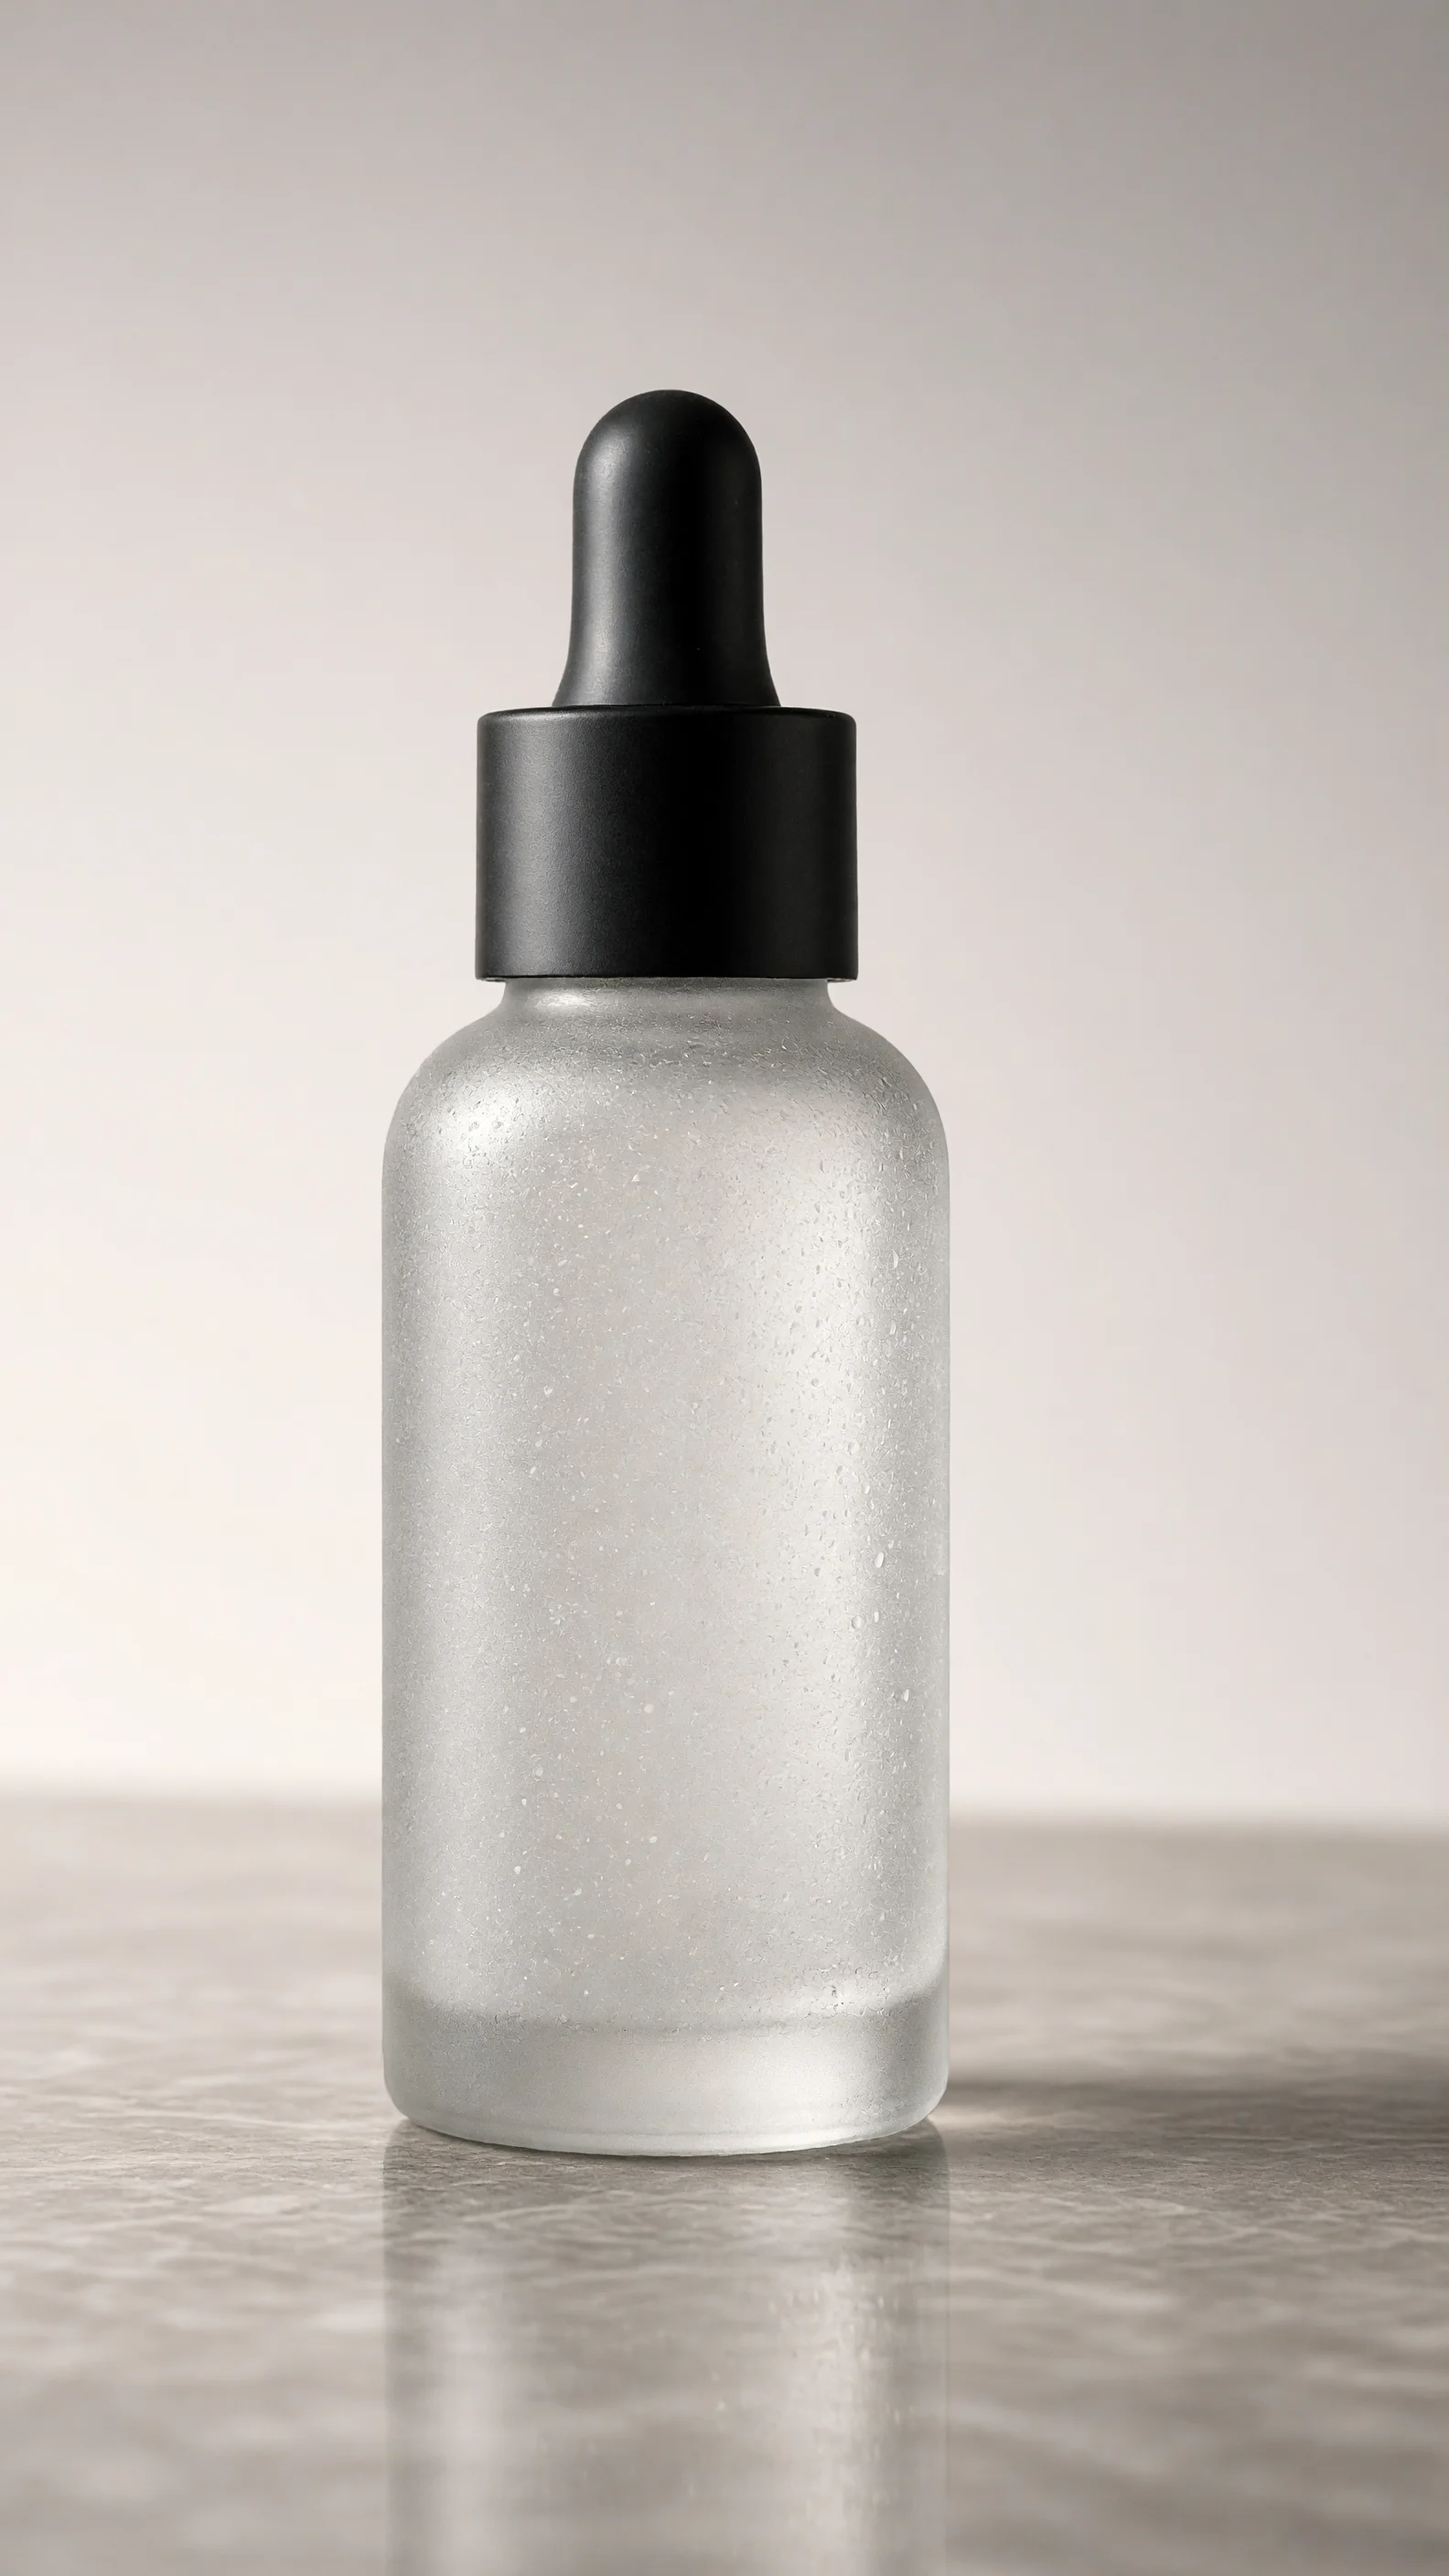
Imagem de produto nível e-commerce: decomposição dos prompts do Grok Imagine 2.0
Estilo Imagem do produto · ecommerce · Iluminação de estúdio
Prompt
Uma fotografia de produto de alto padrão para e-commerce, com um frasco de sérum de vidro fosco sem marca disposto verticalmente no centro da imagem, acompanhado de uma tampa de conta-gotas preta mate. Iluminação de estúdio: na direção superior esquerda a 45 graus, um grande softbox atua como luz principal, criando um reflexo vertical suave na borda esquerda do vidro; no lado direito, uma faixa estreita de luz delineia o contorno para separar a silhueta; em direção ao fundo há uma sutil atenuação gradual. O fundo é um rolo contínuo de tom cinza-claro quente com gradiente vertical suave; o frasco repousa sobre uma superfície de pedra polida, com um reflexo tênue e suave abaixo. Ângulo de câmera ligeiramente baixo, na altura da linha de visão do produto, lente equivalente a 85mm, profundidade de campo rasa, corpo do frasco em foco nítido, fundo completamente limpo. Temperatura de cor neutra puxada para o quente, cerca de 5200K, saturação contida, retoque comercial limpo, microdetalhes nítidos da textura fosca e das gotas de condensação, sem texto, sem rótulos, sem adereços, amplo espaço negativo acima do produto. Realismo fotorrealista, composição 16:9, produto ligeiramente deslocado para a esquerda do centro do quadro, com espaço limpo para texto à direita.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
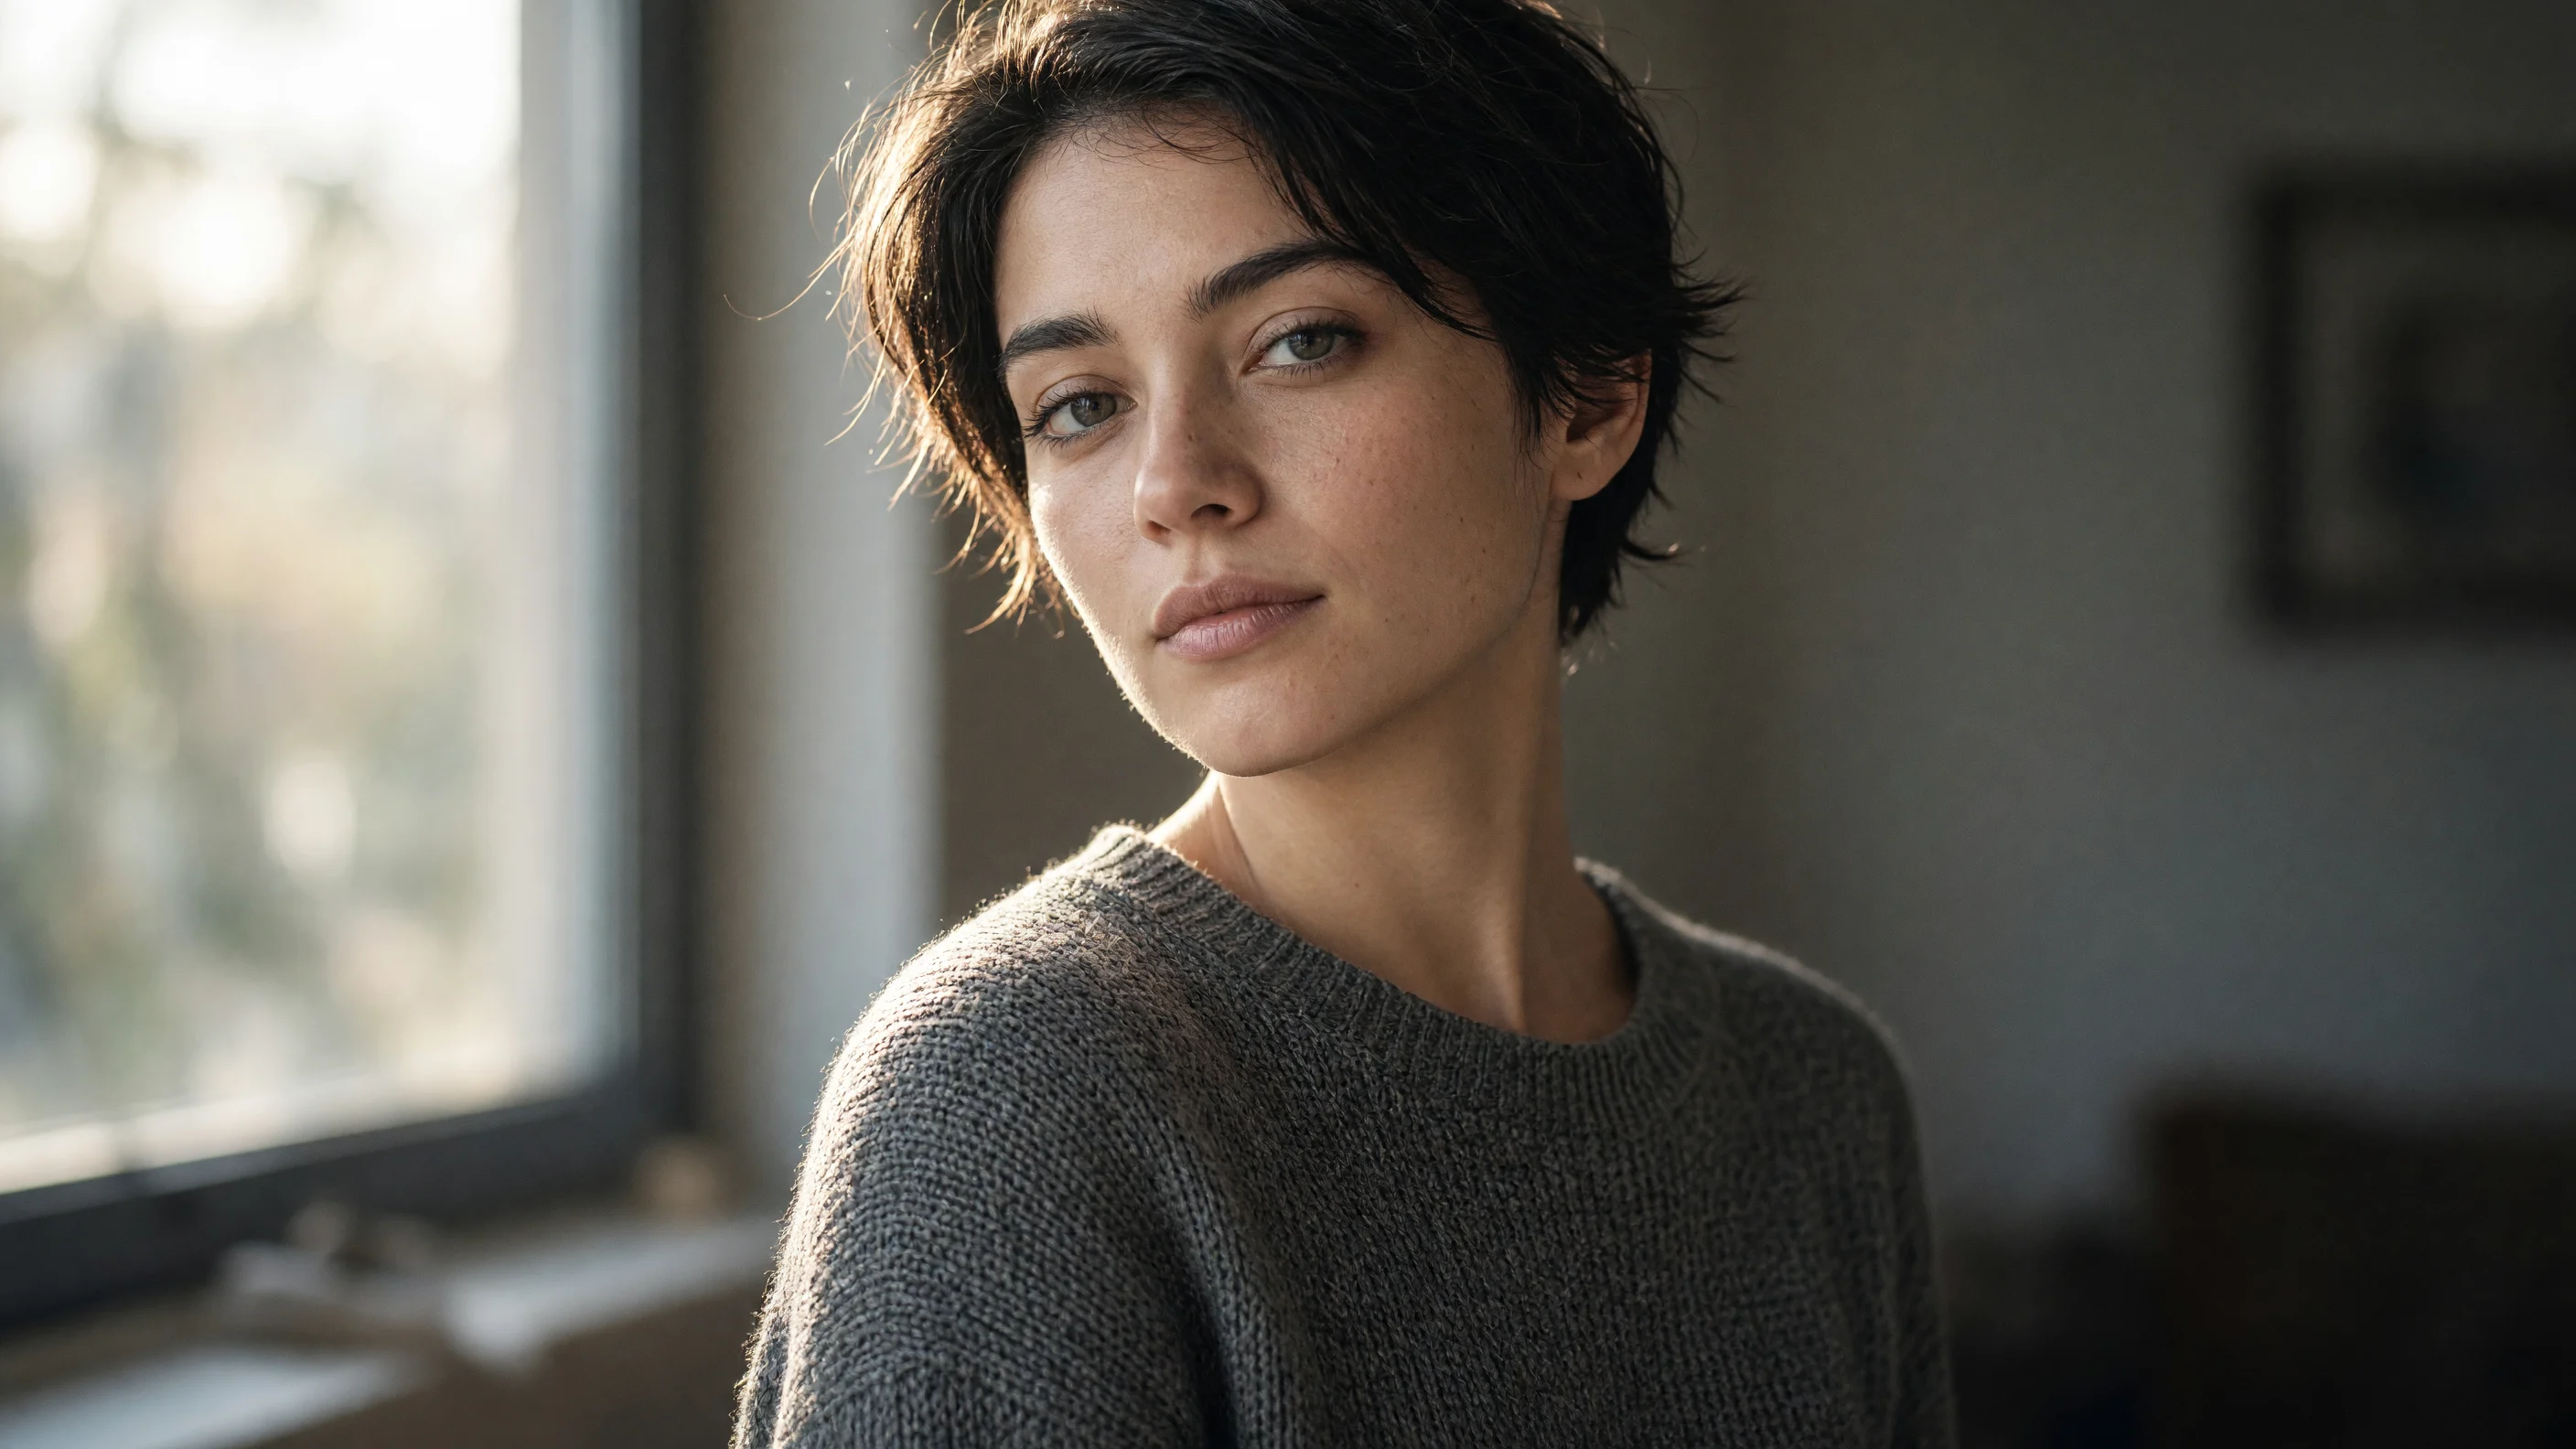
Referência de prompts de retrato do Grok Imagine Image 2.0: estilos realista e artístico
Estilo Retrato e fotografia · Fotorrealismo · Engenharia de Prompt
Prompt
Retrato de meio-corpo de uma jovem de cabelo curto escuro, em pé ao lado de uma janela ampla; uma contraluz natural suave forma uma luz de contorno em seus fios de cabelo e ombros; expressão calma e natural, textura de pele delicada, poros e fios finos claramente visíveis; vestindo um suéter de tricô cinza-carvão de cor sólida, profundidade de campo rasa, fundo interno suavemente desfocado, color grading de filme de baixa saturação, realces quentes e sombras frias, sensação de lente 85mm, ângulo de três quartos, composição vertical 3:4, espaço livre acima da cabeça, fotografia em estilo editorial realista, detalhes ricos nos olhos e na textura do tecido, sem texto, sem marca d'água
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
grok-imagine-image-2.0/text-to-image per image
| Preço unitário | $0.052 |
|---|
Visão geral do posicionamento
grok-imagine-image-2.0/text-to-image é a rota de entrada exclusivamente textual do modelo de geração de imagens da xAI, chamada por meio da interface unificada do HiAPI.ai. Ele se destaca em converter prompts longos e detalhados em uma imagem completa, com alto grau de aderência a instruções em cenários complexos, múltiplos sujeitos, estilos artísticos e demandas de layout que incluem tipografia. Os desenvolvedores podem escolher entre duas faixas de qualidade (baixa e média) e resoluções de 1K/2K, além de selecionar a proporção de saída entre mais de dez opções de 1:1 a 20:9. É adequado para visualização de conceitos, exploração de esboços de design e produção de materiais em múltiplas proporções.
Destaques principais
- Alta aderência a prompts longos e complexos——consegue reproduzir bem restrições criativas detalhadas; múltiplos sujeitos e cenários complexos tendem a não se desviar.
- Tipografia e layouts complexos mais nítidos——materiais com disposição de texto, como pôsteres e capas, apresentam layout superior ao de modelos de imagem comuns.
- Opções de resolução e proporção cobrem usos comuns de veiculação——duas faixas de saída em 1K/2K aliadas a mais de dez proporções, atendendo diretamente a orientações horizontal, vertical e cenas sociais.
- Níveis de qualidade ajustáveis ao custo——oferece as faixas baixa e média; a baixa renderiza mais rápido, ideal para gerar rascunhos em lote e depois refinar os melhores.
Descrição das capacidades
Geração de imagem a partir de texto: gera a imagem completa a partir de um prompt em texto longo, ideal para transformar descrições criativas diretamente em peças visuais avaliáveis.
Escolha de resolução e qualidade: permite especificar saída em 1k ou 2k e escolher entre as qualidades baixa e média, alternando entre exploração de rascunhos e saída final.
Saída em múltiplas proporções: suporta mais de dez opções, como quadrado, paisagem, retrato, ultrawide e proporção automática; uma única configuração gera a imagem conforme o layout exigido.
Alta fidelidade a restrições fortes no prompt: mantém elevado grau de reprodução para descrições densas em detalhes e que incluem tipografia, reduzindo o número de iterações de reescrita do prompt.
Cenários de aplicação
- Equipes de arte e design: descrição textual de conceitos de cena——gera imagens conceituais diretamente a partir de descrições de cena, iluminação e estilo, para propostas iniciais e alinhamento de direção visual.
- Design de marketing: materiais de layout como pôsteres e capas——insira descrições com títulos e layout para produzir peças de layout claramente legíveis, usadas em publicações sociais e rascunhos de materiais de veiculação.
- Operações e publicidade: materiais em múltiplas proporções——configure diferentes proporções de uma vez e produza materiais horizontais e verticais em lote, diretamente para espaços publicitários de diversos canais.
- Ilustração e exploração de estilos——use prompts estilizados para gerar rapidamente várias direções de ilustração, para que clientes ou diretores de arte escolham entre elas.
Limitações e recomendações de escolha
A resolução máxima de saída é 2K e há apenas duas faixas de qualidade (baixa e média), não sendo possível produzir peças maiores com qualidade superior ou mais refinadas; cenários que exigem imagem de referência, repintura local ou múltiplas edições de várias imagens devem usar a rota image-to-image da mesma família. Esta rota aceita apenas prompts de texto e não suporta entrada de imagem. Se a necessidade for imagem em ultra-alta definição ou alterações complexas com múltiplas referências, é preciso avaliar outros modelos ou fluxos de pós-processamento. O modelo é recente e há dados limitados de estabilidade de longo prazo e de avaliações independentes; recomenda-se validar o efeito em pequenos lotes fora do fluxo oficial antes do uso.
Perguntas frequentes
Ver todas as perguntas →-
Para que tarefas o Grok Image 2.0 Text to Image é principalmente adequado?
Suporta níveis de qualidade low/medium, saída em 1K/2K e formatos de quadrado a ultra-wide, sendo adequado para visuais de produtos, editoriais, paisagens e personagens.
-
O Grok Image 2.0 Text to Image suporta imagem de referência?
A rota atual é de geração puramente a partir de texto, não aceita imagem de referência.
-
Quais especificações de saída são suportadas?
A página atual exibe 1K, 2K e auto, 1:1, 16:9, 9:16, 4:3, 3:4, 2:1, 1:2; as opções finais estão sujeitas aos parâmetros do Playground.
-
Como é cobrado o Grok Image 2.0 Text to Image?
A cobrança é feita com base na quantidade de imagens geradas com sucesso; eventuais diferenças entre resoluções ou níveis de qualidade são exibidas no preço em tempo real na página.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: grok-imagine-image-2.0/text-to-image
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para grok-imagine-image-2.0/text-to-image e a rota default — veja a tabela de parâmetros abaixo.
promptstringObrigatóriominLength 1Texto de prompt para geração de imagem, que determina o conteúdo e o estilo da imagem.
qualitystringOpcionalPadrão: "medium"Nível de qualidade da geração; o padrão é medium (nível recomendado); selecionar low torna a geração mais rápida.
lowmediumresolutionstringOpcionalPadrão: "1k"Resolução da imagem de saída, padrão 1k.
1k2kaspect_ratiostringOpcionalPadrão: "1:1"Proporção largura-altura da imagem de saída, padrão 1:1.
1:116:99:164:33:43:22:32:1Mostrar tudo (6)
1:219.5:99:19.520:99:20autocallbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "grok-imagine-image-2.0/text-to-image",
  "input": {
    "prompt": "…",
    "quality": "medium",
    "resolution": "1k",
    "aspect_ratio": "1:1"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "grok-imagine-image-2.0/text-to-image",
input: {
"prompt": "…",
"quality": "medium",
"resolution": "1k",
"aspect_ratio": "1:1"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "grok-imagine-image-2.0/text-to-image",
"input": {
"prompt": "…",
"quality": "medium",
"resolution": "1k",
"aspect_ratio": "1:1"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video na HiAPI: curl + Python
Faça uma requisição de imagem para vídeo funcional na HiAPI: do upload do primeiro quadro ao polling assíncrono e ao download final
-

Avaliação comparativa
Comparação lado a lado do Recraft v4.1 Flash em text-to-image: guia de seleção e migração para desenvolvedores
Com um custo de $0.01 por imagem e capacidade de text-to-image pura, avalie se ele é adequado para seu pipeline de geração de imagens
-

Tutorial
Como chamar kling-4.0/image-to-video na HiAPI: curl, Python e polling
-

Tutorial
Como usar kling-4.0/text-to-video através da API HiAPI: curl, Python e um exemplo de requisição executável
Guia prático para desenvolvedores: prompts cinematográficos, áudio sincronizado, polling assíncrono e download da saída
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
recraft-v4.1-flash geração de imagens por texto na prática: 5 cenários de negócio de alto valor e pontos de integração
Partindo de um custo de US$ 0,01 por imagem, planeje como aplicar a geração de imagens em negócios reais
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado
-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Avaliação comparativa
hailuo-2.3-fast/image-to-video comparação lado a lado: como escolher modelos de imagem para vídeo e pontos de migração
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagem
-
 FLUX.1 Schnell Black Forest Labs $0.005 /imagem
-
 GPT Image 2.5 OpenAI $0.017 /imagem
-
 FIBO 1.5 Bria $0.058 /imagem
-
 Grok Imagine Image 2.0 xAI $0.052 /imagem
-
 Qwen Image 2.0 Alibaba $0.042 /imagem
-
 Ideogram V3 Character Ideogram $0.090 /imagem
-
 Grok Imagine Quality xAI $0.070 /imagem
-
 Grok Imagine xAI $0.011 /segundo
-
 851 Labs Background Remover 851 Labs $0.002 /imagem
-
 Nano Banana 2 Google $0.036 /imagem
-
 BRIA Eraser Bria $0.058 /imagem


