MiniMax
MiniMax H3 Image
minimax-h3-image/text-to-image
Модель изображений MiniMax: генерация по тексту и редактирование с 1–16 референсными изображениями работают на едином наборе возможностей, вывод до 4K, поддержка десяти форматов кадра и автоматического соотношения сторон — подходит для концепт-дизайна, коммерческой визуализации и создания работ в разных стилях
Попробовать minimax-h3-image/text-to-image
Ввод
Работы
Все работыВывод
image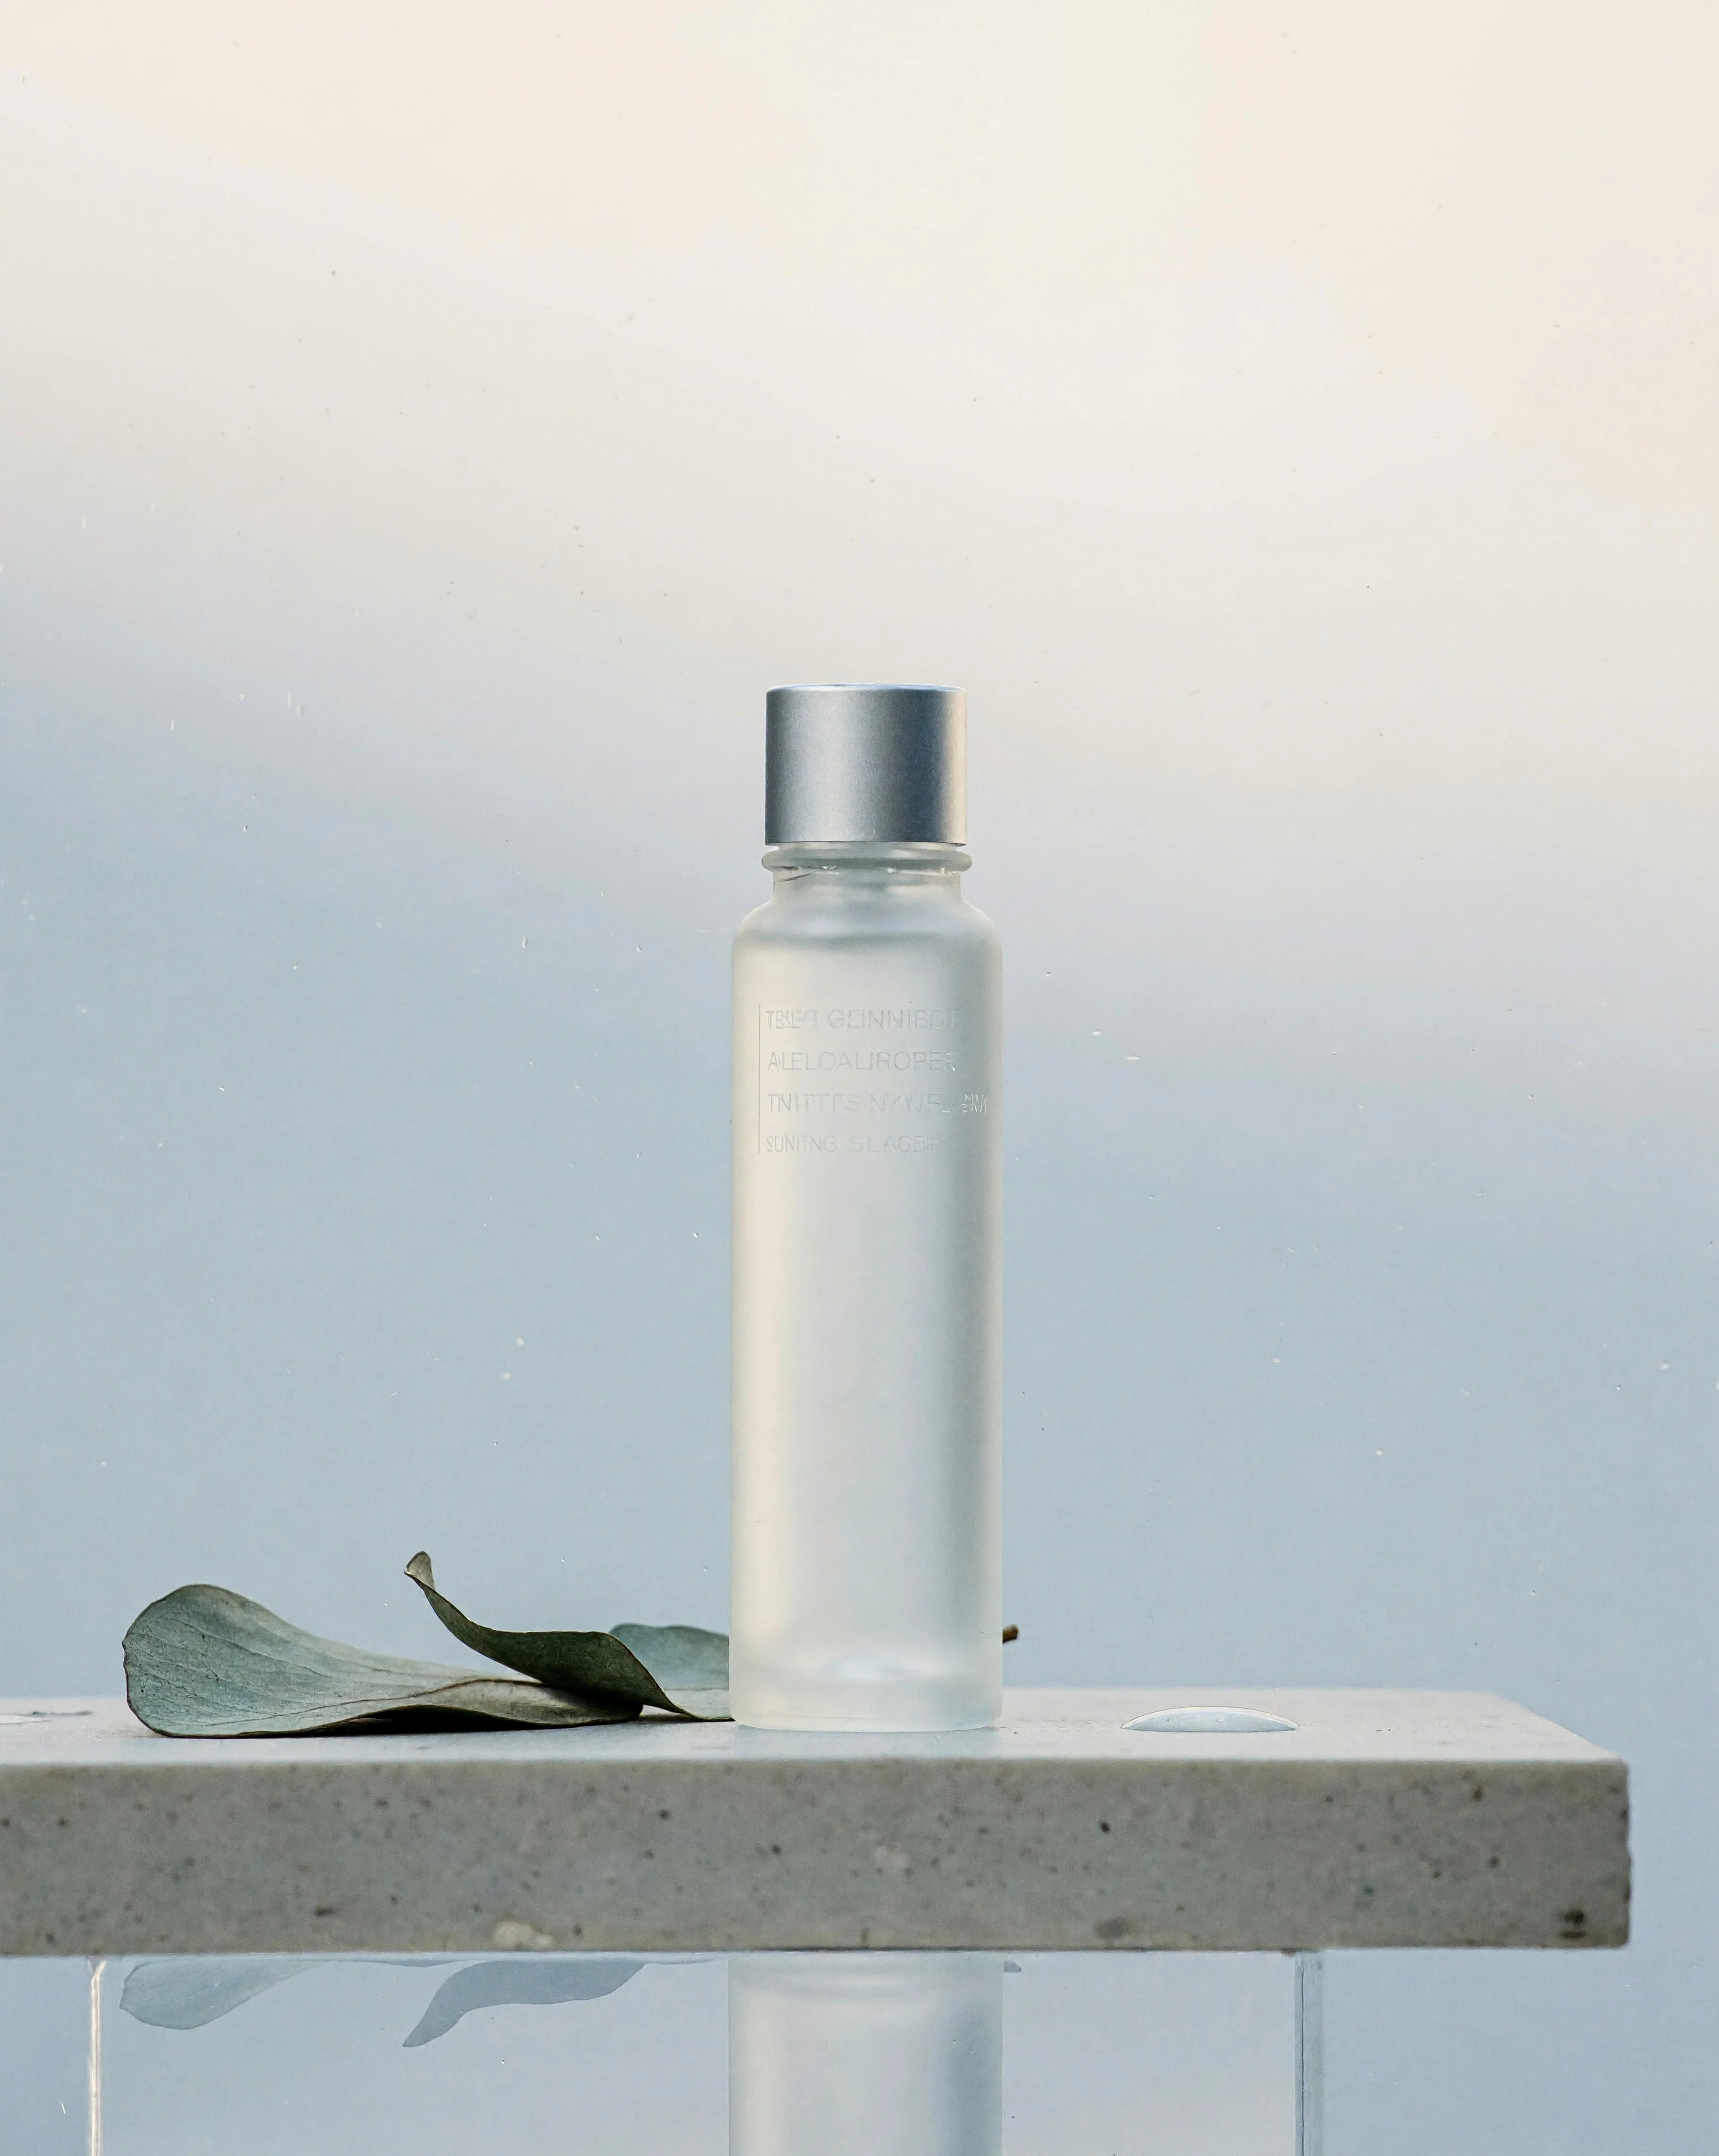
Матовый флакон сыворотки · натюрморт на каменной поверхности для коммерческой съёмки
Стиль Изображение продукта · Натюрморт · Студийный свет
Промпт
Флакон сыворотки для ухода за кожей из матового стекла вертикально стоит на постаменте из светло-серого микроцемента; матовая поверхность благодаря стеклянной фактуре выглядит мягкой, на лицевой стороне — небольшая тиснёная этикетка с мелкими неразборчивыми буквами. Рядом с флаконом лежат два сухих листа эвкалипта и одна прозрачная капля воды. Большой софтбокс расположен сзади сбоку и очерчивает тонкий вытянутый блик по краю флакона, а мягкий заполняющий свет подсвечивает теневую сторону. Низкая акриловая подставка отражает слабое размытое отражение флакона. Фон переходит от холодного светло-серого внизу к тёплому кремово-белому ближе к верху, в воздухе парят мельчайшие пылинки. Малая глубина резкости, фокус чётко на плечиках и крышке флакона, над объектом и вокруг него оставлено спокойное негативное пространство, изысканная коммерческая постановка натюрморта, реалистичная фактура стекла и камня, естественная цветокоррекция.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
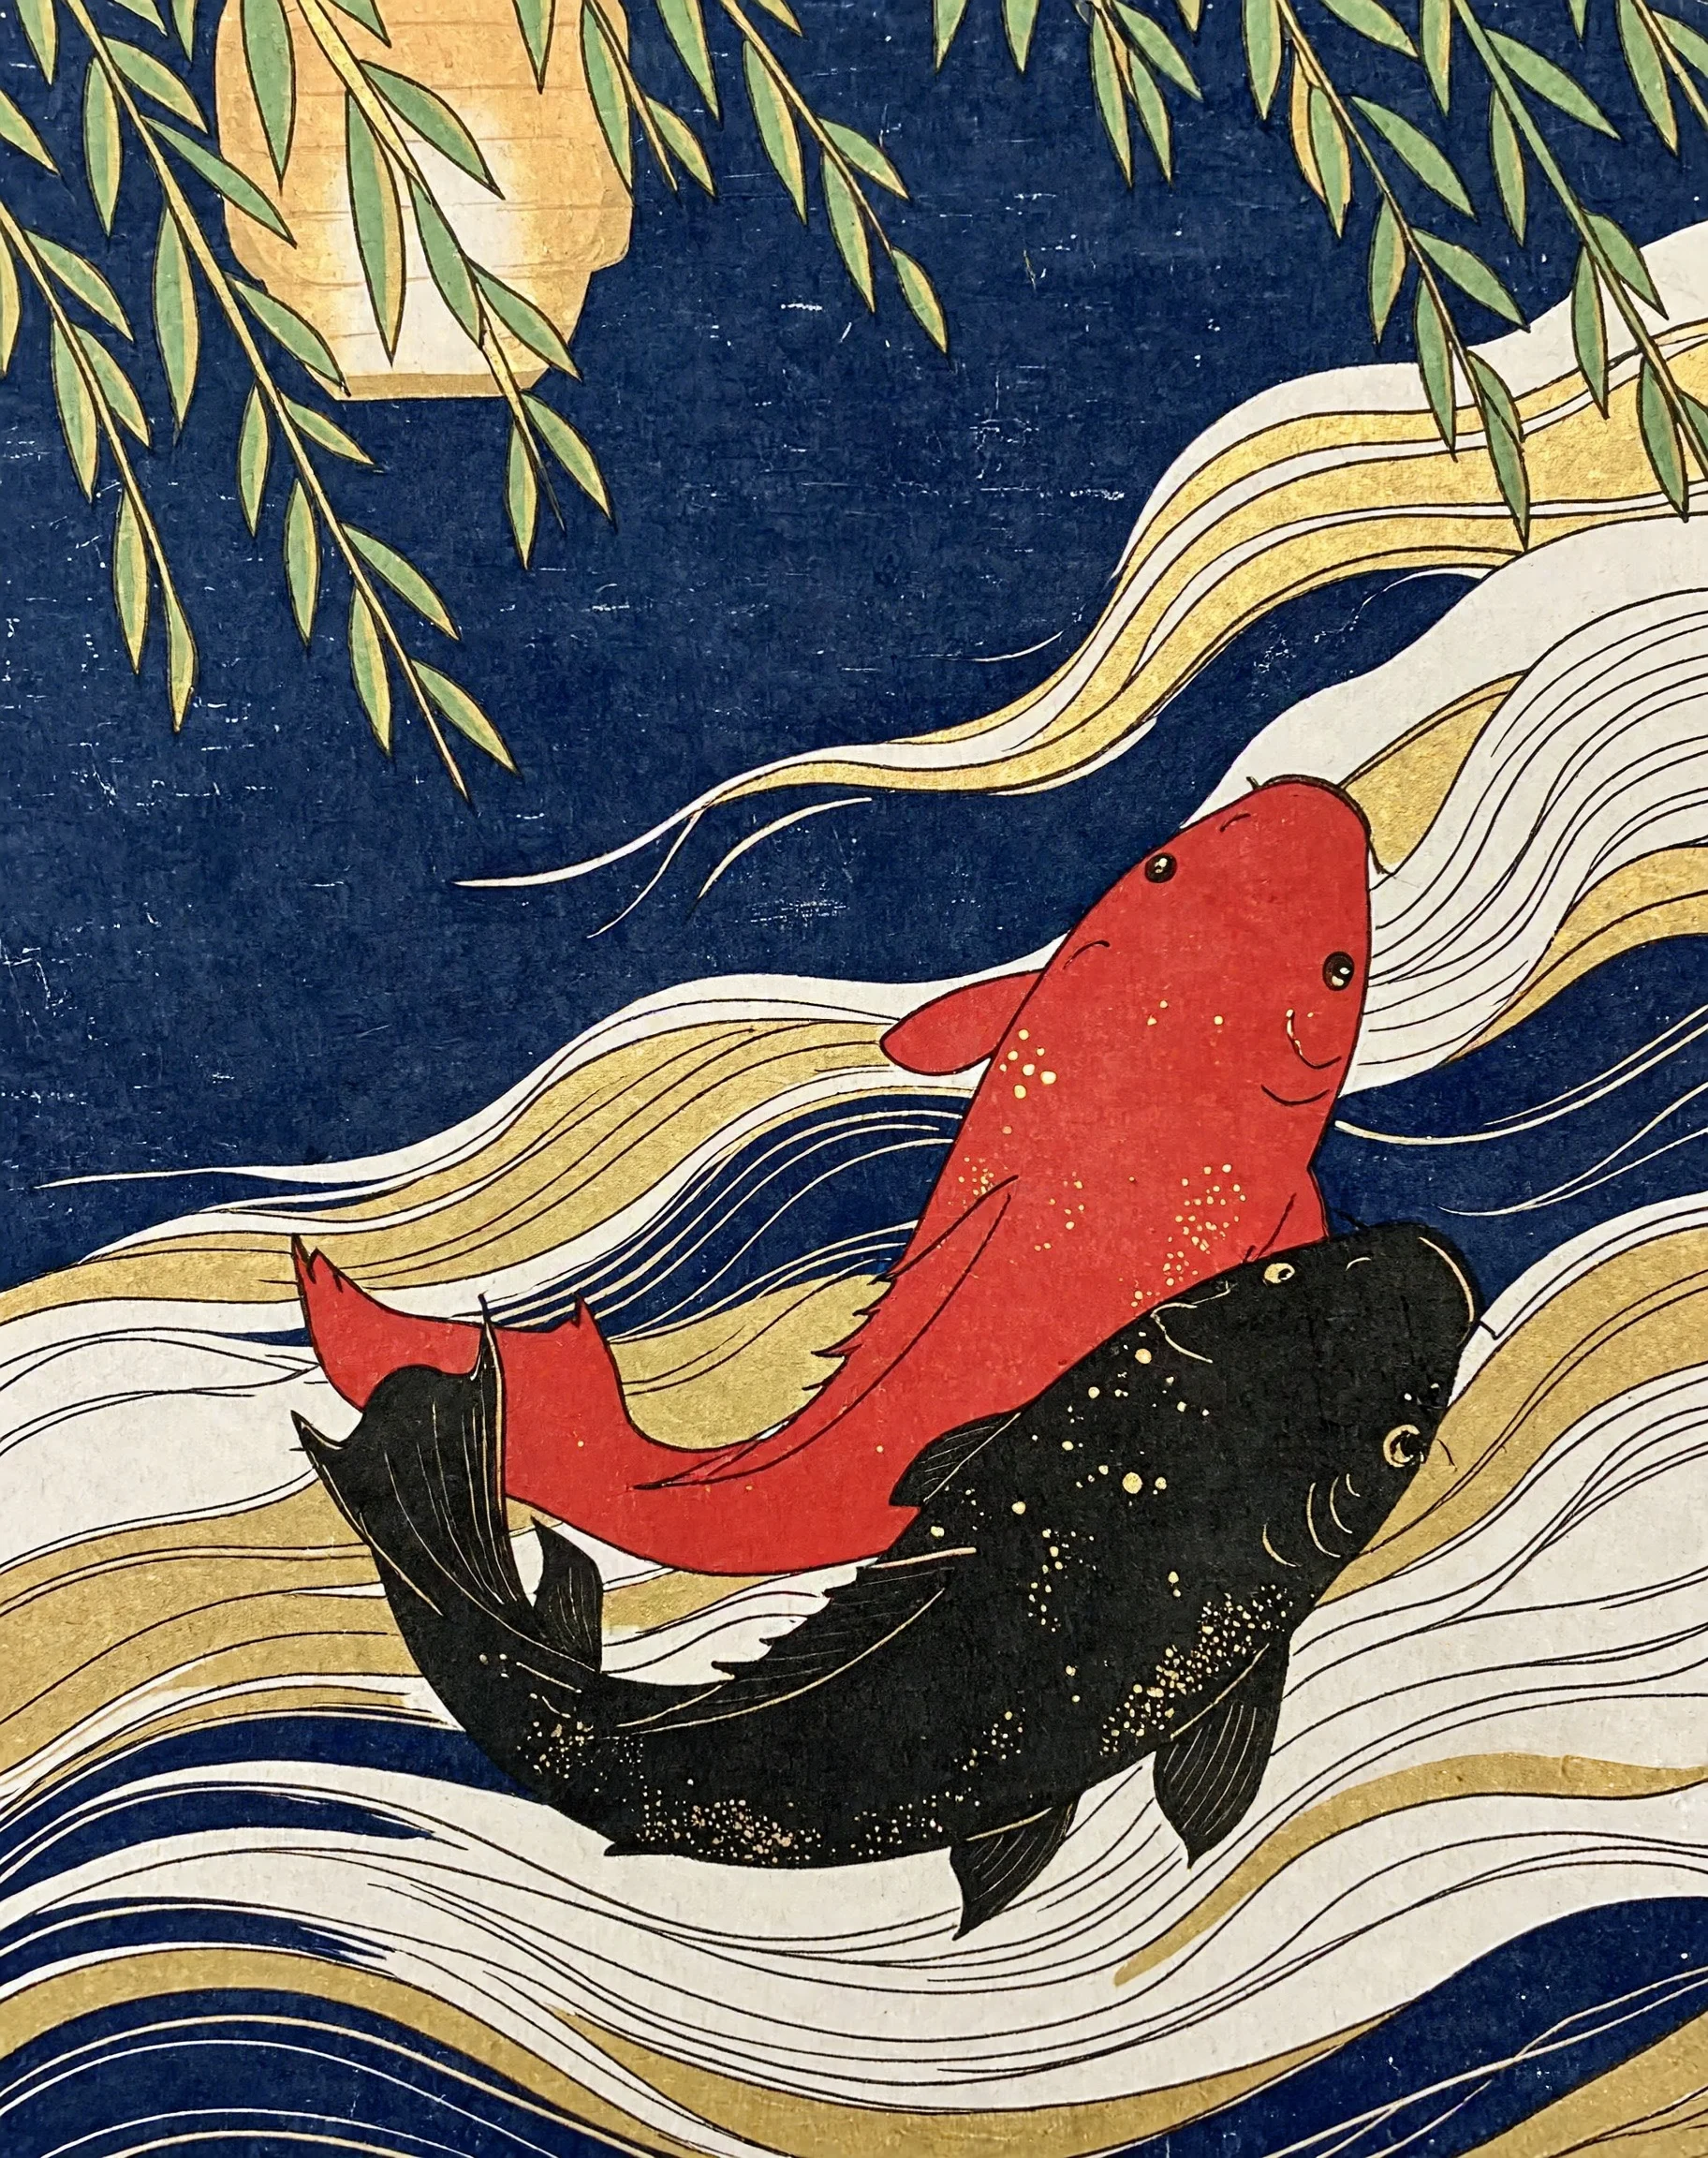
Карпы в стиле укиё-э · Золотая чешуя в ночном переходе
Стиль Укиё-э · japanese-print · Художественная иллюстрация
Промпт
Иллюстрация в стиле укиё-э: два карпа плывут в воде глубокого индигово-синего цвета, один ярко-алый, другой чёрный как тушь, чешуя усыпана золотыми хлопьями; слоистые волновые узоры врезаны в гладкие цветовые полосы, контуры чёткие и резкие, а тела рыб сохраняют мягкую влажную объёмность и тонкие блики отражённого света. Ветви плакучей ивы и тёплые ореолы бумажных фонариков вдали формируют композицию в верхней части, оставляя большое открытое водное пространство; зернистость гравюры на дереве и заметная текстура бумаги, сдержанная цветовая гамма с преобладанием индиго, алого, золотого и кремово-белого, вода мягко течёт по диагонали.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
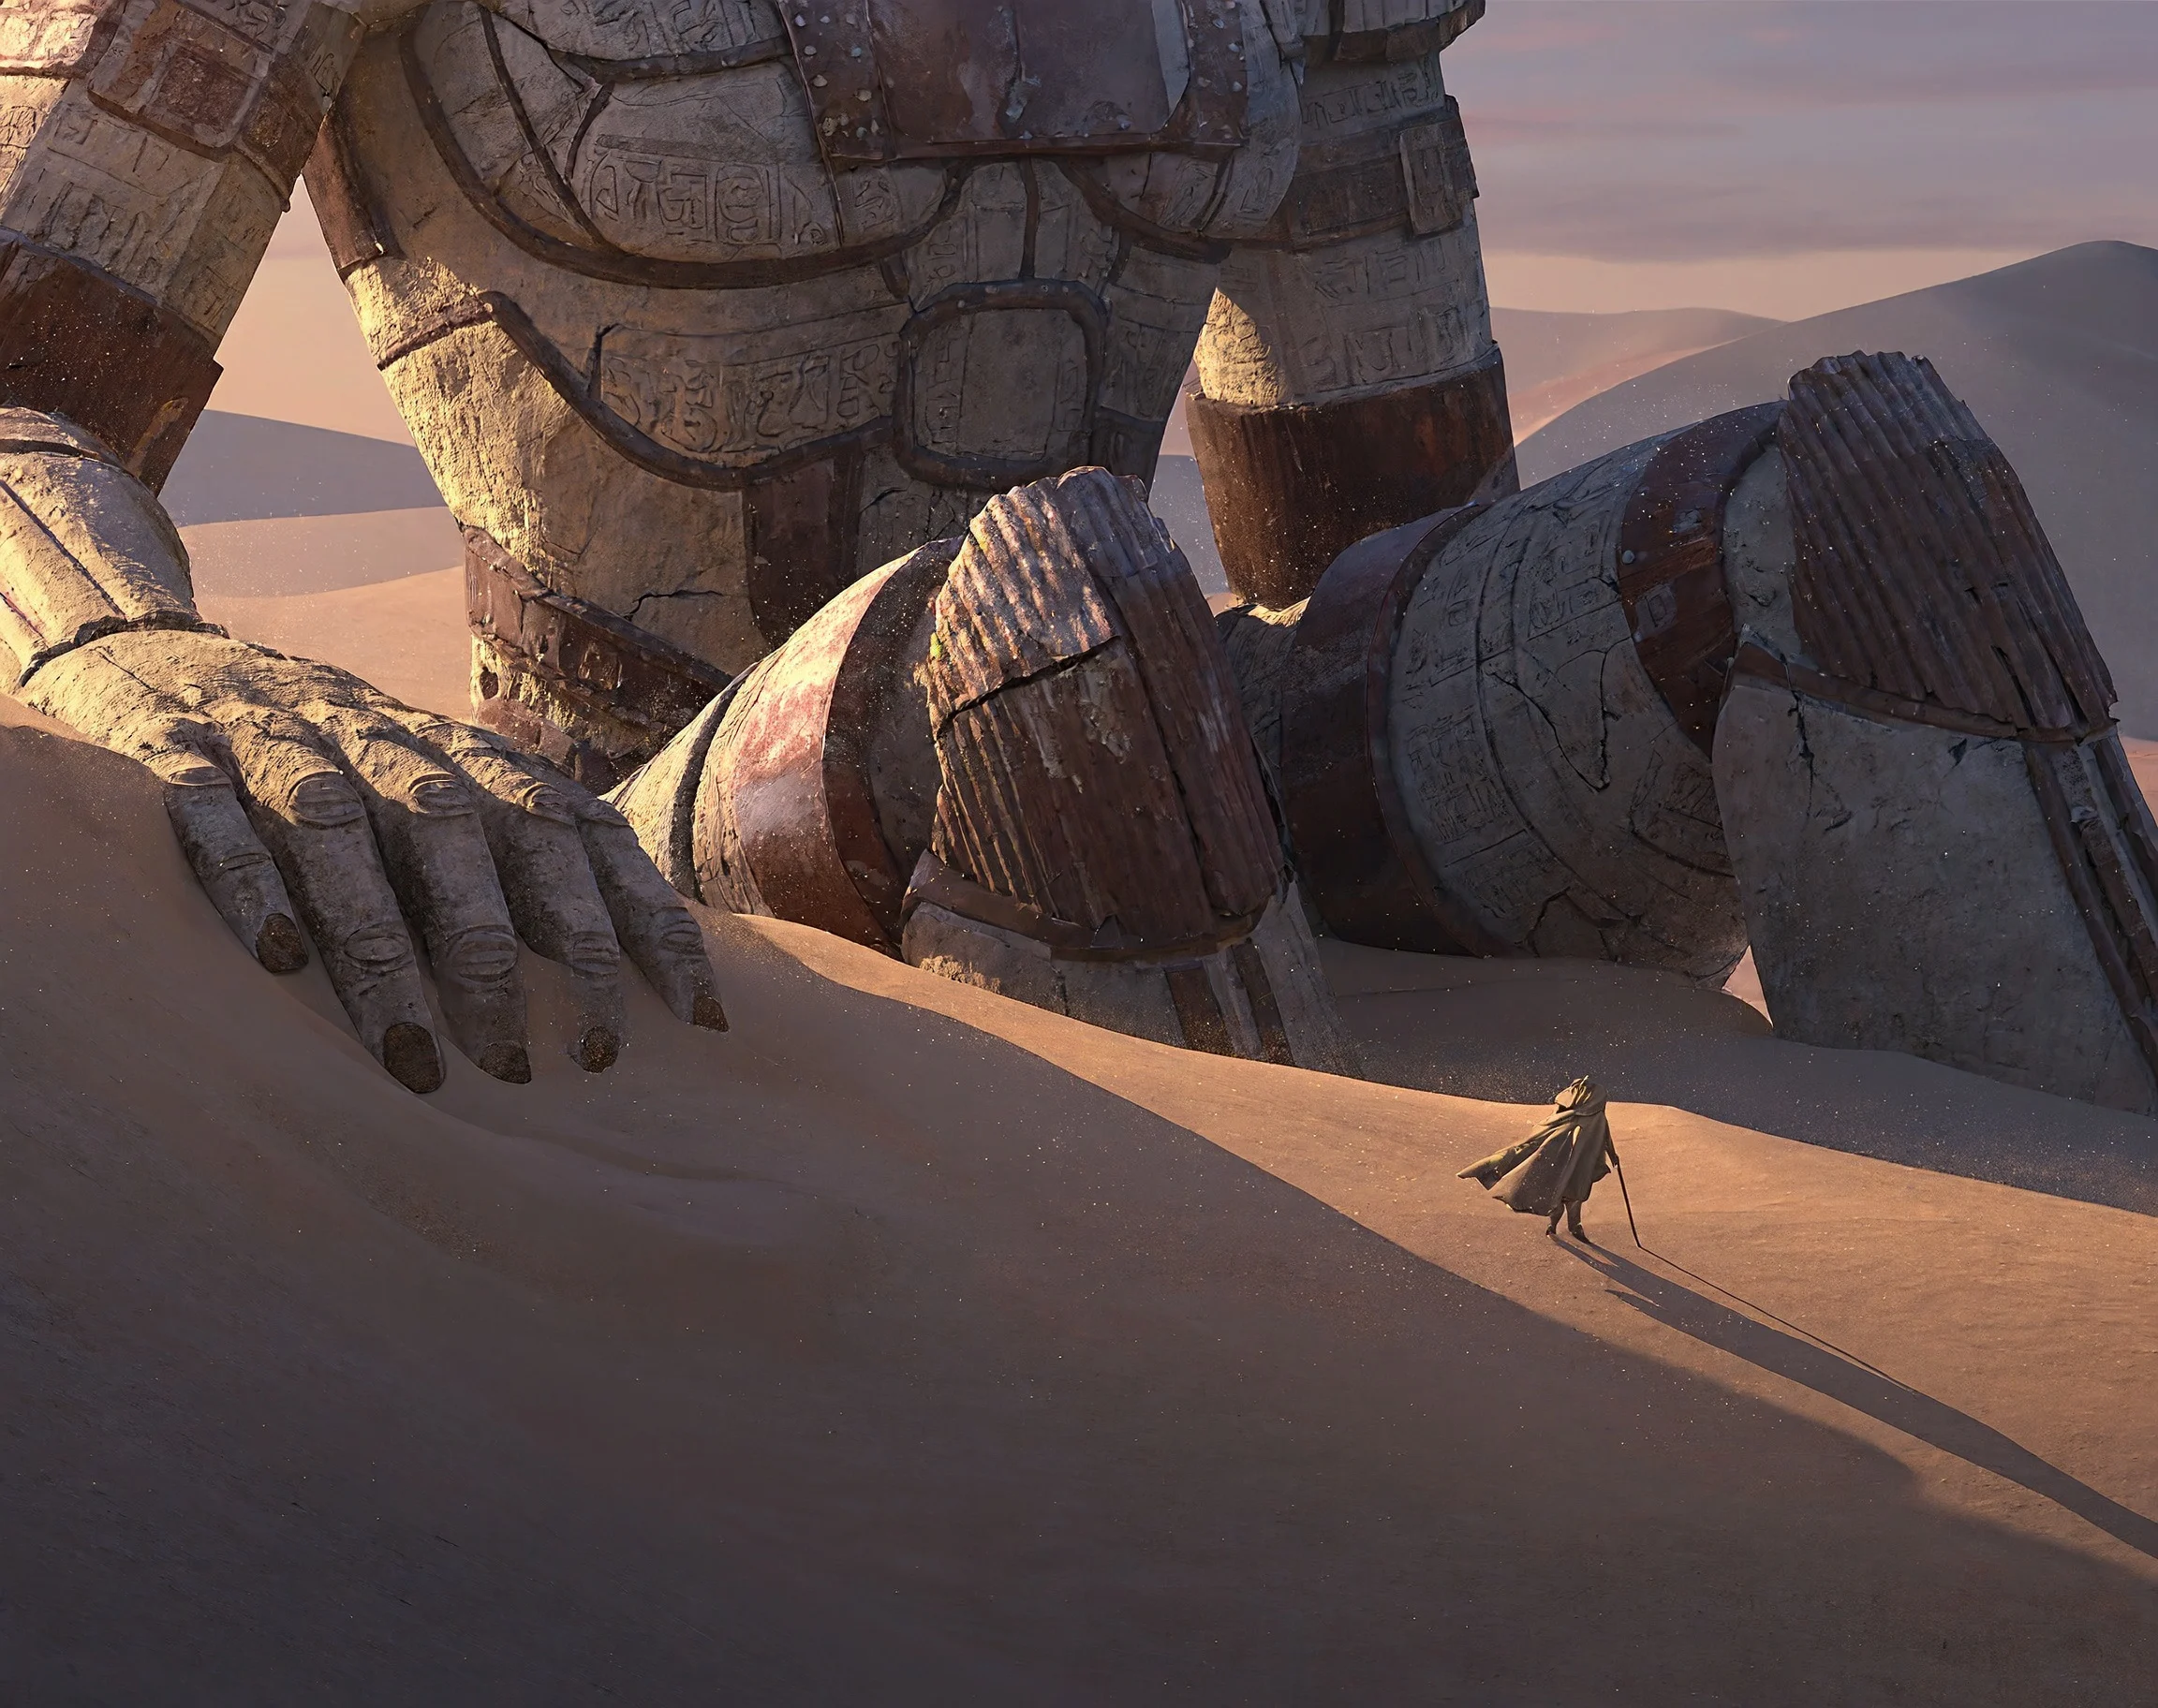
Колосс в песчаном море · Концептуальная сцена руин на закате
Стиль Построение мира · Научная фантастика · Атмосферность
Промпт
Огромный древний колосс, наполовину погребённый в зыбучих песках бескрайней пустыни; выветренный камень и проржавевшая металлическая оболочка густо покрыты слоями эрозионной резьбы, а из песка простирается гигантская рука. Крошечный одинокий путник в длинном плаще идёт по гребню соседней дюны, отбрасывая длинную тень и выглядя ничтожным перед колоссом. Косые лучи закатного солнца в золотой час падают сбоку, окаймляя края статуи тёплым янтарным контурным светом, а дальние дюны постепенно растворяются в мягкой пыльной дымке; в воздухе мелкие песчинки мерцают в свете. Живописный концепт-арт-рендер с реалистичной детализацией материалов, мягкая охра и серо-фиолетовая палитра, глубокая атмосферная перспектива, эпический масштаб, тихое и загадочное настроение.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
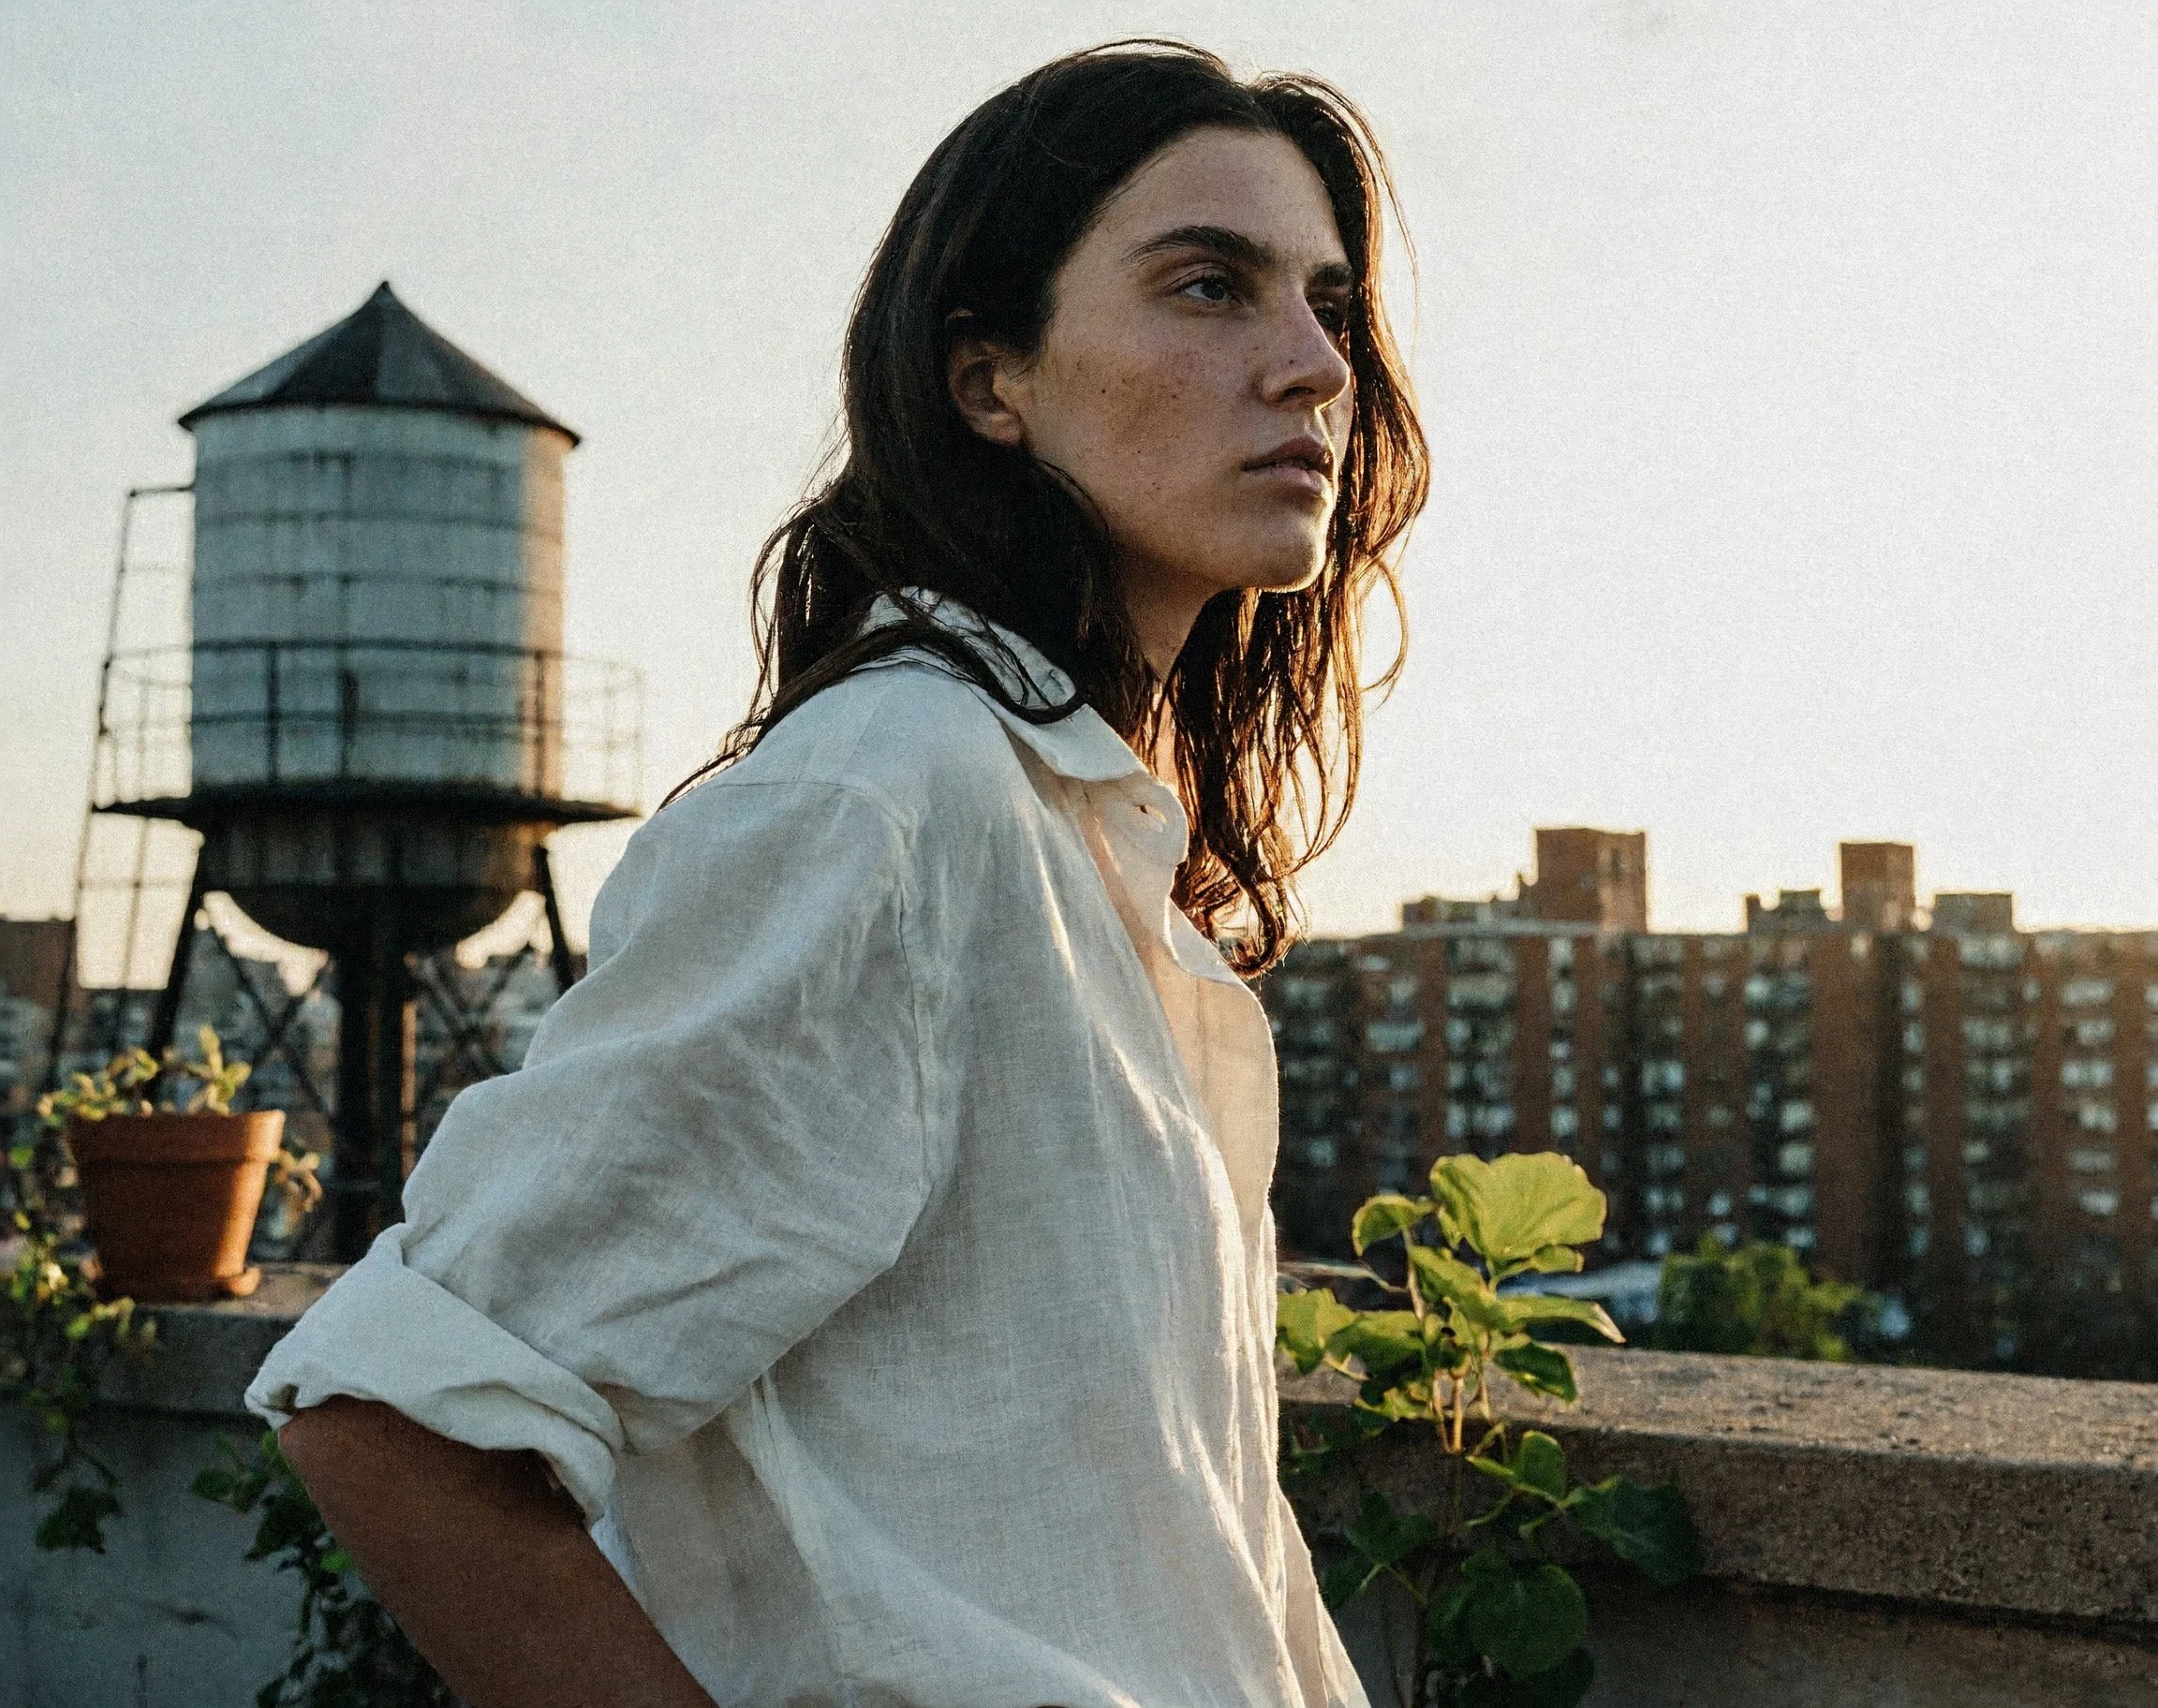
Послеполуденная терраса · Портрет с боковым светом в плёночной эстетике
Стиль Портреты и фотография · Кинематографическое качество · Золотой час
Промпт
Портрет молодой женщины в свободной льняной рубашке цвета топлёного молока, стоящей на краю городской крыши в вечерний час. Она слегка повернула лицо к низкому солнцу; закат окаймляет её рассыпанные тёмные волосы тёплым золотым контуром и погружает теневую сторону её щёк в мягкий, деликатный полумрак. Позади неё водонапорная башня и далёкие жилые высотки растворяются в лёгком размытии; невысокий бетонный парапет и несколько горшков с зеленью образуют передний план. Естественная текстура кожи, различимые мелкие поры и лёгкие веснушки, плёночное зерно, приглушённая тёплая палитра в сочетании с холодными тенями, малая глубина резкости, фактура кадра из глянцевого журнала о моде.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
minimax-h3-image/text-to-image per image
| Характеристики | Цена за единицу |
|---|---|
| 1K | $0.0129 |
| 2K | $0.0129 |
| 4K | $0.0393 |
Общее описание
Это модель, которая создаёт статичные изображения по текстовому описанию. Достаточно ввести подсказку, чтобы получить картинку, соответствующую описанию, а также можно управлять уровнем разрешения, соотношением сторон и форматом вывода. При необходимости можно зафиксировать случайное зерно, чтобы сделать результат воспроизводимым при одной и той же подсказке и настройках. Модель ориентирована на дизайнеров, авторов контента и разработчиков, которым нужно быстро воплощать идеи; она подходит для создания концепт-артов, атмосферных сцен и различных визуальных материалов.
Ключевые особенности
- Автоматическое расширение подсказки — отправленная подсказка автоматически дополняется деталями, что помогает получить более насыщенное изображение.
- Несколько уровней разрешения — разрешение вывода можно выбрать из трёх уровней: 1K, 2K и 4K, что соответствует примерно 1, 4 и 16 мегапикселям.
- Поддержка различных соотношений сторон — встроены соотношения от 1:1 до 21:9, а также автоматический выбор, что подходит для разных вариантов вёрстки.
- Воспроизводимость при фиксированном зерне — целочисленное зерно от 0 до 2147483647 позволяет воспроизвести результат при той же подсказке и параметрах.
Описание возможностей
Генерация изображения по тексту: введите подсказку с описанием изображения, и модель создаст по ней статичную картинку. Длина подсказки — от 1 до 5000 символов.
Управление уровнем разрешения: можно выбрать разрешение вывода из трёх уровней — 1K, 2K или 4K, что соответствует примерно 1, 4 и 16 мегапикселям; по умолчанию используется 2K.
Управление соотношением сторон: поддерживаются 1:1, 5:4, 4:5, 4:3, 3:4, 3:2, 2:3, 16:9, 9:16, 21:9 и автоматическое соотношение; по умолчанию — 1:1.
Выбор формата вывода: можно выводить в формате JPEG или PNG; файлы PNG больше по размеру — около 12 МБ при 2K и около 30 МБ при 4K.
Фиксированное случайное зерно: целочисленное зерно от 0 до 2147483647 позволяет воспроизводить результат при одинаковой подсказке и параметрах; если не задано, генерируется случайно.
Сценарии применения
- Концепт-дизайнеры рисуют персонажей и сцены — введите текстовое описание персонажа или сцены и получите стилизованный концепт-арт для предварительных предложений и визуальной разработки.
- Авторы контента создают иллюстрации — составьте подсказку по теме статьи или видео и получите изображение, подходящее к вёрстке, для прямой публикации.
- Создание коммерческих визуальных материалов — выберите уровень 4K и широкое соотношение сторон, чтобы получить материал высокого разрешения для рекламы или презентационных материалов.
- Разработчики генерируют изображения пакетно — с помощью комбинаций фиксированного зерна и параметров пакетно создавайте воспроизводимые графические ресурсы и подключайте их к дизайн- или контент-процессам.
Ограничения и рекомендации по выбору
Подсказка обязательна, её длина — не более 5000 символов, и она не может состоять только из пробельных символов. Уровень разрешения, соотношение сторон и формат вывода выбираются по одному значению из перечисления; произвольные числовые значения не поддерживаются. Значение зерна ограничено целыми числами от 0 до 2147483647. Результат генерации — статичное изображение, по одному на каждый запрос.
Новости
Смотреть changelog →- Новая модель MiniMax H3 Image запущен: генерация изображений по тексту и редактирование по нескольким референсам
Частые вопросы
Все частые вопросы →-
Сколько референсных изображений можно передать максимум?
При генерации изображения по изображению можно передать максимум 16 референсных изображений, минимум 1, в формате JPG, PNG или WEBP, со стороной 128–8192 px, каждое не более 20 MB. За каждое референсное изображение дополнительно взимается $0.0036; например, для 2K с 3 референсными изображениями итого $0.0129 + 3 × $0.0036 = $0.0237. При написании промпта ссылайтесь на изображения по порядку передачи номерами вида Picture 1, Picture 2, чтобы модель правильно сопоставила их с объектами, которые вы хотите отредактировать или объединить.
-
Как задаются выходные размеры и насколько большими они могут быть?
Доступны три уровня разрешения: 1K, 2K и 4K, что соответствует примерно 1 MP, 4 MP и 16 MP; по умолчанию — 2K. Соотношение сторон можно выбрать: auto или 1:1, 5:4, 4:5, 4:3, 3:4, 3:2, 2:3, 16:9, 9:16, 21:9; при выборе auto модель сама определит его на основе промпта и референсных изображений, а если нужна фиксированная композиция, укажите его явно.
-
Как писать запрос, чтобы сохранить внешность персонажа?
Стройте запрос в таком порядке: сначала опишите объект, который нужно сохранить, затем — часть, которую нужно изменить, и в конце укажите изображения по номерам: ① сначала одной-двумя фразами зафиксируйте внешние признаки объекта, такие как причёска, одежда, цветовая гамма, характерные детали; ② затем опишите целевую сцену, позу, ракурс и освещение; ③ если нужно сослаться на референсное изображение, пишите «персонаж на Picture 1», а несколько изображений нумеруйте в порядке передачи. Ограничение запроса — 5000 символов; подробности в основном тексте работают эффективнее нагромождения прилагательных.
-
Как сделать набор изображений одного и того же персонажа с разных ракурсов?
Сначала используйте один чёткий референс с хорошо видимым объектом без перекрытий в качестве Picture 1, зафиксируйте в промпте описание черт персонажа, затем генерируйте изображения по одному, меняя только описание угла или позы, например: анфас, профиль, вид со спины, поясной и полноростовой портрет, с фиксированным соотношением сторон 3:4 или 1:1. Сохранение одинакового seed для каждого изображения помогает уменьшить случайные различия; стилистическая согласованность серии изображений в основном поддерживается за счёт референса и фиксированного описания объекта.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: minimax-h3-image/text-to-image
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для minimax-h3-image/text-to-image и маршрута default — см. таблицу параметров ниже.
seedintegerНеобязательноmin 0max 2147483647Фиксированное случайное зерно для воспроизводимости результата; принимает целое число, при пропуске используется случайное зерно.
promptstringОбязательноminLength 1maxLength 5000pattern \SТекстовый запрос с описанием изображения, длина 1–5000 символов; запрос автоматически расширяется для передачи более богатых деталей.
resolutionstringНеобязательноПо умолчанию: "2K"Уровень выходного разрешения: 1K — около 1 МП, 2K — около 4 МП, 4K — около 16 МП; по умолчанию 2K.
1K2K4Kaspect_ratiostringНеобязательноПо умолчанию: "1:1"Соотношение сторон выходного изображения; при значении auto модель выбирает его самостоятельно, по умолчанию 1:1.
auto1:15:44:54:33:43:22:3Показать все (3)Свернуть
16:99:1621:9output_formatstringНеобязательноПо умолчанию: "jpeg"Формат выходного изображения, по умолчанию jpeg; файлы PNG значительно больше по размеру (около 12 МБ для 2K и около 30 МБ для 4K).
jpegpngcallbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "minimax-h3-image/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "output_format": "jpeg"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "minimax-h3-image/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "jpeg"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "minimax-h3-image/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "jpeg"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →
Похожие модели
Все модели →Тот же тип
-
 Seedream 5.5 ByteDance $0.019 /изображение
-
 Grok Imagine Image 2.0 xAI $0.052 /изображение
-
 Z-Image Alibaba $0.008 /изображение
-
 Wan 2.7 Image Alibaba $0.035 /изображение
-
 Recraft V4.1 Recraft $0.010 /изображение
-
 FLUX.2 Klein 9B Black Forest Labs $0.0086 /изображение
-
 Ideogram V4.5 Ideogram $0.011 /изображение
-
 Google Virtual Try-On Google $0.107 /изображение
-
 GPT Image 2 OpenAI $0.007 /изображение
-
 GPT Image 2.5 OpenAI $0.017 /изображение
-
 FLUX 3 Image Klein Black Forest Labs $0.0092 /изображение
-
 FIBO 1.5 Bria $0.058 /изображение