MiniMax
MiniMax H3 Image
minimax-h3-image/text-to-image
Modelo de imagem MiniMax, geração de imagem a partir de texto e edição com 1 a 16 imagens de referência compartilham o mesmo conjunto de recursos, saída de até 4K, suporta dez formatos de proporção e proporção automática, ideal para design conceitual, visuais comerciais e criação em múltiplos estilos
Experimentar minimax-h3-image/text-to-image
Entrada
Criações
Ver todas as criaçõesSaída
image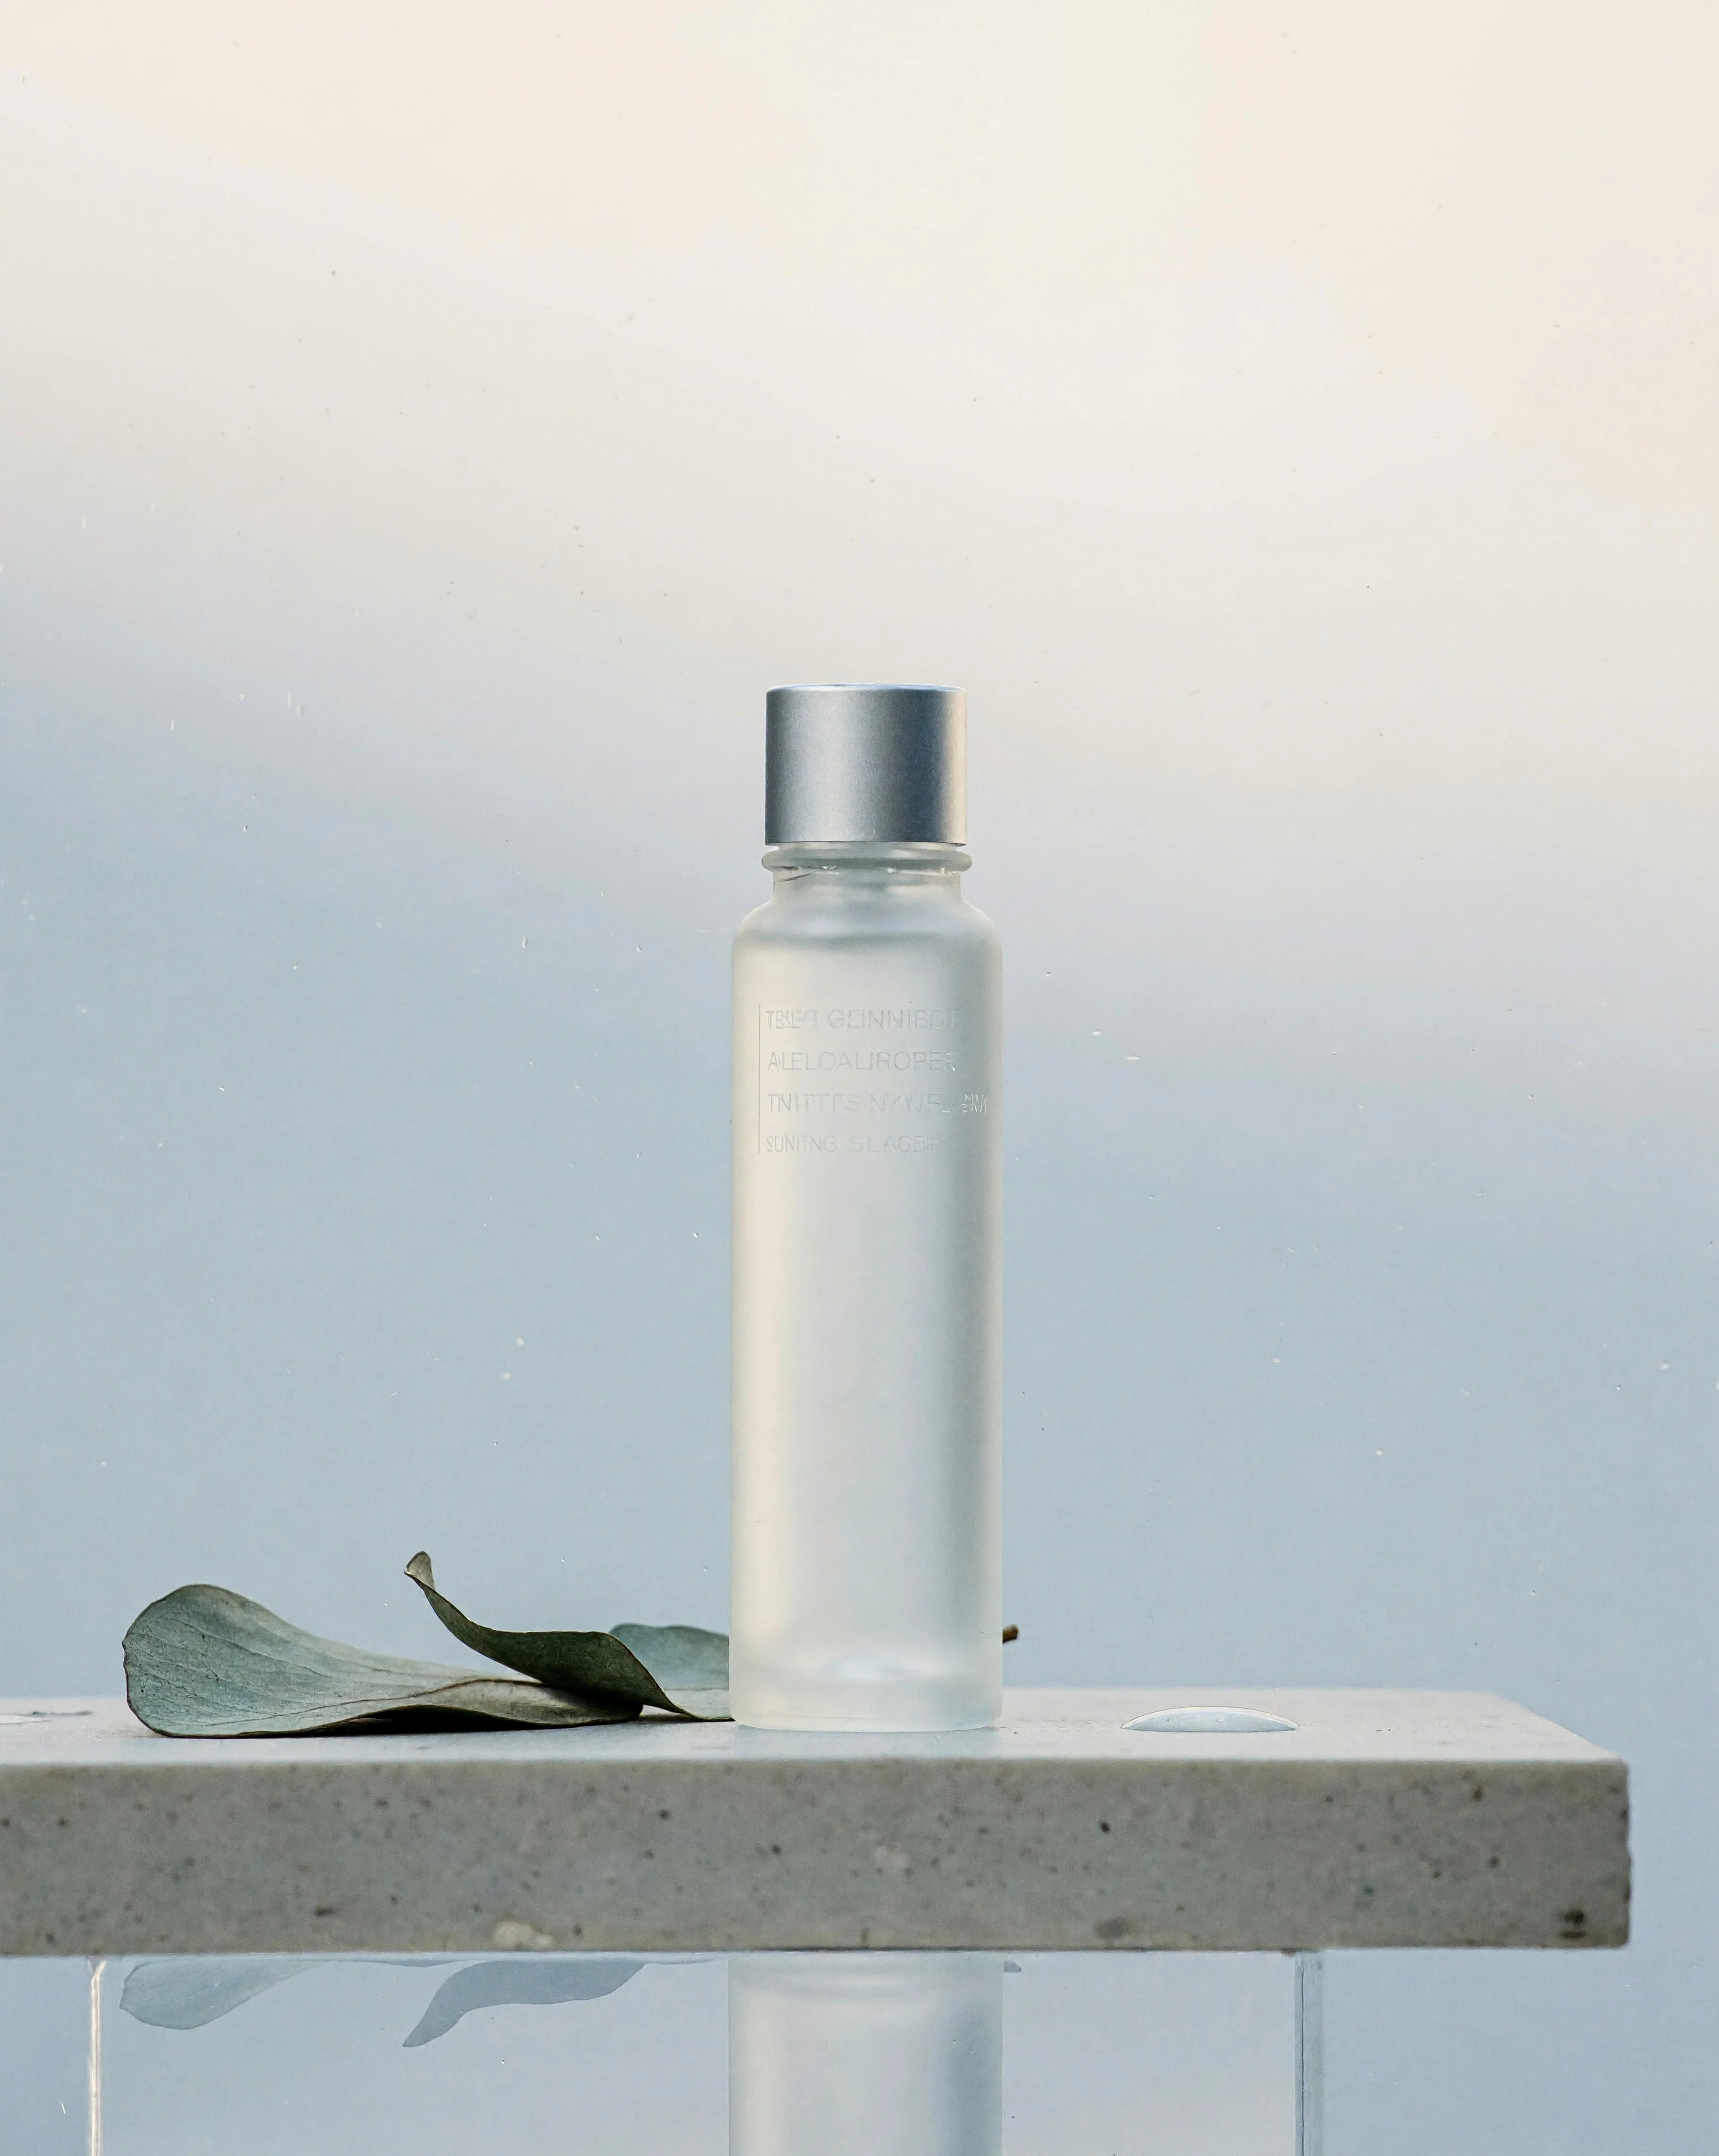
Frasco de sérum com acabamento fosco · Natureza morta sobre pedra para fotografia comercial
Estilo Imagem do produto · Natureza-morta · Iluminação de estúdio
Prompt
Um frasco de sérum facial de vidro fosco, em pé, sobre uma base de microcimento cinza-claro; a superfície matte parece suave graças à textura do vidro, e na frente há uma pequena etiqueta em relevo seco com letras minúsculas e ilegíveis. Ao lado do frasco, duas folhas secas de eucalipto e uma gota de água cristalina. Um grande softbox posicionado atrás e ligeiramente de lado desenha um reflexo alto e estreito ao longo da borda do frasco, enquanto uma luz de preenchimento sutil ilumina o lado da sombra. A base baixa de acrílico reflete uma imagem tênue e desfocada do frasco. O fundo faz uma transição de um cinza-claro frio na parte inferior para um branco-creme quente perto do topo, com partículas de poeira extremamente finas flutuando no ar. Profundidade de campo rasa, com foco nítido no ombro e na tampa do frasco, espaço negativo silencioso acima e ao redor do objeto, composição de natureza morta comercial refinada, texturas realistas de vidro e pedra, correção de cor natural.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
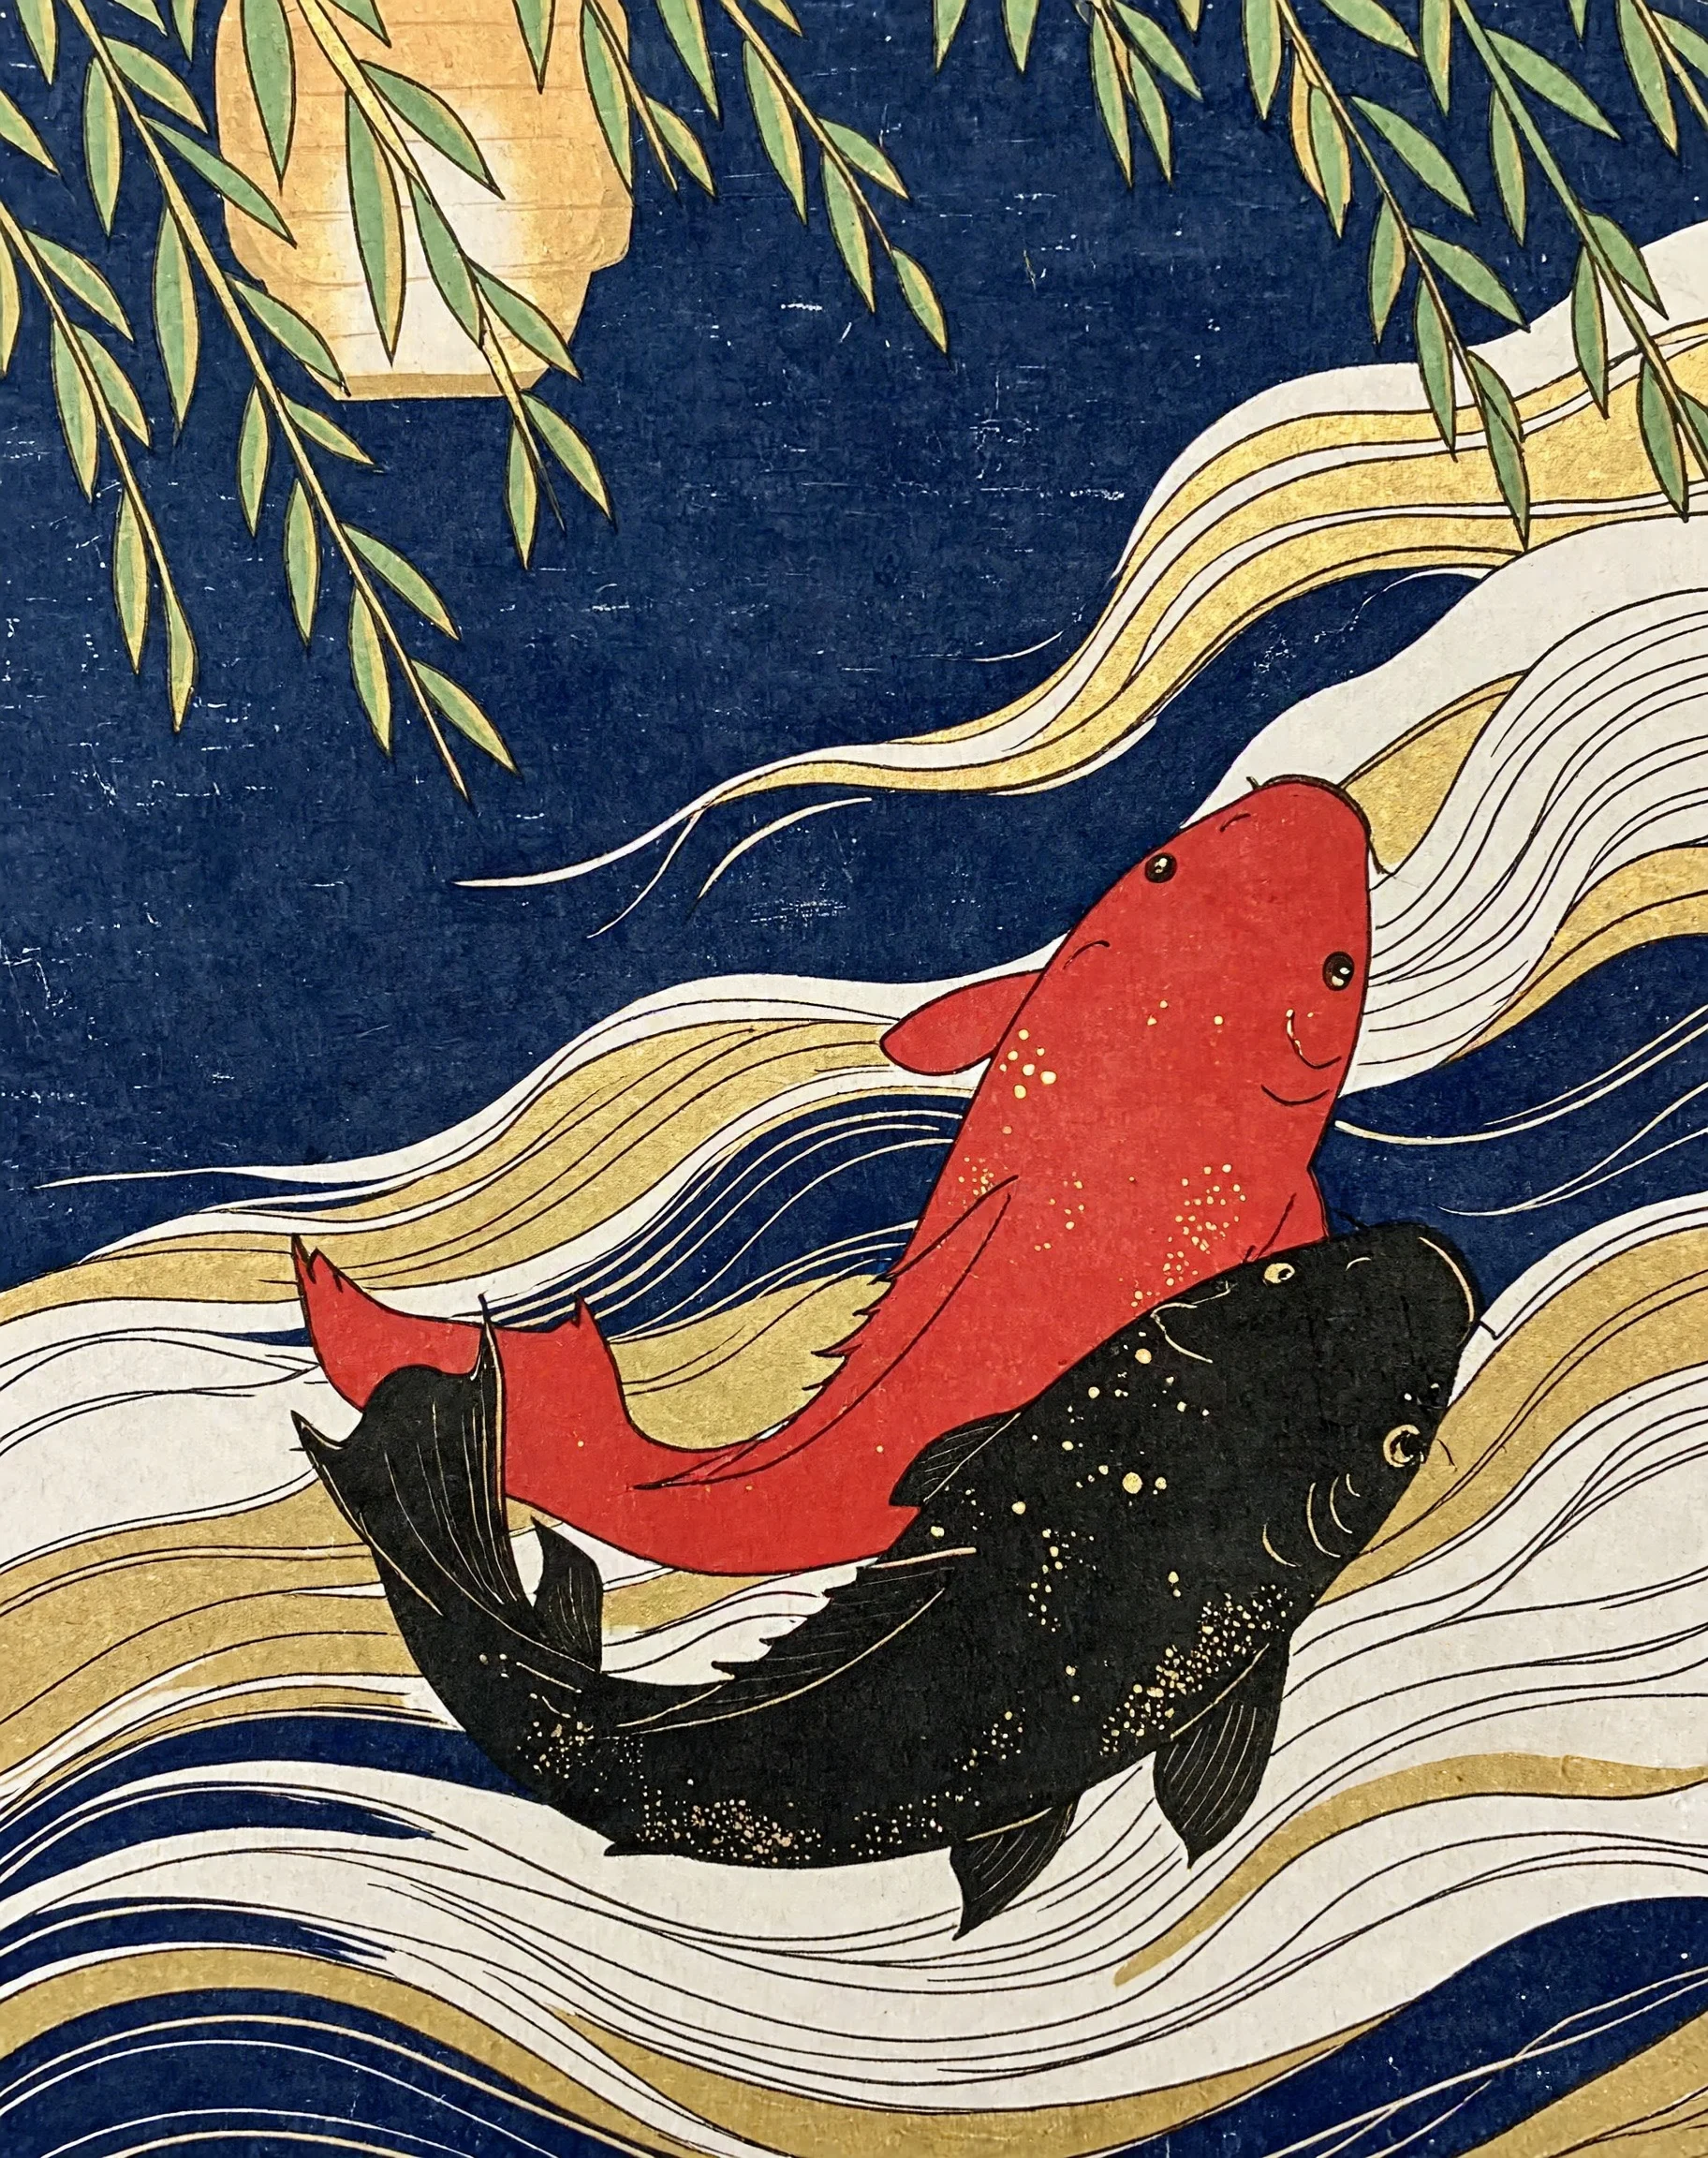
Koi Ukiyo-e·Escamas Douradas na Travessia Noturna
Estilo Ukiyo-e · gravura-japonesa · Ilustração artística
Prompt
Ilustração em estilo ukiyo-e, dois kois nadam em água azul-índigo profunda, um vermelho-cinabrio, outro preto-tinta, com escamas salpicadas de fragmentos de folha de ouro; padrões de ondas em camadas gravados em faixas de cor lisas, contornos nítidos e afiados, enquanto o corpo dos peixes mantém um volume úmido e suave com reflexos sutis de luz. Galhos de salgueiro-chorão e o halo quente de lanternas de papel ao longe formam a composição na área superior, deixando uma grande extensão de água vazia; textura granulada de xilogravura e visível textura do papel, paleta contida dominada por azul-índigo, vermelho-cinabrio, dourado e branco-creme, com o fluxo da água em suave movimento diagonal.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
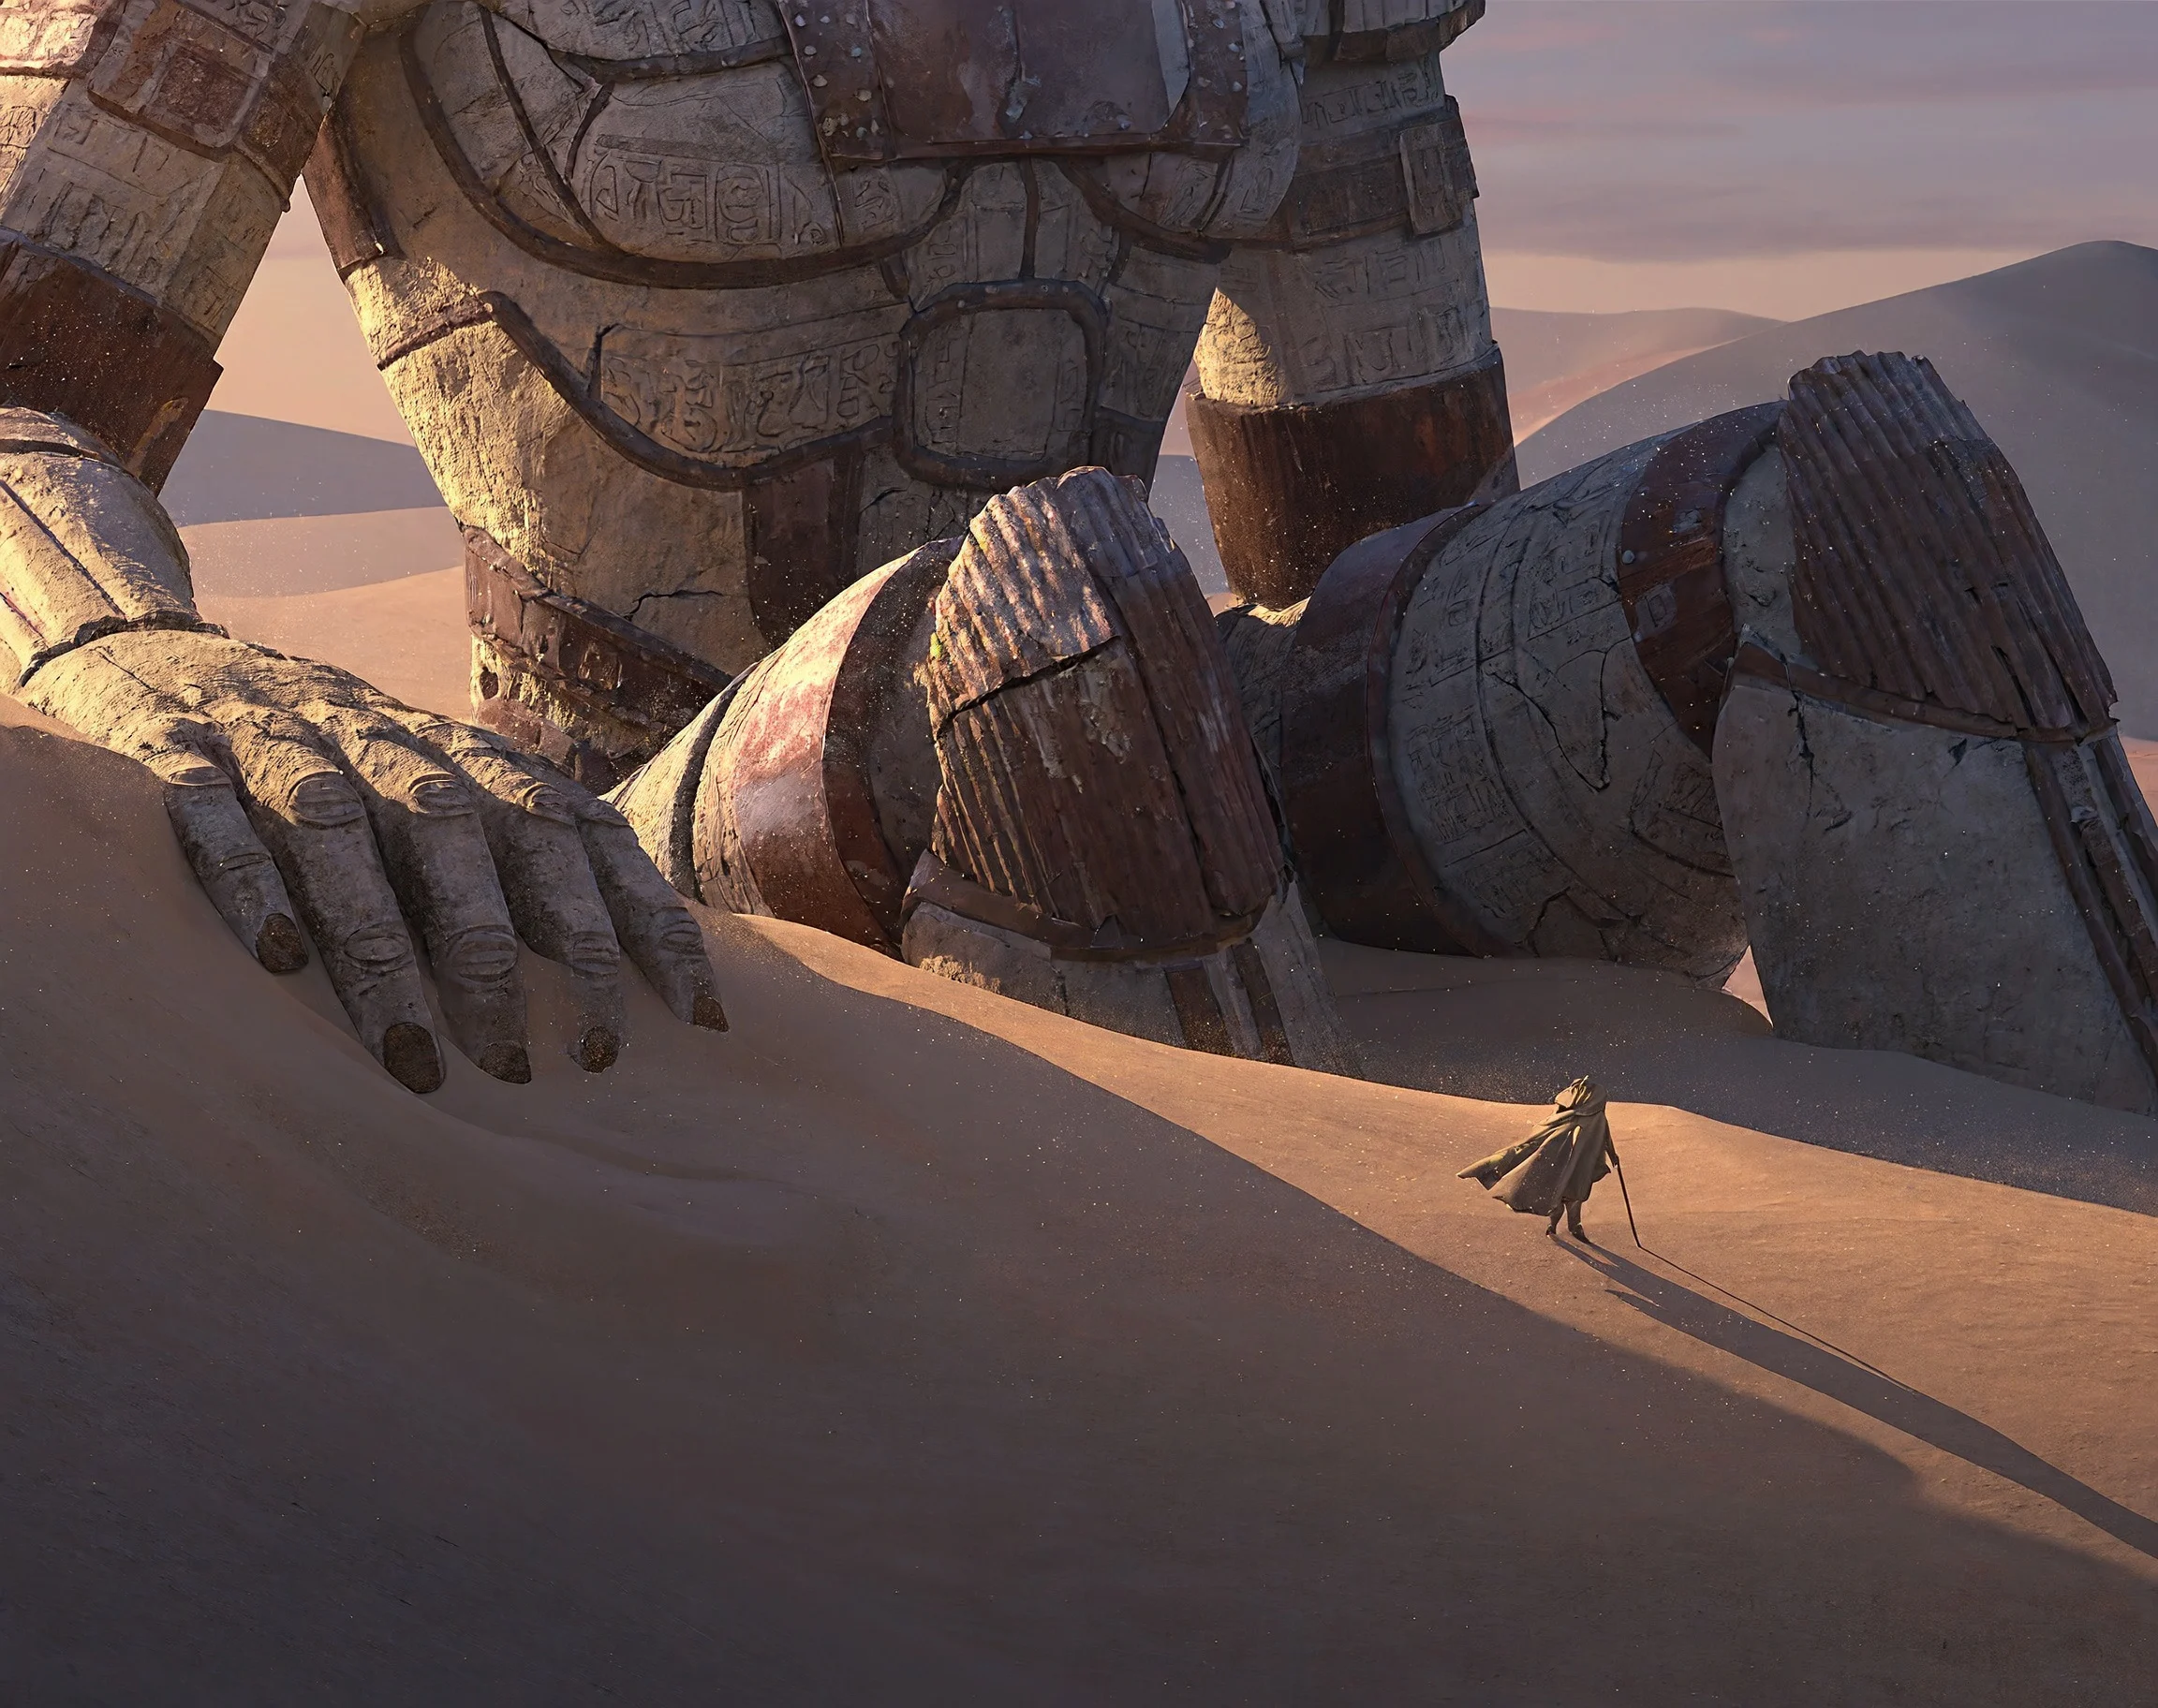
Colosso do Mar de Areia · Cena Conceitual das Ruínas ao Crepúsculo
Estilo Construção de mundo · Ficção científica · Atmosfera
Prompt
Um enorme colosso antigo meio enterrado em um deserto de areias movediças, sua pedra desgastada pelo vento e sua carcaça de metal corroído cobertas por camadas de entalhes erodidos, com uma mão gigante emergindo da areia. Um pequeno e solitário viajante envolto em uma longa capa caminha ao longo da crista de uma duna próxima, projetando uma longa sombra e parecendo insignificante diante do colosso. A luz do sol da hora dourada incide obliquamente pela lateral, banhando as bordas da estátua com uma luz de contorno âmbar quente, enquanto as dunas ao longe desaparecem gradualmente em uma névoa de poeira suave; no ar, finos grãos de areia cintilam sob a luz. Renderização de arte conceitual com aspecto pictórico, com detalhes realistas de materiais, tons suaves de ocre e púrpura acinzentado, profunda sensação de profundidade atmosférica, escala épica, atmosfera serena e misteriosa.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
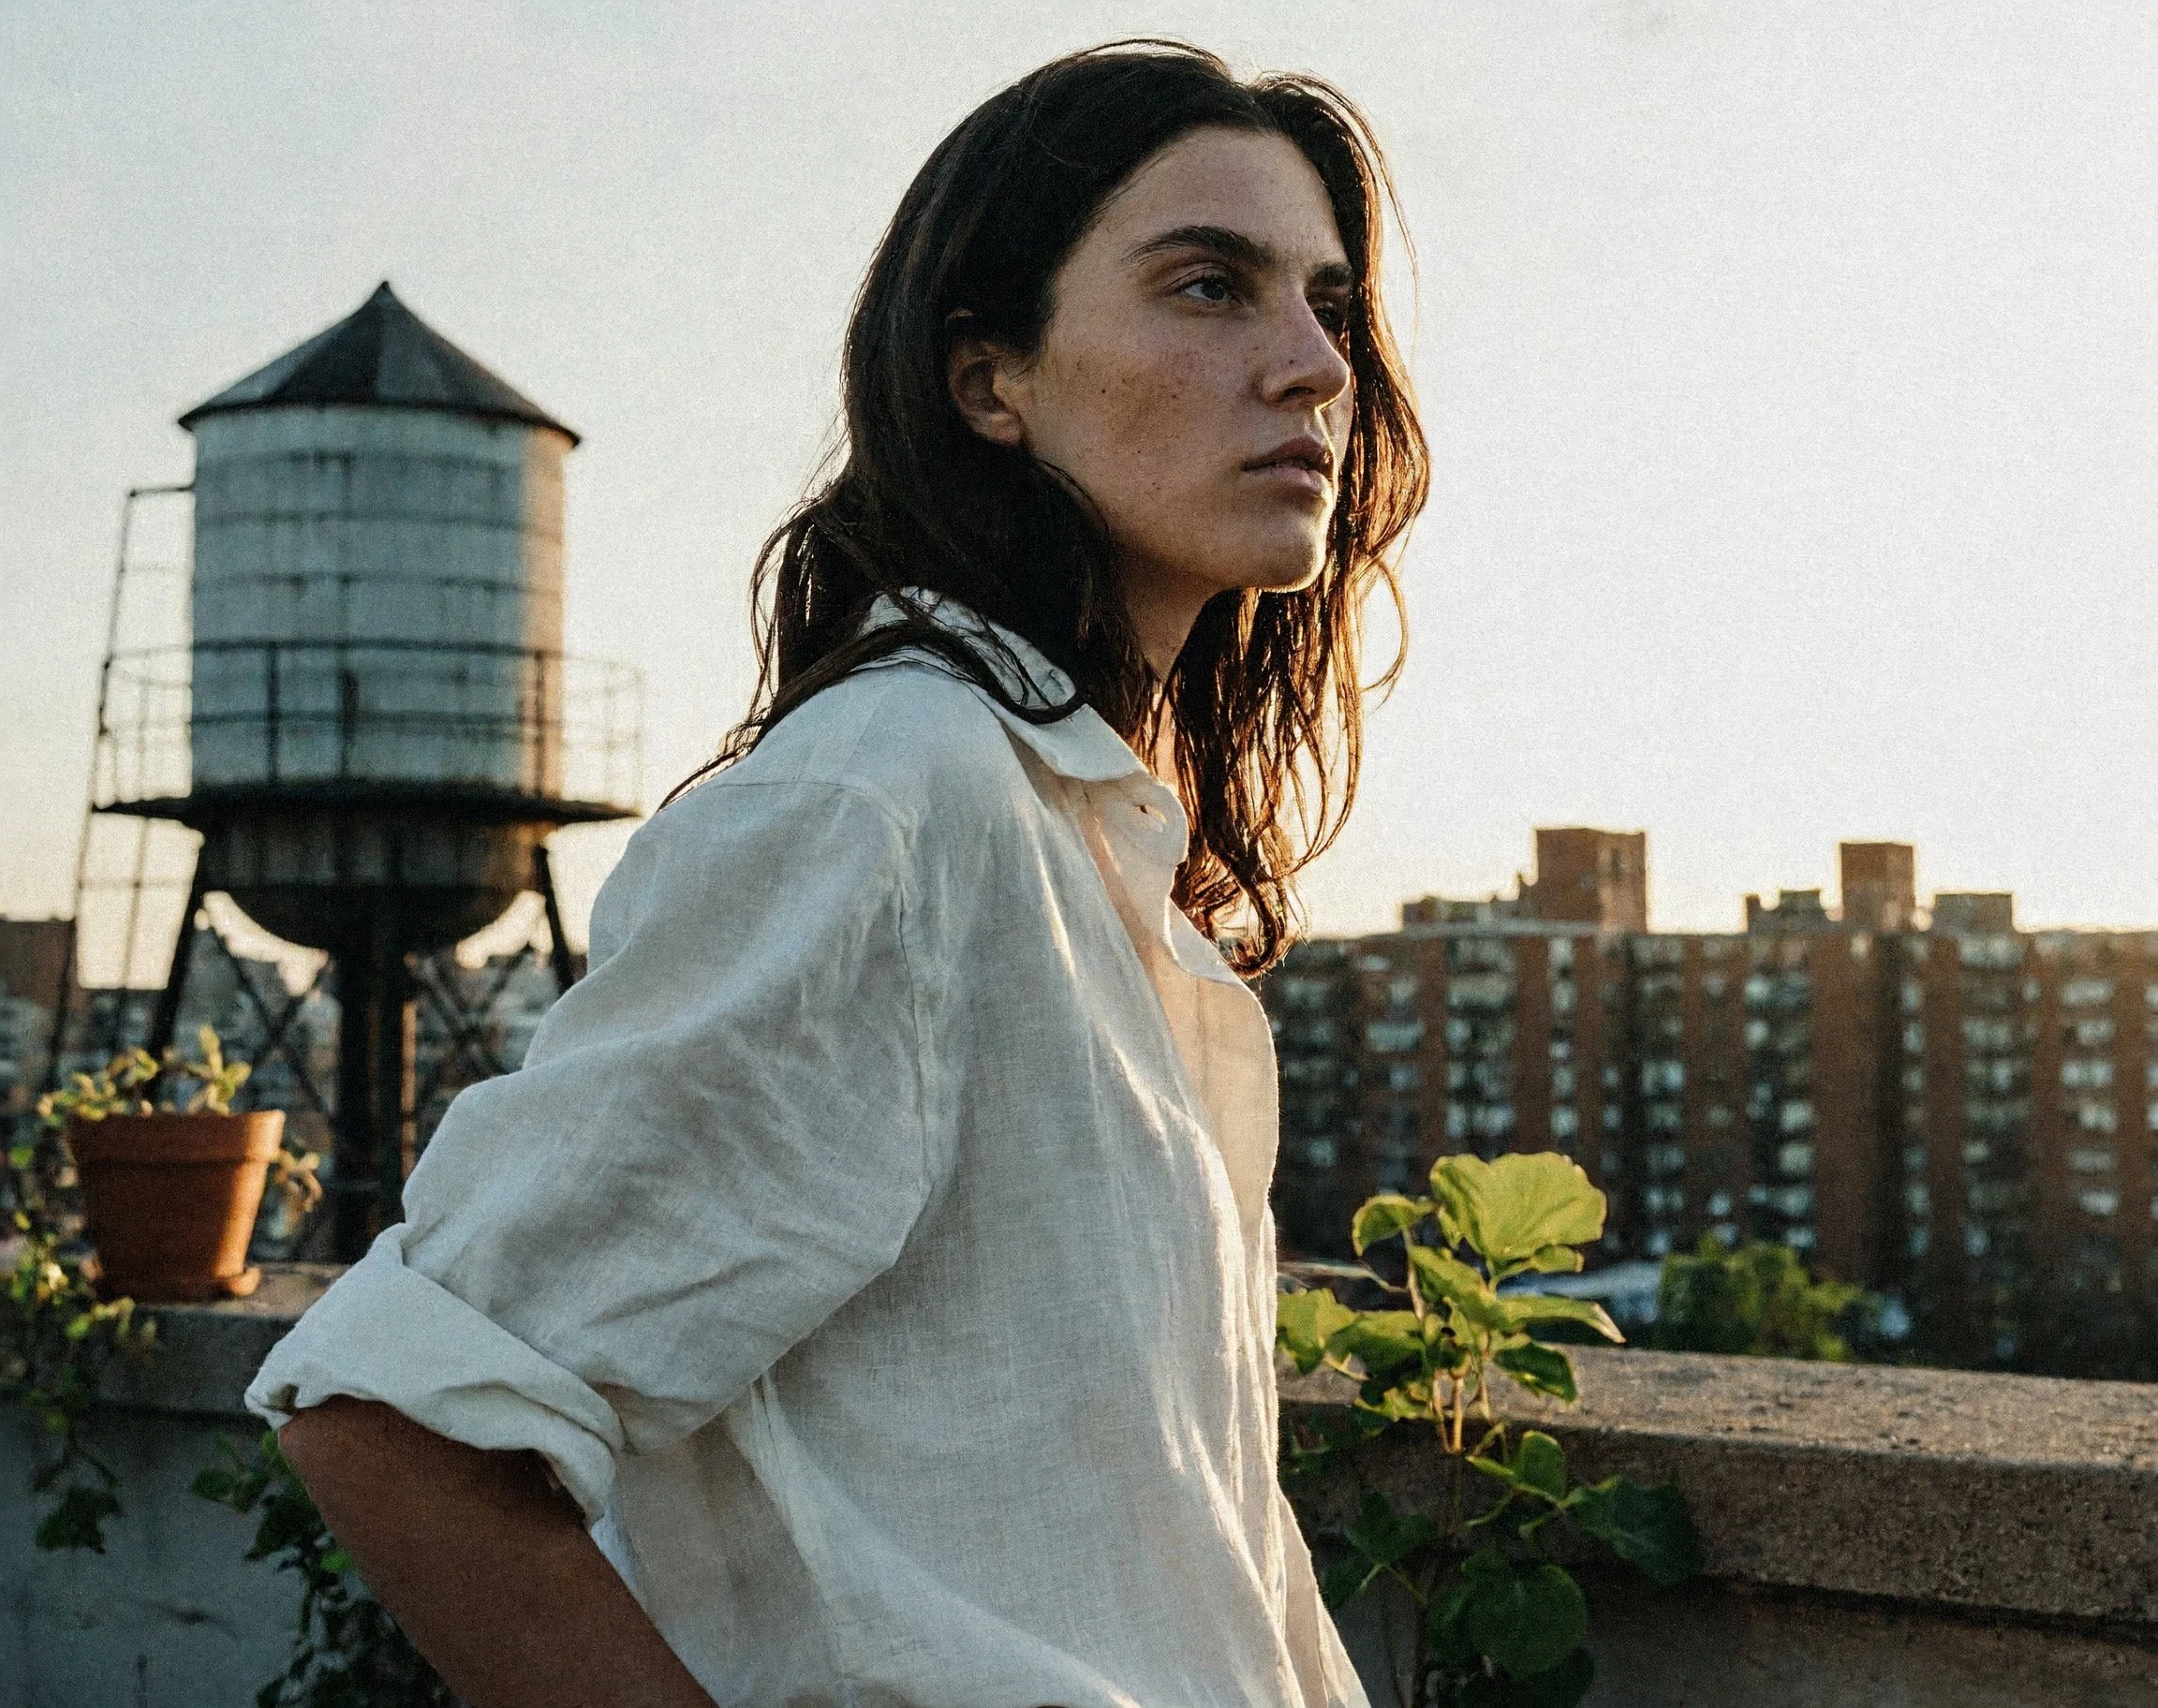
Terraço à tarde · Retrato com luz lateral e textura de filme
Estilo Retrato e fotografia · Qualidade cinematográfica · Hora dourada
Prompt
Um retrato de uma jovem usando uma camisa de linho solta na cor bege-creme, em pé na beira de um terraço urbano ao entardecer. Ela vira o rosto levemente para o sol baixo, e a luz do pôr do sol cria uma borda dourada e quente em seus cabelos escuros soltos, enquanto o lado sombreado de seu rosto fica imerso em um claro-escuro suave e delicado. Atrás dela, uma caixa d'água e os prédios de apartamentos ao longe se dissolvem em um desfoque suave; uma mureta baixa de concreto e alguns vasos de plantas compõem o primeiro plano. Textura de pele natural, poros finos e sardas leves visíveis, granulação semelhante à de filme, tons quentes de baixa saturação combinados com sombras frias, profundidade de campo rasa, com a qualidade de uma produção editorial de revista de moda.
Copie o prompt completo e adapte-o para a sua própria geração.
Etiquetas
Preços
minimax-h3-image/text-to-image per image
| Especificações | Preço unitário |
|---|---|
| 1K | $0.0129 |
| 2K | $0.0129 |
| 4K | $0.0393 |
Visão geral do posicionamento
Este é um modelo que gera imagens estáticas a partir de descrições textuais. Basta inserir um prompt para obter uma imagem condizente com a descrição, com controle sobre o nível de resolução, a proporção da imagem e o formato de saída. Quando necessário, também é possível fixar uma semente aleatória para tornar reproduzíveis os resultados gerados com o mesmo prompt e as mesmas configurações. Ele é voltado para designers, criadores de conteúdo e desenvolvedores que precisam materializar ideias rapidamente, sendo adequado para criar concept art, imagens de atmosfera de cenas e diversos tipos de materiais visuais.
Destaques principais
- Expansão automática do prompt — o prompt enviado é automaticamente expandido, acrescentando mais detalhes que ajudam a obter uma expressão visual mais rica.
- Múltiplos níveis de resolução disponíveis — a resolução de saída pode ser escolhida entre 1K, 2K e 4K, correspondendo a aproximadamente 1, 4 e 16 megapixels.
- Suporte a diversas proporções de imagem — inclui várias proporções de 1:1 a 21:9 e também permite a seleção automática, adaptando-se a diferentes necessidades de layout.
- Semente fixa e reproduzível — defina uma semente inteira entre 0 e 2147483647 para reproduzir resultados com o mesmo prompt e os mesmos parâmetros.
Descrição das capacidades
Geração de imagem a partir de texto: insira um prompt que descreva a cena e o modelo gera uma imagem estática com base nele. O prompt deve ter no mínimo 1 caractere e no máximo 5000 caracteres.
Controle do nível de resolução: é possível escolher a resolução de saída entre 1K, 2K e 4K, correspondendo a aproximadamente 1, 4 e 16 megapixels; o padrão é 2K.
Controle da proporção da imagem: suporta 1:1, 5:4, 4:5, 4:3, 3:4, 3:2, 2:3, 16:9, 9:16, 21:9 e proporção automática; o padrão é 1:1.
Escolha do formato de saída: é possível escolher a saída em JPEG ou PNG; arquivos PNG são maiores, cerca de 12 MB em 2K e cerca de 30 MB em 4K.
Semente aleatória fixa: oferece uma semente inteira de 0 a 2147483647 para facilitar a reprodução de resultados com o mesmo prompt e os mesmos parâmetros; se não for definida, é gerada aleatoriamente.
Cenários de aplicação
- Designers conceituais criando personagens e cenários — insira a descrição textual de um personagem ou cenário e gere concept art estilizada para propostas iniciais e desenvolvimento visual.
- Criadores de conteúdo produzindo imagens de apoio — escreva prompts com base no tema de artigos ou vídeos e gere imagens adaptadas ao layout, prontas para uso direto na publicação de conteúdo.
- Produção de materiais visuais comerciais — selecione o nível 4K e proporções amplas para gerar materiais de alta resolução para publicidade ou peças de exibição.
- Desenvolvedores gerando imagens em lote — por meio de combinações fixas de sementes e parâmetros, gere ativos de imagem reproduzíveis em lote e integre-os a pipelines de design ou conteúdo.
Limitações e recomendações de escolha
O prompt é obrigatório, tem no máximo 5000 caracteres e não pode conter apenas caracteres de espaço em branco. O nível de resolução, a proporção da imagem e o formato de saída devem ser escolhidos entre valores enumerados, sem suporte a valores personalizados. O valor da semente é limitado a um inteiro de 0 a 2147483647. O resultado gerado é uma imagem estática, com uma imagem por requisição.
Novidades
Ver o changelog →- Novo modelo MiniMax H3 Image disponível: geração de imagem a partir de texto e edição com múltiplas imagens de referência
Perguntas frequentes
Ver todas as perguntas →-
Quantas imagens de referência no máximo podem ser fornecidas?
A conversão imagem-para-imagem aceita no máximo 16 imagens de referência por vez, no mínimo 1, nos formatos JPG, PNG ou WEBP, com cada lado entre 128–8192 px e no máximo 20 MB por imagem. Cada imagem de referência custa $ 0,0036 adicionais, por exemplo, 2K com 3 imagens de referência totaliza $ 0,0129 + 3 × $ 0,0036 = $ 0,0237. Ao escrever o prompt, refira-se a cada imagem pela numeração na ordem em que foram enviadas, como Picture 1, Picture 2, para que o modelo corresponda corretamente aos objetos que você deseja editar ou combinar.
-
Como defino o tamanho da saída e qual é o tamanho máximo?
A resolução tem três níveis: 1K, 2K e 4K, correspondendo a aproximadamente 1 MP, 4 MP e 16 MP, respectivamente, com 2K como padrão. A proporção pode ser auto ou 1:1, 5:4, 4:5, 4:3, 3:4, 3:2, 2:3, 16:9, 9:16, 21:9; ao escolher auto, o modelo decide por conta própria com base no prompt e nas imagens de referência; se precisar de uma composição fixa, especifique explicitamente.
-
Como devo escrever o prompt para preservar a aparência do personagem?
Organize na seguinte ordem: «primeiro descreva o sujeito que deve ser preservado, depois escreva as partes a alterar e, por fim, refira as imagens por número»: ① comece com uma ou duas frases que fixem as características físicas do sujeito, como penteado, vestuário, cores e detalhes marcantes; ② em seguida, indique o cenário pretendido, a pose, o enquadramento e a iluminação; ③ quando for necessário referir imagens de referência, escreva «a pessoa na Picture 1», numerando várias imagens pela ordem em que são introduzidas. O prompt tem um limite de 5000 caracteres; detalhar na descrição principal é mais eficaz do que acumular adjetivos.
-
Como fazer um conjunto de imagens de referência do mesmo personagem em vários ângulos?
Comece usando uma imagem de referência nítida e sem oclusões do sujeito como Picture 1, fixe a descrição das características do personagem no prompt e, em seguida, gere uma imagem por vez alterando apenas a descrição do ângulo ou da pose, por exemplo frontal, perfil, costas, meio corpo e corpo inteiro, com proporção fixa de 3:4 ou 1:1. Manter o mesmo seed em cada imagem ajuda a reduzir variações aleatórias; a consistência de estilo da série é mantida principalmente pela imagem de referência somada à descrição fixa do sujeito.
Criar uma tarefa de geração
https://api.hiapi.ai/v1/tasks Cabeçalhos
AuthorizationstringObrigatórioChave de API da conta. Obrigatória em toda requisição. Exemplo: Bearer YOUR_HIAPI_API_KEY. Obter chave de API
Content-TypestringOpcionalO corpo da requisição é sempre interpretado como JSON; se enviado, apenas application/json (charset opcional) é aceito — qualquer outro valor retorna 415. Exemplo: application/json.
Idempotency-KeystringOpcionalChave de idempotência, até 255 bytes. Retries com a mesma chave da mesma conta criam a tarefa apenas uma vez; replays retornam o taskId original.
Em timeouts de rede ou retries automáticos do cliente, a mesma chave cria a tarefa apenas uma vez, sem cobrança duplicada (escopo = a conta da chave de API). Use um identificador de negócio exclusivo (ex.: "order-42"); replays retornam o taskId original e as chaves expiram 24 h após a primeira requisição. A matriz completa de cenários está na introdução da API assíncrona unificada.
Corpo
modelstringObrigatórioValor fixo atual: minimax-h3-image/text-to-image
routestringOpcionalValor fixo atual: default
inputobjectObrigatório
Objeto de parâmetros de negócio para minimax-h3-image/text-to-image e a rota default — veja a tabela de parâmetros abaixo.
seedintegerOpcionalmin 0max 2147483647Semente aleatória fixa para resultados reproduzíveis; use um número inteiro; se omitido, uma semente aleatória é usada.
promptstringObrigatóriominLength 1maxLength 5000pattern \SPrompt de descrição da imagem, com 1 a 5000 caracteres; o prompt é expandido automaticamente para apresentar detalhes mais ricos.
resolutionstringOpcionalPadrão: "2K"Nível de resolução de saída: 1K equivale a aproximadamente 1 MP, 2K a aproximadamente 4 MP e 4K a aproximadamente 16 MP; o padrão é 2K.
1K2K4Kaspect_ratiostringOpcionalPadrão: "1:1"Proporção de aspecto da saída; quando definida como auto, o modelo escolhe sozinho; o padrão é 1:1.
auto1:15:44:54:33:43:22:3Mostrar tudo (3)Mostrar menos
16:99:1621:9output_formatstringOpcionalPadrão: "jpeg"Formato da imagem de saída, padrão jpeg; arquivos PNG são significativamente maiores (cerca de 12 MB em 2K e cerca de 30 MB em 4K).
jpegpngcallbackobjectOpcional
Configuração de notificação de estado terminal. Se omitida, sem callback: consulte a tarefa por conta própria.
Informe callback.url na criação e o HiAPI fará POST no seu serviço no estado terminal, sem polling. O corpo do callback replica a estrutura do detalhe da tarefa; assinatura, retries e idempotência estão descritos na introdução da API assíncrona unificada.
urlstringObrigatórioObrigatória se callback estiver presente. No estado terminal é enviado um POST para esta URL; deve ser uma URL http(s) válida.
whenstringOpcionalPadrão: "final"Atualmente só há suporte a final — notifica tanto em success quanto em fail.
finalstoragestringOpcionalPadrão: "temp"Nível de armazenamento de artefatos: temp (padrão, ~7 dias) ou persistent (longo prazo, cobrado por tamanho). Saldo insuficiente ou limite excedido ⇒ rebaixamento silencioso para temp; o nível efetivo aparece na resposta de detalhes.
temppersistentExemplos de requisição
# Envia uma tarefa assíncrona; retorna um taskId imediatamente (sem esperar a geração)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "minimax-h3-image/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "output_format": "jpeg"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "minimax-h3-image/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "jpeg"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "minimax-h3-image/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"output_format": "jpeg"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obter detalhes da tarefa
https://api.hiapi.ai/v1/tasks/:id Campos da resposta
taskIdstringObrigatórioID da tarefa, sempre com prefixo tk-hiapi-.
modelstringObrigatórioNome completo resolvido do modelo. Tarefas enviadas com o parâmetro route retornam base@route (ex.: gpt-image-2/text-to-image@ext); caso contrário, igual ao nome enviado.
routestringOpcionalPresente apenas se o parâmetro route explícito foi usado; ecoa o valor enviado.
statusstringObrigatórioEstado da tarefa.
queued Na fila, ainda não iniciada.
handling Em processamento.
archiving Processamento concluído, preparando artefatos.
success Terminal: concluído, artefatos disponíveis (retorna output).
fail Terminal: falha (retorna error).
Após o envio, acompanhe status: success e fail são terminais, os demais não. Faça polling a cada 1–3 s até o estado terminal. Em caso de sucesso, baixe os artefatos em output[].url e transfira antes de expireAt; para retenção longa, use storage: "persistent" na criação.
creatednumberObrigatórioMomento de criação da tarefa (segundos Unix).
completednumberObrigatórioSegundos Unix do estado terminal; 0 enquanto não terminal.
outputarrayOpcional
Presente apenas com status == success. Lista de artefatos — sempre um array; uma tarefa pode retornar vários types ao mesmo tempo (ex.: video + first_frame).
Array [ object ]
Itens do array
urlstringObrigatórioURL do artefato, baixável diretamente.
typestringObrigatórioValores possíveis no momento: video, image, audio, first_frame, last_frame, thumbnail; poderão ser ampliados.
expireAtnumberObrigatórioSegundos Unix de disponibilidade do artefato; baixe ou transfira antes da expiração.
errorobjectOpcional
Presente apenas com status == fail.
codestringObrigatórioCódigo de erro de negócio.
messagestringObrigatórioDescrição do erro.
Exemplos de resposta
Sucesso
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Em processamento (não final)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Falhou
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artigos
Ver todos os artigos →
Modelos relacionados
Ver todos os modelos →Mesmo tipo
-
 GPT Image 2.6 OpenAI $0.023 /imagem
-
 BRIA Product Shot Bria $0.058 /imagem
-
 Qwen Image 2.0 Alibaba $0.042 /imagem
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /imagem
-
 FLUX 3 Image Klein Black Forest Labs $0.0092 /imagem
-
 Ideogram V4.5 Ideogram $0.011 /imagem
-
 Nano Banana Pro Google $0.029 /imagem
-
 BRIA Eraser Bria $0.058 /imagem
-
 FASHN Tryon v1.6 FASHN $0.107 /imagem
-
 Recraft V4.1 Recraft $0.010 /imagem
-
 FLUX.2 Klein 4B Black Forest Labs $0.0004 /imagem
-
 Krea 2 Medium Turbo Krea $0.021 /imagem