
Alibaba
Wan 2.7 Image
wan2.7-image/text-to-image
Модель генерации и редактирования изображений от Alibaba, объединяющая генерацию изображений по тексту, объединение нескольких референсных изображений и редактирование по инструкциям в единый рабочий процесс, с поддержкой длинного текстового рендеринга и контроля фирменных цветов
Попробовать wan2.7-image/text-to-image
Ввод
Работы
Все работыВывод
image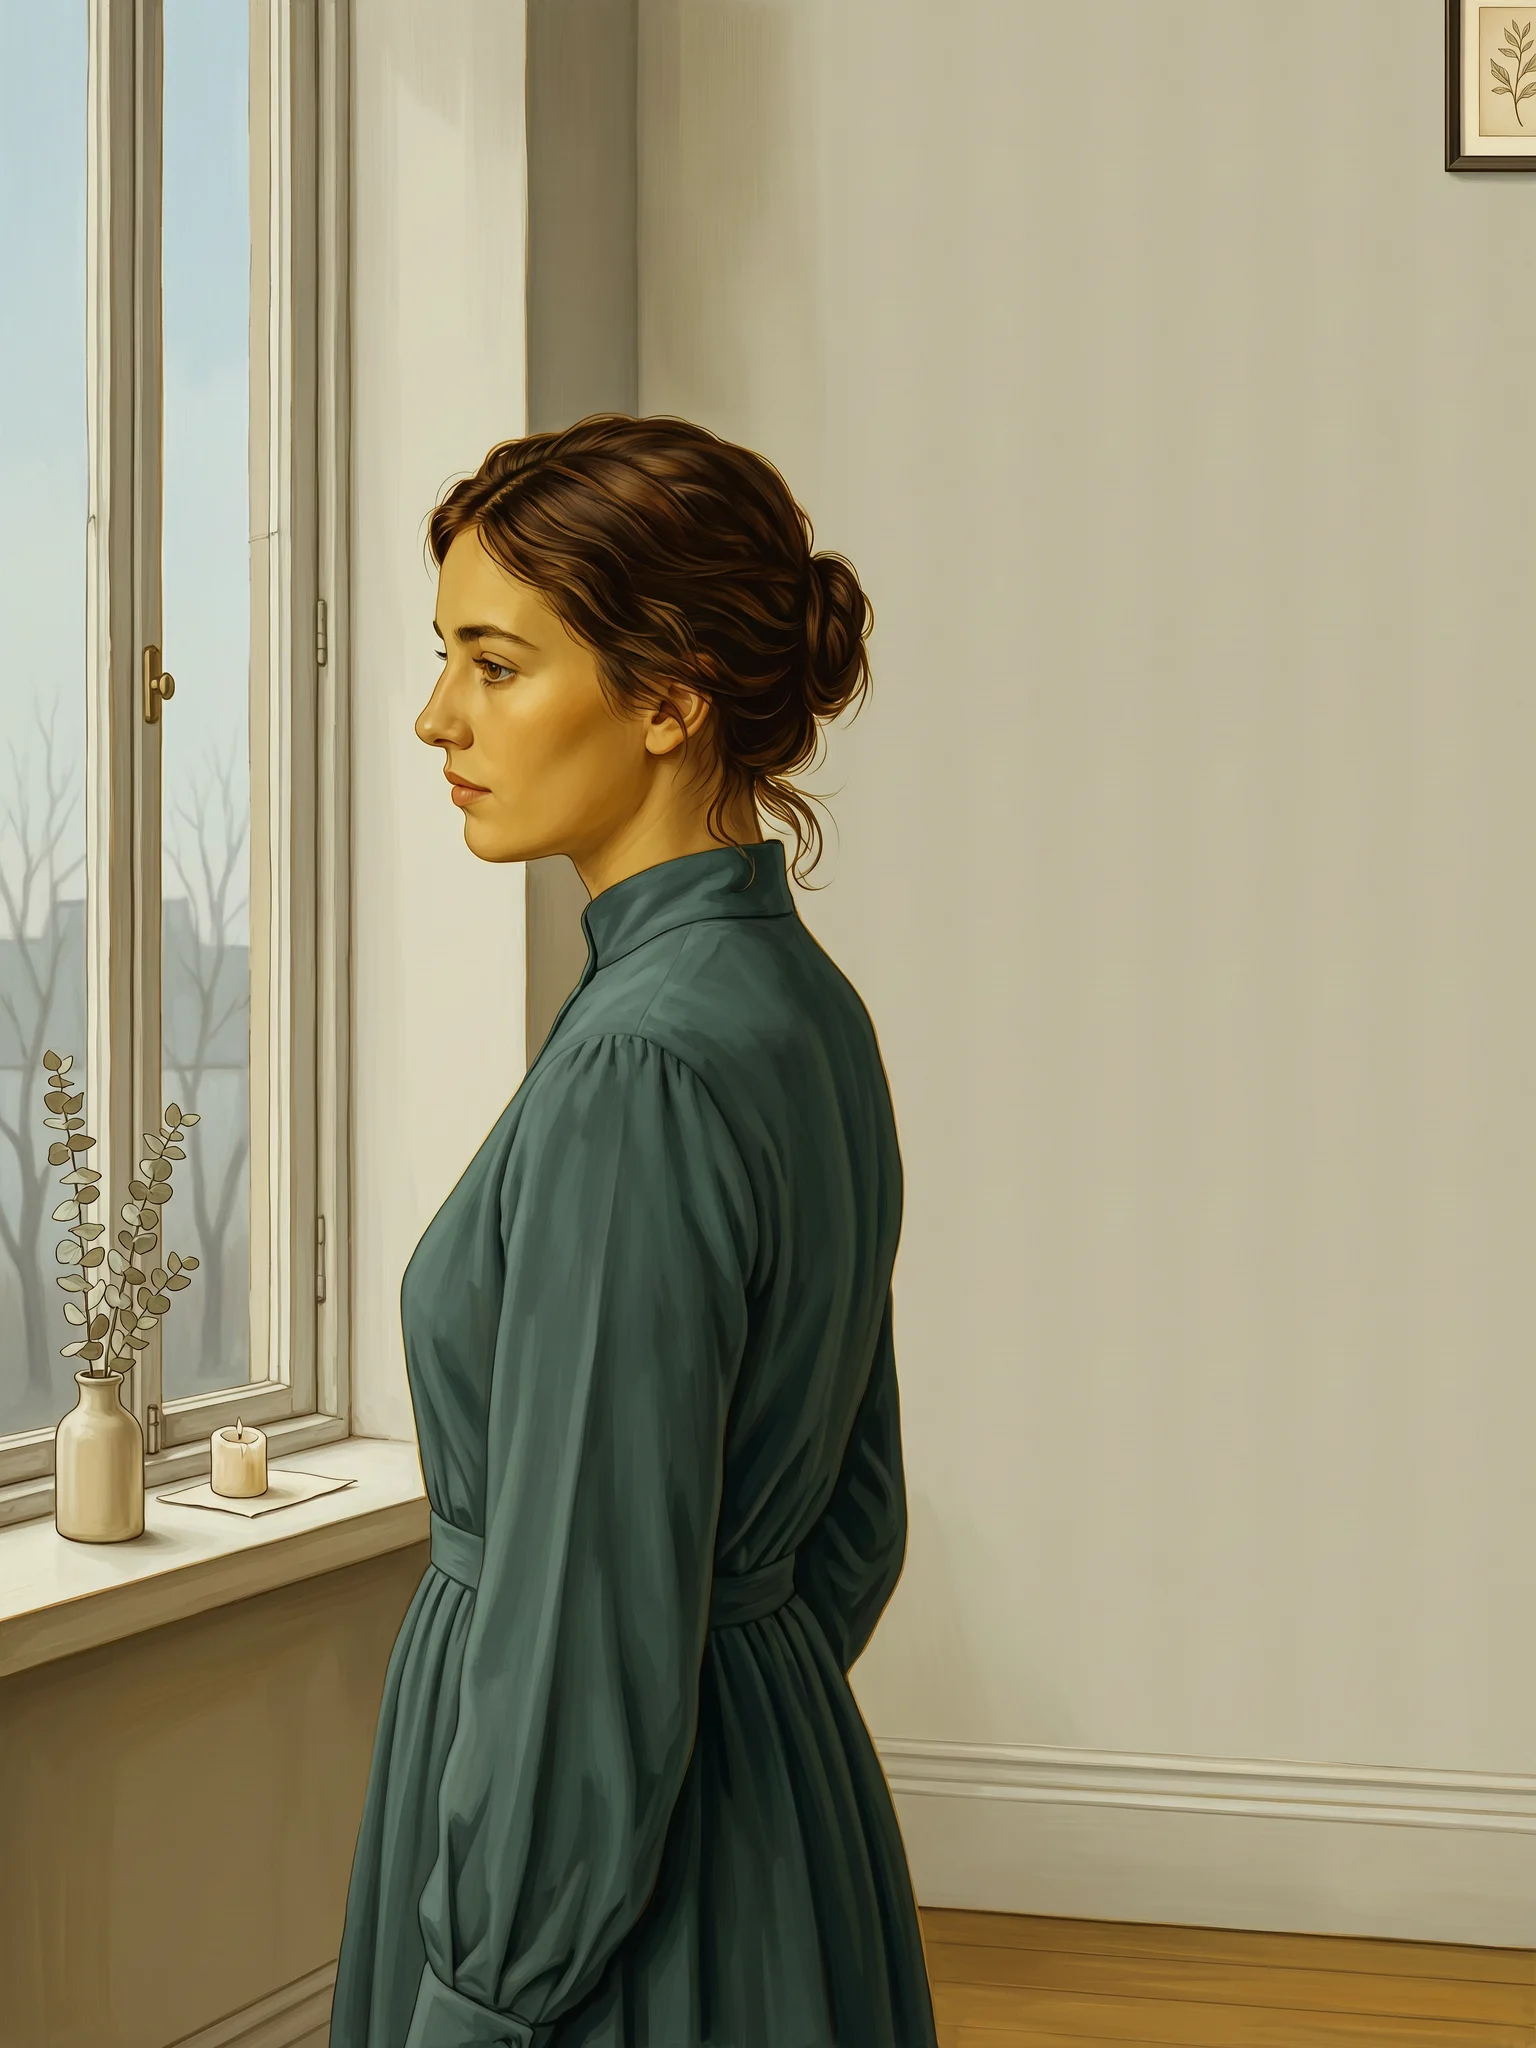
От реализма к флэту: один промпт проходит весь спектр стилей иллюстрации
Стиль Иллюстрация · style-spectrum · Дизайн персонажа
Промпт
Портрет молодой женщины в профиль: она стоит у высокого окна и слегка поворачивает голову к зрителю, мягкий дневной свет падает слева, фон — скромный нейтральный интерьер. Единая классическая иллюстративная композиция, чёткий контур, средний план, справа сбалансированное негативное пространство для размещения текста. Живописный рендеринг с видимой фактурой мазка, тёплые охристые и приглушённые бирюзово-зелёные тона, строгие пропорции тела, мягкий контурный свет на щеке и плече, тонкая воздушная глубина в интерьере, горизонтальная композиция 16:9, богатая детализация складок одежды и прядей волос.
Скопируйте полный промпт и адаптируйте под свою задачу.
Теги
Цены
wan2.7-image/text-to-image per image
| Цена за единицу | $0.080 |
|---|
Краткое описание
wan2.7-image/text-to-image — это модель генерации изображений по текстовому описанию из серии Wan от Alibaba, доступная на HiAPI.ai через единый интерфейс. Она принимает промпты на китайском и английском языках и создаёт изображения с опциональными разрешениями 1K и 2K и восемью соотношениями сторон, а также поддерживает фиксацию случайного зерна для воспроизведения одного и того же результата; при включении режима расширенного рассуждения модель сначала выполняет рассуждение, а затем генерирует изображение, обменивая более длительное время генерации на качество картинки. Подходит разработчикам, которым нужно массово создавать визуальные материалы и предъявлять требования к характеристикам изображения и воспроизводимости результатов, — для производственных процессов, таких как оформление плакатов, сценарные изображения для электронной коммерции и раскадровки.
Ключевые особенности
- Переключатель расширенного рассуждения: выбор между качеством и временем — thinking_mode по умолчанию выключен; при включении модель сначала выполняет рассуждение, а затем генерирует изображение, что позволяет гибко переключаться в зависимости от требований бизнеса к качеству генерации и времени ожидания.
- Фиксированное зерно, воспроизводимый результат — передача seed позволяет воспроизвести одно и то же изображение, что удобно для контроля переменных при отладке промптов или пакетной генерации и для стабильного вывода.
- Соотношения сторон от портретного до сверхширокого — помимо распространённых пропорций 1:1, 16:9, 9:16, доступны также 21:9, 8:1 и 1:8, что позволяет напрямую адаптироваться к баннерам, вертикальным материалам и сверхширокой вёрстке.
Описание возможностей
Генерация изображений по тексту на китайском и английском: промпты поддерживают китайский и английский языки, длина — до 5000 символов; разработчики могут напрямую описывать изображение по-китайски или использовать английские промпты, что снижает затраты на межъязыковую переработку.
Управление разрешением и форматом: вывод доступен в вариантах 1K и 2K в сочетании с восемью соотношениями сторон; один вызов позволяет получить готовое изображение, соответствующее спецификации места размещения, сокращая необходимость последующей обрезки и масштабирования.
Генерация с усиленным рассуждением: при включении thinking_mode повышается качество изображения, но увеличивается время; можно выбирать по уровням в зависимости от важности материала, например отключать на этапе черновика и включать на этапе финального варианта.
Воспроизводимость результата: случайность фиксируется через seed; один и тот же промпт и параметры позволяют повторно получать одинаковый результат, что удобно для регрессионного сравнения и проверки результатов при пакетном производстве.
Сценарии применения
- Пакетная генерация иллюстраций для кампаний маркетинговыми разработчиками — ввод темы кампании и описания изображения, генерация в формате 16:9 или 1:1; полученные иллюстрации можно напрямую размещать на лендингах и в рекламных материалах.
- Создание сценарных изображений товаров для систем электронной коммерции — генерация сценарных изображений по тексту с преимуществами товара в качестве промпта, для использования в качестве материалов на страницах описания товара и в списках товаров.
- Раскадровки и эскизы сторибордов для контент-команд — написание промптов покадрово по сценарию с фиксированным seed и получение воспроизводимых референсных раскадровок для предварительной оценки идей.
- Адаптация материалов под разные форматы размещения — генерация одного и того же описания в пропорциях 21:9, 3:4, 1:8 и других для получения комплекта материалов, необходимых для баннеров, вертикальных и сверхшироких форматов.
Ограничения и рекомендации по выбору
Эта модель выполняет только генерацию изображений по тексту: она не принимает входные референсные изображения и не предоставляет возможностей редактирования изображений или локальной перерисовки; максимальное разрешение вывода — 2K, поэтому при необходимости получить изображение 4K следует использовать модель Pro той же серии. Если задача требует согласованности нескольких изображений, редактирования по инструкции или редактирования по клику, текущая модель не подходит. Рендеринг текста в промпте не гарантируется; готовые изображения с точной вёрсткой и требованиями к фирменным цветам по-прежнему требуют ручной проверки. Результат генерации в значительной степени зависит от формулировки промпта; рекомендуется сначала пробовать версию с более низким разрешением и фиксированным seed, а затем переходить к пакетной генерации.
Новости
Смотреть changelog →- Новая модель Запущена модель генерации изображений wan2.7-image-standard
Частые вопросы
Все частые вопросы →-
Какие специальные форматы изображения поддерживает Wan 2.7 Image?
Помимо обычных горизонтальных и вертикальных форматов, поддерживаются также сверхширокие и сверхвысокие форматы, такие как 21:9, 8:1 и 1:8.
-
Какую роль играет режим размышления (Thinking Mode)?
После включения увеличивается время генерации, но повышается качество рассуждений и организации изображения для сложных промптов; для быстрых черновиков его можно оставить выключенным.
-
Как выбрать между 1K, 2K и 4K?
Сначала используйте 1K или 2K для проверки направления, а 4K выбирайте, когда в итоге нужен более крупный результат. Цена на этой странице — фиксированная стоимость за одно изображение.
-
Поддерживается ли референсное изображение?
Текущий идентификатор модели относится к чисто текстовой генерации изображений и не принимает референсные изображения.
Создать задачу генерации
https://api.hiapi.ai/v1/tasks Заголовки
AuthorizationstringОбязательноAPI-ключ аккаунта. Обязателен в каждом запросе. Пример: Bearer YOUR_HIAPI_API_KEY. Получить API-ключ
Content-TypestringНеобязательноТело запроса всегда разбирается как JSON; при отправке принимается только application/json (charset опционален) — любое иное значение возвращает 415. Пример: application/json.
Idempotency-KeystringНеобязательноКлюч идемпотентности, до 255 байт. Повторные запросы с тем же ключом того же аккаунта создают задачу лишь один раз; реплеи возвращают исходный taskId.
При сетевых таймаутах или автоповторах клиента один и тот же ключ создаёт задачу только один раз, без двойного списания (область = аккаунт API-ключа). Рекомендуется бизнес-уникальный идентификатор (напр. "order-42"); реплеи возвращают исходный taskId, ключ истекает через 24 часа после первого запроса. Полная матрица сценариев — во введении единого асинхронного API.
Тело запроса
modelstringОбязательноТекущее фиксированное значение: wan2.7-image/text-to-image
routestringНеобязательноТекущее фиксированное значение: default
inputobjectОбязательно
Объект бизнес-параметров для wan2.7-image/text-to-image и маршрута default — см. таблицу параметров ниже.
seedintegerНеобязательноmin 0max 2147483647Случайное зерно для воспроизведения результата генерации; при задании одного и того же зерна выходные данные будут одинаковыми.
promptstringОбязательноminLength 1maxLength 5000Текстовый промпт для генерации изображения, поддерживает ввод на китайском и английском языках, определяет содержание генерируемого изображения.
resolutionstringНеобязательноПо умолчанию: "2K"Уровень выходного разрешения, Pro поддерживает до 4K; по умолчанию 2K.
1K2K4Kaspect_ratiostringНеобязательноПо умолчанию: "1:1"Соотношение сторон выходного изображения; по умолчанию 1:1.
1:116:94:321:93:49:168:11:8thinking_modebooleanНеобязательноПо умолчанию: falseВключать ли усиленное рассуждение для повышения качества изображения; при включении увеличивается время генерации; по умолчанию отключено (false).
callbackobjectНеобязательно
Настройка уведомления о терминальном состоянии. Если не задана — обратных вызовов нет, опрашивайте задачу сами.
Укажите callback.url при создании, и HiAPI отправит POST вашему сервису в терминальном состоянии — опрос не нужен. Тело callback повторяет структуру деталей задачи; проверка подписи, повторы и идемпотентность описаны во введении единого асинхронного API.
urlstringОбязательноОбязательна при наличии callback. В терминальном состоянии на этот URL отправляется POST; это должна быть корректная http(s)-ссылка.
whenstringНеобязательноПо умолчанию: "final"Сейчас поддерживается только final — уведомление и при success, и при fail.
finalstoragestringНеобязательноПо умолчанию: "temp"Уровень хранения артефактов: temp (по умолчанию, ~7 дней) или persistent (долгосрочно, оплата по объёму). При нехватке баланса или превышении лимита — тихое понижение до temp; фактический уровень виден в ответе деталей задачи.
temppersistentПримеры запроса
# Отправляет асинхронную задачу; сразу возвращает taskId (не ждёт генерации)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "wan2.7-image/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "thinking_mode": false
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "wan2.7-image/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": false
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "wan2.7-image/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": False
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Получить детали задачи
https://api.hiapi.ai/v1/tasks/:id Поля ответа
taskIdstringОбязательноИдентификатор задачи, всегда с префиксом tk-hiapi-.
modelstringОбязательноПолное разрешённое имя модели. Задачи, отправленные с параметром route, возвращают base@route (напр. gpt-image-2/text-to-image@ext); иначе совпадает с переданным именем.
routestringНеобязательноПрисутствует только при явном параметре route; повторяет переданное значение.
statusstringОбязательноСтатус задачи.
queued В очереди, ещё не начата.
handling Обрабатывается.
archiving Обработка завершена, готовятся артефакты.
success Терминальное: завершено, артефакты доступны (возвращается output).
fail Терминальное: ошибка (возвращается error).
После отправки следите за status: success и fail — терминальные, остальные нет. Опрашивайте каждые 1–3 с до терминального состояния. При успехе скачайте артефакты из output[].url и перенесите до expireAt; для длительного хранения укажите storage: "persistent" при создании.
creatednumberОбязательноВремя создания задачи (Unix-секунды).
completednumberОбязательноUnix-секунды терминального состояния; до этого — 0.
outputarrayНеобязательно
Только при status == success. Список артефактов — всегда массив; одна задача может вернуть несколько type сразу (напр. video + first_frame).
Array [ object ]
Элементы массива
urlstringОбязательноURL артефакта, доступен для скачивания напрямую.
typestringОбязательноТекущие возможные значения: video, image, audio, first_frame, last_frame, thumbnail; список может расширяться.
expireAtnumberОбязательноUnix-секунды доступности артефакта; скачайте или перенесите до истечения.
errorobjectНеобязательно
Только при status == fail.
codestringОбязательноБизнес-код ошибки.
messagestringОбязательноОписание ошибки.
Примеры ответа
Успех
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
Обработка (не финальное)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Ошибка
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Статьи
Все статьи →-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
Практика генерации изображений по тексту с recraft-v4.1-flash: 5 ценных бизнес-сценариев и ключевые моменты интеграции
Отталкиваясь от стоимости $0.01 за изображение, спланируйте внедрение генерации изображений в реальные бизнес-процессы
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Сравнительный обзор
hailuo-2.3-fast/image-to-video — горизонтальное сравнение: как выбрать модель «изображение в видео» и что учесть при миграции
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата
-

Руководство
kandinsky-6.0-pro/image-to-video в HiAPI: руководство по curl + Python
Как выполнить рабочий запрос генерации видео из изображения в HiAPI: от загрузки первого кадра до асинхронного опроса и финальной загрузки
-

Руководство
Как вызывать kling-4.0/image-to-video на HiAPI: curl, Python и опрос
-

Сравнительный обзор
Recraft v4.1 Flash 文生图横向对比:开发者选型与迁移指南
用每张 $0.01 的成本与纯文生图能力,判断它是否适合你的图像生成流水线
-

Руководство
Как использовать kling-4.0/text-to-video через HiAPI API: curl, Python и рабочий пример запроса
Практическое руководство для разработчиков: кинематографичные промпты, синхронный звук, асинхронный опрос и скачивание результатов
Похожие модели
Все модели →Тот же тип
-
 Krea 2 Medium Turbo Krea $0.021 /изображение
-
 FLUX.1 Schnell Black Forest Labs $0.005 /изображение
-
 Nano Banana Pro Google $0.057 /изображение
-
 BRIA Eraser Bria $0.058 /изображение
-
 Seedream 4.5 ByteDance $0.045 /изображение
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /изображение
-
 Qwen Image 3.0 Alibaba $0.036 /изображение
-
 851 Labs Background Remover 851 Labs $0.002 /изображение
-
 Seedream 5.0 ByteDance $0.025 /изображение
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /изображение
-
 Ideogram V4.5 Ideogram $0.011 /изображение
-
 Ideogram V3 Character Ideogram $0.090 /изображение
Тот же вендор
-
 Qwen Image 2.1 Alibaba $0.020 /изображение
-
 Z-Image Alibaba $0.008 /изображение
-
 HappyHorse 1.1 Alibaba $0.160 /секунду
-
 Wan 2.6 Flash Alibaba $0.043 /секунду
-
 Qwen Image 2.0 Alibaba $0.042 /изображение
-
 Wan 2.7 Video Alibaba $0.100 /секунду
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1 000 символов
- Qwen Image 3.0 Alibaba $0.036 /изображение
-
 HappyHorse 1.0 Alibaba $0.168 /секунду
-
 Wan 3.0 Video Alibaba $0.040 /секунду