
Alibaba
Wan 2.7 Image
wan2.7-image/text-to-image
Modèle de génération et d'édition d'images lancé par Alibaba, qui intègre la génération texte-image, la combinaison de plusieurs images de référence et l'édition par instructions dans un même flux de travail, avec prise en charge du rendu de textes longs et du contrôle des couleurs de marque
Essayer wan2.7-image/text-to-image
Entrée
Créations
Voir toutes les créationsSortie
image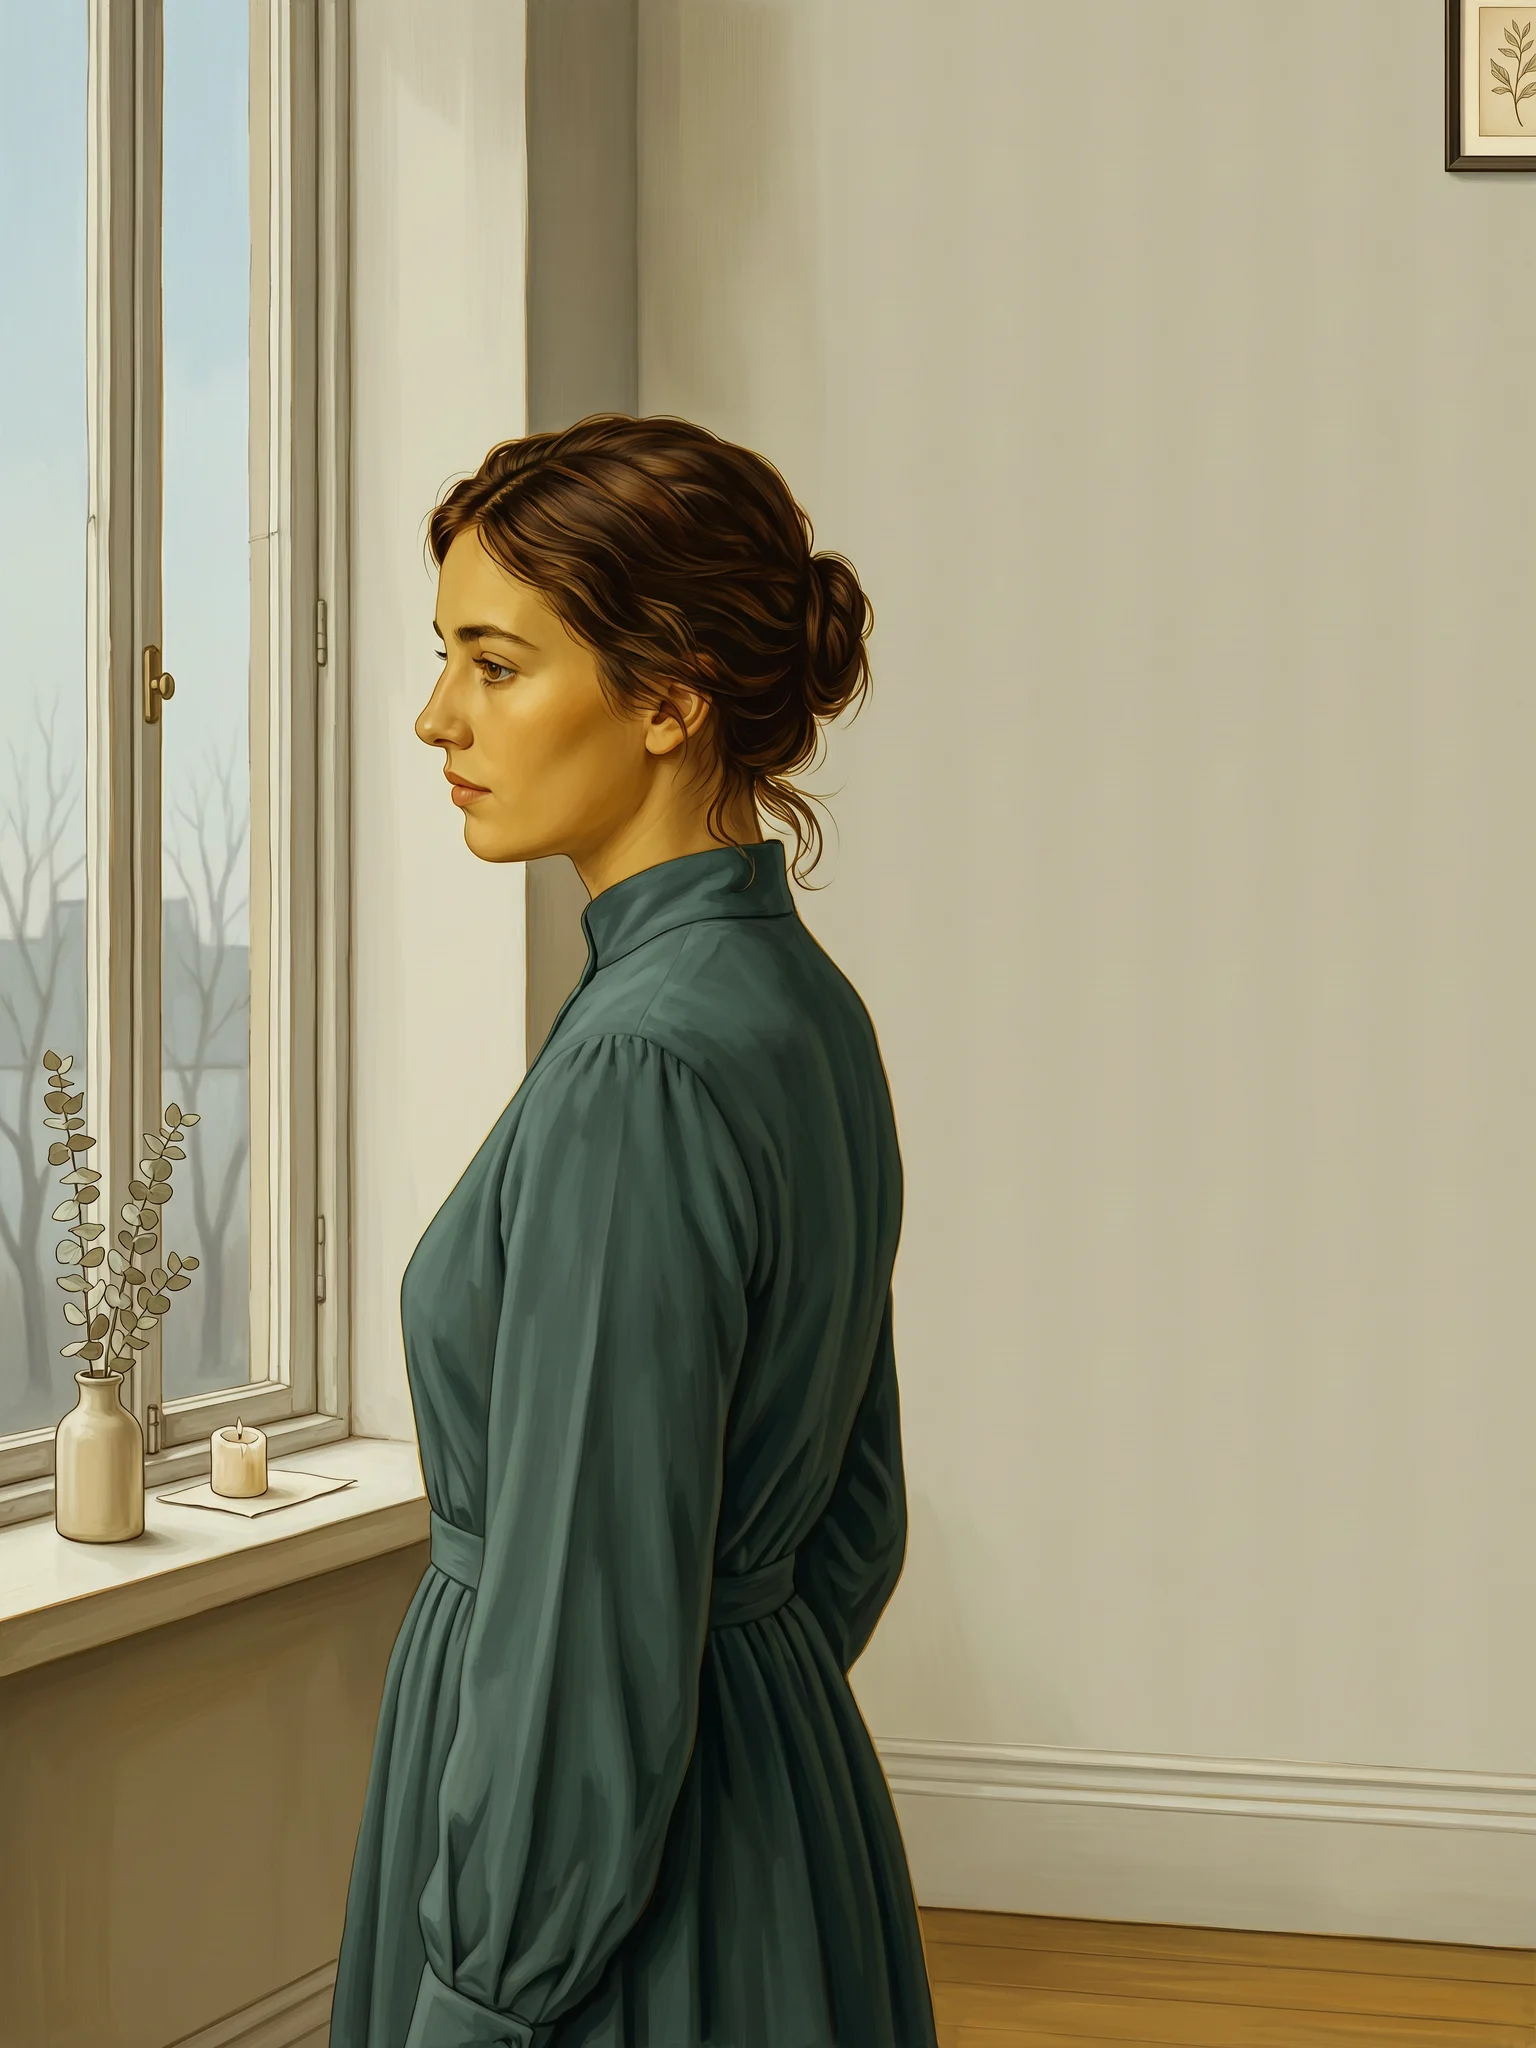
Du réalisme à l'aplat : un seul prompt pour parcourir tout le spectre des styles d'illustration
Style Illustration · style-spectrum · Conception de personnage
Prompt
Portrait de profil d'une jeune femme debout devant une grande fenêtre, la tête légèrement tournée vers le spectateur, une lumière douce venant de la gauche, dans un intérieur sobre et neutre. Composition d'illustration classique unifiée, contours nets, cadrage en plan moyen, avec un espace négatif équilibré à droite pour y placer du texte. Rendu pictural, texture de coups de pinceau visible, palette d'ocre chaud et de vert-bleu désaturé, proportions anatomiques rigoureuses, lumière de contour douce sur le visage et les épaules, profondeur atmosphérique subtile dans la pièce, composition horizontale 16:9, plis des vêtements et mèches de cheveux finement détaillés.
Copiez le prompt complet et adaptez-le à votre propre génération.
Tags
Tarifs
wan2.7-image/text-to-image per image
| Prix unitaire | $0.080 |
|---|
Présentation
wan2.7-image/text-to-image est la voie de génération d'images à partir de texte de la série Wan d'Alibaba, appelée sur HiAPI.ai via une interface unifiée. Il accepte des prompts en chinois et en anglais pour générer des images, avec des paliers de résolution 1K et 2K en option et huit ratios d'aspect, et prend en charge la fixation d'une graine aléatoire pour reproduire un même résultat ; une fois le mode raisonnement renforcé activé, le modèle raisonne d'abord puis génère l'image, échangeant un temps de génération plus long contre la qualité visuelle. Il convient aux développeurs qui doivent produire des visuels par lots et qui ont des exigences sur les spécifications d'image et la reproductibilité des résultats, pour des flux de production tels que les illustrations d'affiches, les visuels de scènes e-commerce et les croquis de storyboard.
Points clés
- Interrupteur de raisonnement renforcé, qualité et durée au choix — thinking_mode est désactivé par défaut ; une fois activé, le modèle raisonne d'abord puis génère l'image, pour basculer flexibilité selon les exigences métier de qualité d'image et de temps d'attente.
- Graine fixe, résultats reproductibles — transmettre seed permet de reproduire la même image, ce qui facilite le contrôle des variables et la stabilité de la production lors du débogage des prompts ou de la génération par lots.
- Ratios d'aspect du portrait à l'ultra-large — outre les ratios courants 1:1, 16:9 et 9:16, il propose également 21:9, 8:1 et 1:8, directement adaptés aux bannières, aux supports verticaux et aux mises en page ultra-larges.
Description des capacités
Génération d'images à partir de texte en chinois et en anglais : les prompts acceptent le chinois et l'anglais, jusqu'à 5000 caractères ; les développeurs peuvent décrire directement l'image en chinois ou réutiliser des prompts en anglais, ce qui réduit le coût de réécriture interlangue.
Contrôle de la résolution et du format : la sortie peut être réglée sur les paliers 1K ou 2K avec huit ratios d'aspect ; un seul appel suffit pour obtenir une image finale conforme aux spécifications d'emplacement, ce qui réduit le recadrage et la mise à l'échelle en post-traitement.
Génération avec raisonnement renforcé : une fois thinking_mode activé, la qualité d'image s'améliore mais le temps de génération augmente ; on peut choisir par niveaux selon l'importance du visuel, par exemple désactivé en phase de brouillon et activé en phase de version finale.
Résultats reproductibles : le caractère aléatoire est fixé via seed ; les mêmes prompt et paramètres permettent d'obtenir de façon répétée le même résultat, ce qui facilite les comparaisons de régression et la vérification des résultats en production par lots.
Cas d'usage
- Génération par lots d'illustrations d'événements pour les développeurs marketing — saisir le thème de l'événement et la description de l'image, générer en 16:9 ou 1:1, et produire des illustrations directement intégrables aux pages de destination et aux supports publicitaires.
- Création de visuels de produits pour les systèmes e-commerce — générer des visuels de scènes à partir des arguments de vente du produit comme prompt, pour servir de supports d'affichage sur les pages de détail et les pages de liste des produits.
- Croquis de storyboard et de découpage pour les équipes de contenu — rédiger des prompts plan par plan selon le scénario et fixer la seed pour produire des images de référence de storyboard reproductibles, destinées à la revue créative en amont.
- Adaptation des supports à plusieurs emplacements — générer une même description en 21:9, 3:4, 1:8, etc., pour produire la série complète de supports requise pour les bannières, les versions verticales et les emplacements ultra-larges.
Limites et conseils de choix
Cette voie est purement texte-vers-image : elle n'accepte pas d'image de référence et ne fournit pas de capacités d'édition d'image ou de retouche locale ; la résolution de sortie est plafonnée à 2K, et pour des images finales en 4K, il faut se tourner vers la voie Pro de la même série. Si la tâche dépend de la cohérence entre plusieurs images, de modifications guidées par instructions ou d'édition par clic, la voie actuelle ne peut pas la couvrir. Le rendu du texte dans les prompts n'est pas garanti ; les images finales comportant une mise en page précise et des exigences de couleurs de marque nécessitent encore une vérification humaine. Les résultats générés sont fortement influencés par la formulation des prompts ; il est conseillé d'essayer d'abord une version avec un palier inférieur et une seed fixe, puis de générer par lots.
Nouveautés
Voir le journal des modifications →- Nouveau modèle Mise en ligne du modèle de génération d'images wan2.7-image-standard
Questions fréquentes
Voir toutes les questions →-
Quels formats d'image spéciaux Wan 2.7 Image prend-il en charge ?
Outre les formats paysage et portrait courants, il prend également en charge des formats ultra-larges ou ultra-hauts tels que 21:9, 8:1 et 1:8.
-
À quoi sert le mode Thinking ?
Une fois activé, il augmente le temps de génération afin de renforcer le raisonnement et l'organisation visuelle pour les prompts complexes ; pour un brouillon rapide, il vaut mieux le laisser désactivé.
-
Comment choisir entre 1K, 2K et 4K ?
Commencez par valider la direction avec 1K ou 2K, puis passez à 4K lorsque vous avez besoin d'un rendu final plus grand. Les prix affichés sur cette page correspondent à un tarif fixe par image.
-
Le modèle prend-il en charge les images de référence ?
L'ID de modèle actuel correspond à une approche de génération d'images purement textuelle et n'accepte pas les images de référence.
Créer une tâche de génération
https://api.hiapi.ai/v1/tasks En-têtes
AuthorizationstringRequisClé API du compte. Requise sur chaque requête. Exemple : Bearer YOUR_HIAPI_API_KEY. Obtenir une clé API
Content-TypestringOptionnelLe corps de la requête est toujours analysé en JSON ; s'il est envoyé, seul application/json (charset facultatif) est accepté — toute autre valeur renvoie 415. Exemple : application/json.
Idempotency-KeystringOptionnelClé d'idempotence, jusqu'à 255 octets. Les reprises avec la même clé du même compte ne créent la tâche qu'une seule fois ; les rejeux renvoient le taskId d'origine.
En cas de timeout réseau ou de relance automatique du client, la même clé ne crée la tâche qu'une seule fois, sans double facturation (portée = le compte de la clé API). Utilisez un identifiant métier unique (ex. "order-42") ; les rejeux renvoient le taskId d'origine et les clés expirent 24 h après la première requête. La matrice complète des scénarios est dans la présentation de l'API asynchrone unifiée.
Corps
modelstringRequisValeur fixe actuelle : wan2.7-image/text-to-image
routestringOptionnelValeur fixe actuelle : default
inputobjectRequis
Objet de paramètres métier pour wan2.7-image/text-to-image et la route default — voir le tableau des paramètres ci-dessous.
seedintegerOptionnelmin 0max 2147483647Graine aléatoire, utilisée pour reproduire les résultats de génération ; définir la même graine permet d'obtenir une sortie identique.
promptstringRequisminLength 1maxLength 5000Invite textuelle pour la génération d'images, accepte les entrées en chinois et en anglais, détermine le contenu de l'image générée.
resolutionstringOptionnelDéfaut: "2K"Niveau de résolution de sortie, Pro prend en charge jusqu'à 4K ; par défaut 2K.
1K2K4Kaspect_ratiostringOptionnelDéfaut: "1:1"Rapport largeur-hauteur de l'image de sortie ; par défaut 1:1.
1:116:94:321:93:49:168:11:8thinking_modebooleanOptionnelDéfaut: falseIndique s'il faut activer le raisonnement renforcé pour améliorer la qualité des images générées ; une fois activé, le temps de génération augmente ; désactivé par défaut (false).
callbackobjectOptionnel
Configuration de notification d'état terminal. Sans elle, aucun callback — interrogez la tâche vous-même.
Fournissez callback.url à la création et HiAPI envoie un POST à votre service à l'état terminal — plus besoin de polling. Le corps du rappel reprend la structure du détail de tâche ; vérification de signature, relances et idempotence sont décrits dans la présentation de l'API asynchrone unifiée.
urlstringRequisObligatoire si callback est présent. Un POST est envoyé vers cette URL à l'état terminal ; doit être une URL http(s) valide.
whenstringOptionnelDéfaut: "final"Seul final est pris en charge pour l'instant — notifié sur success et fail.
finalstoragestringOptionnelDéfaut: "temp"Niveau de stockage des artefacts : temp (par défaut, ~7 jours) ou persistent (long terme, facturé au volume). Solde insuffisant ou dépassement de limite ⇒ rétrogradation silencieuse en temp ; le niveau effectif figure dans la réponse de détail.
temppersistentExemples de requête
# Soumet une tâche asynchrone ; renvoie immédiatement un taskId (n'attend pas la génération)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "wan2.7-image/text-to-image",
  "input": {
    "prompt": "…",
    "resolution": "2K",
    "aspect_ratio": "1:1",
    "thinking_mode": false
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "wan2.7-image/text-to-image",
input: {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": false
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "wan2.7-image/text-to-image",
"input": {
"prompt": "…",
"resolution": "2K",
"aspect_ratio": "1:1",
"thinking_mode": False
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtenir le détail de la tâche
https://api.hiapi.ai/v1/tasks/:id Champs de réponse
taskIdstringRequisIdentifiant de tâche, toujours préfixé tk-hiapi-.
modelstringRequisNom complet résolu du modèle. Les tâches envoyées avec le paramètre route renvoient base@route (ex. gpt-image-2/text-to-image@ext) ; sinon identique au nom fourni.
routestringOptionnelPrésent uniquement si le paramètre route explicite a été utilisé ; renvoie la valeur soumise.
statusstringRequisStatut de la tâche.
queued En file, pas encore démarrée.
handling En cours de traitement.
archiving Traitement terminé, préparation des artefacts.
success Terminal : terminé, artefacts disponibles (output renvoyé).
fail Terminal : échec (error renvoyé).
Après soumission, suivez status : success et fail sont terminaux, le reste non terminal. Interrogez toutes les 1–3 s jusqu'à l'état terminal. En cas de succès, téléchargez les artefacts via output[].url et transférez-les avant expireAt ; pour une conservation longue durée, indiquez storage: "persistent" à la création.
creatednumberRequisDate de création de la tâche (secondes Unix).
completednumberRequisSecondes Unix de l'état terminal ; 0 tant que non terminal.
outputarrayOptionnel
Présent uniquement si status == success. Liste d'artefacts — toujours un tableau ; une tâche peut renvoyer plusieurs types à la fois (ex. video + first_frame).
Array [ object ]
Éléments du tableau
urlstringRequisURL de l'artefact, téléchargeable directement.
typestringRequisValeurs possibles actuelles : video, image, audio, first_frame, last_frame, thumbnail ; d'autres pourront s'ajouter.
expireAtnumberRequisSecondes Unix de disponibilité de l'artefact ; téléchargez ou transférez avant l'expiration.
errorobjectOptionnel
Présent uniquement si status == fail.
codestringRequisCode d'erreur métier.
messagestringRequisDescription de l'erreur.
Exemples de réponse
Succès
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En cours (non terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Échec
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articles
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Comparatif et évaluation
Comparatif transversal de hailuo-2.3-fast/image-to-video : comment choisir un modèle image-to-video et les points clés de migration
-

Tutoriel
Comment utiliser kling-4.0/text-to-video via l'API HiAPI : curl, Python et un exemple de requête fonctionnel
Guide pratique pour les développeurs : prompts cinématographiques, audio synchronisé, interrogation asynchrone et téléchargement des sorties
-

Tutoriel
Tutoriel pour kandinsky-6.0-pro/image-to-video sur HiAPI : curl + Python
Lancer une requête image-vers-vidéo exploitable sur HiAPI : de l'envoi de la première image à l'interrogation asynchrone jusqu'au téléchargement final
-

Tutoriel
recraft-v4.1-flash génération d'images texte-à-image en pratique : 5 scénarios métier à forte valeur et points d'intégration clés
À partir d'un coût de 0,01 $ par image, planifier le déploiement de la génération d'images dans de vrais contextes métier
-

Tutoriel
Comment appeler kling-4.0/image-to-video sur HiAPI : curl, Python et interrogation périodique
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Comparatif et évaluation
Comparatif horizontal de Recraft v4.1 Flash en génération d'images à partir de texte : guide de sélection et de migration pour les développeurs
Avec un coût de 0,01 $ par image et ses capacités de génération pure à partir de texte, déterminez s'il convient à votre pipeline de génération d'images
Modèles associés
Voir tous les modèles →Même type
-
 Nano Banana Pro Google $0.057 /image
-
 Nano Banana Google $0.021 /image
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /image
-
 Grok Imagine Image 2.0 xAI $0.052 /image
-
 Krea 2 Medium Turbo Krea $0.021 /image
-
 Google Virtual Try-On Google $0.107 /image
-
 Nano Banana 2 Lite Google $0.033 /image
-
 FIBO 1.5 Bria $0.058 /image
-
 FLUX.1 Schnell Black Forest Labs $0.005 /image
-
 BRIA Eraser Bria $0.058 /image
-
 Recraft V4.1 Recraft $0.010 /image
-
 Ideogram V3 Character Ideogram $0.090 /image
Même fournisseur
-
 Wan 2.7 Video Alibaba $0.100 /seconde
-
 HappyHorse 1.1 Alibaba $0.160 /seconde
-
 Wan 2.6 Flash Alibaba $0.043 /seconde
-
 HappyHorse 1.0 Alibaba $0.168 /seconde
-
 Qwen Image 3.0 Alibaba $0.036 /image
-
 Qwen Image 2.1 Alibaba $0.020 /image
-
 Qwen Audio 3.0 TTS Alibaba $0.030 /1 000 caractères
-
 Qwen Image 2.0 Alibaba $0.042 /image
-
 Z-Image Alibaba $0.008 /image
-
 Wan 3.0 Video Alibaba $0.040 /seconde